Cursus
Introductie tot Deep Learning in Python
4 uur
264.7K
(Deze tutorial gaat ervan uit dat je bekend bent met de basis van neurale netwerken)
Neuraal netwerk is allang geen onbekende term meer voor de informaticagemeenschap, of laten we zeggen voor de maatschappij in het algemeen. De belangrijkste reden dat het zo cool is, is niet alleen het aantal problemen uit de echte wereld dat het oplost, maar ook het soort problemen dat het aanpakt. Hoe kan dat zo uiteenlopend zijn?
Of het nu in de cognitieve psychologie is, in het domein van cyberbeveiliging, of in de zorg (Even laten we Computer Vision, Computer Graphics, Natural Language Processing, enz. buiten beschouwing.). Laten we de minder voor de hand liggende noemen! Bijna elke sector profiteert enorm van de intelligentie en automatisering die een neuraal netwerk te bieden heeft.
Maar waarom? Dat is de vraag die steeds terugkomt! Tja, het antwoord hierop is nog volop onderwerp van onderzoek, omdat neurale netwerken van nature nogal een black box zijn en hun gelijkenis met een brein de vraag nog ingewikkelder maakt. Hoe dan ook, die vraag beantwoorden is niet het doel van dit artikel.
Eén ding is zeker! Om de verwachte resultaten uit een neuraal netwerk te halen, moet je zorgen voor de training. En inmiddels heb je vast al gemerkt dat heel groot trainen een enorme hoeveelheid rekenkracht vereist. Zonder goede GPU’s en SSD’s is het bijna onmogelijk om een zeer groot neuraal netwerk te trainen. Hoe groot is zeer groot? Groot genoeg om goede resultaten te behalen op een ImageNet-dataset, want dat is zo’n beetje de benchmark.
Maar dit hele idee van gigantische neurale netwerken trainen werd volledig op zijn kop gezet toen een team getalenteerde onderzoekers van Fast.ai erin slaagde Google’s model te verslaan met een nauwkeurigheid van 93% in slechts 18 minuten, en dat voor maar $40.
Klinkt interessant? Lees verder!
Wat waren de sleutelingrediënten waardoor dit kon gebeuren? State-of-the-art GPU’s? State-of-the-art TPU’s? State-of-the-art SSD’s?
Absoluut niet. De configuratie van het team was vrij eenvoudig, gezien de kosten slechts $40 waren. Het sleutelingrediënt was het gebruik van state-of-the-art algoritmen om het neuraal netwerk te trainen. In deze blog bespreekt de geweldige onderzoeker en docent Jeremy Howard de belangrijkste redenen voor deze grote overwinning.
Dit is een klassiek voorbeeld waarin de kracht van dure hardware het aflegt tegen de kracht van sterke algoritmen. In dit artikel ga je één zo’n techniek ontrafelen die kan zorgen dat een neuraal netwerk met de best mogelijke leersnelheid wordt getraind. Deze techniek staat bekend als Cyclische leersnelheid (CLR). Deze werd al in 2015 voorgesteld door Leslie N. Smith. Je kunt het oorspronkelijke paper hier bekijken.
Maar waarom behandel je alleen de leersnelheid als er ook andere essentiële hyperparameters zijn, zoals droprate en activatiefuncties? Omdat de leersnelheid de belangrijkste van allemaal is. Punt.
In dit artikel ga je het volgende behandelen:
Laten we snel het primaire doel herhalen van het gebruik van leersnelheden bij het trainen van een neuraal netwerk.
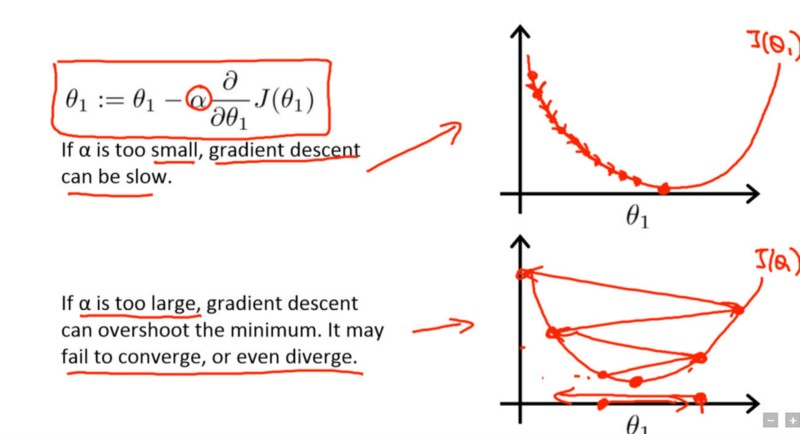
Leersnelheid is een hyperparameter die bepaalt in welke mate je de gewichten van je netwerk aanpast ten opzichte van de verliesgradiënt. Wat? Waarom komen gradiënten in beeld? Omdat je een neuraal netwerk dat je net hebt gebouwd aan het optimaliseren bent met gradient descent. Het doel van gradient descent is in essentie het vinden van het minimum van de verliesfunctie die je neuraal netwerk probeert te optimaliseren. Bekijk de volgende afbeelding [uit Andrew Ng’s Deep Learning-cursus op Coursera]:
De term in de rechthoek is de updaterichtlijn waarmee het netwerk zijn parameter $\theta$1 begint te leren, waarbij $\alpha$ de leersnelheid is.
In de eerste curve is het onderste punt het minimum van de verliesfunctie. Stel dat je netwerk in de huidige iteratie zich vlak bij het linkerbovenste punt bevindt. Om te convergeren naar het laagste punt, neem je partiële afgeleiden van de verliesfunctie $J(\theta1)$ en bereken je de gradiënten om de richting te krijgen naar dat laagste punt.
Om wat sneller bij dat punt te komen, voeg je een extra term $\alpha$ toe: de leersnelheid. Hoe lager de waarde, hoe trager je langs de dalende helling beweegt. Hoewel dit (een lage leersnelheid) een goed idee kan zijn om te zorgen dat je geen lokaal minimum mist, kan het ook betekenen dat de convergentie lang duurt — zeker als je op een plateau terechtkomt.
Dat was een korte opfrissing van het doel van leersnelheden in eenvoudige bewoordingen. Nu ga je de technieken bestuderen om een goede leersnelheid voor je neuraal netwerk te kiezen.
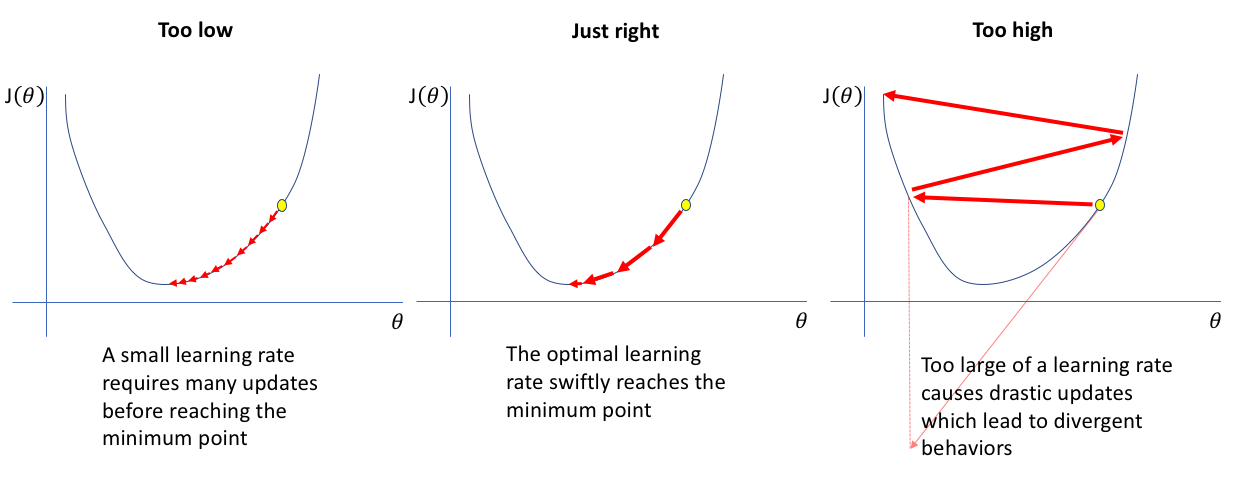
Er is geen vaste leersnelheid voor een neuraal netwerk. Het hangt af van het soort probleem waar je aan werkt, het type data dat je aan je netwerk voert en, vooral, de structuur van het netwerk, die per probleem verschilt. Handmatig een leersnelheid kiezen is een lastige klus, want als je een groot netwerk traint, kun je enorme kosten maken. En het kost ook heel veel tijd.
Moet je standaardmethoden voor hyperparameteroptimalisatie gebruiken, zoals Grid Search of Random Search?
Voor CLR werden adaptieve leersnelheden voorgesteld, die je kunt zien als een concurrent van CLR, maar experimenteren met adaptieve leersnelheden is rekenkundig duur, en CLR niet.
Tot op heden is de meest gebruikelijke praktijk om de leersnelheid op een constante waarde te zetten en die met een orde van grootte te verlagen zodra de nauwkeurigheid een plateau bereikt.
Er is dus duidelijk behoefte aan een systematische techniek die het kiezen van een goede leersnelheid voor een specifiek neuraal netwerk vereenvoudigt. En bovendien moeten er voldoende argumenten zijn die ondersteunen waarom die aanpak betrouwbaar is.
Het lijkt erop dat cyclische leersnelheden (CLR) precies op tijd zijn verschenen.
De doelen van de cyclische leersnelheid (CLR) zijn tweeledig:
Je leest dit deel vooral om je intuïtie op te bouwen over hoe CLR werkt. In het volgende deel ga je dieper in op de details. In de vorige secties heb je kort begrepen waarom leersnelheden überhaupt worden gebruikt. Laten we dat nog even ophalen.
Een ideale leersnelheid is er een die zorgt voor een steile daling van het verlies van het netwerk. Hier komt de magie van CLR om de hoek kijken. Het oorspronkelijke CLR-paper beschrijft een experiment waarin je het gedrag van de leersnelheid ten opzichte van het verlies kunt observeren. Het experiment is eenvoudig te visualiseren: je verhoogt de leersnelheid geleidelijk na elke mini-batch en noteert het verlies bij elke stap. Deze geleidelijke toename kan lineair of exponentieel zijn. En ja, dit is in essentie de LR Range Test.
Na het uitvoeren van het experiment liet Leslie zien dat bij te lage leersnelheden het verlies wel daalt, maar heel langzaam. Wanneer je in de optimale zone voor de leersnelheid komt, zie je een snelle daling van de verliesfunctie. Als je de leersnelheid verder verhoogt, kan dat leiden tot parameterverlies in het netwerk, wat op zijn beurt tot stijgende verliezen kan leiden. Uit dit experiment blijkt dus dat je geïnteresseerd bent in een steile daling van de verliesfunctie en dat je daarvoor de gradiënten van de verliesfunctie op verschillende momenten tijdens de training kunt analyseren.
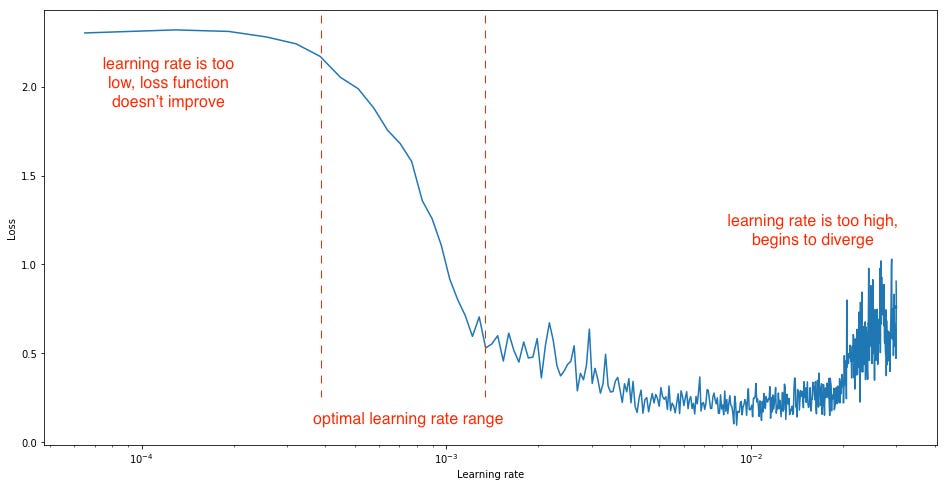
Uit de bovenstaande grafiek kun je gemakkelijk drie verschillende fasen onderscheiden: eerst verandert het verlies weinig, vervolgens komt er een periode met een steile daling, en daarna begint het verlies weer langzaam toe te nemen.
Zie je de steilste daling van allemaal? Ja, daar wil je uiteindelijk in terechtkomen, en CLR geeft je een gedisciplineerde aanpak om die te vinden. Nu je de smaak te pakken hebt, gaan we verder.
De bovenstaande observatie levert je een belangrijk aandachtspunt op:
De intuïtie achter CLR komt voort uit het idee om de leersnelheid te laten variëren binnen een bereik van waarden, in plaats van lineair of exponentieel te laten dalen. Dat kun je doen door een vast bereik aan leersnelheden te kiezen en die vervolgens cyclisch te laten variëren binnen dat bereik, in plaats van lineair of exponentieel. Leslie bekeek de volgende functievormen om de leersnelheid cyclisch te variëren:
Maar alle vormen leverden vergelijkbare resultaten op, en daarom wordt in het oorspronkelijke paper het idee alleen met een driehoeksvorm (lineair stijgend en dan lineair dalend) gepresenteerd vanwege de eenvoud. Dit beleid wordt ook wel de triangular learning rate policy genoemd. Implementeren is ook rechttoe rechtaan. Hieronder staat een gegeneraliseerde implementatie van de triangular learning rate policy:
local cycle = math.floor(1 + epochCounter / ( 2 ∗ stepsize))
local x = math.abs(epochCounter / stepsize − 2∗ cycle + 1 )
local lr = opt.LR + (maxLR − opt.LR) ∗ math.max(0 , (1−x ))
waar
Bekijk de volgende afbeelding om de driehoeksvorm visueel te maken:

Bron: het oorspronkelijke CLR-paper vermeld aan het begin van de tutorial.
Naast het driehoekige leersnelheidsbeleid werden in het paper ook de volgende beleidsvormen gepresenteerd:
Een vraag die je jezelf nu waarschijnlijk stelt is: Hoe kun je redelijke minimale en maximale grenswaarden schatten? Weet je de LR Range Test nog die je zojuist hebt bestudeerd? Nu zie je de relevantie ervan beter.
Leslie stelde een eenvoudige en handige manier voor om het leersnelheidsbereik te bepalen:
Laten we nu een snelle casestudy doen om te zien hoe CLR geweldige resultaten kan opleveren.
(Aan het eind van deze tutorial ontdek je nog enkele recente verbeteringen op CLR, maar inmiddels heb je de waarde van CLR al begrepen.)
Dit ga je doen met de klassieke MNIST-dataset, waarschijnlijk de populairste dataset om te beginnen met Computer Vision en Deep Learning. Bekijk deze blog als je MNIST heel uitgebreid wilt leren kennen. Je gebruikt keras intensief voor alle onderdelen van het experiment. keras levert een ingebouwde versie van de dataset. Je begint je experiment met het importeren daarvan en voert wat basis-EDA uit.
from keras.datasets import mnist
Using TensorFlow backend.
Je hebt de dataset succesvol geïmporteerd. Nu ga je wat basisvisualisaties van de dataset maken.
import matplotlib.pyplot as plt

(X_train, y_train), (X_test, y_test) = mnist.load_data()

# Plot 4 images as gray scale
plt.subplot(152)
plt.imshow(X_train[0], cmap=plt.get_cmap('gray'))
plt.subplot(153)
plt.imshow(X_train[1], cmap=plt.get_cmap('gray'))
plt.subplot(154)
plt.imshow(X_train[2], cmap=plt.get_cmap('gray'))
plt.subplot(155)
plt.imshow(X_train[3], cmap=plt.get_cmap('gray'))
# Show the plot
plt.show()
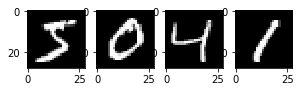
Mooi! Je gaat meteen door met het bouwen van een eenvoudig meerlaags neuraal netwerk. Maar eerst doe je wat basisvoorbewerking van de data.
# Flatten 28*28 images to a 784 vector for each image
num_pixels = X_train.shape[1] * X_train.shape[2]
X_train = X_train.reshape(X_train.shape[0], num_pixels).astype('float32')
X_test = X_test.reshape(X_test.shape[0], num_pixels).astype('float32')
Wat heb je gedaan?
De afbeeldingen in de dataset hebben afmetingen van 28×28, wat lastig is om in te passen in een eenvoudig meerlaags neuraal netwerk. Daarom heb je de afbeeldingen omgezet naar één dimensie, waarbij elke afbeelding 784 pixelwaarden bevat met de functie reshape().
De pixelwaarden in de afbeeldingen liggen tussen 0 en 255. Een goed idee is om dit verder te verkleinen door het bereik te normaliseren naar 0–1.
X_train = X_train / 255
X_test = X_test / 255
De doelvariabele is een geheel getal van 0 tot 9. Dit is een multiclass-classificatieprobleem. Je gaat one-hot-encoding toepassen op de klassenlabels om een vector met klasse-integers om te zetten in een binaire matrix. Dit doe je om de categorie te “binariseren” en zodat je die als feature kunt opnemen om het neuraal netwerk te trainen.
Je kunt dit eenvoudig doen met de ingebouwde helperfunctie np_utils.to_categorical() in keras.
from keras.utils import np_utils

y_train = np_utils.to_categorical(y_train)
y_test = np_utils.to_categorical(y_test)
num_classes = y_test.shape[1]
Nu ga je de structuur van je netwerk definiëren. Je gebruikt hiervoor een eenvoudig volledig verbonden netwerk. In keras is dit doorgaans een driestappenproces:
import numpy as np
from keras.models import Sequential
from keras.layers import Dense

# Create model
model = Sequential()
model.add(Dense(num_pixels, input_dim=num_pixels, kernel_initializer='normal', activation='relu'))
model.add(Dense(num_classes, kernel_initializer='normal', activation='softmax'))

# Compile model
model.compile(loss='categorical_crossentropy', optimizer='adam', metrics=['accuracy'])
Laten we bekijken wat je hierboven hebt gedaan. Je bouwt het netwerk sequentieel op (een lineaire stapel lagen). Daarna begon je lagen toe te voegen: in de eerste laag heb je neuronen toegevoegd (gelijk aan het aantal pixels in een afbeelding, dus 784) en je specificeerde de inputdimensie van de afbeeldingen, die hier hetzelfde is als het aantal pixels. Je hebt het netwerk geïnstrueerd om zichzelf te initialiseren met gewichten uit een normale verdeling. Tot slot gaf je relu op als activatiefunctie voor de eerste laag.
In de uiteindelijke laag hield je het aantal neuronen op 10 (het aantal klassenlabels) en je gebruikte als activatie softmax om de outputs om te zetten in waarschijnlijkheidsachtige waarden en één klasse van de 10 te laten kiezen als de voorspelling van het model.
Je hebt het model gecompileerd om de optimalisatiemethode te kiezen (in dit geval ADAM) en het soort verlies dat deze methode zal optimaliseren (in dit geval categorical_loss).
Nu ga je het model trainen en de tijd registreren die daarvoor nodig is. Je test ook de prestaties.
import timeit

# For fixing the reproducibility
from numpy.random import seed
seed(1)

# Fit the model
startTime = timeit.default_timer()
model.fit(X_train, y_train, validation_data=(X_test, y_test), epochs=10, batch_size=200, verbose=2)
elapsedTime = timeit.default_timer() - startTime
print("Time taken for the Network to train : ",elapsedTime)

# Final evaluation of the model
scores = model.evaluate(X_test, y_test, verbose=0)
print("Baseline Error: %.2f%%" % (100-scores[1]*100))
Train on 60000 samples, validate on 10000 samples
Epoch 1/10
 - 10s - loss: 0.2774 - acc: 0.9207 - val_loss: 0.1362 - val_acc: 0.9610
Epoch 2/10
 - 8s - loss: 0.1113 - acc: 0.9675 - val_loss: 0.0951 - val_acc: 0.9720
Epoch 3/10
 - 8s - loss: 0.0712 - acc: 0.9793 - val_loss: 0.0802 - val_acc: 0.9750
Epoch 4/10
 - 8s - loss: 0.0503 - acc: 0.9857 - val_loss: 0.0687 - val_acc: 0.9788
Epoch 5/10
 - 8s - loss: 0.0360 - acc: 0.9897 - val_loss: 0.0632 - val_acc: 0.9797
Epoch 6/10
 - 8s - loss: 0.0267 - acc: 0.9928 - val_loss: 0.0643 - val_acc: 0.9784
Epoch 7/10
 - 8s - loss: 0.0201 - acc: 0.9951 - val_loss: 0.0633 - val_acc: 0.9802
Epoch 8/10
 - 8s - loss: 0.0150 - acc: 0.9962 - val_loss: 0.0613 - val_acc: 0.9808
Epoch 9/10
 - 8s - loss: 0.0108 - acc: 0.9978 - val_loss: 0.0625 - val_acc: 0.9806
Epoch 10/10
 - 8s - loss: 0.0076 - acc: 0.9988 - val_loss: 0.0612 - val_acc: 0.9809
Time taken for the Network to train :  86.4216202873591
Baseline Error: 1.91%
Dit eenvoudige model deed het behoorlijk goed met een foutpercentage van slechts 1,91% in ongeveer 87 seconden. Nu ga je de kracht van CLR zien. Je begint met het clonen van de keras-implementatie van CLR van Github.
Na een geslaagde clone zou je de volgende bestanden in je lokale werkmap moeten hebben.

Het CLR-beleid is hier geïmplementeerd als een keras callback.
from keras.callbacks import *
from clr_callback import *
from keras.optimizers import Adam

# You are using the triangular learning rate policy and
#  base_lr (initial learning rate which is the lower boundary in the cycle) is 0.1
clr_triangular = CyclicLR(mode='triangular')
model.compile(optimizer=Adam(0.1), loss='categorical_crossentropy', metrics=['accuracy'])
Je geeft deze clr_triangular door aan de parameter callbacks tijdens het fitten van het netwerk. Dit keer gebruik je een grotere batch_size. Je registreert ook de tijd.
startTime = timeit.default_timer()
model.fit(X_train, y_train, validation_data=(X_test, y_test), epochs=10, batch_size=2000,callbacks=[clr_triangular], verbose=2)
elapsedTime = timeit.default_timer() - startTime
print("Time taken for the Network to train : ",elapsedTime)

# Final evaluation of the model
scores = model.evaluate(X_test, y_test, verbose=0)
print("Baseline Error: %.2f%%" % (100-scores[1]*100))
Train on 60000 samples, validate on 10000 samples
Epoch 1/10
 - 4s - loss: 0.0046 - acc: 0.9996 - val_loss: 0.0571 - val_acc: 0.9831
Epoch 2/10
 - 4s - loss: 0.0030 - acc: 0.9998 - val_loss: 0.0575 - val_acc: 0.9829
Epoch 3/10
 - 4s - loss: 0.0023 - acc: 0.9999 - val_loss: 0.0594 - val_acc: 0.9827
Epoch 4/10
 - 4s - loss: 0.0018 - acc: 0.9999 - val_loss: 0.0589 - val_acc: 0.9835
Epoch 5/10
 - 4s - loss: 0.0014 - acc: 1.0000 - val_loss: 0.0595 - val_acc: 0.9831
Epoch 6/10
 - 4s - loss: 0.0011 - acc: 1.0000 - val_loss: 0.0600 - val_acc: 0.9836
Epoch 7/10
 - 4s - loss: 0.0010 - acc: 1.0000 - val_loss: 0.0612 - val_acc: 0.9832
Epoch 8/10
 - 4s - loss: 8.2190e-04 - acc: 1.0000 - val_loss: 0.0621 - val_acc: 0.9829
Epoch 9/10
 - 4s - loss: 6.6182e-04 - acc: 1.0000 - val_loss: 0.0624 - val_acc: 0.9836
Epoch 10/10
 - 4s - loss: 5.7177e-04 - acc: 1.0000 - val_loss: 0.0635 - val_acc: 0.9836
Time taken for the Network to train :  43.23223609056981
Baseline Error: 1.64%
Zie je het voordeel? Dit is geweldig om te zien! Je model had slechts 44 seconden nodig om te trainen en leverde zelfs een beter foutpercentage dan het vorige. Heel goed!
Je bent tot het einde gekomen. In deze tutorial heb je een heel cruciaal probleem bestudeerd: het vinden van een geschikte leersnelheid, en hoe CLR de manier waarop je dit probleem benaderde volledig veranderde. Je hebt CLR in behoorlijke detail doorgenomen en kleine experimenten gedaan om te zien hoe CLR uitstekende resultaten kan opleveren in minder tijd.
Wat nu? De twee bijproducten die uit CLR zijn voortgekomen zijn:
Bestudeer de bovenstaande twee benaderingen om nog meer inzicht in dit onderwerp te krijgen. Na CLR publiceerde Leslie ook een paper getiteld A disciplined approach to neural network hyper-parameters: Part 1 -- learning rate, batch size, momentum, and weight decay, waarin CLR opnieuw wordt bekeken en efficiënte methoden worden besproken om waarden te kiezen voor andere belangrijke hyperparameters van een neuraal netwerk. Leslie hernam in dit paper ook een van zijn technieken, genaamd Super Convergence. Dit paper is een must-read voor iedereen die denkt, eet en slaapt met neurale netwerken.
Beperkte toepasbaarheid is een van de belangrijke tekortkomingen van CLR. Het moet waterdicht worden gemaakt voordat je het op productieniveau kunt gebruiken.
Als je meer wilt weten over neurale netwerken, volg dan de cursus Deep Learning in Python van DataCamp, die erg goed is opgezet en wordt gegeven door Dan Becker (Head of Kaggle Learn).
Meer leren over Python en Deep Learning
Cursus
Cursus
blog
Adel Nehme
15 min

