Khóa học
Nhập môn Deep Learning với Python
4 giờ
264.8K
(Hướng dẫn này giả định người đọc đã quen với những kiến thức cơ bản về mạng nơ-ron)
Mạng nơ-ron không còn là một cụm từ xa lạ với cộng đồng Khoa học Máy tính hay nói rộng hơn là với xã hội nói chung. Lý do chính khiến nó trở nên cuốn hút không chỉ ở số lượng vấn đề thực tiễn mà nó giải quyết, mà còn ở bản chất đa dạng của những vấn đề đó. Tại sao chúng có thể đa dạng đến vậy?
Dù là trong lĩnh vực Tâm lý học nhận thức, an ninh mạng hay chăm sóc sức khỏe (chưa xét đến thị giác máy tính, đồ họa máy tính, xử lý ngôn ngữ tự nhiên, v.v.). Hãy kể tên những lĩnh vực ít phổ biến hơn! Hầu như mọi ngành đều đang hưởng lợi to lớn từ trí tuệ và khả năng tự động hóa mà mạng nơ-ron mang lại.
Nhưng vì sao? Đây là câu hỏi cứ lặp đi lặp lại! Thực ra câu trả lời vẫn đang được nghiên cứu tích cực bởi mạng nơ-ron khá giống một “hộp đen”, và sự tương đồng của nó với bộ não càng khiến câu hỏi trở nên phức tạp. Dù sao đi nữa, trả lời câu hỏi đó không phải mục tiêu của bài viết này.
Có một điều chắc chắn! Để đạt được kết quả như kỳ vọng từ một mạng nơ-ron, điều cần phải đảm bảo là huấn luyện. Và có lẽ đến lúc này, bạn đã nhận ra rằng huấn luyện rất lớn đòi hỏi một lượng sức mạnh tính toán khổng lồ. Không có GPU, SSD tốt thì gần như không thể huấn luyện một mạng nơ-ron rất lớn. Vậy “rất lớn” là bao nhiêu? Đủ lớn để tạo ra kết quả tốt trên bộ dữ liệu ImageNet vì đó là một dạng chuẩn đối sánh.
Nhưng chính ý tưởng huấn luyện các mạng nơ-ron khổng lồ này đã được thay đổi hoàn toàn khi một nhóm nhà nghiên cứu tài năng từ Fast.ai đánh bại mô hình của Google, đạt độ chính xác 93% chỉ trong 18 phút với chi phí vỏn vẹn $40.
Nghe thú vị chứ? Đọc tiếp nào!
Vậy thành phần then chốt đằng sau thành tựu này là gì? GPU tối tân? TPU tối tân? SSD tối tân?
Hoàn toàn không. Cấu hình của nhóm rất đơn giản tương xứng với chi phí chỉ $40. Thành phần chủ chốt là sử dụng các thuật toán tối tân để huấn luyện mạng nơ-ron. Trong bài blog này, nhà nghiên cứu và giáo dục xuất sắc Jeremy Howard đã bàn về những lý do chính cho chiến thắng lớn đó.
Đây là ví dụ kinh điển nơi sức mạnh của phần cứng đắt tiền bị lu mờ trước sức mạnh của thuật toán mạnh mẽ. Trong bài viết này, bạn sẽ khám phá chi tiết một kỹ thuật có thể đảm bảo mạng nơ-ron được huấn luyện với tốc độ học tốt nhất có thể. Kỹ thuật này gọi là Tốc độ Học Tuần hoàn (CLR). Kỹ thuật này được đề xuất từ năm 2015 bởi Leslie N. Smith. Bạn có thể xem bài báo gốc tại đây.
Nhưng tại sao bạn chỉ bàn về tốc độ học khi còn có những siêu tham số quan trọng khác như tỷ lệ dropout và hàm kích hoạt? Bởi vì tốc độ học là quan trọng nhất trong số đó. Vậy thôi!
Trong bài này, bạn sẽ tìm hiểu:
Hãy ôn nhanh mục đích chính của việc dùng tốc độ học khi huấn luyện mạng nơ-ron.
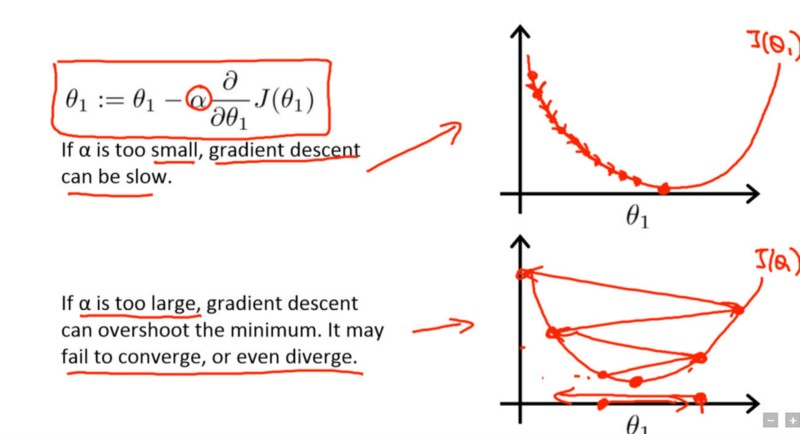
Tốc độ học là một siêu tham số điều khiển mức độ bạn điều chỉnh trọng số của mạng tương ứng với gradient của hàm mất mát. Gì cơ? Tại sao gradient lại xuất hiện ở đây? Bởi vì bạn đang tối ưu hóa mạng nơ-ron vừa tạo bằng gradient descent. Mục tiêu của gradient descent về bản chất là tìm điểm cực tiểu của hàm mất mát mà mạng nơ-ron đang cố tối ưu. Hãy nhìn bức hình sau [trích từ khóa học Deep Learning của Andrew Ng trên Coursera]:
Biểu thức trong hình chữ nhật là quy tắc cập nhật theo đó mạng bắt đầu học các tham số $\theta$1, trong đó $\alpha$ là tốc độ học.
Ở đường cong đầu tiên, điểm thấp nhất là cực tiểu của hàm mất mát. Giả sử trong vòng lặp hiện tại, mạng của bạn ở gần điểm cao nhất bên trái. Để hội tụ về điểm thấp nhất, bạn lấy đạo hàm riêng của hàm mất mát $J(\theta1)$ và tính gradient để xác định hướng đi tới điểm thấp nhất đó.
Để tới điểm đó nhanh hơn một chút, bạn thêm một hạng $\alpha$ là tốc độ học. Giá trị càng thấp, bạn càng di chuyển chậm dọc theo sườn dốc đi xuống. Điều này có thể là ý tưởng hay (dùng tốc độ học thấp) để đảm bảo không bỏ lỡ cực tiểu cục bộ nào, nhưng cũng có nghĩa là bạn sẽ mất rất nhiều thời gian để hội tụ — đặc biệt nếu bị kẹt ở vùng “cao nguyên”.
Đó là phần ôn nhanh về mục tiêu của tốc độ học theo cách dễ hiểu. Giờ bạn sẽ tìm hiểu các kỹ thuật chọn một tốc độ học tốt cho mạng nơ-ron của mình.
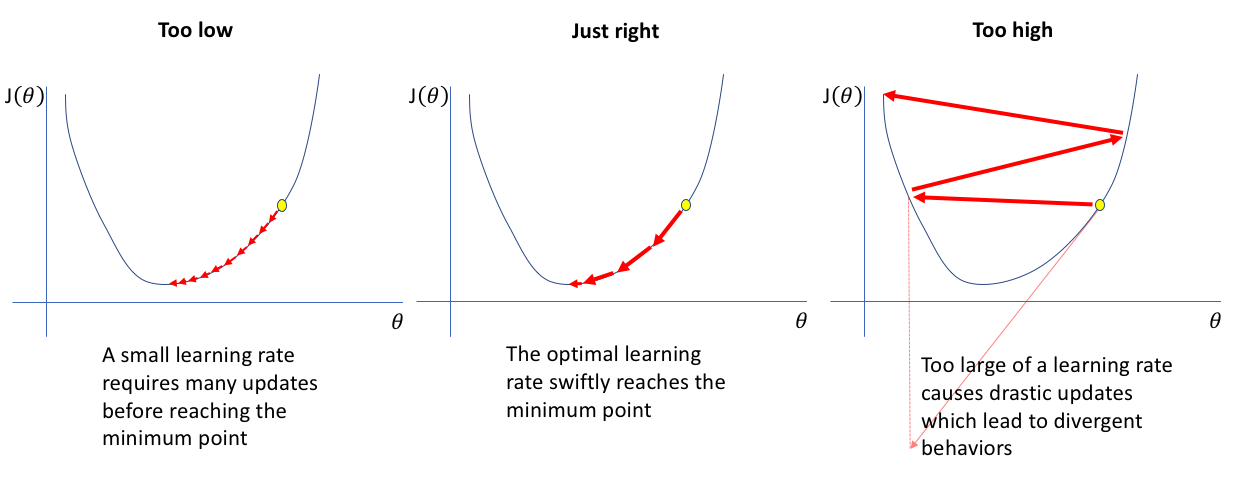
Không có một tốc độ học cố định cho mọi mạng nơ-ron. Nó phụ thuộc vào loại bài toán bạn đang xử lý, kiểu dữ liệu bạn đưa vào mạng, và quan trọng nhất là cấu trúc mạng vốn thay đổi theo từng bài toán. Chọn tay một tốc độ học là một công việc rất mệt mỏi vì nếu bạn đang huấn luyện một mạng lớn, chi phí có thể tăng vọt. Và cũng rất tốn thời gian.
Bạn có nên chạy các phương pháp tối ưu hóa siêu tham số tiêu chuẩn như Grid Search hay Random Search?
Trước CLR, người ta đề xuất Tốc độ Học Thích nghi (Adaptive Learning Rates), có thể coi như đối thủ của CLR, nhưng thử nghiệm với Tốc độ Học Thích nghi tốn kém tính toán hơn, trong khi CLR thì không.
Đến nay, thực hành phổ biến nhất vẫn là đặt tốc độ học ở một giá trị hằng số và giảm nó theo bậc khi độ chính xác bị “chững lại”.
Vì vậy, rõ ràng cần một kỹ thuật có hệ thống để đơn giản hóa việc chọn tốc độ học tốt cho một mạng nơ-ron cụ thể. Không chỉ vậy, còn cần đủ lý do thuyết phục để chứng minh cách tiếp cận đó là đáng tin.
Có vẻ Tốc độ Học Tuần hoàn (CLR) xuất hiện đúng lúc.
Mục tiêu của tốc độ học tuần hoàn (CLR) có hai phần:
Bạn sẽ học phần này chủ yếu để xây dựng trực giác về cách CLR hoạt động. Ở phần tiếp theo, bạn sẽ đi sâu hơn. Ở các phần trước, bạn đã hiểu lướt qua vì sao cần tốc độ học. Hãy cùng nhắc lại.
Một tốc độ học lý tưởng là tốc độ giúp giảm mạnh hàm mất mát của mạng. Đây là “phép màu” của CLR. Bài báo gốc về CLR nêu một thí nghiệm để bạn quan sát hành vi của tốc độ học tương ứng với mất mát. Thí nghiệm rất trực quan: bạn tăng dần tốc độ học sau mỗi mini-batch, và ghi lại mất mát ở mỗi lần tăng. Sự tăng dần này có thể tuyến tính hoặc mũ. Và đúng vậy, đó chính là LR Range Test.
Sau khi thực hiện thí nghiệm theo Leslie, với tốc độ học quá thấp, mất mát có thể giảm nhưng rất chậm. Khi đi vào vùng tốc độ học tối ưu, bạn sẽ thấy hàm mất mát giảm nhanh. Nếu tiếp tục tăng tốc độ học, điều đó có thể gây “mất” tham số trong mạng, từ đó làm mất mát tăng trở lại. Vậy từ thí nghiệm này, rõ ràng bạn quan tâm đến đoạn giảm dốc mạnh của hàm mất mát, và để làm vậy, bạn có thể phân tích gradient của hàm mất mát ở các giai đoạn khác nhau của quá trình huấn luyện.
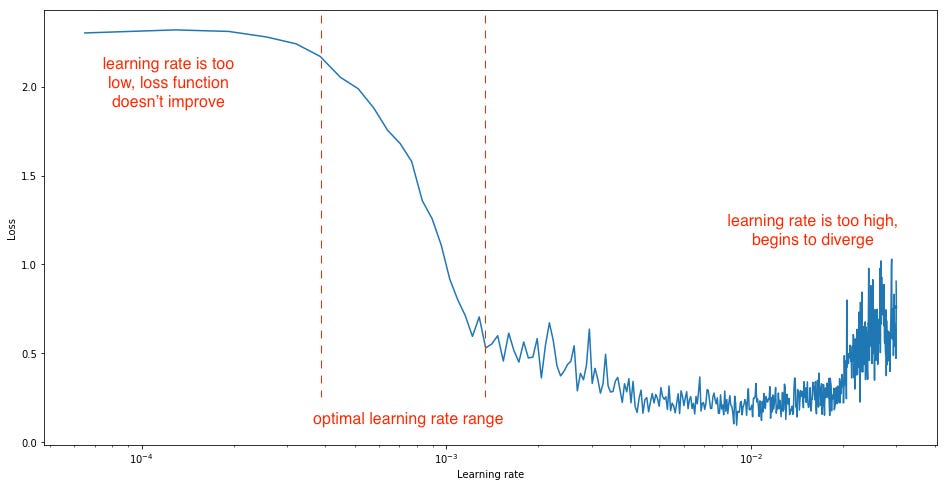
Vậy, từ đồ thị trên, bạn dễ dàng thấy ba giai đoạn khác nhau: đoạn mà mất mát không thay đổi nhiều, rồi đến lúc xảy ra giảm mạnh, và sau đó mất mát lại bắt đầu tăng dần lên.
Bạn có thấy đoạn giảm mạnh nhất trong tất cả các đoạn giảm khác không? Đúng vậy, về cơ bản bạn muốn dừng lại trong khoảng đó, và CLR sẽ cung cấp cho bạn một cách tiếp cận có kỷ luật để tìm ra nó. Nắm được ý rồi, hãy tìm hiểu thêm.
Quan sát trên cho bạn một điểm quan trọng cần cân nhắc:
Trực giác của CLR xuất phát từ ý tưởng để tốc độ học thay đổi trong một khoảng giá trị thay vì giảm tuyến tính hoặc theo hàm mũ. Bạn có thể làm điều này bằng cách đặt một khoảng tốc độ học xác định rồi thay vì biến thiên tuyến tính hay mũ, bạn cho tốc độ học thay đổi tuần hoàn trong khoảng đã định. Leslie đã cân nhắc các dạng hàm sau để thay đổi tốc độ học theo chu kỳ:
Nhưng tất cả các dạng đều cho kết quả tương đương, vì vậy trong bài báo gốc, ý tưởng chỉ được trình bày với dạng tam giác (tăng tuyến tính rồi giảm tuyến tính) vì tính đơn giản. Chính sách này còn được gọi là chính sách tốc độ học tam giác. Việc triển khai cũng rất thẳng thắn. Dưới đây là một hiện thực tổng quát của chính sách tốc độ học tam giác:
local cycle = math.floor(1 + epochCounter / ( 2 ∗ stepsize))
local x = math.abs(epochCounter / stepsize − 2∗ cycle + 1 )
local lr = opt.LR + (maxLR − opt.LR) ∗ math.max(0 , (1−x ))
trong đó
Tham khảo hình dưới để hình dung dạng tam giác:

Nguồn: Bài báo CLR gốc được nhắc đến ở đầu hướng dẫn.
Bên cạnh chính sách tốc độ học tam giác, bài báo còn trình bày các chính sách sau:
Một câu hỏi bạn có thể tự hỏi ngay lúc này là - Làm sao ước lượng hợp lý các giá trị biên dưới và biên trên? Nhớ bài kiểm tra LR Range bạn vừa học không? Giờ bạn sẽ thấy nó liên quan chặt chẽ thế nào.
Leslie đề xuất một cách đơn giản và thuận tiện để quyết định khoảng Tốc độ Học:
Hãy làm một nghiên cứu tình huống nhanh để xem CLR có thể cho kết quả ấn tượng thế nào.
(Đến cuối hướng dẫn, bạn sẽ khám phá thêm một số cải tiến vượt trội so với CLR được đề xuất gần đây, nhưng đến giờ, bạn đã hiểu rõ giá trị của CLR.)
Bạn sẽ thực hiện với bộ dữ liệu kinh điển MNIST, có lẽ là bộ phổ biến nhất để bắt đầu với Thị giác máy tính và Học sâu. Xem bài blog này nếu bạn muốn tìm hiểu MNIST chi tiết. Bạn sẽ dùng keras rộng rãi cho mọi mục đích thí nghiệm. keras cung cấp sẵn phiên bản tích hợp của bộ dữ liệu. Bạn sẽ bắt đầu bằng cách nhập bộ dữ liệu đó và thực hiện một số EDA cơ bản.
from keras.datasets import mnist
Using TensorFlow backend.
Bạn đã nhập bộ dữ liệu thành công. Giờ hãy trực quan hóa sơ bộ dữ liệu.
import matplotlib.pyplot as plt

(X_train, y_train), (X_test, y_test) = mnist.load_data()

# Plot 4 images as gray scale
plt.subplot(152)
plt.imshow(X_train[0], cmap=plt.get_cmap('gray'))
plt.subplot(153)
plt.imshow(X_train[1], cmap=plt.get_cmap('gray'))
plt.subplot(154)
plt.imshow(X_train[2], cmap=plt.get_cmap('gray'))
plt.subplot(155)
plt.imshow(X_train[3], cmap=plt.get_cmap('gray'))
# Show the plot
plt.show()
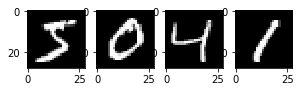
Tuyệt vời! Bạn sẽ tiến thẳng tới việc xây dựng một mạng nơ-ron nhiều lớp đơn giản. Nhưng trước đó, hãy tiền xử lý dữ liệu cơ bản.
# Flatten 28*28 images to a 784 vector for each image
num_pixels = X_train.shape[1] * X_train.shape[2]
X_train = X_train.reshape(X_train.shape[0], num_pixels).astype('float32')
X_test = X_test.reshape(X_test.shape[0], num_pixels).astype('float32')
Bạn đã làm gì?
Các ảnh trong bộ dữ liệu có kích thước 28*28, khó đưa trực tiếp vào một mạng nhiều lớp đơn giản. Vì vậy, bạn chuyển ảnh về một chiều, mỗi ảnh gồm 784 điểm ảnh bằng hàm reshape().
Giá trị điểm ảnh nằm trong khoảng 0 - 255. Một ý tưởng hay là giảm hơn nữa bằng cách chuẩn hóa về khoảng 0 - 1.
X_train = X_train / 255
X_test = X_test / 255
Biến đầu ra là số nguyên từ 0 đến 9. Đây là bài toán phân loại đa lớp. Bạn sẽ one-hot encode các nhãn lớp để chuyển vector số nguyên lớp thành ma trận nhị phân. Làm vậy để “nhị phân hóa” danh mục và có thể đưa nó vào như một đặc trưng để huấn luyện mạng nơ-ron.
Bạn có thể làm dễ dàng bằng hàm trợ giúp tích hợp np_utils.to_categorical() trong keras.
from keras.utils import np_utils

y_train = np_utils.to_categorical(y_train)
y_test = np_utils.to_categorical(y_test)
num_classes = y_test.shape[1]
Giờ bạn sẽ định nghĩa cấu trúc mạng. Bạn sẽ dùng một mạng fully-connected đơn giản cho mục đích này. Trong keras, đây thường là quy trình ba bước:
import numpy as np
from keras.models import Sequential
from keras.layers import Dense

# Create model
model = Sequential()
model.add(Dense(num_pixels, input_dim=num_pixels, kernel_initializer='normal', activation='relu'))
model.add(Dense(num_classes, kernel_initializer='normal', activation='softmax'))

# Compile model
model.compile(loss='categorical_crossentropy', optimizer='adam', metrics=['accuracy'])
Xem bạn đã làm gì trong đoạn mã trên. Bạn xây dựng mạng theo kiểu tuần tự (ngăn xếp các lớp theo tuyến tính). Sau đó bạn bắt đầu thêm lớp vào mạng, trong lớp đầu tiên bạn thêm số nơ-ron bằng với số điểm ảnh của một ảnh (tức 784) và chỉ định kích thước đầu vào của ảnh, ở đây trùng với số điểm ảnh. Bạn yêu cầu mạng khởi tạo trọng số từ phân phối chuẩn. Cuối cùng bạn đặt relu làm hàm kích hoạt cho lớp đầu.
Ở lớp cuối, bạn để số nơ-ron là 10 (ứng với số nhãn lớp), và dùng softmax làm hàm kích hoạt để chuyển đầu ra thành dạng giống xác suất và cho phép chọn một trong 10 lớp làm dự đoán của mô hình.
Bạn biên dịch mô hình để quyết định phương pháp tối ưu (ở đây là ADAM) và loại mất mát mà phương pháp này sẽ tối ưu (ở đây là categorical_loss).
Giờ bạn sẽ huấn luyện mô hình và ghi lại thời gian huấn luyện. Bạn cũng sẽ kiểm tra hiệu năng.
import timeit

# For fixing the reproducibility
from numpy.random import seed
seed(1)

# Fit the model
startTime = timeit.default_timer()
model.fit(X_train, y_train, validation_data=(X_test, y_test), epochs=10, batch_size=200, verbose=2)
elapsedTime = timeit.default_timer() - startTime
print("Time taken for the Network to train : ",elapsedTime)

# Final evaluation of the model
scores = model.evaluate(X_test, y_test, verbose=0)
print("Baseline Error: %.2f%%" % (100-scores[1]*100))
Train on 60000 samples, validate on 10000 samples
Epoch 1/10
 - 10s - loss: 0.2774 - acc: 0.9207 - val_loss: 0.1362 - val_acc: 0.9610
Epoch 2/10
 - 8s - loss: 0.1113 - acc: 0.9675 - val_loss: 0.0951 - val_acc: 0.9720
Epoch 3/10
 - 8s - loss: 0.0712 - acc: 0.9793 - val_loss: 0.0802 - val_acc: 0.9750
Epoch 4/10
 - 8s - loss: 0.0503 - acc: 0.9857 - val_loss: 0.0687 - val_acc: 0.9788
Epoch 5/10
 - 8s - loss: 0.0360 - acc: 0.9897 - val_loss: 0.0632 - val_acc: 0.9797
Epoch 6/10
 - 8s - loss: 0.0267 - acc: 0.9928 - val_loss: 0.0643 - val_acc: 0.9784
Epoch 7/10
 - 8s - loss: 0.0201 - acc: 0.9951 - val_loss: 0.0633 - val_acc: 0.9802
Epoch 8/10
 - 8s - loss: 0.0150 - acc: 0.9962 - val_loss: 0.0613 - val_acc: 0.9808
Epoch 9/10
 - 8s - loss: 0.0108 - acc: 0.9978 - val_loss: 0.0625 - val_acc: 0.9806
Epoch 10/10
 - 8s - loss: 0.0076 - acc: 0.9988 - val_loss: 0.0612 - val_acc: 0.9809
Time taken for the Network to train :  86.4216202873591
Baseline Error: 1.91%
Mô hình đơn giản này hoạt động khá tốt, đạt tỷ lệ lỗi chỉ 1.91% trong khoảng 87 giây. Giờ bạn sẽ thấy sức mạnh của CLR. Hãy bắt đầu bằng cách clone triển khai CLR cho keras từ Github.
Sau khi clone thành công, bạn sẽ có các tệp sau trong thư mục làm việc cục bộ.

Chính sách CLR được triển khai dưới dạng một keras callback ở đây.
from keras.callbacks import *
from clr_callback import *
from keras.optimizers import Adam

# You are using the triangular learning rate policy and
#  base_lr (initial learning rate which is the lower boundary in the cycle) is 0.1
clr_triangular = CyclicLR(mode='triangular')
model.compile(optimizer=Adam(0.1), loss='categorical_crossentropy', metrics=['accuracy'])
Bạn sẽ truyền clr_triangular vào tham số callbacks khi fit mạng. Lần này bạn sẽ dùng batch_size lớn hơn. Bạn cũng sẽ ghi lại thời gian.
startTime = timeit.default_timer()
model.fit(X_train, y_train, validation_data=(X_test, y_test), epochs=10, batch_size=2000,callbacks=[clr_triangular], verbose=2)
elapsedTime = timeit.default_timer() - startTime
print("Time taken for the Network to train : ",elapsedTime)

# Final evaluation of the model
scores = model.evaluate(X_test, y_test, verbose=0)
print("Baseline Error: %.2f%%" % (100-scores[1]*100))
Train on 60000 samples, validate on 10000 samples
Epoch 1/10
 - 4s - loss: 0.0046 - acc: 0.9996 - val_loss: 0.0571 - val_acc: 0.9831
Epoch 2/10
 - 4s - loss: 0.0030 - acc: 0.9998 - val_loss: 0.0575 - val_acc: 0.9829
Epoch 3/10
 - 4s - loss: 0.0023 - acc: 0.9999 - val_loss: 0.0594 - val_acc: 0.9827
Epoch 4/10
 - 4s - loss: 0.0018 - acc: 0.9999 - val_loss: 0.0589 - val_acc: 0.9835
Epoch 5/10
 - 4s - loss: 0.0014 - acc: 1.0000 - val_loss: 0.0595 - val_acc: 0.9831
Epoch 6/10
 - 4s - loss: 0.0011 - acc: 1.0000 - val_loss: 0.0600 - val_acc: 0.9836
Epoch 7/10
 - 4s - loss: 0.0010 - acc: 1.0000 - val_loss: 0.0612 - val_acc: 0.9832
Epoch 8/10
 - 4s - loss: 8.2190e-04 - acc: 1.0000 - val_loss: 0.0621 - val_acc: 0.9829
Epoch 9/10
 - 4s - loss: 6.6182e-04 - acc: 1.0000 - val_loss: 0.0624 - val_acc: 0.9836
Epoch 10/10
 - 4s - loss: 5.7177e-04 - acc: 1.0000 - val_loss: 0.0635 - val_acc: 0.9836
Time taken for the Network to train :  43.23223609056981
Baseline Error: 1.64%
Bạn thấy lợi thế chứ? Thật đáng kinh ngạc! Mô hình của bạn chỉ mất 44 giây để huấn luyện và còn đạt tỷ lệ lỗi tốt hơn mô hình trước. Rất tốt!
Bạn đã đi đến cuối cùng. Trong hướng dẫn này, bạn đã nghiên cứu một vấn đề rất quan trọng là tìm tốc độ học phù hợp và cách mà CLR hoàn toàn thay đổi cách tiếp cận trước đây. Bạn đã học CLR với lượng chi tiết đủ tốt và làm một số thử nghiệm nhỏ để thấy CLR có thể tạo ra kết quả xuất sắc trong thời gian ngắn hơn.
Vậy tiếp theo là gì? Hai “sản phẩm phụ” xuất phát từ CLR là:
Nghiên cứu hai phương pháp trên để có thêm góc nhìn về chủ đề này. Ngoài ra, sau CLR, Leslie đã công bố bài báo tựa đề A disciplined approach to neural network hyper-parameters: Part 1 -- learning rate, batch size, momentum, and weight decay trong đó xem xét lại CLR và bàn về các phương pháp hiệu quả để chọn giá trị cho những siêu tham số quan trọng khác của mạng nơ-ron. Leslie cũng xem lại một kỹ thuật của mình gọi là Super Convergence trong bài báo này. Đây là tài liệu phải đọc cho bất kỳ ai “nghĩ, ăn và ngủ” cùng mạng nơ-ron.
Phạm vi áp dụng còn hạn chế là một trong những nhược điểm đáng kể của CLR. Nó cần được làm cho thật “chắc chắn” trước khi có thể dùng ở môi trường sản xuất.
Nếu bạn muốn biết thêm về Mạng nơ-ron, bạn nên học khóa Deep Learning in Python của DataCamp, khóa học được thiết kế rất tốt và do Dan Becker (Trưởng bộ phận Kaggle Learn) giảng dạy.
Tìm hiểu thêm về Python và Học sâu
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
