Last chance! 50% off DataCamp Premium
Sale ends in
(Bu öğretici, okuyucunun sinir ağlarının temellerine aşina olduğunu varsayar)
Sinir ağı ifadesi artık Bilgisayar Bilimi camiası için, hatta genel toplum için yabancı bir kavram değil. Onu bu kadar havalı kılan şey, yalnızca çözdüğü gerçek dünya problemlerinin sayısı değil, aynı zamanda çözdüğü problem türleri. Nasıl bu kadar çeşitli olabiliyorlar?
İster Bilişsel Psikoloji alanında, ister Siber Güvenlik alanında, ister Sağlık alanında (Şimdilik Bilgisayarlı Görü, Bilgisayar Grafiği, Doğal Dil İşleme vb. konuları bir kenara bırakın.). Hadi daha az bilinenleri sayalım! Hemen her sektör, bir sinir ağının sunduğu zekâ ve otomasyondan olağanüstü derecede fayda sağlıyor.
Peki neden? İşte tekrar tekrar gelen soru bu! Bunun yanıtı hâlâ aktif araştırma konusu çünkü Sinir Ağları doğası gereği oldukça bir kara kutu ve beyinle benzerliği bu soruyu daha da karmaşıklaştırıyor. Neyse ki, bu soruyu yanıtlamak bu yazının amacı değil.
Kesin olan bir şey var! Bir sinir ağından beklenen sonuçları almak için mutlaka sağlanması gereken şey Eğitimidir. Ve artık biliyorsunuz ki, çok büyük modellerin eğitimi muazzam bir hesaplama gücü gerektiriyor. İyi GPU’lar, SSD’ler olmadan çok büyük bir sinir ağını eğitmek neredeyse imkânsız. Peki çok büyük ne kadar büyük? Eh, bir ImageNet veri kümesinde iyi sonuçlar üretecek kadar büyük; çünkü bu bir tür kıyas ölçütü.
Ancak devasa sinir ağlarını eğitme fikri tamamen devrim niteliğinde değişti; Fast.ai’dan yetenekli bir araştırmacı ekibi, Google’ın modelini geçerek yalnızca 18 dakikada yüzde 93 doğruluk elde etti ve bunun maliyeti sadece 40 $ oldu.
İlginç mi? Okumaya devam edin!
Peki bunun arkasındaki temel bileşenler neydi? En son teknoloji GPU’lar mı? En son teknoloji TPU’lar mı? En son teknoloji SSD’ler mi?
Kesinlikle hayır. Ekibin yapılandırması oldukça basitti; sonuçta maliyet yalnızca 40 $. Esas bileşen, sinir ağını eğitmek için en son algoritmaların kullanılmasıydı. Bu blog yazısında, büyük araştırmacı ve eğitmen Jeremy Howard bu büyük başarının başlıca nedenlerini tartışıyor.
Bu, pahalı donanımın gücünün güçlü algoritmalara yenildiği klasik bir örnek. Bu yazıda, bir sinir ağının mümkün olan en iyi öğrenme oranıyla eğitildiğinden emin olabilen bu tür bir tekniğin ayrıntılarını açığa çıkaracaksınız. Bu tekniğin adı Döngüsel Öğrenme Oranı (CLR). İlk olarak 2015’te Leslie N. Smith tarafından önerildi. Orijinal makaleyi buradan inceleyebilirsiniz.
Peki bırakın sadece öğrenme oranını neden ele alıyorsunuz; bırakma oranı (dropout rate) ve aktivasyon fonksiyonları gibi başka önemli hiperparametreler varken? Çünkü öğrenme oranı bunların arasında en önemlisidir. Hepsi bu!
Bu yazıda şunları inceleyeceksiniz:
Bir sinir ağını eğitmek için öğrenme oranlarının kullanılmasının temel amacını hızla yeniden gözden geçirelim.
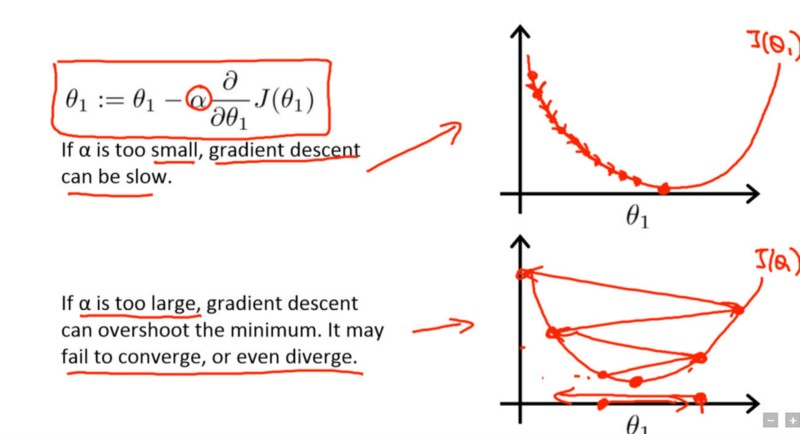
Öğrenme oranı, ağımızın ağırlıklarını kayıp gradyanına göre ne kadar ayarladığınızı kontrol eden bir hiperparametredir. Ne? Gradyanlar neden devreye giriyor? Çünkü yeni oluşturduğunuz bir sinir ağını gradyan inişi ile optimize etme yolundasınız. Gradyan inişinin temel amacı, sinir ağınızın optimize etmeye çalıştığı kayıp fonksiyonunun en küçük değerini bulmaktır. Coursera’daki Andrew Ng’nin Derin Öğrenme kursundan alınan şu görsele bakın:
Dikdörtgen içindeki terim, ağın $\theta$1 parametresini öğrenmeye başladığı güncelleme kuralıdır; burada $\alpha$ öğrenme oranıdır.
İlk eğride, en alt nokta kayıp fonksiyonunun en küçük değeridir. Diyelim ki, mevcut iterasyonda ağınız sol üstteki noktaya yakın. Artık en alt noktaya yakınsamak için kayıp fonksiyonu $J(\theta1)$’in kısmi türevlerini alır ve o en düşük noktaya ulaşmak için yönleri elde etmek üzere gradyanları hesaplarsınız.
O noktaya biraz daha hızlı varmak için, öğrenme oranı olan $\alpha$ terimini eklersiniz. Değer ne kadar düşükse, aşağı eğim boyunca o kadar yavaş ilerlersiniz. Bu, yerel minimumları kaçırmama açısından iyi bir fikir gibi görünse de (düşük öğrenme oranı kullanmak), aynı zamanda yakınsamanın uzun zaman alacağı anlamına da gelebilir — özellikle de plato bölgesine takılırsanız.
Bu, öğrenme oranlarının amaçlarına dair basit bir özetti. Şimdi sinir ağınız için iyi bir öğrenme oranı seçme tekniklerini inceleyeceksiniz.
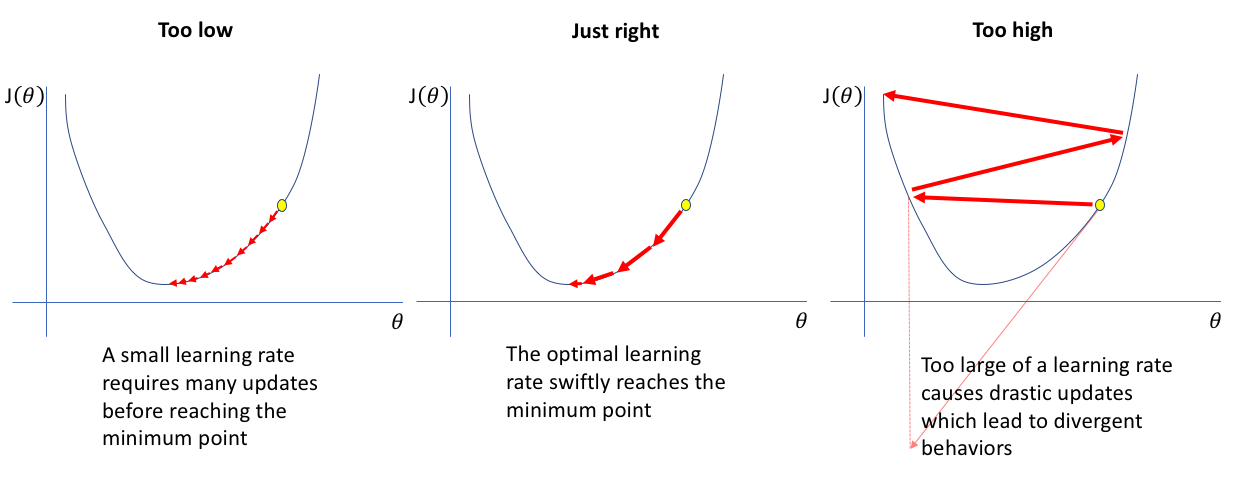
Kaynak: Jeremy Jordan’ın blogu
Bir sinir ağı için sabit bir öğrenme oranı yoktur. Üzerinde çalıştığınız problem türüne, ağa verdiğiniz veri türüne ve en önemlisi problemden probleme değişen ağın yapısına bağlıdır. Öğrenme oranını elle seçmek çok zahmetlidir; çünkü büyük bir ağı eğitiyorsanız çok ciddi maliyetlere yol açabilir. Ayrıca çok zaman alır.
Izgara Araması (Grid Search) veya Rastgele Arama (Random Search) gibi standart hiperparametre optimizasyon yöntemlerini mi çalıştırmalısınız?
CLR’dan önce, Uyarlamalı Öğrenme Oranları önerilmişti ve bunlar CLR’a bir rakip olarak görülebilir; ancak Uyarlamalı Öğrenme Oranları ile yapılan denemeler hesaplama açısından pahalıyken CLR öyle değildir.
Hâlâ en yaygın uygulama, öğrenme oranını sabit bir değere ayarlamak ve doğruluk plato yaptığında onu bir mertebe düşürmektir.
Dolayısıyla, belirli bir sinir ağı için iyi bir öğrenme oranı seçme sürecini basitleştirecek sistematik bir tekniğe açık bir ihtiyaç vardır. Sadece bu da değil; aynı zamanda bu yaklaşımın neden güvenilir olduğunu destekleyecek yeterli miktarda gerekçe olmalıdır.
Görünüşe göre Döngüsel Öğrenme Oranları (CLR) tam zamanında ortaya çıktı.
Döngüsel öğrenme oranının (CLR) hedefleri iki yönlüdür:
Bu bölümü yalnızca CLR’ın nasıl çalıştığına dair sezginizi oluşturmak için inceleyeceksiniz. Bir sonraki bölümde daha fazla ayrıntıya gireceksiniz. Önceki bölümlerde öğrenme oranlarının neden kullanıldığını kısaca anlamıştınız. Hadi tekrar hatırlayalım.
İdeal bir öğrenme oranı, ağın kaybında keskin bir azalma sağlayandır. İşte burada CLR’ın sihri devreye girer. Orijinal CLR makalesi, öğrenme oranının kayıpla ilişkisini gözlemleyebileceğiniz bir deneyden bahseder. Deney görselleştirmesi oldukça basittir: her mini-yığın sonrasında öğrenme oranını kademeli olarak artırır, her artışta kaybı kaydedersiniz. Bu kademeli artış doğrusal da olabilir üstel de. Evet, bu esasen LR Aralık Testidir.
Leslie’nin gösterdiği deneyi yaptıktan sonra, çok düşük öğrenme oranlarında kayıp azalabilir ancak çok sığ bir hızla. Optimal öğrenme oranı bölgesine girildiğinde, kayıp fonksiyonunda hızlı bir düşüş gözlemlersiniz. Öğrenme oranını daha da artırırsanız, ağda parametre kaybına neden olabilir; bu da kayıpların artmasına yol açabilir. Dolayısıyla bu deneyden, kayıp fonksiyonunda keskin bir azalma ile ilgilendiğiniz ve bunun için eğitimin farklı aşamalarında kayıp fonksiyonunun gradyanlarını analiz edebileceğiniz açıktır.
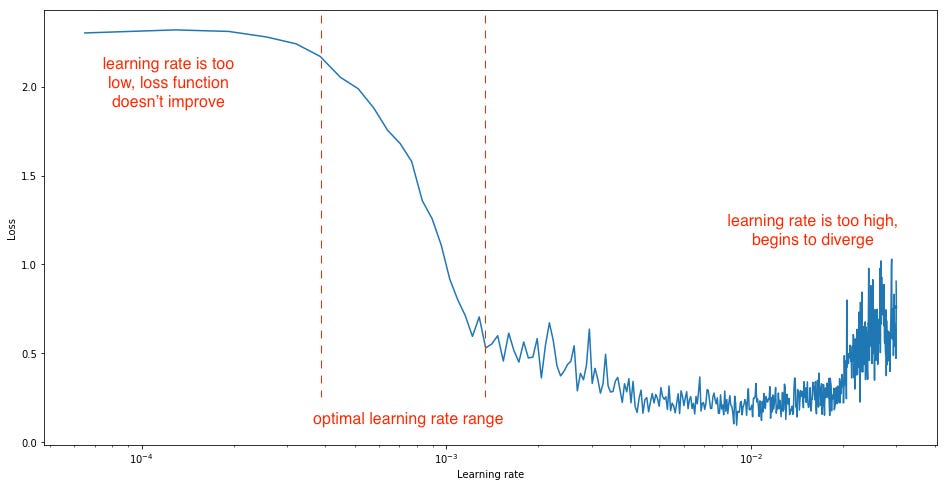
Kaynak: Jeremy Jordan’ın blogu
Yukarıdaki grafikten, kaybın pek değişmediği bir dönem, ardından keskin bir azalmanın olduğu bir dönem ve sonra kaybın tekrar yavaşça artmaya başladığı bir dönem olmak üzere üç farklı fazı kolayca görebilirsiniz.
Tüm azalmalar arasında en dik düşüşü görebiliyor musunuz? Evet, aslında o aralıkta kalmak istiyorsunuz ve CLR bunu bulmada disiplinli bir yaklaşım sunuyor. Mantığını kavradığımıza göre, daha fazlasını keşfedelim.
Yukarıdaki gözlem size dikkate alınması gereken önemli bir nokta veriyor:
CLR’nin sezgisi, öğrenme oranını doğrusal veya üstel olarak azalan bir değer benimsemek yerine, bir değer aralığı içinde değişmesine izin verme fikrinden doğar. Bunu, belirli bir öğrenme oranı aralığı belirleyip doğrusal veya üstel bir değişim yerine öğrenme oranlarını tanımlanan aralıkta döngüsel olarak değiştirerek yapabilirsiniz. Leslie, öğrenme oranını döngüsel olarak değiştirmek için aşağıdaki pencere biçimlerini ele aldı:
Ancak tüm biçimler eşdeğer sonuçlar üretti ve bu nedenle orijinal makalede, sadeliği nedeniyle fikir yalnızca üçgensel biçimle (doğrusal artış, ardından doğrusal azalış) sunuldu. Bu politika üçgensel öğrenme oranı politikası olarak da anılır. Bunu uygulamak da oldukça basittir. Aşağıda üçgensel öğrenme oranı politikasının genelleştirilmiş bir uygulaması yer alıyor:
local cycle = math.floor(1 + epochCounter / ( 2 ∗ stepsize))
local x = math.abs(epochCounter / stepsize − 2∗ cycle + 1 )
local lr = opt.LR + (maxLR − opt.LR) ∗ math.max(0 , (1−x ))
burada
Üçgensel biçimi görsel olarak düşünmek için aşağıdaki görsele bakın:

Kaynak: Öğreticinin başında belirtilen orijinal CLR makalesi.
Üçgensel öğrenme oranı politikasına ek olarak, makalede şu politikalar da sunulmuştur:
Bu noktada kendinize hızla sormuş olabileceğiniz bir soru var - Makul minimum ve maksimum sınır değerleri nasıl tahmin edilebilir? Az önce incelediğiniz LR Aralık Testini hatırlıyor musunuz? Şimdi onunla olan ilişkisini daha iyi görebilmelisiniz.
Leslie, Öğrenme Oranı aralığını belirlemek için basit ve kullanışlı bir yol önerdi:
Şimdi CLR’ın nasıl harika sonuçlar verebileceğini görmek için hızlı bir vaka çalışması yapalım.
(Bu öğreticinin sonuna doğru, CLR üzerine yakın zamanda önerilen bazı geliştirmeleri daha keşfedeceksiniz; ancak şu ana kadar CLR’ın değerini zaten anladınız.)
Bunu, muhtemelen Bilgisayarlı Görü ve Derin Öğrenmeye başlamak için en popüler veri kümesi olan klasik MNIST veri kümesini kullanarak yapacaksınız. MNIST’i çok ayrıntılı bir şekilde öğrenmek isterseniz bu blog yazısına göz atın. Deneyin tüm amaçları için yoğun biçimde keras kullanacaksınız. keras veri kümesinin yerleşik bir sürümünü sağlar. Deneye bunu içe aktararak ve bazı temel Keşifsel Veri Analizi (EDA) yaparak başlayacaksınız.
from keras.datasets import mnist
Using TensorFlow backend.
Veri kümesini başarıyla içe aktardınız. Şimdi veri kümesinin bazı temel görselleştirmelerini yapacaksınız.
import matplotlib.pyplot as plt

(X_train, y_train), (X_test, y_test) = mnist.load_data()

# Plot 4 images as gray scale
plt.subplot(152)
plt.imshow(X_train[0], cmap=plt.get_cmap('gray'))
plt.subplot(153)
plt.imshow(X_train[1], cmap=plt.get_cmap('gray'))
plt.subplot(154)
plt.imshow(X_train[2], cmap=plt.get_cmap('gray'))
plt.subplot(155)
plt.imshow(X_train[3], cmap=plt.get_cmap('gray'))
# Show the plot
plt.show()
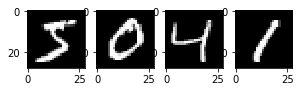
Harika! Şimdi doğrudan basit bir çok katmanlı sinir ağı kurmaya geçeceksiniz. Ancak ondan önce, bazı temel veri ön işleme adımlarını uygulayacaksınız.
# Flatten 28*28 images to a 784 vector for each image
num_pixels = X_train.shape[1] * X_train.shape[2]
X_train = X_train.reshape(X_train.shape[0], num_pixels).astype('float32')
X_test = X_test.reshape(X_test.shape[0], num_pixels).astype('float32')
Ne yaptınız?
Veri kümesindeki görüntüler 28*28 boyutunda; bu, basit bir çok katmanlı sinir ağına sığdırması zordur. Bu nedenle, reshape() fonksiyonunu kullanarak görüntüleri tek boyuta dönüştürdünüz; her görüntü 784 piksel verisi içeriyor.
Görüntülerdeki piksel değerleri 0 - 255 aralığında. Bu aralığı 0 - 1’e normalleştirerek daha da küçültmek iyi bir fikir olacaktır.
X_train = X_train / 255
X_test = X_test / 255
Çıktı değişkeni 0 ile 9 arasında bir tam sayıdır. Bu bir çok sınıflı sınıflandırma problemidir. Sınıf etiketlerine tek-sıcak kodlama (one-hot encoding) uygulayarak sınıf tamsayılarından oluşan bir vektörü ikili bir matrise dönüştüreceksiniz. Bunu, kategoriyi “ikilemek” ve sinir ağını eğitmek için bir özellik olarak dahil edebilmek amacıyla yapacaksınız.
Bunu keras’ta yerleşik np_utils.to_categorical() yardımcı işleviyle kolayca yapabilirsiniz.
from keras.utils import np_utils

y_train = np_utils.to_categorical(y_train)
y_test = np_utils.to_categorical(y_test)
num_classes = y_test.shape[1]
Şimdi ağınızın yapısını tanımlayacaksınız. Bu amaçla basit bir tam bağlantılı ağ kullanacaksınız. keras’ta bu tipik olarak üç adımlı bir süreçtir:
import numpy as np
from keras.models import Sequential
from keras.layers import Dense

# Create model
model = Sequential()
model.add(Dense(num_pixels, input_dim=num_pixels, kernel_initializer='normal', activation='relu'))
model.add(Dense(num_classes, kernel_initializer='normal', activation='softmax'))

# Compile model
model.compile(loss='categorical_crossentropy', optimizer='adam', metrics=['accuracy'])
Yukarıdaki kodda neler yaptığınıza bakalım. Ağı katmanların doğrusal bir yığını olan sıralı şekilde kuruyorsunuz. Ardından ağa katman eklemeye başladınız; ilk katmanda nöron sayısını (bir görüntüdeki piksel sayısına eşit, yani 784) eklediniz ve görüntülerin giriş boyutunu belirttiniz; bu örnekte piksel sayısıyla aynıdır. Ağınızın ağırlıklarının bir normal dağılımdan başlatılmasını söylediniz. Son olarak ilk katman için aktivasyon fonksiyonu olarak relu verdiniz.
Son katmanda nöron sayısını 10’da tuttunuz (sınıf etiketlerinin sayısı) ve çıktıları olasılık benzeri değerlere dönüştürmek ve 10 sınıftan birini modelin çıktı tahmini olarak seçmek için aktivasyonu softmax olarak belirlediniz.
Modeli derlediniz; böylece modelin optimizasyon yöntemini (bu durumda ADAM) ve bu yöntemin optimize edeceği kayıp türünü (bu durumda categorical_loss) belirlediniz.
Şimdi modeli eğitecek ve eğitilmesinin ne kadar sürdüğünü kaydedeceksiniz. Performansını da test edeceksiniz.
import timeit

# For fixing the reproducibility
from numpy.random import seed
seed(1)

# Fit the model
startTime = timeit.default_timer()
model.fit(X_train, y_train, validation_data=(X_test, y_test), epochs=10, batch_size=200, verbose=2)
elapsedTime = timeit.default_timer() - startTime
print("Time taken for the Network to train : ",elapsedTime)

# Final evaluation of the model
scores = model.evaluate(X_test, y_test, verbose=0)
print("Baseline Error: %.2f%%" % (100-scores[1]*100))
Train on 60000 samples, validate on 10000 samples
Epoch 1/10
 - 10s - loss: 0.2774 - acc: 0.9207 - val_loss: 0.1362 - val_acc: 0.9610
Epoch 2/10
 - 8s - loss: 0.1113 - acc: 0.9675 - val_loss: 0.0951 - val_acc: 0.9720
Epoch 3/10
 - 8s - loss: 0.0712 - acc: 0.9793 - val_loss: 0.0802 - val_acc: 0.9750
Epoch 4/10
 - 8s - loss: 0.0503 - acc: 0.9857 - val_loss: 0.0687 - val_acc: 0.9788
Epoch 5/10
 - 8s - loss: 0.0360 - acc: 0.9897 - val_loss: 0.0632 - val_acc: 0.9797
Epoch 6/10
 - 8s - loss: 0.0267 - acc: 0.9928 - val_loss: 0.0643 - val_acc: 0.9784
Epoch 7/10
 - 8s - loss: 0.0201 - acc: 0.9951 - val_loss: 0.0633 - val_acc: 0.9802
Epoch 8/10
 - 8s - loss: 0.0150 - acc: 0.9962 - val_loss: 0.0613 - val_acc: 0.9808
Epoch 9/10
 - 8s - loss: 0.0108 - acc: 0.9978 - val_loss: 0.0625 - val_acc: 0.9806
Epoch 10/10
 - 8s - loss: 0.0076 - acc: 0.9988 - val_loss: 0.0612 - val_acc: 0.9809
Time taken for the Network to train :  86.4216202873591
Baseline Error: 1.91%
Bu basit model, yaklaşık 87 saniyede yalnızca %1,91 hata oranına ulaşarak oldukça iyi iş çıkardı. Şimdi CLR’ın gücünü göreceksiniz. keras için CLR uygulamasını GitHub’dan klonlayarak başlayacaksınız.
Başarılı bir klonlamadan sonra, yerel çalışma dizininizde aşağıdaki dosyalar olmalıdır.

CLR politikası burada bir keras geri çağırımı olarak uygulanmıştır.
from keras.callbacks import *
from clr_callback import *
from keras.optimizers import Adam

# You are using the triangular learning rate policy and
#  base_lr (initial learning rate which is the lower boundary in the cycle) is 0.1
clr_triangular = CyclicLR(mode='triangular')
model.compile(optimizer=Adam(0.1), loss='categorical_crossentropy', metrics=['accuracy'])
Bu clr_triangular nesnesini ağı eğitirken callbacks parametresine geçeceksiniz. Bu kez daha büyük bir batch_size kullanacaksınız. Süreyi de kaydedeceksiniz.
startTime = timeit.default_timer()
model.fit(X_train, y_train, validation_data=(X_test, y_test), epochs=10, batch_size=2000,callbacks=[clr_triangular], verbose=2)
elapsedTime = timeit.default_timer() - startTime
print("Time taken for the Network to train : ",elapsedTime)

# Final evaluation of the model
scores = model.evaluate(X_test, y_test, verbose=0)
print("Baseline Error: %.2f%%" % (100-scores[1]*100))
Train on 60000 samples, validate on 10000 samples
Epoch 1/10
 - 4s - loss: 0.0046 - acc: 0.9996 - val_loss: 0.0571 - val_acc: 0.9831
Epoch 2/10
 - 4s - loss: 0.0030 - acc: 0.9998 - val_loss: 0.0575 - val_acc: 0.9829
Epoch 3/10
 - 4s - loss: 0.0023 - acc: 0.9999 - val_loss: 0.0594 - val_acc: 0.9827
Epoch 4/10
 - 4s - loss: 0.0018 - acc: 0.9999 - val_loss: 0.0589 - val_acc: 0.9835
Epoch 5/10
 - 4s - loss: 0.0014 - acc: 1.0000 - val_loss: 0.0595 - val_acc: 0.9831
Epoch 6/10
 - 4s - loss: 0.0011 - acc: 1.0000 - val_loss: 0.0600 - val_acc: 0.9836
Epoch 7/10
 - 4s - loss: 0.0010 - acc: 1.0000 - val_loss: 0.0612 - val_acc: 0.9832
Epoch 8/10
 - 4s - loss: 8.2190e-04 - acc: 1.0000 - val_loss: 0.0621 - val_acc: 0.9829
Epoch 9/10
 - 4s - loss: 6.6182e-04 - acc: 1.0000 - val_loss: 0.0624 - val_acc: 0.9836
Epoch 10/10
 - 4s - loss: 5.7177e-04 - acc: 1.0000 - val_loss: 0.0635 - val_acc: 0.9836
Time taken for the Network to train :  43.23223609056981
Baseline Error: 1.64%
Avantajı görebiliyor musunuz? Bu gerçekten etkileyici! Modeliniz yalnızca 44 saniyede eğitildi ve önceki modelden bile daha iyi bir hata oranı verdi. Çok iyi!
Sonuna geldiniz. Bu öğreticide, uygun bir öğrenme oranı bulma gibi çok kritik bir problemi ve CLR’ın bu probleme yaklaşımınızı nasıl tamamen değiştirdiğini incelediniz. CLR’ı hatırı sayılır ayrıntılarla ele aldınız ve CLR’ın daha kısa sürede nasıl mükemmel sonuçlar üretebileceğini görmek için küçük deneyler yaptınız.
Şimdi sırada ne var? CLR’dan çıkan iki yan ürün şunlardır:
Bu konu hakkında daha fazla içgörü edinmek için yukarıdaki iki yaklaşımı inceleyin. Ayrıca, CLR’dan sonra Leslie, Sinir ağı hiperparametrelerine disiplinli bir yaklaşım: Bölüm 1 -- öğrenme oranı, yığın boyutu, momentum ve ağırlık çürümesi başlıklı bir makale yayımladı; bu makale CLR’ı yeniden ele alır ve bir sinir ağının diğer önemli hiperparametreleri için değer seçmenin verimli yöntemlerini tartışır. Leslie bu makalede Süper Yakınsama olarak adlandırdığı tekniklerinden birini de yeniden ele aldı. Sinir ağlarını düşünen, yiyen ve onlarla yaşayan herkes için bu makale mutlaka okunmalıdır.
CLR’ın önemli eksikliklerinden biri sınırlı uygulanabilirliğidir. Üretim seviyelerinde kullanılmadan önce tam anlamıyla sağlam hâle getirilmesi gerekir.
Sinir Ağları hakkında daha fazla bilgi edinmekle ilgileniyorsanız, DataCamp’in Dan Becker (Kaggle Learn Başkanı) tarafından verilen ve çok iyi tasarlanmış Python ile Derin Öğrenme kursunu almalısınız.
Python ve Derin Öğrenme hakkında daha fazlasını öğrenin
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.