Last chance! 50% off DataCamp Premium
Sale ends in
(Questo tutorial presuppone che tu conosca le basi delle reti neurali)
Rete neurale non è più un'espressione insolita per la comunità dell'Informatica o, diciamo, per la società in generale. Il motivo principale che la rende così interessante non è solo la quantità di problemi reali che risolve, ma anche il tipo di problemi che affronta. Come possono essere così vari?
Sia nel campo della Psicologia cognitiva, sia nel dominio della Cybersecurity, sia nell'ambito dell'Healthcare (per il momento, non stiamo considerando Computer Vision, Computer Graphics, Natural Language Processing, ecc.). Citiamo i casi meno comuni! Praticamente ogni settore sta traendo enormi benefici dall'intelligenza e dall'automazione che una rete neurale può offrire.
Ma perché? È la domanda che torna di continuo! Be', la risposta è ancora oggetto di ricerca attiva perché le reti neurali sono in buona parte una scatola nera e la loro somiglianza con il cervello rende la questione ancora più complicata. In ogni caso, rispondere a questa domanda non è l'obiettivo di questo post.
Una cosa è certa! Per ottenere i risultati attesi da una rete neurale, l'unica cosa da garantire è il suo training. E ormai avrai già scoperto che addestrare reti molto grandi richiede un'enorme potenza di calcolo. Senza buone GPU e SSD è quasi impossibile addestrare una rete neurale molto grande. Ma quanto è molto grande? Be', abbastanza grande da produrre buoni risultati su un dataset ImageNet, perché quello è una sorta di benchmark.
Ma l'idea stessa di addestrare reti neurali gigantesche è stata rivoluzionata quando un team di ricercatori di talento di Fast.ai è riuscito a battere il modello di Google raggiungendo un'accuratezza del 93% in soli 18 minuti, spendendo appena 40$.
Sembra interessante? Continua a leggere!
Ma quali sono stati gli ingredienti chiave che l'hanno reso possibile? GPU all'avanguardia? TPU all'avanguardia? SSD all'avanguardia?
Assolutamente no. La configurazione del team era piuttosto semplice, dato che il costo è stato di soli $40. L'ingrediente chiave è stato l'uso di algoritmi all'avanguardia per addestrare la rete neurale. In questo blog, il grande ricercatore e divulgatore Jeremy Howard ha discusso i motivi principali di questa grande vittoria.
Questo è un classico esempio in cui la potenza di un hardware costoso viene surclassata dalla potenza di algoritmi potenti. In questo post scoprirai i dettagli di una di queste tecniche che può garantire che una rete neurale sia addestrata con il miglior learning rate possibile. Questa tecnica è nota come Cyclical Learning Rate (CLR). È stata proposta già nel 2015 da Leslie N. Smith. Puoi consultare l'articolo originale qui.
Ma perché parlare solo di learning rate quando ci sono altri iperparametri essenziali come dropout rate e funzioni di attivazione? Perché il learning rate è il più importante tra tutti. Punto!
In questo post studierai:
Ripassiamo rapidamente lo scopo principale dell'uso dei learning rate per addestrare una rete neurale.
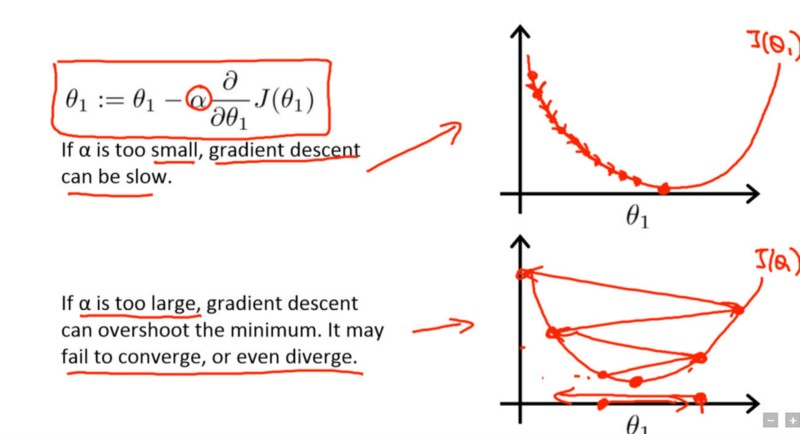
Il learning rate è un iperparametro che controlla di quanto si aggiornano i pesi della rete rispetto al gradiente della loss. Come? Perché entrano in gioco i gradienti? Perché stai ottimizzando una rete neurale che hai appena creato con il gradient descent. L'obiettivo del gradient descent è trovare il minimo della funzione di loss che la tua rete neurale sta cercando di ottimizzare. Dai un'occhiata alla seguente immagine [tratta dal corso di Deep Learning di Andrew Ng su Coursera]:
Il termine nel riquadro è la regola di aggiornamento con cui la rete inizia a imparare il suo parametro $\theta$1, dove $\alpha$ è il learning rate.
Nella prima curva, il punto più basso è il minimo della funzione di loss. Supponi che, nell'iterazione corrente, la tua rete sia vicina al punto più in alto a sinistra. Ora, per convergere verso il punto più basso, prendi le derivate parziali della funzione di loss $J(\theta1)$ e calcoli i gradienti per ottenere le direzioni che ti portano a quel punto.
Per arrivare un po' più velocemente a quel punto, aggiungi un altro termine $\alpha$ che è il learning rate. Più basso è il valore, più lentamente scendi lungo la pendenza. Sebbene usare un learning rate basso possa essere una buona idea per non perdere eventuali minimi locali, può anche significare che impiegherai molto tempo a convergere, soprattutto se rimani bloccato su un altopiano.
Questo era un rapido riepilogo degli obiettivi dei learning rate in parole semplici. Ora studierai le tecniche per scegliere un buon learning rate per la tua rete neurale.
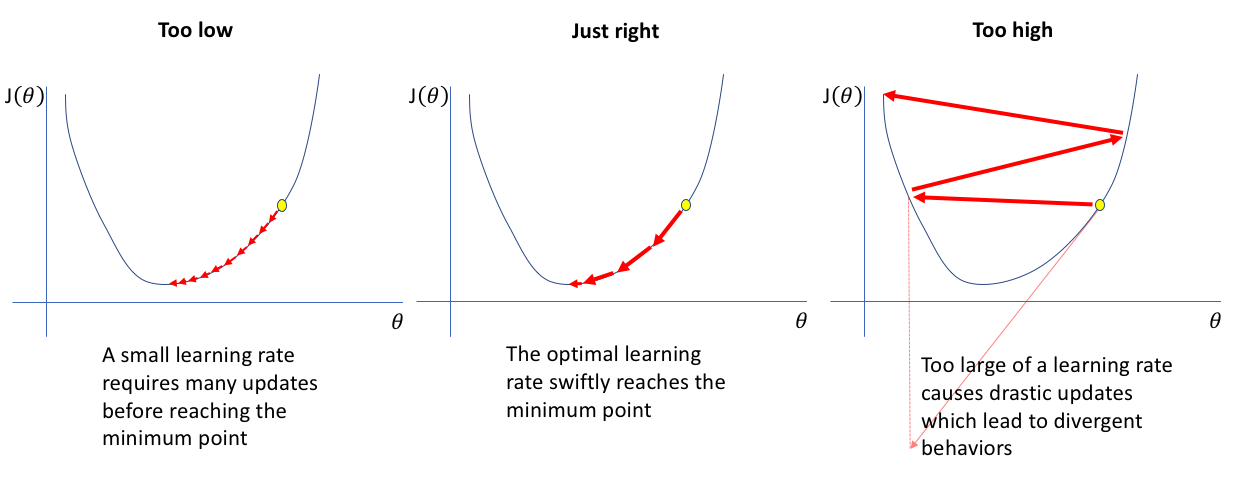
Non esiste un learning rate fisso per una rete neurale. Dipende dal tipo di problema su cui lavori, dal tipo di dati che fornisci alla rete e, soprattutto, dalla struttura della rete, che varia da problema a problema. Scegliere a mano un learning rate è un compito molto oneroso perché, se stai addestrando una rete grande, puoi incorrere in costi enormi. E richiede anche molto tempo.
Dovresti eseguire metodi standard di ottimizzazione degli iperparametri come Grid Search o Random Search?
Prima di CLR, erano stati proposti i Learning Rate adattivi, che si possono considerare concorrenti di CLR, ma gli esperimenti con i Learning Rate adattivi sono computazionalmente costosi, mentre CLR non lo è.
Ancora oggi, la pratica più comune è impostare il learning rate a un valore costante e ridurlo di un ordine di grandezza una volta che l'accuratezza si è stabilizzata su un plateau.
Pertanto, c'è un chiaro bisogno di una tecnica sistematica che semplifichi il processo di scelta di un buon learning rate per una determinata rete neurale. Non solo: devono esserci anche sufficienti motivazioni a supporto dell'approccio per renderlo affidabile.
Sembra che i Cyclical Learning Rates (CLR) siano arrivati al momento giusto.
Gli obiettivi del cyclical learning rate (CLR) sono due:
Studierai questa sezione per costruirti l'intuizione su come funziona CLR. Nella sezione successiva entrerai più nel dettaglio. Nelle sezioni precedenti hai capito brevemente perché si usano i learning rate. Ricordiamolo ancora una volta.
Un learning rate ideale è quello che produce una diminuzione ripida della loss della rete. Qui entra in gioco la “magia” di CLR. L'articolo originale su CLR parla di un esperimento in cui puoi osservare il comportamento del learning rate rispetto alla loss. L'esperimento è molto semplice da visualizzare: aumenti gradualmente il learning rate dopo ogni mini-batch, registrando la loss a ogni incremento. Questo aumento graduale può essere lineare oppure esponenziale. E sì, questo è essenzialmente l'LR Range Test.
Dopo aver eseguito l'esperimento mostrato da Leslie, per learning rate troppo bassi la loss può diminuire ma a un ritmo molto blando. Entrando nella zona del learning rate ottimale, osserverai un calo rapido della funzione di loss. Se aumenti ulteriormente il learning rate, può causare perdita di parametri nella rete, il che a sua volta può portare a un aumento delle perdite. Quindi, da questo esperimento è chiaro che ti interessa una diminuzione ripida della funzione di loss e, per ottenerla, puoi analizzare i gradienti della funzione di loss nelle diverse fasi dell'addestramento.
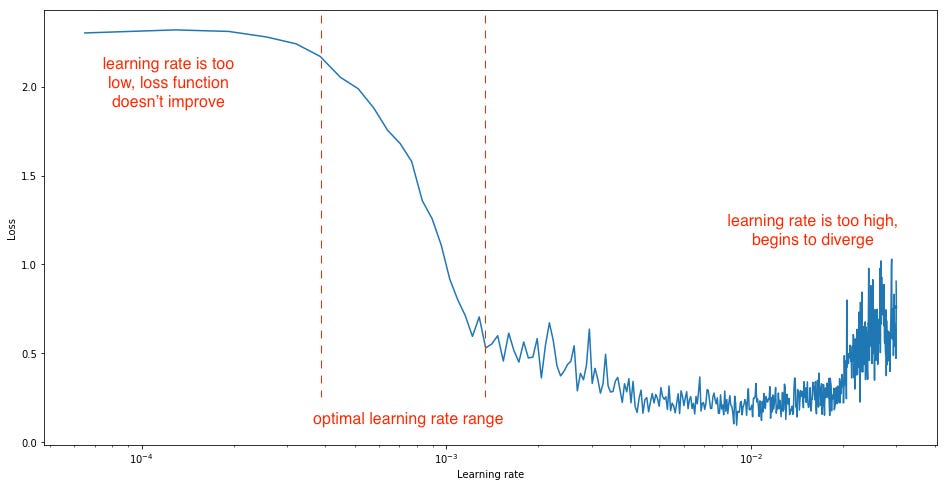
Quindi, dal grafico sopra, puoi facilmente individuare tre fasi diverse: prima la loss non cambia molto, poi arriva un momento in cui si verifica una diminuzione ripida e infine la loss ricomincia ad aumentare lentamente.
Riesci a vedere la diminuzione più ripida tra tutte? Sì, essenzialmente vuoi finire in quell'intervallo, e CLR ti darà un approccio disciplinato per trovarlo. Presa confidenza con l'idea, scopriamo di più.
L'osservazione di cui sopra ti fornisce un punto importante da considerare:
L'intuizione di CLR nasce dall'idea di lasciare che il learning rate vari all'interno di un intervallo di valori, invece di adottare un valore decrescente linearmente o esponenzialmente. Puoi farlo impostando un intervallo definito di learning rate e poi, invece di una variazione lineare o esponenziale, vari ciclicamente i learning rate all'interno dell'intervallo definito. Leslie ha considerato le seguenti forme di funzione per variare ciclicamente il learning rate:
Ma tutte le forme hanno prodotto risultati equivalenti e, nell'articolo originale, l'idea è presentata solo con una forma triangolare (aumento lineare seguito da diminuzione lineare) per via della sua semplicità. Questa policy è chiamata anche triangular learning rate policy. Implementarla è altrettanto semplice. Di seguito una implementazione generalizzata della triangular learning rate policy:
local cycle = math.floor(1 + epochCounter / ( 2 ∗ stepsize))
local x = math.abs(epochCounter / stepsize − 2∗ cycle + 1 )
local lr = opt.LR + (maxLR − opt.LR) ∗ math.max(0 , (1−x ))
dove
Riferisciti all'immagine seguente per visualizzare la forma triangolare:

Fonte: l'articolo originale su CLR citato all'inizio del tutorial.
Oltre alla triangular learning rate policy, nell'articolo sono state presentate anche le seguenti policy:
Una domanda che potresti esserti posto a questo punto è: Come stimare valori ragionevoli per i limiti minimo e massimo? Ricordi l'LR Range Test che hai studiato poco fa? Ora dovresti coglierne meglio la rilevanza.
Leslie ha proposto un modo semplice e pratico per decidere l'intervallo del Learning Rate:
Facciamo ora un rapido caso di studio per vedere come CLR possa dare risultati notevoli.
(Alla fine di questo tutorial, scoprirai alcuni ulteriori avanzamenti rispetto a CLR proposti di recente, ma a questo punto avrai già capito il valore di CLR.)
Lo faremo usando il classico dataset MNIST, probabilmente il più popolare per iniziare con Computer Vision e Deep Learning. Dai un'occhiata a questo blog se vuoi imparare MNIST in modo molto dettagliato. Userai keras estensivamente per tutte le finalità dell'esperimento. keras fornisce una versione integrata del dataset. Inizierai l'esperimento importandolo ed eseguendo un po' di EDA di base.
from keras.datasets import mnist
Using TensorFlow backend.
Hai importato correttamente il dataset. Ora farai alcune visualizzazioni di base del dataset.
import matplotlib.pyplot as plt

(X_train, y_train), (X_test, y_test) = mnist.load_data()

# Plot 4 images as gray scale
plt.subplot(152)
plt.imshow(X_train[0], cmap=plt.get_cmap('gray'))
plt.subplot(153)
plt.imshow(X_train[1], cmap=plt.get_cmap('gray'))
plt.subplot(154)
plt.imshow(X_train[2], cmap=plt.get_cmap('gray'))
plt.subplot(155)
plt.imshow(X_train[3], cmap=plt.get_cmap('gray'))
# Show the plot
plt.show()
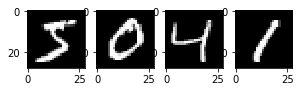
Ottimo! Passerai direttamente a costruire una semplice rete neurale multistrato. Ma prima farai un po' di preprocessing dei dati.
# Flatten 28*28 images to a 784 vector for each image
num_pixels = X_train.shape[1] * X_train.shape[2]
X_train = X_train.reshape(X_train.shape[0], num_pixels).astype('float32')
X_test = X_test.reshape(X_test.shape[0], num_pixels).astype('float32')
Cosa hai fatto?
Le immagini nel dataset hanno dimensioni 28×28, che è difficile da gestire in una semplice rete multistrato. Per questo le hai convertite in una singola dimensione in cui ogni immagine contiene 784 pixel usando la funzione reshape().
I valori dei pixel nelle immagini sono nell'intervallo 0 - 255. Un'idea utile è ridurli ulteriormente normalizzando l'intervallo a 0 - 1.
X_train = X_train / 255
X_test = X_test / 255
La variabile di output è un intero da 0 a 9. È un problema di classificazione multiclasse. Eseguirai il one-hot encoding delle etichette di classe per ottenere un vettore di interi di classe in una matrice binaria. Lo farai per una “binarizzazione” della categoria e per poterla includere come feature per addestrare la rete neurale.
Puoi farlo facilmente usando la funzione helper integrata np_utils.to_categorical() in keras.
from keras.utils import np_utils

y_train = np_utils.to_categorical(y_train)
y_test = np_utils.to_categorical(y_test)
num_classes = y_test.shape[1]
Ora definirai la struttura della tua rete. Userai una semplice rete fully-connected per questo scopo. In keras è tipicamente un processo in tre passi:
import numpy as np
from keras.models import Sequential
from keras.layers import Dense

# Create model
model = Sequential()
model.add(Dense(num_pixels, input_dim=num_pixels, kernel_initializer='normal', activation='relu'))
model.add(Dense(num_classes, kernel_initializer='normal', activation='softmax'))

# Compile model
model.compile(loss='categorical_crossentropy', optimizer='adam', metrics=['accuracy'])
Vediamo cosa hai fatto nel codice sopra. Stai costruendo la rete in modo sequenziale (cioè uno stack lineare di layer). Poi hai iniziato ad aggiungere i layer: nel primo layer hai aggiunto i neuroni (uguali al numero di pixel in un'immagine, cioè 784) e hai specificato la dimensione di input delle immagini, che in questo caso coincide con il numero di pixel. Hai istruito la rete a inizializzarsi con pesi da una distribuzione normale. Infine, hai fornito relu come funzione di attivazione per il primo layer.
Nell'ultimo layer, hai mantenuto il numero di neuroni a 10 (che è il numero di etichette di classe) e hai impostato l'attivazione a softmax per trasformare le uscite in valori simili a probabilità e consentire la selezione di una classe su 10 come previsione del modello.
Hai compilato il modello per decidere il metodo di ottimizzazione (in questo caso ADAM) e il tipo di loss che questo metodo ottimizzerà (in questo caso categorical_loss).
Ora addestrerai il modello e registrerai il tempo impiegato per l'addestramento. Testerai anche le sue prestazioni.
import timeit

# For fixing the reproducibility
from numpy.random import seed
seed(1)

# Fit the model
startTime = timeit.default_timer()
model.fit(X_train, y_train, validation_data=(X_test, y_test), epochs=10, batch_size=200, verbose=2)
elapsedTime = timeit.default_timer() - startTime
print("Time taken for the Network to train : ",elapsedTime)

# Final evaluation of the model
scores = model.evaluate(X_test, y_test, verbose=0)
print("Baseline Error: %.2f%%" % (100-scores[1]*100))
Train on 60000 samples, validate on 10000 samples
Epoch 1/10
 - 10s - loss: 0.2774 - acc: 0.9207 - val_loss: 0.1362 - val_acc: 0.9610
Epoch 2/10
 - 8s - loss: 0.1113 - acc: 0.9675 - val_loss: 0.0951 - val_acc: 0.9720
Epoch 3/10
 - 8s - loss: 0.0712 - acc: 0.9793 - val_loss: 0.0802 - val_acc: 0.9750
Epoch 4/10
 - 8s - loss: 0.0503 - acc: 0.9857 - val_loss: 0.0687 - val_acc: 0.9788
Epoch 5/10
 - 8s - loss: 0.0360 - acc: 0.9897 - val_loss: 0.0632 - val_acc: 0.9797
Epoch 6/10
 - 8s - loss: 0.0267 - acc: 0.9928 - val_loss: 0.0643 - val_acc: 0.9784
Epoch 7/10
 - 8s - loss: 0.0201 - acc: 0.9951 - val_loss: 0.0633 - val_acc: 0.9802
Epoch 8/10
 - 8s - loss: 0.0150 - acc: 0.9962 - val_loss: 0.0613 - val_acc: 0.9808
Epoch 9/10
 - 8s - loss: 0.0108 - acc: 0.9978 - val_loss: 0.0625 - val_acc: 0.9806
Epoch 10/10
 - 8s - loss: 0.0076 - acc: 0.9988 - val_loss: 0.0612 - val_acc: 0.9809
Time taken for the Network to train :  86.4216202873591
Baseline Error: 1.91%
Questo semplice modello si è comportato piuttosto bene, ottenendo un tasso di errore dell'1,91% in circa 87 secondi. Ora vedrai la potenza di CLR. Inizierai clonando la implementazione di keras di CLR da Github.
Dopo un clone riuscito, dovresti avere i seguenti file nella tua directory di lavoro locale.

La policy CLR è implementata qui come un keras callback.
from keras.callbacks import *
from clr_callback import *
from keras.optimizers import Adam

# You are using the triangular learning rate policy and
#  base_lr (initial learning rate which is the lower boundary in the cycle) is 0.1
clr_triangular = CyclicLR(mode='triangular')
model.compile(optimizer=Adam(0.1), loss='categorical_crossentropy', metrics=['accuracy'])
Passerai questo clr_triangular nel parametro callbacks durante il fit della rete. Userai questa volta un batch_size più grande. Registrerai anche il tempo.
startTime = timeit.default_timer()
model.fit(X_train, y_train, validation_data=(X_test, y_test), epochs=10, batch_size=2000,callbacks=[clr_triangular], verbose=2)
elapsedTime = timeit.default_timer() - startTime
print("Time taken for the Network to train : ",elapsedTime)

# Final evaluation of the model
scores = model.evaluate(X_test, y_test, verbose=0)
print("Baseline Error: %.2f%%" % (100-scores[1]*100))
Train on 60000 samples, validate on 10000 samples
Epoch 1/10
 - 4s - loss: 0.0046 - acc: 0.9996 - val_loss: 0.0571 - val_acc: 0.9831
Epoch 2/10
 - 4s - loss: 0.0030 - acc: 0.9998 - val_loss: 0.0575 - val_acc: 0.9829
Epoch 3/10
 - 4s - loss: 0.0023 - acc: 0.9999 - val_loss: 0.0594 - val_acc: 0.9827
Epoch 4/10
 - 4s - loss: 0.0018 - acc: 0.9999 - val_loss: 0.0589 - val_acc: 0.9835
Epoch 5/10
 - 4s - loss: 0.0014 - acc: 1.0000 - val_loss: 0.0595 - val_acc: 0.9831
Epoch 6/10
 - 4s - loss: 0.0011 - acc: 1.0000 - val_loss: 0.0600 - val_acc: 0.9836
Epoch 7/10
 - 4s - loss: 0.0010 - acc: 1.0000 - val_loss: 0.0612 - val_acc: 0.9832
Epoch 8/10
 - 4s - loss: 8.2190e-04 - acc: 1.0000 - val_loss: 0.0621 - val_acc: 0.9829
Epoch 9/10
 - 4s - loss: 6.6182e-04 - acc: 1.0000 - val_loss: 0.0624 - val_acc: 0.9836
Epoch 10/10
 - 4s - loss: 5.7177e-04 - acc: 1.0000 - val_loss: 0.0635 - val_acc: 0.9836
Time taken for the Network to train :  43.23223609056981
Baseline Error: 1.64%
Noti il vantaggio? È qualcosa di sorprendente! Il tuo modello ha impiegato solo 44 secondi per addestrarsi e ha ottenuto un tasso di errore persino migliore del precedente. Molto bene!
Sei arrivato alla fine. In questo tutorial hai studiato un problema cruciale: trovare un learning rate adatto, e come CLR abbia cambiato completamente il modo in cui eri solito affrontare questo problema. Hai studiato CLR coprendo una buona quantità di dettagli e hai fatto piccoli esperimenti per vedere come CLR possa produrre ottimi risultati in meno tempo.
E adesso? I due sottoprodotti nati da CLR sono:
Studia i due approcci qui sopra per ottenere ulteriori insight sull'argomento. Inoltre, dopo CLR Leslie ha pubblicato un articolo intitolato A disciplined approach to neural network hyper-parameters: Part 1 -- learning rate, batch size, momentum, and weight decay che riprende CLR e discute metodi efficienti per scegliere i valori di altri importanti iperparametri di una rete neurale. In questo articolo Leslie ha anche ripreso una sua tecnica chiamata Super Convergence. È una lettura imprescindibile per chiunque pensi, mangi e dorma reti neurali.
Una delle principali limitazioni di CLR è la scarsa applicabilità generale. Deve essere reso a prova di bomba prima di poterlo usare in produzione.
Se ti interessa saperne di più sulle reti neurali, dovresti seguire il corso di DataCamp Deep Learning in Python, molto ben progettato e tenuto da Dan Becker (Head of Kaggle Learn).
Approfondisci Python e il Deep Learning
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min