Kurs
Einführung in Deep Learning mit Python
4 Std.
264.6K
(Dieses Tutorial setzt voraus, dass du mit den Grundlagen neuronaler Netze vertraut bist.)
„Neurales Netzwerk“ ist längst kein Fremdwort mehr – weder in der Informatik noch allgemein. Faszinierend ist nicht nur, wie viele reale Probleme damit gelöst werden, sondern vor allem, welche Arten von Problemen es bewältigt. Wie kann das so vielfältig sein?
Egal ob in der Kognitionspsychologie, in der IT-Sicherheit oder im Gesundheitswesen (Computer Vision, Computer Graphics, Natural Language Processing usw. lassen wir hier kurz außen vor). Nennen wir ruhig die weniger offensichtlichen Bereiche: Praktisch jede Branche profitiert enorm von der Intelligenz und Automatisierung, die neuronale Netze ermöglichen.
Aber warum ist das so? Diese Frage taucht immer wieder auf. Die Antwort ist weiterhin Gegenstand aktiver Forschung, denn neuronale Netze sind in ihrer Natur eine Art Black Box – und die Ähnlichkeit zum menschlichen Gehirn macht die Frage nicht leichter. Doch diese Frage zu klären, ist nicht das Ziel dieses Beitrags.
Eines ist sicher: Damit ein neuronales Netz die erwarteten Ergebnisse liefert, muss das Training stimmen. Und wahrscheinlich hast du schon festgestellt: Sehr großes Training erfordert enorme Rechenleistung. Ohne gute GPUs und SSDs ist es fast unmöglich, ein sehr großes Netz zu trainieren. Wie groß ist „sehr groß“? Groß genug, um auf dem ImageNet-Datensatz gute Ergebnisse zu liefern – das gilt als Benchmark.
Diese Vorstellung vom Training riesiger Netze wurde auf den Kopf gestellt, als ein Team von Fast.ai Googles Modell übertraf: 93% Genauigkeit in nur 18 Minuten – für lediglich 40 US-Dollar.
Klingt spannend? Lies weiter!
Was waren die entscheidenden Zutaten? State-of-the-Art-GPUs? Modernste TPUs? High-End-SSDs?
Ganz und gar nicht. Die Hardware war schlicht – bei 40 US-Dollar Kosten kaum anders zu erwarten. Der Schlüssel waren modernste Trainingsalgorithmen. In diesem Blogpost erklärt Jeremy Howard die Hauptgründe für diesen Erfolg.
Ein klassisches Beispiel, wie starke Algorithmen teure Hardware ausstechen. In diesem Beitrag schauen wir uns eine Methode an, die sicherstellt, dass ein Netz mit einer optimalen Lernrate trainiert wird: die Cyclical Learning Rate (CLR). Vorgeschlagen wurde sie bereits 2015 von Leslie N. Smith. Das Originalpapier findest du hier.
Warum fokussieren wir uns nur auf die Lernrate, wo es doch andere wichtige Hyperparameter wie Dropout-Rate und Aktivierungsfunktionen gibt? Weil die Lernrate der wichtigste davon ist. Punkt.
In diesem Beitrag lernst du:
Kurzer Rückblick auf den Zweck von Lernraten beim Training neuronaler Netze.
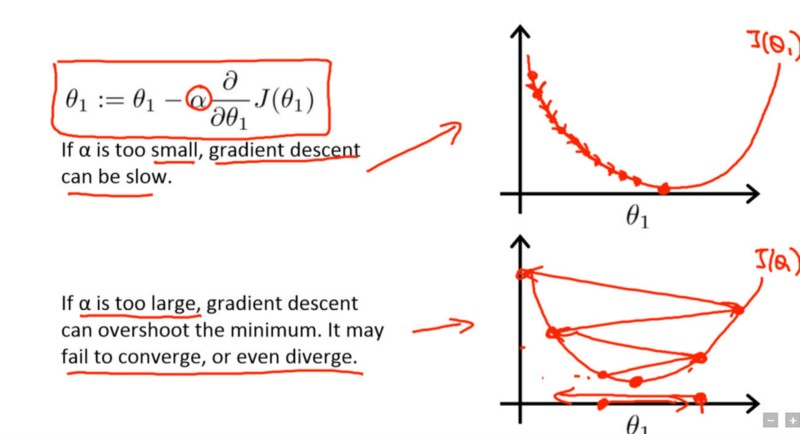
Die Lernrate ist ein Hyperparameter, der steuert, wie stark du die Gewichte deines Netzes entlang des Verlustgradienten anpasst. Wie kommen hier Gradienten ins Spiel? Du willst das von dir erstellte Netz mithilfe von Gradient Descent optimieren. Ziel von Gradient Descent ist es, das Minimum der Verlustfunktion zu finden, die dein Netz minimieren soll. Sieh dir dazu folgendes Bild an [aus Andrew Ngs Deep-Learning-Kurs auf Coursera]:
Die markierte Formel ist die Aktualisierungsregel, mit der das Netz beginnt, seinen Parameter $\theta$1 zu lernen; $\alpha$ ist die Lernrate.
Im ersten Kurvenbild ist der tiefste Punkt das Minimum der Verlustfunktion. Angenommen, dein Netz befindet sich aktuell nahe des linken oberen Punktes. Um zum Minimum zu konvergieren, bildest du die partiellen Ableitungen der Verlustfunktion $J(\theta1)$ und berechnest die Gradienten, um die Richtung hinunter ins Tal zu erhalten.
Damit es schneller geht, fügst du den Faktor $\alpha$ hinzu – die Lernrate. Je kleiner der Wert, desto langsamer bewegst du dich den Abhang hinunter. Das kann helfen, lokale Minima nicht zu verpassen; es kann aber auch bedeuten, dass die Konvergenz sehr lange dauert – insbesondere, wenn du auf einem Plateau festhängst.
So weit der schnelle Recap zur Lernrate. Als Nächstes schauen wir uns Techniken an, um eine gute Lernrate für dein Netz zu wählen.
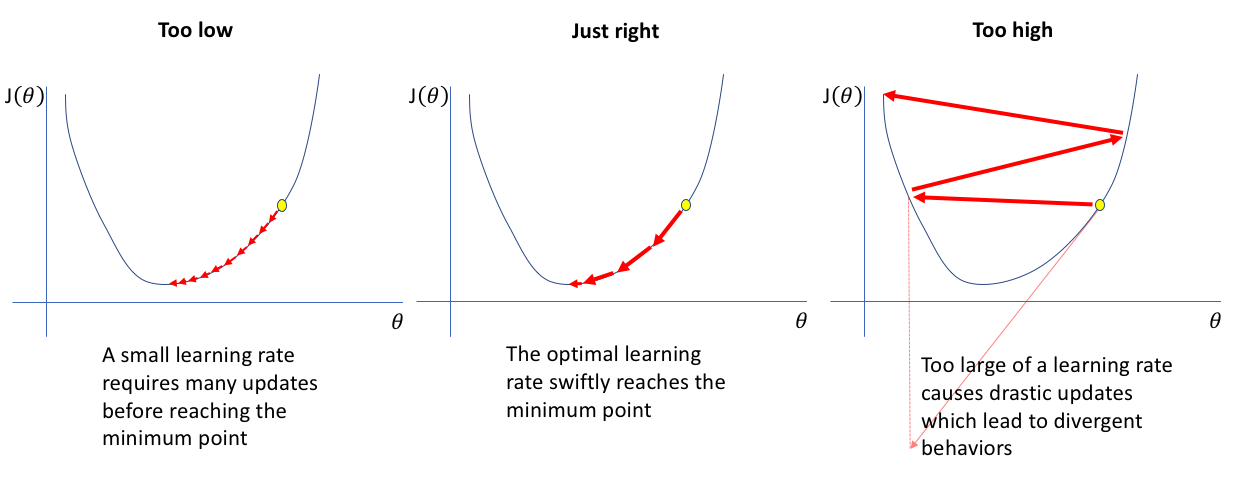
Es gibt keine fixe Lernrate für alle Netze. Sie hängt vom Problem, den Daten und vor allem der Architektur ab – und die variiert je nach Aufgabe. Eine Lernrate per Hand zu wählen ist mühsam, teuer und zeitaufwändig, insbesondere bei großen Netzen.
Solltest du Standardmethoden zur Hyperparameter-Optimierung wie Grid Search oder Random Search verwenden?
Vor CLR wurden Adaptive Lernraten vorgeschlagen – gewissermaßen ein Gegenentwurf. Experimente damit sind jedoch rechenintensiv, was bei CLR nicht der Fall ist.
Bis heute ist es üblich, mit einer konstanten Lernrate zu starten und sie um eine Größenordnung zu senken, sobald die Genauigkeit stagniert.
Es braucht also eine systematische Methode, die die Wahl einer guten Lernrate vereinfacht – und idealerweise gute Gründe, warum dieser Ansatz vertrauenswürdig ist.
Hier kommen zyklische Lernraten (CLR) ins Spiel.
CLR verfolgt zwei Ziele:
In diesem Abschnitt bauen wir zunächst Intuition dafür auf, wie CLR funktioniert. Im nächsten Teil gehen wir tiefer. Vorhin hast du kurz wiederholt, warum Lernraten überhaupt eingesetzt werden. Erinnern wir uns noch einmal daran.
Eine ideale Lernrate sorgt für einen steilen Abfall der Loss. Genau hier kommt CLR ins Spiel. Das Originalpapier beschreibt ein Experiment, mit dem du das Verhalten der Lernrate in Bezug auf die Loss beobachten kannst: Du erhöhst die Lernrate nach jedem Mini-Batch schrittweise und zeichnest die Loss auf. Diese Erhöhung kann linear oder exponentiell sein. Das ist der LR Range Test.
Die Beobachtung von Leslie: Bei zu kleinen Lernraten sinkt die Loss, aber nur flach. Im optimalen Bereich siehst du einen schnellen Abfall. Erhöhst du die Lernrate weiter, kann das zu Parameterverlusten im Netz führen und die Loss wieder steigen lassen. Du suchst also den Bereich mit dem steilsten Abfall und kannst dafür die Gradienten der Loss in verschiedenen Trainingsphasen analysieren.
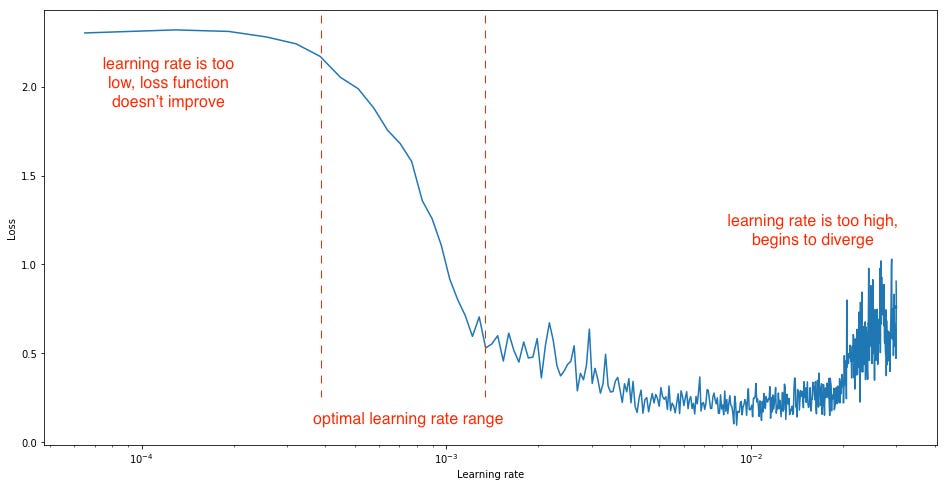
Im obigen Diagramm erkennst du leicht drei Phasen: Zunächst ändert sich die Loss kaum, dann fällt sie steil, anschließend steigt sie wieder langsam an.
Siehst du den steilsten Abfall? Genau in diesem Bereich willst du landen – und CLR liefert dir einen disziplinierten Weg dorthin. Schauen wir genauer hin.
Aus der Beobachtung folgt ein wichtiger Punkt:
Die Intuition hinter CLR ist, die Lernrate innerhalb eines Wertebereichs variieren zu lassen, statt sie linear oder exponentiell nur zu senken. Du legst also einen Bereich fest und variierst die Lernrate darin zyklisch. Leslie betrachtete folgende Fensterfunktionen für die zyklische Variation:
Alle lieferten vergleichbare Ergebnisse. Im Originalpapier wird daher der Einfachheit halber nur die Dreiecksform dargestellt (linear ansteigend, dann linear abfallend). Diese Policy heißt auch triangular learning rate policy. Die Implementierung ist unkompliziert. Hier ist eine verallgemeinerte Implementierung der triangular learning rate policy:
local cycle = math.floor(1 + epochCounter / ( 2 ∗ stepsize))
local x = math.abs(epochCounter / stepsize − 2∗ cycle + 1 )
local lr = opt.LR + (maxLR − opt.LR) ∗ math.max(0 , (1−x ))
Dabei gilt:
Die Dreiecksform lässt sich so visualisieren:

Quelle: Das zu Beginn verlinkte CLR-Originalpapier.
Neben der triangular-Policy wurden im Papier folgende Varianten vorgestellt:
Eine naheliegende Frage: Wie wählt man sinnvolle minimale und maximale Grenzen? Erinnerst du dich an den LR Range Test? Genau hier wird er relevant.
Leslie schlug einen einfachen, praktischen Weg zur Wahl des Bereichs vor:
Schauen wir uns nun eine kurze Fallstudie an, um zu sehen, wie gut CLR funktioniert.
(Am Ende des Tutorials findest du noch neuere Weiterentwicklungen auf Basis von CLR. Aber inzwischen solltest du die Stärke von CLR gut einschätzen können.)
Wir verwenden den klassischen MNIST-Datensatz – wahrscheinlich der populärste Einstieg in Computer Vision und Deep Learning. Wenn du MNIST im Detail kennenlernen willst, lies diesen Blogpost. Für das Experiment nutzen wir intensiv keras. keras bringt MNIST bereits mit. Wir starten, indem wir den Datensatz importieren und eine kleine EDA machen.
from keras.datasets import mnist
Using TensorFlow backend.
Der Import war erfolgreich. Jetzt visualisieren wir einige Bilder aus dem Datensatz.
import matplotlib.pyplot as plt

(X_train, y_train), (X_test, y_test) = mnist.load_data()

# Plot 4 images as gray scale
plt.subplot(152)
plt.imshow(X_train[0], cmap=plt.get_cmap('gray'))
plt.subplot(153)
plt.imshow(X_train[1], cmap=plt.get_cmap('gray'))
plt.subplot(154)
plt.imshow(X_train[2], cmap=plt.get_cmap('gray'))
plt.subplot(155)
plt.imshow(X_train[3], cmap=plt.get_cmap('gray'))
# Show the plot
plt.show()
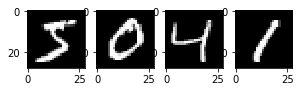
Super! Jetzt bauen wir ein einfaches, mehrschichtiges Netz. Zuvor führen wir ein wenig Vorverarbeitung durch.
# Flatten 28*28 images to a 784 vector for each image
num_pixels = X_train.shape[1] * X_train.shape[2]
X_train = X_train.reshape(X_train.shape[0], num_pixels).astype('float32')
X_test = X_test.reshape(X_test.shape[0], num_pixels).astype('float32')
Was haben wir gemacht?
Die Bilder sind 28×28 Pixel groß – unpraktisch für ein simples voll verbundenes Netz. Daher wandeln wir jedes Bild per reshape() in einen 784-dimensionalen Vektor um.
Die Pixelwerte liegen zwischen 0 und 255. Sinnvoll ist, sie durch Normalisierung auf 0 bis 1 zu skalieren.
X_train = X_train / 255
X_test = X_test / 255
Die Zielvariable sind Ganzzahlen von 0 bis 9. Es handelt sich also um ein Multiclass-Problem. Wir führen One-Hot-Encoding durch, um aus Klassenindizes Binärvektoren zu machen.
Das geht bequem mit np_utils.to_categorical() aus keras.
from keras.utils import np_utils

y_train = np_utils.to_categorical(y_train)
y_test = np_utils.to_categorical(y_test)
num_classes = y_test.shape[1]
Als Nächstes definieren wir die Struktur unseres Netzes – ein einfaches Fully-Connected-Modell. In keras läuft das typischerweise in drei Schritten:
import numpy as np
from keras.models import Sequential
from keras.layers import Dense

# Create model
model = Sequential()
model.add(Dense(num_pixels, input_dim=num_pixels, kernel_initializer='normal', activation='relu'))
model.add(Dense(num_classes, kernel_initializer='normal', activation='softmax'))

# Compile model
model.compile(loss='categorical_crossentropy', optimizer='adam', metrics=['accuracy'])
Was passiert hier? Wir bauen das Netz als linearen Stack aus Schichten. In der ersten Schicht fügen wir so viele Neuronen hinzu wie Pixel (784) und setzen die Eingabedimension entsprechend. Die Gewichte werden aus einer normalverteilten Initialisierung gezogen. Als Aktivierung nutzen wir relu.
In der Ausgabeschicht setzen wir 10 Neuronen (eine je Klasse) und verwenden softmax, um Wahrscheinlichkeiten zu erhalten und genau eine Klasse als Vorhersage zu wählen.
Beim Kompilieren legen wir das Optimierungsverfahren (ADAM) und die zu minimierende Loss (categorical_crossentropy) fest.
Jetzt trainieren wir das Modell, messen die Zeit und testen anschließend die Performance.
import timeit

# For fixing the reproducibility
from numpy.random import seed
seed(1)

# Fit the model
startTime = timeit.default_timer()
model.fit(X_train, y_train, validation_data=(X_test, y_test), epochs=10, batch_size=200, verbose=2)
elapsedTime = timeit.default_timer() - startTime
print("Time taken for the Network to train : ",elapsedTime)

# Final evaluation of the model
scores = model.evaluate(X_test, y_test, verbose=0)
print("Baseline Error: %.2f%%" % (100-scores[1]*100))
Train on 60000 samples, validate on 10000 samples
Epoch 1/10
 - 10s - loss: 0.2774 - acc: 0.9207 - val_loss: 0.1362 - val_acc: 0.9610
Epoch 2/10
 - 8s - loss: 0.1113 - acc: 0.9675 - val_loss: 0.0951 - val_acc: 0.9720
Epoch 3/10
 - 8s - loss: 0.0712 - acc: 0.9793 - val_loss: 0.0802 - val_acc: 0.9750
Epoch 4/10
 - 8s - loss: 0.0503 - acc: 0.9857 - val_loss: 0.0687 - val_acc: 0.9788
Epoch 5/10
 - 8s - loss: 0.0360 - acc: 0.9897 - val_loss: 0.0632 - val_acc: 0.9797
Epoch 6/10
 - 8s - loss: 0.0267 - acc: 0.9928 - val_loss: 0.0643 - val_acc: 0.9784
Epoch 7/10
 - 8s - loss: 0.0201 - acc: 0.9951 - val_loss: 0.0633 - val_acc: 0.9802
Epoch 8/10
 - 8s - loss: 0.0150 - acc: 0.9962 - val_loss: 0.0613 - val_acc: 0.9808
Epoch 9/10
 - 8s - loss: 0.0108 - acc: 0.9978 - val_loss: 0.0625 - val_acc: 0.9806
Epoch 10/10
 - 8s - loss: 0.0076 - acc: 0.9988 - val_loss: 0.0612 - val_acc: 0.9809
Time taken for the Network to train :  86.4216202873591
Baseline Error: 1.91%
Dieses einfache Modell schneidet gut ab: nur 1,91% Fehler in rund 87 Sekunden. Jetzt kommt die Stärke von CLR. Wir klonen die keras-Implementierung von CLR von GitHub.
Nach dem Klonen solltest du folgende Dateien im Arbeitsverzeichnis sehen:

Die CLR-Policy ist hier als keras callback implementiert.
from keras.callbacks import *
from clr_callback import *
from keras.optimizers import Adam

# You are using the triangular learning rate policy and
#  base_lr (initial learning rate which is the lower boundary in the cycle) is 0.1
clr_triangular = CyclicLR(mode='triangular')
model.compile(optimizer=Adam(0.1), loss='categorical_crossentropy', metrics=['accuracy'])
Dieses clr_triangular übergeben wir beim Fitten über den Parameter callbacks. Außerdem erhöhen wir die batch_size und messen erneut die Zeit.
startTime = timeit.default_timer()
model.fit(X_train, y_train, validation_data=(X_test, y_test), epochs=10, batch_size=2000,callbacks=[clr_triangular], verbose=2)
elapsedTime = timeit.default_timer() - startTime
print("Time taken for the Network to train : ",elapsedTime)

# Final evaluation of the model
scores = model.evaluate(X_test, y_test, verbose=0)
print("Baseline Error: %.2f%%" % (100-scores[1]*100))
Train on 60000 samples, validate on 10000 samples
Epoch 1/10
 - 4s - loss: 0.0046 - acc: 0.9996 - val_loss: 0.0571 - val_acc: 0.9831
Epoch 2/10
 - 4s - loss: 0.0030 - acc: 0.9998 - val_loss: 0.0575 - val_acc: 0.9829
Epoch 3/10
 - 4s - loss: 0.0023 - acc: 0.9999 - val_loss: 0.0594 - val_acc: 0.9827
Epoch 4/10
 - 4s - loss: 0.0018 - acc: 0.9999 - val_loss: 0.0589 - val_acc: 0.9835
Epoch 5/10
 - 4s - loss: 0.0014 - acc: 1.0000 - val_loss: 0.0595 - val_acc: 0.9831
Epoch 6/10
 - 4s - loss: 0.0011 - acc: 1.0000 - val_loss: 0.0600 - val_acc: 0.9836
Epoch 7/10
 - 4s - loss: 0.0010 - acc: 1.0000 - val_loss: 0.0612 - val_acc: 0.9832
Epoch 8/10
 - 4s - loss: 8.2190e-04 - acc: 1.0000 - val_loss: 0.0621 - val_acc: 0.9829
Epoch 9/10
 - 4s - loss: 6.6182e-04 - acc: 1.0000 - val_loss: 0.0624 - val_acc: 0.9836
Epoch 10/10
 - 4s - loss: 5.7177e-04 - acc: 1.0000 - val_loss: 0.0635 - val_acc: 0.9836
Time taken for the Network to train :  43.23223609056981
Baseline Error: 1.64%
Erkennst du den Vorteil? Beeindruckend: Das Modell war in nur 44 Sekunden trainiert und erzielte sogar eine geringere Fehlerrate. Sehr gut!
Du hast es bis zum Ende geschafft. In diesem Tutorial hast du das zentrale Problem der passenden Lernrate behandelt – und gesehen, wie CLR den Ansatz grundlegend verändert. Du hast CLR im Detail kennengelernt und in kleinen Experimenten erlebt, wie damit in kürzerer Zeit starke Ergebnisse möglich sind.
Wie geht es weiter? Zwei Ableger von CLR sind besonders interessant:
Beschäftige dich mit diesen beiden Ansätzen für noch tiefere Einblicke. Außerdem veröffentlichte Leslie nach CLR das Paper A disciplined approach to neural network hyper-parameters: Part 1 -- learning rate, batch size, momentum, and weight decay, das CLR erneut aufgreift und effiziente Methoden zur Wahl weiterer wichtiger Hyperparameter vorstellt. Darin wird auch Super Convergence erneut betrachtet. Pflichtlektüre für alle, die neuronale Netze denken, essen und schlafen.
Eine wesentliche Einschränkung von CLR ist die begrenzte Anwendbarkeit. Bevor es im Produktivbetrieb breit genutzt wird, braucht es noch mehr Absicherung.
Wenn du mehr über neuronale Netze erfahren willst, schau dir DataCamps Kurs Deep Learning in Python an – hervorragend aufgebaut und unterrichtet von Dan Becker (Head of Kaggle Learn).
Mehr über Python und Deep Learning
Kurs
Kurs
Blog
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Satyabrata Pal
15 Min.
Tutorial
DataCamp Team
5 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
DataCamp Team
3 Min.




