Curso
Introducción al Deep Learning en Python
4 h
264.6K
(Este tutorial asume que ya conoces los fundamentos de las redes neuronales)
La expresión red neuronal ya no suena extraña ni en Informática ni, en realidad, en la sociedad en general. Lo interesante no es solo la cantidad de problemas reales que resuelve, sino también la variedad de esos problemas. ¿Cómo pueden ser tan diversos?
Ya sea en Psicología cognitiva, en Ciberseguridad o en el sector sanitario (dejando a un lado por ahora Visión por computador, Gráficos por computador, Procesamiento del lenguaje natural, etc.). ¡Incluso en los ámbitos menos comunes! Prácticamente todas las industrias se están beneficiando enormemente de la inteligencia y la automatización que ofrece una red neuronal.
Pero ¿por qué? Es la pregunta que vuelve una y otra vez. La respuesta sigue en investigación activa: las redes neuronales son en gran medida una caja negra y su parecido con el cerebro complica aún más el tema. En fin, responder a esa pregunta no es el objetivo de este artículo.
Algo sí está claro: para obtener los resultados esperados de una red neuronal, hay que garantizar su entrenamiento. Y a estas alturas ya habrás comprobado que entrenar redes muy grandes exige una potencia de cálculo enorme. Sin buenas GPU y SSD es casi imposible entrenar una red muy grande. ¿Qué tan grande es muy grande? Pues lo bastante como para dar buenos resultados en ImageNet, que es el benchmark de referencia.
Esta idea de entrenar redes masivas cambió por completo cuando un equipo de investigadores de Fast.ai superó el modelo de Google logrando un 93% de precisión en solo 18 minutos y por apenas 40 $.
¿Te interesa? ¡Sigue leyendo!
¿Cuáles fueron los ingredientes clave? ¿GPU de última generación? ¿TPU punteras? ¿SSD de alto rendimiento?
En absoluto. La configuración fue bastante sencilla —el coste total fue de solo 40 $. La clave estuvo en usar algoritmos de vanguardia para entrenar la red. En esta entrada, el investigador y educador Jeremy Howard explica los motivos del éxito.
Es un ejemplo clásico de cómo el poder de los buenos algoritmos supera al del hardware caro. En este post vas a ver en detalle una técnica que ayuda a entrenar una red con la mejor tasa de aprendizaje posible: cyclical learning rate (CLR, tasa de aprendizaje cíclica). La propuso en 2015 Leslie N. Smith. Puedes consultar el paper original aquí.
¿Por qué centrarnos en la tasa de aprendizaje y no en otros hiperparámetros como dropout o las funciones de activación? Porque la tasa de aprendizaje es el factor más importante. Sin más.
En este post vas a ver:
Repasemos el objetivo principal de usar tasas de aprendizaje al entrenar una red.
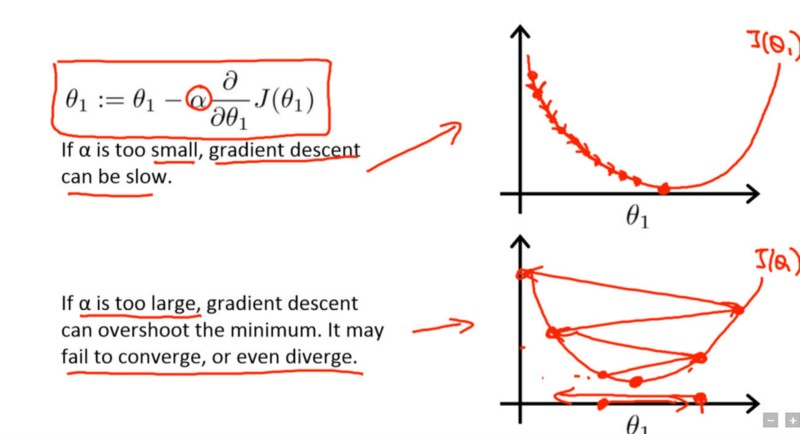
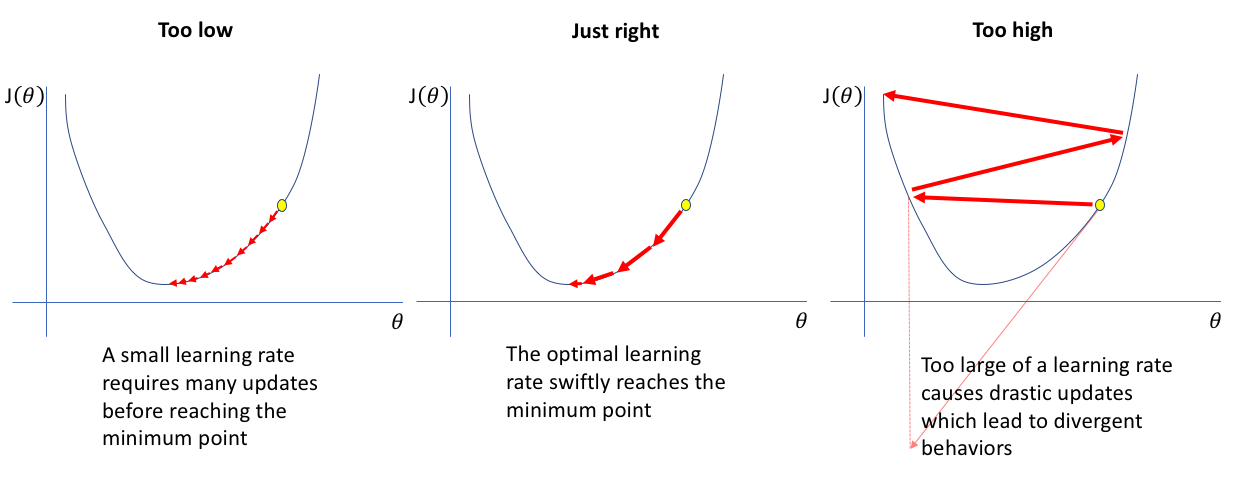
La tasa de aprendizaje es un hiperparámetro que controla cuánto ajustas los pesos de la red con respecto al gradiente de la pérdida. ¿Gradientes? Sí: estás optimizando la red que acabas de crear con descenso por gradiente. El objetivo del descenso por gradiente es encontrar el mínimo de la función de pérdida que tu red intenta optimizar. Fíjate en la siguiente imagen [tomada del curso de Deep Learning de Andrew Ng en Coursera]:
La expresión del recuadro es la regla de actualización con la que la red aprende su parámetro $\theta$1, donde $\alpha$ es la tasa de aprendizaje.
En la primera curva, el punto más bajo es el mínimo de la función de pérdida. Supón que en la iteración actual tu red está cerca del punto superior izquierdo. Para converger hacia el punto más bajo, tomas derivadas parciales de la función de pérdida $J(\theta1)$ y calculas los gradientes para obtener la dirección hacia ese mínimo.
Para llegar más rápido, añades el término $\alpha$, la tasa de aprendizaje. Cuanto menor es su valor, más lento avanzas por la pendiente descendente. Aunque usar una tasa baja puede ayudarte a no saltarte mínimos locales, también puede alargar muchísimo la convergencia, sobre todo si te quedas en una meseta.
Hasta aquí el repaso. Ahora veremos técnicas para elegir una buena tasa de aprendizaje para tu red.
No existe una tasa de aprendizaje fija para todas las redes. Depende del problema, de los datos que introduces y, sobre todo, de la arquitectura, que cambia según el caso. Elegirla a mano es un suplicio: si entrenas una red grande, puedes incurrir en costes enormes y además lleva mucho tiempo.
¿Usamos optimización de hiperparámetros como Grid Search o Random Search?
Antes de CLR, se propusieron las tasas de aprendizaje adaptativas, una alternativa a CLR, pero experimentar con ellas resulta costoso computacionalmente, a diferencia de CLR.
Hoy, lo más habitual sigue siendo fijar una tasa constante y reducirla un orden de magnitud cuando la precisión se estanca.
Hace falta, por tanto, una técnica sistemática que simplifique la elección de una buena tasa de aprendizaje y que, además, tenga argumentos sólidos que la respalden.
Parece que Cyclical Learning Rates (CLR) llegó en el momento justo.
CLR persigue dos objetivos:
Esta sección busca darte intuición sobre cómo funciona CLR. En la siguiente entraremos en detalle. Ya has visto por qué usamos tasas de aprendizaje; recordémoslo.
La tasa ideal es la que provoca una caída pronunciada de la pérdida. Aquí está la magia de CLR. El paper original plantea un experimento para observar cómo se comporta la pérdida al variar la tasa: aumentas gradualmente la tasa tras cada mini-batch y registras la pérdida en cada incremento. Ese aumento puede ser lineal o exponencial. Este es, básicamente, el LR Range Test.
Tras el experimento que propone Leslie, con tasas demasiado bajas la pérdida disminuye muy lentamente. Al entrar en la zona óptima, verás una caída brusca. Si sigues subiendo, puedes causar que los parámetros “se pierdan” y la pérdida vuelva a aumentar. Por tanto, te interesa la caída más pronunciada, y para ello puedes analizar los gradientes de la pérdida en distintas fases del entrenamiento.
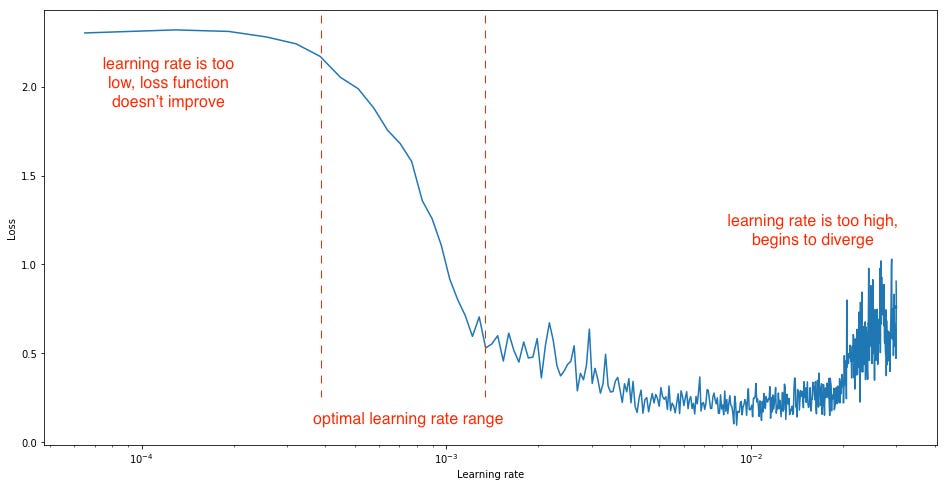
En el gráfico puedes distinguir tres fases: una en la que la pérdida apenas cambia, otra de descenso acusado y, por último, un aumento progresivo.
¿Ves el descenso más pronunciado? Ahí es donde quieres acabar, y CLR te da un método disciplinado para encontrarlo. Vamos a profundizar.
La observación anterior lleva a un punto clave:
La intuición de CLR surge de permitir que la tasa de aprendizaje varíe dentro de un rango, en lugar de disminuir lineal o exponencialmente. Para ello fijas un rango y, en vez de variarla lineal o exponencialmente, la haces oscilar cíclicamente dentro de ese rango. Leslie consideró estas funciones para variar la tasa de forma cíclica:
Todas dieron resultados equivalentes, así que en el paper se presenta la forma triangular (subida lineal y bajada lineal) por simplicidad. A esta política también se la llama triangular learning rate policy. Implementarla es directo. Esta es una implementación generalizada de la política triangular:
local cycle = math.floor(1 + epochCounter / ( 2 ∗ stepsize))
local x = math.abs(epochCounter / stepsize − 2∗ cycle + 1 )
local lr = opt.LR + (maxLR − opt.LR) ∗ math.max(0 , (1−x ))
donde
Para visualizar la forma triangular, fíjate en esta imagen:

Fuente: el paper original de CLR citado al inicio del tutorial.
Además de la política triangular, el paper presenta:
Quizá te estés preguntando: ¿cómo estimar límites razonables mínimo y máximo? ¿Recuerdas el LR Range Test de hace un momento? Ahora verás su utilidad.
Leslie propuso una manera sencilla y práctica de decidir el rango:
Veamos ahora un caso práctico para comprobar lo bien que funciona CLR.
(Al final del tutorial verás avances recientes sobre CLR, pero a estas alturas ya has visto su valor.)
Usaremos el clásico MNIST, probablemente el dataset más popular para empezar con Visión por computador y Deep Learning. Consulta este post si quieres conocer MNIST en detalle. Utilizaremos keras para todo; trae el dataset integrado. Empezamos importándolo y haciendo algo de EDA básica.
from keras.datasets import mnist
Using TensorFlow backend.
Dataset importado correctamente. Ahora, unas visualizaciones rápidas.
import matplotlib.pyplot as plt

(X_train, y_train), (X_test, y_test) = mnist.load_data()

# Representa 4 imágenes en escala de grises
plt.subplot(152)
plt.imshow(X_train[0], cmap=plt.get_cmap('gray'))
plt.subplot(153)
plt.imshow(X_train[1], cmap=plt.get_cmap('gray'))
plt.subplot(154)
plt.imshow(X_train[2], cmap=plt.get_cmap('gray'))
plt.subplot(155)
plt.imshow(X_train[3], cmap=plt.get_cmap('gray'))
# Muestra la figura
plt.show()
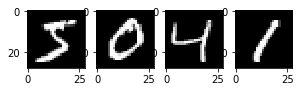
¡Perfecto! Pasamos a construir una red neuronal multicapa sencilla. Antes, un poco de preprocesado.
# Aplana imágenes 28*28 a un vector de 784 para cada imagen
num_pixels = X_train.shape[1] * X_train.shape[2]
X_train = X_train.reshape(X_train.shape[0], num_pixels).astype('float32')
X_test = X_test.reshape(X_test.shape[0], num_pixels).astype('float32')
¿Qué hemos hecho?
Las imágenes son de 28×28, difícil de acomodar en una red densa sencilla. Por eso las convertimos a una dimensión, con 784 píxeles por imagen, usando reshape().
Los píxeles van de 0 a 255. Conviene normalizarlos a 0–1.
X_train = X_train / 255
X_test = X_test / 255
La variable de salida es un entero de 0 a 9. Es un problema multiclase. Haremos one-hot encoding de las etiquetas para obtener una matriz binaria. Así “binarizamos” la categoría y la podemos usar como feature para entrenar la red.
Puedes hacerlo con la función np_utils.to_categorical() de keras.
from keras.utils import np_utils

y_train = np_utils.to_categorical(y_train)
y_test = np_utils.to_categorical(y_test)
num_classes = y_test.shape[1]
Definimos ahora la arquitectura. Usaremos una red totalmente conectada sencilla. En keras esto suele ser un proceso en tres pasos:
import numpy as np
from keras.models import Sequential
from keras.layers import Dense

# Crea el modelo
model = Sequential()
model.add(Dense(num_pixels, input_dim=num_pixels, kernel_initializer='normal', activation='relu'))
model.add(Dense(num_classes, kernel_initializer='normal', activation='softmax'))

# Compila el modelo
model.compile(loss='categorical_crossentropy', optimizer='adam', metrics=['accuracy'])
¿Qué hicimos arriba? Construyes la red secuencialmente (pila lineal de capas). Añades la primera capa con tantas neuronas como píxeles (784) y especificas la dimensión de entrada. Indicas inicialización normal y usas relu como activación.
En la última capa pones 10 neuronas (las clases) y activación softmax para obtener probabilidades y elegir una de las 10 como predicción del modelo.
Compilas el modelo para fijar el método de optimización (ADAM) y la pérdida a optimizar (categorical_crossentropy).
Ahora entrenamos y medimos el tiempo. También probamos su rendimiento.
import timeit

# Para garantizar reproducibilidad
from numpy.random import seed
seed(1)

# Entrena el modelo
startTime = timeit.default_timer()
model.fit(X_train, y_train, validation_data=(X_test, y_test), epochs=10, batch_size=200, verbose=2)
elapsedTime = timeit.default_timer() - startTime
print("Time taken for the Network to train : ",elapsedTime)

# Evaluación final del modelo
scores = model.evaluate(X_test, y_test, verbose=0)
print("Baseline Error: %.2f%%" % (100-scores[1]*100))
Train on 60000 samples, validate on 10000 samples
Epoch 1/10
 - 10s - loss: 0.2774 - acc: 0.9207 - val_loss: 0.1362 - val_acc: 0.9610
Epoch 2/10
 - 8s - loss: 0.1113 - acc: 0.9675 - val_loss: 0.0951 - val_acc: 0.9720
Epoch 3/10
 - 8s - loss: 0.0712 - acc: 0.9793 - val_loss: 0.0802 - val_acc: 0.9750
Epoch 4/10
 - 8s - loss: 0.0503 - acc: 0.9857 - val_loss: 0.0687 - val_acc: 0.9788
Epoch 5/10
 - 8s - loss: 0.0360 - acc: 0.9897 - val_loss: 0.0632 - val_acc: 0.9797
Epoch 6/10
 - 8s - loss: 0.0267 - acc: 0.9928 - val_loss: 0.0643 - val_acc: 0.9784
Epoch 7/10
 - 8s - loss: 0.0201 - acc: 0.9951 - val_loss: 0.0633 - val_acc: 0.9802
Epoch 8/10
 - 8s - loss: 0.0150 - acc: 0.9962 - val_loss: 0.0613 - val_acc: 0.9808
Epoch 9/10
 - 8s - loss: 0.0108 - acc: 0.9978 - val_loss: 0.0625 - val_acc: 0.9806
Epoch 10/10
 - 8s - loss: 0.0076 - acc: 0.9988 - val_loss: 0.0612 - val_acc: 0.9809
Time taken for the Network to train :  86.4216202873591
Baseline Error: 1.91%
Este modelo sencillo rinde bastante bien: 1,91% de error en unos 87 segundos. Ahora verás la fuerza de CLR. Empezamos clonando la implementación de CLR para keras en GitHub.
Tras clonar, deberías tener estos archivos en tu directorio de trabajo.

La política CLR está implementada como un keras callback.
from keras.callbacks import *
from clr_callback import *
from keras.optimizers import Adam

# Usas la política triangular
#  y base_lr (tasa inicial, límite inferior del ciclo) es 0.1
clr_triangular = CyclicLR(mode='triangular')
model.compile(optimizer=Adam(0.1), loss='categorical_crossentropy', metrics=['accuracy'])
Pasa clr_triangular al parámetro callbacks al ajustar la red. Esta vez usarás un batch_size mayor. Registra también el tiempo.
startTime = timeit.default_timer()
model.fit(X_train, y_train, validation_data=(X_test, y_test), epochs=10, batch_size=2000,callbacks=[clr_triangular], verbose=2)
elapsedTime = timeit.default_timer() - startTime
print("Time taken for the Network to train : ",elapsedTime)

# Evaluación final del modelo
scores = model.evaluate(X_test, y_test, verbose=0)
print("Baseline Error: %.2f%%" % (100-scores[1]*100))
Train on 60000 samples, validate on 10000 samples
Epoch 1/10
 - 4s - loss: 0.0046 - acc: 0.9996 - val_loss: 0.0571 - val_acc: 0.9831
Epoch 2/10
 - 4s - loss: 0.0030 - acc: 0.9998 - val_loss: 0.0575 - val_acc: 0.9829
Epoch 3/10
 - 4s - loss: 0.0023 - acc: 0.9999 - val_loss: 0.0594 - val_acc: 0.9827
Epoch 4/10
 - 4s - loss: 0.0018 - acc: 0.9999 - val_loss: 0.0589 - val_acc: 0.9835
Epoch 5/10
 - 4s - loss: 0.0014 - acc: 1.0000 - val_loss: 0.0595 - val_acc: 0.9831
Epoch 6/10
 - 4s - loss: 0.0011 - acc: 1.0000 - val_loss: 0.0600 - val_acc: 0.9836
Epoch 7/10
 - 4s - loss: 0.0010 - acc: 1.0000 - val_loss: 0.0612 - val_acc: 0.9832
Epoch 8/10
 - 4s - loss: 8.2190e-04 - acc: 1.0000 - val_loss: 0.0621 - val_acc: 0.9829
Epoch 9/10
 - 4s - loss: 6.6182e-04 - acc: 1.0000 - val_loss: 0.0624 - val_acc: 0.9836
Epoch 10/10
 - 4s - loss: 5.7177e-04 - acc: 1.0000 - val_loss: 0.0635 - val_acc: 0.9836
Time taken for the Network to train :  43.23223609056981
Baseline Error: 1.64%
¿Ves la ventaja? ¡Es una pasada! El modelo tardó solo 44 segundos y además redujo el error. ¡Muy bien!
Has llegado al final. En este tutorial has abordado el problema crucial de elegir una tasa de aprendizaje adecuada y cómo CLR cambió por completo el enfoque. Viste CLR con buen nivel de detalle e hiciste pequeños experimentos para comprobar cómo puede dar resultados excelentes en menos tiempo.
¿Y ahora qué? Dos líneas de trabajo derivadas de CLR:
Estudia ambos para profundizar aún más. Además, después de CLR, Leslie publicó A disciplined approach to neural network hyper-parameters: Part 1 -- learning rate, batch size, momentum, and weight decay, que revisita CLR y propone métodos eficientes para elegir otros hiperparámetros importantes. También retoma su técnica de Super Convergence. Es una lectura imprescindible para quien vive y respira redes neuronales.
Una limitación importante de CLR es su aplicabilidad restringida. Hay que robustecerlo antes de usarlo en producción.
Si quieres saber más sobre redes neuronales, echa un vistazo al curso de DataCamp Deep Learning in Python, muy bien diseñado e impartido por Dan Becker (Head of Kaggle Learn).
Aprende más sobre Python y deep learning
Curso
Curso
blog
Abid Ali Awan
10 min
Tutorial
Bharath K
13 min
Tutorial
Moez Ali
14 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Abid Ali Awan
15 min
Tutorial
Zoumana Keita
14 min