Curso
Introdução a Deep Learning em Python
4 h
264.6K
(Este tutorial parte do princípio de que você já conhece o básico sobre redes neurais)
Rede neural já não é mais um termo estranho para quem é de Computação — ou, vamos ser sinceros, para a sociedade em geral. O que a torna tão interessante não é só a quantidade de problemas do mundo real que resolve, mas também a variedade de problemas que consegue atacar. Como dá para cobrir tanto terreno assim?
Seja em Psicologia Cognitiva, em Segurança Cibernética, em Saúde (sem falar, por enquanto, de Visão Computacional, Computação Gráfica, Processamento de Linguagem Natural, etc.). Vamos lembrar de áreas menos óbvias! Praticamente todos os setores estão colhendo ganhos enormes com a inteligência e a automação que redes neurais oferecem.
Mas por quê? Essa é a pergunta que volta sempre! A resposta ainda é tema de muita pesquisa, porque redes neurais têm um certo caráter de caixa‑preta e a semelhança com o cérebro complica ainda mais a questão. De qualquer forma, responder a isso não é o objetivo deste post.
Uma coisa é certa: para extrair os resultados esperados de uma rede neural, é preciso garantir um bom treinamento. E você já deve ter percebido que treinar modelos muito grandes exige um poder computacional enorme. Sem boas GPUs e SSDs é quase impossível treinar uma rede neural muito grande. E o que é muito grande? Em geral, grande o suficiente para performar bem no dataset ImageNet, que serve como um benchmark.
Essa ideia de treinar redes gigantes mudou de patamar quando um time talentoso da Fast.ai superou o modelo do Google, alcançando 93% de acurácia em apenas 18 minutos — gastando só US$ 40.
Interessou? Então continua comigo.
Mas quais foram os ingredientes‑chave para isso acontecer? GPUs de ponta? TPUs de última geração? SSDs ultra rápidos?
Nada disso. A configuração do time era simples — afinal, o custo foi de apenas US$ 40. O diferencial foi o uso de algoritmos de ponta para treinar a rede neural. Neste post, o pesquisador e educador Jeremy Howard explica os principais motivos desse grande resultado.
É um exemplo clássico em que o poder de algoritmos supera o de hardware caro. Neste artigo, você vai conhecer em detalhes uma dessas técnicas que ajuda a treinar uma rede neural com a melhor taxa de aprendizado possível. Essa técnica é o Cyclical Learning Rate (CLR) — taxa de aprendizado cíclica. Ela foi proposta em 2015 por Leslie N. Smith. O artigo original está aqui.
Mas por que focar só em taxa de aprendizado, se há outros hiperparâmetros importantes como taxa de dropout e funções de ativação? Porque a taxa de aprendizado é, de longe, a mais importante. Simples assim!
Neste post, você vai ver:
Vamos relembrar rapidamente o objetivo principal da taxa de aprendizado no treinamento de uma rede neural.
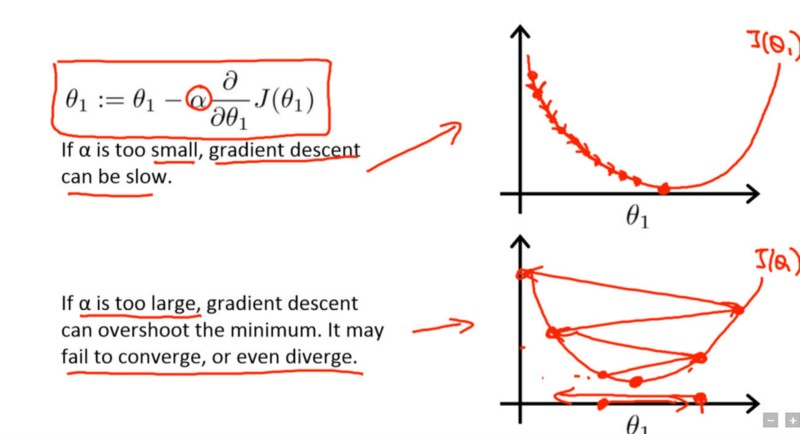
A taxa de aprendizado é um hiperparâmetro que controla o quanto você ajusta os pesos da rede em relação ao gradiente da loss. Como assim? Por que entram gradientes na história? Porque você quer otimizar a rede que acabou de criar usando gradient descent. O objetivo do gradient descent é encontrar o mínimo da função de loss que sua rede está tentando otimizar. Veja a imagem abaixo [do curso de Deep Learning do Andrew Ng na Coursera]:
O termo no retângulo é a regra de atualização com a qual a rede começa a aprender seus parâmetros $\theta$1, onde $\alpha$ é a taxa de aprendizado.
Na primeira curva, o ponto mais baixo é o mínimo da função de loss. Suponha que, na iteração atual, sua rede esteja perto do ponto mais alto à esquerda. Para convergir ao ponto mais baixo, você toma as derivadas parciais da função de loss $J(\theta1)$ e calcula os gradientes para obter a direção até esse ponto.
Para chegar um pouco mais rápido, você adiciona o termo $\alpha$, a taxa de aprendizado. Quanto menor o valor, mais devagar você desce a ladeira. Embora usar uma taxa baixa possa ajudar a não pular mínimos locais, também pode fazer você demorar muito para convergir — especialmente se ficar preso em um platô.
Esse foi um resumo simples dos objetivos da taxa de aprendizado. Agora vamos às técnicas de como escolher um bom valor para sua rede.
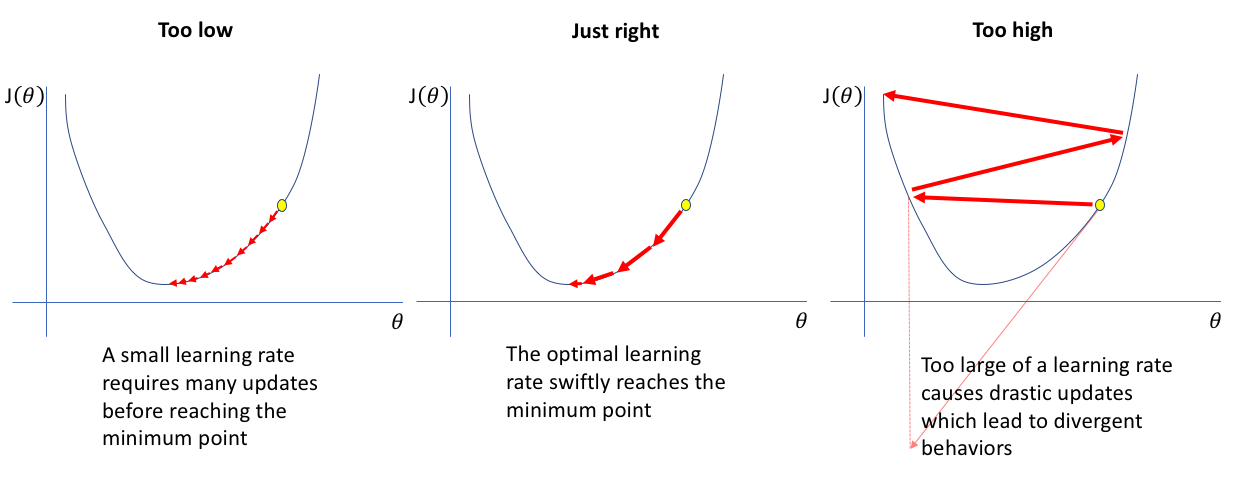
Não existe uma taxa de aprendizado fixa para toda rede neural. Ela depende do problema, do tipo de dado que você alimenta na rede e, principalmente, da arquitetura — que varia de problema para problema. Escolher “no olho” é doloroso: se você estiver treinando uma rede grande, o custo pode explodir. E leva tempo.
Devo rodar Grid Search ou Random Search para hiperparâmetros?
Antes do CLR, surgiram as taxas de aprendizado adaptativas, que podem ser vistas como concorrentes do CLR — mas experimentá‑las costuma ser caro computacionalmente, diferente do CLR.
Ainda hoje, a prática mais comum é definir uma taxa constante e reduzi‑la em uma ordem de grandeza quando a acurácia estaciona.
Fica clara a necessidade de uma técnica sistemática que simplifique a escolha de uma boa taxa de aprendizado para uma rede específica — e que venha acompanhada de evidências para confiar nela.
Pois é aí que entram as Cyclical Learning Rates (CLR).
Os objetivos do CLR são dois:
Vamos construir a intuição de como o CLR funciona. No próximo tópico, entramos em mais detalhes. Antes, vale relembrar rapidamente por que usamos taxas de aprendizado.
A taxa ideal é aquela que provoca uma queda acentuada na loss da rede. Aqui entra a “mágica” do CLR. O artigo original propõe um experimento para observar o comportamento da taxa de aprendizado em relação à loss. É fácil de visualizar: você aumenta gradualmente a taxa após cada mini‑batch, registrando a loss a cada incremento. Esse aumento pode ser linear ou exponencial. E sim, esse é o LR Range Test.
Ao realizar o experimento, Leslie mostrou que, com taxas muito baixas, a loss até diminui, mas de forma bem lenta. Ao entrar na zona ótima, você observa uma queda rápida. Se aumentar demais a taxa, pode causar perda de parâmetros na rede e, com isso, as perdas voltam a subir. Ou seja: você quer a região de queda mais íngreme da loss — e pode analisar os gradientes em diferentes estágios do treino para encontrá‑la.
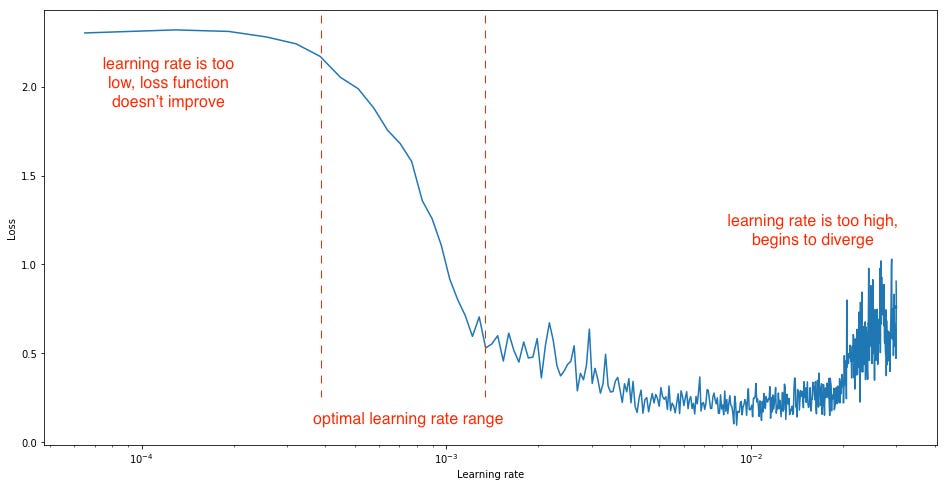
No gráfico acima, dá para ver três fases: primeiro, a loss quase não muda; depois, há uma queda acentuada; por fim, a loss volta a subir aos poucos.
Consegue identificar a queda mais íngreme? É nessa faixa que você quer chegar — e o CLR dá um caminho disciplinado para isso. Vamos avançar.
Da observação anterior, vem um ponto importante:
A intuição do CLR é deixar a taxa de aprendizado variar dentro de um intervalo de valores, em vez de adotar uma queda linear ou exponencial ao longo do tempo. Você define um intervalo e, em vez de variar linear ou exponencialmente, faz a taxa oscilar ciclicamente dentro dele. Leslie considerou as seguintes janelas para variar ciclicamente:
Todas produziram resultados equivalentes. No artigo, a ideia é apresentada com a forma triangular (sobe linearmente e depois desce linearmente) pela simplicidade — também chamada de triangular learning rate policy. Implementar é direto. Abaixo, uma implementação generalizada da política triangular:
local cycle = math.floor(1 + epochCounter / ( 2 ∗ stepsize))
local x = math.abs(epochCounter / stepsize − 2∗ cycle + 1 )
local lr = opt.LR + (maxLR − opt.LR) ∗ math.max(0 , (1−x ))
onde
Veja a figura abaixo para visualizar a forma triangular:

Fonte: o artigo original do CLR mencionado no início do tutorial.
Além da política triangular, o artigo também apresenta:
Talvez você esteja se perguntando: como estimar limites mínimo e máximo razoáveis? Lembra do LR Range Test de pouco atrás? Agora fica claro o papel dele.
Leslie propôs um jeito simples e prático de definir o intervalo:
Vamos a um estudo de caso rápido para ver o CLR em ação.
(No fim do tutorial, você vai ver alguns avanços recentes sobre o CLR. Mas, até aqui, já deu para perceber o valor da técnica.)
Vamos usar o clássico MNIST, provavelmente o dataset mais popular para começar em Visão Computacional e Deep Learning. Veja este post para um mergulho completo no MNIST. Você vai usar bastante o keras — que já traz o dataset pronto. Vamos começar importando e fazendo um EDA básico.
from keras.datasets import mnist
Using TensorFlow backend.
Dataset importado com sucesso. Agora, algumas visualizações rápidas.
import matplotlib.pyplot as plt

(X_train, y_train), (X_test, y_test) = mnist.load_data()

# Plotar 4 imagens em escala de cinza
plt.subplot(152)
plt.imshow(X_train[0], cmap=plt.get_cmap('gray'))
plt.subplot(153)
plt.imshow(X_train[1], cmap=plt.get_cmap('gray'))
plt.subplot(154)
plt.imshow(X_train[2], cmap=plt.get_cmap('gray'))
plt.subplot(155)
plt.imshow(X_train[3], cmap=plt.get_cmap('gray'))
# Exibir o gráfico
plt.show()
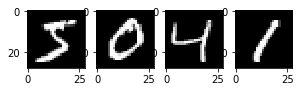
Perfeito! Vamos direto para a construção de uma rede neural simples, totalmente conectada. Antes, um pré-processamento básico.
# Achatar imagens 28*28 para um vetor de 784 por imagem
num_pixels = X_train.shape[1] * X_train.shape[2]
X_train = X_train.reshape(X_train.shape[0], num_pixels).astype('float32')
X_test = X_test.reshape(X_test.shape[0], num_pixels).astype('float32')
O que fizemos?
As imagens têm dimensão 28×28, o que dificulta o uso direto em uma MLP simples. Por isso, convertemos para uma dimensão única de 784 pixels por imagem com reshape().
Os pixels estão no intervalo 0–255. Uma boa prática é normalizar para 0–1.
X_train = X_train / 255
X_test = X_test / 255
A variável de saída é um inteiro de 0 a 9. É um problema de classificação multiclasse. Vamos fazer one‑hot encoding dos rótulos para obter uma matriz binária — uma “binarização” da categoria — e usá‑la como alvo no treinamento.
Você pode fazer isso facilmente com np_utils.to_categorical() do keras.
from keras.utils import np_utils

y_train = np_utils.to_categorical(y_train)
y_test = np_utils.to_categorical(y_test)
num_classes = y_test.shape[1]
Agora, vamos definir a arquitetura. Usaremos uma rede totalmente conectada simples. No keras, isso segue três passos:
import numpy as np
from keras.models import Sequential
from keras.layers import Dense

# Criar o modelo
model = Sequential()
model.add(Dense(num_pixels, input_dim=num_pixels, kernel_initializer='normal', activation='relu'))
model.add(Dense(num_classes, kernel_initializer='normal', activation='softmax'))

# Compilar o modelo
model.compile(loss='categorical_crossentropy', optimizer='adam', metrics=['accuracy'])
O que fizemos acima: construímos a rede de forma sequencial (pilha linear de camadas). Na primeira camada, colocamos o número de neurônios igual ao número de pixels (784) e informamos a dimensão de entrada. Inicializamos os pesos com distribuição normal e usamos relu como ativação.
Na última camada, definimos 10 neurônios (número de classes) e ativação softmax para transformar as saídas em probabilidades e permitir escolher uma das 10 classes como previsão final.
Compilamos o modelo escolhendo o otimizador (ADAM) e a loss a otimizar (categorical_crossentropy).
Agora, vamos treinar e medir o tempo. Depois, avaliamos o desempenho.
import timeit

# Para reprodutibilidade
from numpy.random import seed
seed(1)

# Treinar o modelo
startTime = timeit.default_timer()
model.fit(X_train, y_train, validation_data=(X_test, y_test), epochs=10, batch_size=200, verbose=2)
elapsedTime = timeit.default_timer() - startTime
print("Time taken for the Network to train : ",elapsedTime)

# Avaliação final do modelo
scores = model.evaluate(X_test, y_test, verbose=0)
print("Baseline Error: %.2f%%" % (100-scores[1]*100))
Train on 60000 samples, validate on 10000 samples
Epoch 1/10
 - 10s - loss: 0.2774 - acc: 0.9207 - val_loss: 0.1362 - val_acc: 0.9610
Epoch 2/10
 - 8s - loss: 0.1113 - acc: 0.9675 - val_loss: 0.0951 - val_acc: 0.9720
Epoch 3/10
 - 8s - loss: 0.0712 - acc: 0.9793 - val_loss: 0.0802 - val_acc: 0.9750
Epoch 4/10
 - 8s - loss: 0.0503 - acc: 0.9857 - val_loss: 0.0687 - val_acc: 0.9788
Epoch 5/10
 - 8s - loss: 0.0360 - acc: 0.9897 - val_loss: 0.0632 - val_acc: 0.9797
Epoch 6/10
 - 8s - loss: 0.0267 - acc: 0.9928 - val_loss: 0.0643 - val_acc: 0.9784
Epoch 7/10
 - 8s - loss: 0.0201 - acc: 0.9951 - val_loss: 0.0633 - val_acc: 0.9802
Epoch 8/10
 - 8s - loss: 0.0150 - acc: 0.9962 - val_loss: 0.0613 - val_acc: 0.9808
Epoch 9/10
 - 8s - loss: 0.0108 - acc: 0.9978 - val_loss: 0.0625 - val_acc: 0.9806
Epoch 10/10
 - 8s - loss: 0.0076 - acc: 0.9988 - val_loss: 0.0612 - val_acc: 0.9809
Time taken for the Network to train :  86.4216202873591
Baseline Error: 1.91%
Esse modelo simples foi muito bem: erro de apenas 1,91% em ~87 segundos. Agora vamos ver o poder do CLR. Primeiro, clone a implementação de CLR em keras no GitHub.
Depois de clonar, você deve ver estes arquivos no seu diretório local:

A política de CLR está implementada como um keras callback.
from keras.callbacks import *
from clr_callback import *
from keras.optimizers import Adam

# Usando a política triangular
# base_lr (taxa inicial, limite inferior do ciclo) é 0.1
clr_triangular = CyclicLR(mode='triangular')
model.compile(optimizer=Adam(0.1), loss='categorical_crossentropy', metrics=['accuracy'])
Vamos passar o clr_triangular no parâmetro callbacks ao treinar. Desta vez, usaremos um batch_size maior e também vamos medir o tempo.
startTime = timeit.default_timer()
model.fit(X_train, y_train, validation_data=(X_test, y_test), epochs=10, batch_size=2000,callbacks=[clr_triangular], verbose=2)
elapsedTime = timeit.default_timer() - startTime
print("Time taken for the Network to train : ",elapsedTime)

# Avaliação final do modelo
scores = model.evaluate(X_test, y_test, verbose=0)
print("Baseline Error: %.2f%%" % (100-scores[1]*100))
Train on 60000 samples, validate on 10000 samples
Epoch 1/10
 - 4s - loss: 0.0046 - acc: 0.9996 - val_loss: 0.0571 - val_acc: 0.9831
Epoch 2/10
 - 4s - loss: 0.0030 - acc: 0.9998 - val_loss: 0.0575 - val_acc: 0.9829
Epoch 3/10
 - 4s - loss: 0.0023 - acc: 0.9999 - val_loss: 0.0594 - val_acc: 0.9827
Epoch 4/10
 - 4s - loss: 0.0018 - acc: 0.9999 - val_loss: 0.0589 - val_acc: 0.9835
Epoch 5/10
 - 4s - loss: 0.0014 - acc: 1.0000 - val_loss: 0.0595 - val_acc: 0.9831
Epoch 6/10
 - 4s - loss: 0.0011 - acc: 1.0000 - val_loss: 0.0600 - val_acc: 0.9836
Epoch 7/10
 - 4s - loss: 0.0010 - acc: 1.0000 - val_loss: 0.0612 - val_acc: 0.9832
Epoch 8/10
 - 4s - loss: 8.2190e-04 - acc: 1.0000 - val_loss: 0.0621 - val_acc: 0.9829
Epoch 9/10
 - 4s - loss: 6.6182e-04 - acc: 1.0000 - val_loss: 0.0624 - val_acc: 0.9836
Epoch 10/10
 - 4s - loss: 5.7177e-04 - acc: 1.0000 - val_loss: 0.0635 - val_acc: 0.9836
Time taken for the Network to train :  43.23223609056981
Baseline Error: 1.64%
Deu para ver a vantagem? Surpreendente! O modelo treinou em apenas 44 segundos e ainda reduziu o erro em relação ao anterior. Excelente!
Você chegou ao fim. Neste tutorial, vimos o problema crucial de escolher uma taxa de aprendizado adequada e como o CLR mudou totalmente essa abordagem. Entendemos o CLR em boa profundidade e fizemos pequenos experimentos para ver como ele pode gerar ótimos resultados em menos tempo.
E agora? Dois desdobramentos importantes relacionados ao CLR:
Estude as duas abordagens para aprofundar ainda mais no tema. Depois do CLR, Leslie publicou A disciplined approach to neural network hyper-parameters: Part 1 -- learning rate, batch size, momentum, and weight decay, que revisita o CLR e discute como escolher valores eficientes para outros hiperparâmetros importantes. Nesse trabalho, Leslie também revisita a técnica de Super Convergence. É leitura obrigatória para quem pensa, respira e vive redes neurais.
Uma limitação do CLR é a aplicabilidade restrita. Ainda precisa ser mais robusto para uso pleno em produção.
Se você quer aprender mais sobre redes neurais, confira o curso da DataCamp Deep Learning in Python, muito bem estruturado e ministrado por Dan Becker (Head of Kaggle Learn).
aprofundar em Python e Deep Learning
Curso
Curso
blog
Yolanda Ferreiro
7 min
Tutorial
Abid Ali Awan
11 min
Tutorial
Bharath K
13 min
Tutorial
Zoumana Keita
14 min
Tutorial
Zoumana Keita
14 min
Tutorial
Abid Ali Awan
15 min