
{count, plural, one {Kursus} other {Kursus}}
Pengantar dbt
{hours} jam
34.1K
dbt semakin populer di bidang analitik berkat fungsi transformasi data dan pengujiannya. Dalam artikel ini, kami akan membahas apa itu dbt dan bagaimana Anda dapat menjalankan beberapa uji dbt untuk memastikan kualitas data. Jika Anda baru memulai dengan dbt, pastikan untuk melihat kursus Introduction to dbt kami untuk mempelajari lebih lanjut.
Seperti yang kami bahas dalam panduan terpisah, dbt (data build tool) adalah alat open-source populer yang digunakan tim data untuk mentransformasikan data mentah di gudang data mereka menjadi set data yang bersih, teruji, terdokumentasi, dan siap analitik.
Berbeda dengan alat ETL, dbt hanya berfokus pada komponen "T" (Transform) dalam pipeline data dan berjalan di atas gudang data cloud modern seperti BigQuery, Snowflake, Redshift, dan Databricks.
Salah satu fitur paling kuat dari dbt adalah kerangka kerja pengujian data bawaan, yang memungkinkan praktisi data menulis uji untuk memvalidasi asumsi tentang data mereka. Kerangka pengujian ini tidak hanya membantu menangkap masalah lebih awal tetapi juga krusial untuk menjaga kualitas dan kepercayaan data dalam basis kode analitik yang modular dan terus bertumbuh.
Pengujian adalah bagian mendasar dari rekayasa analitik. Seiring pertumbuhan dataset dan semakin banyak pemangku kepentingan yang bergantung pada data, biaya dari isu data yang tidak terdeteksi akan meningkat. Kapabilitas pengujian dbt membantu Anda:
Di dbt, uji adalah asersi berbasis SQL yang memvalidasi asumsi data. Uji di dbt terbagi menjadi dua kategori utama:
Uji ini telah ditentukan oleh dbt dan diterapkan secara deklaratif dalam berkas YAML. Uji generik mencakup kendala umum yang biasanya ada dalam pemodelan data dan pergudangan data.
Ciri-cirinya:
Empat jenis uji generik bawaan meliputi:
not_null: Memastikan sebuah kolom tidak berisi nilai NULL.unique: Memastikan nilai sebuah kolom berbeda antar baris (umumnya untuk kunci utama).accepted_values: Membatasi sebuah kolom pada himpunan nilai yang diizinkan sebelumnya.relationships: Memvalidasi integritas referensial antar tabel, memastikan kunci asing cocok dengan nilai di tabel lain.Uji-uji ini ideal untuk menegakkan integritas data dasar, khususnya terkait kunci, field kategorikal, dan relasi inti tabel.
Uji generik bekerja dengan secara otomatis menghasilkan SQL di balik layar.
Sebagai contoh, uji not_null pada kolom customer_id akan menghasilkan SQL serupa:
SELECT *
FROM {{ ref('customers') }}
WHERE customer_id IS NULL
Jika kueri ini mengembalikan baris apa pun, uji dinyatakan gagal.
Uji kustom atau tunggal adalah kueri SQL yang ditentukan pengguna dan disimpan sebagai berkas .sql di direktori tests/. Ini digunakan untuk:
Uji tunggal menawarkan fleksibilitas maksimum. Anda dapat memvalidasi data dengan hampir cara apa pun, selama kueri SQL Anda hanya mengembalikan baris yang melanggar ekspektasi.
Sebagai contoh:
Berkat fleksibilitasnya, uji kustom ideal bagi tim analitik yang ingin menegakkan kontrak kualitas data yang bernuansa di lingkungan produksi.
Makro yang disertakan dalam dbt juga dapat digunakan untuk pengujian, seperti paket dbt-utils.
Singkatnya:
|
Fitur |
Uji Generik |
Uji Kustom (Tunggal) |
|
Didefinisikan di |
schema.yml |
Berkas .sql di folder tests/ |
|
Cakupan |
Kendala umum (mis. null, kunci) |
Logika apa pun yang dapat diekspresikan dalam SQL |
|
Kompleksitas |
Sederhana |
Menengah hingga kompleks |
|
Dapat digunakan ulang |
Tinggi |
Rendah (biasanya spesifik kasus) |
|
Fleksibilitas |
Terbatas |
Tak terbatas (logika SQL apa pun) |
Mengombinasikan keduanya memberi Anda yang terbaik dari dua dunia: konsistensi dan cakupan dari uji generik, serta ketepatan dari uji kustom. Mari kita telusuri masing-masing jenis lebih lanjut.
Uji generik telah ditentukan oleh dbt dan digunakan secara deklaratif dengan menambahkannya ke berkas schema.yml model Anda.
Uji ini biasanya memvalidasi kendala seperti keunikan, non-null, integritas referensial, atau nilai dalam himpunan yang ditentukan.
Mari kita telusuri tutorial sederhana untuk mencoba uji generik di dbt.
Di berkas schema.yml yang sesuai dengan model Anda, definisikan uji di bawah bagian columns::
version: 2

models:
  - name: customers
    description: "Customer dimension table"
    columns:
      - name: customer_id
        description: "Unique customer identifier"
        tests:
          - not_null
          - unique
      - name: email
        tests:
- not_nullyaml
columns:
- name: customer_id
tests:
- not_null
- uniqueUji di atas memastikan bahwa customer_id selalu ada di setiap baris dan bersifat unik. Ini biasa digunakan untuk menegakkan asumsi bahwa customer_id adalah kunci utama tabel.
columns:
  - name: customer_type
    tests:
      - accepted_values:
          values: ['new', 'returning', 'vip']
Ini memeriksa bahwa field customer_type hanya berisi salah satu dari tiga string yang diizinkan: new, returning, atau vip. Uji ini sering digunakan untuk field kategorikal yang harus mematuhi himpunan nilai yang diketahui, seperti enum atau status.
columns:
  - name: customer_id
    tests:
      - relationships:
          to: ref('customers')
          field: id
Ini menegakkan kendala integritas referensial dengan memverifikasi bahwa setiap customer_id dalam model saat ini ada sebagai id di tabel customers. Ini meniru kendala kunci asing di SQL, tetapi pada lapisan analitik.
Ketika uji bawaan tidak memadai untuk kasus Anda, misalnya Anda ingin memvalidasi logika bisnis yang kompleks, Anda dapat menulis uji kustom menggunakan SQL. Ini dikenal sebagai uji tunggal.
1. Buat berkas .sql di dalam direktori tests/ pada proyek dbt Anda.
2. Tulis kueri SQL yang mengembalikan baris yang gagal dalam uji.
ordersDi folder tests, buat berkas bernama no_future_dates.sql.
SELECT *
FROM {{ ref('orders') }}
WHERE order_date > current_date
Uji ini memeriksa apakah ada catatan di tabel orders yang memiliki order_date di masa depan. Jika ada baris yang dikembalikan, uji gagal, memberi tahu Anda data tidak valid yang mungkin disebabkan oleh kesalahan zona waktu, bug ETL, atau entri sistem sumber yang salah.
-- Berkas: tests/duplicate_emails_per_region.sql
SELECT email, region, COUNT(*) as occurrences
FROM {{ ref('customers') }}
GROUP BY email, region
HAVING COUNT(*) > 1
Uji ini memastikan setiap email unik dalam suatu wilayah. Ini dapat mencerminkan aturan bisnis bahwa orang yang sama tidak dapat mendaftar dua kali di wilayah yang sama. Baris apa pun yang dikembalikan menunjukkan pelanggaran kualitas data.
Bagian ini menjabarkan langkah-langkah praktis untuk menerapkan, mengonfigurasi, dan menjalankan uji dbt dalam proyek serta pipeline penempatan Anda.
Sebelum mulai menulis uji atau model, Anda perlu memasang dbt dan menginisialisasi proyek baru.
1. Buat folder proyek:
Buat folder di lokasi pilihan Anda.
2. Masuk ke folder proyek:
cd dbt-test-project3. Buat lingkungan virtual Python:
python3 -m venv dbt-envSelanjutnya, aktifkan lingkungan tersebut setelah dibuat.
dbt-venv\Scripts\activate4. Pasang dbt
pip dbt install5. Buat folder .dbt
mkdir $home\.dbt6. Inisialisasi dbt
dbt init7. Buat berkas profiles.yml
Buat berkas baru di folder .dbt Anda dengan konten berikut:
austi:
  target: dev
  outputs:
    dev:
      type: sqlite
      threads: 1
      database: ./dbt_project.db
      schema: main
      schema_directory: ./schemas
      schemas_and_paths:
        main: ./dbt_project.db
Anda dapat mengganti “austi” dengan nama profil pengguna di komputer Windows Anda.
8. Buat berkas dbt_project.yml
Selanjutnya, Anda perlu membuat berkas konfigurasi lain di folder .dbt dengan konten berikut.
name: dbt_test_project
version: '1.0'
profile: austi

seeds:
  dbt_test_project:
    +quote_columns: false
Sekali lagi, ganti “austi” dengan nama profil pengguna Anda.
9. Verifikasi proyek berfungsi:
dbt debugSetelah penyiapan selesai, Anda siap mulai membuat dataset dan membangun model dbt.
Jika Anda bekerja tanpa akses ke gudang data, Anda dapat mensimulasikan uji dbt secara lokal menggunakan berkas CSV dan fungsionalitas seed dbt.
1. Buat berkas CSV: Letakkan berkas ini di dalam folder /seeds baru pada proyek dbt Anda.
Berikut penamaan yang sebaiknya digunakan:
seeds/customers.csv
customer_id,name,email,customer_type
1,Alice Smith,alice@example.com,new
2,Bob Jones,bob@example.com,returning
3,Carol Lee,carol@example.com,vip
4,David Wu,david@example.com,new
2. Buat berkas lain di direktori yang sama:
Gunakan konvensi penamaan ini:
seeds/orders.csv
order_id,customer_id,order_date,order_total,order_status
1001,1,2023-12-01,150.00,shipped
1002,2,2023-12-03,200.00,delivered
1003,1,2023-12-05,175.00,cancelled
1004,3,2024-01-01,225.00,pending
3. Buat berkas konfigurasi untuk mengidentifikasi seed:
Selanjutnya, Anda perlu membuat berkas konfigurasi bernama dbt_project.yml.
Tempel konten berikut ke dalam berkas konfigurasi.
name: dbt_test_project
version: '1.0'
profile: austi

seeds:
  dbt_test_project:
    +quote_columns: false
Ubah field profile agar sesuai dengan nama profil pengguna di komputer Windows Anda.
4. Muat data seed:
dbt seedPerintah ini membuat tabel main.customers dan main.orders dari berkas CSV. Inilah seed yang diperlukan untuk menggantikan basis data.
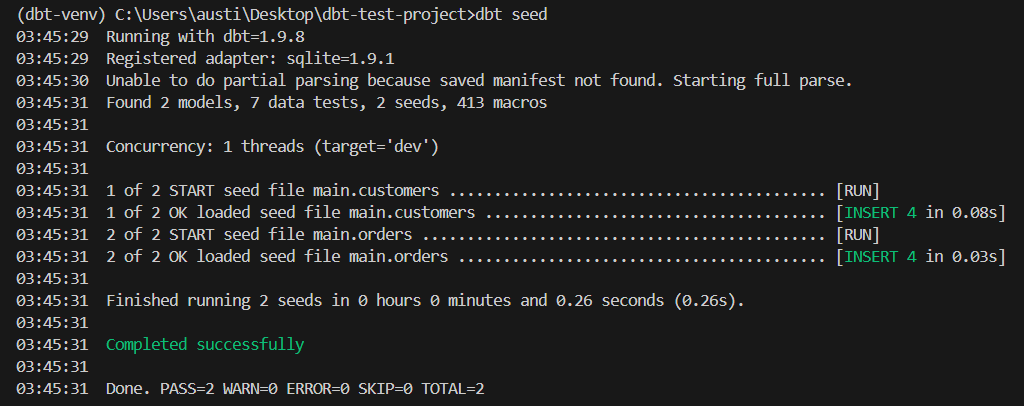
Seperti terlihat pada gambar di atas, dua seed telah ditemukan dan dimuat.
Sekarang, kita akan membuat model staging untuk mentransformasikan dan menguji data mentah Anda.
1. Buat model staging:
Buat folder baru bernama models di folder proyek Anda. Di folder tersebut, buat berkas bernama stg_customers.sql.
Tempelkan kode berikut ke dalam berkas:
SELECT
  *
FROM {{ ref('customers') }}
Di berkas lain bernama stg_orders.sql, tempelkan kode berikut:
SELECT
  *
FROM {{ ref('orders') }}
2. Definisikan uji skema:
Buat berkas baru di lokasi berikut:
models/schema.yml
Tempel yang berikut ini ke dalam berkas
version: 2

models:
  - name: stg_customers
    description: "Customer staging table"
    columns:
      - name: customer_id
        description: "Unique identifier for each customer"
        tests:
          - not_null:
              tags: [critical]
          - unique:
              tags: [critical]

      - name: email
        description: "Email address of the customer"
        tests:
          - not_null

  - name: stg_orders
    description: "Orders staging table"
    columns:
      - name: order_id
        description: "Unique identifier for each order"
        tests:
          - not_null:
              tags: [critical]
          - unique:
              tags: [critical]

      - name: customer_id
        description: "Foreign key to stg_customers"
        tests:
          - not_null:
              tags: [critical]
3. Jalankan dbt untuk membangun model staging:
dbt run --select stg_customers stg_ordersModel staging ini sekarang menjadi fondasi untuk menerapkan uji dbt menggunakan data hasil seed lokal Anda.
Contoh keluaran yang mungkin:
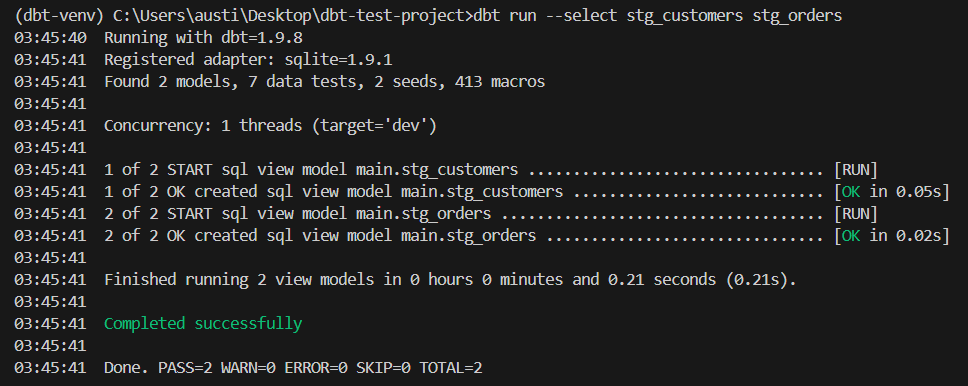
Sekarang data Anda sudah di-staging, mari terapkan uji dbt pertama menggunakan kerangka uji bawaan yang generik.
1. Buka berkas schema.yml tempat model staging Anda didefinisikan.
2. Di bawah bagian columns: pada model Anda, definisikan uji seperti not_null atau unique.
Contoh:
models:

  - name: stg_customers

    columns:

      - name: customer_id

        tests:

          - not_null

- uniquedbt test --select stg_customersBerikut hasil yang diharapkan:
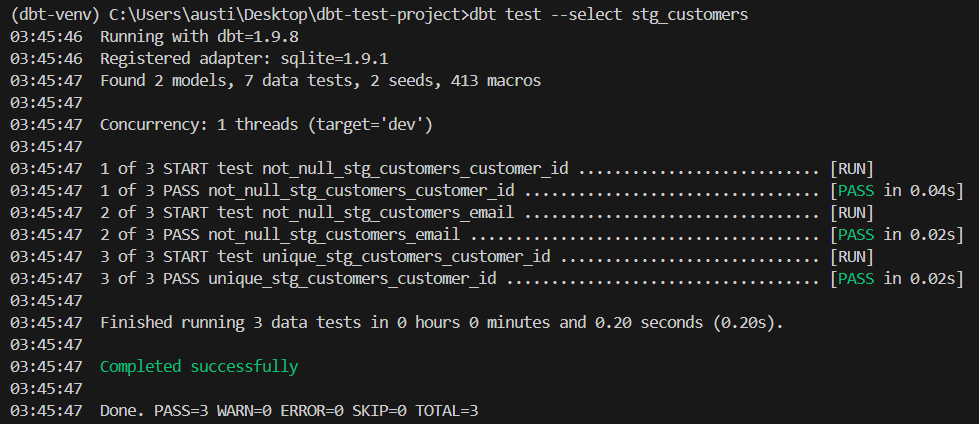
Ketika kebutuhan Anda melampaui uji bawaan, Anda dapat membuat uji kustom menggunakan SQL.
1. Buat berkas baru di folder tests/, misalnya: tests/no_future_orders.sql
2. Tambahkan logika SQL yang mengembalikan baris yang gagal:
SELECT *
FROM {{ ref('stg_orders') }}
WHERE order_date > current_date
3. Jalankan uji:
dbt test --select no_future_ordersUji ini akan gagal jika ada pesanan yang memiliki nilai order_date di masa depan.
Berikut hasil yang diharapkan:
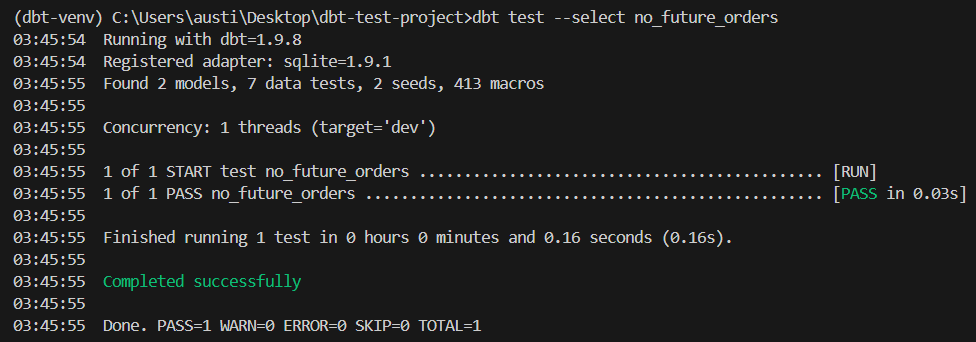
Untuk memastikan eksekusi uji yang konsisten, integrasikan uji dbt ke dalam pipeline pengembangan Anda.
1. Gunakan tag untuk memprioritaskan atau mengisolasi uji:
Anda dapat memodifikasi skema model apa pun untuk menyertakan tag berikut dalam format ini:
columns:
  - name: customer_id
    tests:
      - not_null:
          tags: [critical]
2. Jalankan uji selektif secara lokal:
dbt test --select tag:criticalJika uji berjalan dengan benar, Anda dapat mengharapkan keluaran ini:
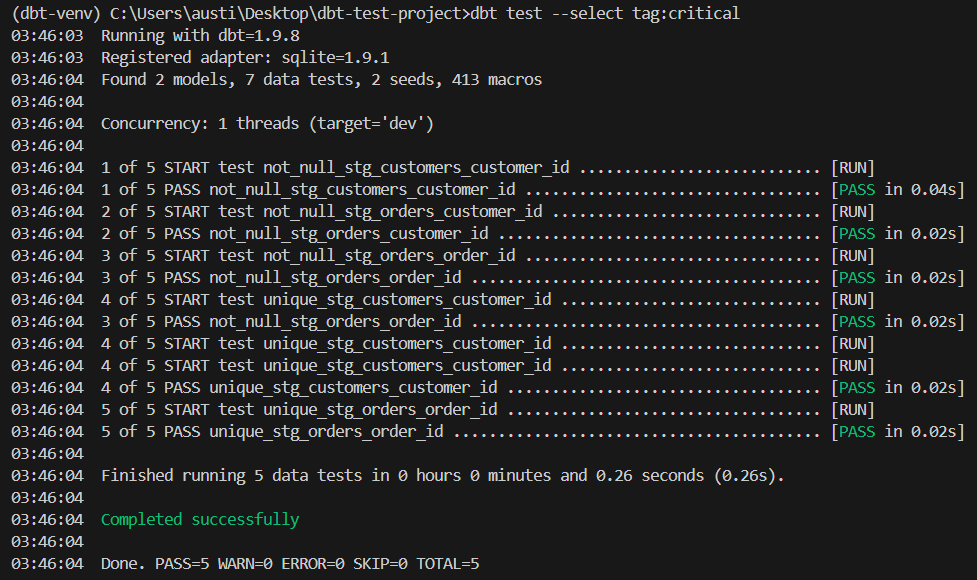
3. Konfigurasikan alur kerja CI Anda untuk menjalankan uji dbt secara otomatis. Anda dapat menghubungkannya ke platform CI seperti GitHub Actions.
Menerapkan uji dbt secara efektif bukan hanya tentang menulisnya; ini tentang mengintegrasikan pengujian ke dalam siklus pengembangan dan budaya tim Anda. Berikut beberapa praktik terbaik sebagai panduan:
Selalu terapkan uji not_null dan unique pada kolom kunci utama di tabel dimensi dan fakta. Kedua kendala ini adalah fondasi join yang andal dan logika deduplikasi pada kueri hilir.
Kunci asing krusial untuk menjaga integritas referensial. Gunakan uji relationships untuk meniru kendala kunci asing, terutama di gudang data yang tidak menegakkannya secara native.
Kendalikan konsistensi dimensi dengan menegakkan nilai spesifik pada kolom seperti status, region, atau product_type. Ini mengurangi risiko salah ketik atau perluasan enum yang tidak tertangani.
Logika bisnis tidak selalu selaras dengan aturan generik. Contoh logika yang sebaiknya Anda tulis uji kustomnya meliputi:
Jika Anda memiliki banyak uji, semuanya bisa cepat menjadi berantakan. Pertimbangkan praktik terbaik berikut agar tetap tertata:
tests/ dan berikan nama yang deskriptif.Jalankan dbt test sebagai bagian dari pipeline CI Anda. Ini memastikan kode tidak dapat digabungkan kecuali kendala kualitas data lulus. Mengintegrasikan uji ke CI/CD memperkuat akuntabilitas dan kepercayaan pada pipeline data.
Pengujian yang berlebihan atau tidak perlu (terutama pada volume data besar) dapat memperlambat penempatan. Fokus pada uji yang:
Hindari menguji field terhitung kecuali jika merupakan bagian dari SLA kontraktual.
Untuk contoh uji lanjutan, kita dapat melakukan uji deteksi outlier.
Buat berkas SQL di folder tests Anda dengan kode berikut:
SELECT *
FROM {{ ref('orders') }}
WHERE order_total > 100000
Ini adalah uji deteksi outlier dasar. Jika bisnis Anda umumnya melihat pesanan di bawah $10.000, Anda dapat menandai pesanan di atas $100.000 untuk ditinjau secara manual. Meskipun bukan pelanggaran kualitas data yang ketat, ini dapat berguna untuk deteksi penipuan atau pemantauan operasional.
Seiring skala proyek dbt Anda dan pertumbuhan cakupan uji, kinerja menjadi semakin penting. Bagian ini menguraikan teknik dan strategi untuk menjaga efisiensi uji dan mengendalikan biaya komputasi.
Untuk pengujian, coba teknik berikut untuk mengoptimalkan kinerja:
dbt test --select customers
dbt test --exclude tag:slowMenerapkan strategi pengelolaan biaya memastikan uji dbt tetap berkinerja baik dan efisien biaya, terutama di lingkungan di mana penagihan komputasi terkait dengan kompleksitas dan frekuensi kueri.
Beberapa strategi antara lain:
Uji dbt adalah cara ampuh untuk memastikan kualitas data yang tinggi, mengotomatiskan pemeriksaan validasi, dan menangkap masalah lebih awal di pipeline transformasi Anda. Uji generik dan kustom dapat digunakan untuk membangun alur kerja data yang tangguh dan mudah dirawat.
Pelajari lebih lanjut tentang dbt di kursus Introduction to dbt kami atau tutorial dbt kami.
Kursus Teratas di DataCamp
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Program} other {Program}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



