
Last chance! 50% off DataCamp Premium
Sale ends in
एनालिटिक्स क्षेत्र में डेटा ट्रांसफॉर्मेशन और टेस्टिंग क्षमताओं के कारण dbt की लोकप्रियता बढ़ रही है। इस लेख में, हम बताएंगे कि dbt क्या है और आप डेटा गुणवत्ता सुनिश्चित करने के लिए dbt में कौन-कौन से टेस्ट चला सकते हैं। यदि आप dbt के साथ अभी शुरुआत कर रहे हैं, तो अधिक जानने के लिए हमारे Introduction to dbt कोर्स को अवश्य देखें।
जैसा कि हम अपने अलग गाइड dbt (data build tool) में समझाते हैं, यह एक लोकप्रिय ओपन-सोर्स टूल है जिसका उपयोग डेटा टीमें अपने वेयरहाउस की कच्ची डेटा को स्वच्छ, टेस्टेड, डॉक्युमेंटेड और एनालिटिक्स-रेडी डेटासेट में बदलने के लिए करती हैं।
ETL टूल्स के विपरीत, dbt डेटा पाइपलाइन के केवल "T" (Transform) घटक पर केंद्रित रहता है और BigQuery, Snowflake, Redshift और Databricks जैसे आधुनिक क्लाउड डेटा वेयरहाउस के ऊपर काम करता है।
dbt की सबसे शक्तिशाली विशेषताओं में से एक इसका बिल्ट-इन डेटा टेस्टिंग फ्रेमवर्क है, जो डेटा प्रैक्टिशनर्स को अपने डेटा के बारे में मान्यताओं की पुष्टि करने के लिए टेस्ट लिखने देता है। यह फ्रेमवर्क न केवल शुरुआती चरण में समस्याओं को पकड़ने में सहायक है, बल्कि बढ़ते, मॉड्यूलर एनालिटिक्स कोडबेस में डेटा गुणवत्ता और भरोसा बनाए रखने के लिए भी महत्वपूर्ण है।
टेस्टिंग, एनालिटिक्स इंजीनियरिंग का आधार है। जैसे-जैसे डेटासेट बढ़ते हैं और अधिक स्टेकहोल्डर्स डेटा पर निर्भर होते हैं, अनदेखी डेटा समस्याओं की लागत बढ़ जाती है। dbt की टेस्टिंग क्षमताएं आपकी मदद करती हैं:
dbt में, टेस्ट SQL-आधारित एसेर्शन होते हैं जो डेटा संबंधी मान्यताओं को सत्यापित करते हैं। dbt में टेस्ट दो मुख्य श्रेणियों में आते हैं:
ये टेस्ट dbt द्वारा पूर्व-परिभाषित होते हैं और YAML फाइलों में घोषणात्मक रूप से लागू किए जाते हैं। जेनेरिक टेस्ट आम तौर पर डेटा मॉडलिंग और डेटा वेयरहाउसिंग में पाए जाने वाले सामान्य बाधाओं को कवर करते हैं।
ये हैं:
बिल्ट-इन जेनेरिक टेस्ट के चार प्रकार शामिल हैं:
not_null: सुनिश्चित करता है कि किसी कॉलम में कोई NULL मान न हो।unique: सुनिश्चित करता है कि किसी कॉलम के मान अलग-अलग हों (आमतौर पर प्राइमरी की के लिए प्रयोग होता है)।accepted_values: किसी कॉलम को पूर्व-परिभाषित अनुमत मानों के सेट तक सीमित करता है।relationships: तालिकाओं के बीच रेफरेंशियल इंटीग्रिटी सत्यापित करता है, सुनिश्चित करता है कि फॉरेन की के मान दूसरी तालिका में मौजूद मानों से मेल खाते हों।ये टेस्ट बेसलाइन डेटा अखंडता लागू करने के लिए उपयुक्त हैं, विशेष रूप से की, श्रेणीबद्ध फील्ड और कोर टेबल रिलेशनशिप के आसपास।
जेनेरिक टेस्ट पर्दे के पीछे स्वचालित रूप से SQL जनरेट करके काम करते हैं।
उदाहरण के लिए, customer_id कॉलम पर not_null टेस्ट निम्न जैसा SQL बनाता है:
SELECT *
FROM {{ ref('customers') }}
WHERE customer_id IS NULL
यदि यह क्वेरी कोई पंक्तियाँ लौटाती है, तो टेस्ट असफल हो जाता है।
कस्टम या सिंगुलर टेस्ट यूज़र-परिभाषित SQL क्वेरी होती हैं जिन्हें tests/ डायरेक्टरी में .sql फाइलों के रूप में सेव किया जाता है। इनका उपयोग किया जाता है:
सिंगुलर टेस्ट अधिकतम लचीलापन देते हैं। जब तक आपकी SQL क्वेरी केवल वे पंक्तियाँ लौटाती है जो अपेक्षाओं का उल्लंघन करती हैं, आप लगभग किसी भी तरह से डेटा वैलिडेट कर सकते हैं।
उदाहरण के लिए:
अपने लचीलेपन के कारण, कस्टम टेस्ट उन एनालिटिक्स टीमों के लिए उपयुक्त हैं जो प्रोडक्शन में सूक्ष्म डेटा गुणवत्ता कॉन्ट्रैक्ट लागू करना चाहती हैं।
dbt में शामिल मैक्रोज़ का उपयोग भी टेस्टिंग के लिए किया जा सकता है, जैसे dbt-utils पैकेज।
संक्षेप में:
|
फ़ीचर |
जेनेरिक टेस्ट |
कस्टम (सिंगुलर) टेस्ट |
|
कहाँ परिभाषित |
schema.yml |
tests/ फोल्डर में .sql फाइलें |
|
कवरेज |
सामान्य बाधाएँ (जैसे nulls, keys) |
SQL में व्यक्त होने वाला कोई भी लॉजिक |
|
जटिलता |
सरल |
मध्यम से जटिल |
|
पुन: उपयोग |
उच्च |
कम (आमतौर पर केस-विशिष्ट) |
|
लचीलापन |
सीमित |
असीमित (कोई भी SQL लॉजिक) |
दोनों प्रकारों को मिलाकर आप दोनों दुनिया का सर्वश्रेष्ठ पाते हैं: जेनेरिक टेस्ट से स्थिरता और कवरेज, और कस्टम टेस्ट से परिशुद्धता। आइए प्रत्येक प्रकार को विस्तार से देखें।
जेनेरिक टेस्ट dbt द्वारा पूर्व-परिभाषित होते हैं और आपके मॉडल की schema.yml फाइल में जोड़कर घोषणात्मक रूप से उपयोग किए जाते हैं।
ये टेस्ट आम तौर पर यूनिकनेस, नॉन-नल, रेफरेंशियल इंटीग्रिटी या परिभाषित सेट के मानों जैसी बाधाओं को वैलिडेट करते हैं।
आइए dbt में जेनेरिक टेस्ट आज़माने के लिए एक सरल ट्यूटोरियल देखें।
अपने मॉडल की संबंधित schema.yml फाइल में, columns: सेक्शन के अंतर्गत टेस्ट परिभाषित करें:
version: 2

models:
  - name: customers
    description: "Customer dimension table"
    columns:
      - name: customer_id
        description: "Unique customer identifier"
        tests:
          - not_null
          - unique
      - name: email
        tests:
- not_nullyaml
columns:
- name: customer_id
tests:
- not_null
- uniqueऊपर दिया गया टेस्ट सुनिश्चित करता है कि customer_id हर पंक्ति में मौजूद हो और अलग-अलग भी हो। यह आम तौर पर इस धारणा को लागू करने के लिए उपयोग किया जाता है कि customer_id तालिका के लिए प्राइमरी की है।
columns:
  - name: customer_type
    tests:
      - accepted_values:
          values: ['new', 'returning', 'vip']
यह जाँचता है कि customer_type फील्ड में केवल इन तीन अनुमत स्ट्रिंग्स में से एक ही हो: new, returning, या vip। यह टेस्ट अक्सर श्रेणीबद्ध फील्ड के लिए उपयोग होता है जिन्हें ज्ञात मानों के सेट, जैसे एनम या स्टेटस, के अनुरूप होना चाहिए।
columns:
  - name: customer_id
    tests:
      - relationships:
          to: ref('customers')
          field: id
यह रेफरेंशियल इंटीग्रिटी बाधा लागू करता है, यह सत्यापित करके कि मौजूदा मॉडल का हर customer_id, customers तालिका में एक id के रूप में मौजूद है। यह SQL में फॉरेन की बाधा की तरह है, लेकिन एनालिटिक्स लेयर पर।
जब बिल्ट-इन टेस्ट आपके उपयोग-केस के लिए पर्याप्त नहीं होते, उदाहरण के लिए आप जटिल बिज़नेस लॉजिक वैलिडेट करना चाहते हैं, तो आप SQL से कस्टम टेस्ट लिख सकते हैं। इन्हें सिंगुलर टेस्ट कहा जाता है।
1. अपने dbt प्रोजेक्ट के tests/ डायरेक्टरी के अंदर एक .sql फाइल बनाएं।
2. ऐसी SQL क्वेरी लिखें जो केवल वे पंक्तियाँ लौटाए जो टेस्ट में असफल हों।
orders में भविष्य की तिथियाँ न होंtests फोल्डर में no_future_dates.sql नाम की फाइल बनाएं।
SELECT *
FROM {{ ref('orders') }}
WHERE order_date > current_date
यह टेस्ट जाँचता है कि orders तालिका में किसी भी रिकॉर्ड का order_date भविष्य में तो नहीं है। यदि पंक्तियाँ लौटती हैं, तो टेस्ट असफल हो जाता है और आपको अमान्य डेटा के बारे में सचेत करता है, जो टाइमज़ोन त्रुटियों, ETL बग या सोर्स सिस्टम में गलत एंट्री के कारण हो सकता है।
-- फ़ाइल: tests/duplicate_emails_per_region.sql
SELECT email, region, COUNT(*) as occurrences
FROM {{ ref('customers') }}
GROUP BY email, region
HAVING COUNT(*) > 1
यह टेस्ट सुनिश्चित करता है कि किसी दिए गए क्षेत्र के भीतर प्रत्येक ईमेल यूनिक हो। यह ऐसा बिज़नेस रूल दर्शा सकता है कि वही व्यक्ति एक ही क्षेत्र में दो बार रजिस्टर नहीं कर सकता। लौटाई गई कोई भी पंक्ति डेटा गुणवत्ता उल्लंघन को इंगित करती है।
यह सेक्शन आपके प्रोजेक्ट और डिप्लॉयमेंट पाइपलाइनों में dbt टेस्ट को लागू, कॉन्फ़िगर और चलाने के व्यावहारिक चरणों से होकर गुजरता है।
टेस्ट या मॉडल लिखना शुरू करने से पहले, आपके पास dbt इंस्टॉल होना चाहिए और एक नया प्रोजेक्ट इनिशियलाइज़ होना चाहिए।
1. प्रोजेक्ट फोल्डर बनाएं:
अपनी पसंद के स्थान पर एक फोल्डर बनाएं।
2. प्रोजेक्ट फोल्डर में जाएँ:
cd dbt-test-project3. वर्चुअल Python वातावरण बनाएं:
python3 -m venv dbt-envइसके बाद, वातावरण बन जाने पर उसे सक्रिय करें।
dbt-venv\Scripts\activate4. dbt इंस्टॉल करें
pip dbt install5. .dbt फोल्डर बनाएं
mkdir $home\.dbt6. dbt इनिशियलाइज़ करें
dbt init7. profiles.yml फाइल बनाएं
अपनी .dbt फोल्डर में निम्न सामग्री के साथ नई फाइल बनाएं:
austi:
  target: dev
  outputs:
    dev:
      type: sqlite
      threads: 1
      database: ./dbt_project.db
      schema: main
      schema_directory: ./schemas
      schemas_and_paths:
        main: ./dbt_project.db
आप Windows कंप्यूटर के अपने यूज़र प्रोफ़ाइल नाम के स्थान पर “austi” को बदल सकते हैं।
8. dbt_project.yml फाइल बनाएं
इसके बाद, आपको .dbt फोल्डर में निम्न सामग्री के साथ एक और कॉन्फ़िग फाइल बनानी होगी।
name: dbt_test_project
version: '1.0'
profile: austi

seeds:
  dbt_test_project:
    +quote_columns: false
फिर से, “austi” को अपने यूज़र प्रोफ़ाइल नाम से बदलें।
9. प्रोजेक्ट के काम करने की पुष्टि करें:
dbt debugसेटअप पूरा हो जाने के बाद, आप डेटासेट बनाने और dbt मॉडल तैयार करने के लिए तैयार हैं।
यदि आप डेटा वेयरहाउस तक पहुँच के बिना काम कर रहे हैं, तो आप CSV फाइलों और dbt की seed क्षमता का उपयोग करके लोकली dbt टेस्ट का सिमुलेशन कर सकते हैं।
1. CSV फाइलें बनाएं: इन्हें अपने dbt प्रोजेक्ट के नए /seeds फोल्डर में रखें।
इसे इस प्रकार नाम दें:
seeds/customers.csv
customer_id,name,email,customer_type
1,Alice Smith,alice@example.com,new
2,Bob Jones,bob@example.com,returning
3,Carol Lee,carol@example.com,vip
4,David Wu,david@example.com,new
2. उसी डायरेक्टरी में एक और फाइल बनाएं:
इस नामकरण का उपयोग करें:
seeds/orders.csv
order_id,customer_id,order_date,order_total,order_status
1001,1,2023-12-01,150.00,shipped
1002,2,2023-12-03,200.00,delivered
1003,1,2023-12-05,175.00,cancelled
1004,3,2024-01-01,225.00,pending
3. सीड्स को पहचानने के लिए एक कॉन्फ़िग फाइल बनाएं:
इसके बाद, आपको dbt_project.yml नाम की एक कॉन्फ़िग फाइल बनानी होगी।
नीचे दी गई सामग्री को कॉन्फ़िग फाइल में पेस्ट करें।
name: dbt_test_project
version: '1.0'
profile: austi

seeds:
  dbt_test_project:
    +quote_columns: false
profile फ़ील्ड को अपने Windows कंप्यूटर के यूज़र प्रोफ़ाइल नाम से मिलान करने के लिए बदलें।
4. सीड डेटा लोड करें:
dbt seedयह कमांड CSV फाइलों से main.customers और main.orders टेबल बनाता है। ये एक डेटाबेस के स्थानापन्न के रूप में आवश्यक सीड्स हैं।
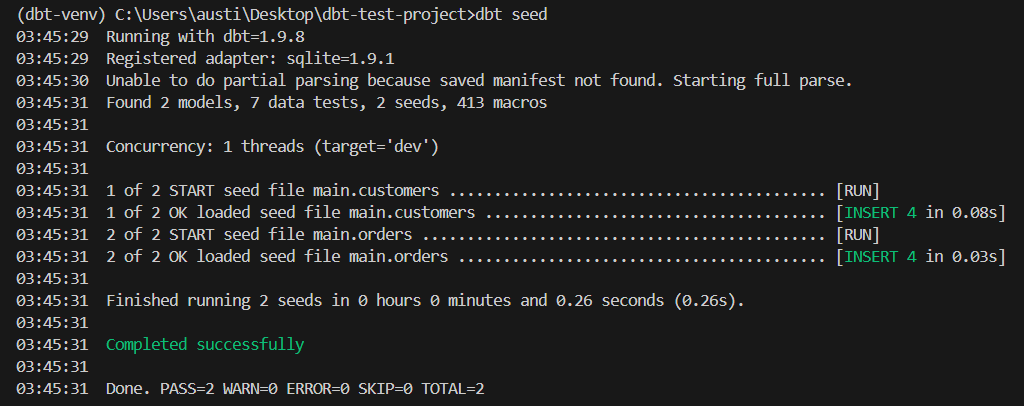
जैसा कि ऊपर की छवि में दिख रहा है, दो सीड मिले हैं और लोड कर दिए गए हैं।
अब हम आपके कच्चे डेटा को ट्रांसफॉर्म और टेस्ट करने के लिए स्टेजिंग मॉडल बनाएँगे।
1. स्टेजिंग मॉडल बनाएं:
अपने प्रोजेक्ट फोल्डर में models नाम का नया फोल्डर बनाएं। उस फोल्डर में stg_customers.sql नाम की फाइल बनाएं।
फाइल में निम्न कोड पेस्ट करें:
SELECT
  *
FROM {{ ref('customers') }}
एक और फाइल stg_orders.sql में निम्न कोड पेस्ट करें:
SELECT
  *
FROM {{ ref('orders') }}
2. स्कीमा टेस्ट परिभाषित करें:
निम्न स्थान पर नई फाइल बनाएं:
models/schema.yml
फाइल में यह पेस्ट करें
version: 2

models:
  - name: stg_customers
    description: "Customer staging table"
    columns:
      - name: customer_id
        description: "Unique identifier for each customer"
        tests:
          - not_null:
              tags: [critical]
          - unique:
              tags: [critical]

      - name: email
        description: "Email address of the customer"
        tests:
          - not_null

  - name: stg_orders
    description: "Orders staging table"
    columns:
      - name: order_id
        description: "Unique identifier for each order"
        tests:
          - not_null:
              tags: [critical]
          - unique:
              tags: [critical]

      - name: customer_id
        description: "Foreign key to stg_customers"
        tests:
          - not_null:
              tags: [critical]
3. स्टेजिंग मॉडल बनाने के लिए dbt चलाएँ:
dbt run --select stg_customers stg_ordersये स्टेजिंग मॉडल अब आपके लोकल सीडेड डेटा का उपयोग करके dbt टेस्ट लागू करने के लिए आधार का काम करते हैं।
एक उदाहरण आउटपुट इस प्रकार होगा:
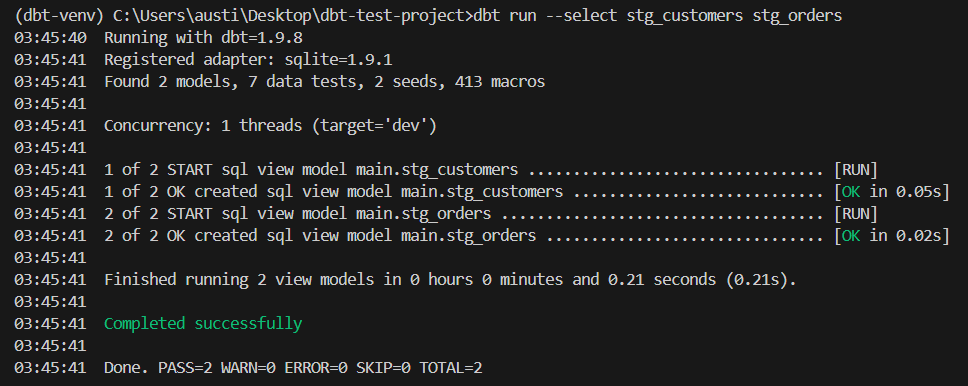
अब जब आपका डेटा स्टेज हो चुका है, तो आइए जेनेरिक बिल्ट-इन टेस्टिंग फ्रेमवर्क का उपयोग करके आपका पहला dbt टेस्ट लागू करें।
1. वह schema.yml फाइल खोलें जहाँ आपका स्टेजिंग मॉडल परिभाषित है।
2. अपने मॉडल के columns: सेक्शन के अंतर्गत, not_null या unique जैसा कोई टेस्ट परिभाषित करें।
उदाहरण:
models:

  - name: stg_customers

    columns:

      - name: customer_id

        tests:

          - not_null

- uniquedbt test --select stg_customersअपेक्षित परिणाम इस प्रकार होगा:
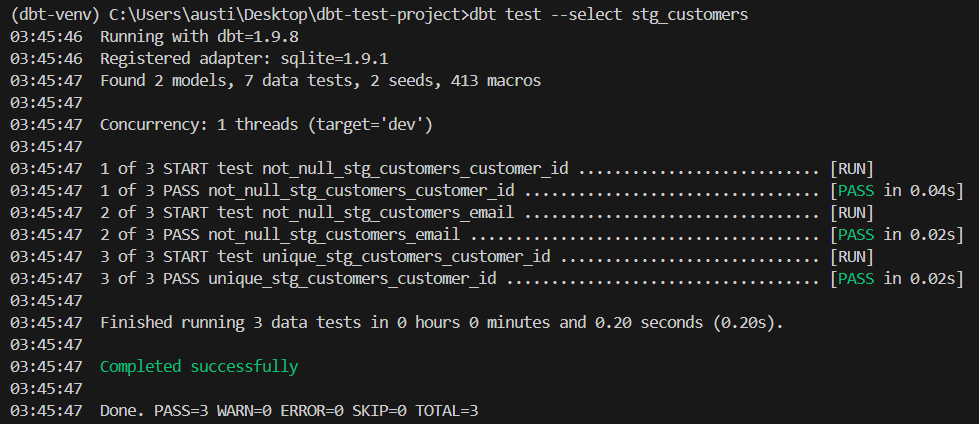
जब आपकी आवश्यकताएँ बिल्ट-इन टेस्ट से आगे बढ़ें, तो आप SQL का उपयोग करके कस्टम टेस्ट बना सकते हैं।
1. tests/ फोल्डर में नई फाइल बनाएं, उदाहरण: tests/no_future_orders.sql
2. ऐसी SQL लॉजिक जोड़ें जो असफल पंक्तियाँ लौटाए:
SELECT *
FROM {{ ref('stg_orders') }}
WHERE order_date > current_date
3. टेस्ट चलाएँ:
dbt test --select no_future_ordersयदि किसी भी ऑर्डर में भविष्य-तिथि वाले order_date मान होंगे, तो यह टेस्ट असफल हो जाएगा।
अपेक्षित परिणाम इस प्रकार होगा:
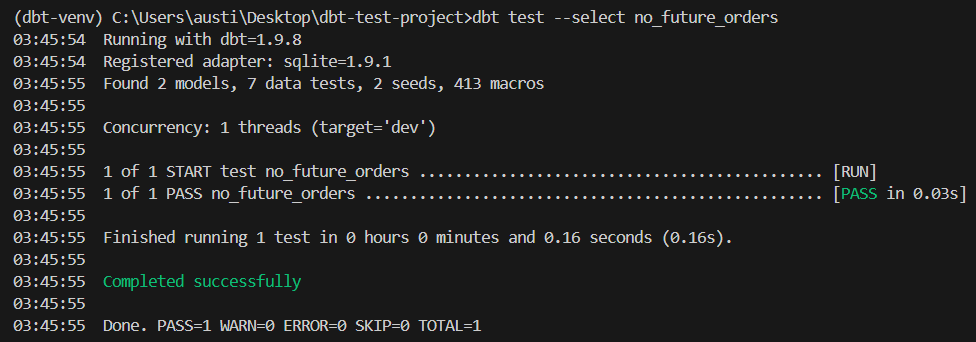
सुसंगत टेस्ट निष्पादन सुनिश्चित करने के लिए, dbt टेस्ट को अपनी डेवलपमेंट पाइपलाइन में एकीकृत करें।
1. टेस्ट को प्राथमिकता देने या अलग करने के लिए टैग्स का उपयोग करें:
आप किसी भी मॉडल स्कीमा को निम्न प्रारूप में टैग्स शामिल करने के लिए संशोधित कर सकते हैं:
columns:
  - name: customer_id
    tests:
      - not_null:
          tags: [critical]
2. लोकली चयनित टेस्ट चलाएँ:
dbt test --select tag:criticalयदि टेस्ट सही चलते हैं, तो आपको यह आउटपुट दिखेगा:
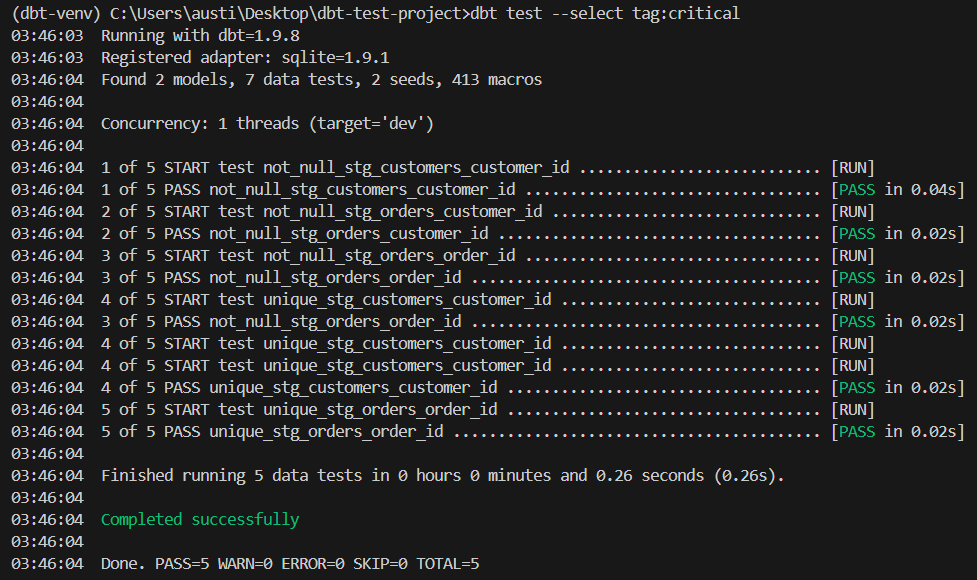
3. अपनी CI वर्कफ़्लो को इस प्रकार कॉन्फ़िगर करें कि dbt टेस्ट स्वचालित रूप से चलें। आप इसे GitHub Actions जैसे CI प्लेटफ़ॉर्म से कनेक्ट कर सकते हैं।
dbt टेस्ट को प्रभावी ढंग से लागू करना केवल उन्हें लिखने के बारे में नहीं है; यह आपकी टीम के डेवलपमेंट लाइफसाइकल और संस्कृति में टेस्टिंग को एकीकृत करने के बारे में है। यहाँ कुछ सर्वोत्तम प्रथाएँ दी गई हैं:
डायमेंशन और फैक्ट टेबल में प्राइमरी की कॉलम पर हमेशा not_null और unique टेस्ट लागू करें। ये दोनों बाधाएँ डाउनस्ट्रीम क्वेरी में भरोसेमंद जॉइन और डिडुप्लीकेशन लॉजिक की नींव हैं।
फॉरेन की रेफरेंशियल इंटीग्रिटी बनाए रखने के लिए महत्वपूर्ण हैं। relationships टेस्ट का उपयोग करके फॉरेन की बाधाओं की नकल करें, खासकर उन डेटा वेयरहाउस में जो उन्हें मूल रूप से लागू नहीं करते।
status, region, या product_type जैसे कॉलम में विशिष्ट मान लागू करके डाइमेंशनल संगति नियंत्रित करें। इससे टाइपो या अनियोजित enum विस्तार का जोखिम कम होता है।
बिज़नेस लॉजिक हमेशा जेनेरिक नियमों में फिट नहीं बैठता। ऐसे लॉजिक के उदाहरण जिनके लिए आपको कस्टम टेस्ट लिखने चाहिए, शामिल हैं:
यदि आपके पास बहुत से टेस्ट हैं, तो चीजें जल्दी ही उलझ सकती हैं। उन्हें व्यवस्थित रखने के लिए ये सर्वोत्तम प्रथाएँ अपनाएँ:
tests/ फोल्डर में रखें और उनका नाम वर्णनात्मक रखें।dbt test को अपनी CI पाइपलाइन का हिस्सा बनाकर चलाएँ। इससे सुनिश्चित होता है कि जब तक डेटा गुणवत्ता बाधाएँ पास नहीं होतीं, कोड मर्ज नहीं हो सकता। CI/CD में टेस्ट को एकीकृत करना डेटा पाइपलाइन में जवाबदेही और भरोसा मजबूत करता है।
अत्यधिक या अनावश्यक टेस्टिंग (खासकर बड़े डेटा वॉल्यूम पर) डिप्लॉयमेंट को धीमा कर सकती है। उन टेस्ट पर ध्यान दें जो:
कैल्क्युलेटेड फील्ड का परीक्षण करने से बचें जब तक कि वे किसी संविदात्मक SLA का हिस्सा न हों।
एक उन्नत टेस्ट उदाहरण के रूप में, हम आउटलायर डिटेक्शन टेस्ट कर सकते हैं।
अपनी tests फोल्डर में निम्न कोड के साथ एक SQL फाइल बनाएं:
SELECT *
FROM {{ ref('orders') }}
WHERE order_total > 100000
यह एक बेसिक आउटलायर डिटेक्शन टेस्ट है। यदि आपके बिज़नेस में आमतौर पर $10,000 से कम के ऑर्डर होते हैं, तो आप $100,000 से ऊपर के ऑर्डर को मैन्युअल समीक्षा के लिए फ़्लैग कर सकते हैं। यह सख्त डेटा गुणवत्ता उल्लंघन नहीं है, लेकिन धोखाधड़ी का पता लगाने या परिचालन मॉनिटरिंग के लिए मूल्यवान हो सकता है।
जैसे-जैसे आपका dbt प्रोजेक्ट स्केल होता है और टेस्ट कवरेज बढ़ता है, परफॉर्मेंस अधिक महत्वपूर्ण हो जाता है। यह सेक्शन टेस्ट की दक्षता बनाए रखने और कंप्यूटेशनल लागत को नियंत्रित करने के लिए तकनीकें और रणनीतियाँ बताता है।
टेस्टिंग के लिए, परफॉर्मेंस ऑप्टिमाइज़ करने हेतु ये तकनीकें आज़माएँ:
dbt test --select customers
dbt test --exclude tag:slow
लागत प्रबंधन रणनीतियाँ लागू करने से dbt टेस्ट प्रदर्शनकारी और किफायती बने रहते हैं, विशेषकर वहाँ जहाँ कंप्यूट बिलिंग क्वेरी की जटिलता और आवृत्ति से जुड़ी होती है।
कुछ रणनीतियाँ:
dbt टेस्ट डेटा गुणवत्ता सुनिश्चित करने, वैलिडेशन चेक को स्वचालित करने और आपके ट्रांसफॉर्मेशन पाइपलाइन में समस्याओं को शुरुआती चरण में पकड़ने का एक शक्तिशाली तरीका हैं। मजबूत और मेंटेन करने योग्य डेटा वर्कफ़्लो बनाने के लिए जेनेरिक और कस्टम टेस्ट दोनों का उपयोग किया जा सकता है।
dbt के बारे में अधिक जानें हमारे Introduction to dbt कोर्स या हमारे dbt ट्यूटोरियल में।
शीर्ष DataCamp कोर्स
कोर्स
लर्निंग पाथ
कोर्स
