
{count, plural, one {Cursus} other {Cursussen}}
Introductie tot dbt
{hours} uur
34.1K
dbt wint aan populariteit in de analytics-wereld dankzij de functies voor datatransformatie en testen. In dit artikel leggen we uit wat dbt is en hoe je dbt-tests kunt uitvoeren om datakwaliteit te waarborgen. Begin je net met dbt? Bekijk dan zeker onze cursus Introduction to dbt voor meer informatie.
Zoals we uitleggen in onze aparte gids, dbt (data build tool) is een populair open-sourcetool dat door datateams wordt gebruikt om ruwe data in hun warehouse om te zetten in schone, geteste, gedocumenteerde en analytics-klare datasets.
In tegenstelling tot ETL-tools richt dbt zich uitsluitend op de "T" (Transform) in de datapijplijn en werkt het bovenop moderne cloud datawarehouses zoals BigQuery, Snowflake, Redshift en Databricks.
Een van de krachtigste functies van dbt is het ingebouwde datatestframework, waarmee dataprofessionals tests kunnen schrijven die aannames over hun data valideren. Dit testframework helpt niet alleen om problemen vroeg te signaleren, maar is ook cruciaal om datakwaliteit en vertrouwen te behouden in een groeiende, modulaire analytics-codebase.
Testen is een fundament van analytics engineering. Naarmate datasets groeien en meer stakeholders afhankelijk zijn van data, stijgen de kosten van onopgemerkte dataproblemen. De testmogelijkheden van dbt helpen je om:
In dbt zijn tests SQL-gebaseerde beweringen die data-aannames valideren. Tests in dbt vallen in twee hoofdcategorieën:
Deze tests zijn vooraf gedefinieerd door dbt en worden declaratief toegepast in YAML-bestanden. Generieke tests dekken veelvoorkomende beperkingen die typisch zijn in datamodellering en datawarehousing.
Ze zijn:
De vier ingebouwde generieke testtypes zijn:
not_null: Zorgt ervoor dat een kolom geen NULL-waarden bevat.unique: Zorgt ervoor dat waarden in een kolom uniek zijn over rijen (vaak gebruikt voor primaire sleutels).accepted_values: Beperkt een kolom tot een vooraf gedefinieerde set toegestane waarden.relationships: Valideert referentiële integriteit tussen tabellen en zorgt dat foreign keys overeenkomen met waarden in een andere tabel.Deze tests zijn ideaal om basis-dataintegriteit af te dwingen, vooral rond sleutels, categorische velden en kernrelaties tussen tabellen.
Generieke tests werken door onder water automatisch SQL te genereren.
Een not_null-test op de kolom customer_id genereert bijvoorbeeld SQL zoals:
SELECT *
FROM {{ ref('customers') }}
WHERE customer_id IS NULL
Als deze query rijen retourneert, faalt de test.
Aangepaste of singular tests zijn door de gebruiker gedefinieerde SQL-queries die als .sql-bestanden in de map tests/ worden opgeslagen. Deze worden gebruikt voor:
Singular tests bieden maximale flexibiliteit. Je kunt data op vrijwel elke manier valideren, zolang je SQL-query alleen rijen retourneert die verwachtingen schenden.
Bijvoorbeeld:
Vanwege hun flexibiliteit zijn aangepaste tests ideaal voor analytics-teams die genuanceerde datakwaliteitscontracten willen afdwingen in productie.
Ook macro’s die in dbt zijn opgenomen kunnen worden gebruikt om te testen, zoals het dbt-utils-pakket.
Samengevat:
|
Functie |
Generieke tests |
Aangepaste (singular) tests |
|
Gedefinieerd in |
schema.yml |
.sql-bestanden in map tests/ |
|
Dekking |
Algemene constraints (bijv. nulls, sleutels) |
Elke in SQL uit te drukken logica |
|
Complexiteit |
Eenvoudig |
Middelmatig tot complex |
|
Herbruikbaarheid |
Hoog |
Laag (meestal casus-specifiek) |
|
Flexibiliteit |
Beperkt |
Onbeperkt (elke SQL-logica) |
Door beide types te combineren krijg je het beste van twee werelden: consistentie en dekking via generieke tests, en precisie via aangepaste tests. Laten we elk type in meer detail bekijken.
Generieke tests zijn vooraf gedefinieerd door dbt en worden declaratief gebruikt door ze toe te voegen aan het schema.yml-bestand van je model.
Deze tests valideren doorgaans beperkingen zoals uniciteit, niet-nullbaarheid, referentiële integriteit of waarden binnen een gedefinieerde set.
Laten we een eenvoudige tutorial doornemen om generieke tests in dbt uit te proberen.
Definieer in het bijbehorende schema.yml-bestand van je model tests onder de sectie columns::
version: 2

models:
  - name: customers
    description: "Customer dimension table"
    columns:
      - name: customer_id
        description: "Unique customer identifier"
        tests:
          - not_null
          - unique
      - name: email
        tests:
- not_nullyaml
columns:
- name: customer_id
tests:
- not_null
- uniqueDe bovenstaande test zorgt ervoor dat customer_id in elke rij aanwezig is en uniek is. Dit wordt vaak gebruikt om de aanname af te dwingen dat customer_id de primaire sleutel van de tabel is.
columns:
  - name: customer_type
    tests:
      - accepted_values:
          values: ['new', 'returning', 'vip']
Dit controleert dat het veld customer_type alleen een van de drie toegestane strings bevat: new, returning of vip. Deze test wordt vaak gebruikt voor categorische velden die moeten voldoen aan een bekende set waarden, zoals enums of statussen.
columns:
  - name: customer_id
    tests:
      - relationships:
          to: ref('customers')
          field: id
Dit dwingt een constraint voor referentiële integriteit af door te verifiëren dat elke customer_id in het huidige model bestaat als een id in de tabel customers. Het bootst een foreign key-constraint in SQL na, maar dan op de analytics-laag.
Als ingebouwde tests niet volstaan voor jouw usecase, bijvoorbeeld wanneer je complexe bedrijfslogica wilt valideren, kun je aangepaste tests schrijven met SQL. Deze staan bekend als singular tests.
1. Maak een .sql-bestand in de map tests/ van je dbt-project.
2. Schrijf een SQL-query die rijen retourneert die voor de test falen.
ordersMaak in de map tests een bestand met de naam no_future_dates.sql.
SELECT *
FROM {{ ref('orders') }}
WHERE order_date > current_date
Deze test controleert of er records in de tabel orders zijn met een order_date in de toekomst. Als er rijen worden geretourneerd, faalt de test en word je gewaarschuwd voor ongeldige data, mogelijk veroorzaakt door tijdzonefouten, ETL-bugs of onjuiste invoer in bronsystemen.
-- Bestand: tests/duplicate_emails_per_region.sql
SELECT email, region, COUNT(*) as occurrences
FROM {{ ref('customers') }}
GROUP BY email, region
HAVING COUNT(*) > 1
Deze test zorgt ervoor dat elk e-mailadres uniek is binnen een gegeven regio. Dit kan een bedrijfsregel weerspiegelen waarbij dezelfde persoon zich niet twee keer in dezelfde regio kan registreren. Elke geretourneerde rij geeft een schending van de datakwaliteit aan.
In deze sectie doorlopen we de praktische stappen om dbt-tests te implementeren, te configureren en uit te voeren binnen je project en deployment-pijplijnen.
Voordat je tests of modellen gaat schrijven, moet dbt geïnstalleerd zijn en een nieuw project geïnitialiseerd.
1. Maak een projectmap:
Maak een map op een locatie naar keuze.
2. Navigeer naar de projectmap:
cd dbt-test-project3. Maak een virtuele Python-omgeving:
python3 -m venv dbt-envActiveer vervolgens de omgeving zodra deze is aangemaakt.
dbt-venv\Scripts\activate4. Installeer dbt
pip dbt install5. Maak de map .dbt
mkdir $home\.dbt6. Initialiseer dbt
dbt init7. Maak het bestand profiles.yml
Maak een nieuw bestand in je .dbt-map met de volgende inhoud:
austi:
  target: dev
  outputs:
    dev:
      type: sqlite
      threads: 1
      database: ./dbt_project.db
      schema: main
      schema_directory: ./schemas
      schemas_and_paths:
        main: ./dbt_project.db
Je kunt “austi” vervangen door de naam van het gebruikersprofiel van je Windows-computer.
8. Maak het bestand dbt_project.yml
Vervolgens moet je nog een configuratiebestand aanmaken in de .dbt-map met de volgende inhoud.
name: dbt_test_project
version: '1.0'
profile: austi

seeds:
  dbt_test_project:
    +quote_columns: false
Vervang opnieuw “austi” door je gebruikersprofiellnaam.
9. Controleer of het project werkt:
dbt debugZodra de setup is voltooid, kun je beginnen met het maken van datasets en het bouwen van dbt-modellen.
Als je werkt zonder toegang tot een datawarehouse, kun je dbt-tests lokaal simuleren met CSV-bestanden en de seed-functionaliteit van dbt.
1. Maak CSV-bestanden: Plaats deze in een nieuwe map /seeds van je dbt-project.
Zo moet je het bestand noemen:
seeds/customers.csv
customer_id,name,email,customer_type
1,Alice Smith,alice@example.com,new
2,Bob Jones,bob@example.com,returning
3,Carol Lee,carol@example.com,vip
4,David Wu,david@example.com,new
2. Maak nog een bestand in dezelfde map:
Gebruik deze naamgevingsconventie:
seeds/orders.csv
order_id,customer_id,order_date,order_total,order_status
1001,1,2023-12-01,150.00,shipped
1002,2,2023-12-03,200.00,delivered
1003,1,2023-12-05,175.00,cancelled
1004,3,2024-01-01,225.00,pending
3. Maak een configuratiebestand om seeds te identificeren:
Vervolgens moet je een configuratiebestand maken met de naam dbt_project.yml.
Plak de volgende inhoud in het configuratiebestand.
name: dbt_test_project
version: '1.0'
profile: austi

seeds:
  dbt_test_project:
    +quote_columns: false
Wijzig het veld profile zodat het overeenkomt met de naam van je gebruikersprofiel op je Windows-computer.
4. Laad seed-data:
dbt seedDeze opdracht maakt de tabellen main.customers en main.orders aan op basis van de CSV-bestanden. Dit zijn de seeds die nodig zijn om een database te vervangen.
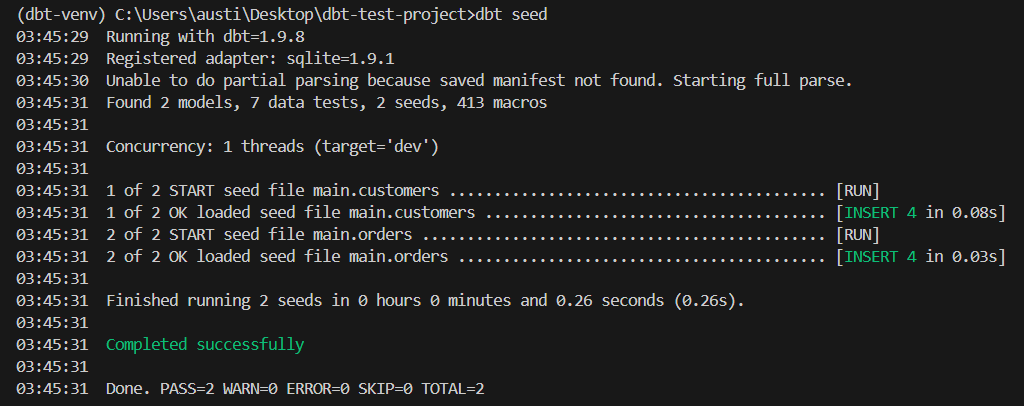
Zoals je op de afbeelding hierboven ziet, zijn er twee seeds gevonden en geladen.
Nu maken we stagingmodellen om je ruwe data te transformeren en te testen.
1. Maak stagingmodellen:
Maak een nieuwe map genaamd models in je projectmap. Maak in die map een bestand met de naam stg_customers.sql.
Plak de volgende code in het bestand:
SELECT
  *
FROM {{ ref('customers') }}
Plak in een ander bestand met de naam stg_orders.sql de volgende code:
SELECT
  *
FROM {{ ref('orders') }}
2. Definieer schematests:
Maak een nieuw bestand op de volgende locatie:
models/schema.yml
Plak het volgende in het bestand
version: 2

models:
  - name: stg_customers
    description: "Customer staging table"
    columns:
      - name: customer_id
        description: "Unique identifier for each customer"
        tests:
          - not_null:
              tags: [critical]
          - unique:
              tags: [critical]

      - name: email
        description: "Email address of the customer"
        tests:
          - not_null

  - name: stg_orders
    description: "Orders staging table"
    columns:
      - name: order_id
        description: "Unique identifier for each order"
        tests:
          - not_null:
              tags: [critical]
          - unique:
              tags: [critical]

      - name: customer_id
        description: "Foreign key to stg_customers"
        tests:
          - not_null:
              tags: [critical]
3. Voer dbt uit om stagingmodellen te bouwen:
dbt run --select stg_customers stg_ordersDeze stagingmodellen vormen nu de basis voor het toepassen van dbt-tests met je lokaal gezaaide data.
Een voorbeeldoutput zou zijn:
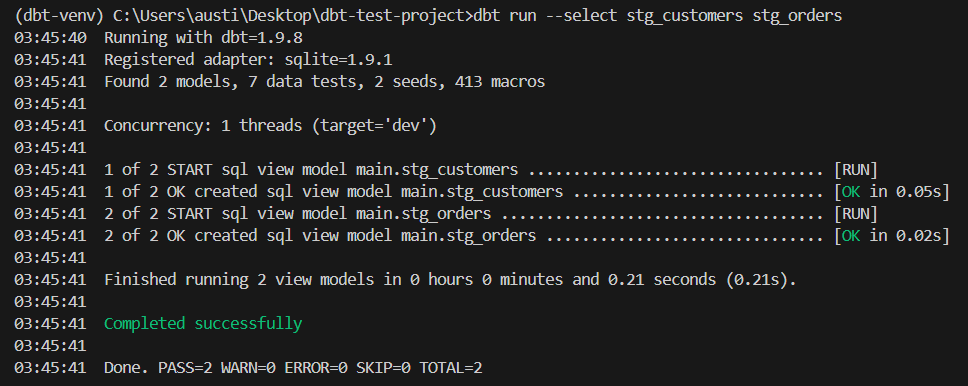
Nu je data is gestaged, voeren we je eerste dbt-test uit met het generieke ingebouwde testframework.
1. Open het bestand schema.yml waarin je stagingmodel is gedefinieerd.
2. Definieer onder de sectie columns: van je model een test zoals not_null of unique.
Voorbeeld:
models:

  - name: stg_customers

    columns:

      - name: customer_id

        tests:

          - not_null

- uniquedbt test --select stg_customersHier is een verwachte output:
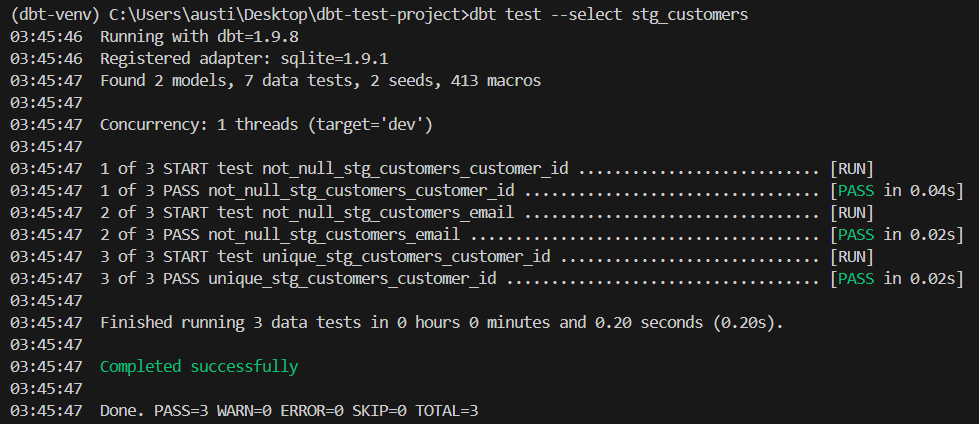
Als je behoeften verder gaan dan ingebouwde tests, kun je aangepaste tests maken met SQL.
1. Maak een nieuw bestand in de map tests/, bijvoorbeeld: tests/no_future_orders.sql
2. Voeg SQL-logica toe die falende rijen retourneert:
SELECT *
FROM {{ ref('stg_orders') }}
WHERE order_date > current_date
3. Voer de test uit:
dbt test --select no_future_ordersDeze test faalt als er bestellingen zijn met een order_date in de toekomst.
Hier is een verwachte output:
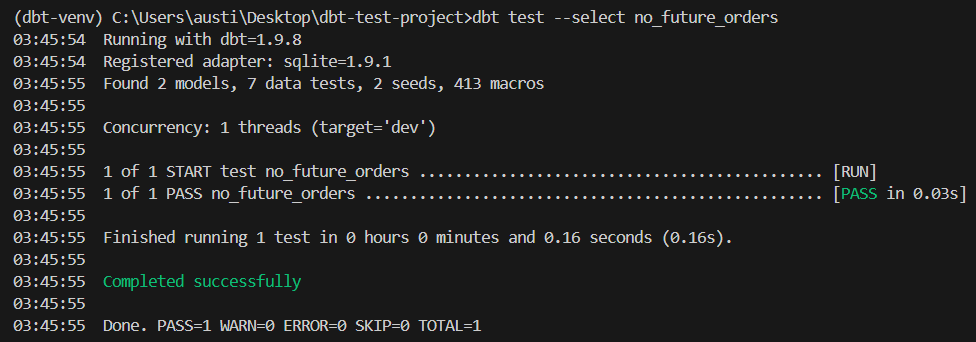
Om consistente testuitvoering te garanderen, integreer je dbt-tests in je ontwikkelpijplijn.
1. Gebruik tags om tests te prioriteren of te isoleren:
Je kunt elk modelschema aanpassen om de volgende tags in dit formaat op te nemen:
columns:
  - name: customer_id
    tests:
      - not_null:
          tags: [critical]
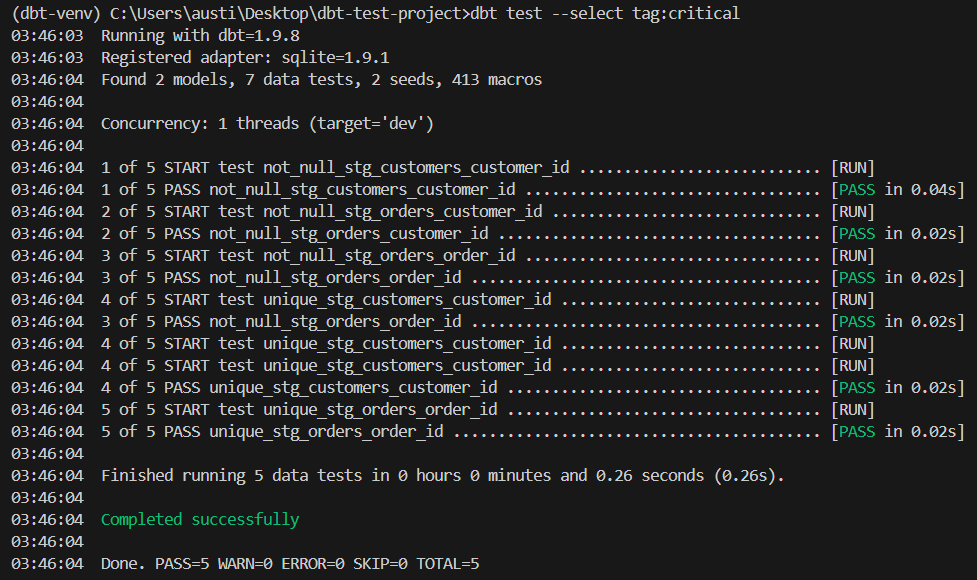
2. Voer selectieve tests lokaal uit:
dbt test --select tag:criticalAls de tests correct draaien, kun je deze output verwachten:
3. Configureer je CI-workflow om dbt-tests automatisch uit te voeren. Je kunt dit verbinden met een CI-platform zoals GitHub Actions.
Effectief dbt-tests implementeren gaat niet alleen over ze schrijven; het gaat erom testen te integreren in de ontwikkelcyclus en cultuur van je team. Hier zijn enkele best practices als leidraad:
Pas altijd not_null en unique toe op primaire-sleutelkolommen in dimensie- en feitentabellen. Deze twee beperkingen vormen de basis voor betrouwbare joins en deduplicatielogica in downstream-queries.
Foreign keys zijn cruciaal voor het behouden van referentiële integriteit. Gebruik de relationships-test om foreign key-constraints na te bootsen, vooral in datawarehouses die deze niet native afdwingen.
Beheer dimensionele consistentie door specifieke waarden af te dwingen in kolommen zoals status, region of product_type. Dit verkleint de kans op typfouten of ongecontroleerde uitbreidingen van enums.
Bedrijfslogica laat zich niet altijd netjes vangen in generieke regels. Voorbeelden van logica waarvoor je aangepaste tests zou moeten schrijven:
Als je veel tests hebt, kan het snel rommelig worden. Overweeg deze best practices om ze overzichtelijk te houden:
tests/ en geef ze een duidelijke naam.Voer dbt test uit als onderdeel van je CI-pijplijn. Zo kun je geen code mergen tenzij de datakwaliteitscontroles slagen. Door tests te integreren in CI/CD versterk je verantwoordelijkheid en vertrouwen in de datapijplijn.
Overmatige of onnodige tests (zeker op grote hoeveelheden data) kunnen deployments vertragen. Richt je op tests die:
Vermijd het testen van berekende velden, tenzij ze onderdeel zijn van een contractuele SLA.
Voor een geavanceerd testvoorbeeld kunnen we een test voor outlierdetectie uitvoeren.
Maak een SQL-bestand in je tests-map met de volgende code:
SELECT *
FROM {{ ref('orders') }}
WHERE order_total > 100000
Dit is een basistest voor outlierdetectie. Als je bedrijf doorgaans bestellingen onder de $10.000 ziet, kun je bestellingen boven $100.000 markeren voor handmatige controle. Hoewel dit geen strikte datakwaliteitsschending is, kan het waardevol zijn voor fraudedetectie of operationele monitoring.
Naarmate je dbt-project groeit en de testdekking toeneemt, worden prestaties steeds belangrijker. In deze sectie bespreken we technieken en strategieën om testefficiëntie te behouden en rekenkosten te beheersen.
Probeer voor testen deze technieken om de prestaties te optimaliseren:
dbt test --select customers
dbt test --exclude tag:slowMet kostenbeheersingsstrategieën blijven dbt-tests performant en kostenefficiënt, vooral in omgevingen waar compute-kosten zijn gekoppeld aan querycomplexiteit en -frequentie.
Enkele strategieën:
dbt-tests zijn een krachtige manier om hoge datakwaliteit te waarborgen, validatiecontroles te automatiseren en problemen vroeg in je transformatiepijplijn op te sporen. Met generieke en aangepaste tests kun je robuuste en onderhoudbare dataworkflows opzetten.
Leer meer over dbt in onze cursus Introduction to dbt of onze dbt-tutorial.
Topcursussen op DataCamp
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min

