
Corso
Introduzione a dbt
4 ore
34K
dbt sta diventando sempre più popolare nell’analisi dei dati per le sue funzioni di trasformazione e testing. In questo articolo, vedremo cos’è dbt e come puoi eseguire alcuni test dbt per garantire la qualità dei dati. Se stai iniziando ora con dbt, dai un’occhiata al nostro corso Introduction to dbt per saperne di più.
Come approfondiamo nella nostra guida dedicata, dbt (data build tool) è un popolare strumento open-source usato dai team dati per trasformare i dati grezzi nel data warehouse in dataset puliti, testati, documentati e pronti per l’analisi.
A differenza degli strumenti ETL, dbt si concentra esclusivamente sulla componente “T” (Transform) della pipeline dei dati e opera sopra i moderni data warehouse cloud come BigQuery, Snowflake, Redshift e Databricks.
Una delle funzionalità più potenti di dbt è il framework integrato di test dei dati, che consente ai professionisti dei dati di scrivere test per validare le assunzioni sui propri dati. Questo framework non solo aiuta a intercettare i problemi in anticipo, ma è anche cruciale per mantenere qualità e affidabilità dei dati in una codebase analitica modulare in crescita.
Il testing è un pilastro dell’analytics engineering. Man mano che i dataset crescono e più stakeholder dipendono dai dati, il costo di problemi non rilevati aumenta. Le funzionalità di testing di dbt ti aiutano a:
In dbt, i test sono asserzioni basate su SQL che validano assunzioni sui dati. I test in dbt rientrano in due categorie principali:
Questi test sono predefiniti da dbt e si applicano in modo dichiarativo nei file YAML. I test generici coprono vincoli comuni tipici della modellazione e del data warehousing.
Sono:
I quattro tipi di test generici integrati includono:
not_null: Garantisce che una colonna non contenga valori NULL.unique: Garantisce che i valori di una colonna siano distinti tra le righe (usato spesso per le chiavi primarie).accepted_values: Restringe una colonna a un insieme predefinito di valori consentiti.relationships: Valida l’integrità referenziale tra tabelle, assicurando che le chiavi esterne corrispondano a valori presenti in un’altra tabella.Questi test sono ideali per far rispettare l’integrità di base dei dati, in particolare per chiavi, campi categorici e relazioni fondamentali tra tabelle.
I test generici funzionano generando automaticamente SQL sotto il cofano.
Per esempio, un test not_null sulla colonna customer_id genererà SQL simile a:
SELECT *
FROM {{ ref('customers') }}
WHERE customer_id IS NULL
Se questa query restituisce righe, il test fallisce.
I test personalizzati o singular sono query SQL definite dall’utente, salvate come file .sql nella directory tests/. Si usano per:
I test singular offrono la massima flessibilità. Puoi validare i dati praticamente in qualsiasi modo, purché la tua query SQL restituisca solo le righe che violano le aspettative.
Per esempio:
Grazie alla loro flessibilità, i test personalizzati sono ideali per i team di analytics che vogliono far rispettare data contract sfumati in produzione.
Anche le macro incluse in dbt possono essere usate per i test, come il pacchetto dbt-utils.
In sintesi:
|
Funzionalità |
Test generici |
Test personalizzati (singular) |
|
Definiti in |
schema.yml |
File .sql nella cartella tests/ |
|
Copertura |
Vincoli comuni (es. null, chiavi) |
Qualsiasi logica esprimibile in SQL |
|
Complessità |
Semplice |
Media o complessa |
|
Riutilizzabilità |
Alta |
Bassa (di solito caso-specifica) |
|
Flessibilità |
Limitata |
Illimitata (qualsiasi logica SQL) |
Combinare entrambi i tipi ti offre il meglio dei due mondi: coerenza e copertura dai test generici, e precisione dai test personalizzati. Vediamo ciascun tipo più nel dettaglio.
I test generici sono predefiniti da dbt e si usano in modo dichiarativo aggiungendoli al file schema.yml del tuo modello.
Questi test di solito validano vincoli come unicità, non null, integrità referenziale o valori in un insieme definito.
Vediamo un semplice tutorial per provare i test generici in dbt.
Nel file schema.yml corrispondente al tuo modello, definisci i test nella sezione columns::
version: 2

models:
  - name: customers
    description: "Customer dimension table"
    columns:
      - name: customer_id
        description: "Unique customer identifier"
        tests:
          - not_null
          - unique
      - name: email
        tests:
- not_nullyaml
columns:
- name: customer_id
tests:
- not_null
- uniqueQuesto test garantisce che customer_id sia presente in ogni riga e sia distinto. È comunemente usato per far rispettare l’assunzione che customer_id sia una chiave primaria della tabella.
columns:
  - name: customer_type
    tests:
      - accepted_values:
          values: ['new', 'returning', 'vip']
Questo verifica che il campo customer_type contenga solo una delle tre stringhe consentite: new, returning o vip. Questo test è spesso usato per campi categorici che devono rispettare un insieme noto di valori, come enum o stati.
columns:
  - name: customer_id
    tests:
      - relationships:
          to: ref('customers')
          field: id
Questo fa rispettare un vincolo di integrità referenziale verificando che ogni customer_id nel modello corrente esista come id nella tabella customers. Imita un vincolo di chiave esterna in SQL, ma a livello analitico.
Quando i test integrati non bastano per il tuo caso d’uso, ad esempio vuoi validare logiche di business complesse, puoi scrivere test personalizzati usando SQL. Questi sono noti come test singular.
1. Crea un file .sql dentro la directory tests/ del tuo progetto dbt.
2. Scrivi una query SQL che restituisca le righe che falliscono il test.
ordersNella cartella tests, crea un file chiamato no_future_dates.sql.
SELECT *
FROM {{ ref('orders') }}
WHERE order_date > current_date
Questo test verifica se nella tabella orders ci sono record con order_date nel futuro. Se vengono restituite righe, il test fallisce, segnalando dati non validi che potrebbero essere causati da errori di fuso orario, bug ETL o inserimenti errati dal sistema sorgente.
-- File: tests/duplicate_emails_per_region.sql
SELECT email, region, COUNT(*) as occurrences
FROM {{ ref('customers') }}
GROUP BY email, region
HAVING COUNT(*) > 1
Questo test assicura che ogni email sia unica all’interno di una determinata regione. Potrebbe riflettere una regola di business secondo cui la stessa persona non può registrarsi due volte nella stessa regione. Ogni riga restituita indica una violazione della qualità dei dati.
Questa sezione illustra i passaggi pratici per implementare, configurare ed eseguire i test dbt nel tuo progetto e nelle pipeline di deploy.
Prima di iniziare a scrivere test o modelli, devi avere dbt installato e un nuovo progetto inizializzato.
1. Crea la cartella del progetto:
Crea una cartella in una posizione a tua scelta.
2. Entra nella cartella del progetto:
cd dbt-test-project3. Crea un ambiente virtuale Python:
python3 -m venv dbt-envPoi attiva l’ambiente una volta creato.
dbt-venv\Scripts\activate4. Installa dbt
pip dbt install5. Crea la cartella .dbt
mkdir $home\.dbt6. Inizializza dbt
dbt init7. Crea il file profiles.yml
Crea un nuovo file nella tua cartella .dbt con il seguente contenuto:
austi:
  target: dev
  outputs:
    dev:
      type: sqlite
      threads: 1
      database: ./dbt_project.db
      schema: main
      schema_directory: ./schemas
      schemas_and_paths:
        main: ./dbt_project.db
Puoi sostituire “austi” con il nome del profilo utente del tuo computer Windows.
8. Crea il file dbt_project.yml
Poi, dovrai creare un altro file di configurazione nella cartella .dbt con il seguente contenuto.
name: dbt_test_project
version: '1.0'
profile: austi

seeds:
  dbt_test_project:
    +quote_columns: false
Anche in questo caso, sostituisci “austi” con il nome del tuo profilo utente.
9. Verifica che il progetto funzioni:
dbt debugUna volta completata la configurazione, sei pronto per iniziare a creare dataset e costruire modelli dbt.
Se lavori senza accesso a un data warehouse, puoi simulare i test dbt in locale usando file CSV e la funzionalità seed di dbt.
1. Crea i file CSV: Inseriscili in una nuova cartella /seeds del tuo progetto dbt.
Ecco come dovresti chiamarlo:
seeds/customers.csv
customer_id,name,email,customer_type
1,Alice Smith,alice@example.com,new
2,Bob Jones,bob@example.com,returning
3,Carol Lee,carol@example.com,vip
4,David Wu,david@example.com,new
2. Crea un altro file nella stessa directory:
Usa questa convenzione di denominazione:
seeds/orders.csv
order_id,customer_id,order_date,order_total,order_status
1001,1,2023-12-01,150.00,shipped
1002,2,2023-12-03,200.00,delivered
1003,1,2023-12-05,175.00,cancelled
1004,3,2024-01-01,225.00,pending
3. Crea un file di configurazione per identificare i seed:
Successivamente, dovrai creare un file di configurazione chiamato dbt_project.yml.
Incolla il seguente contenuto nel file di configurazione.
name: dbt_test_project
version: '1.0'
profile: austi

seeds:
  dbt_test_project:
    +quote_columns: false
Modifica il campo profile in modo che corrisponda al nome del tuo profilo utente su Windows.
4. Carica i dati seed:
dbt seedQuesto comando crea le tabelle main.customers e main.orders dai file CSV. Questi sono i seed necessari per sostituire un database.
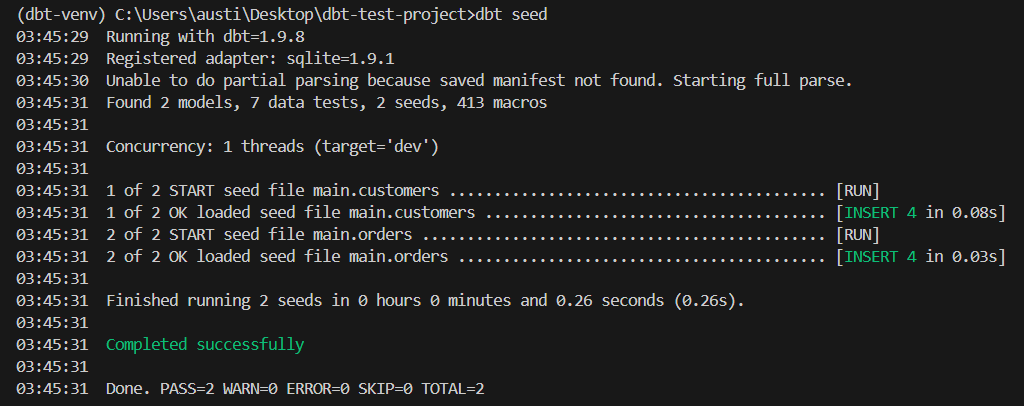
Come puoi vedere dall’immagine qui sopra, sono stati trovati due seed e sono stati caricati.
Ora creeremo modelli di staging per trasformare e testare i tuoi dati grezzi.
1. Crea i modelli di staging:
Crea una nuova cartella chiamata models nella cartella del tuo progetto. In quella cartella, crea un file chiamato stg_customers.sql.
Incolla il seguente codice nel file:
SELECT
  *
FROM {{ ref('customers') }}
In un altro file chiamato stg_orders.sql, incolla il seguente codice:
SELECT
  *
FROM {{ ref('orders') }}
2. Definisci i test di schema:
Crea un nuovo file nella seguente posizione:
models/schema.yml
Incolla quanto segue nel file
version: 2

models:
  - name: stg_customers
    description: "Customer staging table"
    columns:
      - name: customer_id
        description: "Unique identifier for each customer"
        tests:
          - not_null:
              tags: [critical]
          - unique:
              tags: [critical]

      - name: email
        description: "Email address of the customer"
        tests:
          - not_null

  - name: stg_orders
    description: "Orders staging table"
    columns:
      - name: order_id
        description: "Unique identifier for each order"
        tests:
          - not_null:
              tags: [critical]
          - unique:
              tags: [critical]

      - name: customer_id
        description: "Foreign key to stg_customers"
        tests:
          - not_null:
              tags: [critical]
3. Esegui dbt per costruire i modelli di staging:
dbt run --select stg_customers stg_ordersQuesti modelli di staging ora fungono da base per applicare i test dbt usando i tuoi dati seed locali.
Un output di esempio potrebbe essere:
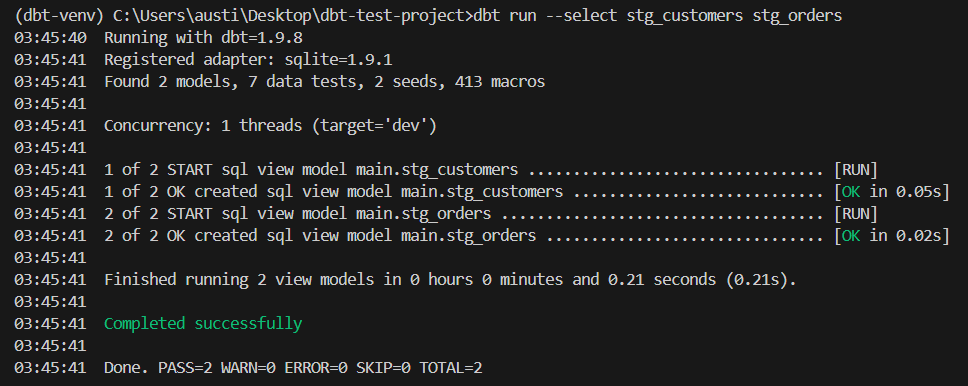
Ora che i tuoi dati sono in staging, implementiamo il tuo primo test dbt utilizzando il framework di test generico integrato.
1. Apri il file schema.yml dove è definito il tuo modello di staging.
2. Nella sezione columns: del tuo modello, definisci un test come not_null o unique.
Esempio:
models:

  - name: stg_customers

    columns:

      - name: customer_id

        tests:

          - not_null

- uniquedbt test --select stg_customersEcco un risultato atteso:
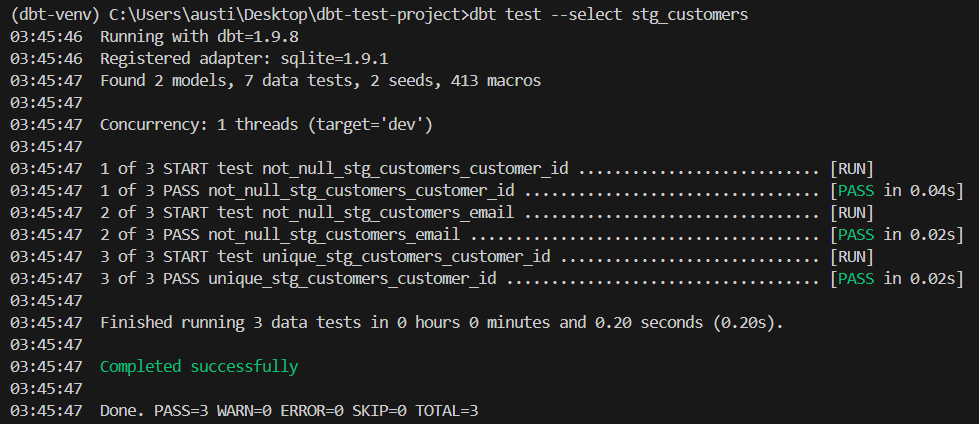
Quando le tue esigenze vanno oltre i test integrati, puoi creare test personalizzati usando SQL.
1. Crea un nuovo file nella cartella tests/, ad esempio: tests/no_future_orders.sql
2. Aggiungi la logica SQL che restituisca le righe che falliscono:
SELECT *
FROM {{ ref('stg_orders') }}
WHERE order_date > current_date
3. Esegui il test:
dbt test --select no_future_ordersQuesto test fallirà se ci sono ordini con valori di order_date futuri.
Ecco un risultato atteso:
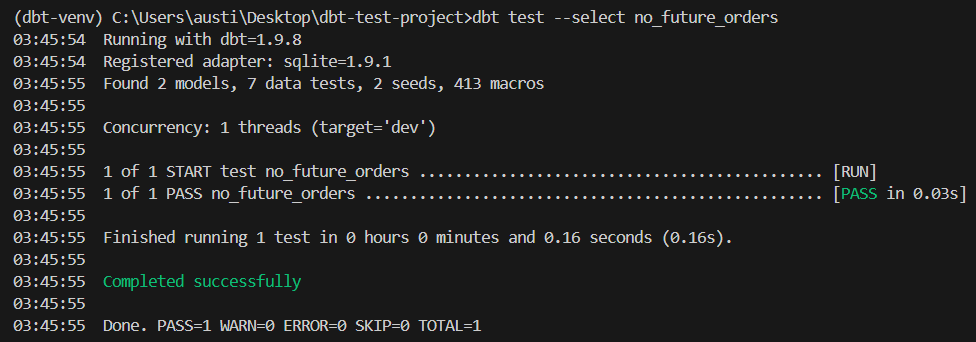
Per garantire un’esecuzione dei test coerente, integra i test dbt nella tua pipeline di sviluppo.
1. Usa i tag per dare priorità o isolare i test:
Puoi modificare qualsiasi schema di modello per includere i seguenti tag in questo formato:
columns:
  - name: customer_id
    tests:
      - not_null:
          tags: [critical]
2. Esegui test selettivi in locale:
dbt test --select tag:criticalSe i test vengono eseguiti correttamente, dovresti aspettarti questo output:
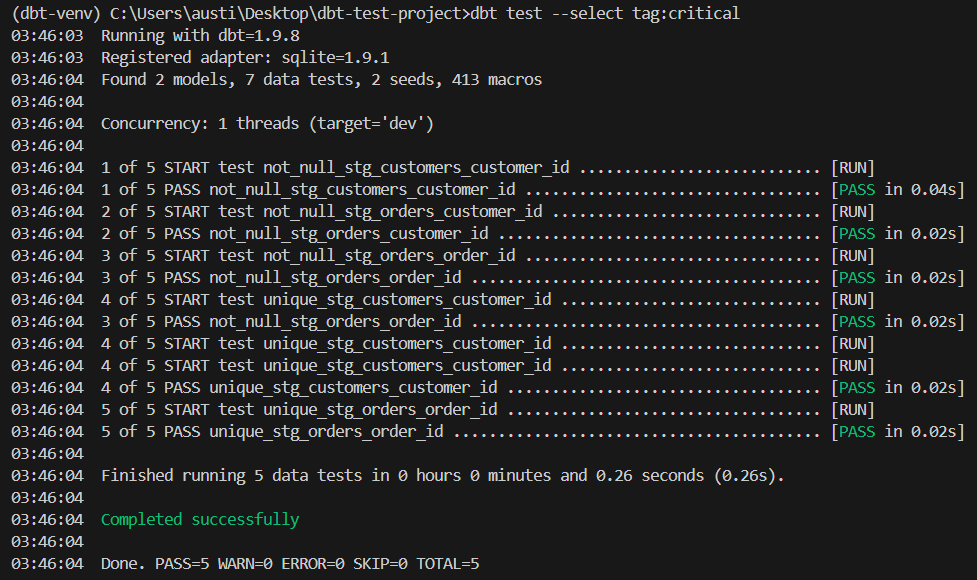
3. Configura il tuo workflow CI per eseguire automaticamente i test dbt. Puoi collegarlo a una piattaforma CI come GitHub Actions.
Implementare efficacemente i test dbt non significa solo scriverli; significa integrare il testing nel ciclo di sviluppo e nella cultura del tuo team. Ecco alcune best practice da seguire:
Applica sempre i test not_null e unique alle colonne chiave primaria nelle tabelle di dimensione e di fatto. Questi due vincoli sono le fondamenta di join affidabili e logiche di deduplicazione nelle query a valle.
Le chiavi esterne sono fondamentali per mantenere l’integrità referenziale. Usa il test relationships per imitare i vincoli di chiave esterna, soprattutto nei data warehouse che non li applicano nativamente.
Controlla la coerenza dimensionale imponendo valori specifici in colonne come status, region o product_type. Questo riduce il rischio di refusi o espansioni di enum non gestite.
La logica di business non si mappa sempre chiaramente a regole generiche. Esempi di logiche per cui dovresti scrivere test personalizzati includono:
Se imposti molti test, il disordine può crescere rapidamente. Considera queste best practice per tenerli organizzati:
tests/ e dai loro nomi descrittivi.Esegui dbt test come parte della tua pipeline CI. Questo assicura che il codice non possa essere unito finché i vincoli di qualità dei dati non passano. Integrare i test nel CI/CD rafforza responsabilità e fiducia nella pipeline dati.
Test eccessivi o non necessari (soprattutto su grandi volumi di dati) possono rallentare i deploy. Concentrati sui test che sono:
Evita di testare campi calcolati a meno che non facciano parte di una SLA contrattuale.
Per un esempio avanzato, possiamo eseguire un test di rilevamento degli outlier.
Crea un file SQL nella tua cartella tests con il seguente codice:
SELECT *
FROM {{ ref('orders') }}
WHERE order_total > 100000
Questo è un test di rilevamento outlier di base. Se il tuo business tipicamente registra ordini sotto i 10.000 $, puoi segnalare ordini oltre i 100.000 $ per una revisione manuale. Pur non essendo una violazione stretta della qualità dei dati, può essere utile per il rilevamento frodi o il monitoraggio operativo.
Man mano che il tuo progetto dbt scala e la copertura dei test cresce, le prestazioni diventano sempre più importanti. Questa sezione illustra tecniche e strategie per mantenere l’efficienza dei test e controllare i costi computazionali.
Per il testing, prova queste tecniche per ottimizzare le prestazioni:
dbt test --select customers
dbt test --exclude tag:slowApplicare strategie di gestione dei costi assicura che i test dbt restino performanti ed economici, soprattutto in ambienti in cui la fatturazione del compute è legata alla complessità e frequenza delle query.
Alcune strategie sono:
I test dbt sono un modo potente per garantire alta qualità dei dati, automatizzare i controlli di validazione e intercettare i problemi in anticipo nella tua pipeline di trasformazione. Test generici e personalizzati possono essere utilizzati per creare workflow dati robusti e manutenibili.
Scopri di più su dbt nel nostro corso Introduction to dbt o nel nostro tutorial su dbt.
I migliori corsi DataCamp
Corso
Programma
Corso
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min



