
Last chance! 50% off DataCamp Premium
Sale ends in
Một trong những khái niệm tiên quyết bạn cần biết là kho dữ liệu. Kho là nơi bạn lưu trữ mọi dữ liệu thuộc về một công ty.
Doanh nghiệp xây kho dữ liệu vì chúng cho phép phân tích và mọi thứ khác bạn có thể làm với dữ liệu (à, dữ liệu có cấu trúc). Chúng lưu trữ dữ liệu lịch sử được tổ chức thành các bảng, và được cấu trúc để truy vấn và phân tích nhanh.
Có nhiều công cụ triển khai kho dữ liệu:
v.v.
dbt không giúp bạn thu thập hay nạp dữ liệu vào các công cụ trên mà là biến đổi dữ liệu bên trong chúng. Nói cách khác, nó đảm nhận chữ T trong quy trình ETL/ELT (trích xuất, biến đổi, nạp) là trái tim của mọi kho dữ liệu.
dbt được cung cấp qua hai giao diện: dbt Core và dbt Cloud.
dbt Core là thư viện mã nguồn mở triển khai phần lớn chức năng của dbt. Nó có giao diện dòng lệnh (lệnh dbt mà bạn sẽ yêu thích) để bạn quản lý các biến đổi dữ liệu trong dự án của mình.
dbt Cloud là giải pháp doanh nghiệp dành cho nhóm. Bên cạnh CLI, dbt Cloud còn cung cấp IDE dựa trên web thân thiện hơn. Với nó, bạn không phải lo lắng quá nhiều về kết nối cơ sở dữ liệu và chỉnh sửa tệp YAML (như bạn sẽ thấy ở các phần sau).
dbt Cloud cũng cung cấp các tính năng bổ sung như lập lịch công việc, tích hợp nâng cao và hỗ trợ ưu tiên cao.
Dưới đây là bảng tóm tắt sự khác biệt giữa dbt Core và dbt Cloud:
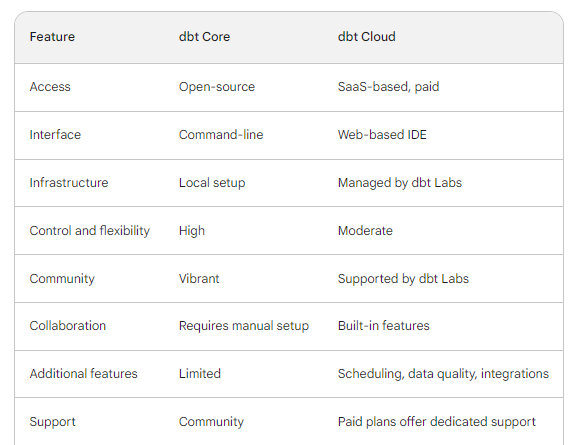
Bất chấp các tính năng bổ sung, chúng ta sẽ đề cập dbt Core vì nó phù hợp nhất cho các dự án cục bộ, thử nghiệm và học tập. Bạn có thể cài đặt nó bằng pip trên bất kỳ hệ điều hành nào (tất nhiên là trong môi trường ảo).
Tôi sẽ dùng môi trường Conda:
$ conda create -n learn_dbt -y
$ pip install dbt-<adapter_name>
Bạn nên thay adapter_name bằng cơ sở dữ liệu bạn muốn dùng. dbt Labs (công ty đứng sau dbt) đã tích hợp nhiều adapter cho các nền tảng dữ liệu khác nhau.
Trong bài này, chúng ta sẽ dùng adapter dbt-duckdb để kết nối tới cơ sở dữ liệu DuckDB. Nhưng bạn có thể dùng bất kỳ adapter nào được liệt kê trên trang này của tài liệu dbt.
$ pip install dbt-duckdb
Vậy là xong phần thiết lập ban đầu!
Về cơ bản, một dự án dbt là một thư mục trên máy bạn chứa mọi thứ cần thiết để thực hiện các biến đổi trên dữ liệu. Nó chứa nhiều tệp .sql (gọi là model) và tệp YAML (để cấu hình).
Để tạo dự án dbt, bạn có thể dùng lệnh dbt init <project_name> trên CLI:
$ dbt init dbt_learnTerminal sẽ yêu cầu bạn nhập một mã tương ứng với các adapter nền tảng dữ liệu sẵn có. Vì bạn chỉ có DuckDB, bạn có thể nhấn 1.
$ cd dbt_learn
Bên trong dbt_learn, bạn có cấu trúc sau:
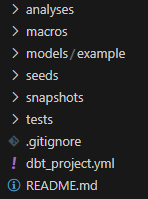
Đây là nơi kỹ sư dữ liệu trở thành kỹ sư phần mềm bởi vì dự án dbt cho phép bạn:
Tóm lại, dự án dbt mang đến cách thức mạnh mẽ để quản lý và điều phối các biến đổi dữ liệu. Chúng đem lại những lợi ích bấy lâu mong đợi của kỹ nghệ phần mềm cho thế giới dữ liệu.
Chúng ta đã khởi tạo một dự án dbt và giờ cần kết nối tới một cơ sở dữ liệu hiện có (hoặc tạo mới từ đầu). Để làm điều này, ta cần một cách an toàn để cung cấp thông tin xác thực của cơ sở dữ liệu cho dbt nhằm thiết lập kết nối. Đây là lúc ta dùng hồ sơ dự án.
Một hồ sơ dự án là tệp YAML chứa chi tiết kết nối cho nền tảng dữ liệu đã chọn. Bản thân tệp được tạo trong thư mục .dbt tại $HOME và có tên profiles.yml. Hiện tại nó trông như sau:
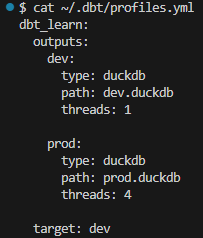
Tệp liệt kê một hồ sơ duy nhất tên dbt_learn cho dự án của chúng ta. Nó chỉ định hai output: dev và prod.
Output là các cấu hình riêng lẻ chỉ định các kết nối khác nhau tới kho dữ liệu hoặc cơ sở dữ liệu. Thông qua output, bạn có thể quản lý kết nối tới các môi trường khác nhau:
Trong hồ sơ của chúng ta, output mặc định là dev, được liệt kê trong trường target. Bạn có thể đổi sang output khác tùy nhu cầu. Tạm thời, ta giữ nguyên.
Lưu ý: bạn có thể đổi tên profile và output miễn là chúng được tham chiếu đúng trong các tệp dbt còn lại.
Trường path chỉ vị trí của một cơ sở dữ liệu hiện có tên dev.duckdb. Nếu chưa tồn tại, nó sẽ được adapter DuckDB của dbt tạo trong thư mục làm việc của chúng ta (bên trong dự án dbt_learn; trường path chỉ đường dẫn tương đối với thư mục dự án). Vì chúng ta chưa có cơ sở dữ liệu tên dev.duckdb, ta sẽ để dbt tạo bằng cách chạy dbt debug.
$ dbt debug
Tiểu lệnh debug được dùng để kiểm tra nhiều khía cạnh của dự án như:
profiles.ymlprofiles.ymldbt_project.yml, v.v.Nếu bạn nhận thông báo màu xanh “All tests passed” và xuất hiện cơ sở dữ liệu dev.duckdb mới, thì bạn đã sẵn sàng.
Model là trái tim của dbt vì chúng đại diện cho các biến đổi thực sự mà dbt nổi tiếng.
Một mô hình dữ liệu là ý tưởng khái niệm thể hiện cấu trúc và mối quan hệ trong một tập dữ liệu. Model dữ liệu trong dbt đơn giản và cụ thể hơn. Chúng có các thuộc tính sau:
.sql (các phiên bản mới hơn của dbt cho phép Python)Dự án dbt_learn của chúng ta có sẵn hai model mẫu trong models/example:
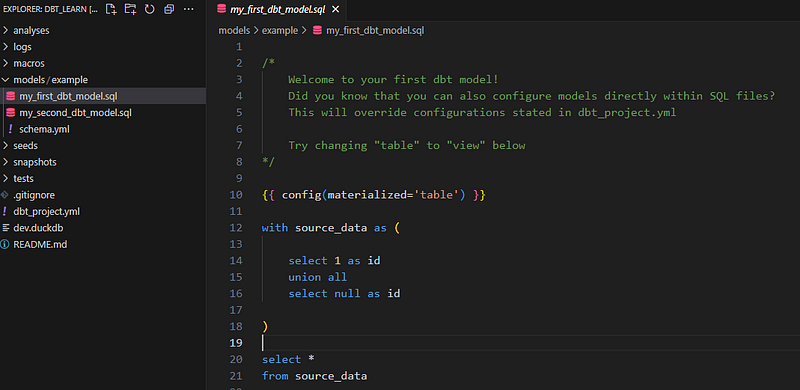
Chúng ta sẽ xóa chúng và tạo model của riêng mình:
$ rm -rf models/example
$ mkdir models/stats
$ touch models/stats/average_diamond_price_per_group.sql
Ở dòng cuối cùng của đoạn mã trên, chúng ta đang tạo một model tên average_diamond_price_per_group trong thư mục stats. Việc đặt tên model mang tính mô tả là quan trọng.
Bên trong model (tệp .sql), dán truy vấn SQL kiểm thử đơn giản này:
SELECT 1 AS Id
và chạy model với dbt run:
$ dbt run
Bạn sẽ nhận thông báo màu xanh “Completed successfully”.
Sau khi mọi thứ được thiết lập, ta có thể nạp một ít dữ liệu vào cơ sở dữ liệu dev.duckdb. Chúng ta sẽ dùng tệp parquet vì DuckDB hỗ trợ chúng nguyên bản.
SELECT AVG(price), cut
 FROM "diamonds.parquet"
GROUP BY cut
Truy vấn sẽ trả về cùng thông báo thành công.
Trong hướng dẫn này, tôi đã chuẩn bị bộ dữ liệu diamonds dưới dạng tệp parquet. Trong GitHub gist này, bạn có thể tìm đoạn mã để tải nó về không gian làm việc của bạn.
Chúng ta vừa thấy cách tạo model dbt đầu tiên bằng một câu lệnh SELECT trả về một số thống kê tóm tắt về một tập dữ liệu. Trong thực tế, các model của bạn sẽ phụ thuộc vào yêu cầu kinh doanh và cách các nhân viên khác làm việc với cơ sở dữ liệu. Do đó, chúng ta sẽ không tập trung vào logic thực tế của model dbt mà vào cách triển khai chúng đúng cách.
Trong dự án thực tế, các model của bạn nhiều khả năng phụ thuộc lẫn nhau, tạo thành một dạng phân cấp. Trong thế giới dữ liệu, phân cấp này được gọi là Đồ thị có hướng phi chu trình (DAG) hay đồ thị phả hệ.
Một DAG duy nhất có thể thay thế tài liệu 1000 từ. Hãy xem ví dụ này từ trang DAGs của dbt:
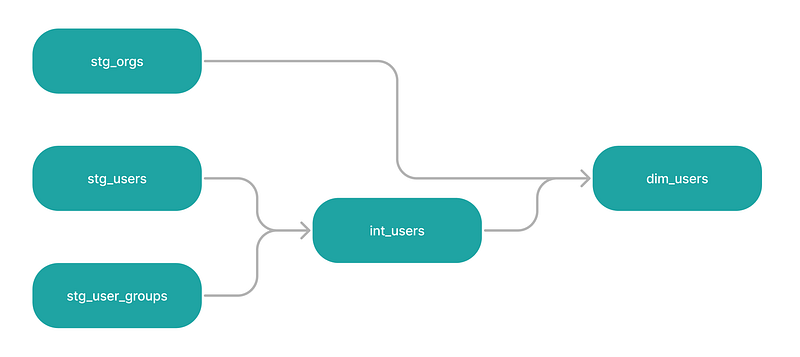
Có bốn model trong đồ thị này, tất cả nối tuyến tính tới các model ở hạ nguồn. stg_users và stg_user_groups là model cha của int_users, và đến lượt mình, int_users là model cha của dim_users cùng với model stg_orgs ở thượng nguồn.
Lưu ý: các từ upstream (thượng nguồn) và downstream (hạ nguồn) thường được dùng để chỉ vị trí tương đối của mỗi model trong DAG.
Một khía cạnh then chốt của DAG là không có vòng lặp kín. Điều này nghĩa là một model hạ nguồn, vốn là kết quả của các model trước đó, không thể được join với một model thượng nguồn. Đó là nguồn gốc của chữ “phi chu trình”.
Ngoài sự giàu hình ảnh, mục đích của DAG là cho phép dbt dựng/cập nhật model theo đúng phụ thuộc của chúng. Nếu chúng ta không định nghĩa DAG cho bốn model trên, dbt sẽ dựng chúng theo thứ tự chữ cái. Điều này sẽ dẫn đến đủ loại thông báo đỏ và lỗi.
Để định nghĩa DAG trong dbt, chúng ta sẽ dùng Jinja templating.
Trong DAG trên, model int_users là sản phẩm của stg_users và stg_user_groups. Chúng ta cần chỉ rõ mối quan hệ này trong dự án, nếu không dbt run sẽ chạy tất cả model theo thứ tự chữ cái, nghĩa là int_users chạy trước. Điều này sẽ gây lỗi vì các phụ thuộc của nó chưa được materialize.
Hiện tại, model int_users có thể trông như sau:
SELECT some_column
 FROM stg_users as su
 JOIN stg_user_groups as sug
   ON su.a = sug.a
Giờ, chúng ta sẽ liên kết ba model bằng cách biến chúng thành các nút của một DAG bằng Jinja:
SELECT some_column
 FROM {{ ref("stg_users") }} as su
 JOIN {{ ref("stg_user_groups" )}} as sug
   ON su.a = sug.a
Thay vì viết thẳng tên model, chúng ta đặt chúng trong một hàm Jinja gọi là ref. Cú pháp là {{ ref("column_name") }} (chú ý khoảng trắng và dấu nháy). Khi truy vấn được biên dịch, hàm Jinja được thay thế bằng tên model thực tế.
Lưu ý rằng stg_users và stg_user_groups phải tồn tại dưới dạng tệp .sql trong dự án dbt của bạn.
Giờ đây, khi thực thi dbt run, nó sẽ tìm phụ thuộc của mỗi model, kết nối chúng và thực thi tương ứng.
Hàm ref trong Jinja không phải là duy nhất chúng ta có thể dùng trong dbt. Thực tế, bằng cách dùng các hàm và tính năng khác của Jinja, bạn có thể mở rộng đáng kể chức năng của các câu lệnh SQL. Dưới đây là vài ví dụ:
{% set status = 'active' %}  -- Define a variable

SELECT *
FROM customers
WHERE status = {{ status }};
Nếu chúng ta có tệp models/model_properties.yml và nó có các trường sau:
# models/model_properties.yml
version: 2

models:
 - name: my_model
   config:
     target_schema: analytics
Ta có thể truy cập các trường của nó bên trong bất kỳ tệp .sql nào bằng Jinja:
{% set target_schema = config.target_schema %}

CREATE TABLE {{ target_schema }}.{{ target_table }} AS
...
Điều kiện:
{% if some_condition %}
 SELECT * FROM test_data
{% else %}
 SELECT * FROM production_data
{% endif %}
Vòng lặp:
SELECT
 order_id,
 {% for payment_method in ["bank_transfer", "credit_card", "gift_card"] %}
   SUM(CASE WHEN payment_method = '{{ payment_method }}' THEN amount END) AS {{ payment_method }}_amount,
 {% endfor %}
 SUM(amount) AS total_amount
FROM {{ ref('raw_payments') }}
GROUP BY 1;
Đây là macro:
{% macro create_table(table_name, columns) %}
 CREATE TABLE {{ table_name }} (
   {% for column in columns %}
     {{ column.name }} {{ column.type }},
   {% endfor %}
 );
{% endmacro %}
Và đây là cách dùng nó trong model:
{% call create_table('my_customer_table', [
   {'name': 'id', 'type': 'integer'},
   {'name': 'name', 'type': 'varchar(255)'},
   {'name': 'email', 'type': 'varchar(255)'},
]) %}

INSERT INTO {{ my_customer_table }} (id, name, email)
SELECT customer_id, customer_name, customer_email
FROM raw_customers;
Nếu bạn muốn tìm hiểu thêm về dùng Jinja trong dbt với SQL, hãy xem trang này của tài liệu dbt.
Một nhà phát triển phần mềm giỏi biết rằng họ cần kiểm thử mã liên tục để tìm lỗi và sai sót. Vì dbt biến kỹ sư dữ liệu thành nhà phát triển phần mềm, nó cung cấp một quy trình làm việc thẳng thắn để dùng kiểm thử, cả dựng sẵn lẫn tùy chỉnh.
Hiện tại, dbt cung cấp bốn kiểm thử dựng sẵn sau:
unique - xác minh tất cả giá trị là duy nhấtnot_null - kiểm tra giá trị thiếuaccepted_values - xác minh tất cả giá trị nằm trong danh sách chỉ định, có tham số valuesrelationships - xác minh kết nối tới một bảng hoặc cột cụ thể, có tham số to và fieldĐể chỉ định kiểm thử nào dùng cho cột nào, chúng ta dùng tệp YAML tên model_properties.yml trong thư mục models.
Lưu ý: model_properties.yml không bắt buộc để model chạy và có thể đặt tên bất kỳ. Nhưng nếu bạn muốn tạo kiểm thử để xác thực dữ liệu đi vào model, tệp này là bắt buộc.
Hãy xem cách dùng kiểm thử not_null để kiểm tra giá trị thiếu ở cột cut của bảng diamonds. Trước tiên, tạo tệp model_properties.yml trong models:
$ touch models/model_properties.yml
Bên trong, dán nội dung sau:
version: 2

models:
 - name: average_diamond_price_per_group
   columns:
     - name: cut
       tests:
         - not_null
Ở trường - name dưới models, chúng ta chỉ định model nào đang định nghĩa thuộc tính. Sau đó, chỉ định cột và tên của nó. Cuối cùng, viết trường tests, bên dưới liệt kê kiểm thử not_null.
Giờ bạn có thể dùng kiểm thử này để xác thực dữ liệu trước khi chạy dbt run. Lệnh là dbt test:
$ dbt test
Nếu nhận thông báo lỗi, nghĩa là kiểm thử thất bại và bạn cần kiểm tra vấn đề trong bảng và sửa nếu cần.
Để dùng dbt thành công trong dự án của bạn, bạn có thể theo quy trình khuyến nghị này:
1. Khởi tạo dự án
dbt và tạo dự án mới với dbt init2. Cấu hình
profiles.yml tại thư mục home.dbt_project.yml cho các thiết lập cấp dự án (ví dụ: phiên bản, phụ thuộc).3. Phát triển
.sql trong thư mục models để định nghĩa model..yml trong thư mục tests để định nghĩa kiểm thử.dbt test để chạy kiểm thử thường xuyên trong quá trình phát triển.dbt debug để xử lý sự cố.4. Xác thực cục bộ (các chủ đề chúng ta chưa đề cập)
Thực hành tốt bổ sung:
dbt docs generate để dựng tài liệu của model trên một máy chủ web (vâng, điều đó là có thể) sau này.Chúng ta đã đề cập nhiều điều cơ bản trong hướng dẫn này, nhưng như tôi đã nói ngay từ đầu, dbt là một công cụ đồ sộ với nhiều tính năng. Sẽ mất thời gian để bạn làm chủ nó ở mức có thể dùng thoải mái trong môi trường sản xuất. Sao không dùng những tài nguyên này để giúp bạn đạt mục tiêu nhanh hơn?
Bắt đầu hành trình với dbt ngay hôm nay!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút

