Curso
Introdução ao dbt
4 h
33.4K
Um dos conceitos prévios que você precisa conhecer é o de data warehouse. Um warehouse é onde você armazena todos os dados que pertencem a uma empresa.
As empresas constroem warehouses porque eles viabilizam análises e tudo o que mais você pode fazer com dados (cof, dados estruturados). Eles armazenam dados históricos organizados em tabelas e são estruturados para consultas e análises rápidas.
Existem muitas ferramentas que implementam data warehouses:
entre outras.
O dbt não ajuda você a coletar ou carregar dados para as ferramentas acima, mas a transformar os dados dentro delas. Em outras palavras, ele faz o T do processo ETL/ELT (extração, transformação e carga) que está no coração de todo warehouse.
O dbt é oferecido em duas interfaces: dbt Core e dbt Cloud.
O dbt Core é uma biblioteca open source que implementa a maior parte das funcionalidades do dbt. Ele tem uma interface de linha de comando (o comando dbt que você vai amar) para gerenciar transformações de dados nos seus projetos.
O dbt Cloud é uma solução corporativa para times. Além da CLI, o dbt Cloud oferece uma IDE web mais amigável. Com ela, você não precisa se preocupar tanto com conexões ao banco e edição de arquivos YAML (como você verá nas próximas seções).
O dbt Cloud também traz recursos adicionais como agendamento de jobs, integrações avançadas e suporte prioritário.
Aqui vai uma tabela que resume as diferenças entre dbt Core e dbt Cloud:
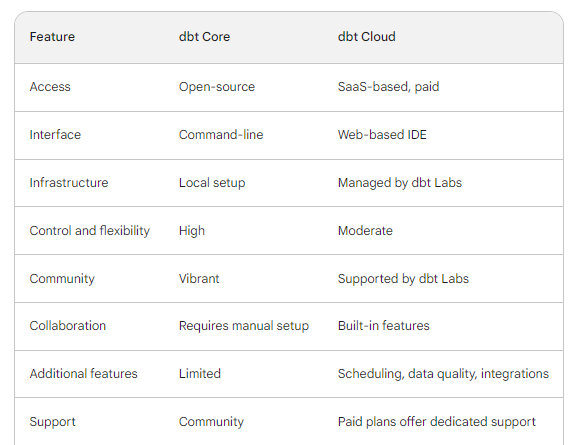
Apesar dos extras, vamos focar no dbt Core, que é mais adequado para projetos locais, testes e aprendizado. Você pode instalá-lo com pip em qualquer sistema operacional (dentro de um ambiente virtual, claro).
Vou usar um ambiente Conda:
$ conda create -n learn_dbt -y
$ pip install dbt-<adapter_name>
Substitua adapter_name pelo banco de dados que você quer usar. A dbt Labs (a empresa por trás do dbt) integrou diversos adapters para diferentes plataformas de dados.
Neste artigo, vamos usar o adapter dbt-duckdb para conectar a um banco DuckDB. Mas você pode usar qualquer um dos adapters listados nesta página da documentação do dbt.
$ pip install dbt-duckdb
Pronto, configuração inicial feita!
Basicamente, um projeto dbt é um diretório na sua máquina que contém tudo o que é necessário para realizar transformações nos seus dados. Ele contém vários arquivos .sql (chamados de models) e arquivos YAML (para configurações).
Para criar um projeto dbt, use o comando dbt init <project_name> na CLI:
$ dbt init dbt_learnO terminal vai pedir um código correspondente aos adapters de plataforma de dados disponíveis. Como você só tem DuckDB, pode pressionar 1.
$ cd dbt_learn
Dentro de dbt_learn, você verá a seguinte estrutura:
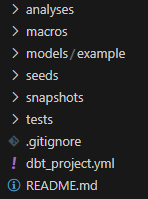
É aqui que engenheiros de dados começam a agir como engenheiros de software, porque projetos dbt permitem que você seja:
Resumindo, projetos dbt oferecem uma forma poderosa de gerenciar e orquestrar transformações de dados, trazendo os tão esperados benefícios da engenharia de software para o mundo dos dados.
Inicializamos um projeto dbt e agora precisamos conectar a um banco existente (ou criar um do zero). Para isso, precisamos de uma forma segura de fornecer credenciais do banco ao dbt. É aí que entra o perfil do projeto.
Um perfil é um arquivo YAML com os detalhes de conexão da sua plataforma de dados. Ele é criado no diretório .dbt no $HOME e se chama profiles.yml. Ele está assim agora:
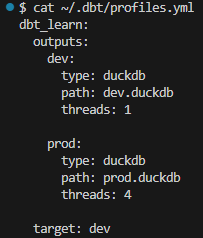
O arquivo lista um único perfil chamado dbt_learn para o nosso projeto. Ele especifica duas saídas: dev e prod.
As saídas são configurações individuais que especificam conexões diferentes para data warehouses ou bancos de dados. Por meio delas, você gerencia conexões com diferentes ambientes:
No nosso perfil, a saída padrão é dev, indicada no campo target. Você pode alterá-la conforme sua necessidade. Por enquanto, vamos manter assim.
Observação: você pode mudar os nomes do perfil e das saídas desde que eles sejam referenciados corretamente no restante dos arquivos do dbt.
O campo path indica a localização de um banco existente chamado dev.duckdb. Se ele não existir, será criado pelo adapter DuckDB do dbt no nosso diretório de trabalho (dentro do projeto dbt_learn; o campo path usa caminhos relativos ao diretório do projeto). Como não temos um banco chamado dev.duckdb, vamos deixar o dbt criá-lo executando o dbt debug.
$ dbt debug
O subcomando debug testa vários aspectos do projeto, como:
profiles.ymlprofiles.ymldbt_project.yml, entre outros.Se você recebeu uma mensagem verde “All tests passed” e apareceu um novo banco dev.duckdb, está tudo certo.
Os models são o coração do dbt, pois representam as transformações pelas quais a ferramenta é conhecida.
Um modelo de dados é uma ideia conceitual que representa estrutura e relacionamentos dentro de um conjunto de dados. No dbt, os models são mais simples e específicos. Eles têm as seguintes características:
.sql (Python é permitido nas versões mais recentes do dbt)Nosso projeto dbt_learn vem pré-populado com dois models de exemplo em models/example:
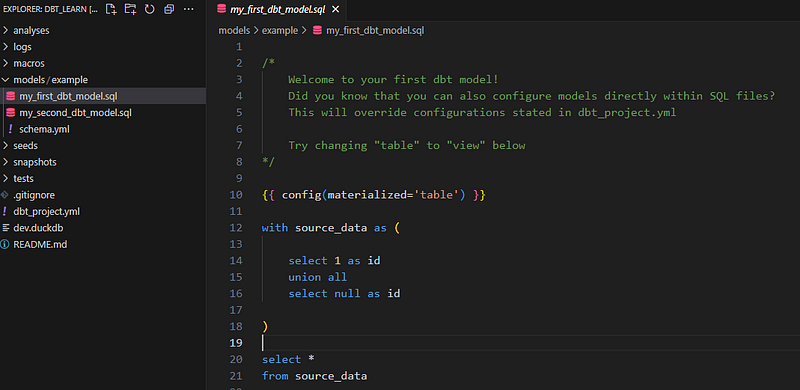
Vamos removê-los e criar os nossos:
$ rm -rf models/example
$ mkdir models/stats
$ touch models/stats/average_diamond_price_per_group.sql
Na última linha, criamos um model chamado average_diamond_price_per_group dentro do diretório stats. É importante usar nomes descritivos.
Dentro do model (arquivo .sql), cole esta query SQL de teste:
SELECT 1 AS Id
e rode o model com dbt run:
$ dbt run
Você deverá ver uma mensagem verde “Completed successfully”.
Com tudo pronto, podemos carregar alguns dados no nosso banco dev.duckdb. Vamos usar um arquivo parquet, já que o DuckDB tem suporte nativo a esse formato.
SELECT AVG(price), cut
 FROM "diamonds.parquet"
GROUP BY cut
A query deve retornar a mesma mensagem de sucesso.
Para este tutorial, eu preparei o dataset diamonds como um arquivo parquet. Neste GitHub gist, você encontra o snippet para baixá-lo para o seu ambiente de trabalho.
Acabamos de ver como criar nosso primeiro model no dbt usando um SELECT que retorna estatísticas resumidas de um dataset. Na prática, seus models vão depender das necessidades de negócio e de como diferentes áreas usam o banco. Por isso, não vamos focar na lógica em si, mas em como implementá-los corretamente.
Em um projeto real, seus models provavelmente dependerão uns dos outros, formando algum tipo de hierarquia. No mundo de dados, essa hierarquia é chamada de grafo acíclico direcionado (DAG) ou grafo de linhagem.
Um único DAG pode valer mais do que mil palavras de documentação. Veja este exemplo na página de DAGs do dbt:
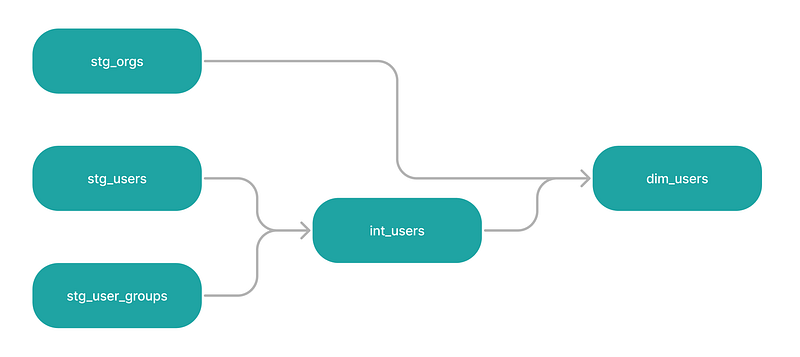
Há quatro models no grafo, todos conectados linearmente aos modelos a jusante. stg_users e stg_user_groups são pais de int_users, que por sua vez é pai de dim_users junto com o model stg_orgs a montante.
Observação: os termos upstream (a montante) e downstream (a jusante) são usados com frequência para indicar a posição relativa de cada model no DAG.
Um aspecto-chave dos DAGs é que não há ciclos fechados. Ou seja, um model a jusante, que é o resultado de modelos anteriores, não pode ser unido a um model a montante. Daí vem o “acíclico”.
Além da visualização rica, o objetivo dos DAGs é permitir que o dbt construa/atualize os models de acordo com suas dependências. Se não definirmos um DAG para os quatro models acima, o dbt os construirá em ordem alfabética — o que geraria todo tipo de erro em vermelho.
Para definir um DAG no dbt, vamos usar a template engine Jinja.
No DAG acima, o model int_users é o produto de stg_users e stg_user_groups. Precisamos especificar essa relação no projeto; caso contrário, dbt run executa tudo em ordem alfabética, o que colocaria int_users primeiro. Isso causaria erro, pois suas dependências ainda não estariam materializadas.
Neste momento, o model int_users pode estar assim:
SELECT some_column
 FROM stg_users as su
 JOIN stg_user_groups as sug
   ON su.a = sug.a
Agora, vamos ligar os três models transformando-os em nós de um DAG usando Jinja:
SELECT some_column
 FROM {{ ref("stg_users") }} as su
 JOIN {{ ref("stg_user_groups" )}} as sug
   ON su.a = sug.a
Em vez de escrever os nomes dos models diretamente, colocamos dentro da função Jinja chamada ref. A sintaxe é {{ ref("column_name") }} (atenção aos espaços e às aspas). Quando a query é compilada, a função Jinja é substituída pelo nome real do model.
Observe que stg_users e stg_user_groups devem existir como arquivos .sql no seu projeto dbt.
Agora, quando executarmos dbt run, o dbt vai buscar as dependências de cada model, conectá-las e executar tudo na ordem correta.
A função ref não é a única que podemos usar no dbt. Na verdade, usando outras funções e recursos do Jinja, você pode expandir bastante o que seu SQL consegue fazer. Alguns exemplos:
{% set status = 'active' %}  -- Define uma variável

SELECT *
FROM customers
WHERE status = {{ status }};
Se tivermos o arquivo models/model_properties.yml com os campos abaixo:
# models/model_properties.yml
version: 2

models:
 - name: my_model
   config:
     target_schema: analytics
Podemos acessar esses campos em qualquer arquivo .sql usando Jinja:
{% set target_schema = config.target_schema %}

CREATE TABLE {{ target_schema }}.{{ target_table }} AS
...
Condicionais:
{% if some_condition %}
 SELECT * FROM test_data
{% else %}
 SELECT * FROM production_data
{% endif %}
Loops:
SELECT
 order_id,
 {% for payment_method in ["bank_transfer", "credit_card", "gift_card"] %}
   SUM(CASE WHEN payment_method = '{{ payment_method }}' THEN amount END) AS {{ payment_method }}_amount,
 {% endfor %}
 SUM(amount) AS total_amount
FROM {{ ref('raw_payments') }}
GROUP BY 1;
Aqui está a macro:
{% macro create_table(table_name, columns) %}
 CREATE TABLE {{ table_name }} (
   {% for column in columns %}
     {{ column.name }} {{ column.type }},
   {% endfor %}
 );
{% endmacro %}
E aqui está como usá-la nos models:
{% call create_table('my_customer_table', [
   {'name': 'id', 'type': 'integer'},
   {'name': 'name', 'type': 'varchar(255)'},
   {'name': 'email', 'type': 'varchar(255)'},
]) %}

INSERT INTO {{ my_customer_table }} (id, name, email)
SELECT customer_id, customer_name, customer_email
FROM raw_customers;
Se quiser aprender mais sobre o uso de Jinja no dbt com SQL, veja esta página da documentação do dbt.
Todo bom desenvolvedor sabe que precisa testar o código constantemente para evitar bugs e erros. Como o dbt aproxima engenheiros de dados do trabalho de software, ele oferece um fluxo simples para usar testes, tanto nativos quanto personalizados.
Hoje, o dbt oferece quatro testes nativos:
unique — verifica se todos os valores são únicosnot_null — verifica ausência de valoresaccepted_values — verifica se todos os valores estão dentro de uma lista especificada; possui o argumento valuesrelationships — verifica a relação com uma tabela ou coluna específica; possui os argumentos to e fieldPara definir quais testes aplicar em quais colunas, usamos um arquivo YAML chamado model_properties.yml dentro do diretório models.
Observação: model_properties.yml não é obrigatório para os models rodarem e pode ter qualquer nome. Mas, se você quiser validar os dados que alimentam seus models por meio de testes, esse arquivo é essencial.
Vamos ver como usar o teste not_null para checar valores ausentes na coluna cut da tabela diamonds. Primeiro, crie o arquivo model_properties.yml dentro de models:
$ touch models/model_properties.yml
Dentro dele, cole o seguinte conteúdo:
version: 2

models:
 - name: average_diamond_price_per_group
   columns:
     - name: cut
       tests:
         - not_null
No campo - name sob models, indicamos para qual model estamos definindo propriedades. Em seguida, especificamos a coluna e seu nome. Por fim, adicionamos o campo tests e listamos o teste not_null.
Agora, você pode usar esse teste para validar os dados antes de executar o dbt run. O comando é dbt test:
$ dbt test
Se aparecer uma mensagem de erro, significa que o teste falhou e você precisa investigar a tabela e corrigir o problema, se necessário.
Para usar o dbt com sucesso nos seus projetos, você pode seguir este fluxo recomendado:
1. Inicialização do projeto
dbt e crie um novo projeto com dbt init2. Configuração
profiles.yml no seu diretório home.dbt_project.yml para definições em nível de projeto (por exemplo, versão, dependências).3. Desenvolvimento
.sql no diretório models..yml no diretório tests com as definições.dbt test com frequência durante o desenvolvimento.dbt debug para troubleshooting.4. Validação local (tópicos que não cobrimos)
dbt build para compilar models e testes.dbt test.Boas práticas adicionais:
dbt docs generate para renderizar a documentação dos models em um servidor web depois (sim, isso é possível).Cobrimos muitos fundamentos neste tutorial, mas, como falei lá no começo, o dbt é uma ferramenta enorme e cheia de recursos. Leva um tempo até dominá-la a ponto de usá-la com tranquilidade em produção. Que tal usar estes recursos para acelerar essa jornada?
Nossos programas de certificação ajudam você a se destacar e a provar que suas habilidades estão prontas para o trabalho para possíveis empregadores.

Comece sua jornada com dbt hoje!
Curso
Curso
Curso
blog
Joleen Bothma
11 min
blog
Kurtis Pykes
11 min
blog
Javier Canales Luna
15 min
blog
Abid Ali Awan
9 min
Tutorial
DataCamp Team
3 min
Tutorial
Kevin Babitz
13 min