
Cours
Introduction à dbt
4 h
33.5K
L’un des prérequis à connaître est celui de data warehouse. Un entrepôt est l’endroit où vous stockez toutes les données d’une entreprise.
Les entreprises conçoivent des entrepôts car ils rendent possibles l’analyse et tout ce que l’on peut faire avec les données (notamment les données structurées). Ils conservent des historiques organisés en tables et sont pensés pour des requêtes et analyses rapides.
De nombreux outils implémentent des data warehouses :
etc.
dbt ne sert pas à collecter ou charger des données dans ces outils, mais à les transformer à l’intérieur. Autrement dit, il réalise le T du processus ETL/ELT (extraction, transformation, chargement) au cœur de tout entrepôt.
dbt est accessible via deux interfaces : dbt Core et dbt Cloud.
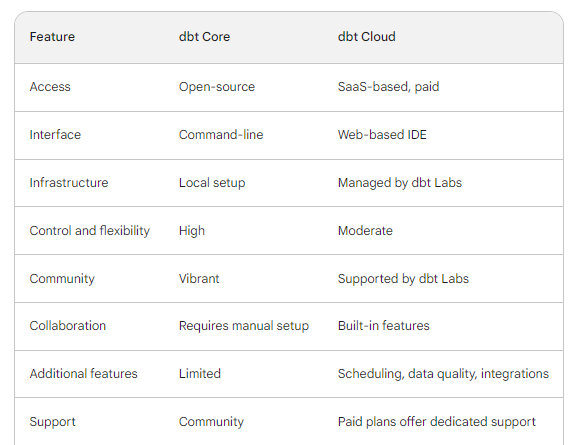
dbt Core est une bibliothèque open source qui implémente l’essentiel des fonctionnalités de dbt. Elle propose une interface en ligne de commande (la commande dbt que vous allez adorer) pour piloter les transformations de vos projets.
dbt Cloud est une solution entreprise pour les équipes. En plus de la CLI, dbt Cloud offre un IDE web plus convivial. Avec lui, vous vous préoccupez beaucoup moins des connexions à la base et de l’édition des fichiers YAML (comme vous le verrez plus loin).
dbt Cloud propose également des fonctionnalités supplémentaires comme la planification de jobs, des intégrations avancées et un support prioritaire.
Voici un tableau récapitulant les différences entre dbt Core et dbt Cloud :
Malgré ces options, nous allons couvrir dbt Core, idéal pour les projets locaux, les tests et l’apprentissage. Vous pouvez l’installer avec pip sur n’importe quel OS (dans un environnement virtuel, bien entendu).
J’utiliserai un environnement Conda :
$ conda create -n learn_dbt -y
$ pip install dbt-<adapter_name>
Remplacez adapter_name par la base que vous souhaitez utiliser. dbt Labs (l’entreprise derrière dbt) propose de nombreux adaptateurs pour différentes plateformes de données.
Dans cet article, nous utiliserons l’adaptateur dbt-duckdb pour nous connecter à une base DuckDB. Mais vous pouvez utiliser n’importe quel adaptateur listé sur cette page de la doc dbt.
$ pip install dbt-duckdb
C’est tout pour l’installation initiale !
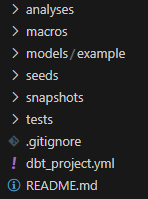
Un projet dbt est tout simplement un répertoire sur votre machine contenant tout le nécessaire pour transformer vos données. On y trouve beaucoup de fichiers .sql (appelés modèles) et des fichiers YAML (pour la configuration).
Pour créer un projet dbt, utilisez la commande dbt init <project_name> dans la CLI :
$ dbt init dbt_learnLe terminal vous demande de saisir un code correspondant aux adaptateurs disponibles. Comme vous n’avez que DuckDB, appuyez sur 1.
$ cd dbt_learn
Dans dbt_learn, vous obtenez la structure suivante :
C’est là que les data engineers adoptent les réflexes des software engineers, car les projets dbt vous permettent d’être :
En bref, les projets dbt offrent un cadre puissant pour gérer et orchestrer les transformations. Ils apportent enfin les bénéfices attendus de l’ingénierie logicielle au monde de la donnée.
Nous avons initialisé un projet dbt et nous devons maintenant nous connecter à une base existante (ou en créer une). Pour cela, il nous faut un moyen sûr de transmettre les identifiants à dbt. C’est le rôle du profil de projet.
Un profil est un fichier YAML contenant les détails de connexion à votre plateforme de données. Il est créé dans le répertoire .dbt de $HOME et s’appelle profiles.yml. Voici à quoi il ressemble pour l’instant :
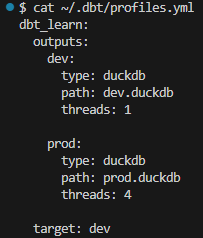
Le fichier contient un profil dbt_learn pour notre projet, avec deux sorties : dev et prod.
Les sorties sont des configurations distinctes qui définissent différentes connexions à des data warehouses ou bases. Elles vous permettent de gérer plusieurs environnements :
Dans notre profil, la sortie par défaut est dev, renseignée dans le champ target. Vous pouvez la modifier selon vos besoins. Pour l’instant, on la laisse telle quelle.
Remarque : vous pouvez renommer le profil et les sorties, tant que ces noms sont correctement référencés dans les autres fichiers dbt.
Le champ path indique l’emplacement d’une base existante appelée dev.duckdb. Si elle n’existe pas, l’adaptateur DuckDB de dbt la créera dans notre répertoire de travail (dans le projet dbt_learn ; path indique un chemin relatif au projet). Comme nous n’avons pas encore dev.duckdb, laissons dbt la créer en exécutant dbt debug.
$ dbt debug
La sous-commande debug teste plusieurs aspects du projet, par exemple :
profiles.ymlprofiles.ymldbt_project.yml, etc.Si vous voyez le message vert « All tests passed » et qu’un nouveau fichier dev.duckdb est apparu, tout est en place.
Les modèles sont au cœur de dbt : ils représentent les transformations qui font la réputation de l’outil.
Un modèle de données est une idée conceptuelle qui décrit la structure et les relations d’un jeu de données. Dans dbt, les modèles sont plus simples et ciblés. Ils ont les caractéristiques suivantes :
.sql (Python est également possible dans les versions récentes)Notre projet dbt_learn est pré-rempli avec deux modèles de démo dans models/example :
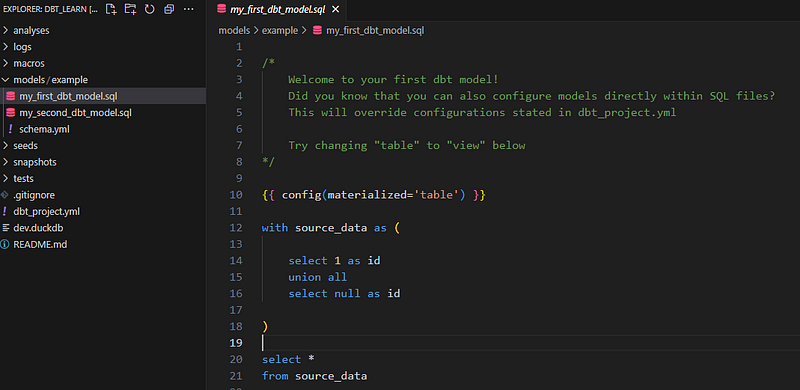
Nous allons les supprimer et créer les nôtres :
$ rm -rf models/example
$ mkdir models/stats
$ touch models/stats/average_diamond_price_per_group.sql
Dans la dernière ligne, nous créons un modèle nommé average_diamond_price_per_group dans le répertoire stats. Il est important d’adopter des noms explicites.
Dans le fichier du modèle (.sql), collez cette requête SQL de test :
SELECT 1 AS Id
puis lancez le modèle avec dbt run :
$ dbt run
Vous devriez voir un message vert « Completed successfully ».
Une fois tout en place, nous pouvons charger des données dans notre base dev.duckdb. Nous utiliserons un fichier Parquet, nativement pris en charge par DuckDB.
SELECT AVG(price), cut
 FROM "diamonds.parquet"
GROUP BY cut
La requête devrait renvoyer le même message de succès.
Pour ce tutoriel, j’ai préparé le jeu de données « diamonds » au format Parquet. Dans ce gist GitHub, vous trouverez un extrait pour le télécharger dans votre espace de travail.
Nous venons de voir comment créer un premier modèle dbt avec une instruction SELECT qui calcule des statistiques résumées. En pratique, vos modèles dépendent de vos besoins métiers et des usages de la base par les équipes. Nous nous concentrerons donc moins sur la logique même des modèles que sur leur bonne mise en œuvre.
Dans un projet réel, vos modèles dépendent très probablement les uns des autres et forment une hiérarchie. Dans l’univers data, cette hiérarchie s’appelle un graphe orienté acyclique (DAG) ou graphe de lignage.
Un DAG peut remplacer des pages de documentation. Regardez cet exemple tiré de la page sur les DAG dbt :
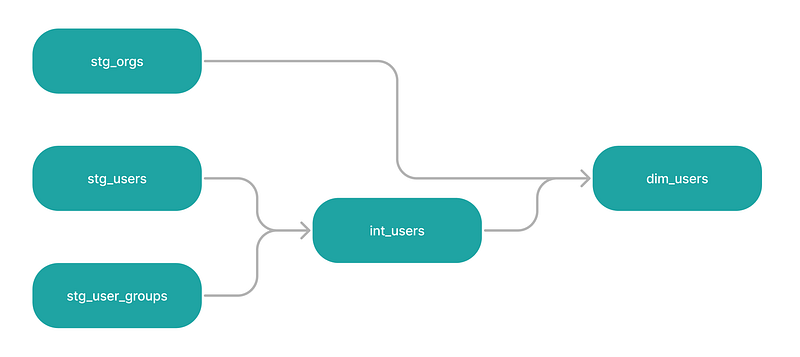
Ce graphe comporte quatre modèles, connectés linéairement vers l’aval. stg_users et stg_user_groups sont parents de int_users, lequel est parent de dim_users avec stg_orgs en amont.
Remarque : on parle souvent d’« amont » (upstream) et d’« aval » (downstream) pour situer un modèle dans le DAG.
Un point clé : il n’y a pas de boucles fermées. Un modèle en aval, qui résulte des modèles précédents, ne peut pas être joint à un modèle en amont. C’est le sens d’« acyclique ».
Au-delà de l’aspect visuel, les DAG permettent à dbt de construire/mettre à jour les modèles selon leurs dépendances. Sans DAG pour ces quatre modèles, dbt les exécuterait par ordre alphabétique, avec à la clé des erreurs en série.
Pour définir un DAG dans dbt, nous allons utiliser les templates Jinja.
Dans le DAG ci-dessus, le modèle int_users résulte de stg_users et stg_user_groups. Nous devons préciser cette relation dans le projet ; sinon, dbt run exécutera les modèles par ordre alphabétique et int_users passera en premier, provoquant une erreur puisque ses dépendances ne seront pas encore matérialisées.
Actuellement, int_users peut ressembler à ceci :
SELECT some_column
 FROM stg_users as su
 JOIN stg_user_groups as sug
   ON su.a = sug.a
Maintenant, relions ces trois modèles en nœuds d’un DAG avec Jinja :
SELECT some_column
 FROM {{ ref("stg_users") }} as su
 JOIN {{ ref("stg_user_groups" )}} as sug
   ON su.a = sug.a
Au lieu d’écrire les noms en dur, nous les passons dans la fonction Jinja ref. Sa syntaxe est {{ ref("column_name") }} (attention aux espaces et aux guillemets). Lors de la compilation, la fonction est remplacée par le nom effectif du modèle.
Notez que stg_users et stg_user_groups doivent exister en tant que fichiers .sql dans votre projet dbt.
Désormais, quand vous lancez dbt run, dbt résout les dépendances, les relie, puis exécute dans le bon ordre.
La fonction ref n’est pas la seule utilisable dans dbt. En exploitant d’autres fonctions et capacités de Jinja, vous pouvez enrichir nettement vos requêtes SQL. Exemples :
{% set status = 'active' %}  -- Define a variable

SELECT *
FROM customers
WHERE status = {{ status }};
Si nous avons un fichier models/model_properties.yml contenant :
# models/model_properties.yml
version: 2

models:
 - name: my_model
   config:
     target_schema: analytics
Nous pouvons accéder à ses champs dans n’importe quel fichier .sql via Jinja :
{% set target_schema = config.target_schema %}

CREATE TABLE {{ target_schema }}.{{ target_table }} AS
...
Conditions :
{% if some_condition %}
 SELECT * FROM test_data
{% else %}
 SELECT * FROM production_data
{% endif %}
Boucles :
SELECT
 order_id,
 {% for payment_method in ["bank_transfer", "credit_card", "gift_card"] %}
   SUM(CASE WHEN payment_method = '{{ payment_method }}' THEN amount END) AS {{ payment_method }}_amount,
 {% endfor %}
 SUM(amount) AS total_amount
FROM {{ ref('raw_payments') }}
GROUP BY 1;
Voici la macro :
{% macro create_table(table_name, columns) %}
 CREATE TABLE {{ table_name }} (
   {% for column in columns %}
     {{ column.name }} {{ column.type }},
   {% endfor %}
 );
{% endmacro %}
Et son utilisation dans des modèles :
{% call create_table('my_customer_table', [
   {'name': 'id', 'type': 'integer'},
   {'name': 'name', 'type': 'varchar(255)'},
   {'name': 'email', 'type': 'varchar(255)'},
]) %}

INSERT INTO {{ my_customer_table }} (id, name, email)
SELECT customer_id, customer_name, customer_email
FROM raw_customers;
Pour en savoir plus sur l’usage de Jinja dans dbt avec SQL, consultez cette page de la doc dbt.
Tout bon développeur teste régulièrement son code. Puisque dbt rapproche les data engineers du développement logiciel, il leur offre un flux simple pour mettre en place des tests, natifs ou personnalisés.
Actuellement, dbt propose quatre tests intégrés :
unique : vérifie l’unicé des valeursnot_null : contrôle l’absence de valeurs manquantesaccepted_values : vérifie que les valeurs appartiennent à une liste spécifiée, avec un argument valuesrelationships : vérifie une relation vers une table ou une colonne spécifique, avec les arguments to et fieldPour indiquer quels tests appliquer à quelles colonnes, on utilise un fichier YAML, model_properties.yml, dans le répertoire models.
Remarque : model_properties.yml n’est pas obligatoire pour exécuter des modèles, et peut porter un autre nom. En revanche, si vous souhaitez valider les données alimentant vos modèles via des tests, ce fichier est indispensable.
Voyons comment utiliser le test not_null pour contrôler les valeurs manquantes dans la colonne cut de la table diamonds. Créez d’abord model_properties.yml dans models :
$ touch models/model_properties.yml
Collez-y le contenu suivant :
version: 2

models:
 - name: average_diamond_price_per_group
   columns:
     - name: cut
       tests:
         - not_null
Dans le champ - name sous models, nous indiquons le modèle concerné. Puis, nous déclarons la colonne et son nom. Enfin, sous tests, nous listons le test not_null.
Vous pouvez maintenant exécuter ce test pour valider les données avant dbt run. La commande est dbt test :
$ dbt test
Si vous obtenez un message d’erreur, le test a échoué : examinez la table et corrigez si besoin.
Pour réussir vos projets avec dbt, vous pouvez suivre ce flux recommandé :
1. Initialisation du projet
dbt et créez un nouveau projet avec dbt init2. Configuration
profiles.yml de votre répertoire personnel.dbt_project.yml pour les réglages globaux (version, dépendances, etc.).3. Développement
.sql dans le répertoire models..yml dans le répertoire tests pour définir vos tests.dbt test pendant le développement.dbt debug pour le dépannage.4. Validation locale (sujets non couverts ici)
dbt build pour compiler modèles et tests.dbt test.Bonnes pratiques complémentaires :
dbt docs generate.Nous avons couvert de nombreux fondamentaux, mais comme indiqué dès le début, dbt est un outil vaste et riche. Il vous faudra un peu de temps pour l’apprivoiser au point de l’utiliser sereinement en production. Pourquoi ne pas vous appuyer sur ces ressources pour accélérer ?
Nos programmes de certification vous aident à vous démarquer et à prouver aux employeurs potentiels que vos compétences sont adaptées à l'emploi.

Commencez votre parcours dbt d’ès aujourd’hui !
Cours
Cours
Cours