Curso
Introducción al dbt
4 h
33.4K
Uno de los conceptos previos que tienes que conocer es el de data warehouse. Un warehouse es donde almacenas todos los datos que pertenecen a una empresa.
Las empresas construyen warehouses porque permiten hacer analítica y todo lo demás que puedes hacer con datos (ejem, datos estructurados). Almacenan datos históricos organizados en tablas y están diseñados para consultas y análisis rápidos.
Hay muchas herramientas que implementan data warehouses:
y más.
dbt no te ayuda a recopilar o cargar datos en las herramientas anteriores, sino a transformar los datos dentro de ellas. En otras palabras, hace la T del proceso ETL/ELT (extracción, transformación y carga) que está en el corazón de todo warehouse.
dbt se ofrece a través de dos interfaces: dbt Core y dbt Cloud.
dbt Core es una librería open-source que implementa la mayor parte de la funcionalidad de dbt. Tiene una interfaz de línea de comandos (el comando dbt que vas a adorar) que puedes usar para gestionar transformaciones de datos en tus proyectos.
dbt Cloud es una solución empresarial para equipos. Además del CLI, dbt Cloud ofrece un IDE web más amigable. Con él, no tienes que preocuparte tanto por las conexiones a bases de datos y la edición de archivos YAML (como verás en las próximas secciones).
dbt Cloud también ofrece funciones adicionales como planificación de jobs, integraciones avanzadas y soporte prioritario.
Aquí tienes una tabla que resume las diferencias entre dbt Core y dbt Cloud:
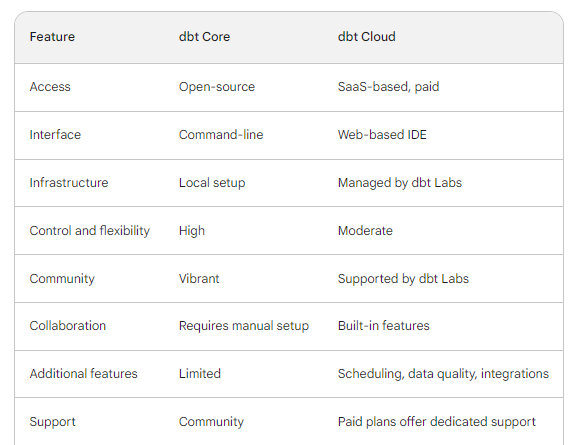
A pesar de las funciones extra, cubriremos dbt Core porque es lo más adecuado para proyectos locales, pruebas y aprendizaje. Puedes instalarlo con pip en cualquier sistema operativo (dentro de un entorno virtual, por supuesto).
Yo usaré un entorno de Conda:
$ conda create -n learn_dbt -y
$ pip install dbt-<adapter_name>
Debes sustituir adapter_name por la base de datos que quieras usar. dbt Labs (la empresa detrás de dbt) ha integrado muchos adaptadores para distintas plataformas de datos.
En este artículo, usaremos el adaptador dbt-duckdb para conectar con una base de datos DuckDB. Pero puedes usar cualquiera de los adaptadores listados en esta página de la documentación de dbt.
$ pip install dbt-duckdb
¡Y con esto terminamos la configuración inicial!
Básicamente, un proyecto de dbt es un directorio en tu máquina que contiene todo lo necesario para realizar transformaciones sobre tus datos. Incluye muchos archivos .sql (llamados modelos) y archivos YAML (para configuraciones).
Para crear un proyecto de dbt, puedes usar el comando dbt init <project_name> en la CLI:
$ dbt init dbt_learnLa terminal te pedirá que introduzcas un código correspondiente a los adaptadores de plataforma de datos disponibles. Como solo tienes DuckDB, puedes pulsar 1.
$ cd dbt_learn
Dentro de dbt_learn, tienes la siguiente estructura:
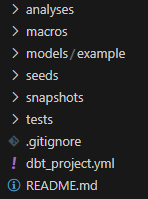
Aquí es donde los data engineers se convierten en software engineers, porque los proyectos de dbt te permiten:
En resumen, los proyectos de dbt ofrecen una forma potente de gestionar y orquestar transformaciones de datos. Traen al mundo del dato los beneficios tan esperados de la ingeniería de software.
Ya hemos inicializado un proyecto de dbt y ahora necesitamos conectarlo a una base de datos existente (o crear una desde cero). Para ello, necesitamos una forma segura de pasar las credenciales de la base de datos a dbt para establecer la conexión. Aquí es donde usaremos un perfil de proyecto.
Un perfil de proyecto es un archivo YAML que contiene los detalles de conexión de la plataforma de datos elegida. El archivo se crea en el directorio .dbt en $HOME y se llama profiles.yml. Ahora mismo se ve así:
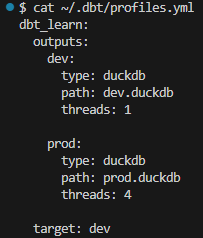
El archivo lista un único perfil llamado dbt_learn para nuestro proyecto. Especifica dos outputs: dev y prod.
Los outputs son configuraciones individuales que especifican distintas conexiones a data warehouses o bases de datos. Con ellos puedes gestionar conexiones a diferentes entornos:
En nuestro perfil, el output predeterminado es dev, indicado en el campo target. Puedes cambiarlo a cualquier otro output según lo necesites. Por ahora, lo dejamos así.
Nota: puedes cambiar los nombres del perfil y de los outputs siempre que estén referenciados correctamente en el resto de archivos de dbt.
El campo path especifica la ubicación de una base de datos existente llamada dev.duckdb. Si no existe, el adaptador DuckDB de dbt la creará en nuestro directorio de trabajo (dentro del proyecto dbt_learn; el campo path especifica rutas relativas al directorio del proyecto). Como no tenemos una base de datos llamada dev.duckdb, dejaremos que dbt la cree ejecutando dbt debug.
$ dbt debug
El subcomando debug se usa para probar muchos aspectos del proyecto, como:
profiles.ymlprofiles.ymldbt_project.yml, etc.Si recibes un mensaje en verde de "All tests passed" y ves una nueva base de datos dev.duckdb, estás listo para continuar.
Los modelos son el corazón de dbt, ya que representan las transformaciones que han hecho famoso a dbt.
Un modelo de datos es una idea conceptual que representa la estructura y las relaciones dentro de un conjunto de datos. En dbt, los modelos son más simples y específicos. Tienen estas características:
.sql (en versiones recientes de dbt también se permite Python)Nuestro proyecto dbt_learn viene prellenado con dos modelos de ejemplo en models/example:
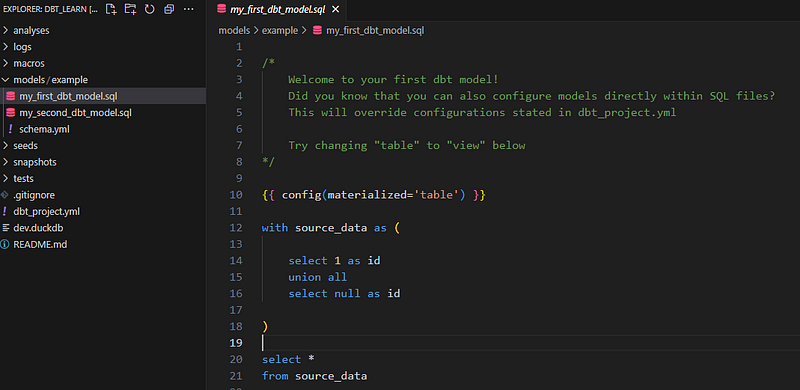
Los borraremos y crearemos los nuestros:
$ rm -rf models/example
$ mkdir models/stats
$ touch models/stats/average_diamond_price_per_group.sql
En la última línea del fragmento anterior, estamos creando un modelo llamado average_diamond_price_per_group dentro del directorio stats. Es importante usar nombres descriptivos para los modelos.
Dentro del modelo (archivo .sql), pega esta consulta SQL de prueba:
SELECT 1 AS Id
y ejecuta el modelo con dbt run:
$ dbt run
Deberías ver un mensaje en verde de "Completed successfully".
Una vez que todo está configurado, podemos cargar algunos datos en nuestra base de datos dev.duckdb. Usaremos un archivo parquet, ya que DuckDB los soporta de forma nativa.
SELECT AVG(price), cut
 FROM "diamonds.parquet"
GROUP BY cut
La consulta debería devolver el mismo mensaje de éxito.
Para este tutorial, he preparado el conjunto de datos de diamantes como archivo parquet. En este gist de GitHub encontrarás el script para descargarlo a tu espacio de trabajo.
Acabamos de ver cómo crear nuestro primer modelo de dbt usando una sentencia SELECT que devuelve estadísticas de resumen de un dataset. En la práctica, tus modelos dependerán de los requisitos del negocio y de cómo trabajan con la base de datos las distintas personas. Por ello, no nos centraremos en la lógica de los modelos de dbt, sino en cómo implementarlos correctamente.
En un proyecto real, lo más probable es que tus modelos dependan entre sí, formando algún tipo de jerarquía. En el mundo de los datos, a esta jerarquía se la llama grafo acíclico dirigido (DAG) o grafo de linaje.
Un solo DAG puede sustituir a una documentación de mil palabras. Echa un vistazo a este ejemplo de la página de DAGs de dbt:
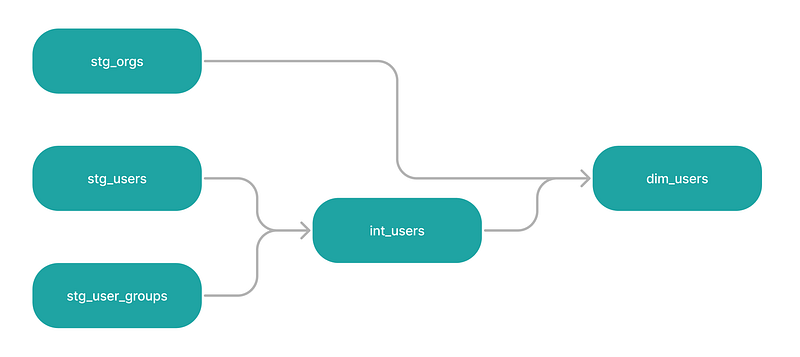
Hay cuatro modelos en este grafo, todos conectados linealmente con modelos downstream. stg_users y stg_user_groups son modelos padre de int_users que, a su vez, es padre de dim_users junto con el modelo stg_orgs upstream.
Nota: los términos upstream y downstream se usan con frecuencia para referirse a la posición relativa de cada modelo en el DAG.
Un aspecto clave de los DAGs es que no hay bucles cerrados. Esto significa que un modelo downstream, que es el resultado de modelos anteriores, no puede unirse con un modelo upstream. De ahí viene lo de acíclico.
Más allá de su riqueza visual, su propósito es permitir que dbt construya/actualice los modelos según sus dependencias. Si no definimos un DAG para los cuatro modelos anteriores, dbt los construirá en orden alfabético. Eso daría lugar a todo tipo de mensajes en rojo y errores.
Para definir un DAG en dbt, usaremos plantillas Jinja.
En el DAG anterior, el modelo int_users es el resultado de stg_users y stg_user_groups. Debemos especificar esta relación en nuestro proyecto; de lo contrario, dbt run ejecutará todos los modelos por orden alfabético, lo que significa que int_users iría primero. Esto provocará un error porque sus dependencias aún no están materializadas.
Ahora mismo, el modelo int_users puede tener este aspecto:
SELECT some_column
 FROM stg_users as su
 JOIN stg_user_groups as sug
   ON su.a = sug.a
Ahora vamos a enlazar los tres modelos convirtiéndolos en nodos de un DAG usando Jinja:
SELECT some_column
 FROM {{ ref("stg_users") }} as su
 JOIN {{ ref("stg_user_groups" )}} as sug
   ON su.a = sug.a
En lugar de escribir los nombres de los modelos directamente, los ponemos dentro de una función de Jinja llamada ref. La sintaxis es {{ ref("column_name") }} (atento a los espacios y a las comillas). Cuando nuestra consulta se compila, la función de Jinja se sustituye por el nombre real del modelo.
Ten en cuenta que stg_users y stg_user_groups deben existir como archivos .sql en tu proyecto de dbt.
Ahora, cuando ejecutemos dbt run, buscará las dependencias de cada modelo, las conectará y las ejecutará en el orden correcto.
La función ref en Jinja no es la única que podemos usar en dbt. De hecho, usando otras funciones y características de Jinja puedes ampliar considerablemente la potencia de tus sentencias SQL. Aquí tienes algunos ejemplos:
{% set status = 'active' %}  -- Define una variable

SELECT *
FROM customers
WHERE status = {{ status }};
Si tenemos el archivo models/model_properties.yml y contiene los siguientes campos:
# models/model_properties.yml
version: 2

models:
 - name: my_model
   config:
     target_schema: analytics
Podemos acceder a sus campos dentro de cualquier archivo .sql usando Jinja:
{% set target_schema = config.target_schema %}

CREATE TABLE {{ target_schema }}.{{ target_table }} AS
...
Condicionales:
{% if some_condition %}
 SELECT * FROM test_data
{% else %}
 SELECT * FROM production_data
{% endif %}
Bucles:
SELECT
 order_id,
 {% for payment_method in ["bank_transfer", "credit_card", "gift_card"] %}
   SUM(CASE WHEN payment_method = '{{ payment_method }}' THEN amount END) AS {{ payment_method }}_amount,
 {% endfor %}
 SUM(amount) AS total_amount
FROM {{ ref('raw_payments') }}
GROUP BY 1;
Aquí va la macro:
{% macro create_table(table_name, columns) %}
 CREATE TABLE {{ table_name }} (
   {% for column in columns %}
     {{ column.name }} {{ column.type }},
   {% endfor %}
 );
{% endmacro %}
Y así puedes usarla en los modelos:
{% call create_table('my_customer_table', [
   {'name': 'id', 'type': 'integer'},
   {'name': 'name', 'type': 'varchar(255)'},
   {'name': 'email', 'type': 'varchar(255)'},
]) %}

INSERT INTO {{ my_customer_table }} (id, name, email)
SELECT customer_id, customer_name, customer_email
FROM raw_customers;
Si quieres aprender más sobre cómo usar Jinja en dbt con SQL, consulta esta página de la documentación de dbt.
Todo buen desarrollador de software sabe que tiene que probar su código constantemente para detectar bugs y errores. Como dbt convierte a los data engineers en desarrolladores de software, les ofrece un flujo de trabajo sencillo para usar tests, tanto integrados como personalizados.
Actualmente, dbt ofrece estos cuatro tests integrados:
unique - verifica que todos los valores sean únicosnot_null - comprueba valores faltantesaccepted_values - verifica que todos los valores estén dentro de una lista especificada; tiene el argumento valuesrelationships - verifica la relación con una tabla o columna específica; tiene los argumentos to y fieldPara especificar qué tests usar en qué columnas, utilizamos un archivo YAML llamado model_properties.yml dentro del directorio models.
Nota: model_properties.yml no es obligatorio para que los modelos se ejecuten y puede llamarse como quieras. Pero si quieres crear tests para validar los datos que alimentan a tus modelos, este archivo es imprescindible.
Veamos cómo usar el test not_null para comprobar valores faltantes en la columna cut de la tabla de diamantes. Primero, crea un archivo model_properties.yml dentro de models:
$ touch models/model_properties.yml
Dentro, pega el siguiente contenido:
version: 2

models:
 - name: average_diamond_price_per_group
   columns:
     - name: cut
       tests:
         - not_null
En el campo - name bajo models, indicamos para qué modelo definimos propiedades. Luego, especificamos la columna y su nombre. Por último, escribimos el campo tests, bajo el cual listamos el test not_null.
Ahora puedes usar este test para hacer validaciones de datos antes de ejecutar dbt run. El comando es dbt test:
$ dbt test
Si recibes un mensaje de error, significa que el test ha fallado y debes examinar el problema en la tabla y corregirlo si es necesario.
Para usar dbt con éxito en tus proyectos, puedes seguir este flujo recomendado:
1. Inicialización del proyecto
dbt y crea un nuevo proyecto con dbt init2. Configuración
profiles.yml en tu directorio de usuario.dbt_project.yml para la configuración a nivel de proyecto (por ejemplo, versión, dependencias).3. Desarrollo
.sql en el directorio models con las definiciones..yml en el directorio tests con las definiciones de pruebas.dbt test para ejecutar tests con frecuencia durante el desarrollo.dbt debug para el troubleshooting.4. Validación local (temas que no cubrimos)
dbt build para compilar modelos y tests.dbt test.Buenas prácticas adicionales:
dbt docs generate para renderizar la documentación de los modelos en un servidor web (sí, se puede) más adelante.Hemos cubierto muchos fundamentos en este tutorial, pero como comenté al principio, dbt es una herramienta enorme, con muchas funciones. Te llevará un tiempo dominarla hasta sentirte cómodo en entornos de producción. ¿Por qué no usar estos recursos para acelerar ese camino?
Nuestros programas de certificación te ayudan a destacar y a demostrar que tus aptitudes están preparadas para el trabajo a posibles empleadores.

¡Empieza hoy tu camino con dbt!
Curso
Curso
Curso
blog
Javier Canales Luna
15 min
blog
Joleen Bothma
11 min
blog
Tim Lu
12 min
Tutorial
Joleen Bothma
9 min
Tutorial
Joleen Bothma
11 min
Tutorial
Abid Ali Awan
9 min