
Kurs
dbt'ye Giriş
4 sa
34K
Bilmeniz gereken önkoşul kavramlardan biri veri ambarıdır. Ambar, bir şirkete ait tüm verilerin saklandığı yerdir.
Şirketler veri ambarları kurar çünkü analitiği ve verilerle (öhm, yapılandırılmış verilerle) yapabileceğiniz her şeyi mümkün kılarlar. Geçmiş verileri tablolar hâlinde saklarlar ve hızlı sorgulama ve analiz için yapılandırılmıştır.
Veri ambarlarını hayata geçiren pek çok araç vardır:
vb.
dbt, yukarıdaki araçlara veri toplamaya veya yüklemeye yardımcı olmaz; bunun yerine içlerindeki verileri dönüştürür. Başka bir deyişle, tüm ambarların kalbinde yer alan ETL/ELT sürecindeki (extraction, transformation, load) T işlemini yapar.
dbt iki arayüz üzerinden sunulur: dbt Core ve dbt Cloud.
dbt Core, dbt işlevlerinin çoğunu uygulayan açık kaynaklı bir kütüphanedir. Projelerinizde veri dönüşümlerini yönetmek için kullanabileceğiniz bir komut satırı arayüzüne (seveceğiniz dbt komutu) sahiptir.
dbt Cloud, ekipler için kurumsal bir çözümdür. CLI’ın yanı sıra dbt Cloud daha kullanıcı dostu, web tabanlı bir IDE sunar. Bununla, veritabanı bağlantıları ve YAML dosyalarını düzenleme konusunda (birazdan göreceğiniz üzere) bu kadar endişelenmenize gerek kalmaz.
dbt Cloud ayrıca iş zamanlama, gelişmiş entegrasyonlar ve öncelikli destek gibi ek özellikler de sunar.
İşte dbt Core ve dbt Cloud arasındaki farkları özetleyen bir tablo:
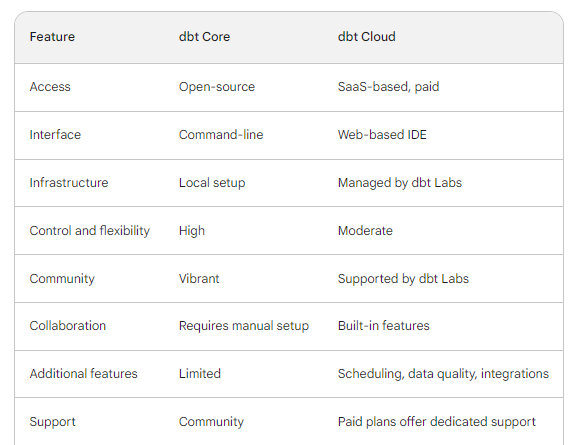
Ek özelliklere rağmen, yerel projeler, test ve öğrenme için en uygun olan dbt Core’u ele alacağız. Herhangi bir işletim sisteminde pip ile kurabilirsiniz (tabii ki bir sanal ortam içinde).
Ben bir Conda ortamı kullanacağım:
$ conda create -n learn_dbt -y
$ pip install dbt-<adapter_name>
adapter_name değerini kullanmak istediğiniz veritabanıyla değiştirmelisiniz. dbt’nin arkasındaki şirket olan dbt Labs, farklı veri platformları için birçok adaptörü entegre etti.
Bu makalede, DuckDB veritabanına bağlanmak için dbt-duckdb adaptörünü kullanacağız. Ancak dbt dokümanlarının bu sayfasında listelenen adaptörlerden herhangi birini kullanabilirsiniz.
$ pip install dbt-duckdb
İlk kurulum bu kadar!
Özetle, bir dbt projesi makinenizde verileriniz üzerinde dönüşümler yapmak için gereken her şeyi içeren bir dizindir. Çok sayıda .sql dosyası (model olarak adlandırılır) ve YAML dosyası (yapılandırmalar için) barındırır.
Bir dbt projesi oluşturmak için CLI üzerinde dbt init <project_name> komutunu kullanabilirsiniz:
$ dbt init dbt_learnTerminal, mevcut veri platformu adaptörlerinize karşılık gelen bir kod girmenizi ister. Yalnızca DuckDB’ye sahip olduğunuzdan 1’e basabilirsiniz.
$ cd dbt_learn
dbt_learn içinde şu yapı bulunur:
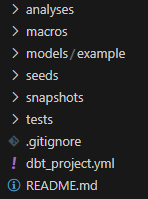
Burası, veri mühendislerinin yazılım mühendisine dönüştüğü yerdir; çünkü dbt projeleri size şunları sağlar:
Kısacası, dbt projeleri veri dönüşümlerini yönetmek ve orkestre etmek için güçlü bir yol sunar. Yazılım mühendisliğinin uzun zamandır beklenen faydalarını veri dünyasına taşırlar.
Bir dbt projesi başlattık ve şimdi mevcut bir veritabanına bağlanmamız (ya da sıfırdan bir tane oluşturmamız) gerekiyor. Bunu yapmak için dbt’ye veritabanı kimlik bilgilerini güvenli şekilde aktararak bir bağlantı kurmanın yoluna ihtiyacımız var. İşte burada bir proje profili kullanacağız.
Proje profili, seçtiğiniz veri platformuna ait bağlantı ayrıntılarını içeren bir YAML dosyasıdır. Dosyanın kendisi $HOME içindeki .dbt dizininde oluşturulur ve adı profiles.yml’dir. Şu anda şöyle görünüyor:
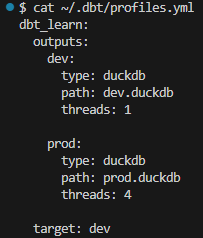
Dosya, projemiz için dbt_learn adında tek bir profil listeler. İki çıktı belirtir: dev ve prod.
Çıktılar, veri ambarlarına veya veritabanlarına farklı bağlantıları belirten bireysel yapılandırmalardır. Çıktılar aracılığıyla farklı ortamlarla bağlantıları yönetebilirsiniz:
Profilimizde varsayılan çıktı, target alanında listelenen dev’dir. İhtiyaçlarınıza göre başka herhangi bir çıktıyla değiştirebilirsiniz. Şimdilik olduğu gibi bırakıyoruz.
Not: profil ve çıktı adlarını, dbt dosyalarının geri kalanında doğru şekilde referans verildiği sürece değiştirebilirsiniz.
path alanı, dev.duckdb adlı mevcut bir veritabanının konumunu belirtir. Yoksa, dbt DuckDB adaptörü tarafından çalışma dizinimizde ( dbt_learn projesinin içinde; path alanı proje dizinine göreceli yollar belirtir) oluşturulacaktır. dev.duckdb adlı bir veritabanımız olmadığından, dbt debug çalıştırarak oluşturmasını sağlayacağız.
$ dbt debug
debug alt komutu, projenin birçok yönünü test etmek için kullanılır; örneğin:
profiles.yml dosyasındaki hatalarprofiles.yml içindeki veritabanı bağlantı ayrıntılarıdbt_project.yml dosyasındaki hatalar vb.Yeşil “All tests passed” mesajını aldıysanız ve yeni bir dev.duckdb veritabanı oluştuysa, hazırsınız demektir.
Modeller, dbt’nin kalbidir; çünkü dbt’yi ünlü yapan asıl dönüşümleri temsil ederler.
Bir veri modeli, bir veri kümesinin içindeki yapı ve ilişkileri temsil eden kavramsal bir fikirdir. dbt’deki veri modelleri daha basit ve daha özeldir. Şu özelliklere sahiptirler:
.sql dosyalarında SQL ile yazılır (dbt’nin yeni sürümlerinde Python da mümkündür)dbt_learn projemiz, models/example içinde iki örnek modelle birlikte gelir:
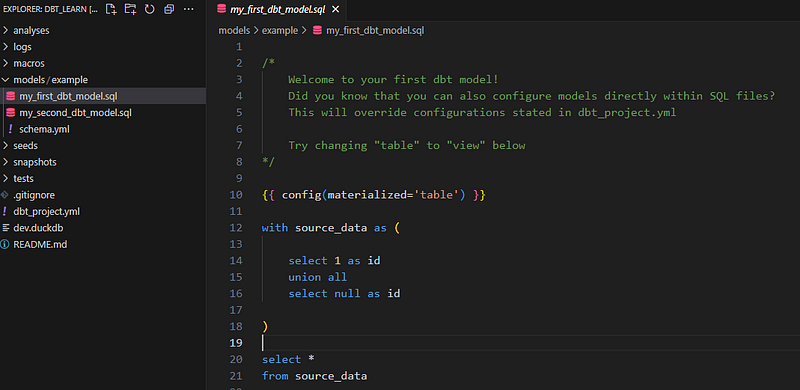
Bunları sileceğiz ve kendi modellerimizi oluşturacağız:
$ rm -rf models/example
$ mkdir models/stats
$ touch models/stats/average_diamond_price_per_group.sql
Yukarıdaki kod parçacığının son satırında, stats dizini içinde average_diamond_price_per_group adlı bir model oluşturuyoruz. Model adlarında açıklayıcı olmak önemlidir.
Modelin (.sql dosyasının) içine şu sahte test SQL sorgusunu yapıştırın:
SELECT 1 AS Id
ve modeli dbt run ile çalıştırın:
$ dbt run
Yeşil “Completed successfully” mesajını almalısınız.
Her şey kurulduktan sonra, dev.duckdb veritabanımıza biraz veri yükleyebiliriz. DuckDB bunları yerel olarak desteklediği için bir parquet dosyası kullanacağız.
SELECT AVG(price), cut
 FROM "diamonds.parquet"
GROUP BY cut
Sorgu aynı başarı mesajını döndürmelidir.
Bu eğitim için elmaslar veri setini bir parquet dosyası olarak hazırladım. Bu GitHub gist içinde, çalışma alanınıza indirmeniz için kod parçacığını bulabilirsiniz.
Bir veri kümesi hakkında bazı özet istatistikler döndüren bir SELECT ifadesi kullanarak ilk dbt modelimizi nasıl oluşturacağımızı gördük. Pratikte, modelleriniz iş gereksinimlerinize ve farklı çalışanların veritabanınızla nasıl çalıştığına bağlı olacaktır. Bu nedenle, dbt modellerinin gerçek mantığına değil, onları doğru şekilde nasıl uygulayacağınıza odaklanacağız.
Gerçek bir projede, modelleriniz büyük olasılıkla birbirine bağımlı olacak ve bir tür hiyerarşi oluşturacaktır. Veri dünyasında bu hiyerarşi, Doğrudan Döngüsüz Grafik (DAG) veya soy ağacı grafiği olarak adlandırılır.
Tek bir DAG, 1000 kelimelik bir dokümantasyonun işini görebilir. dbt DAG’leri sayfasındaki şu örneğe bir bakın:
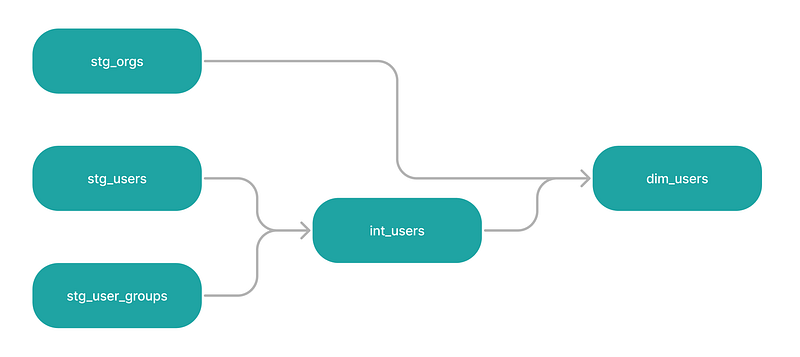
Grafikte dört model var ve hepsi aşağı akıştaki modellere doğrusal biçimde bağlı. stg_users ve stg_user_groups, int_users’ın üst modelleridir; bu model de stg_orgs üst modeliyle birlikte dim_users’ın üst modelidir.
Not: upstream (yukarı akış) ve downstream (aşağı akış) kelimeleri, DAG içindeki her modelin göreli konumuna atıfta bulunmak için sıklıkla kullanılır.
DAG’lerin kilit yönlerinden biri kapalı döngülerin olmamasıdır. Yani önceki modellerin sonucu olan bir aşağı akış modeli, yukarı akıştaki bir modelle birleştirilemez. Döngüsüz kelimesi buradan gelir.
DAG’lerin görsel zenginliğinin ötesinde amaçları, dbt’nin modelleri bağımlılıklarına göre inşa/ güncellemesine imkân vermektir. Yukarıdaki dört model için bir DAG tanımlamazsak, dbt onları alfabetik sırayla inşa eder. Bu da her türden kırmızı mesaj ve hatayla sonuçlanır.
dbt’de bir DAG tanımlamak için Jinja şablonlamasını kullanacağız.
Yukarıdaki DAG’de, int_users modeli stg_users ve stg_user_groups’un ürünüdür. Bu ilişkiyi projemizde belirtmemiz gerekir; aksi hâlde dbt run tüm modelleri alfabetik olarak çalıştırır, bu da int_users’ın önce gitmesi anlamına gelir. Bu, bağımlılıkları henüz oluşturulmadığından hataya yol açar.
Şu anda, int_users modeli şöyle görünebilir:
SELECT some_column
 FROM stg_users as su
 JOIN stg_user_groups as sug
   ON su.a = sug.a
Şimdi, Jinja kullanarak bu üç modeli bir DAG’in düğümlerine dönüştürüp birbirine bağlayacağız:
SELECT some_column
 FROM {{ ref("stg_users") }} as su
 JOIN {{ ref("stg_user_groups" )}} as sug
   ON su.a = sug.a
Model adlarını doğrudan yazmak yerine, onları ref adlı bir Jinja fonksiyonunun içine koyuyoruz. Sözdizimi {{ ref("column_name") }} şeklindedir (boşluklara ve tırnaklara dikkat). Sorgumuz derlendiğinde Jinja fonksiyonu gerçek model adıyla değiştirilir.
stg_users ve stg_user_groups’un dbt projenizde .sql dosyaları olarak mevcut olması gerektiğini unutmayın.
Artık dbt run çalıştırdığımızda, her modelin bağımlılıklarını arayacak, onları birbirine bağlayacak ve buna göre çalıştıracaktır.
Jinja’daki ref fonksiyonu dbt’de kullanabileceğimiz tek fonksiyon değildir. Aslında, Jinja’nın diğer fonksiyon ve özelliklerini kullanarak SQL ifadelerinizin işlevselliğini önemli ölçüde genişletebilirsiniz. İşte bazı örnekler:
{% set status = 'active' %}  -- Define a variable

SELECT *
FROM customers
WHERE status = {{ status }};
models/model_properties.yml dosyamız varsa ve şu alanları içeriyorsa:
# models/model_properties.yml
version: 2

models:
 - name: my_model
   config:
     target_schema: analytics
Jinja kullanarak herhangi bir .sql dosyası içinde alanlarına erişebiliriz:
{% set target_schema = config.target_schema %}

CREATE TABLE {{ target_schema }}.{{ target_table }} AS
...
Koşullar:
{% if some_condition %}
 SELECT * FROM test_data
{% else %}
 SELECT * FROM production_data
{% endif %}
Döngüler:
SELECT
 order_id,
 {% for payment_method in ["bank_transfer", "credit_card", "gift_card"] %}
   SUM(CASE WHEN payment_method = '{{ payment_method }}' THEN amount END) AS {{ payment_method }}_amount,
 {% endfor %}
 SUM(amount) AS total_amount
FROM {{ ref('raw_payments') }}
GROUP BY 1;
İşte makro:
{% macro create_table(table_name, columns) %}
 CREATE TABLE {{ table_name }} (
   {% for column in columns %}
     {{ column.name }} {{ column.type }},
   {% endfor %}
 );
{% endmacro %}
Ve modellerde nasıl kullanabileceğiniz:
{% call create_table('my_customer_table', [
   {'name': 'id', 'type': 'integer'},
   {'name': 'name', 'type': 'varchar(255)'},
   {'name': 'email', 'type': 'varchar(255)'},
]) %}

INSERT INTO {{ my_customer_table }} (id, name, email)
SELECT customer_id, customer_name, customer_email
FROM raw_customers;
dbt’de SQL ile Jinja kullanımı hakkında daha fazla bilgi edinmek isterseniz, dbt dokümanlarının bu sayfasına göz atın.
İyi bir yazılım geliştirici, kodunu hatalar için sürekli test etmesi gerektiğini bilir. dbt veri mühendislerini yazılım geliştiricilere dönüştürdüğüne göre, yerleşik ve özel testleri kullanmak için onlara basit bir iş akışı sunar.
Şu anda dbt, aşağıdaki dört yerleşik testi sunmaktadır:
unique - tüm değerlerin benzersiz olduğunu doğrularnot_null - eksikleri kontrol ederaccepted_values - tüm değerlerin belirtilen bir liste içinde olduğunu doğrular, values argümanına sahiptirrelationships - belirli bir tabloya veya sütuna bağlantıyı doğrular, to ve field argümanlarına sahiptirHangi sütunlarda hangi testleri kullanacağımızı belirtmek için models dizini içinde model_properties.yml adlı bir YAML dosyası kullanırız.
Not: model_properties.yml, modellerin çalışması için zorunlu değildir ve herhangi bir ad verilebilir. Ancak, modellerinize veri besleyen verileri testlerle doğrulamak istiyorsanız, bu dosya şarttır.
Elmaslar tablosundaki cut sütununda eksik değerleri kontrol etmek için not_null testini nasıl kullanacağımıza bakalım. Önce, models içinde bir model_properties.yml dosyası oluşturun:
$ touch models/model_properties.yml
İçine aşağıdaki içeriği yapıştırın:
version: 2

models:
 - name: average_diamond_price_per_group
   columns:
     - name: cut
       tests:
         - not_null
models altındaki - name alanında, özelliklerini tanımladığımız modeli belirtiyoruz. Ardından sütunu ve adını belirtiyoruz. Son olarak tests alanını yazıp altına not_null testini listeliyoruz.
Artık bu testi, dbt run çalıştırmadan önce veri doğrulaması yapmak için kullanabilirsiniz. Komut dbt test’tir:
$ dbt test
Bir hata mesajı alırsanız, testin başarısız olduğu anlamına gelir ve tablodaki sorunu inceleyip gerekirse düzeltmeniz gerekir.
Projelerinizde dbt’yi başarıyla kullanmak için şu önerilen iş akışını izleyebilirsiniz:
1. Proje başlatma
dbt’yi kurun ve dbt init ile yeni bir proje oluşturun2. Yapılandırma
profiles.yml içinde veritabanı kimlik bilgilerini yapılandırın.dbt_project.yml dosyasını proje düzeyi ayarlar (ör. sürüm, bağımlılıklar) için değiştirin.3. Geliştirme
models dizininde .sql dosyaları oluşturun.tests dizininde .yml dosyaları oluşturun.dbt test kullanın.dbt debug kullanın.4. Yerel Doğrulama (ele almadığımız konular)
Ek en iyi uygulamalar:
dbt docs generate ile modellerin dokümanlarını bir web sunucusunda (evet, mümkün) oluşturabilirsiniz.Bu eğitimde birçok temeli ele aldık; ancak en başta da belirttiğim gibi, dbt pek çok özelliği olan devasa bir araçtır. Üretim ortamlarında rahatça kullanabilecek seviyede ustalaşmanız zaman alacaktır. Neden bu hedefe daha hızlı ulaşmak için şu kaynakları kullanmayasınız?
dbt Yolculuğunuza Bugün Başlayın!
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




