
Last chance! 50% off DataCamp Premium
Sale ends in
उन पूर्वापेक्षित कॉन्सेप्ट्स में से एक जिसे आपको जानना होगा, वह है डेटा वेयरहाउस। वेयरहाउस वह जगह है जहाँ आप किसी कंपनी से संबंधित सभी डेटा संग्रहीत करते हैं।
कंपनियाँ वेयरहाउस बनाती हैं क्योंकि वे विश्लेषण और डेटा से जुड़ी बाकी सभी चीज़ों (हम्, स्ट्रक्चर्ड डेटा) को संभव बनाते हैं। वे ऐतिहासिक डेटा को टेबलों में संग्रहीत करते हैं और तेज़ क्वेरी और विश्लेषण के लिए संरचित होते हैं।
कई टूल हैं जो डेटा वेयरहाउस को लागू करते हैं:
आदि।
dbt आपको ऊपर दिए गए टूल्स में डेटा इकट्ठा करने या लोड करने में मदद नहीं करता, बल्कि उनके भीतर डेटा को ट्रांसफॉर्म करता है। दूसरे शब्दों में, यह ETL/ELT प्रक्रिया (extraction, transformation, load) में T करता है, जो सभी वेयरहाउस के केंद्र में है।
dbt दो इंटरफेस के माध्यम से उपलब्ध है: dbt Core और dbt Cloud।
dbt Core एक ओपन-सोर्स लाइब्रेरी है जो dbt की अधिकांश फंक्शनैलिटी लागू करती है। इसमें एक कमांड-लाइन इंटरफेस (वह dbt कमांड जिसे आप पसंद करने लगेंगे) होता है, जिसका उपयोग आप अपने प्रोजेक्ट्स में डेटा ट्रांसफॉर्मेशन को मैनेज करने के लिए कर सकते हैं।
dbt Cloud टीमों के लिए एक एंटरप्राइज़ समाधान है। CLI के ऊपर, dbt Cloud एक अधिक उपयोगकर्ता-अनुकूल वेब-आधारित IDE भी प्रदान करता है। इसके साथ, आपको डेटाबेस कनेक्शन्स और YAML फ़ाइलों को एडिट करने की ज्यादा चिंता नहीं करनी पड़ती (जैसा कि आप आगे के अनुभागों में देखेंगे)।
dbt Cloud जॉब शेड्यूलिंग, उन्नत इंटीग्रेशन्स और उच्च-प्राथमिकता सपोर्ट जैसी अतिरिक्त सुविधाएँ भी प्रदान करता है।
यहाँ एक तालिका है जो dbt Core और dbt Cloud के अंतर को संक्षेप में बताती है:
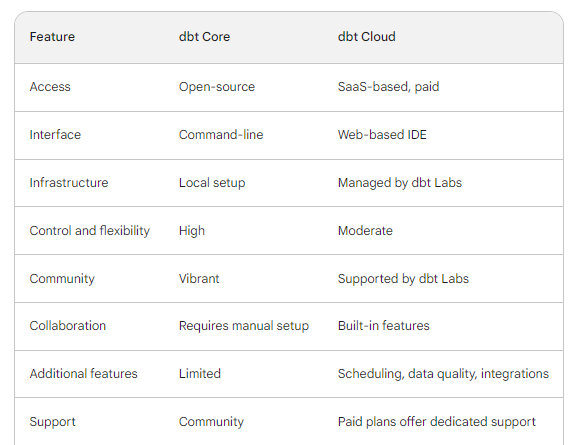
अतिरिक्त सुविधाओं के बावजूद, हम dbt Core को कवर करेंगे क्योंकि यह लोकल प्रोजेक्ट्स, टेस्टिंग और सीखने के लिए सबसे उपयुक्त है। आप इसे किसी भी OS पर pip से इंस्टॉल कर सकते हैं (बिल्कुल, एक वर्चुअल एनवायरनमेंट के भीतर)।
मैं Conda एनवायरनमेंट का उपयोग करूँगा:
$ conda create -n learn_dbt -y
$ pip install dbt-<adapter_name>
आपको adapter_name को उस डेटाबेस से बदलना चाहिए जिसे आप उपयोग करना चाहते हैं। dbt Labs (dbt के पीछे की कंपनी) ने अलग-अलग डेटा प्लेटफ़ॉर्म्स के लिए कई एडेप्टर्स इंटीग्रेट किए हैं।
इस लेख में, हम DuckDB डेटाबेस से कनेक्ट होने के लिए dbt-duckdb एडेप्टर का उपयोग करेंगे। लेकिन आप dbt डॉक्यूमेंटेशन के इस पेज पर सूचीबद्ध किसी भी एडेप्टर का उपयोग कर सकते हैं।
$ pip install dbt-duckdb
प्रारंभिक सेटअप के लिए बस इतना ही!
मूल रूप से, एक dbt प्रोजेक्ट आपकी मशीन पर एक डायरेक्टरी होती है जिसमें आपके डेटा पर ट्रांसफॉर्मेशन करने के लिए आवश्यक हर चीज़ शामिल होती है। इसमें बहुत-सी .sql फ़ाइलें (जिन्हें मॉडल कहा जाता है) और YAML फ़ाइलें (कॉन्फ़िगरेशन के लिए) होती हैं।
एक dbt प्रोजेक्ट बनाने के लिए, आप CLI पर dbt init <project_name> कमांड का उपयोग कर सकते हैं:
$ dbt init dbt_learnटर्मिनल आपसे एक कोड डालने को कहेगा जो आपके उपलब्ध डेटा प्लेटफ़ॉर्म एडेप्टर्स से मेल खाता है। चूँकि आपके पास केवल DuckDB है, आप 1 दबा सकते हैं।
$ cd dbt_learn
dbt_learn के अंदर, आपके पास निम्न संरचना होगी:
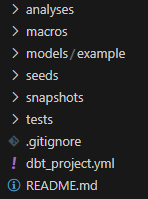
यहीं डेटा इंजीनियर सॉफ्टवेयर इंजीनियर बनते हैं क्योंकि dbt प्रोजेक्ट्स आपको यह करने देते हैं:
संक्षेप में, dbt प्रोजेक्ट्स डेटा ट्रांसफॉर्मेशन को मैनेज और ऑर्केस्ट्रेट करने का एक शक्तिशाली तरीका प्रदान करते हैं। वे डेटा जगत में सॉफ्टवेयर इंजीनियरिंग के लंबे समय से प्रतीक्षित लाभ लाते हैं।
हमने एक dbt प्रोजेक्ट इनिशियलाइज़ कर लिया है और अब हमें किसी मौजूदा डेटाबेस से कनेक्ट करना है (या नया बनाना है)। ऐसा करने के लिए, हमें dbt को डेटाबेस क्रेडेंशियल्स सुरक्षित रूप से देने का तरीका चाहिए ताकि कनेक्शन स्थापित हो सके। यहीं पर हम प्रोजेक्ट प्रोफाइल का उपयोग करेंगे।
एक प्रोजेक्ट प्रोफाइल एक YAML फ़ाइल होती है जिसमें आपके चुने हुए डेटा प्लेटफ़ॉर्म के कनेक्शन विवरण होते हैं। यह फ़ाइल $HOME की .dbt डायरेक्टरी में बनती है और इसका नाम profiles.yml होता है। अभी यह कुछ इस तरह दिखती है:
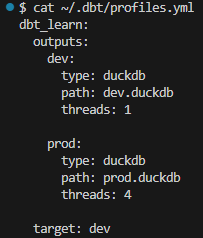
फ़ाइल हमारे प्रोजेक्ट के लिए dbt_learn नाम का एक सिंगल प्रोफाइल सूचीबद्ध करती है। यह दो आउटपुट बताती है: dev और prod।
आउटपुट्स अलग-अलग कॉन्फ़िगरेशन होते हैं जो डेटा वेयरहाउस या डेटाबेस के अलग-अलग कनेक्शनों को निर्दिष्ट करते हैं। आउटपुट्स के माध्यम से, आप विभिन्न एनवायरनमेंट्स के कनेक्शन मैनेज कर सकते हैं:
हमारे प्रोफाइल में, डिफ़ॉल्ट आउटपुट dev है, जिसे target फ़ील्ड में सूचीबद्ध किया गया है। आप अपनी जरूरत के अनुसार इसे किसी अन्य आउटपुट में बदल सकते हैं। अभी के लिए, इसे ऐसे ही रहने दें।
नोट: आप प्रोफाइल और आउटपुट के नाम बदल सकते हैं, बशर्ते वे बाकी dbt फ़ाइलों में सही तरीके से संदर्भित हों।
path फ़ील्ड dev.duckdb नामक मौजूदा डेटाबेस के लोकेशन को निर्दिष्ट करता है। यदि यह मौजूद नहीं है, तो dbt DuckDB एडेप्टर इसे हमारी कार्यशील डायरेक्टरी में (dbt_learn प्रोजेक्ट के अंदर; path फ़ील्ड प्रोजेक्ट डायरेक्टरी के सापेक्ष पथ निर्दिष्ट करता है) बना देगा। चूँकि हमारे पास dev.duckdb नाम का डेटाबेस नहीं है, हम dbt को dbt debug चलाकर इसे बनाने देंगे।
$ dbt debug
debug सब-कमांड का उपयोग प्रोजेक्ट के कई पहलुओं की जाँच करने के लिए किया जाता है, जैसे:
profiles.yml फ़ाइल में त्रुटियाँprofiles.yml में डेटाबेस कनेक्शन विवरणdbt_project.yml फ़ाइल में त्रुटियाँ आदियदि आपको हरे रंग में “All tests passed” संदेश मिला और एक नया dev.duckdb डेटाबेस दिखाई दिया, तो आप तैयार हैं।
मॉडल्स dbt के केंद्र में होते हैं क्योंकि वे वही वास्तविक ट्रांसफॉर्मेशन दर्शाते हैं जिनके लिए dbt प्रसिद्ध है।
डेटा मॉडल एक वैचारिक विचार होता है जो किसी डेटा सेट के भीतर संरचना और संबंधों का प्रतिनिधित्व करता है। dbt में डेटा मॉडल सरल और अधिक विशिष्ट होते हैं। उनके ये गुण होते हैं:
.sql फ़ाइलों में SQL के साथ लिखे जाते हैं (dbt के नए संस्करणों में Python भी अनुमति है)हमारे dbt_learn प्रोजेक्ट में models/example के अंदर दो डमी मॉडल पहले से मौजूद हैं:
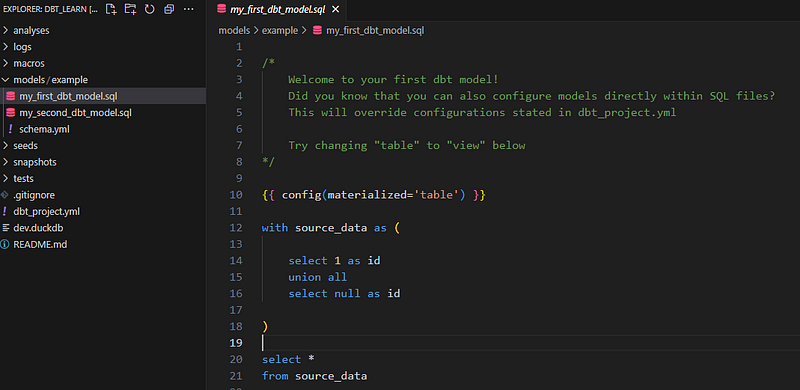
हम उन्हें हटा देंगे और अपने बनाएँगे:
$ rm -rf models/example
$ mkdir models/stats
$ touch models/stats/average_diamond_price_per_group.sql
ऊपर दिए गए स्निपेट की आखिरी पंक्ति में, हम stats डायरेक्टरी के अंदर average_diamond_price_per_group नाम का मॉडल बना रहे हैं। मॉडल के नामों में वर्णनात्मक होना महत्वपूर्ण है।
मॉडल (.sql फ़ाइल) के अंदर यह डमी टेस्ट SQL क्वेरी पेस्ट करें:
SELECT 1 AS Id
और dbt run के साथ मॉडल चलाएँ:
$ dbt run
आपको हरे रंग में “Completed successfully” संदेश मिलना चाहिए।
सब सेटअप हो जाने के बाद, हम अपने dev.duckdb डेटाबेस में कुछ डेटा लोड कर सकते हैं। हम इसके लिए एक parquet फ़ाइल का उपयोग करेंगे, क्योंकि DuckDB उन्हें नैटिव रूप से सपोर्ट करता है।
SELECT AVG(price), cut
 FROM "diamonds.parquet"
GROUP BY cut
क्वेरी को वही सफलता संदेश लौटाना चाहिए।
इस ट्यूटोरियल के लिए, मैंने डायमंड्स डेटासेट को एक parquet फ़ाइल के रूप में तैयार किया है। इस GitHub gist में, आप इसे अपने वर्कस्पेस में डाउनलोड करने का स्निपेट पा सकते हैं।
हमने अभी देखा कि कैसे एक SELECT स्टेटमेंट का उपयोग करके अपना पहला dbt मॉडल बनाया जाए जो किसी डेटासेट के बारे में कुछ सार-सांख्यिकी देता है। व्यवहार में, आपके मॉडल आपके बिजनेस आवश्यकताओं और अलग-अलग कर्मचारियों के आपके डेटाबेस के साथ काम करने के तरीके पर निर्भर करेंगे। इसलिए, हम dbt मॉडल्स की वास्तविक लॉजिक पर नहीं, बल्कि उन्हें सही तरीके से लागू करने पर ध्यान देंगे।
वास्तविक-जीवन के प्रोजेक्ट में, आपके मॉडल अधिकांशतः एक-दूसरे पर निर्भर होंगे और किसी प्रकार की पदानुक्रम बनाएँगे। डेटा जगत में, इस पदानुक्रम को Direct Acyclic Graph (DAG) या lineage ग्राफ कहा जाता है।
एक अकेला DAG 1000-शब्दों के डॉक्यूमेंटेशन का काम कर सकता है। dbt DAGs पेज से इस उदाहरण को देखें:
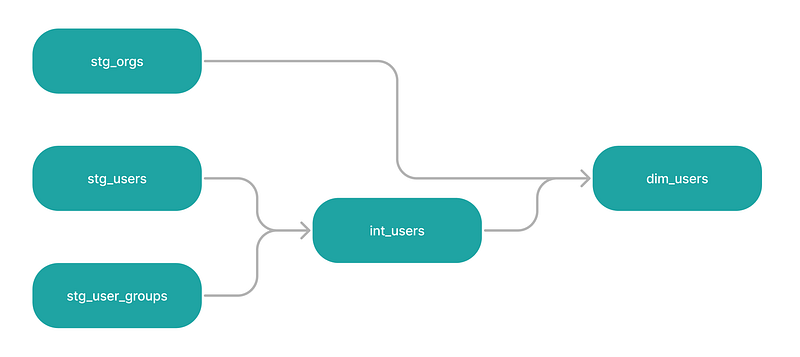
इस ग्राफ में चार मॉडल हैं, जो सभी डाउनस्ट्रीम मॉडलों से रैखिक रूप से जुड़े हैं। stg_users और stg_user_groups int_users के पैरेंट मॉडल हैं, जो बदले में stg_orgs मॉडल (अपस्ट्रीम) के साथ मिलकर dim_users का पैरेंट मॉडल है।
नोट: शब्द upstream और downstream का उपयोग अक्सर DAG में प्रत्येक मॉडल की सापेक्ष स्थिति का उल्लेख करने के लिए किया जाता है।
DAGs का एक प्रमुख पहलू यह है कि इनमें बंद लूप नहीं होते। इसका मतलब है कि डाउनस्ट्रीम मॉडल, जो पहले के मॉडलों का परिणाम है, उसे अपस्ट्रीम मॉडल के साथ जोड़ा नहीं जा सकता। यहीं से acyclic शब्द आता है।
DAGs की दृश्य समृद्धि के अलावा, उनका उद्देश्य dbt को निर्भरताओं के अनुसार मॉडल बनाने/अपडेट करने देना है। यदि हम ऊपर दिए चार मॉडलों के लिए DAG परिभाषित नहीं करते, तो dbt उन्हें वर्णानुक्रम में बनाएगा। इससे हर तरह के लाल संदेश और त्रुटियाँ मिलेंगी।
dbt में DAG परिभाषित करने के लिए, हम Jinja टेम्पलेटिंग का उपयोग करेंगे।
ऊपर वाले DAG में, int_users मॉडल stg_users और stg_user_groups का उत्पाद है। हमें अपने प्रोजेक्ट में इस संबंध को निर्दिष्ट करने की आवश्यकता है, अन्यथा dbt run सभी मॉडल्स को वर्णानुक्रम में चलाएगा, जिसका मतलब है कि int_users पहले चलेगा। यह त्रुटि देगा क्योंकि इसकी निर्भरताएँ अभी materialize नहीं हुई हैं।
अभी, int_users मॉडल कुछ इस तरह दिख सकता है:
SELECT some_column
 FROM stg_users as su
 JOIN stg_user_groups as sug
   ON su.a = sug.a
अब, हम Jinja का उपयोग करके इन तीन मॉडलों को एक DAG के नोड्स में बदलकर आपस में लिंक करेंगे:
SELECT some_column
 FROM {{ ref("stg_users") }} as su
 JOIN {{ ref("stg_user_groups" )}} as sug
   ON su.a = sug.a
मॉडल के नाम सीधे लिखने के बजाय, हम उन्हें ref नाम के Jinja फ़ंक्शन के अंदर रख रहे हैं। इसका सिंटैक्स है {{ ref("column_name") }} (स्पेस और कोट्स का ध्यान रखें)। जब हमारी क्वेरी कम्पाइल होती है, तो Jinja फ़ंक्शन वास्तविक मॉडल नाम से प्रतिस्थापित हो जाता है।
ध्यान दें कि stg_users और stg_user_groups आपके dbt प्रोजेक्ट में .sql फ़ाइलों के रूप में मौजूद होने चाहिए।
अब, जब हम dbt run चलाते हैं, तो यह प्रत्येक मॉडल की निर्भरताएँ खोजेगा, उन्हें जोड़ेगा और उसी के अनुसार निष्पादित करेगा।
Jinja में ref फ़ंक्शन dbt में उपयोग करने के लिए एकमात्र फ़ंक्शन नहीं है। वास्तव में, Jinja के अन्य फ़ंक्शन्स और फ़ीचर्स का उपयोग करके, आप अपनी SQL स्टेटमेंट्स की कार्यक्षमता को काफी बढ़ा सकते हैं। यहाँ कुछ उदाहरण हैं:
{% set status = 'active' %}  -- Define a variable

SELECT *
FROM customers
WHERE status = {{ status }};
यदि हमारे पास models/model_properties.yml फ़ाइल है और उसमें निम्न फ़ील्ड्स हैं:
# models/model_properties.yml
version: 2

models:
 - name: my_model
   config:
     target_schema: analytics
तो हम Jinja का उपयोग करके किसी भी .sql फ़ाइल के अंदर इसके फ़ील्ड्स को एक्सेस कर सकते हैं:
{% set target_schema = config.target_schema %}

CREATE TABLE {{ target_schema }}.{{ target_table }} AS
...
कंडीशनल्स:
{% if some_condition %}
 SELECT * FROM test_data
{% else %}
 SELECT * FROM production_data
{% endif %}
लूप्स:
SELECT
 order_id,
 {% for payment_method in ["bank_transfer", "credit_card", "gift_card"] %}
   SUM(CASE WHEN payment_method = '{{ payment_method }}' THEN amount END) AS {{ payment_method }}_amount,
 {% endfor %}
 SUM(amount) AS total_amount
FROM {{ ref('raw_payments') }}
GROUP BY 1;
यह रहा मैक्रो:
{% macro create_table(table_name, columns) %}
 CREATE TABLE {{ table_name }} (
   {% for column in columns %}
     {{ column.name }} {{ column.type }},
   {% endfor %}
 );
{% endmacro %}
और इसे मॉडलों में इस तरह उपयोग कर सकते हैं:
{% call create_table('my_customer_table', [
   {'name': 'id', 'type': 'integer'},
   {'name': 'name', 'type': 'varchar(255)'},
   {'name': 'email', 'type': 'varchar(255)'},
]) %}

INSERT INTO {{ my_customer_table }} (id, name, email)
SELECT customer_id, customer_name, customer_email
FROM raw_customers;
यदि आप dbt में SQL के साथ Jinja का उपयोग करने के बारे में और सीखना चाहते हैं, तो dbt डॉक्यूमेंटेशन के इस पेज को देखें।
एक अच्छा सॉफ्टवेयर डेवलपर जानता है कि उन्हें अपने कोड को लगातार बग्स और त्रुटियों के लिए टेस्ट करना चाहिए। चूँकि dbt डेटा इंजीनियरों को सॉफ्टवेयर डेवलपर्स जैसा बना देता है, यह उन्हें बिल्ट-इन और कस्टम—दोनों तरह के टेस्ट्स के लिए सीधा-सरल वर्कफ़्लो प्रदान करता है।
वर्तमान में, dbt निम्न चार बिल्ट-इन टेस्ट्स प्रदान करता है:
unique - सत्यापित करता है कि सभी मान यूनिक हैंnot_null - मिसिंग वैल्यू की जाँचaccepted_values - सत्यापित करता है कि सभी मान निर्दिष्ट सूची में हैं, इसमें values आर्ग्युमेंट होता हैrelationships - किसी विशिष्ट टेबल या कॉलम से कनेक्शन को सत्यापित करता है, इसमें to और field आर्ग्युमेंट होते हैंकिस कॉलम पर कौन-सा टेस्ट उपयोग करना है, इसे निर्दिष्ट करने के लिए हम models डायरेक्टरी के अंदर model_properties.yml नाम की YAML फ़ाइल का उपयोग करते हैं।
नोट: model_properties.yml मॉडलों के चलने के लिए आवश्यक नहीं है और इसका नाम कुछ भी हो सकता है। लेकिन, यदि आप अपने मॉडलों में आने वाले डेटा को टेस्ट्स के माध्यम से वैलिडेट करना चाहते हैं, तो यह फ़ाइल आवश्यक है।
आइए देखें कि diamonds टेबल के cut कॉलम में मिसिंग वैल्यू की जाँच के लिए not_null टेस्ट का उपयोग कैसे किया जाए। पहले, models के अंदर model_properties.yml फ़ाइल बनाएँ:
$ touch models/model_properties.yml
अंदर निम्न सामग्री पेस्ट करें:
version: 2

models:
 - name: average_diamond_price_per_group
   columns:
     - name: cut
       tests:
         - not_null
models के अंतर्गत - name फ़ील्ड में, हम यह निर्दिष्ट कर रहे हैं कि हम किस मॉडल के लिए प्रॉपर्टीज़ परिभाषित कर रहे हैं। फिर, हम कॉलम और उसका नाम निर्दिष्ट करते हैं। अंत में, हम tests फ़ील्ड लिखते हैं, जिसके अंतर्गत हम not_null टेस्ट सूचीबद्ध करते हैं।
अब, आप dbt run चलाने से पहले डेटा वैलिडेशन करने के लिए इस टेस्ट का उपयोग कर सकते हैं। कमांड है dbt test:
$ dbt test
यदि आपको कोई त्रुटि संदेश मिलता है, तो इसका अर्थ है कि टेस्ट विफल हुआ और आपको टेबल में समस्या की जाँच करनी होगी तथा आवश्यक हो तो उसे ठीक करना होगा।
अपने प्रोजेक्ट्स में dbt का सफलतापूर्वक उपयोग करने के लिए, आप यह अनुशंसित वर्कफ़्लो अपना सकते हैं:
1. प्रोजेक्ट इनिशियलाइज़ेशन
dbt इंस्टॉल करें और dbt init से नया प्रोजेक्ट बनाएँ2. कॉन्फ़िगरेशन
profiles.yml में डेटाबेस क्रेडेंशियल्स कॉन्फ़िगर करें।dbt_project.yml में परिवर्तन करें।3. डेवलपमेंट
models डायरेक्टरी में .sql फ़ाइलें बनाएँ।tests डायरेक्टरी में .yml फ़ाइलें बनाएँ।dbt test का उपयोग करें।dbt debug का उपयोग करें।4. लोकल वैलिडेशन (विषय जिन्हें हमने कवर नहीं किया)
अतिरिक्त सर्वोत्तम प्रथाएँ:
dbt docs generate का उपयोग कर सकते हैं (हाँ, यह संभव है)।हमने इस ट्यूटोरियल में कई बुनियादी बातें कवर की हैं, लेकिन जैसा कि मैंने शुरुआत में ही बताया था, dbt एक विशाल टूल है जिसमें बहुत-सी सुविधाएँ हैं। इसे उस स्तर तक मास्टर करने में समय लगेगा जहाँ आप इसे प्रोडक्शन एनवायरनमेंट्स में सहजता से उपयोग कर सकें। क्यों न इन संसाधनों का उपयोग करके उस लक्ष्य को तेजी से हासिल करें?
आज ही अपना dbt सफर शुरू करें!
कोर्स
कोर्स
कोर्स
