
Kurs
Einführung in dbt
4 Std.
33.4K
Eines der Grundkonzepte, das du kennen solltest, ist das Data Warehouse. Ein Warehouse ist der zentrale Speicherort für sämtliche Daten eines Unternehmens.
Unternehmen bauen Warehouses, weil sie Analytics und alles Weitere ermöglichen, was du mit Daten machen kannst (zumindest mit strukturierten Daten). Sie speichern historische Daten in Tabellen und sind auf schnelle Abfragen und Analysen ausgelegt.
Es gibt viele Tools, die Data Warehouses umsetzen:
und viele mehr.
dbt hilft dir nicht dabei, Daten in diese Tools zu sammeln oder zu laden, sondern transformiert Daten innerhalb dieser Systeme. Anders gesagt: dbt übernimmt das T im ETL/ELT-Prozess (Extract, Transform, Load), der das Herzstück jedes Warehouses ist.
dbt wird über zwei Oberflächen angeboten: dbt Core und dbt Cloud.
dbt Core ist eine Open-Source-Bibliothek, die den Großteil der dbt-Funktionalität bereitstellt. Sie kommt mit einer Kommandozeilenoberfläche (dem dbt-Befehl, den du lieben wirst), mit der du Datentransformationen in deinen Projekten steuerst.
dbt Cloud ist die Enterprise-Lösung für Teams. Zusätzlich zur CLI bietet dbt Cloud eine benutzerfreundliche, webbasierte IDE. Damit musst du dich deutlich weniger um Datenbankverbindungen und das Editieren von YAML-Dateien kümmern (wie du gleich sehen wirst).
dbt Cloud liefert außerdem Features wie Job-Scheduling, erweiterte Integrationen und priorisierten Support.
Hier ist eine Tabelle, die die Unterschiede zwischen dbt Core und dbt Cloud zusammenfasst:
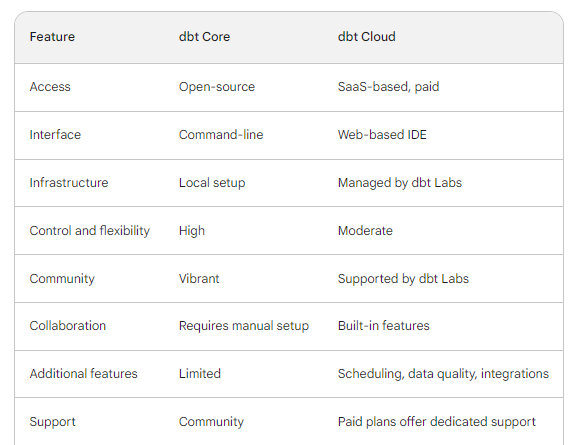
Trotz der zusätzlichen Funktionen behandeln wir dbt Core, da es sich ideal für lokale Projekte, Tests und zum Lernen eignet. Du kannst es auf jedem Betriebssystem mit pip installieren (natürlich in einer virtuellen Umgebung).
Ich verwende eine Conda-Umgebung:
$ conda create -n learn_dbt -y
$ pip install dbt-<adapter_name>
Ersetze adapter_name durch die Datenbank, die du nutzen möchtest. dbt Labs (das Unternehmen hinter dbt) hat viele Adapter für unterschiedliche Datenplattformen integriert.
In diesem Artikel verwenden wir den dbt-duckdb-Adapter, um eine Verbindung zu einer DuckDB-Datenbank herzustellen. Du kannst aber jeden der Adapter auf dieser Seite der dbt-Dokumentation verwenden.
$ pip install dbt-duckdb
Damit ist das initiale Setup erledigt!
Ein dbt-Projekt ist im Grunde ein Verzeichnis auf deinem Rechner, das alles enthält, was du für Transformationen deiner Daten brauchst. Es enthält viele .sql-Dateien (die sogenannten Models) und YAML-Dateien (für Konfigurationen).
Ein neues dbt-Projekt erstellst du mit dem CLI-Befehl dbt init <project_name>:
$ dbt init dbt_learnIm Terminal wirst du aufgefordert, einen Code für deine verfügbaren Datenplattform-Adapter einzugeben. Da du nur DuckDB hast, kannst du 1 drücken.
$ cd dbt_learn
Innerhalb von dbt_learn findest du folgende Struktur:
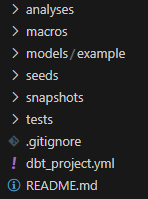
Hier werden Data Engineers zu Software Engineers, denn dbt-Projekte ermöglichen dir:
Kurz gesagt: dbt-Projekte sind ein leistungsstarkes Mittel, um Transformationen zu managen und zu orchestrieren. Sie bringen die lange erwarteten Vorteile der Softwareentwicklung in die Datenwelt.
Wir haben ein dbt-Projekt initialisiert und müssen es nun mit einer bestehenden Datenbank verbinden (oder eine neue erstellen). Dafür brauchen wir eine sichere Möglichkeit, dbt die Datenbankzugangsdaten zu übergeben. Hier kommt das Projektprofil ins Spiel.
Ein Projektprofil ist eine YAML-Datei mit den Verbindungsdetails zu deiner Datenplattform. Sie wird im Verzeichnis .dbt in $HOME erstellt und heißt profiles.yml. Aktuell sieht sie so aus:
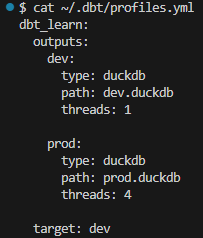
Die Datei führt ein einziges Profil namens dbt_learn für unser Projekt auf. Es definiert zwei Outputs: dev und prod.
Outputs sind einzelne Konfigurationen für verschiedene Verbindungen zu Warehouses oder Datenbanken. Darüber steuerst du Verbindungen zu unterschiedlichen Umgebungen:
In unserem Profil ist der Standard-Output dev, was im Feld target steht. Du kannst das je nach Bedarf ändern. Fürs Erste lassen wir es so.
Hinweis: Du kannst Profil- und Output-Namen frei wählen, solange sie in den übrigen dbt-Dateien korrekt referenziert werden.
Das Feld path gibt den Speicherort einer bestehenden Datenbank namens dev.duckdb an. Falls sie nicht existiert, wird sie vom DuckDB-Adapter von dbt in unserem Arbeitsverzeichnis (im Projekt dbt_learn; path ist relativ zum Projektverzeichnis) erstellt. Da wir keine dev.duckdb haben, lassen wir dbt sie per dbt debug erstellen.
$ dbt debug
Der Subbefehl debug prüft viele Aspekte des Projekts, etwa:
profiles.ymlprofiles.ymldbt_project.yml und mehrWenn du die grüne Meldung „All tests passed“ siehst und eine neue dev.duckdb-Datenbank erschienen ist, bist du bereit für den nächsten Schritt.
Modelle sind das Herzstück von dbt – sie repräsentieren die eigentlichen Transformationen, für die dbt bekannt ist.
Ein Datenmodell ist eine konzeptionelle Darstellung der Struktur und Beziehungen innerhalb eines Datensatzes. dbt-Modelle sind einfacher und konkreter. Sie haben folgende Eigenschaften:
.sql-Dateien geschrieben (in neueren dbt-Versionen ist auch Python möglich)Unser Projekt dbt_learn enthält bereits zwei Beispielmodelle im Ordner models/example:
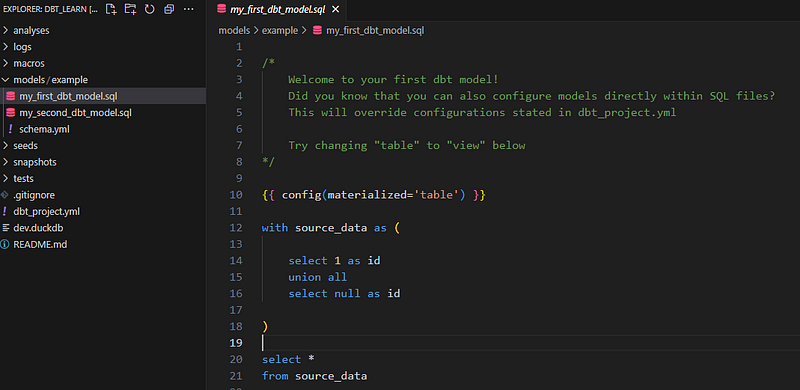
Wir löschen diese und erstellen eigene:
$ rm -rf models/example
$ mkdir models/stats
$ touch models/stats/average_diamond_price_per_group.sql
In der letzten Zeile legen wir ein Modell namens average_diamond_price_per_group im Verzeichnis stats an. Aussagekräftige Modellnamen sind wichtig.
Füge in die Modelldatei (.sql) diese einfache Testabfrage ein:
SELECT 1 AS Id
und führe das Modell mit dbt run aus:
$ dbt run
Du solltest die grüne Meldung „Completed successfully“ erhalten.
Nachdem alles eingerichtet ist, können wir Daten in unsere dev.duckdb-Datenbank laden. Wir verwenden dafür eine Parquet-Datei, da DuckDB diese nativ unterstützt.
SELECT AVG(price), cut
 FROM "diamonds.parquet"
GROUP BY cut
Auch diese Abfrage sollte erfolgreich durchlaufen.
Für dieses Tutorial habe ich den Diamonds-Datensatz als Parquet-Datei vorbereitet. Im GitHub Gist findest du ein Snippet, um sie in deinen Workspace zu laden.
Wir haben soeben unser erstes dbt-Modell erstellt – per SELECT-Statement, das einige Kennzahlen zu einem Datensatz liefert. In der Praxis hängen deine Modelle von Business-Anforderungen und der Arbeitsweise verschiedener Teams mit deiner Datenbank ab. Deshalb konzentrieren wir uns hier nicht auf die konkrete Modelllogik, sondern darauf, wie du sie korrekt umsetzt.
In realen Projekten hängen deine Modelle meist voneinander ab und bilden eine Art Hierarchie. In der Datenwelt heißt diese Hierarchie Directed Acyclic Graph (DAG) oder Lineage-Graph.
Ein einzelner DAG kann eine 1.000-Wörter-Doku ersetzen. Sieh dir dieses Beispiel von der dbt-DAGs-Seite an:
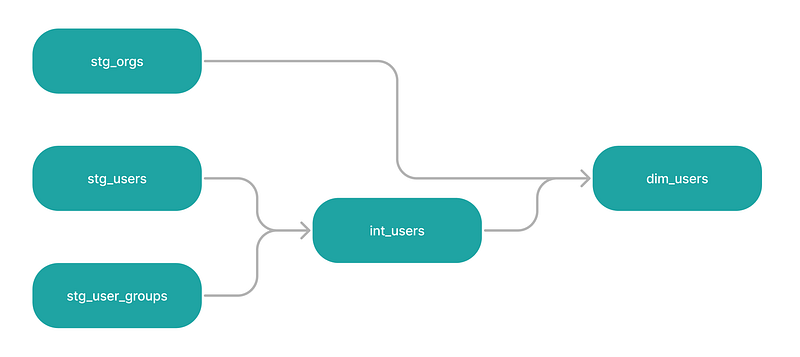
Es gibt vier Modelle in diesem Graphen, alle linear mit nachgelagerten Modellen verbunden. stg_users und stg_user_groups sind Parent-Modelle von int_users, das wiederum gemeinsam mit stg_orgs das Parent-Modell von dim_users ist.
Hinweis: Die Begriffe upstream und downstream bezeichnen häufig die relative Position eines Modells im DAG.
Ein zentrales Merkmal von DAGs: Es gibt keine geschlossenen Schleifen. Ein nachgelagertes Modell, das auf Ergebnissen früherer Modelle basiert, kann nicht wieder mit einem vorgelagerten Modell zusammengeführt werden. Daher „acyclic“.
Neben der hilfreichen Visualisierung sorgen DAGs vor allem dafür, dass dbt Modelle gemäß ihrer Abhängigkeiten baut/aktualisiert. Ohne definierten DAG würde dbt die vier Modelle alphabetisch bauen – das führt schnell zu roten Fehlermeldungen.
Um einen DAG in dbt zu definieren, verwenden wir Jinja-Templating.
Im obigen DAG ist das Modell int_users das Ergebnis aus stg_users und stg_user_groups. Diese Beziehung müssen wir im Projekt festhalten. Andernfalls führt dbt run alle Modelle alphabetisch aus – int_users käme zuerst und würde scheitern, weil seine Abhängigkeiten noch nicht materialisiert sind.
Aktuell könnte int_users so aussehen:
SELECT some_column
 FROM stg_users as su
 JOIN stg_user_groups as sug
   ON su.a = sug.a
Jetzt verknüpfen wir die drei Modelle, indem wir sie per Jinja zu Knoten eines DAG machen:
SELECT some_column
 FROM {{ ref("stg_users") }} as su
 JOIN {{ ref("stg_user_groups" )}} as sug
   ON su.a = sug.a
Anstatt die Modellnamen direkt zu schreiben, setzen wir sie in die Jinja-Funktion ref. Die Syntax lautet {{ ref("column_name") }} (achte auf Leerzeichen und Anführungszeichen). Beim Kompilieren wird die Jinja-Funktion durch den tatsächlichen Modellnamen ersetzt.
Beachte: stg_users und stg_user_groups müssen als .sql-Dateien in deinem dbt-Projekt existieren.
Führen wir nun dbt run aus, ermittelt dbt für jedes Modell die Abhängigkeiten, verknüpft sie und führt sie in der richtigen Reihenfolge aus.
Die Funktion ref ist nicht die einzige Jinja-Funktion, die wir in dbt nutzen können. Mit weiteren Jinja-Features kannst du die Möglichkeiten deiner SQL-Statements deutlich erweitern. Einige Beispiele:
{% set status = 'active' %}  -- Define a variable

SELECT *
FROM customers
WHERE status = {{ status }};
Wenn wir eine Datei models/model_properties.yml mit folgenden Feldern haben:
# models/model_properties.yml
version: 2

models:
 - name: my_model
   config:
     target_schema: analytics
Dann können wir auf diese Felder in jeder .sql-Datei per Jinja zugreifen:
{% set target_schema = config.target_schema %}

CREATE TABLE {{ target_schema }}.{{ target_table }} AS
...
If-Abfrage:
{% if some_condition %}
 SELECT * FROM test_data
{% else %}
 SELECT * FROM production_data
{% endif %}
Schleife:
SELECT
 order_id,
 {% for payment_method in ["bank_transfer", "credit_card", "gift_card"] %}
   SUM(CASE WHEN payment_method = '{{ payment_method }}' THEN amount END) AS {{ payment_method }}_amount,
 {% endfor %}
 SUM(amount) AS total_amount
FROM {{ ref('raw_payments') }}
GROUP BY 1;
Hier das Macro:
{% macro create_table(table_name, columns) %}
 CREATE TABLE {{ table_name }} (
   {% for column in columns %}
     {{ column.name }} {{ column.type }},
   {% endfor %}
 );
{% endmacro %}
Und so nutzt du es in Modellen:
{% call create_table('my_customer_table', [
   {'name': 'id', 'type': 'integer'},
   {'name': 'name', 'type': 'varchar(255)'},
   {'name': 'email', 'type': 'varchar(255)'},
]) %}

INSERT INTO {{ my_customer_table }} (id, name, email)
SELECT customer_id, customer_name, customer_email
FROM raw_customers;
Wenn du mehr darüber lernen willst, wie du Jinja in dbt mit SQL einsetzt, sieh dir diese Seite der dbt-Dokumentation an.
Gute Softwareentwickler testen ihren Code kontinuierlich auf Bugs und Fehler. Da dbt Data Engineers zu Softwareentwicklern macht, bietet es einen klaren Workflow für Tests – sowohl eingebaute als auch eigene.
Aktuell bietet dbt diese vier integrierten Tests:
unique – prüft, ob alle Werte eindeutig sindnot_null – prüft auf fehlende Werteaccepted_values – prüft, ob Werte in einer vorgegebenen Liste liegen; hat ein Argument valuesrelationships – prüft die Beziehung zu einer bestimmten Tabelle oder Spalte; nutzt to und field als ArgumenteUm festzulegen, welche Tests auf welche Spalten angewendet werden, nutzen wir eine YAML-Datei namens model_properties.yml im Ordner models.
Hinweis: model_properties.yml ist keine Voraussetzung, damit Modelle laufen, und kann beliebig benannt werden. Wenn du jedoch Daten validieren willst, die in deine Modelle einfließen, ist diese Datei unverzichtbar.
Sehen wir uns an, wie wir mit dem Test not_null fehlende Werte in der Spalte cut der Tabelle diamonds prüfen. Erstelle zuerst die Datei model_properties.yml in models:
$ touch models/model_properties.yml
Füge anschließend folgenden Inhalt ein:
version: 2

models:
 - name: average_diamond_price_per_group
   columns:
     - name: cut
       tests:
         - not_null
Im Feld - name unter models geben wir an, für welches Modell wir Eigenschaften definieren. Dann benennen wir die Spalte. Unter tests listen wir schließlich den Test not_null auf.
Nun kannst du diese Validierung vor dbt run ausführen. Der Befehl lautet dbt test:
$ dbt test
Wenn du eine Fehlermeldung erhältst, ist der Test fehlgeschlagen. Untersuche dann die Tabelle und behebe das Problem bei Bedarf.
Um dbt erfolgreich einzusetzen, kannst du dich an diesem Workflow orientieren:
1. Projektinitialisierung
dbt und erstelle ein neues Projekt mit dbt init2. Konfiguration
profiles.yml in deinem Home-Verzeichnis.dbt_project.yml für Projekteinstellungen (z. B. Version, Abhängigkeiten).3. Entwicklung
.sql-Dateien im Ordner models an..yml-Dateien im Ordner tests für Testdefinitionen an.dbt test aus.dbt debug für die Fehlersuche.4. Lokale Validierung (Themen, die wir nicht vertieft haben)
dbt build, um Modelle und Tests zu kompilieren.dbt test aus.Weitere Best Practices:
dbt docs generate kannst du später Modelldokumentation auf einem Webserver rendern.Wir haben in diesem Tutorial viele Grundlagen behandelt. Wie eingangs erwähnt, ist dbt jedoch ein sehr mächtiges Tool mit vielen Funktionen. Es dauert eine Weile, es so zu beherrschen, dass du es souverän in Produktionsumgebungen einsetzt. Warum nicht diese Ressourcen nutzen, um schneller dorthin zu kommen?
Unsere Zertifizierungsprogramme helfen dir, dich von anderen abzuheben und potenziellen Arbeitgebern zu beweisen, dass deine Fähigkeiten für den Job geeignet sind.

Starte noch heute mit dbt!
Kurs
Kurs
Kurs