
Kursus
Bekerja dengan OpenAI API
3 jam
179.8K
Untuk mengakses model DeepSeek melalui API:
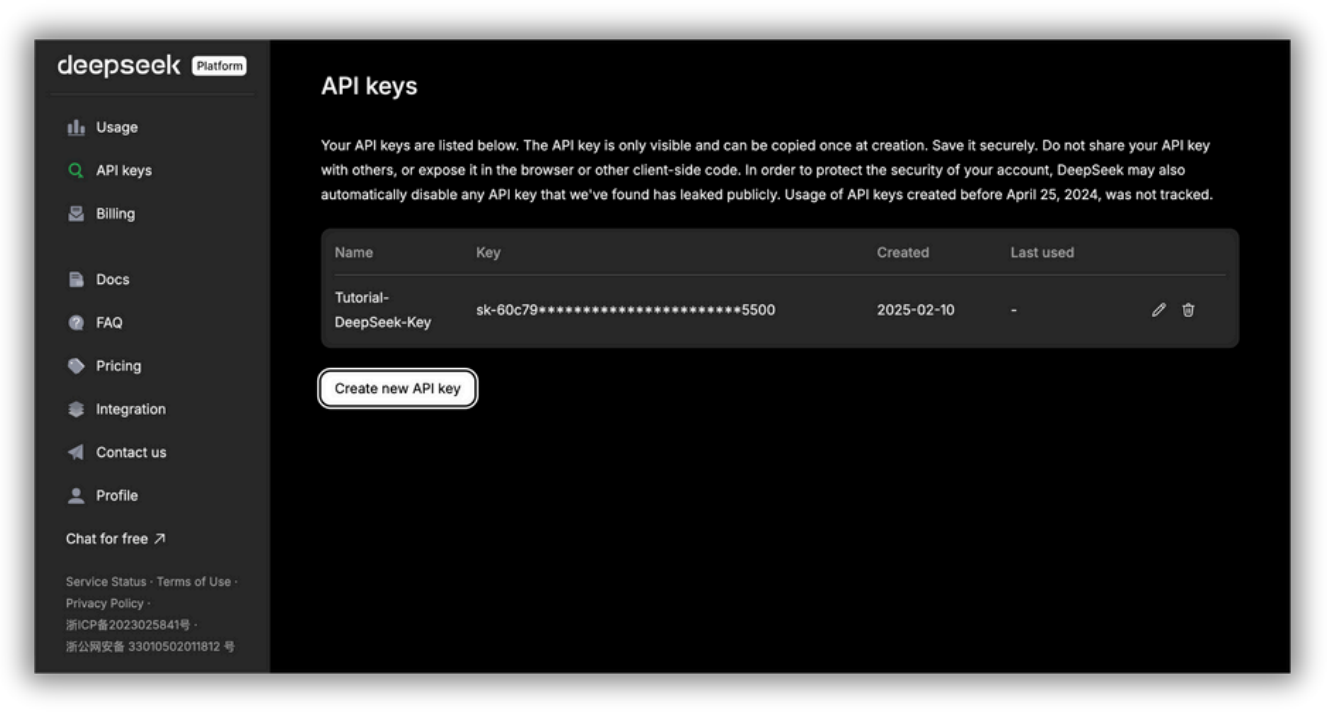
Halaman pengelolaan kunci API di platform DeepSeek API. Di sini Anda dapat membuat dan mengelola kunci API untuk mengakses layanan AI DeepSeek. Kunci API hanya terlihat saat pembuatan dan harus disimpan dengan aman; membagikannya secara publik dapat menimbulkan risiko keamanan.
Untuk menggunakan DeepSeek-V3 Anda perlu mengatur model='deepseek-chat' dan untuk menggunakan DeepSeek-R1 Anda perlu mengatur model='deepseek-reasoner'.
Berikut cara menggunakan OpenAI SDK untuk mengakses DeepSeek API:
from openai import OpenAI
client = OpenAI(api_key="<DeepSeek API Key>", base_url="https://api.deepseek.com")
response = client.chat.completions.create(
    model="deepseek-chat",
    messages=[
        {"role": "system", "content": "You are a helpful assistant"},
        {"role": "user", "content": "Hello"},
    ],
    stream=False
)
print(response.choices[0].message.content)
Mari kita lihat lebih dekat apa yang dilakukan potongan kode ini.
Tujuan kode adalah mengirim pesan chat ke model DeepSeek dan mencetak respons model.
Pertama, from openai import OpenAI mengimpor kelas OpenAI dari pustaka openai.
Lalu, client = OpenAI(...) membuat objek klien OpenAI. Klien ini adalah koneksi Anda ke DeepSeek API. Ia mengonfigurasi klien dengan kunci API Anda (autentikasi) dan menentukan base URL API DeepSeek.
Penting: Ganti <DeepSeek API Key> dengan kunci API DeepSeek Anda yang sebenarnya!
Bagian response adalah bagian yang mengirimkan pesan chat Anda ke model DeepSeek dan mendapatkan responsnya. client.chat.completions.create(...) memanggil DeepSeek API untuk mendapatkan respons dari model.
Mari lihat messages=[...], yaitu bagian yang menentukan riwayat percakapan:
Perhatikan bahwa dalam contoh ini kita menggunakan DeepSeek-V3 karena kita mengatur model='deepseek-chat’ tetapi ingat Anda dapat menggunakan DeepSeek-R1 dengan mengatur model='deepseek-reasoner'.
Bagian stream=False berarti "Berikan seluruh jawaban sekaligus." Pada dasarnya, saat Anda mengatur stream=False, model menunggu hingga seluruh respons dihasilkan sebelum mengirimkannya kembali. Gunakan ini jika Anda ingin menampilkan atau menganalisis respons lengkap sekaligus.
Namun, Anda mungkin harus menunggu sebentar untuk respons yang panjang sebelum menerima keluarannya. Jika Anda mengatur stream=True, model menampilkan kata (tepatnya token) saat dihasilkan, sehingga Anda melihat respons secara waktu nyata alih-alih menunggu jawaban lengkap.
Terakhir, print(response.choices.message.content) mengekstrak respons model dari objek respons dan mencetaknya ke konsol Anda. Objek respons berisi banyak informasi, tetapi yang terutama Anda butuhkan adalah pesan model. API terkadang mengembalikan beberapa kemungkinan jawaban (choices). Ini memilih yang pertama.
Pada saat artikel ini diterbitkan, DeepSeek menghentikan sementara penambahan dana baru ke akun API karena server mereka kekurangan sumber daya. Artinya, Anda tidak dapat menambah saldo API saat ini. Jika Anda sudah memiliki dana, Anda masih dapat menggunakan API seperti biasa. DeepSeek kemungkinan akan melanjutkan pengisian ulang ketika kapasitas server meningkat, jadi pantau pembaruan!
Tim DeepSeek mengklaim model mereka lebih murah dibanding kompetitor. Namun Anda tetap perlu menggunakannya dengan bijak agar biaya rendah dan kinerja optimal. Berikut hal-hal kunci yang perlu diketahui dan dipertimbangkan saat menggunakan model DeepSeek untuk mengendalikan keluaran dan harga.
Setiap model DeepSeek dirancang untuk tugas yang berbeda. Memilih yang tepat membantu Anda menyeimbangkan biaya dan kinerja sesuai kebutuhan. Berikut perbandingan singkat:
Token adalah unit teks terkecil yang diproses model, bisa berupa kata, angka, atau tanda baca. Jumlah token yang digunakan bergantung pada bahasa dan cara model memproses teks.
Berikut perbandingan umum bagaimana karakter dikonversi menjadi token:
Untuk perkiraan yang akurat, sebaiknya periksa detail penggunaan setelah menjalankan permintaan Anda. Jika Anda memahami cara token dihitung, Anda dapat lebih baik mengelola biaya dan mengoptimalkan kinerja saat menggunakan model DeepSeek.
Berikut harga per 1 juta token untuk masing-masing model DeepSeek (catatan: ini adalah harga pada saat artikel ini diterbitkan—periksa biaya terbaru di sini):
|
Model |
Panjang konteks |
Maks token CoT |
Maks token keluaran |
Harga input 1 jt token (cache hit) |
Harga input 1 jt token (cache miss) |
Harga output 1 jt token |
|
deepseek-chat |
64k |
- |
8k |
$0.07 |
$0.27 |
$1.10 |
|
deepseek-reasoner |
64k |
32k |
8k |
$0.14 |
$0.55 |
$2.19 |
Seperti disebutkan sebelumnya, DeepSeek menawarkan dua model, deepseek-chat dan deepseek-reasoner. Namun masing-masing memiliki kekuatan dan biaya berbeda. Mengetahui bagaimana keduanya memproses informasi dan membebankan biaya token dapat membantu Anda menggunakannya lebih efisien dan menjaga biaya tetap terkendali.
Kedua model dapat menangani hingga 64.000 token dalam satu percakapan, artinya mereka mengingat lebih banyak konteks untuk respons yang lebih baik dan relevan. Namun, cara kerjanya berbeda.
Deepseek-chat dirancang untuk percakapan umum dan tidak menggunakan penalaran tingkat lanjut. Di sisi lain, deepseek-reasoner memungkinkan hingga 32.000 token untuk berpikir langkah demi langkah (penalaran chain-of-thought—akan dibahas sebentar lagi) sebelum memberikan jawaban akhir. Ini membuatnya hebat untuk memecahkan masalah kompleks tetapi juga meningkatkan jumlah token yang digunakan, yang berarti biaya lebih tinggi.
Dalam hal panjang respons, kedua model dapat menghasilkan hingga 8.000 token per balasan. Batas ini membantu mencegah respons menjadi terlalu panjang dan mahal.
Dari sisi harga, deepseek-chat lebih ramah anggaran. Jika input di-cache (artinya pernah digunakan sebelumnya), biayanya $0,07 per satu juta token. Untuk input baru, harganya naik menjadi $0,27 per satu juta token, dan output seharga $1,10 per satu juta token.
Deepseek-reasoner lebih mahal karena menyediakan penalaran yang lebih dalam. Input yang di-cache seharga $0,14 per satu juta token, sedangkan input baru $0,55 per satu juta token. Outputnya juga lebih mahal yaitu $2,19 per satu juta token, mencerminkan kompleksitas respons yang dihasilkan.
Jadi, model mana yang harus Anda gunakan?
Jika Anda membutuhkan respons chat sederhana atau jawaban cepat, deepseek-chat adalah pilihan lebih baik karena lebih murah. Namun jika Anda butuh penalaran mendetail atau pemecahan masalah kompleks, deepseek-reasoner lebih kuat—meskipun biayanya lebih tinggi.
Untuk menghemat biaya, Anda juga dapat menggunakan caching. Saat model mengenali input yang pernah dilihat sebelumnya, tarif yang dikenakan lebih rendah. Ini sangat berguna untuk kueri berulang atau percakapan multi-giliran.
Model DeepSeek memiliki harga yang kompetitif, tetapi penggunaan token dapat cepat bertambah. Cara terbaik mengelola biaya adalah menjaga prompt tetap singkat, gunakan caching bila memungkinkan, dan pilih model yang tepat untuk tugasnya. Untuk mempelajari lebih lanjut, baca blog tentang optimasi prompt ini.
Parameter temperature mengendalikan seberapa acak atau dapat diprediksi respons model. Secara bawaan, di DeepSeek diatur ke 1,0, artinya respons seimbang antara kreatif dan deterministik. Namun, Anda dapat menyesuaikannya sesuai kebutuhan spesifik.
DeepSeek memberikan rekomendasi berikut untuk berbagai use case:
|
Use Case |
Temperature yang Direkomendasikan |
|
Coding / Matematika |
0.0 (Deterministik, presisi) |
|
Pembersihan Data / Analisis Data |
1.0 (Respons seimbang) |
|
Percakapan Umum |
1.3 (Variasi respons lebih banyak) |
|
Penerjemahan |
1.3 (Memungkinkan fleksibilitas diksi) |
|
Penulisan Kreatif / Puisi |
1.5 (Mendorong keluaran yang beragam dan imajinatif) |
Temperature rendah (mendekati 0,0) membuat model lebih dapat diprediksi dan presisi. Ini cocok untuk tugas yang memerlukan jawaban akurat, seperti coding, matematika, dan analisis data terstruktur.
Temperature lebih tinggi (di atas 1,0) membuat model lebih kreatif dan bervariasi, cocok untuk penceritaan, puisi, dan penerjemahan yang membutuhkan fleksibilitas.
Untuk percakapan umum, temperature sekitar 1,3 membantu menghasilkan dialog yang natural dan menarik tanpa terlalu repetitif atau terlalu acak.
Meskipun pengaturan temperature tidak langsung memengaruhi biaya, ia dapat secara tidak langsung meningkatkan jumlah token output:
Saat berinteraksi dengan API DeepSeek, Anda dapat mengendalikan format respons dengan menentukan parameter response_format. Ini sangat berguna saat bekerja dengan data terstruktur, karena membantu memastikan konsistensi dan keterbacaan keluaran model.
Untuk menerima respons dalam format JSON, atur:
response_format={'type': 'json_object'}Ini memberi tahu model untuk mengembalikan keluaran terstruktur, sehingga lebih mudah memproses informasi secara terprogram. Format JSON lazim digunakan dalam aplikasi yang membutuhkan respons terstruktur dan dapat dibaca mesin, seperti ekstraksi data, otomasi, dan integrasi API.
Walaupun format JSON tidak langsung berdampak pada harga, dalam kasus tertentu dapat secara tidak langsung menurunkan biaya.
CoT adalah proses penalaran yang dilalui DeepSeek-R1 sebelum memberikan jawaban akhir. Artinya, model menjelaskan proses berpikirnya langkah demi langkah sebelum mencapai kesimpulan.
Setiap token yang digunakan dalam penalaran CoT dan jawaban akhir dikenakan biaya $2,19 per satu juta token, karena termasuk bagian dari output. Ini merupakan trade-off; semakin banyak token CoT = biaya lebih tinggi tetapi juga akurasi lebih baik pada tugas kompleks.
Apa yang dapat Anda lakukan untuk mengendalikan biaya saat menggunakan CoT?
Untuk mengilustrasikan bagaimana keluaran Chain-of-Thought (CoT) bekerja di DeepSeek-R1 dan dampaknya pada harga, mari pertimbangkan contoh berikut:
from openai import OpenAI

client = OpenAI(
    api_key="<Your_DeepSeek_API_Key>",
    base_url="https://api.deepseek.com"
)

def generate_response(prompt):
    response = client.chat.completions.create(
        model="deepseek-reasoner",
        messages=[
            {"role": "system", "content": "You are a helpful assistant."},
            {"role": "user", "content": prompt}
        ],
        stream=False
    )
    return response.choices[0].message.content

# Example usage
prompt = "Calculate the area of a triangle with a base of 6 cm and a height of 4 cm."
result = generate_response(prompt)
print(result)
CoT:
Okay, so I need to find the area of a triangle with a base of 6 cm and a height of 4 cm. Hmm, let me remember how to do this. I think the formula for the area of a triangle is something like base multiplied by height divided by two. Wait, is that right? Let me think.
When I was in math class, the teacher mentioned that a triangle is basically half of a parallelogram. So if you have a parallelogram, its area is base times height. If you cut it along the diagonal, you get two triangles. That means each triangle would have half the area of the parallelogram. So yes, the formula should be (base × height) / 2. That makes sense. Let me write that down to visualize it better.
Area = (base × height) / 2
Given the base is 6 cm and the height is 4 cm, I can substitute those values into the formula. Let me plug them in step by step.
First, multiply the base and the height: 6 cm × 4 cm. Let me calculate that. 6 times 4 is 24. So that gives me 24 cm². Now, divide that result by 2. So 24 divided by 2 is 12. Therefore, the area should be 12 cm².
Wait, let me verify that. If the base was 6 and the height 4, multiplying them gives the area of the corresponding parallelogram, which would be 24 cm². Then, since the triangle is half of that, dividing by 2 gives 12 cm². Yes, that seems correct.
Is there another way to check this? Maybe using a different method? Let's see. For a triangle, the area can also be calculated using Heron's formula, but that requires knowing all three sides. Since I only have the base and height, that might not apply here. Alternatively, if it's a right-angled triangle, the area would be (1/2)*base*height, which is the same formula. But even if it's not a right-angled triangle, the formula still applies because the height is given. The height is the perpendicular distance from the base to the opposite vertex, so regardless of the triangle's type, as long as we know the base and the corresponding height, the formula works.
Let me draw a mental picture. Imagine a triangle where the base is 6 cm. The height is 4 cm, which means if I were to drop a perpendicular line from the top vertex to the base, that line would measure 4 cm. So, even if the triangle is slanted, that vertical height is still 4 cm. Multiplying base and height gives the area of the parallelogram, so dividing by two gives the triangle's area.
Another way to think about it: If I have two identical triangles, I can put them together to form a parallelogram. The area of that parallelogram is base times height, so each triangle is half of that. Therefore, the area of one triangle is 1/2 * base * height.
So, plugging the numbers in again: 1/2 * 6 cm * 4 cm. 1/2 of 6 is 3, and 3 times 4 is 12. Yep, 12 cm².
I think that's solid. Let me check with an example. Suppose the base was 2 cm and the height 3 cm. Then the area would be (2*3)/2 = 3 cm². If I draw such a triangle, it should have an area of 3 cm², which seems right. So scaling up, with a base of 6 and height of 4, the area is proportionally larger.
Alternatively, if I consider a rectangle with the same base and height, area would be 6*4=24 cm². The triangle is half of that, so 12 cm². That also checks out.
Wait, but hold on. If the triangle isn't a right triangle, does the formula still hold? Let's think. If I have an obtuse triangle where the height is outside the triangle, does that affect the area? For example, suppose the base is 6 cm, but the height is measured from the base to a vertex that's outside the triangle, making an obtuse triangle. Even in that case, the area is still (base*height)/2. Because the height is the perpendicular distance regardless of where it's located. So even if the triangle is obtuse, the formula remains the same. Therefore, regardless of the triangle type, as long as the height is given, the formula applies.
Therefore, using 6 cm and 4 cm, multiplying them, dividing by two, gives 12 cm². That seems to be the correct answer. I can't see any mistakes in the reasoning.
Let me just recap. The formula for the area of a triangle is 1/2 multiplied by base multiplied by height. Given base = 6 cm, height = 4 cm. Plugging into the formula: 1/2 * 6 * 4 = 12. The units are in centimeters, and since area is in square units, the answer is 12 cm².
Yes, that all lines up. I think I've got it right. The area is 12 square centimeters.
Jawaban akhir:
The area of the triangle is 12 cm².
To calculate the area of a triangle with a base of 6 cm and a height of 4 cm, we use the standard formula:
Area=1/2×base×height
Step-by-Step Calculation
Multiply the base and height: 6 cm×4 cm=24 cm²Divide the result by 2: 24 cm²/ 2=12 cm²Final Answer: 12 cm²
Thus, the area of the triangle is 12 cm².Sekarang, mari kita perbaiki prompt dan lihat bagaimana keluarannya berubah:
Prompt: "Luas segitiga: alas 6 cm, tinggi 4 cm. Tampilkan rumus dan hasil saja"
CoT:
Okay, so I need to find the area of a triangle with a base of 6 cm and a height of 4 cm. Hmm, let me remember the formula for the area of a triangle. I think it's something like base multiplied by height divided by two. Wait, yeah, right, because a triangle is basically half of a parallelogram, right? So if you have a parallelogram, the area is base times height, and then a triangle would be half of that. So the formula should be (base * height) / 2.
Let me double-check that. Maybe I can visualize a triangle with base 6 and height 4. If I had another identical triangle, I could put them together to form a parallelogram. The base would still be 6, the height would still be 4, so the area of the parallelogram would be 6*4=24. Then the area of one triangle would be half of that, which is 12. So that makes sense.
Alternatively, I remember in school they taught us the formula as A = 1/2 * b * h. So plugging in the values, it should be 1/2 * 6 cm * 4 cm. Let me calculate that. 1/2 of 6 is 3, then 3 times 4 is 12. So the area should be 12 cm².
Wait, but just to be thorough, let me make sure there aren't any other formulas that could apply here. For example, Heron's formula requires the lengths of all three sides, but I only have the base and height here. So Heron's formula isn't necessary. Since we have the base and height given directly, using the standard area formula is the way to go.
Also, units: the base is in centimeters, the height is in centimeters, so when multiplying, the area will be in square centimeters. That checks out.
Another thing to consider: is the height corresponding to the given base? The problem states "base 6 cm, height 4 cm," so yes, they correspond. If the height was relative to a different side, it might complicate things, but here it's specified for the base. So no issues there.
I think that's all. The formula is correct, the calculation seems right. 6 times 4 is 24, divided by 2 is 12. So the area is 12 square centimeters.
Jawaban akhir:
The area of the triangle is calculated using the formula: Area=1/2×base×height
Substituting the given values: Area=1/2×6 cm ×4 cm = 12 cm²
Result: 12 cm²Tabel di bawah ini menunjukkan bagaimana jumlah token yang digunakan memengaruhi total biaya panggilan API:
|
Contoh |
Token yang digunakan |
Biaya (USD) |
|
Prompt Tidak Teroptimasi |
1165 |
$0.00255 |
|
Prompt Teroptimasi |
496 |
$0.00109 |
Kita menurunkan biaya sekitar 57% dibandingkan versi awal dengan prompt yang dioptimasi, sambil tetap mendapatkan jawaban yang benar.
Dari tabel harga yang kita lihat di bagian Biaya Token, kita dapat menyimpulkan bahwa caching menghemat sekitar 74,07% biaya API untuk deepseek-chat dan 74,55% untuk deepseek-reasoner dibandingkan biaya memproses token input baru (tidak di-cache). Ini berarti penggunaan caching yang efektif dapat menurunkan biaya token input hampir tiga perempat.
Ini sangat berguna untuk prompt panjang, karena mengurangi waktu tunggu. Selain itu, sistem secara otomatis menangani caching—tidak perlu mengubah kode Anda.
Lalu bagaimana cara kerja context caching?
Saat Anda mengirim permintaan, DeepSeek menyimpan input di servernya. Jika Anda mengirim permintaan serupa di kemudian hari, sistem mengambil respons yang tersimpan alih-alih menghitung ulang semuanya. Ini membuat proses lebih cepat dan lebih murah.
Caching dapat berguna dan menurunkan biaya dalam situasi berikut:
Untuk memaksimalkan penghematan biaya, berikut rekomendasi saya:
Untuk melacak penggunaan cache dengan API DeepSeek, Anda tidak perlu mengubah kode. Informasi penggunaan cache otomatis disertakan dalam respons API. Sistem caching diaktifkan secara bawaan untuk semua pengguna. Saat Anda melakukan panggilan API, objek respons akan menyertakan dua field baru di bagian usage:
prompt_cache_hit_tokens: Jumlah token input yang dilayani dari cacheprompt_cache_miss_tokens: Jumlah token input yang tidak ditemukan di cacheUntuk mengakses informasi ini, Anda perlu memeriksa field usage dalam respons API. Berikut contoh cara mengakses nilai-nilai ini dalam:
response = client.chat.completions.create(
    model="deepseek-chat",
    messages=[
        {"role": "user", "content": "You are a helpful assistant."}
    ]
)

cache_hits = response.usage.prompt_cache_hit_tokens
cache_misses = response.usage.prompt_cache_miss_tokens

print(f"Cache hits: {cache_hits}")
print(f"Cache misses: {cache_misses}")
Fitur ini memungkinkan Anda memantau bagaimana sistem caching bekerja untuk use case Anda.
Namun caching memiliki beberapa keterbatasan:
Untuk mempelajari lebih lanjut, baca blog tentang prompt caching ini.
Dalam tutorial ini, kita telah mempelajari cara menggunakan DeepSeek API dan dua modelnya, DeepSeek-R1 dan V3. Jika Anda memahami cara kerja model-model ini, Anda dapat membangun aplikasi AI yang cerdas dan hemat biaya.
Pantau terus dokumentasi DeepSeek dan praktik terbaik terbaru untuk memaksimalkan kemampuan model-model ini. Setelah Anda memiliki kunci API DeepSeek, Anda dapat mengarahkannya ke agen pengodean milik DeepSeek sendiri; lihat tutorial DeepSeek Harness kami.
Selamat berkoding!
Pelajari AI dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt




