
Kurs
OpenAI API ile Çalışmak
3 sa
179.1K
DeepSeek modellerine API üzerinden erişmek için:
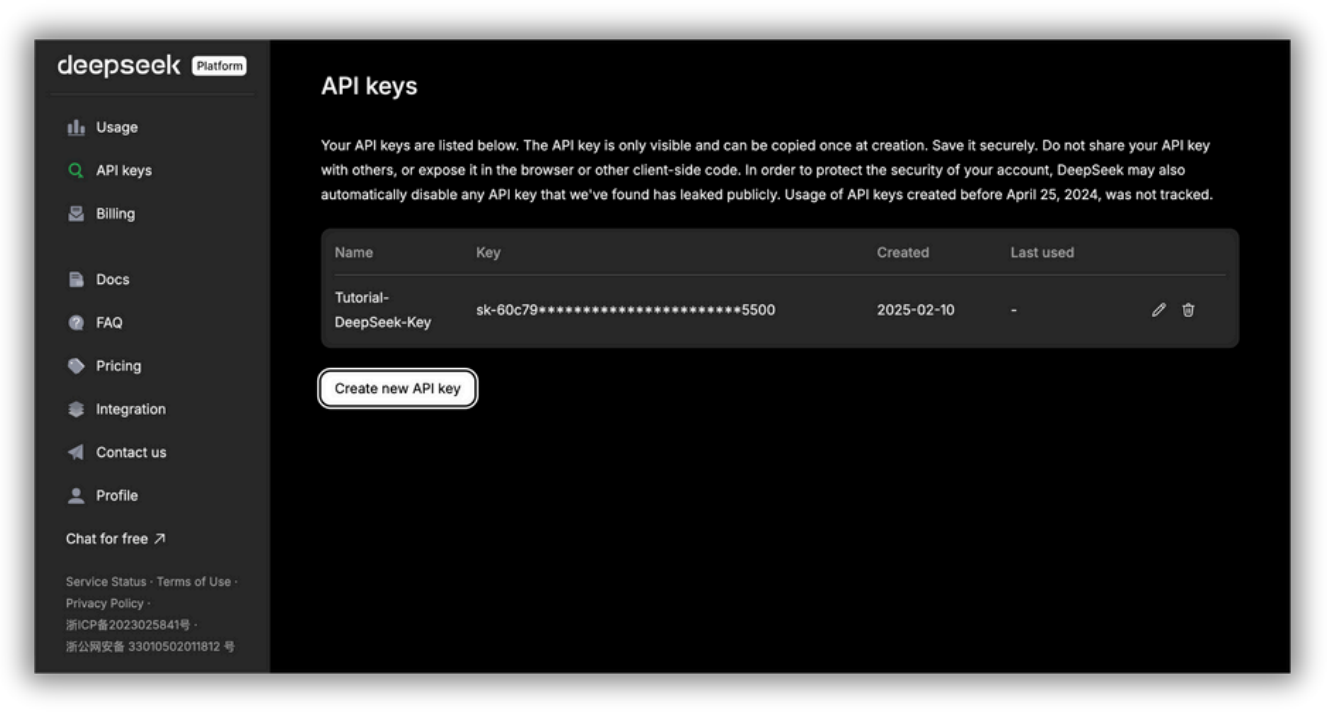
DeepSeek API platformu API anahtarı yönetim sayfası. Burada DeepSeek'in yapay zekâ servislerine erişmek için API anahtarlarınızı oluşturabilir ve yönetebilirsiniz. API anahtarı yalnızca oluşturulduğu anda görünür ve güvenli şekilde saklanmalıdır; herkese açık paylaşılması güvenlik risklerine yol açabilir.
DeepSeek-V3’ü kullanmak için model='deepseek-chat', DeepSeek-R1’i kullanmak için model='deepseek-reasoner' ayarlanmalıdır.
OpenAI SDK’yı kullanarak DeepSeek API’ye şu şekilde erişebilirsiniz:
from openai import OpenAI
client = OpenAI(api_key="<DeepSeek API Key>", base_url="https://api.deepseek.com")
response = client.chat.completions.create(
    model="deepseek-chat",
    messages=[
        {"role": "system", "content": "You are a helpful assistant"},
        {"role": "user", "content": "Hello"},
    ],
    stream=False
)
print(response.choices[0].message.content)
Bu kodun ne yaptığına daha yakından bakalım.
Bu kodun amacı, DeepSeek modeline bir sohbet mesajı göndermek ve modelin yanıtını yazdırmaktır.
Önce, from openai import OpenAI ifadesi openai kütüphanesinden OpenAI sınıfını içe aktarır.
Ardından, client = OpenAI(...) bir OpenAI istemci nesnesi oluşturur. Bu istemci, DeepSeek API’ye bağlantınızdır. İstemciyi API anahtarınızla (kimlik doğrulama) yapılandırır ve DeepSeek API’nin temel URL’sini belirtir.
Önemli: <DeepSeek API Key> ifadesini kendi gerçek DeepSeek API anahtarınızla değiştirin!
response kısmı, sohbet mesajınızı DeepSeek modeline gönderip yanıtı aldığı bölümdür. client.chat.completions.create(...) modelden yanıt almak için DeepSeek API’yi çağırır.
messages=[...] bölümüne bakalım; bu kısım konuşma geçmişini tanımlar:
Bu örnekte model='deepseek-chat’ ayarlandığı için DeepSeek-V3’ü kullanıyoruz; ancak model='deepseek-reasoner' ayarlayarak DeepSeek-R1’i kullanabileceğinizi unutmayın.
stream=False bölümü "Yanıtın tamamını tek seferde ver" anlamına gelir. Yani stream=False iken, model yanıtın tamamını oluşturana kadar bekler ve sonra gönderir. Yanıtı tek seferde göstermek ya da analiz etmek istiyorsanız bunu kullanın.
Ancak, özellikle uzun yanıtlar için çıktıyı almadan önce biraz beklemeniz gerekebilir. Eğer stream=True ayarlanırsa, model sözcükleri (daha doğrusu token’ları) oluşturur oluşturmaz gösterir; böylece tam yanıtı beklemek yerine gerçek zamanlı bir akış görürsünüz.
Son olarak, print(response.choices.message.content) modelin yanıtını nesneden çıkarır ve konsolunuza yazdırır. Yanıt nesnesi birçok bilgi içerir, ancak esas olarak modelin iletisiyle ilgilenirsiniz. API bazen birden fazla olası yanıt (seçenek) döndürebilir. Bu da ilkini seçer.
Bu makalenin yayımlandığı tarihte, DeepSeek sunucularında kaynakların azalması nedeniyle API hesaplarına yeni bakiye eklemeyi duraklattı. Bu da şu an için API bakiyenize para ekleyemeyeceğiniz anlamına geliyor. Hâlihazırda bakiyeniz varsa, API’yı normal şekilde kullanabilirsiniz. DeepSeek, sunucu kapasitesi arttığında yüklemelere muhtemelen devam edecektir; güncellemeleri takip edin!
DeepSeek ekibi, modellerinin rakiplere göre daha ucuz olduğunu iddia ediyor. Ancak yine de maliyetleri düşük tutmak ve en iyi performansı almak için akıllıca kullanmanız gerekir. DeepSeek’in modellerini kullanırken çıktıyı ve fiyatlandırmayı kontrol etmek için bilmeniz ve dikkate almanız gereken temel noktalar şunlardır.
Her DeepSeek modeli farklı görevler için tasarlanmıştır. Doğru seçimi yapmak, ihtiyaçlarınıza göre maliyet ile performans arasında denge kurmanıza yardımcı olur. Kısa bir karşılaştırma:
Token’lar, modelin işlediği en küçük metin birimleridir; bir kelime, sayı veya noktalama işareti olabilir. Kullanılan token sayısı dile ve modelin metni işleme biçimine bağlıdır.
Karakterlerin token’a dönüşümüne dair genel bir karşılaştırma:
Doğru bir tahmin için isteğinizi çalıştırdıktan sonra kullanım ayrıntılarını kontrol etmek en iyisidir. Token’ların nasıl sayıldığını anlarsanız, DeepSeek’in modellerini kullanırken maliyeti daha iyi yönetebilir ve performansı optimize edebilirsiniz.
Aşağıda her bir DeepSeek modeli için 1 milyon token başına fiyatlar yer almaktadır (not: bunlar bu makalenin yayımlandığı tarihteki fiyatlardır—en güncel maliyetleri buradan kontrol edin):
|
Model |
Bağlam uzunluğu |
Maks. CoT token |
Maks. çıktı token |
1m token giriş fiyatı (önbellek isabeti) |
1m token giriş fiyatı (önbellek kaçırma) |
1m token çıktı fiyatı |
|
deepseek-chat |
64k |
- |
8k |
$0.07 |
$0.27 |
$1.10 |
|
deepseek-reasoner |
64k |
32k |
8k |
$0.14 |
$0.55 |
$2.19 |
Daha önce belirtildiği gibi, DeepSeek iki model sunar: deepseek-chat ve deepseek-reasoner. Ancak her birinin farklı güçlü yönleri ve maliyetleri vardır. Bilgiyi nasıl işlediklerini ve token başına nasıl ücretlendirdiklerini bilmek, onları daha verimli kullanmanıza ve maliyetleri kontrol altında tutmanıza yardımcı olur.
Her iki model de bir konuşmada 64.000 token’a kadar işleyebilir; bu da daha fazla bağlamı hatırlayarak daha iyi ve daha ilgili yanıtlar üretmeleri anlamına gelir. Ancak çalışma biçimleri farklıdır.
Deepseek-chat genel konuşmalar için tasarlanmıştır ve ileri düzey akıl yürütme kullanmaz. Öte yandan deepseek-reasoner, nihai cevabı vermeden önce adım adım düşünme için (düşünce zinciri akıl yürütme—birazdan buna değineceğiz) 32.000 token’a kadar izin verir. Bu, karmaşık sorunları çözmek için idealdir ancak kullanılan token sayısını da artırır; bu da daha yüksek maliyet demektir.
Yanıt uzunluğu açısından, her iki model de yanıt başına 8.000 token’a kadar çıktı üretebilir. Bu sınır, yanıtların çok uzayıp pahalı hâle gelmesini önlemeye yardımcı olur.
Fiyatlandırmaya baktığımızda, deepseek-chat daha bütçe dostudur. Giriş önbellekten gelirse (yani daha önce kullanılmışsa) 1 milyon token başına 0,07$’dır. Yeni girişlerde fiyat 0,27$’a çıkar ve çıktı 1 milyon token başına 1,10$’dır.
Deepseek-reasoner, daha derin akıl yürütme sunduğu için daha pahalıdır. Önbellekten gelen giriş 1 milyon token başına 0,14$, yeni giriş 0,55$’dır. Çıkışı da 1 milyon token başına 2,19$ ile daha pahalıdır; bu, ürettiği yanıtların karmaşıklığını yansıtır.
Peki hangi modeli kullanmalısınız?
Basit sohbet yanıtlarına veya hızlı yanıtlara ihtiyacınız varsa deepseek-chat daha ucuz olduğu için daha iyi bir seçimdir. Ancak ayrıntılı akıl yürütme veya karmaşık problem çözme gerekiyorsa deepseek-reasoner daha güçlüdür—ancak maliyeti daha yüksektir.
Tasarruf etmek için önbellekleme de kullanabilirsiniz. Model, daha önce gördüğü bir girişi tanıdığında daha düşük bir ücret uygular. Bu, tekrarlanan sorgular veya çok turlu konuşmalar için oldukça faydalıdır.
DeepSeek modelleri rekabetçi fiyatlandırılır, ancak token kullanımı hızla artabilir. Maliyeti yönetmenin en iyi yolu, istemleri kısa tutmak, mümkün olduğunda önbelleklemeden yararlanmak ve işe uygun modeli seçmektir. Daha fazla bilgi için şu blogu okuyun: istem optimizasyonu.
Sıcaklık parametresi, modelin yanıtlarının ne kadar rastlantısal veya öngörülebilir olacağını kontrol eder. DeepSeek’te varsayılan olarak 1,0’dır; bu da yanıtların yaratıcı ve kararlı olma arasında dengeli olduğu anlamına gelir. Ancak bu ayarı özel ihtiyaçlarınıza göre değiştirebilirsiniz.
DeepSeek, farklı kullanım senaryoları için şu önerileri sunar:
|
Kullanım Senaryosu |
Önerilen Sıcaklık |
|
Kodlama / Matematik |
0,0 (Deterministik, hassas) |
|
Veri Temizleme / Veri Analizi |
1,0 (Dengeli yanıtlar) |
|
Genel Konuşma |
1,3 (Yanıtlarda daha fazla çeşitlilik) |
|
Çeviri |
1,3 (İfade esnekliğine izin verir) |
|
Yaratıcı Yazım / Şiir |
1,5 (Çeşitli, yaratıcı çıktıyı teşvik eder) |
Düşük sıcaklık (0,0’a yakın) modeli daha öngörülebilir ve hassas hâle getirir. Kodlama, matematik ve yapılandırılmış veri analizi gibi doğru cevap gerektiren görevler için idealdir.
Daha yüksek sıcaklık (1,0’ın üzerinde) modeli daha yaratıcı ve çeşitli kılar; hikâye anlatımı, şiir ve ifade esnekliği gereken çeviriler için uygundur.
Genel konuşmalar için yaklaşık 1,3 sıcaklık, çok tekrar eden ya da aşırı rastgele olmayan doğal ve ilgi çekici diyaloglar üretmeye yardımcı olur.
Sıcaklık ayarı maliyetleri doğrudan etkilemese de çıktı token sayısını dolaylı olarak artırabilir:
DeepSeek’in API’siyle etkileşim kurarken, response_format parametresini belirterek yanıtların formatını kontrol edebilirsiniz. Bu, özellikle yapılandırılmış verilerle çalışırken, model çıktısında tutarlılık ve okunabilirlik sağlamaya yardımcı olur.
Yanıtları JSON formatında almak için şunu ayarlayın:
response_format={'type': 'json_object'}Bu, modelin yapılandırılmış çıktı döndürmesini söyler; bu da bilgiyi programatik olarak işlemenizi kolaylaştırır. JSON formatı, veri çıkarımı, otomasyon ve API entegrasyonları gibi yapılandırılmış, makine tarafından okunabilir yanıt gerektiren uygulamalarda yaygın olarak kullanılır.
JSON biçimlendirme doğrudan fiyatlandırmayı etkilemese de bazı durumlarda dolaylı olarak maliyeti azaltabilir.
CoT, DeepSeek-R1’in nihai cevabı vermeden önce geçtiği akıl yürütme sürecidir. Yani model, sonuca varmadan önce düşünce sürecini adım adım açıklar.
CoT akıl yürütmesinde ve nihai yanıtta kullanılan her token, çıktı kapsamında olduğundan 1 milyon token başına 2,19$ olarak ücretlendirilir. Bu bir tür dengedir; daha fazla CoT token’ı = daha fazla maliyet ama aynı zamanda karmaşık görevlerde daha iyi doğruluk.
CoT kullanırken maliyetleri kontrol etmek için ne yapabilirsiniz?
DeepSeek-R1’de Düşünce Zinciri (CoT) çıktısının nasıl çalıştığını ve fiyatlandırmaya etkisini göstermek için bir örnek ele alalım:
from openai import OpenAI

client = OpenAI(
    api_key="<Your_DeepSeek_API_Key>",
    base_url="https://api.deepseek.com"
)

def generate_response(prompt):
    response = client.chat.completions.create(
        model="deepseek-reasoner",
        messages=[
            {"role": "system", "content": "You are a helpful assistant."},
            {"role": "user", "content": prompt}
        ],
        stream=False
    )
    return response.choices[0].message.content

# Example usage
prompt = "Calculate the area of a triangle with a base of 6 cm and a height of 4 cm."
result = generate_response(prompt)
print(result)
CoT:
Okay, so I need to find the area of a triangle with a base of 6 cm and a height of 4 cm. Hmm, let me remember how to do this. I think the formula for the area of a triangle is something like base multiplied by height divided by two. Wait, is that right? Let me think.
When I was in math class, the teacher mentioned that a triangle is basically half of a parallelogram. So if you have a parallelogram, its area is base times height. If you cut it along the diagonal, you get two triangles. That means each triangle would have half the area of the parallelogram. So yes, the formula should be (base × height) / 2. That makes sense. Let me write that down to visualize it better.
Area = (base × height) / 2
Given the base is 6 cm and the height is 4 cm, I can substitute those values into the formula. Let me plug them in step by step.
First, multiply the base and the height: 6 cm × 4 cm. Let me calculate that. 6 times 4 is 24. So that gives me 24 cm². Now, divide that result by 2. So 24 divided by 2 is 12. Therefore, the area should be 12 cm².
Wait, let me verify that. If the base was 6 and the height 4, multiplying them gives the area of the corresponding parallelogram, which would be 24 cm². Then, since the triangle is half of that, dividing by 2 gives 12 cm². Yes, that seems correct.
Is there another way to check this? Maybe using a different method? Let's see. For a triangle, the area can also be calculated using Heron's formula, but that requires knowing all three sides. Since I only have the base and height, that might not apply here. Alternatively, if it's a right-angled triangle, the area would be (1/2)*base*height, which is the same formula. But even if it's not a right-angled triangle, the formula still applies because the height is given. The height is the perpendicular distance from the base to the opposite vertex, so regardless of the triangle's type, as long as we know the base and the corresponding height, the formula works.
Let me draw a mental picture. Imagine a triangle where the base is 6 cm. The height is 4 cm, which means if I were to drop a perpendicular line from the top vertex to the base, that line would measure 4 cm. So, even if the triangle is slanted, that vertical height is still 4 cm. Multiplying base and height gives the area of the parallelogram, so dividing by two gives the triangle's area.
Another way to think about it: If I have two identical triangles, I can put them together to form a parallelogram. The area of that parallelogram is base times height, so each triangle is half of that. Therefore, the area of one triangle is 1/2 * base * height.
So, plugging the numbers in again: 1/2 * 6 cm * 4 cm. 1/2 of 6 is 3, and 3 times 4 is 12. Yep, 12 cm².
I think that's solid. Let me check with an example. Suppose the base was 2 cm and the height 3 cm. Then the area would be (2*3)/2 = 3 cm². If I draw such a triangle, it should have an area of 3 cm², which seems right. So scaling up, with a base of 6 and height of 4, the area is proportionally larger.
Alternatively, if I consider a rectangle with the same base and height, area would be 6*4=24 cm². The triangle is half of that, so 12 cm². That also checks out.
Wait, but hold on. If the triangle isn't a right triangle, does the formula still hold? Let's think. If I have an obtuse triangle where the height is outside the triangle, does that affect the area? For example, suppose the base is 6 cm, but the height is measured from the base to a vertex that's outside the triangle, making an obtuse triangle. Even in that case, the area is still (base*height)/2. Because the height is the perpendicular distance regardless of where it's located. So even if the triangle is obtuse, the formula remains the same. Therefore, regardless of the triangle type, as long as the height is given, the formula applies.
Therefore, using 6 cm and 4 cm, multiplying them, dividing by two, gives 12 cm². That seems to be the correct answer. I can't see any mistakes in the reasoning.
Let me just recap. The formula for the area of a triangle is 1/2 multiplied by base multiplied by height. Given base = 6 cm, height = 4 cm. Plugging into the formula: 1/2 * 6 * 4 = 12. The units are in centimeters, and since area is in square units, the answer is 12 cm².
Yes, that all lines up. I think I've got it right. The area is 12 square centimeters.
Nihai cevap:
The area of the triangle is 12 cm².
To calculate the area of a triangle with a base of 6 cm and a height of 4 cm, we use the standard formula:
Area=1/2×base×height
Step-by-Step Calculation
Multiply the base and height: 6 cm×4 cm=24 cm²Divide the result by 2: 24 cm²/ 2=12 cm²Final Answer: 12 cm²
Thus, the area of the triangle is 12 cm².Şimdi, istemi iyileştirelim ve çıktının nasıl değiştiğine bakalım:
İstem: "Üçgenin alanı: taban 6 cm, yükseklik 4 cm. Yalnızca formülü ve sonucu göster"
CoT:
Okay, so I need to find the area of a triangle with a base of 6 cm and a height of 4 cm. Hmm, let me remember the formula for the area of a triangle. I think it's something like base multiplied by height divided by two. Wait, yeah, right, because a triangle is basically half of a parallelogram, right? So if you have a parallelogram, the area is base times height, and then a triangle would be half of that. So the formula should be (base * height) / 2.
Let me double-check that. Maybe I can visualize a triangle with base 6 and height 4. If I had another identical triangle, I could put them together to form a parallelogram. The base would still be 6, the height would still be 4, so the area of the parallelogram would be 6*4=24. Then the area of one triangle would be half of that, which is 12. So that makes sense.
Alternatively, I remember in school they taught us the formula as A = 1/2 * b * h. So plugging in the values, it should be 1/2 * 6 cm * 4 cm. Let me calculate that. 1/2 of 6 is 3, then 3 times 4 is 12. So the area should be 12 cm².
Wait, but just to be thorough, let me make sure there aren't any other formulas that could apply here. For example, Heron's formula requires the lengths of all three sides, but I only have the base and height here. So Heron's formula isn't necessary. Since we have the base and height given directly, using the standard area formula is the way to go.
Also, units: the base is in centimeters, the height is in centimeters, so when multiplying, the area will be in square centimeters. That checks out.
Another thing to consider: is the height corresponding to the given base? The problem states "base 6 cm, height 4 cm," so yes, they correspond. If the height was relative to a different side, it might complicate things, but here it's specified for the base. So no issues there.
I think that's all. The formula is correct, the calculation seems right. 6 times 4 is 24, divided by 2 is 12. So the area is 12 square centimeters.
Nihai cevap:
The area of the triangle is calculated using the formula: Area=1/2×base×height
Substituting the given values: Area=1/2×6 cm ×4 cm = 12 cm²
Result: 12 cm²Aşağıdaki tablo, kullanılan token sayısının bir API çağrısının toplam maliyetini nasıl etkilediğini gösterir:
|
Örnek |
Kullanılan Token |
Maliyet (USD) |
|
Optimize edilmemiş İstem |
1165 |
$0.00255 |
|
Optimize edilmiş istem |
496 |
$0.00109 |
Optimize edilmiş istemle, doğru cevabı alırken ilkine kıyasla maliyeti yaklaşık %57 azalttık.
Token Maliyetleri bölümündeki fiyatlandırma tablosundan, deepseek-chat için API maliyetlerinde yaklaşık %74,07 ve deepseek-reasoner için %74,55 tasarruf sağladığını çıkarabiliriz; bu da yeni (önbelleğe alınmamış) giriş token’larının işlenmesi maliyetiyle karşılaştırıldığında geçerlidir. Yani, önbelleği etkin şekilde kullanmak, giriş token maliyetlerini neredeyse dörtte üç oranında azaltabilir.
Özellikle uzun istemlerde faydalıdır; bekleme süresini azaltır. Ayrıca sistem önbellekleme işlemini otomatik olarak yönetir—kodu değiştirmenize gerek yoktur.
Peki bağlam önbellekleme nasıl çalışır?
Bir istek gönderdiğinizde DeepSeek, girdiyi sunucularında saklar. Daha sonra benzer bir istek gönderirseniz, sistem her şeyi yeniden hesaplamak yerine saklanan yanıtı getirir. Bu da süreci daha hızlı ve daha ucuz hâle getirir.
Önbellekleme şu durumlarda faydalı olabilir ve maliyetleri azaltabilir:
Maliyet tasarrufunu maksimize etmek için şunları öneririm:
DeepSeek’in API’siyle önbellek kullanımınızı takip etmek için kodunuzu değiştirmeniz gerekmez. Önbellek kullanım bilgisi API yanıtına otomatik olarak dâhil edilir. Önbellekleme sistemi tüm kullanıcılar için varsayılan olarak etkindir. Bir API çağrısı yaptığınızda, yanıt nesnesinin usage bölümünde iki yeni alan yer alır:
prompt_cache_hit_tokens: Önbellekten sunulan giriş token sayısıprompt_cache_miss_tokens: Önbellekte bulunamayan giriş token sayısıBu bilgilere erişmek için API yanıtındaki usage alanını kontrol etmeniz gerekir. Bu değerlere şu şekilde erişebilirsiniz:
response = client.chat.completions.create(
    model="deepseek-chat",
    messages=[
        {"role": "user", "content": "You are a helpful assistant."}
    ]
)

cache_hits = response.usage.prompt_cache_hit_tokens
cache_misses = response.usage.prompt_cache_miss_tokens

print(f"Cache hits: {cache_hits}")
print(f"Cache misses: {cache_misses}")
Bu özellik, önbellekleme sisteminin kullanım senaryonuzda nasıl çalıştığını izlemenize olanak tanır.
Yine de önbelleğin bazı sınırlamaları vardır:
Daha fazla bilgi için şu blogu okuyun: istem önbellekleme.
Bu eğitimde, DeepSeek API’yi ve iki modelini, DeepSeek-R1 ve V3’ü nasıl kullanacağımızı öğrendik. Bu modellerin nasıl çalıştığını anlayarak akıllı ve maliyet-etkin yapay zekâ uygulamaları geliştirebilirsiniz.
En güncel DeepSeek dokümantasyonunu ve en iyi uygulamaları takip ederek bu güçlü modellerden en iyi şekilde yararlanın. Bir DeepSeek API anahtarınız olduğunda, onu DeepSeek'in kendi kodlama aracısına yönlendirebilirsiniz; bkz. DeepSeek Harness eğitimi.
İyi kodlamalar!
Bu kurslarla yapay zekâyı öğrenin!
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



