
Last chance! 50% off DataCamp Premium
Sale ends in
DeepSeek मॉडलों तक API के जरिए पहुँचने के लिए:
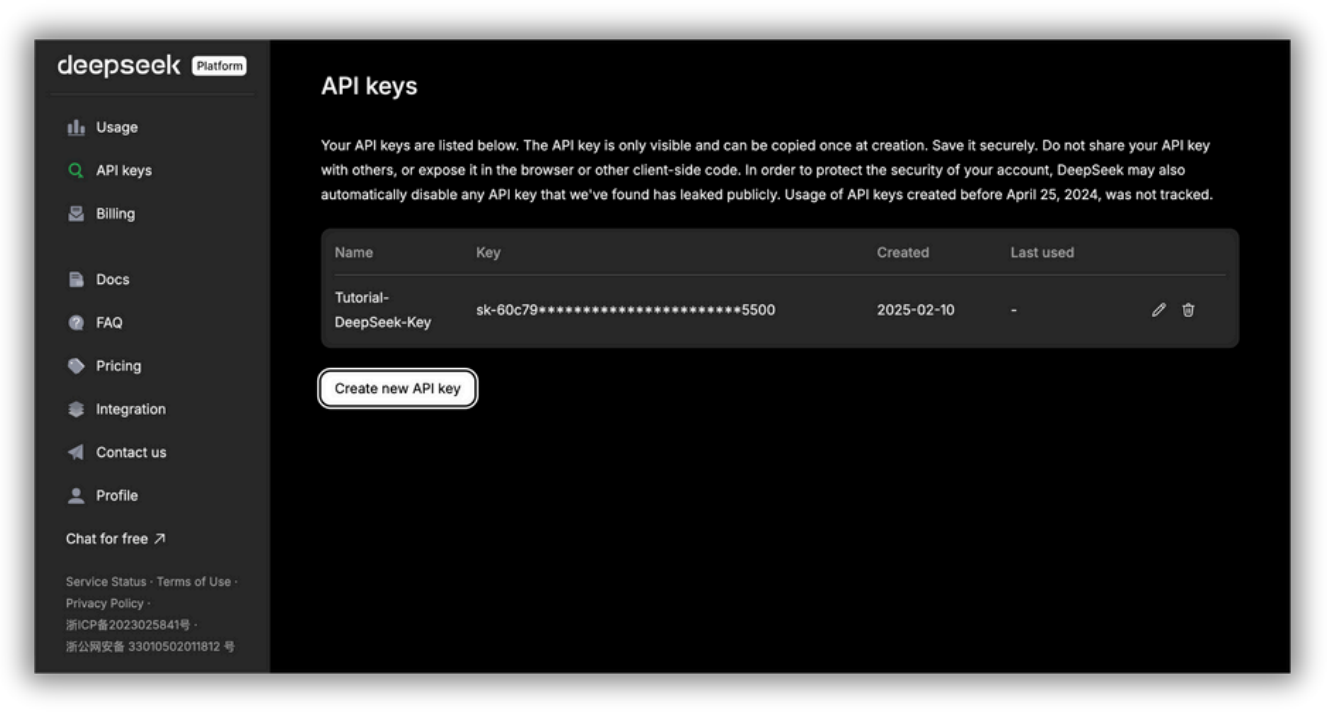
DeepSeek API प्लेटफ़ॉर्म की API कुंजी प्रबंधन पेज। यहाँ आप DeepSeek की AI सेवाओं तक पहुँचने के लिए अपनी API कुंजियाँ जनरेट और प्रबंधित कर सकते हैं। API कुंजी केवल निर्माण के समय दिखाई देती है और इसे सुरक्षित रूप से रखना आवश्यक है; इसे सार्वजनिक रूप से साझा करने से सुरक्षा जोखिम हो सकते हैं।
DeepSeek-V3 का उपयोग करने के लिए आपको model='deepseek-chat' सेट करना होगा और DeepSeek-R1 के लिए model='deepseek-reasoner' सेट करना होगा।
यहाँ OpenAI SDK का उपयोग करके DeepSeek API तक पहुँचने का तरीका दिया गया है:
from openai import OpenAI
client = OpenAI(api_key="<DeepSeek API Key>", base_url="https://api.deepseek.com")
response = client.chat.completions.create(
    model="deepseek-chat",
    messages=[
        {"role": "system", "content": "You are a helpful assistant"},
        {"role": "user", "content": "Hello"},
    ],
    stream=False
)
print(response.choices[0].message.content)
आइए देखें कि यह कोड क्या करता है।
इस कोड का लक्ष्य DeepSeek मॉडल को एक चैट संदेश भेजना और मॉडल की प्रतिक्रिया प्रिंट करना है।
पहले, from openai import OpenAI openai लाइब्रेरी से OpenAI क्लास को इंपोर्ट करता है।
फिर, client = OpenAI(...) एक OpenAI क्लाइंट ऑब्जेक्ट बनाता है। यह क्लाइंट DeepSeek API से आपका कनेक्शन है। यह आपके API कुंजी (प्रमाणीकरण) के साथ क्लाइंट को कॉन्फ़िगर करता है और DeepSeek API का बेस URL निर्दिष्ट करता है।
महत्वपूर्ण: <DeepSeek API Key> को अपनी वास्तविक DeepSeek API कुंजी से बदलें!
response वह भाग है जो आपका चैट संदेश DeepSeek मॉडल को भेजता है और प्रतिक्रिया प्राप्त करता है। client.chat.completions.create(...) मॉडल से प्रतिक्रिया प्राप्त करने के लिए DeepSeek API को कॉल कर रहा है।
आइए messages=[...] पर नज़र डालें, जो वार्तालाप इतिहास को परिभाषित करता है:
ध्यान दें कि इस उदाहरण में हम DeepSeek-V3 का उपयोग कर रहे हैं क्योंकि हमने model='deepseek-chat’ सेट किया है, लेकिन याद रखें कि आप model='deepseek-reasoner' सेट करके DeepSeek-R1 का उपयोग कर सकते हैं।
stream=False का अर्थ है "पूरा जवाब एक साथ दें"। यानी जब आप stream=False सेट करते हैं, तो मॉडल पूरी प्रतिक्रिया तैयार होने तक प्रतीक्षा करता है और फिर एक बार में भेजता है। यह तब उपयोगी है जब आप पूरी प्रतिक्रिया को एक साथ दिखाना या विश्लेषण करना चाहते हैं।
हालाँकि, लंबे जवाबों के लिए आपको आउटपुट मिलने में थोड़ा इंतज़ार करना पड़ सकता है। यदि आप stream=True सेट करते हैं, तो मॉडल शब्दों (यानी, टोकन) को बनते समय दिखाता है, इसलिए आपको पूरी प्रतिक्रिया का इंतजार करने के बजाय रियल-टाइम में आउटपुट दिखाई देता है।
अंत में, print(response.choices.message.content) प्रतिक्रिया ऑब्जेक्ट से मॉडल का जवाब निकालकर आपके कंसोल पर प्रिंट करता है। प्रतिक्रिया ऑब्जेक्ट में बहुत सी जानकारी होती है, लेकिन आपको मुख्य रूप से मॉडल के संदेश में रुचि होती है। API कभी-कभी एक से अधिक संभावित उत्तर (choices) लौटाता है। यह पहला चुनता है।
इस लेख के प्रकाशन के समय, DeepSeek ने अपने सर्वरों पर संसाधनों की कमी के कारण API खातों में नए फंड जोड़ना रोक दिया है। इसका मतलब है कि आप अभी अपनी API बैलेंस में और पैसे नहीं जोड़ सकते। यदि आपके खाते में पहले से फंड हैं, तो आप सामान्य रूप से API का उपयोग कर सकते हैं। DeepSeek सर्वर क्षमता बढ़ने पर रिचार्ज फिर से शुरू कर सकता है, इसलिए अपडेट पर नज़र रखें!
DeepSeek टीम का दावा है कि उनके मॉडल प्रतिस्पर्धियों से सस्ते हैं। परंतु लागत कम रखने और सर्वश्रेष्ठ प्रदर्शन पाने के लिए समझदारी से उपयोग करना जरूरी है। आउटपुट और प्राइसिंग को नियंत्रित करने के लिए DeepSeek के मॉडलों का उपयोग करते समय जानने और ध्यान में रखने योग्य मुख्य बातें यहाँ हैं।
हर DeepSeek मॉडल अलग-अलग कार्यों के लिए बनाया गया है। सही मॉडल चुनने से आप अपनी ज़रूरत के अनुसार लागत और प्रदर्शन में संतुलन बना सकते हैं। त्वरित तुलना:
टोकन वह सबसे छोटी पाठ इकाई है जिसे मॉडल प्रोसेस करता है—यह कोई शब्द, संख्या, या विराम-चिह्न भी हो सकता है। उपयोग किए गए टोकनों की संख्या भाषा और मॉडल के टेक्स्ट प्रोसेस करने के तरीके पर निर्भर करती है।
यहाँ अक्षरों से टोकन में रूपांतरण का सामान्य अनुमान दिया गया है:
सटीक अनुमान के लिए, अनुरोध चलाने के बाद उपयोग विवरण देखना सबसे अच्छा है। यदि आप समझते हैं कि टोकन कैसे गिने जाते हैं, तो आप DeepSeek के मॉडल का उपयोग करते समय लागत को बेहतर ढंग से मैनेज कर सकते हैं और प्रदर्शन को अनुकूलित कर सकते हैं।
यहाँ प्रत्येक DeepSeek मॉडल के लिए प्रति 10 लाख टोकन की कीमतें दी गई हैं (ध्यान दें: ये इस लेख के प्रकाशन के समय की कीमतें थीं—सबसे हाल की लागतें यहाँ देखें):
|
मॉडल |
कॉन्टेक्स्ट लंबाई |
अधिकतम CoT टोकन |
अधिकतम आउटपुट टोकन |
10 लाख टोकन इनपुट कीमत (कैश हिट) |
10 लाख टोकन इनपुट कीमत (कैश मिस) |
10 लाख टोकन आउटपुट कीमत |
|
deepseek-chat |
64k |
- |
8k |
$0.07 |
$0.27 |
$1.10 |
|
deepseek-reasoner |
64k |
32k |
8k |
$0.14 |
$0.55 |
$2.19 |
जैसा कि पहले बताया गया, DeepSeek दो मॉडल प्रदान करता है—deepseek-chat और deepseek-reasoner। परंतु दोनों की ताकतें और लागतें अलग हैं। वे जानकारी कैसे प्रोसेस करते हैं और टोकन के लिए कैसे शुल्क लेते हैं, यह जानना आपको अधिक कुशलता से उपयोग करने और लागत पर नियंत्रण रखने में मदद करता है।
दोनों मॉडल एक बातचीत में अधिकतम 64,000 टोकन संभाल सकते हैं, यानी वे अधिक संदर्भ याद रख सकते हैं जिससे बेहतर और प्रासंगिक जवाब मिलते हैं। हालाँकि, उनका काम करने का तरीका अलग है।
Deepseek-chat सामान्य वार्तालापों के लिए डिज़ाइन किया गया है और उन्नत तर्क का उपयोग नहीं करता। दूसरी ओर, deepseek-reasoner अंतिम उत्तर देने से पहले चरण-दर-चरण सोच (चेन-ऑफ-थॉट तर्क—इसके बारे में आगे) के लिए 32,000 टोकन तक की अनुमति देता है। यह जटिल समस्याएँ हल करने में बेहतरीन है, पर इससे उपयोग हुए टोकनों की संख्या बढ़ती है—और इसका मतलब अधिक लागत है।
प्रतिक्रिया की लंबाई की बात करें, तो दोनों मॉडल प्रति उत्तर 8,000 टोकन तक जनरेट कर सकते हैं। यह सीमा प्रतिक्रियाओं को बहुत लंबा और महंगा होने से रोकती है।
प्राइसिंग देखें तो deepseek-chat अधिक किफायती विकल्प है। यदि इनपुट कैश हुआ है (यानी पहले उपयोग हुआ है), तो लागत प्रति 10 लाख टोकन $0.07 है। नए इनपुट के लिए कीमत $0.27 प्रति 10 लाख टोकन है, और आउटपुट की कीमत $1.10 प्रति 10 लाख टोकन है।
Deepseek-reasoner अधिक महंगा है क्योंकि यह गहन तर्क प्रदान करता है। कैश्ड इनपुट $0.14 प्रति 10 लाख टोकन है, जबकि नया इनपुट $0.55 प्रति 10 लाख टोकन। इसका आउटपुट भी महँगा है—$2.19 प्रति 10 लाख टोकन—जो इसकी प्रतिक्रियाओं की जटिलता को दर्शाता है।
तो, आपको कौन-सा मॉडल उपयोग करना चाहिए?
यदि आपको सरल चैट प्रतिक्रियाएँ या त्वरित उत्तर चाहिए, तो deepseek-chat बेहतर है क्योंकि यह सस्ता है। लेकिन यदि आपको विस्तृत तर्क या जटिल समस्या-समाधान चाहिए, तो deepseek-reasoner अधिक शक्तिशाली है—हालाँकि इसकी लागत अधिक है।
पैसा बचाने के लिए आप कैशिंग का उपयोग भी कर सकते हैं। जब मॉडल पहले से देखे हुए इनपुट को पहचानता है, तो यह कम दर वसूलता है। यह दोहराए जाने वाले क्वेरी या मल्टी-टर्न बातचीत के लिए बहुत उपयोगी है।
DeepSeek मॉडल प्रतिस्पर्धी कीमतों पर हैं, लेकिन टोकन उपयोग जल्दी बढ़ सकता है। लागत प्रबंधन का सबसे अच्छा तरीका है—प्रॉम्प्ट को छोटा रखें, जहाँ संभव हो कैशिंग का उपयोग करें, और काम के अनुसार सही मॉडल चुनें। अधिक जानने के लिए प्रॉम्प्ट ऑप्टिमाइज़ेशन पर यह ब्लॉग पढ़ें।
टेम्परेचर पैरामीटर नियंत्रित करता है कि मॉडल की प्रतिक्रियाएँ कितनी रैंडम या प्रिडिक्टेबल होंगी। DeepSeek में डिफ़ॉल्ट रूप से यह 1.0 है, जिसका मतलब है कि प्रतिक्रियाएँ रचनात्मकता और निर्धारकता के बीच संतुलित होती हैं। हालाँकि, आप अपनी विशिष्ट ज़रूरतों के अनुसार इस सेटिंग को समायोजित कर सकते हैं।
अलग-अलग उपयोग मामलों के लिए DeepSeek निम्नलिखित सिफारिशें देता है:
|
उपयोग मामला |
अनुशंसित टेम्परेचर |
|
कोडिंग / गणित |
0.0 (निर्धारक, सटीक) |
|
डेटा क्लीनिंग / डेटा विश्लेषण |
1.0 (संतुलित प्रतिक्रियाएँ) |
|
सामान्य बातचीत |
1.3 (प्रतिक्रियाओं में अधिक विविधता) |
|
अनुवाद |
1.3 (शब्दों में लचीलापन देता है) |
|
रचनात्मक लेखन / कविता |
1.5 (विविध, कल्पनाशील आउटपुट को प्रोत्साहित करता है) |
कम टेम्परेचर (0.0 के करीब) मॉडल को अधिक प्रिडिक्टेबल और सटीक बनाता है। यह कोडिंग, गणित और संरचित डेटा विश्लेषण जैसे सटीक उत्तरों वाली गतिविधियों के लिए अच्छा है।
उच्च टेम्परेचर (1.0 से ऊपर) मॉडल को अधिक रचनात्मक और विविध बनाता है—कहानी लेखन, कविता और ऐसे अनुवाद जिनमें लचीलापन चाहिए, के लिए उपयुक्त।
सामान्य बातचीत के लिए, लगभग 1.3 का टेम्परेचर प्राकृतिक और आकर्षक संवाद उत्पन्न करने में मदद करता है, बिना बहुत दोहराव या अत्यधिक रैंडम हुए।
हालाँकि टेम्परेचर सेटिंग खुद सीधे लागत को प्रभावित नहीं करती, यह अप्रत्यक्ष रूप से आउटपुट टोकनों की संख्या बढ़ा या घटा सकती है:
DeepSeek की API के साथ बातचीत करते समय, आप response_format पैरामीटर निर्दिष्ट करके प्रतिक्रियाओं का फ़ॉर्मेट नियंत्रित कर सकते हैं। यह विशेष रूप से संरचित डेटा के साथ काम करते समय उपयोगी है, क्योंकि यह मॉडल के आउटपुट में निरंतरता और पठनीयता सुनिश्चित करता है।
JSON फ़ॉर्मेट में प्रतिक्रियाएँ प्राप्त करने के लिए, सेट करें:
response_format={'type': 'json_object'}यह मॉडल से संरचित आउटपुट लौटाने को कहता है, जिससे प्रोग्रामेटिक तरीके से जानकारी प्रोसेस करना आसान हो जाता है। JSON फ़ॉर्मेट आमतौर पर उन एप्लिकेशनों में उपयोग होता है जिन्हें संरचित, मशीन-पठनीय प्रतिक्रियाएँ चाहिए—जैसे डेटा निष्कर्षण, स्वचालन और API इंटीग्रेशन।
भले ही JSON फ़ॉर्मेटिंग सीधे प्राइसिंग को प्रभावित नहीं करती, यह कुछ मामलों में अप्रत्यक्ष रूप से लागत घटा सकती है।
CoT वह तर्क प्रक्रिया है जिससे DeepSeek-R1 अंतिम उत्तर देने से पहले गुजरता है। यानी मॉडल निष्कर्ष पर पहुँचने से पहले चरण-दर-चरण अपना विचार-प्रवाह बताता है।
CoT तर्क और अंतिम उत्तर में उपयोग हुए हर टोकन पर $2.19 प्रति 10 लाख टोकन की दर से शुल्क लगता है, क्योंकि यह आउटपुट का हिस्सा होता है। यहाँ थोड़ा ट्रेड-ऑफ है; अधिक CoT टोकन = अधिक लागत, लेकिन जटिल कार्यों में बेहतर सटीकता भी।
CoT का उपयोग करते हुए लागत कैसे नियंत्रित करें?
यह देखने के लिए कि DeepSeek-R1 में चेन-ऑफ-थॉट (CoT) आउटपुट कैसे काम करता है और इसका प्राइसिंग पर क्या प्रभाव पड़ता है, आइए एक उदाहरण देखें:
from openai import OpenAI

client = OpenAI(
    api_key="<Your_DeepSeek_API_Key>",
    base_url="https://api.deepseek.com"
)

def generate_response(prompt):
    response = client.chat.completions.create(
        model="deepseek-reasoner",
        messages=[
            {"role": "system", "content": "You are a helpful assistant."},
            {"role": "user", "content": prompt}
        ],
        stream=False
    )
    return response.choices[0].message.content

# Example usage
prompt = "Calculate the area of a triangle with a base of 6 cm and a height of 4 cm."
result = generate_response(prompt)
print(result)
CoT:
Okay, so I need to find the area of a triangle with a base of 6 cm and a height of 4 cm. Hmm, let me remember how to do this. I think the formula for the area of a triangle is something like base multiplied by height divided by two. Wait, is that right? Let me think.
When I was in math class, the teacher mentioned that a triangle is basically half of a parallelogram. So if you have a parallelogram, its area is base times height. If you cut it along the diagonal, you get two triangles. That means each triangle would have half the area of the parallelogram. So yes, the formula should be (base × height) / 2. That makes sense. Let me write that down to visualize it better.
Area = (base × height) / 2
Given the base is 6 cm and the height is 4 cm, I can substitute those values into the formula. Let me plug them in step by step.
First, multiply the base and the height: 6 cm × 4 cm. Let me calculate that. 6 times 4 is 24. So that gives me 24 cm². Now, divide that result by 2. So 24 divided by 2 is 12. Therefore, the area should be 12 cm².
Wait, let me verify that. If the base was 6 and the height 4, multiplying them gives the area of the corresponding parallelogram, which would be 24 cm². Then, since the triangle is half of that, dividing by 2 gives 12 cm². Yes, that seems correct.
Is there another way to check this? Maybe using a different method? Let's see. For a triangle, the area can also be calculated using Heron's formula, but that requires knowing all three sides. Since I only have the base and height, that might not apply here. Alternatively, if it's a right-angled triangle, the area would be (1/2)*base*height, which is the same formula. But even if it's not a right-angled triangle, the formula still applies because the height is given. The height is the perpendicular distance from the base to the opposite vertex, so regardless of the triangle's type, as long as we know the base and the corresponding height, the formula works.
Let me draw a mental picture. Imagine a triangle where the base is 6 cm. The height is 4 cm, which means if I were to drop a perpendicular line from the top vertex to the base, that line would measure 4 cm. So, even if the triangle is slanted, that vertical height is still 4 cm. Multiplying base and height gives the area of the parallelogram, so dividing by two gives the triangle's area.
Another way to think about it: If I have two identical triangles, I can put them together to form a parallelogram. The area of that parallelogram is base times height, so each triangle is half of that. Therefore, the area of one triangle is 1/2 * base * height.
So, plugging the numbers in again: 1/2 * 6 cm * 4 cm. 1/2 of 6 is 3, and 3 times 4 is 12. Yep, 12 cm².
I think that's solid. Let me check with an example. Suppose the base was 2 cm and the height 3 cm. Then the area would be (2*3)/2 = 3 cm². If I draw such a triangle, it should have an area of 3 cm², which seems right. So scaling up, with a base of 6 and height of 4, the area is proportionally larger.
Alternatively, if I consider a rectangle with the same base and height, area would be 6*4=24 cm². The triangle is half of that, so 12 cm². That also checks out.
Wait, but hold on. If the triangle isn't a right triangle, does the formula still hold? Let's think. If I have an obtuse triangle where the height is outside the triangle, does that affect the area? For example, suppose the base is 6 cm, but the height is measured from the base to a vertex that's outside the triangle, making an obtuse triangle. Even in that case, the area is still (base*height)/2. Because the height is the perpendicular distance regardless of where it's located. So even if the triangle is obtuse, the formula remains the same. Therefore, regardless of the triangle type, as long as the height is given, the formula applies.
Therefore, using 6 cm and 4 cm, multiplying them, dividing by two, gives 12 cm². That seems to be the correct answer. I can't see any mistakes in the reasoning.
Let me just recap. The formula for the area of a triangle is 1/2 multiplied by base multiplied by height. Given base = 6 cm, height = 4 cm. Plugging into the formula: 1/2 * 6 * 4 = 12. The units are in centimeters, and since area is in square units, the answer is 12 cm².
Yes, that all lines up. I think I've got it right. The area is 12 square centimeters.
अंतिम उत्तर:
The area of the triangle is 12 cm².
To calculate the area of a triangle with a base of 6 cm and a height of 4 cm, we use the standard formula:
Area=1/2×base×height
Step-by-Step Calculation
Multiply the base and height: 6 cm×4 cm=24 cm²Divide the result by 2: 24 cm²/ 2=12 cm²Final Answer: 12 cm²
Thus, the area of the triangle is 12 cm².अब, प्रॉम्प्ट को परिष्कृत करते हैं और देखते हैं आउटपुट कैसे बदलता है:
प्रॉम्प्ट: "त्रिभुज का क्षेत्रफल: आधार 6cm, ऊँचाई 4cm। केवल सूत्र और परिणाम दिखाएँ"
CoT:
Okay, so I need to find the area of a triangle with a base of 6 cm and a height of 4 cm. Hmm, let me remember the formula for the area of a triangle. I think it's something like base multiplied by height divided by two. Wait, yeah, right, because a triangle is basically half of a parallelogram, right? So if you have a parallelogram, the area is base times height, and then a triangle would be half of that. So the formula should be (base * height) / 2.
Let me double-check that. Maybe I can visualize a triangle with base 6 and height 4. If I had another identical triangle, I could put them together to form a parallelogram. The base would still be 6, the height would still be 4, so the area of the parallelogram would be 6*4=24. Then the area of one triangle would be half of that, which is 12. So that makes sense.
Alternatively, I remember in school they taught us the formula as A = 1/2 * b * h. So plugging in the values, it should be 1/2 * 6 cm * 4 cm. Let me calculate that. 1/2 of 6 is 3, then 3 times 4 is 12. So the area should be 12 cm².
Wait, but just to be thorough, let me make sure there aren't any other formulas that could apply here. For example, Heron's formula requires the lengths of all three sides, but I only have the base and height here. So Heron's formula isn't necessary. Since we have the base and height given directly, using the standard area formula is the way to go.
Also, units: the base is in centimeters, the height is in centimeters, so when multiplying, the area will be in square centimeters. That checks out.
Another thing to consider: is the height corresponding to the given base? The problem states "base 6 cm, height 4 cm," so yes, they correspond. If the height was relative to a different side, it might complicate things, but here it's specified for the base. So no issues there.
I think that's all. The formula is correct, the calculation seems right. 6 times 4 is 24, divided by 2 is 12. So the area is 12 square centimeters.
अंतिम उत्तर:
The area of the triangle is calculated using the formula: Area=1/2×base×height
Substituting the given values: Area=1/2×6 cm ×4 cm = 12 cm²
Result: 12 cm²नीचे दी गई तालिका दिखाती है कि प्रयुक्त टोकनों की संख्या API कॉल की कुल लागत को कैसे प्रभावित करती है:
|
उदाहरण |
प्रयुक्त टोकन |
लागत (USD) |
|
अनऑप्टिमाइज़्ड प्रॉम्प्ट |
1165 |
$0.00255 |
|
ऑप्टिमाइज़्ड प्रॉम्प्ट |
496 |
$0.00109 |
हमने ऑप्टिमाइज़्ड प्रॉम्प्ट के साथ मूल की तुलना में लगभग 57% लागत घटाई, और फिर भी सही उत्तर प्राप्त किया।
टोकन लागत अनुभाग में देखी गई प्राइसिंग तालिका से हम निष्कर्ष निकाल सकते हैं कि कैशिंग deepseek-chat के लिए API लागत में लगभग 74.07% और deepseek-reasoner के लिए 74.55% तक की बचत कराती है, जब नए (अनकैश्ड) इनपुट टोकनों की लागत से तुलना की जाती है। यानी प्रभावी रूप से कैशिंग का उपयोग करके आप इनपुट टोकन लागत लगभग तीन-चौथाई तक घटा सकते हैं।
यह लंबे प्रॉम्प्ट के लिए विशेष रूप से उपयोगी है, क्योंकि यह प्रतीक्षा समय घटाता है। साथ ही, सिस्टम स्वचालित रूप से कैशिंग संभालता है—आपको अपने कोड में बदलाव की आवश्यकता नहीं।
लेकिन कॉन्टेक्स्ट कैशिंग काम कैसे करती है?
जब आप अनुरोध भेजते हैं, तो DeepSeek इनपुट को अपने सर्वरों पर संग्रहीत करता है। यदि आप बाद में मिलते-जुलते अनुरोध भेजते हैं, तो सिस्टम सब कुछ दोबारा गणना करने के बजाय संग्रहीत उत्तर पुनः प्राप्त करता है। इससे प्रक्रिया तेज़ और सस्ती हो जाती है।
निम्न स्थितियों में कैशिंग उपयोगी हो सकती है और लागत घटा सकती है:
लागत बचत को अधिकतम करने के लिए, मेरी सिफारिशें:
DeepSeek की API के साथ अपना कैश उपयोग ट्रैक करने के लिए आपको कोड में बदलाव की ज़रूरत नहीं है। कैश उपयोग की जानकारी API प्रतिक्रिया में स्वतः शामिल होती है। सभी यूज़र्स के लिए कैशिंग सिस्टम डिफ़ॉल्ट रूप से सक्षम है। जब आप API कॉल करते हैं, तो प्रतिक्रिया ऑब्जेक्ट के usage सेक्शन में दो नए फ़ील्ड शामिल होंगे:
prompt_cache_hit_tokens: कैश से परोसे गए इनपुट टोकनों की संख्याprompt_cache_miss_tokens: कैश में न मिलने वाले इनपुट टोकनों की संख्याइस जानकारी तक पहुँचने के लिए, आपको API प्रतिक्रिया में usage फ़ील्ड देखना होगा। यहाँ इन मानों तक पहुँचने का एक उदाहरण है:
response = client.chat.completions.create(
    model="deepseek-chat",
    messages=[
        {"role": "user", "content": "You are a helpful assistant."}
    ]
)

cache_hits = response.usage.prompt_cache_hit_tokens
cache_misses = response.usage.prompt_cache_miss_tokens

print(f"Cache hits: {cache_hits}")
print(f"Cache misses: {cache_misses}")
यह सुविधा आपको अपने उपयोग केस के लिए कैशिंग सिस्टम कैसे काम कर रहा है, यह मॉनिटर करने देती है।
हालाँकि कैशिंग की कुछ सीमाएँ हैं:
अधिक जानने के लिए प्रॉम्प्ट कैशिंग पर यह ब्लॉग पढ़ें।
इस ट्यूटोरियल में, हमने DeepSeek API और इसके दो मॉडल—DeepSeek-R1 और V3—का उपयोग करना सीखा। यदि आप समझते हैं कि ये मॉडल कैसे काम करते हैं, तो आप स्मार्ट और किफायती AI एप्लिकेशन बना सकते हैं।
नवीनतम DeepSeek दस्तावेज़ और सर्वोत्तम प्रथाओं पर नज़र रखें ताकि इन शक्तिशाली मॉडलों का अधिकतम लाभ उठा सकें। एक बार जब आपके पास DeepSeek API कुंजी हो, तो आप इसे DeepSeek के अपने कोडिंग एजेंट की ओर इंगित कर सकते हैं; हमारा DeepSeek Harness ट्यूटोरियल देखें।
हैप्पी कोडिंग!
इन पाठ्यक्रमों के साथ AI सीखें!
कोर्स
कोर्स
कोर्स
