
Last chance! 50% off DataCamp Premium
Sale ends in
Zo krijg je toegang tot de DeepSeek-modellen via de API:
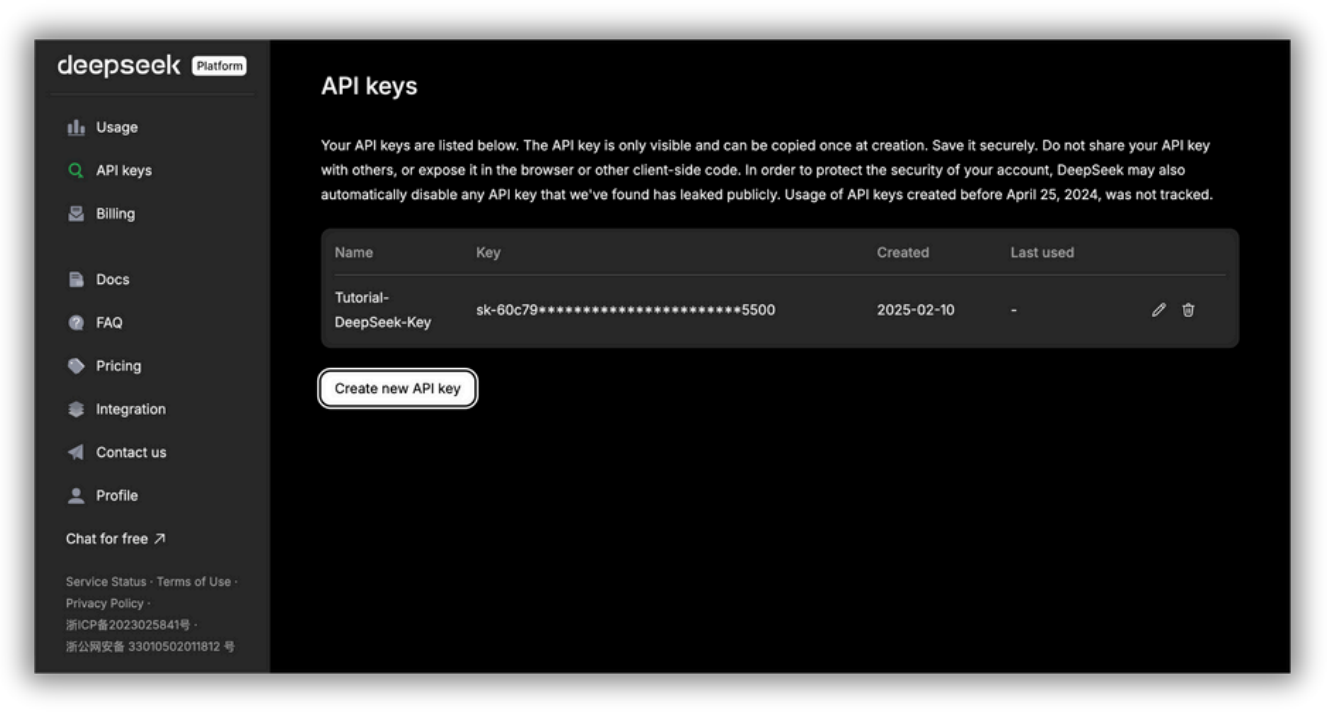
Beheerpagina voor API-sleutels op het DeepSeek API-platform. Hier kun je API-sleutels genereren en beheren om toegang te krijgen tot de AI-diensten van DeepSeek. De API-sleutel is alleen zichtbaar bij aanmaak en moet veilig worden opgeslagen; het publiek delen kan tot veiligheidsrisico's leiden.
Voor DeepSeek-V3 stel je model='deepseek-chat' in en voor DeepSeek-R1 stel je model='deepseek-reasoner' in.
Zo gebruik je de OpenAI SDK om toegang te krijgen tot de DeepSeek API:
from openai import OpenAI
client = OpenAI(api_key="<DeepSeek API Key>", base_url="https://api.deepseek.com")
response = client.chat.completions.create(
    model="deepseek-chat",
    messages=[
        {"role": "system", "content": "You are a helpful assistant"},
        {"role": "user", "content": "Hello"},
    ],
    stream=False
)
print(response.choices[0].message.content)
Laten we van dichterbij kijken wat dit codefragment doet.
Het doel van de code is om een chatbericht naar het DeepSeek-model te sturen en de reactie van het model af te drukken.
Eerst importeert from openai import OpenAI de OpenAI-klasse uit de openai-bibliotheek.
Daarna client = OpenAI(...) maakt een OpenAI-clientobject aan. Deze client is jouw verbinding met de DeepSeek API. Hij configureert de client met je API-sleutel (authenticatie) en geeft de basis-URL van de DeepSeek API op.
Belangrijk: vervang <DeepSeek API Key> door je echte DeepSeek API-sleutel!
De response is het deel dat je chatbericht naar het DeepSeek-model stuurt en de reactie ophaalt. client.chat.completions.create(...) roept de DeepSeek API aan om een antwoord van het model te krijgen.
Laten we kijken naar messages=[...], het deel dat de gespreksgeschiedenis definieert:
Let op: in dit voorbeeld gebruiken we DeepSeek-V3 omdat we model='deepseek-chat’ hebben ingesteld, maar je kunt DeepSeek-R1 gebruiken door model='deepseek-reasoner' te kiezen.
Het deel stream=False betekent: "Geef me het hele antwoord in één keer." Kortom, als je stream=False instelt, wacht het model tot de volledige reactie is gegenereerd voordat die teruggestuurd wordt. Gebruik dit als je de volledige reactie in één keer wilt tonen of analyseren.
Je moet echter mogelijk even wachten op lange antwoorden voordat je output krijgt. Als je stream=True instelt, laat het model woorden (nou ja, tokens) zien terwijl ze worden gegenereerd, zodat je de reactie in realtime ziet in plaats van te wachten op het volledige antwoord.
Tot slot haalt print(response.choices.message.content) de reactie van het model uit het response-object en drukt die af in je console. Het response-object bevat veel informatie, maar je bent vooral geïnteresseerd in het bericht van het model. De API kan soms meerdere mogelijke antwoorden (choices) teruggeven. Dit selecteert de eerste.
Op het moment van publicatie van dit artikel heeft DeepSeek het toevoegen van nieuwe tegoeden aan API-accounts gepauzeerd omdat hun servers weinig middelen hebben. Dat betekent dat je nu geen geld kunt toevoegen aan je API-saldo. Als je al tegoeden hebt, kun je de API nog normaal gebruiken. Waarschijnlijk hervat DeepSeek het opwaarderen zodra er meer servercapaciteit is, dus houd updates in de gaten!
Het DeepSeek-team claimt dat hun modellen goedkoper zijn dan de concurrentie. Maar je moet ze nog steeds verstandig gebruiken om kosten laag te houden en de beste prestaties te krijgen. Dit zijn de belangrijkste zaken om te weten en mee te nemen wanneer je DeepSeek-modellen gebruikt om de output en prijs te sturen.
Elk DeepSeek-model is ontworpen voor andere taken. De juiste keuze helpt je kosten en prestaties te balanceren op basis van je behoeften. Hier is een snelle vergelijking:
Tokens zijn de kleinste tekeneenheid die het model verwerkt; dat kan een woord, getal of zelfs leesteken zijn. Het aantal gebruikte tokens hangt af van de taal en de manier waarop het model tekst verwerkt.
Hier is een algemene vergelijking van hoe tekens naar tokens omzetten:
Voor een nauwkeurige schatting kun je het beste de gebruiksdetails controleren nadat je je request hebt uitgevoerd. Als je begrijpt hoe tokens worden geteld, kun je kosten beter beheren en prestaties optimaliseren bij gebruik van DeepSeek-modellen.
Hier zijn de prijzen per 1 miljoen tokens voor elk van de DeepSeek-modellen (let op: dit waren de prijzen ten tijde van publicatie van dit artikel—controleer de meest recente kosten hier):
|
Model |
Contextlengte |
Max. CoT-tokens |
Max. outputtokens |
Prijs 1 mln tokens input (cache hit) |
Prijs 1 mln tokens input (cache miss) |
Prijs 1 mln tokens output |
|
deepseek-chat |
64k |
- |
8k |
$0.07 |
$0.27 |
$1.10 |
|
deepseek-reasoner |
64k |
32k |
8k |
$0.14 |
$0.55 |
$2.19 |
Zoals eerder vermeld biedt DeepSeek twee modellen: deepseek-chat en deepseek-reasoner. Maar elk heeft andere sterke punten en kosten. Als je weet hoe ze informatie verwerken en tokens in rekening brengen, kun je ze efficiënter gebruiken en de kosten onder controle houden.
Beide modellen kunnen tot 64.000 tokens in een gesprek aan, wat betekent dat ze meer context onthouden voor betere, relevantere reacties. Ze werken echter verschillend.
Deepseek-chat is ontworpen voor algemene gesprekken en gebruikt geen geavanceerd redeneren. Deepseek-reasoner daarentegen staat tot 32.000 tokens toe voor stap-voor-stap-denken (chain-of-thought-redenering—daarover zo meer) voordat er een eindantwoord komt. Dit is geweldig voor complexe problemen, maar verhoogt ook het aantal gebruikte tokens, en dus de kosten.
Wat betreft de lengte van de reactie: beide modellen kunnen tot 8.000 tokens per antwoord genereren. Deze limiet helpt voorkomen dat reacties te lang en te duur worden.
Kijkend naar de prijs is deepseek-chat de budgetvriendelijkere optie. Als de invoer is gecachet (dus eerder is gebruikt), kost het $0,07 per miljoen tokens. Voor nieuwe invoer stijgt de prijs naar $0,27 per miljoen tokens en de output kost $1,10 per miljoen tokens.
Deepseek-reasoner is duurder omdat het dieper redeneert. Gecachete invoer kost $0,14 per miljoen tokens, terwijl nieuwe invoer $0,55 per miljoen tokens kost. De output is ook duurder met $2,19 per miljoen tokens, wat de complexiteit van de gegenereerde antwoorden weerspiegelt.
Welk model moet je dus gebruiken?
Heb je simpele chatreacties of snelle antwoorden nodig, dan is deepseek-chat de betere keuze omdat het goedkoper is. Maar als je gedetailleerd redeneren of complex probleemoplossen nodig hebt, is deepseek-reasoner krachtiger—al kost het meer.
Om geld te besparen kun je ook caching gebruiken. Wanneer het model invoer herkent die het eerder heeft gezien, wordt een lager tarief gerekend. Dit is erg nuttig voor herhaalde queries of gesprekken met meerdere beurten.
DeepSeek-modellen zijn scherp geprijsd, maar tokengebruik kan snel oplopen. De beste manier om kosten te beheersen is prompts kort houden, caching gebruiken wanneer mogelijk, en het juiste model voor de taak kiezen. Lees voor meer info deze blog over promptoptimalisatie.
De temperature-parameter bepaalt hoe willekeurig of voorspelbaar de reacties van het model zijn. In DeepSeek staat die standaard op 1,0, wat betekent dat reacties balanceren tussen creatief en deterministisch. Je kunt deze instelling echter aanpassen aan je specifieke behoeften.
DeepSeek geeft de volgende aanbevelingen voor verschillende use-cases:
|
Use-case |
Aanbevolen temperature |
|
Coderen / Wiskunde |
0,0 (Deterministisch, precies) |
|
Opschonen / Data-analyse |
1,0 (Gebalanceerde reacties) |
|
Algemeen gesprek |
1,3 (Meer variatie in reacties) |
|
Vertaling |
1,3 (Laat flexibiliteit in formulering toe) |
|
Creatief schrijven / Poëzie |
1,5 (Stimuleert diverse, verbeeldingsrijke output) |
Een lage temperature (dicht bij 0,0) maakt het model voorspelbaarder en preciezer. Dit is ideaal voor taken die nauwkeurigheid vereisen, zoals coderen, wiskunde en gestructureerde data-analyse.
Een hogere temperature (boven 1,0) maakt het model creatiever en gevarieerder, geschikt voor verhalen, poëzie en vertalingen waar flexibiliteit nodig is.
Voor algemene gesprekken helpt een temperature rond 1,3 om natuurlijke en boeiende dialogen te produceren zonder te repetitief of te willekeurig te zijn.
Hoewel de temperature-instelling zelf de kosten niet direct beïnvloedt, kan die indirect het aantal outputtokens verhogen:
Wanneer je met de API van DeepSeek werkt, kun je het formaat van de reacties sturen door de parameter response_format op te geven. Dit is vooral handig bij gestructureerde data, omdat het zorgt voor consistentie en leesbaarheid in de output van het model.
Om reacties in JSON-formaat te ontvangen, stel je in:
response_format={'type': 'json_object'}Dit vertelt het model om gestructureerde output terug te geven, waardoor programmatische verwerking eenvoudiger wordt. JSON is een gangbaar formaat voor gestructureerde, machineleesbare reacties, zoals bij data-extractie, automatisering en API-integraties.
Hoewel JSON-formattering de prijs niet direct beïnvloedt, kan het in sommige gevallen indirect de kosten verlagen.
CoT is het redeneerproces dat DeepSeek-R1 doorloopt voordat het een eindantwoord geeft. Dit betekent dat het model zijn denkproces stap voor stap uitlegt voordat het tot een conclusie komt.
Elke token die in de CoT-redenering en het eindantwoord wordt gebruikt, wordt in rekening gebracht tegen $2,19 per miljoen tokens, omdat die tot de output behoren. Het is een afweging; meer CoT-tokens = meer kosten maar ook meer nauwkeurigheid bij complexe taken.
Wat kun je doen om kosten te beheersen terwijl je CoT gebruikt?
Om te laten zien hoe Chain-of-Thought (CoT) output werkt in DeepSeek-R1 en wat de impact op de prijs is, bekijken we een voorbeeld:
from openai import OpenAI

client = OpenAI(
    api_key="<Your_DeepSeek_API_Key>",
    base_url="https://api.deepseek.com"
)

def generate_response(prompt):
    response = client.chat.completions.create(
        model="deepseek-reasoner",
        messages=[
            {"role": "system", "content": "You are a helpful assistant."},
            {"role": "user", "content": prompt}
        ],
        stream=False
    )
    return response.choices[0].message.content

# Example usage
prompt = "Calculate the area of a triangle with a base of 6 cm and a height of 4 cm."
result = generate_response(prompt)
print(result)
CoT:
Okay, so I need to find the area of a triangle with a base of 6 cm and a height of 4 cm. Hmm, let me remember how to do this. I think the formula for the area of a triangle is something like base multiplied by height divided by two. Wait, is that right? Let me think.
When I was in math class, the teacher mentioned that a triangle is basically half of a parallelogram. So if you have a parallelogram, its area is base times height. If you cut it along the diagonal, you get two triangles. That means each triangle would have half the area of the parallelogram. So yes, the formula should be (base × height) / 2. That makes sense. Let me write that down to visualize it better.
Area = (base × height) / 2
Given the base is 6 cm and the height is 4 cm, I can substitute those values into the formula. Let me plug them in step by step.
First, multiply the base and the height: 6 cm × 4 cm. Let me calculate that. 6 times 4 is 24. So that gives me 24 cm². Now, divide that result by 2. So 24 divided by 2 is 12. Therefore, the area should be 12 cm².
Wait, let me verify that. If the base was 6 and the height 4, multiplying them gives the area of the corresponding parallelogram, which would be 24 cm². Then, since the triangle is half of that, dividing by 2 gives 12 cm². Yes, that seems correct.
Is there another way to check this? Maybe using a different method? Let's see. For a triangle, the area can also be calculated using Heron's formula, but that requires knowing all three sides. Since I only have the base and height, that might not apply here. Alternatively, if it's a right-angled triangle, the area would be (1/2)*base*height, which is the same formula. But even if it's not a right-angled triangle, the formula still applies because the height is given. The height is the perpendicular distance from the base to the opposite vertex, so regardless of the triangle's type, as long as we know the base and the corresponding height, the formula works.
Let me draw a mental picture. Imagine a triangle where the base is 6 cm. The height is 4 cm, which means if I were to drop a perpendicular line from the top vertex to the base, that line would measure 4 cm. So, even if the triangle is slanted, that vertical height is still 4 cm. Multiplying base and height gives the area of the parallelogram, so dividing by two gives the triangle's area.
Another way to think about it: If I have two identical triangles, I can put them together to form a parallelogram. The area of that parallelogram is base times height, so each triangle is half of that. Therefore, the area of one triangle is 1/2 * base * height.
So, plugging the numbers in again: 1/2 * 6 cm * 4 cm. 1/2 of 6 is 3, and 3 times 4 is 12. Yep, 12 cm².
I think that's solid. Let me check with an example. Suppose the base was 2 cm and the height 3 cm. Then the area would be (2*3)/2 = 3 cm². If I draw such a triangle, it should have an area of 3 cm², which seems right. So scaling up, with a base of 6 and height of 4, the area is proportionally larger.
Alternatively, if I consider a rectangle with the same base and height, area would be 6*4=24 cm². The triangle is half of that, so 12 cm². That also checks out.
Wait, but hold on. If the triangle isn't a right triangle, does the formula still hold? Let's think. If I have an obtuse triangle where the height is outside the triangle, does that affect the area? For example, suppose the base is 6 cm, but the height is measured from the base to a vertex that's outside the triangle, making an obtuse triangle. Even in that case, the area is still (base*height)/2. Because the height is the perpendicular distance regardless of where it's located. So even if the triangle is obtuse, the formula remains the same. Therefore, regardless of the triangle type, as long as the height is given, the formula applies.
Therefore, using 6 cm and 4 cm, multiplying them, dividing by two, gives 12 cm². That seems to be the correct answer. I can't see any mistakes in the reasoning.
Let me just recap. The formula for the area of a triangle is 1/2 multiplied by base multiplied by height. Given base = 6 cm, height = 4 cm. Plugging into the formula: 1/2 * 6 * 4 = 12. The units are in centimeters, and since area is in square units, the answer is 12 cm².
Yes, that all lines up. I think I've got it right. The area is 12 square centimeters.
Eindantwoord:
The area of the triangle is 12 cm².
To calculate the area of a triangle with a base of 6 cm and a height of 4 cm, we use the standard formula:
Area=1/2×base×height
Step-by-Step Calculation
Multiply the base and height: 6 cm×4 cm=24 cm²Divide the result by 2: 24 cm²/ 2=12 cm²Final Answer: 12 cm²
Thus, the area of the triangle is 12 cm².Laten we nu de prompt verfijnen en kijken hoe de output verandert:
Prompt: "Oppervlakte driehoek: basis 6 cm, hoogte 4 cm. Toon alleen formule en resultaat"
CoT:
Okay, so I need to find the area of a triangle with a base of 6 cm and a height of 4 cm. Hmm, let me remember the formula for the area of a triangle. I think it's something like base multiplied by height divided by two. Wait, yeah, right, because a triangle is basically half of a parallelogram, right? So if you have a parallelogram, the area is base times height, and then a triangle would be half of that. So the formula should be (base * height) / 2.
Let me double-check that. Maybe I can visualize a triangle with base 6 and height 4. If I had another identical triangle, I could put them together to form a parallelogram. The base would still be 6, the height would still be 4, so the area of the parallelogram would be 6*4=24. Then the area of one triangle would be half of that, which is 12. So that makes sense.
Alternatively, I remember in school they taught us the formula as A = 1/2 * b * h. So plugging in the values, it should be 1/2 * 6 cm * 4 cm. Let me calculate that. 1/2 of 6 is 3, then 3 times 4 is 12. So the area should be 12 cm².
Wait, but just to be thorough, let me make sure there aren't any other formulas that could apply here. For example, Heron's formula requires the lengths of all three sides, but I only have the base and height here. So Heron's formula isn't necessary. Since we have the base and height given directly, using the standard area formula is the way to go.
Also, units: the base is in centimeters, the height is in centimeters, so when multiplying, the area will be in square centimeters. That checks out.
Another thing to consider: is the height corresponding to the given base? The problem states "base 6 cm, height 4 cm," so yes, they correspond. If the height was relative to a different side, it might complicate things, but here it's specified for the base. So no issues there.
I think that's all. The formula is correct, the calculation seems right. 6 times 4 is 24, divided by 2 is 12. So the area is 12 square centimeters.
Eindantwoord:
The area of the triangle is calculated using the formula: Area=1/2×base×height
Substituting the given values: Area=1/2×6 cm ×4 cm = 12 cm²
Result: 12 cm²De onderstaande tabel laat zien hoe het aantal gebruikte tokens de totale kosten van een API-call beïnvloedt:
|
Voorbeeld |
Gebruikte tokens |
Kosten (USD) |
|
Niet-geoptimaliseerde prompt |
1165 |
$0.00255 |
|
Geoptimaliseerde prompt |
496 |
$0.00109 |
We hebben de kosten met ongeveer 57% verlaagd ten opzichte van het origineel met de geoptimaliseerde prompt, terwijl we nog steeds het juiste antwoord krijgen.
Uit de prijzentabel die we in de sectie Tokencosts hebben gezien, kunnen we concluderen dat caching ons ongeveer 74,07% aan API-kosten bespaart voor deepseek-chat en 74,55% voor deepseek-reasoner, vergeleken met de kosten voor het verwerken van nieuwe (niet-gecachte) inputtokens. Dit betekent dat effectief gebruik van caching de kosten van inputtokens bijna kan driekwart verminderen.
Het is vooral nuttig voor lange prompts, omdat het wachttijd vermindert. Bovendien handelt het systeem caching automatisch af—je hoeft je code niet aan te passen.
Maar hoe werkt contextcaching?
Wanneer je een request verstuurt, slaat DeepSeek de invoer op zijn servers op. Als je later een vergelijkbaar request stuurt, haalt het systeem de opgeslagen reactie op in plaats van alles opnieuw te berekenen. Hierdoor gaat het sneller en is het goedkoper.
Caching kan nuttig zijn en kosten verlagen in de volgende situaties:
Om maximaal te besparen, raad ik het volgende aan:
Om je cachegebruik te volgen met de API van DeepSeek hoef je je code niet aan te passen. De cache-informatie is automatisch opgenomen in het API-antwoord. Het cachesysteem is standaard ingeschakeld voor alle gebruikers. Wanneer je een API-call doet, bevat het response-object twee nieuwe velden in de sectie usage:
prompt_cache_hit_tokens: Aantal inputtokens dat uit de cache is bediendprompt_cache_miss_tokens: Aantal inputtokens dat niet in de cache is gevondenOm deze informatie te bekijken, moet je het veld usage in het API-antwoord controleren. Hier is een voorbeeld van hoe je deze waarden kunt uitlezen in:
response = client.chat.completions.create(
    model="deepseek-chat",
    messages=[
        {"role": "user", "content": "You are a helpful assistant."}
    ]
)

cache_hits = response.usage.prompt_cache_hit_tokens
cache_misses = response.usage.prompt_cache_miss_tokens

print(f"Cache hits: {cache_hits}")
print(f"Cache misses: {cache_misses}")
Met deze functie kun je monitoren hoe het cachesysteem voor jouw use-case werkt.
Caching heeft wel wat beperkingen:
Lees voor meer informatie deze blog over promptcaching.
In deze tutorial hebben we geleerd hoe je de DeepSeek API en de twee modellen, DeepSeek-R1 en V3, gebruikt. Als je begrijpt hoe deze modellen werken, kun je slimme, kostenefficiënte AI-toepassingen bouwen.
Houd de laatste DeepSeek-documentatie en best practices in de gaten om het meeste uit deze krachtige modellen te halen. Zodra je een DeepSeek API-sleutel hebt, kun je die richten op DeepSeek's eigen coding agent; bekijk onze DeepSeek Harness-tutorial.
Veel codeerplezier!
Leer AI met deze cursussen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min


