Khóa học
Làm việc với OpenAI API
3 giờ
184.5K
Để truy cập các mô hình DeepSeek qua API:
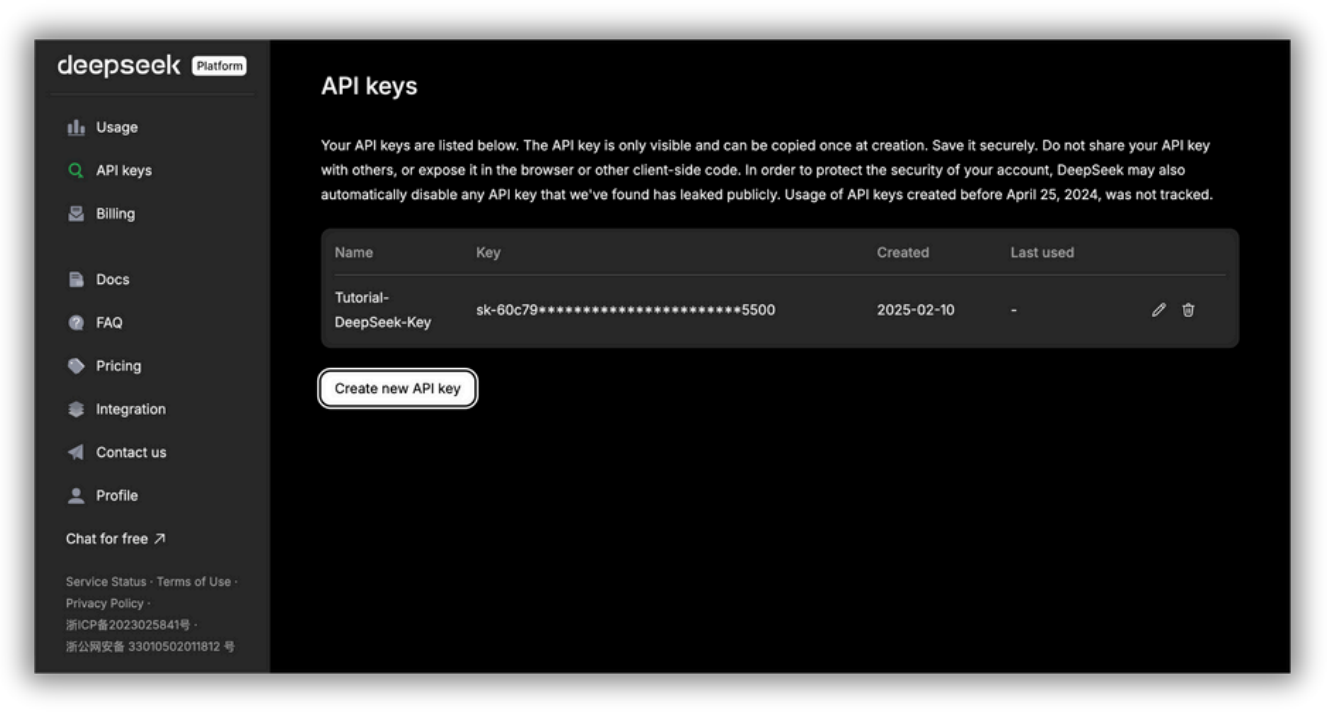
Trang quản lý khóa API trên nền tảng DeepSeek API. Tại đây bạn có thể tạo và quản lý khóa API để truy cập các dịch vụ AI của DeepSeek. Khóa API chỉ hiển thị khi tạo và phải được lưu trữ an toàn; chia sẻ công khai có thể gây rủi ro bảo mật.
Để dùng DeepSeek-V3 bạn cần đặt model='deepseek-chat' và để dùng DeepSeek-R1 bạn cần đặt model='deepseek-reasoner'.
Dưới đây là cách bạn có thể dùng OpenAI SDK để truy cập DeepSeek API:
from openai import OpenAI
client = OpenAI(api_key="<DeepSeek API Key>", base_url="https://api.deepseek.com")
response = client.chat.completions.create(
    model="deepseek-chat",
    messages=[
        {"role": "system", "content": "You are a helpful assistant"},
        {"role": "user", "content": "Hello"},
    ],
    stream=False
)
print(response.choices[0].message.content)
Hãy xem kỹ hơn đoạn mã này làm gì.
Mục tiêu của mã là gửi một tin nhắn chat tới mô hình DeepSeek và in phản hồi của mô hình.
Đầu tiên, from openai import OpenAI nhập lớp OpenAI từ thư viện openai.
Tiếp theo, client = OpenAI(...) tạo một đối tượng khách hàng OpenAI. Client này là kết nối của bạn tới DeepSeek API. Nó cấu hình client với khóa API của bạn (xác thực) và chỉ định base URL của DeepSeek API.
Quan trọng: Hãy thay <DeepSeek API Key> bằng khóa API DeepSeek thực tế của bạn!
Phần response là nơi gửi tin nhắn chat của bạn tới mô hình DeepSeek và nhận phản hồi. client.chat.completions.create(...) là lời gọi tới DeepSeek API để lấy phản hồi từ mô hình.
Xem phần messages=[...], đây là phần định nghĩa lịch sử hội thoại:
Lưu ý trong ví dụ này chúng ta dùng DeepSeek-V3 vì đã đặt model='deepseek-chat’, nhưng nhớ rằng bạn có thể dùng DeepSeek-R1 bằng cách đặt model='deepseek-reasoner'.
Phần stream=False có nghĩa là "Trả về toàn bộ câu trả lời một lần". Tức là khi đặt stream=False, mô hình sẽ đợi tạo xong toàn bộ phản hồi rồi mới gửi lại. Dùng tùy chọn này nếu bạn muốn hiển thị hoặc phân tích trọn vẹn phản hồi cùng lúc.
Tuy nhiên, bạn có thể phải chờ lâu hơn với các câu trả lời dài trước khi nhận được kết quả. Nếu đặt stream=True, mô hình sẽ hiển thị từng từ (thực ra là token) ngay khi được sinh ra, vì vậy bạn thấy phản hồi theo thời gian thực thay vì chờ toàn bộ câu trả lời.
Cuối cùng, print(response.choices.message.content) trích xuất phản hồi của mô hình từ đối tượng phản hồi và in ra console. Đối tượng phản hồi chứa khá nhiều thông tin, nhưng phần bạn quan tâm chủ yếu là thông điệp của mô hình. API đôi khi có thể trả về nhiều phương án (choices). Dòng này chọn phương án đầu tiên.
Tại thời điểm xuất bản bài viết này, DeepSeek đang tạm dừng nạp thêm tiền vào tài khoản API do máy chủ thiếu tài nguyên. Điều đó có nghĩa là hiện bạn không thể nạp thêm tiền vào số dư API. Nếu bạn đã có sẵn tiền, bạn vẫn có thể dùng API như bình thường. DeepSeek có thể sẽ mở lại việc nạp tiền khi có thêm năng lực máy chủ, vì vậy hãy theo dõi các cập nhật!
Đội ngũ DeepSeek cho rằng các mô hình của họ rẻ hơn so với đối thủ. Nhưng bạn vẫn cần dùng một cách khôn ngoan để giữ chi phí thấp và đạt hiệu năng tốt nhất. Dưới đây là những điểm chính cần biết và cân nhắc khi dùng các mô hình của DeepSeek để kiểm soát đầu ra và chi phí.
Mỗi mô hình DeepSeek được thiết kế cho các tác vụ khác nhau. Chọn đúng mô hình giúp bạn cân bằng chi phí và hiệu năng theo nhu cầu. So sánh nhanh:
Token là đơn vị nhỏ nhất của văn bản mà mô hình xử lý, có thể là một từ, con số hoặc dấu câu. Số lượng token sử dụng phụ thuộc vào ngôn ngữ và cách mô hình xử lý văn bản.
Dưới đây là so sánh tổng quát về cách ký tự chuyển đổi thành token:
Để ước tính chính xác, tốt nhất là kiểm tra chi tiết sử dụng sau khi chạy yêu cầu. Hiểu cách đếm token sẽ giúp bạn quản lý chi phí và tối ưu hiệu năng khi dùng các mô hình của DeepSeek.
Dưới đây là mức giá cho mỗi 1 triệu token của từng mô hình DeepSeek (lưu ý: đây là giá tại thời điểm xuất bản bài viết—hãy kiểm tra chi phí mới nhất tại đây):
|
Mô hình |
Độ dài ngữ cảnh |
Tối đa token CoT |
Tối đa token đầu ra |
Giá input/1 triệu token (cache hit) |
Giá input/1 triệu token (cache miss) |
Giá output/1 triệu token |
|
deepseek-chat |
64k |
- |
8k |
$0.07 |
$0.27 |
$1.10 |
|
deepseek-reasoner |
64k |
32k |
8k |
$0.14 |
$0.55 |
$2.19 |
Như đã đề cập, DeepSeek cung cấp hai mô hình, deepseek-chat và deepseek-reasoner. Nhưng mỗi mô hình có thế mạnh và chi phí khác nhau. Biết được cách chúng xử lý thông tin và tính phí theo token sẽ giúp bạn sử dụng hiệu quả hơn và kiểm soát chi phí.
Cả hai mô hình có thể xử lý tối đa 64.000 token trong một cuộc hội thoại, tức là chúng nhớ được nhiều ngữ cảnh hơn để phản hồi phù hợp hơn. Tuy nhiên, cách hoạt động khác nhau.
Deepseek-chat được thiết kế cho hội thoại chung và không dùng suy luận nâng cao. Ngược lại, deepseek-reasoner cho phép tới 32.000 token cho suy nghĩ từng bước (suy luận chain-of-thought—sẽ nói kỹ hơn bên dưới) trước khi đưa ra câu trả lời cuối. Điều này giúp giải bài toán phức tạp tốt hơn nhưng cũng làm tăng số token sử dụng, đồng nghĩa chi phí cao hơn.
Về độ dài phản hồi, cả hai mô hình có thể sinh tối đa 8.000 token mỗi lần. Giới hạn này giúp tránh phản hồi quá dài và tốn kém.
Xét về giá, deepseek-chat thân thiện với ngân sách hơn. Nếu input được cache (tức đã dùng trước đó), chi phí là $0,07 mỗi triệu token. Với input mới, giá là $0,27 mỗi triệu token, và output là $1,10 mỗi triệu token.
Deepseek-reasoner đắt hơn vì cung cấp suy luận sâu hơn. Input đã cache tốn $0,14 mỗi triệu token, còn input mới là $0,55 mỗi triệu token. Output cũng đắt hơn ở mức $2,19 mỗi triệu token, phản ánh độ phức tạp của phản hồi tạo ra.
Vậy bạn nên dùng mô hình nào?
Nếu bạn cần câu trả lời đơn giản hoặc nhanh, deepseek-chat là lựa chọn tốt hơn vì rẻ hơn. Nhưng nếu cần suy luận chi tiết hoặc giải quyết vấn đề phức tạp, deepseek-reasoner mạnh mẽ hơn—dù tốn kém hơn.
Để tiết kiệm, bạn cũng có thể dùng cache. Khi mô hình nhận ra input đã thấy trước đó, nó tính phí thấp hơn. Điều này hữu ích với truy vấn lặp lại hoặc hội thoại nhiều lượt.
Các mô hình DeepSeek có mức giá cạnh tranh, nhưng số token dùng có thể tăng nhanh. Cách tốt nhất để quản lý chi phí là giữ prompt ngắn, dùng cache khi có thể, và chọn đúng mô hình cho công việc. Để tìm hiểu thêm, hãy đọc bài về tối ưu prompt.
Tham số temperature kiểm soát mức độ ngẫu nhiên hay dự đoán được của phản hồi mô hình. Mặc định trong DeepSeek là 1.0, nghĩa là cân bằng giữa sáng tạo và quyết định. Tuy nhiên, bạn có thể điều chỉnh theo nhu cầu cụ thể.
DeepSeek đưa ra các khuyến nghị sau cho những trường hợp sử dụng khác nhau:
|
Trường hợp sử dụng |
Nhiệt độ khuyến nghị |
|
Lập trình / Toán |
0.0 (Quyết định, chính xác) |
|
Làm sạch dữ liệu / Phân tích dữ liệu |
1.0 (Phản hồi cân bằng) |
|
Hội thoại chung |
1.3 (Đa dạng phản hồi hơn) |
|
Dịch thuật |
1.3 (Cho phép linh hoạt về từ ngữ) |
|
Viết sáng tạo / Thơ |
1.5 (Khuyến khích đầu ra đa dạng, giàu tưởng tượng) |
Temperature thấp (gần 0.0) làm mô hình dự đoán hơn và chính xác hơn. Phù hợp cho các tác vụ yêu cầu câu trả lời chuẩn xác như lập trình, toán học và phân tích dữ liệu có cấu trúc.
Temperature cao (trên 1.0) làm mô hình sáng tạo và đa dạng hơn, phù hợp cho kể chuyện, thơ ca, và dịch thuật khi cần linh hoạt.
Với hội thoại chung, temperature khoảng 1.3 giúp tạo đối thoại tự nhiên, lôi cuốn mà không quá lặp lại hay quá ngẫu nhiên.
Bản thân cài đặt temperature không ảnh hưởng trực tiếp đến chi phí, nhưng có thể gián tiếp làm tăng số token đầu ra:
Khi tương tác với API của DeepSeek, bạn có thể kiểm soát định dạng phản hồi bằng cách chỉ định tham số response_format. Điều này đặc biệt hữu ích khi làm việc với dữ liệu có cấu trúc, giúp đảm bảo tính nhất quán và dễ đọc trong đầu ra của mô hình.
Để nhận phản hồi ở định dạng JSON, hãy đặt:
response_format={'type': 'json_object'}Điều này báo cho mô hình trả về đầu ra có cấu trúc, giúp dễ xử lý thông tin bằng lập trình. JSON thường dùng trong các ứng dụng cần phản hồi có cấu trúc, máy có thể đọc như trích xuất dữ liệu, tự động hóa và tích hợp API.
Dù định dạng JSON không tác động trực tiếp đến giá, nhưng có thể gián tiếp giảm chi phí trong một số trường hợp.
CoT là quá trình suy luận mà DeepSeek-R1 thực hiện trước khi đưa ra câu trả lời cuối cùng. Điều này nghĩa là mô hình giải thích quá trình suy nghĩ theo từng bước trước khi kết luận.
Mỗi token dùng trong suy luận CoT và câu trả lời cuối đều được tính phí $2,19 mỗi triệu token, vì đều là một phần của đầu ra. Đây là sự đánh đổi: nhiều token CoT = chi phí cao hơn nhưng cũng chính xác hơn trong các tác vụ phức tạp.
Bạn có thể làm gì để kiểm soát chi phí khi dùng CoT?
Để minh họa cách đầu ra Chain-of-Thought (CoT) hoạt động trong DeepSeek-R1 và tác động đến giá, hãy xét ví dụ sau:
from openai import OpenAI

client = OpenAI(
    api_key="<Your_DeepSeek_API_Key>",
    base_url="https://api.deepseek.com"
)

def generate_response(prompt):
    response = client.chat.completions.create(
        model="deepseek-reasoner",
        messages=[
            {"role": "system", "content": "You are a helpful assistant."},
            {"role": "user", "content": prompt}
        ],
        stream=False
    )
    return response.choices[0].message.content

# Example usage
prompt = "Calculate the area of a triangle with a base of 6 cm and a height of 4 cm."
result = generate_response(prompt)
print(result)
CoT:
Okay, so I need to find the area of a triangle with a base of 6 cm and a height of 4 cm. Hmm, let me remember how to do this. I think the formula for the area of a triangle is something like base multiplied by height divided by two. Wait, is that right? Let me think.
When I was in math class, the teacher mentioned that a triangle is basically half of a parallelogram. So if you have a parallelogram, its area is base times height. If you cut it along the diagonal, you get two triangles. That means each triangle would have half the area of the parallelogram. So yes, the formula should be (base × height) / 2. That makes sense. Let me write that down to visualize it better.
Area = (base × height) / 2
Given the base is 6 cm and the height is 4 cm, I can substitute those values into the formula. Let me plug them in step by step.
First, multiply the base and the height: 6 cm × 4 cm. Let me calculate that. 6 times 4 is 24. So that gives me 24 cm². Now, divide that result by 2. So 24 divided by 2 is 12. Therefore, the area should be 12 cm².
Wait, let me verify that. If the base was 6 and the height 4, multiplying them gives the area of the corresponding parallelogram, which would be 24 cm². Then, since the triangle is half of that, dividing by 2 gives 12 cm². Yes, that seems correct.
Is there another way to check this? Maybe using a different method? Let's see. For a triangle, the area can also be calculated using Heron's formula, but that requires knowing all three sides. Since I only have the base and height, that might not apply here. Alternatively, if it's a right-angled triangle, the area would be (1/2)*base*height, which is the same formula. But even if it's not a right-angled triangle, the formula still applies because the height is given. The height is the perpendicular distance from the base to the opposite vertex, so regardless of the triangle's type, as long as we know the base and the corresponding height, the formula works.
Let me draw a mental picture. Imagine a triangle where the base is 6 cm. The height is 4 cm, which means if I were to drop a perpendicular line from the top vertex to the base, that line would measure 4 cm. So, even if the triangle is slanted, that vertical height is still 4 cm. Multiplying base and height gives the area of the parallelogram, so dividing by two gives the triangle's area.
Another way to think about it: If I have two identical triangles, I can put them together to form a parallelogram. The area of that parallelogram is base times height, so each triangle is half of that. Therefore, the area of one triangle is 1/2 * base * height.
So, plugging the numbers in again: 1/2 * 6 cm * 4 cm. 1/2 of 6 is 3, and 3 times 4 is 12. Yep, 12 cm².
I think that's solid. Let me check with an example. Suppose the base was 2 cm and the height 3 cm. Then the area would be (2*3)/2 = 3 cm². If I draw such a triangle, it should have an area of 3 cm², which seems right. So scaling up, with a base of 6 and height of 4, the area is proportionally larger.
Alternatively, if I consider a rectangle with the same base and height, area would be 6*4=24 cm². The triangle is half of that, so 12 cm². That also checks out.
Wait, but hold on. If the triangle isn't a right triangle, does the formula still hold? Let's think. If I have an obtuse triangle where the height is outside the triangle, does that affect the area? For example, suppose the base is 6 cm, but the height is measured from the base to a vertex that's outside the triangle, making an obtuse triangle. Even in that case, the area is still (base*height)/2. Because the height is the perpendicular distance regardless of where it's located. So even if the triangle is obtuse, the formula remains the same. Therefore, regardless of the triangle type, as long as the height is given, the formula applies.
Therefore, using 6 cm and 4 cm, multiplying them, dividing by two, gives 12 cm². That seems to be the correct answer. I can't see any mistakes in the reasoning.
Let me just recap. The formula for the area of a triangle is 1/2 multiplied by base multiplied by height. Given base = 6 cm, height = 4 cm. Plugging into the formula: 1/2 * 6 * 4 = 12. The units are in centimeters, and since area is in square units, the answer is 12 cm².
Yes, that all lines up. I think I've got it right. The area is 12 square centimeters.
Câu trả lời cuối:
The area of the triangle is 12 cm².
To calculate the area of a triangle with a base of 6 cm and a height of 4 cm, we use the standard formula:
Area=1/2×base×height
Step-by-Step Calculation
Multiply the base and height: 6 cm×4 cm=24 cm²Divide the result by 2: 24 cm²/ 2=12 cm²Final Answer: 12 cm²
Thus, the area of the triangle is 12 cm².Giờ hãy tinh chỉnh prompt và xem đầu ra thay đổi thế nào:
Prompt: "Diện tích tam giác: đáy 6cm, chiều cao 4cm. Chỉ hiển thị công thức và kết quả"
CoT:
Okay, so I need to find the area of a triangle with a base of 6 cm and a height of 4 cm. Hmm, let me remember the formula for the area of a triangle. I think it's something like base multiplied by height divided by two. Wait, yeah, right, because a triangle is basically half of a parallelogram, right? So if you have a parallelogram, the area is base times height, and then a triangle would be half of that. So the formula should be (base * height) / 2.
Let me double-check that. Maybe I can visualize a triangle with base 6 and height 4. If I had another identical triangle, I could put them together to form a parallelogram. The base would still be 6, the height would still be 4, so the area of the parallelogram would be 6*4=24. Then the area of one triangle would be half of that, which is 12. So that makes sense.
Alternatively, I remember in school they taught us the formula as A = 1/2 * b * h. So plugging in the values, it should be 1/2 * 6 cm * 4 cm. Let me calculate that. 1/2 of 6 is 3, then 3 times 4 is 12. So the area should be 12 cm².
Wait, but just to be thorough, let me make sure there aren't any other formulas that could apply here. For example, Heron's formula requires the lengths of all three sides, but I only have the base and height here. So Heron's formula isn't necessary. Since we have the base and height given directly, using the standard area formula is the way to go.
Also, units: the base is in centimeters, the height is in centimeters, so when multiplying, the area will be in square centimeters. That checks out.
Another thing to consider: is the height corresponding to the given base? The problem states "base 6 cm, height 4 cm," so yes, they correspond. If the height was relative to a different side, it might complicate things, but here it's specified for the base. So no issues there.
I think that's all. The formula is correct, the calculation seems right. 6 times 4 is 24, divided by 2 is 12. So the area is 12 square centimeters.
Câu trả lời cuối:
The area of the triangle is calculated using the formula: Area=1/2×base×height
Substituting the given values: Area=1/2×6 cm ×4 cm = 12 cm²
Result: 12 cm²Bảng dưới đây cho thấy số token sử dụng ảnh hưởng thế nào đến tổng chi phí của một lần gọi API:
|
Ví dụ |
Token sử dụng |
Chi phí (USD) |
|
Prompt chưa tối ưu |
1165 |
$0.00255 |
|
Prompt đã tối ưu |
496 |
$0.00109 |
Chúng ta đã giảm khoảng 57% chi phí so với bản gốc nhờ prompt tối ưu, đồng thời vẫn nhận đúng đáp án.
Từ bảng giá trong phần Chi phí token, có thể kết luận rằng caching giúp tiết kiệm khoảng 74,07% chi phí API cho deepseek-chat và 74,55% cho deepseek-reasoner so với chi phí xử lý token đầu vào mới (không cache). Tức là dùng caching hiệu quả có thể giảm gần ba phần tư chi phí token đầu vào.
Đặc biệt hữu ích cho prompt dài, vì giảm thời gian chờ. Thêm nữa, hệ thống tự động xử lý caching—không cần đổi mã nguồn của bạn.
Vậy context caching hoạt động thế nào?
Khi bạn gửi yêu cầu, DeepSeek lưu input trên máy chủ của họ. Nếu sau đó bạn gửi yêu cầu tương tự, hệ thống sẽ truy xuất phản hồi đã lưu thay vì tính toán lại mọi thứ. Quá trình sẽ nhanh hơn và rẻ hơn.
Caching có thể hữu ích và giảm chi phí trong các tình huống sau:
Để tối đa hóa tiết kiệm, tôi khuyến nghị:
Để theo dõi việc dùng cache với API của DeepSeek, bạn không cần sửa mã. Thông tin sử dụng cache được tự động đưa vào phản hồi API. Hệ thống caching được bật mặc định cho mọi người dùng. Khi gọi API, đối tượng phản hồi sẽ có hai trường mới trong phần usage:
prompt_cache_hit_tokens: Số token đầu vào lấy từ cacheprompt_cache_miss_tokens: Số token đầu vào không tìm thấy trong cacheĐể truy cập thông tin này, bạn cần kiểm tra trường usage trong phản hồi API. Ví dụ cách truy cập các giá trị này trong:
response = client.chat.completions.create(
    model="deepseek-chat",
    messages=[
        {"role": "user", "content": "You are a helpful assistant."}
    ]
)

cache_hits = response.usage.prompt_cache_hit_tokens
cache_misses = response.usage.prompt_cache_miss_tokens

print(f"Cache hits: {cache_hits}")
print(f"Cache misses: {cache_misses}")
Tính năng này cho phép bạn theo dõi cách hệ thống caching hoạt động với trường hợp sử dụng của mình.
Tuy nhiên, caching có một số hạn chế:
Để tìm hiểu thêm, hãy đọc bài về prompt caching.
Trong hướng dẫn này, chúng ta đã học cách sử dụng DeepSeek API và hai mô hình của nó, DeepSeek-R1 và V3. Nếu hiểu cách các mô hình này hoạt động, bạn có thể xây dựng ứng dụng AI thông minh và tiết kiệm chi phí.
Hãy theo dõi tài liệu DeepSeek và các thực hành tốt nhất mới nhất để tận dụng tối đa những mô hình mạnh mẽ này. Khi đã có khóa API DeepSeek, bạn có thể trỏ nó tới chính tác nhân lập trình của DeepSeek; xem hướng dẫn DeepSeek Harness của chúng tôi.
Chúc bạn viết code vui vẻ!
Học AI với các khóa học này!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
