
{count, plural, one {Corso} other {Corsi}}
Lavorare con l'API di OpenAI
{hours} ore
181K
Per accedere ai modelli DeepSeek via API:
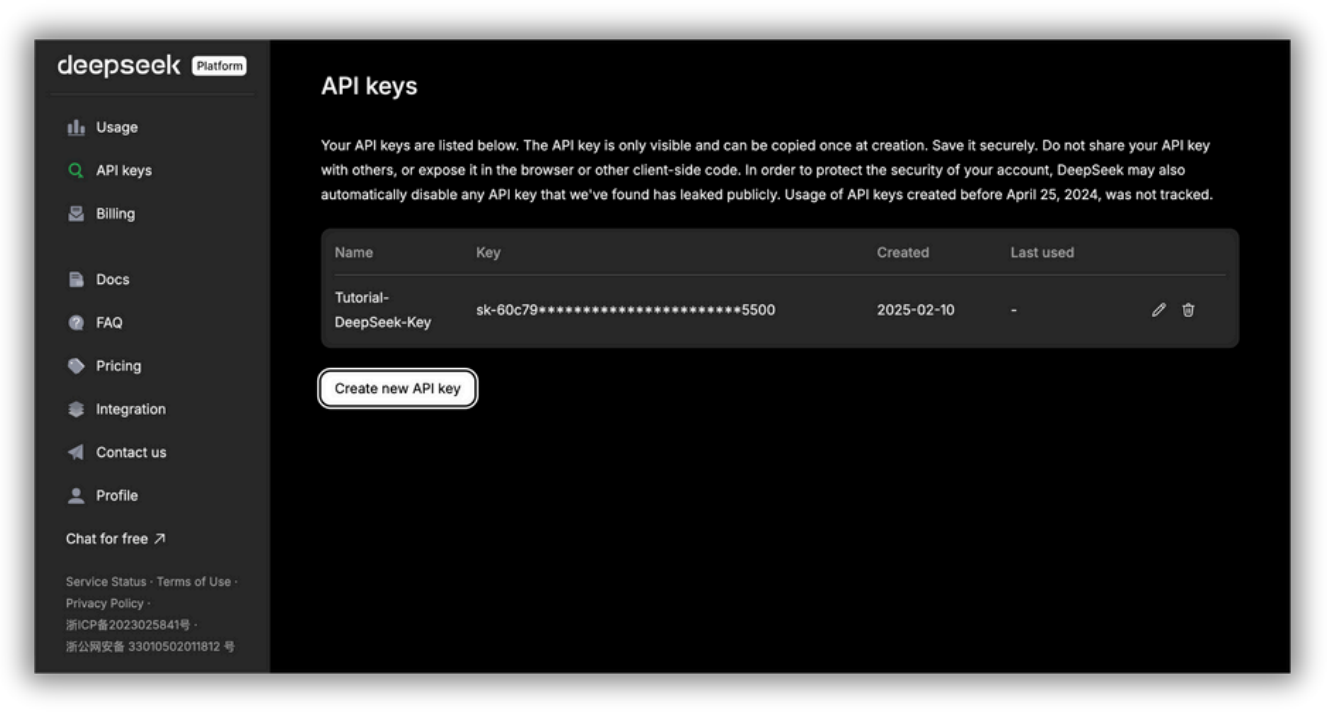
Pagina di gestione delle chiavi API della piattaforma DeepSeek. Qui puoi generare e gestire le tue chiavi API per accedere ai servizi di IA di DeepSeek. La chiave API è visibile solo al momento della creazione e deve essere conservata in modo sicuro; condividerla pubblicamente può comportare rischi di sicurezza.
Per usare DeepSeek-V3 devi impostare model='deepseek-chat' e per usare DeepSeek-R1 devi impostare model='deepseek-reasoner'.
Ecco come puoi usare l’SDK di OpenAI per accedere alla DeepSeek API:
from openai import OpenAI
client = OpenAI(api_key="<DeepSeek API Key>", base_url="https://api.deepseek.com")
response = client.chat.completions.create(
    model="deepseek-chat",
    messages=[
        {"role": "system", "content": "You are a helpful assistant"},
        {"role": "user", "content": "Hello"},
    ],
    stream=False
)
print(response.choices[0].message.content)
Vediamo più da vicino cosa fa questo pezzo di codice.
L’obiettivo del codice è inviare un messaggio in chat al modello DeepSeek e stampare la risposta del modello.
Per prima cosa, from openai import OpenAI importa la classe OpenAI dalla libreria openai.
Poi, client = OpenAI(...) crea un oggetto client OpenAI. Questo client è la tua connessione alla DeepSeek API. Configura il client con la tua chiave API (autenticazione) e specifica la base URL dell’API di DeepSeek.
Importante: sostituisci <DeepSeek API Key> con la tua chiave API DeepSeek reale!
La variabile response è la parte che invia il tuo messaggio al modello DeepSeek e ottiene la risposta. client.chat.completions.create(...) chiama l’API DeepSeek per ottenere una risposta dal modello.
Vediamo messages=[...], la parte che definisce la cronologia della conversazione:
Nota che in questo esempio stiamo usando DeepSeek-V3 avendo impostato model='deepseek-chat’, ma ricorda che puoi usare DeepSeek-R1 impostando model='deepseek-reasoner'.
La parte stream=False significa "Dammi tutta la risposta in una volta". In pratica, con stream=False il modello aspetta di aver generato l’intera risposta prima di inviarla. Usalo se vuoi visualizzare o analizzare la risposta completa in una sola volta.
Tuttavia, per risposte lunghe potresti dover attendere un po’ prima di ricevere l’output. Se imposti stream=True, il modello mostra le parole (o meglio, i token) man mano che vengono generati, così vedi la risposta in tempo reale invece di aspettare quella completa.
Infine, print(response.choices.message.content) estrae la risposta del modello dall’oggetto di risposta e la stampa in console. L’oggetto di risposta contiene molte informazioni, ma ciò che interessa principalmente è il messaggio del modello. L’API a volte può restituire più risposte possibili (choices). Questa seleziona la prima.
Al momento della pubblicazione di questo articolo, DeepSeek ha sospeso l’aggiunta di nuovi fondi ai conti API perché i server sono a corto di risorse. Ciò significa che al momento non puoi aggiungere credito al tuo saldo API. Se hai già fondi, puoi continuare a usare l’API normalmente. È probabile che DeepSeek riprenda le ricariche quando avrà maggiore capacità di server, quindi tieni d’occhio gli aggiornamenti!
Il team di DeepSeek sostiene che i loro modelli siano più economici della concorrenza. Ma devi comunque usarli con criterio per mantenere bassi i costi e ottenere le migliori prestazioni. Ecco gli aspetti chiave da conoscere e da considerare quando usi i modelli di DeepSeek per controllare output e prezzi.
Ogni modello DeepSeek è pensato per compiti diversi. Scegliere quello giusto ti aiuta a bilanciare costo e prestazioni in base alle tue esigenze. Ecco un rapido confronto:
I token sono la più piccola unità di testo elaborata dal modello: possono essere una parola, un numero o anche un segno di punteggiatura. Il numero di token utilizzati dipende dalla lingua e dal modo in cui il modello elabora il testo.
Ecco un confronto generale su come i caratteri si convertono in token:
Per una stima accurata, è meglio controllare i dettagli di utilizzo dopo aver eseguito la richiesta. Capire come vengono conteggiati i token ti aiuta a gestire i costi e ottimizzare le prestazioni quando usi i modelli di DeepSeek.
Ecco i prezzi per 1 milione di token per ciascun modello DeepSeek (nota: questi erano i prezzi al momento della pubblicazione di questo articolo—controlla i costi più recenti qui):
|
Modello |
Lunghezza contesto |
Max token CoT |
Max token output |
Prezzo input per 1M token (cache hit) |
Prezzo input per 1M token (cache miss) |
Prezzo output per 1M token |
|
deepseek-chat |
64k |
- |
8k |
$0.07 |
$0.27 |
$1.10 |
|
deepseek-reasoner |
64k |
32k |
8k |
$0.14 |
$0.55 |
$2.19 |
Come detto, DeepSeek offre due modelli, deepseek-chat e deepseek-reasoner. Ognuno ha punti di forza e costi diversi. Sapere come elaborano le informazioni e come tariffano i token ti aiuta a usarli in modo più efficiente e a tenere sotto controllo i costi.
Entrambi i modelli possono gestire fino a 64.000 token in una conversazione, cioè ricordano più contesto per risposte migliori e più pertinenti. Tuttavia, funzionano in modo diverso.
Deepseek-chat è progettato per conversazioni generali e non usa ragionamento avanzato. Deepseek-reasoner, invece, consente fino a 32.000 token per il ragionamento passo-passo (chain-of-thought—tra poco ne parliamo) prima di dare una risposta finale. Questo lo rende ottimo per problemi complessi, ma aumenta anche il numero di token utilizzati, quindi i costi.
Quanto alla lunghezza della risposta, entrambi i modelli possono generare fino a 8.000 token per risposta. Questo limite aiuta a evitare risposte troppo lunghe e costose.
Guardando i prezzi, deepseek-chat è l’opzione più economica. Se l’input è in cache (cioè è già stato usato), costa $0,07 per milione di token. Per nuovo input, il prezzo sale a $0,27 per milione di token, e l’output costa $1,10 per milione di token.
Deepseek-reasoner è più costoso perché offre un ragionamento più profondo. L’input in cache costa $0,14 per milione di token, mentre il nuovo input costa $0,55 per milione di token. Anche l’output è più caro, a $2,19 per milione di token, a riflettere la complessità delle risposte generate.
Quindi, quale modello dovresti usare?
Se ti servono risposte semplici o rapide, deepseek-chat è la scelta migliore perché costa meno. Ma se ti serve un ragionamento dettagliato o la soluzione di problemi complessi, deepseek-reasoner è più potente—anche se più costoso.
Per risparmiare, puoi usare anche il caching. Quando il modello riconosce un input già visto, applica una tariffa più bassa. È molto utile per query ripetute o conversazioni multi-turno.
I modelli DeepSeek hanno prezzi competitivi, ma l’uso dei token può crescere rapidamente. Il modo migliore per gestire i costi è mantenere i prompt brevi, usare il caching quando possibile e scegliere il modello giusto per il compito. Per saperne di più, leggi questo blog sull’ottimizzazione dei prompt.
Il parametro temperature controlla quanto casuali o prevedibili siano le risposte del modello. In DeepSeek il valore predefinito è 1,0, il che significa risposte bilanciate tra creatività e determinismo. Tuttavia, puoi regolare questa impostazione in base alle tue esigenze.
DeepSeek fornisce le seguenti raccomandazioni per diversi casi d’uso:
|
Caso d’uso |
Temperature consigliata |
|
Coding / Matematica |
0,0 (Deterministica, precisa) |
|
Data cleaning / Analisi dati |
1,0 (Risposte bilanciate) |
|
Conversazione generale |
1,3 (Più varietà nelle risposte) |
|
Traduzione |
1,3 (Consente flessibilità nella formulazione) |
|
Scrittura creativa / Poesia |
1,5 (Favorisce output diversificati e fantasiosi) |
Una temperature bassa (vicina a 0,0) rende il modello più prevedibile e preciso. Ottima per compiti che richiedono accuratezza, come coding, matematica e analisi dati strutturata.
Una temperature più alta (sopra 1,0) rende il modello più creativo e vario, adatta a storytelling, poesia e traduzioni dove serve flessibilità.
Per conversazioni generali, una temperature intorno a 1,3 aiuta a produrre dialoghi naturali e coinvolgenti senza essere troppo ripetitivi o eccessivamente casuali.
Sebbene la temperature non influisca direttamente sui costi, può aumentare indirettamente il numero di token di output:
Interagendo con l’API di DeepSeek, puoi controllare il formato delle risposte specificando il parametro response_format. È particolarmente utile con dati strutturati, perché aiuta a garantire coerenza e leggibilità nell’output del modello.
Per ricevere risposte in formato JSON, imposta:
response_format={'type': 'json_object'}Questo indica al modello di restituire output strutturati, rendendo più semplice elaborare le informazioni a livello programmatico. Il formato JSON è comunemente usato in applicazioni che richiedono risposte strutturate e leggibili dalle macchine, come estrazione dati, automazione e integrazioni API.
Anche se il formato JSON non influisce direttamente sul prezzo, in alcuni casi può ridurre indirettamente i costi.
La CoT è il processo di ragionamento che DeepSeek-R1 segue prima di dare una risposta finale. Significa che il modello spiega passo passo il suo ragionamento prima di arrivare a una conclusione.
Ogni token usato nel ragionamento CoT e nella risposta finale è tariffato a $2,19 per milione di token, in quanto fa parte dell’output. È un compromesso: più token CoT = costo maggiore ma anche migliore accuratezza nei compiti complessi.
Cosa puoi fare per controllare i costi usando la CoT?
Per illustrare come funziona l’output della Chain-of-Thought (CoT) in DeepSeek-R1 e il relativo impatto sui prezzi, consideriamo un esempio:
from openai import OpenAI

client = OpenAI(
    api_key="<Your_DeepSeek_API_Key>",
    base_url="https://api.deepseek.com"
)

def generate_response(prompt):
    response = client.chat.completions.create(
        model="deepseek-reasoner",
        messages=[
            {"role": "system", "content": "You are a helpful assistant."},
            {"role": "user", "content": prompt}
        ],
        stream=False
    )
    return response.choices[0].message.content

# Example usage
prompt = "Calculate the area of a triangle with a base of 6 cm and a height of 4 cm."
result = generate_response(prompt)
print(result)
CoT:
Okay, so I need to find the area of a triangle with a base of 6 cm and a height of 4 cm. Hmm, let me remember how to do this. I think the formula for the area of a triangle is something like base multiplied by height divided by two. Wait, is that right? Let me think.
When I was in math class, the teacher mentioned that a triangle is basically half of a parallelogram. So if you have a parallelogram, its area is base times height. If you cut it along the diagonal, you get two triangles. That means each triangle would have half the area of the parallelogram. So yes, the formula should be (base × height) / 2. That makes sense. Let me write that down to visualize it better.
Area = (base × height) / 2
Given the base is 6 cm and the height is 4 cm, I can substitute those values into the formula. Let me plug them in step by step.
First, multiply the base and the height: 6 cm × 4 cm. Let me calculate that. 6 times 4 is 24. So that gives me 24 cm². Now, divide that result by 2. So 24 divided by 2 is 12. Therefore, the area should be 12 cm².
Wait, let me verify that. If the base was 6 and the height 4, multiplying them gives the area of the corresponding parallelogram, which would be 24 cm². Then, since the triangle is half of that, dividing by 2 gives 12 cm². Yes, that seems correct.
Is there another way to check this? Maybe using a different method? Let's see. For a triangle, the area can also be calculated using Heron's formula, but that requires knowing all three sides. Since I only have the base and height, that might not apply here. Alternatively, if it's a right-angled triangle, the area would be (1/2)*base*height, which is the same formula. But even if it's not a right-angled triangle, the formula still applies because the height is given. The height is the perpendicular distance from the base to the opposite vertex, so regardless of the triangle's type, as long as we know the base and the corresponding height, the formula works.
Let me draw a mental picture. Imagine a triangle where the base is 6 cm. The height is 4 cm, which means if I were to drop a perpendicular line from the top vertex to the base, that line would measure 4 cm. So, even if the triangle is slanted, that vertical height is still 4 cm. Multiplying base and height gives the area of the parallelogram, so dividing by two gives the triangle's area.
Another way to think about it: If I have two identical triangles, I can put them together to form a parallelogram. The area of that parallelogram is base times height, so each triangle is half of that. Therefore, the area of one triangle is 1/2 * base * height.
So, plugging the numbers in again: 1/2 * 6 cm * 4 cm. 1/2 of 6 is 3, and 3 times 4 is 12. Yep, 12 cm².
I think that's solid. Let me check with an example. Suppose the base was 2 cm and the height 3 cm. Then the area would be (2*3)/2 = 3 cm². If I draw such a triangle, it should have an area of 3 cm², which seems right. So scaling up, with a base of 6 and height of 4, the area is proportionally larger.
Alternatively, if I consider a rectangle with the same base and height, area would be 6*4=24 cm². The triangle is half of that, so 12 cm². That also checks out.
Wait, but hold on. If the triangle isn't a right triangle, does the formula still hold? Let's think. If I have an obtuse triangle where the height is outside the triangle, does that affect the area? For example, suppose the base is 6 cm, but the height is measured from the base to a vertex that's outside the triangle, making an obtuse triangle. Even in that case, the area is still (base*height)/2. Because the height is the perpendicular distance regardless of where it's located. So even if the triangle is obtuse, the formula remains the same. Therefore, regardless of the triangle type, as long as the height is given, the formula applies.
Therefore, using 6 cm and 4 cm, multiplying them, dividing by two, gives 12 cm². That seems to be the correct answer. I can't see any mistakes in the reasoning.
Let me just recap. The formula for the area of a triangle is 1/2 multiplied by base multiplied by height. Given base = 6 cm, height = 4 cm. Plugging into the formula: 1/2 * 6 * 4 = 12. The units are in centimeters, and since area is in square units, the answer is 12 cm².
Yes, that all lines up. I think I've got it right. The area is 12 square centimeters.
Risposta finale:
The area of the triangle is 12 cm².
To calculate the area of a triangle with a base of 6 cm and a height of 4 cm, we use the standard formula:
Area=1/2×base×height
Step-by-Step Calculation
Multiply the base and height: 6 cm×4 cm=24 cm²Divide the result by 2: 24 cm²/ 2=12 cm²Final Answer: 12 cm²
Thus, the area of the triangle is 12 cm².Ora ottimizziamo il prompt e vediamo come cambia l’output:
Prompt: "Area of triangle: base 6cm, height 4cm. Show formula and result only"
CoT:
Okay, so I need to find the area of a triangle with a base of 6 cm and a height of 4 cm. Hmm, let me remember the formula for the area of a triangle. I think it's something like base multiplied by height divided by two. Wait, yeah, right, because a triangle is basically half of a parallelogram, right? So if you have a parallelogram, the area is base times height, and then a triangle would be half of that. So the formula should be (base * height) / 2.
Let me double-check that. Maybe I can visualize a triangle with base 6 and height 4. If I had another identical triangle, I could put them together to form a parallelogram. The base would still be 6, the height would still be 4, so the area of the parallelogram would be 6*4=24. Then the area of one triangle would be half of that, which is 12. So that makes sense.
Alternatively, I remember in school they taught us the formula as A = 1/2 * b * h. So plugging in the values, it should be 1/2 * 6 cm * 4 cm. Let me calculate that. 1/2 of 6 is 3, then 3 times 4 is 12. So the area should be 12 cm².
Wait, but just to be thorough, let me make sure there aren't any other formulas that could apply here. For example, Heron's formula requires the lengths of all three sides, but I only have the base and height here. So Heron's formula isn't necessary. Since we have the base and height given directly, using the standard area formula is the way to go.
Also, units: the base is in centimeters, the height is in centimeters, so when multiplying, the area will be in square centimeters. That checks out.
Another thing to consider: is the height corresponding to the given base? The problem states "base 6 cm, height 4 cm," so yes, they correspond. If the height was relative to a different side, it might complicate things, but here it's specified for the base. So no issues there.
I think that's all. The formula is correct, the calculation seems right. 6 times 4 is 24, divided by 2 is 12. So the area is 12 square centimeters.
Risposta finale:
The area of the triangle is calculated using the formula: Area=1/2×base×height
Substituting the given values: Area=1/2×6 cm ×4 cm = 12 cm²
Result: 12 cm²La tabella seguente mostra come il numero di token utilizzati influisce sul costo totale di una chiamata API:
|
Esempio |
Token utilizzati |
Costo (USD) |
|
Prompt non ottimizzato |
1165 |
$0.00255 |
|
Prompt ottimizzato |
496 |
$0.00109 |
Abbiamo ridotto i costi di circa il 57% rispetto all’originale con il prompt ottimizzato, ottenendo comunque la risposta corretta.
Dalla tabella dei prezzi vista nella sezione Costi dei token, possiamo concludere che il caching fa risparmiare circa il 74,07% dei costi API per deepseek-chat e il 74,55% per deepseek-reasoner rispetto al costo di elaborazione di nuovi token di input (non in cache). In pratica, usare bene il caching può ridurre i costi di input di quasi tre quarti.
È particolarmente utile per prompt lunghi, perché riduce i tempi di attesa. Inoltre, il sistema gestisce automaticamente il caching—non serve modificare il codice.
Ma come funziona il caching del contesto?
Quando invii una richiesta, DeepSeek memorizza l’input sui suoi server. Se invii una richiesta simile in seguito, il sistema recupera la risposta memorizzata invece di ricalcolare tutto. Questo rende il processo più veloce ed economico.
Il caching può essere utile e ridurre i costi nelle seguenti situazioni:
Per massimizzare il risparmio, ecco cosa consiglierei:
Per monitorare l’utilizzo della cache con l’API di DeepSeek non devi modificare il codice. Le informazioni sull’uso della cache sono incluse automaticamente nella risposta dell’API. Il sistema di caching è abilitato per impostazione predefinita per tutti gli utenti. Quando effettui una chiamata API, l’oggetto di risposta includerà due nuovi campi nella sezione usage:
prompt_cache_hit_tokens: numero di token di input serviti dalla cacheprompt_cache_miss_tokens: numero di token di input non trovati in cachePer accedere a queste informazioni, devi controllare il campo usage nella risposta dell’API. Ecco un esempio di come puoi accedere a questi valori in:
response = client.chat.completions.create(
    model="deepseek-chat",
    messages=[
        {"role": "user", "content": "You are a helpful assistant."}
    ]
)

cache_hits = response.usage.prompt_cache_hit_tokens
cache_misses = response.usage.prompt_cache_miss_tokens

print(f"Cache hits: {cache_hits}")
print(f"Cache misses: {cache_misses}")
Questa funzionalità ti consente di monitorare come funziona il caching per il tuo caso d’uso.
Il caching ha però alcune limitazioni:
Per saperne di più, leggi questo blog sul prompt caching.
In questo tutorial abbiamo visto come usare la DeepSeek API e i suoi due modelli, DeepSeek-R1 e V3. Capire come funzionano questi modelli ti permette di creare applicazioni di IA intelligenti ed efficienti nei costi.
Tieniti aggiornato con la documentazione DeepSeek e le best practice più recenti per sfruttare al massimo questi potenti modelli. Una volta che hai una chiave API DeepSeek, puoi puntarla anche sull’agente di coding di DeepSeek; vedi il nostro tutorial su DeepSeek Harness.
Buon coding!
Impara l'AI con questi corsi!
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min



