
Kursus
Pengantar Docker
4 jam
52.3K
Seiring AI generatif terus mentransformasi pengembangan perangkat lunak, saya melihat tantangan yang terus berulang: menjalankan model AI secara lokal masih lebih rumit daripada seharusnya.
Pengembang menghadapi peralatan yang terfragmentasi, masalah kompatibilitas perangkat keras, dan alur kerja yang terasa terlepas dari lingkungan pengembangan sehari-hari mereka. Docker Model Runner diluncurkan pada April 2025 untuk mengatasi tantangan ini, memudahkan menjalankan dan menguji model AI secara lokal dalam alur kerja Docker yang sudah ada.
Docker Model Runner merepresentasikan pergeseran dari AI berbasis cloud ke alur kerja terkontainerisasi secara lokal, menawarkan manfaat seperti privasi data, pengurangan biaya, dan iterasi yang lebih cepat, semuanya terintegrasi dengan ekosistem Docker. Berdasarkan pengalaman saya bekerja dengan deployment AI, keunggulan ini krusial bagi tim yang membangun aplikasi siap produksi sambil tetap menjaga kendali atas data sensitif.
Jika Anda baru mengenal Docker, saya sarankan mengikuti kursus pengantar Docker ini.
Penyajian model AI tradisional menghadirkan sejumlah tantangan yang pernah saya alami langsung.
Model AI berisi bobot matematis yang tidak diuntungkan oleh kompresi, tidak seperti image Docker tradisional. Ini menciptakan inefisiensi penyimpanan saat model dikemas bersama runtime-nya. Selain itu, menyiapkan mesin inferensi, mengelola akselerasi perangkat keras, dan mempertahankan peralatan terpisah untuk model versus kontainer aplikasi menambah kompleksitas yang tidak perlu.
Di sinilah Docker Model Runner berperan. Alih-alih menambahkan alat lain ke tumpukan Anda, ini memudahkan untuk menarik, menjalankan, dan mendistribusikan Large Language Model (LLM) langsung dari Docker Hub dalam format yang mematuhi OCI (Open Container Initiative) format atau dari Hugging Face jika model tersedia dalam GPT-Generated Unified Format (GGUF). Platform ini mengatasi masalah fragmentasi dengan membawa pengelolaan model ke dalam alur kerja yang sama yang digunakan pengembang untuk kontainer.
Konteks historisnya penting. Seiring adopsi AI generatif meningkat, industri menyaksikan tren yang tumbuh menuju alur kerja AI yang aman dan mengutamakan lokal. Organisasi semakin khawatir tentang privasi data, biaya API, dan ketergantungan vendor yang terkait dengan layanan AI berbasis cloud.
Docker bermitra dengan nama-nama berpengaruh di AI dan pengembangan perangkat lunak, termasuk Google, Continue, Dagger, Qualcomm Technologies, Hugging Face, Spring AI, dan VMware Tanzu AI Solutions, menyadari bahwa pengembang membutuhkan cara yang lebih baik untuk bekerja dengan model AI secara lokal tanpa mengorbankan kenyamanan praktik pengembangan modern.
Sebelum mulai dengan Docker Model Runner, izinkan saya menjelaskan persyaratan sistem yang Anda perlukan. Kabar baiknya, jika Anda sudah menggunakan Docker, Anda sudah setengah jalan. Docker Model Runner kini umumnya tersedia dan berfungsi di semua versi Docker, mendukung platform macOS, Windows, dan Linux.
Sementara Docker Model Runner awalnya dirilis eksklusif di Docker Desktop, per Desember 2025, ini kompatibel dengan platform apa pun yang mendukung Docker Engine.
Berikut yang Anda perlukan di berbagai platform:
|
Komponen |
Persyaratan |
Catatan |
|
Sistem Operasi |
macOS, Windows, Linux |
Semua platform utama didukung |
|
Versi Docker |
Docker Desktop Docker Engine |
Desktop untuk macOS/Windows Engine untuk Linux |
|
RAM |
Minimal 8 GB Disarankan 16 GB+ |
Model yang lebih besar membutuhkan lebih banyak memori |
|
GPU (opsional) |
Apple Silicon NVIDIA ARM/Qualcomm |
Memberikan peningkatan kinerja 2–3x |
Persyaratan Sistem Docker Model Runner
Untuk akselerasi GPU, Docker Model Runner kini mendukung beberapa backend:
Apple Silicon (M1/M2/M3/M4): Menggunakan Metal API untuk akselerasi GPU, dikonfigurasi otomatis.
GPU NVIDIA: Memerlukan NVIDIA Container Runtime, mendukung akselerasi CUDA.
ARM/Qualcomm: Akselerasi perangkat keras tersedia pada perangkat yang kompatibel.
Selain itu, Docker Model Runner mendukung Vulkan sejak Oktober 2025, memungkinkan akselerasi perangkat keras pada rentang GPU yang jauh lebih luas, termasuk GPU terintegrasi dan dari AMD, Intel, serta vendor lainnya.
Meski Anda dapat menjalankan model hanya di CPU, dukungan GPU sangat meningkatkan kinerja inferensi. Perbedaannya bisa seperti menunggu 10 detik dibandingkan 3 detik untuk respons.
Satu catatan penting: Beberapa fitur llama.cpp mungkin belum sepenuhnya didukung pada GPU seri 6xx, dan dukungan untuk mesin tambahan seperti MLX atau vLLM akan ditambahkan di masa mendatang.
Di sinilah bagian yang benar-benar menarik. Desain arsitektur Docker Model Runner menyimpang dari kontainerisasi tradisional dengan cara yang mungkin mengejutkan Anda. Izinkan saya menjelaskan bagaimana ini bekerja di balik layar.
Docker Model Runner menerapkan pendekatan hibrida yang menggabungkan kemampuan orkestrasi Docker dengan kinerja native host untuk inferensi AI. Apa yang membuat arsitektur ini khas? Ini mendefinisikan ulang secara fundamental bagaimana kita menjalankan beban kerja AI.
Berbeda dengan kontainer Docker standar, mesin inferensi sebenarnya tidak berjalan di dalam kontainer sama sekali. Sebaliknya, server inferensi menggunakan llama.cpp sebagai mesin, berjalan sebagai proses host native yang memuat model sesuai permintaan dan melakukan inferensi langsung pada perangkat keras Anda.
Mengapa ini penting? Pilihan desain ini memungkinkan akses langsung ke Metal API milik Apple untuk akselerasi GPU dan menghindari overhead kinerja saat menjalankan inferensi di dalam mesin virtual. Pemisahan penyimpanan dan eksekusi model ini disengaja: model disimpan terpisah dan dimuat ke memori hanya saat dibutuhkan, lalu dibongkar setelah periode tidak aktif.
Sekarang, mari kita lihat gambaran besarnya dan bagaimana bagian-bagian ini menyatu. Pada tingkat tinggi, Docker Model Runner terdiri dari tiga komponen utama: model runner, peralatan distribusi model, dan plugin CLI model. Arsitektur modular ini memungkinkan iterasi lebih cepat dan batasan API yang lebih rapi antar area tanggung jawab yang berbeda.
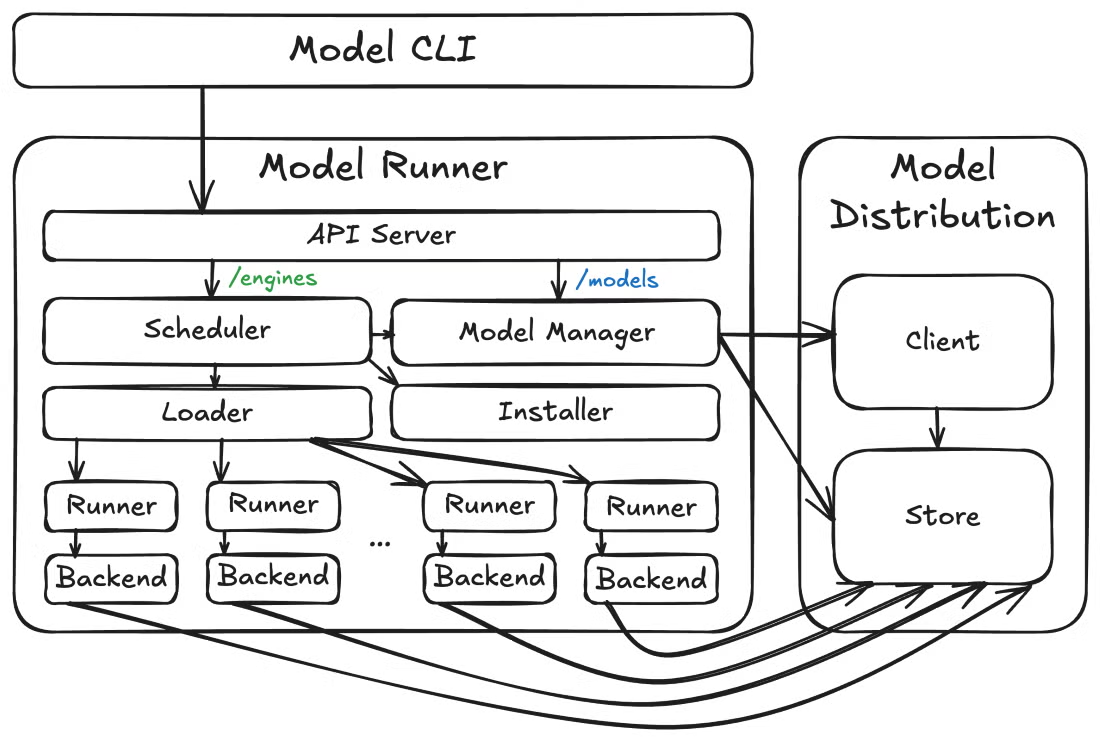
Arsitektur Docker Model Runner
Di luar arsitektur inti, Docker Model Runner juga mengantisipasi kebutuhan operasional. Model Runner mengekspos endpoint metrik di /metrics, memungkinkan Anda memantau kinerja model, statistik permintaan, dan melacak penggunaan sumber daya. Observabilitas bawaan ini penting untuk deployment produksi saat Anda membutuhkan visibilitas terhadap perilaku model dan konsumsi sumber daya.
Dengan arsitektur yang sudah dipahami, Anda mungkin bertanya: apa yang sebenarnya bisa saya lakukan dengan ini? Izinkan saya memandu fitur-fitur yang membuat Docker Model Runner menarik untuk alur kerja pengembangan AI saya.
Berikut gambaran singkat kemampuan unggulannya:
|
Fitur |
Manfaat |
Ideal Untuk |
|
Sumber Terbuka & Gratis |
Tanpa biaya lisensi Transparansi penuh |
Eksperimen Belajar Penggunaan produksi |
|
Integrasi Docker CLI |
Perintah yang familier (docker model pull/run/list) |
Pengguna Docker yang ingin tanpa alat baru untuk dipelajari |
|
Pengemasan yang Mematuhi OCI |
Distribusi model standar melalui registry |
Kontrol versi Manajemen akses |
|
Kompatibilitas API OpenAI |
Pengganti langsung untuk API cloud |
Migrasi mudah dari cloud ke lokal |
|
Eksekusi Terisolasi |
Lingkungan terisolasi untuk keamanan |
Kebutuhan kepatuhan enterprise |
|
Akselerasi GPU |
Inferensi 2–3x lebih cepat |
Aplikasi waktu nyata Throughput tinggi |
Fitur Inti Docker Model Runner
Antarmuka baris perintah terintegrasi mulus dengan alur kerja Docker yang ada. Anda akan menggunakan perintah seperti docker model pull, docker model run, dan docker model list, mengikuti pola yang sudah Anda kenal dari bekerja dengan kontainer.
Antarmuka pengguna grafis di Docker Desktop menyediakan onboarding terpandu untuk membantu bahkan pengembang AI pemula menyajikan model dengan mulus, dengan penanganan otomatis sumber daya yang tersedia seperti RAM dan GPU.
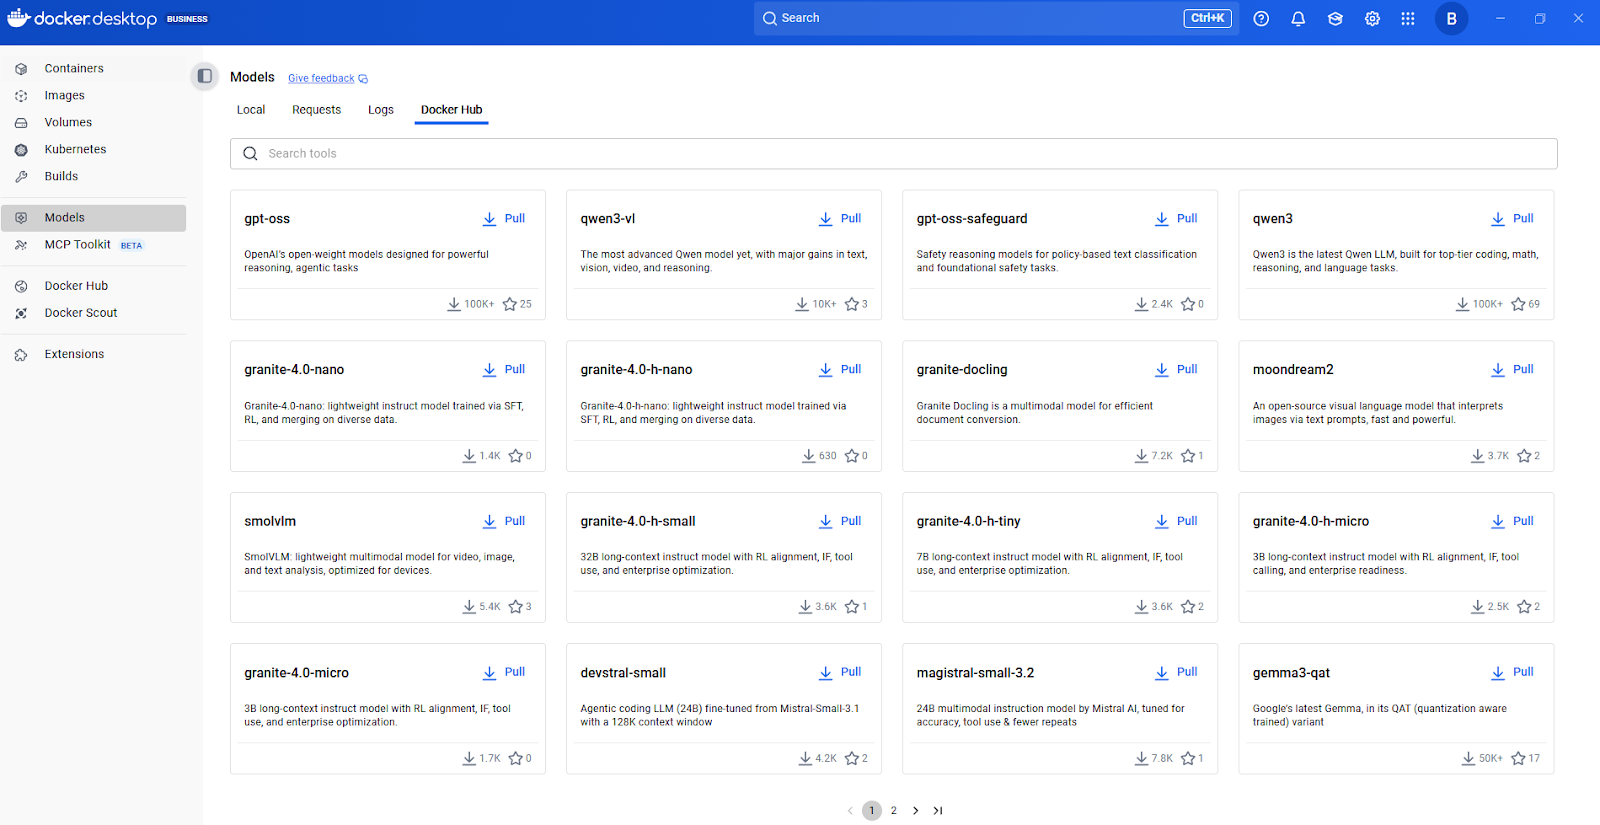
Docker Model Hub
Sekarang, mari bahas bagaimana model dikemas dan didistribusikan. Docker Model Runner mendukung model yang dikemas OCI, memungkinkan Anda menyimpan dan mendistribusikan model melalui registry yang kompatibel dengan OCI, termasuk Docker Hub. Pendekatan pengemasan standar ini berarti Anda dapat menerapkan pola versi, kontrol akses, dan distribusi yang sama seperti untuk image kontainer.
Saat terhubung dengan aplikasi, kemampuan REST API sangat berharga untuk integrasi aplikasi. Docker Model Runner menyertakan mesin inferensi yang dibangun di atas llama.cpp dan dapat diakses melalui API OpenAI yang familier.
Kompatibilitas OpenAI ini berarti kode yang sudah ditulis untuk API OpenAI dapat bekerja dengan model lokal dengan perubahan minimal—cukup arahkan aplikasi Anda ke endpoint lokal alih-alih API cloud. Fleksibilitas ini saja dapat menghemat berminggu-minggu refactoring.
Izinkan saya memandu Anda menyiapkan Docker Model Runner di sistem Anda. Proses instalasinya sederhana, namun ada beberapa pertimbangan spesifik platform yang perlu diketahui sejak awal.
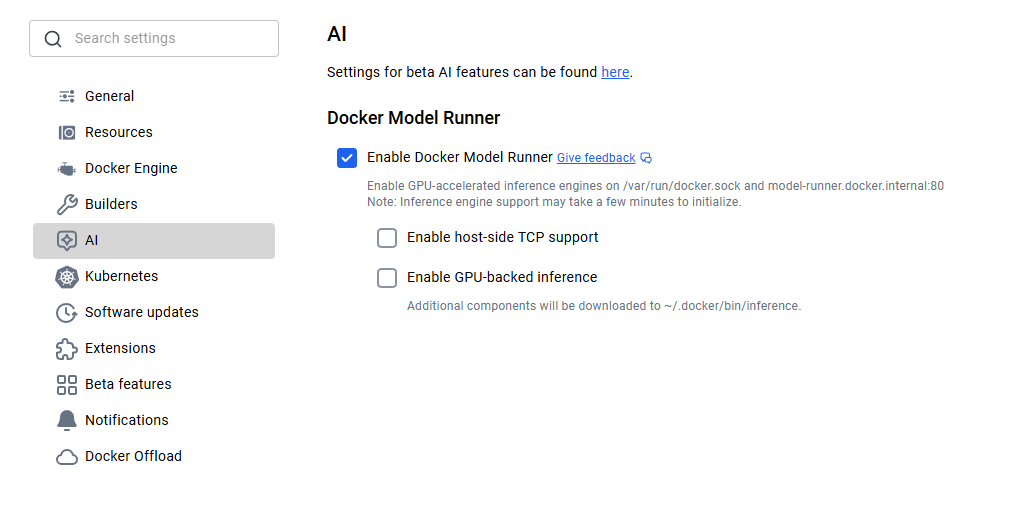
Untuk pengguna macOS dan Windows, Docker Model Runner disertakan dengan Docker Desktop 4.40 atau yang lebih baru. Cukup unduh versi terbaru dari situs resmi Docker dan instal. Setelah terpasang, Anda perlu mengaktifkan Docker Model Runner di pengaturan. Arahkan ke Settings > AI, lalu pilih opsi Docker Model Runner dan inference backend GPU jika komputer Anda mendukung GPU NVIDIA.
Aktivasi Docker Model Runner
Pengguna Linux mendapatkan pengalaman yang bahkan lebih ringkas. Perbarui sistem Anda dan instal plugin Docker Model Runner menggunakan perintah berikut.
sudo apt-get update
sudo apt-get install docker-model-plugin
Setelah instalasi, verifikasi dengan menjalankan docker model version.
Jika Anda menggunakan Apple Silicon, akselerasi GPU melalui Metal dikonfigurasi otomatis, tanpa pengaturan tambahan. Untuk GPU NVIDIA, pastikan Anda telah memasang NVIDIA Container Runtime.
Dengan dukungan Vulkan, kini Anda dapat memanfaatkan akselerasi perangkat keras pada GPU AMD, Intel, dan lainnya yang mendukung Vulkan API. Sistem akan mendeteksi perangkat keras Anda secara cerdas dan menerapkan akselerasi yang sesuai.
Setelah terpasang, mengunduh model menjadi sangat mudah. Anda hanya perlu menarik model terlebih dahulu lalu menjalankannya untuk berinteraksi dengannya:
docker model pull ai/smollm2
docker model run ai/smollm2
Jika semuanya telah disetel dengan benar, Anda akan melihat model tersebut dalam daftar:
docker model listMODEL NAME
ai/smollm2Setelah Anda menginstal Docker Model Runner dan memahami cara menarik model, pertanyaan berikutnya yang wajar adalah: dari mana model ini berasal, dan bagaimana cara mengelolanya dalam skala besar? Di sinilah pendekatan Docker Model Runner menjadi sangat elegan.
Docker mengemas model sebagai OCI Artifact, standar terbuka yang memungkinkan distribusi melalui registry dan alur kerja yang sama seperti untuk kontainer. Tim yang sudah menggunakan private Docker registry dapat menggunakan infrastruktur yang sama untuk model AI. Docker Hub menyediakan fitur enterprise seperti Registry Access Management untuk kontrol akses berbasis kebijakan.
Integrasi dengan Hugging Face patut mendapat sorotan. Pengembang dapat menggunakan Docker Model Runner sebagai mesin inferensi lokal untuk menjalankan model di Hugging Face dan memfilter model yang didukung (memerlukan format GGUF) langsung di antarmuka Hugging Face. Ini membuat penemuan model jauh lebih mudah.
docker model pull hf.co/bartowski/Llama-3.2-1B-Instruct-GGUFYang cerdas adalah cara integrasi ini bekerja di balik layar. Saat Anda menarik model dari Hugging Face dalam format GGUF, Docker Model Runner secara otomatis mengemasnya sebagai artifact OCI secara langsung. Konversi mulus ini menghilangkan langkah pengemasan manual dan mempercepat jalur dari penemuan model ke deployment.
Memahami mekanisme distribusi itu bagus, tetapi model apa yang sebenarnya bisa Anda jalankan? Saya akan tunjukkan apa yang tersedia secara bawaan dan cara menemukan lebih banyak.
Docker Model Runner menampilkan pilihan kurasi model yang siap digunakan segera. SmolLM2 adalah pilihan populer, sempurna untuk asisten percakapan, ekstraksi teks, penulisan ulang, dan tugas ringkasan, dengan 360 juta parameter. Saya menemukan model ini sangat berguna untuk pengembangan dan pengujian karena ukurannya kecil dan inferensinya cepat.
Untuk menemukan model tambahan, saya sarankan mulai dari katalog model AI di Docker Hub. Jelajahi model yang tersedia, periksa dokumentasinya untuk tugas yang didukung dan persyaratan perangkat keras, lalu tarik dengan perintah docker model pull yang sederhana.
Model diunduh dari Docker Hub saat pertama kali Anda menggunakannya dan disimpan secara lokal, dimuat ke memori hanya saat runtime ketika ada permintaan, dan dibongkar saat tidak digunakan untuk mengoptimalkan sumber daya.
Pendekatan ini menjaga sistem Anda tetap responsif meski Anda memiliki banyak model yang diunduh. Anda tidak dipaksa menyimpan semuanya dalam RAM secara bersamaan.
Setiap listing model mencakup informasi tentang tingkat kuantisasi (seperti Q4_0, Q8_0), yang memengaruhi ukuran model dan kualitas inferensi.
|
Tingkat Kuantisasi |
Deskripsi |
Ukuran Berkas |
Kualitas |
Terbaik Untuk |
|
Q8_0 |
Kuantisasi 8-bit |
Terbesar |
Kualitas tertinggi |
Penggunaan produksi, tugas kritis akurasi |
|
Q5_0 |
Kuantisasi 5-bit |
Sedang |
Keseimbangan yang baik |
Serbaguna, kinerja seimbang |
|
Q4_0 |
Kuantisasi 4-bit |
Terkecil |
Dapat diterima |
Pengembangan, pengujian, lingkungan dengan sumber daya terbatas |
Kuantisasi Model
Satu hal penting yang perlu dipertimbangkan adalah versi model. Anda dapat menentukan versi tepat menggunakan tag (seperti Q4_0 atau latest), mirip dengan image Docker. Ini memastikan deployment yang dapat direproduksi dan mencegah perubahan tak terduga saat model diperbarui.
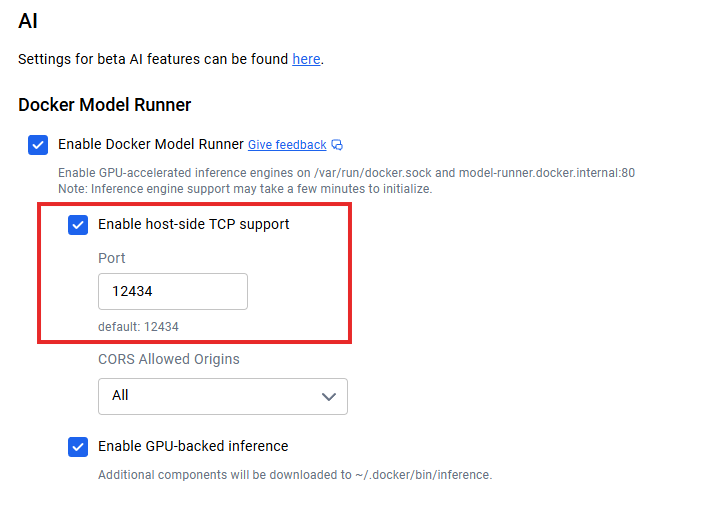
Setelah Anda menjalankan model secara lokal, pertanyaannya menjadi: bagaimana saya menghubungkannya dengan aplikasi saya? Saat dukungan TCP sisi host diaktifkan (misalnya melalui pengaturan TCP Docker Desktop), endpoint API default berjalan pada localhost:12434, mengekspos endpoint yang kompatibel dengan OpenAI.
Integrasi API Docker Model Runner
Berikut contoh sederhana untuk membuat permintaan:
curl http://localhost:12434/engines/llama.cpp/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "ai/smollm2",
    "messages": [{"role": "user", "content": "Explain containerization"}],
    "stream": false
  }'
Untuk arsitektur microservice, kontainer aplikasi Anda dapat berkomunikasi dengan layanan model menggunakan protokol HTTP standar—tanpa SDK khusus. Streaming respons didukung untuk aplikasi waktu nyata dengan menyetel "stream": true.
Dokumentasi REST API menyediakan spesifikasi endpoint lengkap, opsi parameter, dan skema respons. Saya sarankan merujuk dokumentasi resmi Docker untuk detail API terbaru, karena platform ini terus berkembang pesat.
Mendapatkan kinerja optimal dari Docker Model Runner memerlukan pemahaman beberapa strategi kunci. Berikut yang saya pelajari dari bekerja dengan deployment model lokal.
Dengan berjalan sebagai proses tingkat host dengan akses GPU langsung, Model Runner mencapai optimalisasi kinerja yang lebih baik dibandingkan solusi yang dikontainerisasi. Keputusan arsitektural ini berbuah pada throughput dan latensi, namun Anda tetap perlu melakukan penyetelan yang tepat untuk memaksimalkan hasil.
Akselerasi perangkat keras adalah tuas optimalisasi pertama Anda. Mengaktifkan dukungan GPU biasanya memberikan peningkatan kinerja 2–3x dibandingkan inferensi hanya CPU. Di luar perangkat keras, kuantisasi model adalah pengaturan utama kedua. Saya biasanya memulai dengan Q8_0 untuk kualitas terbaik, lalu beralih ke Q5_0 atau Q4_0 jika membutuhkan kinerja yang lebih baik.
Endpoint metrik bawaan di /metrics memungkinkan pemantauan dengan Prometheus atau tumpukan pemantauan Anda saat ini. Untuk penskalaan, konfigurasikan panjang konteks berdasarkan kebutuhan nyata alih-alih menggunakan nilai maksimum. Jika aplikasi Anda hanya butuh konteks 2048 token, jangan konfigurasikan 8192.
Salah satu keunggulan terkuat Docker Model Runner adalah bagaimana ia terintegrasi dengan ekosistem Docker yang lebih luas.
Docker Model Runner mendukung Docker Compose. Ini berarti Anda dapat mendefinisikan aplikasi multi-layanan di mana salah satu layanannya adalah model AI, mengelola seluruh tumpukan dengan berkas Docker Compose yang familier. Berikut contohnya:
services:
  app:
    image: my-app:latest
    models:
      - llm
      - embedding

models:
  llm:
    model: ai/smollm2
  embedding:
    model: ai/embeddinggemma
Anda juga dapat mengotomatisasi alur kerja CI/CD: menyalakan model di lingkungan uji, menjalankan pengujian integrasi terhadapnya, lalu mematikan semuanya, semuanya dalam infrastruktur pipeline yang sudah ada. Ini menghilangkan masalah "berfungsi di mesin saya" untuk fitur AI.
Integrasi menarik lainnya adalah Docker Offload, yang memperluas alur kerja lokal Anda ke cloud saat diperlukan. Meskipun masih fitur Beta, ini memungkinkan Anda mengembangkan secara lokal dengan Docker Model Runner, lalu mengalihkan inferensi yang membutuhkan sumber daya besar ke infrastruktur cloud saat kebutuhan melebihi kapasitas lokal.
Docker Offload
Dukungan untuk berjalan di Kubernetes juga tersedia sebagai Helm chart dan berkas YAML statis. Ini membuka peluang untuk deployment skala produksi yang membutuhkan penskalaan horizontal, penyeimbangan beban, dan ketersediaan tinggi.
Meski masih eksperimental, integrasi Kubernetes merepresentasikan evolusi Docker Model Runner menuju deployment kelas enterprise, di mana Anda menyajikan ribuan permintaan per detik di banyak replika.
Dengan semua opsi integrasi ini, Anda mungkin bertanya: tetapi apakah ini aman? Docker Model Runner berjalan dalam lingkungan terisolasi dan terkendali, menyediakan sandboxing untuk keamanan. Isolasi ini mencegah model mengakses sumber daya sistem sensitif di luar yang disediakan secara eksplisit.
Manfaat keamanan utamanya adalah privasi data. Permintaan inferensi Anda tidak pernah meninggalkan infrastruktur Anda, menghilangkan risiko kebocoran data. Bagi organisasi yang menangani data sensitif, model eksekusi lokal ini penting untuk kepatuhan terhadap GDPR, HIPAA, dan regulasi privasi lainnya.
Admin dapat mengonfigurasi dukungan TCP sisi host dan CORS untuk kontrol keamanan yang lebih terperinci. Metadata lisensi model di registry memungkinkan pelacakan kepatuhan dan jejak audit untuk tata kelola enterprise.
Pada titik ini, Anda mungkin berpikir: bagaimana perbandingannya dengan alat yang sudah saya gunakan? Berikut perbandingan Docker Model Runner dengan Ollama dan NVIDIA NIM:
|
Fitur |
Docker Model Runner |
Ollama |
NVIDIA NIM |
|
Kinerja |
1,00–1,12x lebih cepat daripada Ollama |
Kinerja dasar |
Sangat dioptimalkan untuk GPU NVIDIA |
|
Integrasi Ekosistem |
Alur kerja Docker native, artifact OCI |
Alat mandiri, alur kerja terpisah |
Terkontainerisasi, spesifik NVIDIA |
|
Kustomisasi Model |
Model pra-kemas dari Docker Hub |
Modelfile kustom, impor GGUF/Safetensors |
Hanya model yang dioptimalkan NVIDIA |
|
Dukungan Platform |
macOS, Windows, Linux |
macOS, Windows, Linux, Docker |
Linux hanya dengan GPU NVIDIA |
|
Persyaratan Perangkat Keras |
GPU apa pun (Metal, CUDA, Vulkan) atau CPU |
GPU atau CPU apa pun |
Wajib GPU NVIDIA |
|
Komunitas & SDK |
Tumbuh, fokus ekosistem Docker |
Mapan, ekstensif |
Ekosistem NVIDIA, berfokus enterprise |
|
Terbaik Untuk |
Tim dengan infrastruktur Docker |
Proyek AI mandiri, eksperimen cepat |
Deployment produksi berfokus NVIDIA |
Pembeda utama bagi Docker Model Runner adalah integrasi ekosistem. Ini memperlakukan model AI sebagai warga kelas satu berdampingan dengan kontainer, mengurangi proliferasi alat bagi tim yang berfokus pada Docker.
Ollama menawarkan kustomisasi model yang lebih luas dan komunitas yang matang dengan SDK ekstensif. NVIDIA NIM memberikan performa tertinggi untuk GPU NVIDIA namun kurang fleksibilitas dan dukungan lintas platform dibanding opsi lainnya.
Sebelum kita akhiri, mari bahas apa yang terjadi saat sesuatu tidak berjalan semestinya.
Galat ini biasanya menunjukkan bahwa Docker CLI tidak dapat menemukan executable plugin.
Penyebab: Docker tidak dapat menemukan plugin di direktori plugin CLI yang diharapkan.
Solusi: Anda kemungkinan perlu membuat symbolic link (symlink) ke executable tersebut. Silakan lihat kembali bagian instalasi untuk perintah spesifiknya.
Saat ini, menggunakan digest spesifik untuk menarik atau mereferensikan model mungkin gagal.
Solusi sementara: Rujuk model berdasarkan nama tag-nya (misalnya model:v1) alih-alih digest.
Status: Tim engineering secara aktif mengerjakan dukungan digest yang tepat untuk rilis mendatang.
Jika model Anda berjalan lambat atau tidak memanfaatkan GPU, lakukan pemeriksaan berikut:
Verifikasi Driver: Pastikan driver GPU mesin host Anda mutakhir.
Periksa Izin: Pastikan Docker memiliki izin untuk mengakses sumber daya GPU.
Linux (NVIDIA): Pastikan NVIDIA Container Runtime terpasang dan terkonfigurasi.
Verifikasi: Jalankan perintah berikut untuk memastikan GPU terlihat oleh sistem: nvidia-smi
Jika Anda menemui masalah yang tidak tercantum di sini:
Buat Isu: Laporkan bug atau ajukan fitur di repositori GitHub resmi.
Komunitas: Ada komunitas aktif yang sering memberikan solusi cepat untuk kasus-kasus tepi.
Docker Model Runner merepresentasikan langkah maju yang signifikan dalam membuat pengembangan AI lebih mudah diakses. Dengan membawa manajemen model ke dalam ekosistem Docker, ini menghilangkan friksi yang secara historis memperlambat adopsi AI.
Pentingnya secara strategis melampaui kenyamanan. Di era ketika privasi data, pengendalian biaya, dan kecepatan pengembangan semakin penting, eksekusi AI lokal menjadi semakin krusial. Docker Model Runner memudahkan bereksperimen dan membangun aplikasi AI menggunakan perintah dan alur kerja Docker yang sama yang sudah digunakan pengembang setiap hari.
Ke depan, platform ini terus berkembang dengan dukungan untuk pustaka inferensi tambahan, opsi konfigurasi lanjutan, dan kemampuan deployment terdistribusi. Konvergensi antara kontainerisasi dan AI adalah arah industri, dan Docker Model Runner berdiri di persimpangan ini, mewujudkan pengembangan AI yang berfokus pada privasi dan hemat biaya bagi jutaan pengembang yang sudah menggunakan Docker.
Sekarang setelah Anda menjalankan model di lingkungan Docker lokal, langkah berikutnya adalah membangun pipeline andal di sekelilingnya. Kuasai prinsip versi model, deployment, dan manajemen siklus hidup dengan MLOps Fundamentals Skill Track di DataCamp.
Kursus Docker
Kursus
Program
Program
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



