
{count, plural, one {Kurs} other {Kurs}}
Docker'a Giriş
{hours} sa
52.4K
Üretken yapay zekâ yazılım geliştirmeyi dönüştürmeye devam ederken, kalıcı bir zorluk dikkatimi çekti: yapay zekâ modellerini yerelde çalıştırmak hâlâ olması gerekenden daha karmaşık.
Geliştiriciler parçalı araç zincirleri, donanım uyumluluğu sorunları ve günlük geliştirme ortamlarından kopuk iş akışlarıyla karşılaşıyor. Docker Model Runner, bu zorlukları ele almak için Nisan 2025’te piyasaya sürüldü ve mevcut Docker iş akışları içinde yapay zekâ modellerini yerelde çalıştırmayı ve test etmeyi kolaylaştırdı.
Docker Model Runner, bulut tabanlı yapay zekâdan yerel, konteynerleştirilmiş iş akışlarına bir kaymayı temsil eder; veri gizliliği, maliyetlerin düşmesi ve daha hızlı yineleme gibi avantajlar sunarken Docker ekosistemiyle entegre çalışır. Yapay zekâ dağıtımları üzerinde çalışırken edindiğim deneyime göre, bu avantajlar, hassas veriler üzerinde kontrolü korurken üretime hazır uygulamalar geliştiren ekipler için kritik öneme sahiptir.
Docker’a yeniyseniz, bu giriş niteliğindeki Docker kursunu öneririm.
Geleneksel yapay zekâ model sunumu, bizzat deneyimlediğim çeşitli zorluklar barındırır.
Yapay zekâ modelleri, geleneksel Docker imajlarının aksine sıkıştırmadan fayda görmeyen matematiksel ağırlıklar içerir. Bu durum, modellerin çalışma zamanı ile paketlenmesi halinde depolama verimsizlikleri doğurur. Ayrıca çıkarım motorlarının kurulumu, donanım hızlandırmasının yönetimi ve modeller ile uygulama konteynerleri için ayrı araçların sürdürülmesi gereksiz bir karmaşıklık yaratır.
İşte tam bu noktada Docker Model Runner devreye giriyor. Yığınınıza bir araç daha eklemek yerine, Büyük Dil Modellerini (LLM’ler) doğrudan Docker Hub’dan OCI uyumlu (Open Container Initiative) formatta veya modeller mevcutsa Hugging Face’ten GPT-Generated Unified Format (GGUF) ile çekmeyi, çalıştırmayı ve dağıtmayı kolaylaştırır. Platform, model yönetimini geliştiricilerin konteynerler için kullandığı aynı iş akışına taşıyarak parçalanma sorununu giderir.
Tarihsel bağlam burada önemlidir. Üretken yapay zekânın benimsenmesi hızlandıkça, sektörde güvenli, yerel-öncelikli yapay zekâ iş akışlarına yönelik artan bir eğilim görüldü. Kuruluşlar, bulut tabanlı yapay zekâ hizmetleriyle ilişkili veri gizliliği, API maliyetleri ve tedarikçi bağımlılığı konusunda giderek daha fazla endişe duymaya başladı.
Docker, geliştiricilerin modern geliştirme uygulamalarının sunduğu kolaylıklardan ödün vermeden yapay zekâ modelleriyle yerelde daha iyi çalışabilmesi gerektiğini fark ederek Google, Continue, Dagger, Qualcomm Technologies, Hugging Face, Spring AI ve VMware Tanzu AI Solutions gibi yapay zekâ ve yazılım geliştirme alanındaki etkili isimlerle ortaklık kurdu.
Docker Model Runner’a dalmadan önce ihtiyaç duyacağınız sistem gereksinimlerini aktaralım. Güzel haber şu ki Docker kullanıyorsanız yolun yarısı zaten kat edilmiştir. Docker Model Runner artık genel kullanıma açıktır ve macOS, Windows ve Linux platformlarını destekleyen tüm Docker sürümlerinde çalışır.
Docker Model Runner yalnızca Docker Desktop’ta yayımlanmış olsa da Aralık 2025 itibarıyla Docker Engine’i destekleyen tüm platformlarla uyumludur.
Farklı platformlar için ihtiyacınız olanlar şunlar:
|
Bileşen |
Gereksinim |
Notlar |
|
İşletim Sistemi |
macOS, Windows, Linux |
Tüm ana platformlar desteklenir |
|
Docker Sürümü |
Docker Desktop Docker Engine |
macOS/Windows için Desktop Linux için Engine |
|
RAM |
En az 8 GB 16 GB+ önerilir |
Daha büyük modeller daha fazla bellek ister |
|
GPU (opsiyonel) |
Apple Silicon NVIDIA ARM/Qualcomm |
2-3 kat performans artışı sağlar |
Docker Model Runner Sistem Gereksinimleri
GPU hızlandırma için Docker Model Runner artık birden fazla arkayüzü destekliyor:
Apple Silicon (M1/M2/M3/M4): GPU hızlandırma için Metal API’yi kullanır, otomatik olarak yapılandırılır.
NVIDIA GPU’lar: NVIDIA Container Runtime gerektirir, CUDA hızlandırmasını destekler.
ARM/Qualcomm: Uygun cihazlarda donanım hızlandırma mevcuttur.
Ayrıca Docker Model Runner, Vulkan’ı Ekim 2025’ten beri destekliyor; bu da tümleşik GPU’lar ve AMD, Intel ve diğer üreticilerin GPU’ları dahil çok daha geniş bir yelpazede donanım hızlandırmayı mümkün kılıyor.
Modelleri yalnızca CPU üzerinde çalıştırabilirsiniz, ancak GPU desteği çıkarım performansını dramatik biçimde iyileştirir. Söz konusu olan, 10 saniye beklemek ile 3 saniye beklemek arasındaki farktır.
Önemli bir not: Bazı llama.cpp özellikleri 6xx serisi GPU’larda tam olarak desteklenmeyebilir ve MLX veya vLLM gibi ilave motorlar için destek gelecekte eklenecektir.
İşlerin gerçekten ilginçleştiği yer burası. Docker Model Runner’ın mimari tasarımı, geleneksel konteynerleştirmeden şaşırtıcı gelebilecek şekillerde ayrılıyor. Gelin, perde arkasında nasıl çalıştığını açıklayayım.
Docker Model Runner, Docker’ın orkestrasyon yeteneklerini yapay zekâ çıkarımı için ana makinenin yerel performansıyla birleştiren hibrit bir yaklaşım uygular. Bu mimariyi ayırt edici kılan nedir? Yapay zekâ iş yüklerini çalıştırma biçimimizi temelden yeniden düşünür.
Standart Docker konteynerlerinden farklı olarak çıkarım motoru aslında bir konteyner içinde çalışmaz. Bunun yerine çıkarım sunucusu motor olarak llama.cpp’yi kullanır; modelleri talep üzerine yükleyen ve çıkarımı doğrudan donanımınız üzerinde gerçekleştiren yerel bir ana makine süreci olarak çalışır.
Bu neden önemli? Bu tasarım seçimi, GPU hızlandırma için Apple’ın Metal API’sine doğrudan erişim sağlar ve sanal makineler içinde çıkarım çalıştırmanın performans yükünü ortadan kaldırır. Model depolama ile yürütmenin ayrıştırılması bilinçlidir: Modeller ayrı depolanır ve yalnızca gerektiğinde belleğe yüklenir, ardından bir süre etkinlik olmadığında boşaltılır.
Şimdi, bu parçaların nasıl bir araya geldiğine daha geniş açıdan bakalım. Üst düzeyde Docker Model Runner; model çalıştırıcı, model dağıtım araçları ve model CLI eklentisi olmak üzere üç yüksek seviyeli bileşenden oluşur. Bu modüler mimari, daha hızlı yineleme ve farklı ilgialanları arasında daha net API sınırları sağlar.
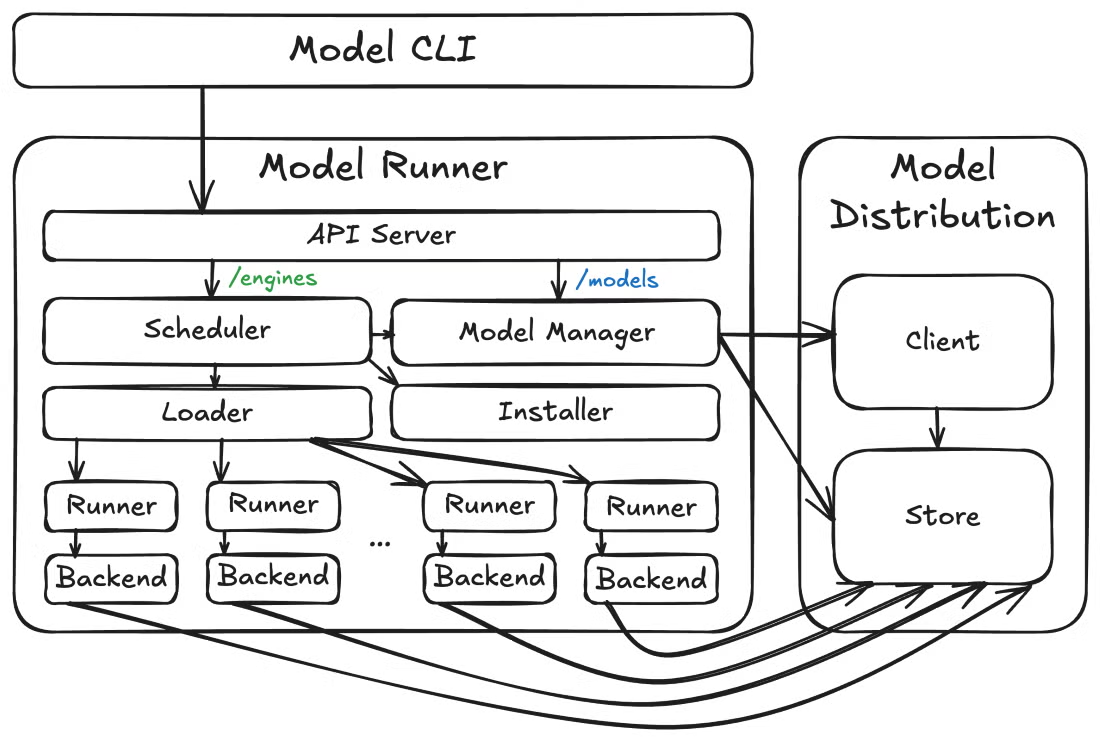
Çekirdek mimarinin ötesinde Docker Model Runner operasyonel ihtiyaçları da öngörür. Model Runner, /metrics altında metrik uç noktaları sunar; böylece model performansını, istek istatistiklerini ve kaynak kullanımını izleyebilirsiniz. Bu yerleşik gözlemlenebilirlik, model davranışı ve kaynak tüketimi üzerinde görünürlük gerektiren üretim dağıtımları için kritiktir.
Mimari akla yattığına göre, muhtemelen şunu merak ediyorsunuz: bununla pratikte neler yapabilirim? Yapay zekâ geliştirme iş akışlarımda Docker Model Runner’ı cazip kılan özellikleri anlatayım.
Öne çıkan yeteneklerin hızlı bir özeti:
|
Özellik |
Fayda |
En Uygun Kullanım |
|
Açık Kaynak & Ücretsiz |
Lisans maliyeti yok Tam şeffaflık |
Deney Öğrenme Üretim kullanımı |
|
Docker CLI Entegrasyonu |
Alışıldık komutlar (docker model pull/run/list) |
Yeni araç öğrenmek istemeyen Docker kullanıcıları |
|
OCI Uyumlu Paketleme |
Kayıtlar üzerinden standart model dağıtımı |
Sürüm kontrolü Erişim yönetimi |
|
OpenAI API Uyumluluğu |
Bulut API’leri için doğrudan ikame |
Buluttan yerele kolay geçiş |
|
Korumalı Yürütme |
Güvenlik için izole ortam |
Kurumsal uyumluluk gereksinimleri |
|
GPU Hızlandırma |
2-3 kat daha hızlı çıkarım |
Gerçek zamanlı uygulamalar Yüksek iş hacmi |
Docker Model Runner’ın Temel Özellikleri
Komut satırı arabirimi, mevcut Docker iş akışlarına sorunsuz entegre olur. Şu komutları kullanırsınız: docker model pull, docker model run ve docker model list; tıpkı konteynerlerle çalışırken bildiğiniz kalıplar gibi.
Docker Desktop’taki grafik arabirim, ilk kez yapay zekâ ile çalışan geliştiricilere bile kılavuzlu bir başlangıç sunar; RAM ve GPU gibi mevcut kaynakları otomatik olarak yönetir.
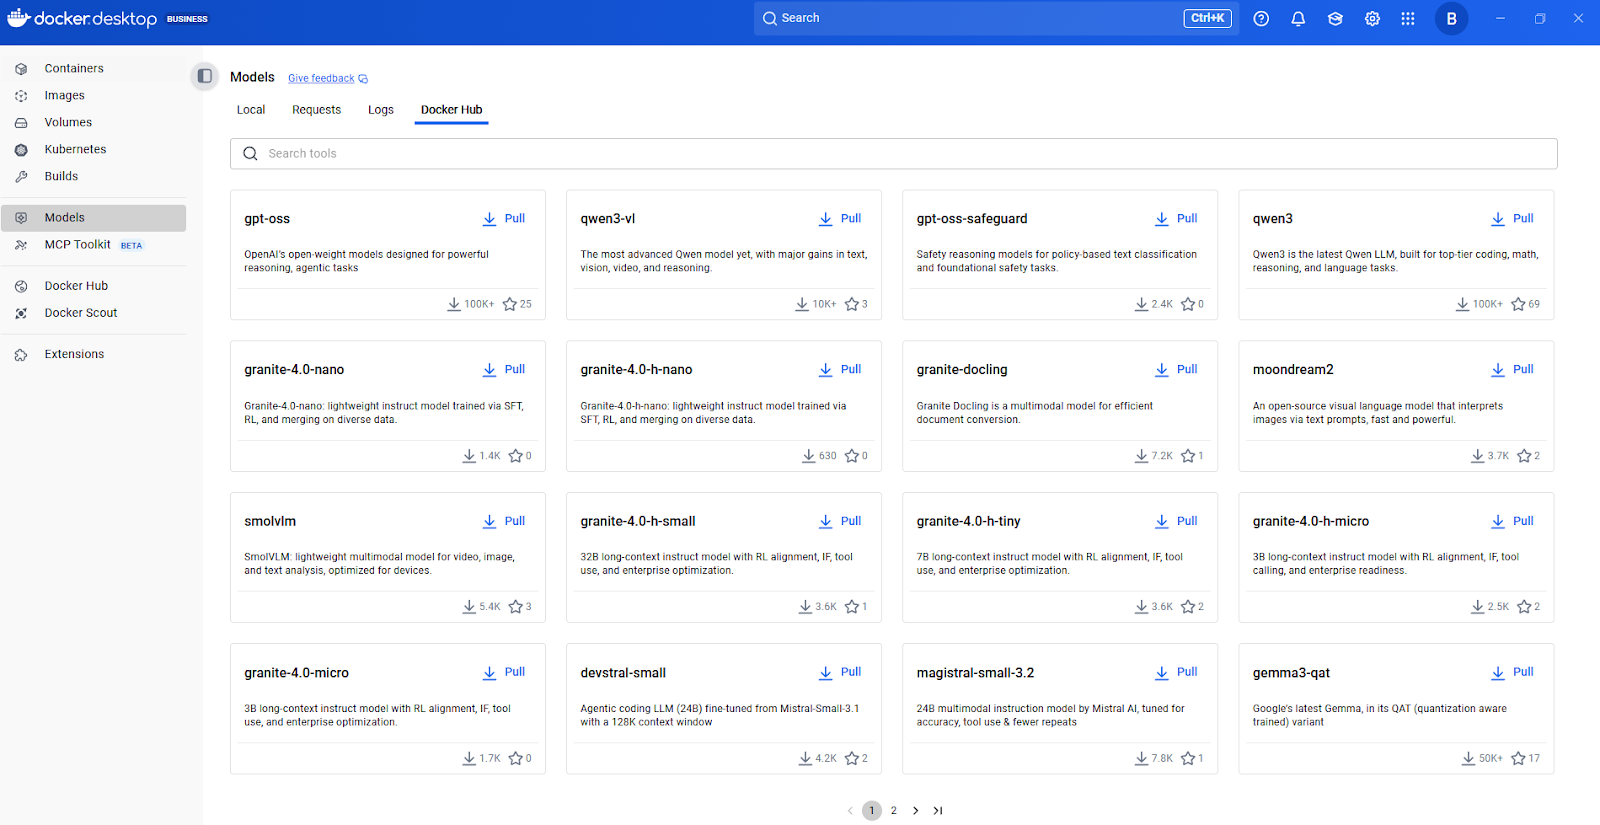
Docker Model Hub
Şimdi, modellerin nasıl paketlendiği ve dağıtıldığına bakalım. Docker Model Runner, modellerin OCI ile paketlenmesini destekler; böylece Docker Hub dahil OCI uyumlu herhangi bir kayıt üzerinden modelleri depolayabilir ve dağıtabilirsiniz. Bu standartlaştırılmış paketleme yaklaşımı, konteyner imajları için kullanılan aynı sürümleme, erişim kontrolü ve dağıtım kalıplarını uygulayabileceğiniz anlamına gelir.
Uygulamalarla entegrasyona geldiğinde REST API yetenekleri özellikle değerlidir. Docker Model Runner, llama.cpp üzerine inşa edilmiş ve tanıdık OpenAI API’si üzerinden erişilebilen bir çıkarım motoru içerir.
Bu OpenAI uyumluluğu, OpenAI’nin API’si için yazılmış mevcut kodların, bulut API’si yerine yerel uç noktaya yönlendirilmesiyle minimum değişiklikle yerel modellerle çalışabileceği anlamına gelir. Bu esneklik tek başına haftalarca yeniden düzenleme maliyetini kurtarabilir.
Docker Model Runner’ı sisteminizde çalışır hâle getirme sürecinde size rehberlik edeyim. Kurulum süreci basittir; ancak baştan bilmeye değer platforma özgü bazı hususlar vardır.
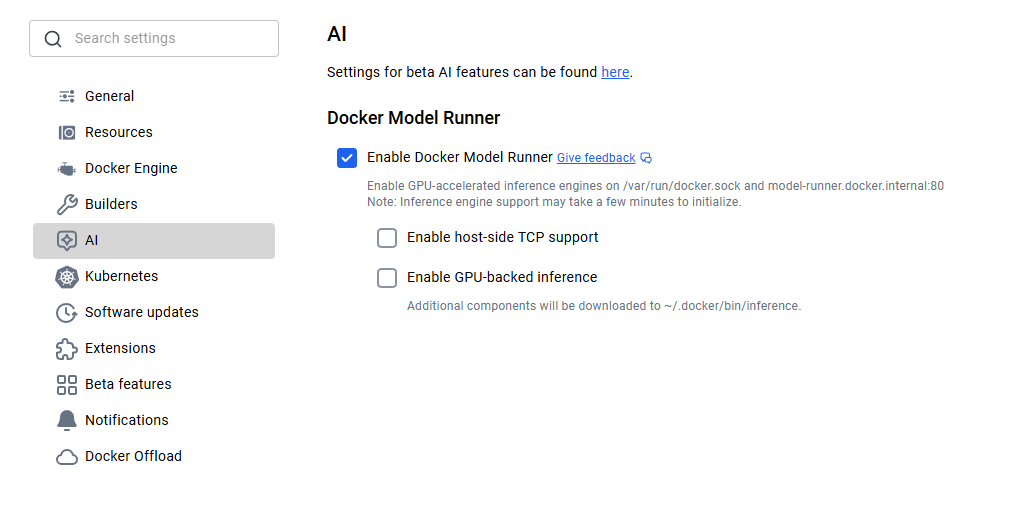
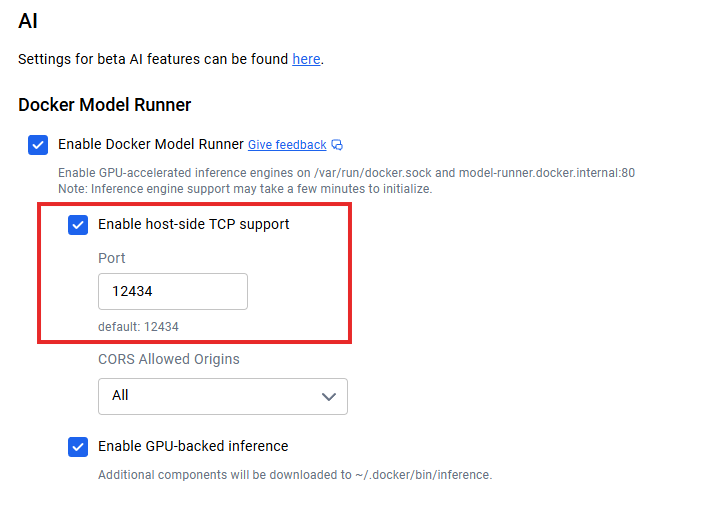
macOS ve Windows kullanıcıları için Docker Model Runner, Docker Desktop 4.40 veya üzeri ile birlikte gelir. Docker’ın resmi web sitesinden en güncel sürümü indirip kurun. Kurulumdan sonra ayarlardan Docker Model Runner’ı etkinleştirmeniz gerekir. Settings > AI yolunu izleyin ve bilgisayarınız NVIDIA GPU destekliyorsa Docker Model Runner seçeneğini ve GPU-arkayüz çıkarımı seçeneğini işaretleyin.
Docker Model Runner Etkinleştirme
Linux kullanıcıları daha da sade bir deneyim elde eder. Sisteminizi güncelleyin ve aşağıdaki komutlarla Docker Model Runner eklentisini kurun.
sudo apt-get update
sudo apt-get install docker-model-plugin
Kurulumdan sonra, docker model version komutunu çalıştırarak her şeyin çalıştığını doğrulayın.
Apple Silicon kullanıyorsanız, Metal üzerinden GPU hızlandırması otomatik olarak yapılandırılır ve ek kurulum gerekmez. NVIDIA GPU’lar için NVIDIA Container Runtime’ın kurulu olduğundan emin olun.
Vulkan desteğiyle artık Vulkan API’sini destekleyen AMD, Intel ve diğer GPU’larda donanım hızlandırmadan yararlanabilirsiniz. Sistem, donanımınızı akıllıca algılar ve uygun hızlandırmayı uygular.
Kurulum tamamlandıktan sonra bir modeli indirmek çok kolaydır. Önce modeli çekmeniz, ardından onunla etkileşime geçmek için çalıştırmanız yeterlidir:
docker model pull ai/smollm2
docker model run ai/smollm2
Her şey doğru şekilde kurulduysa, modeli listede görmelisiniz:
docker model listMODEL NAME
ai/smollm2Docker Model Runner’ı kurup modelleri nasıl çekeceğinizi anladıktan sonra doğal soru şu oluyor: Bu modeller nereden geliyor ve bunları ölçekli olarak nasıl yönetirim? Docker Model Runner’ın yaklaşımının özellikle zarif olduğu yer burası.
Docker, modelleri, konteynerler için kullanılan aynı kayıt ve iş akışları üzerinden dağıtıma imkân veren açık bir standart olan OCI Artifact’leri olarak paketler. Özel Docker kayıtlarını zaten kullanan ekipler, aynı altyapıyı yapay zekâ modelleri için de kullanabilir. Docker Hub, ilke tabanlı erişim kontrolleri için Registry Access Management gibi kurumsal özellikler sağlar.
Hugging Face ile entegrasyon özel bir anmayı hak ediyor. Geliştiriciler, Docker Model Runner’ı Hugging Face üzerindeki modelleri çalıştırmak için yerel çıkarım motoru olarak kullanabilir ve desteklenen modelleri (GGUF formatı gereklidir) doğrudan Hugging Face arayüzünde filtreleyebilir. Bu, model keşfini önemli ölçüde kolaylaştırır.
docker model pull hf.co/bartowski/Llama-3.2-1B-Instruct-GGUFBu entegrasyonun perde arkasında nasıl çalıştığı ise gerçekten zekice. GGUF formatında Hugging Face’ten bir model çektiğinizde, Docker Model Runner onu otomatik olarak anında bir OCI artifact’i olarak paketler. Bu kesintisiz dönüşüm, manuel paketleme adımlarını ortadan kaldırır ve model keşfinden dağıtıma giden yolu hızlandırır.
Dağıtım mekanizmasını anlamak harika, peki gerçekte hangi modelleri çalıştırabilirsiniz? Hazır gelenleri ve daha fazlasını nasıl bulacağınızı göstereyim.
Docker Model Runner, anında kullanıma hazır, özenle seçilmiş bir model yelpazesi sunar. SmolLM2, sohbet asistanları, metin çıkarımı, yeniden yazma ve özetleme görevleri için mükemmel, 360 milyon parametreli popüler bir seçimdir. Küçük boyutu ve hızlı çıkarımı sayesinde bu modeli geliştirme ve test için özellikle kullanışlı buluyorum.
Ek modeller keşfetmek için başlangıç noktası olarak Docker Hub’ın yapay zekâ modeli kataloğunu öneririm. Mevcut modelleri inceleyin, desteklenen görevler ve donanım gereksinimleri için dokümantasyonlarını kontrol edin, ardından basit bir docker model pull komutuyla indirin.
Modeller ilk kullanımda Docker Hub’dan çekilir ve yerelde depolanır; yalnızca çalışma zamanında bir istek geldiğinde belleğe yüklenir, kullanılmadığında boşaltılır ve kaynaklar optimize edilir.
Bu yaklaşım, birden fazla modeli indirmiş olsanız bile sisteminizin duyarlı kalmasını sağlar. Her şeyi aynı anda RAM’de tutmaya zorlanmazsınız.
Her model listesindeki niceleme düzeyleri (ör. Q4_0, Q8_0) model boyutunu ve çıkarım kalitesini etkiler.
|
Niceleme Düzeyi |
Açıklama |
Dosya Boyutu |
Kalite |
En Uygun Kullanım |
|
Q8_0 |
8 bit niceleme |
En büyük |
En yüksek kalite |
Üretim kullanımı, doğruluk kritik görevler |
|
Q5_0 |
5 bit niceleme |
Orta |
İyi denge |
Genel amaçlı, dengeli performans |
|
Q4_0 |
4 bit niceleme |
En küçük |
Kabul edilebilir |
Geliştirme, test, kaynak kısıtlı ortamlar |
Model Niceleme
Önemli bir husus da model sürümlemesidir. Docker imajlarına benzer şekilde etiketler (Q4_0 veya latest gibi) kullanarak tam sürümleri belirtebilirsiniz. Bu, tekrarlanabilir dağıtımları sağlar ve modeller güncellendiğinde beklenmedik değişiklikleri önler.
Modelleri yerelde çalıştırdıktan sonra şu soru gündeme gelir: Uygulamalarımı nasıl bağlarım? Ana makine tarafında TCP desteği etkinleştirildiğinde (ör. Docker Desktop’un TCP ayarlarıyla), varsayılan API uç noktası localhost:12434 üzerinde çalışır ve OpenAI uyumlu uç noktalar sunar.
Docker Model Runner API Entegrasyonu
Basit bir istek örneği şöyle:
curl http://localhost:12434/engines/llama.cpp/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "ai/smollm2",
    "messages": [{"role": "user", "content": "Explain containerization"}],
    "stream": false
  }'
Mikroservis mimarilerinde, uygulama konteynerleriniz model servisiyle standart HTTP protokolleri üzerinden iletişim kurabilir—özel SDK’lar gerekmez. Gerçek zamanlı uygulamalar için yanıt akışı, "stream": true ayarlanarak desteklenir.
REST API dokümantasyonu, tam uç nokta tanımlarını, parametre seçeneklerini ve yanıt şemalarını sağlar. Platform hızla evrilmeye devam ettiği için en güncel API detayları için resmi Docker dokümantasyonuna başvurmanızı öneririm.
Docker Model Runner’dan en iyi performansı almak, birkaç kilit stratejiyi anlamayı gerektirir. Yerel model dağıtımlarından edindiğim deneyimleri paylaşayım.
Model Runner, GPU’ya doğrudan erişimi olan ana makine düzeyinde bir süreç olarak çalışarak konteynerleştirilmiş çözümlerden daha iyi performans optimizasyonu sağlar. Bu mimari karar, çıktı hacmi ve gecikme açısından karşılığını verir; ancak en iyi sonucu almak için yine de uygun ayarları yapmanız gerekir.
Donanım hızlandırma, ilk optimizasyon kolunuzdur. GPU desteğini etkinleştirmek genellikle yalnızca CPU ile çıkarıma kıyasla 2-3 kat performans artışı sağlar. Donanımın ötesinde, model nicelemesi ikinci büyük ayar düğmenizdir. En iyi kalite için genellikle Q8_0 ile başlar, daha iyi performans gerekirse Q5_0 veya Q4_0’a geçerim.
/metrics altındaki yerleşik metrik uç noktası, Prometheus veya mevcut izleme yığınınızla izlemeye imkân tanır. Ölçekleme için, maksimum değerleri kullanmak yerine gerçek ihtiyaçlara göre bağlam uzunluğu yapılandırın. Uygulamanız yalnızca 2048 belirteçlik bağlama ihtiyaç duyuyorsa, 8192 olarak yapılandırmayın.
Docker Model Runner’ın en güçlü avantajlarından biri, daha geniş Docker ekosistemiyle nasıl entegre olduğudur.
Docker Model Runner, Docker Compose’u destekler. Bu, bir hizmetin yapay zekâ modeli olduğu çoklu hizmetli uygulamaları tanımlayabileceğiniz ve tüm yığını tanıdık Docker Compose dosyalarıyla yönetebileceğiniz anlamına gelir. Görünümü şöyledir:
services:
  app:
    image: my-app:latest
    models:
      - llm
      - embedding

models:
  llm:
    model: ai/smollm2
  embedding:
    model: ai/embeddinggemma
CI/CD iş akışlarını da otomatikleştirebilirsiniz: Test ortamınızda modelleri ayağa kaldırın, bunlara karşı entegrasyon testleri çalıştırın ve her şeyi kapatın; tümü mevcut hat altyapınız içinde. Bu, yapay zekâ özellikleri için “benim makinemde çalışıyor” sorununu ortadan kaldırır.
Bir diğer ilginç entegrasyon da Docker Offload; gerektiğinde yerel iş akışınızı buluta genişletir. Hâlâ Beta bir özellik olsa da Docker Model Runner ile yerelde geliştirme yapmanıza, ardından gereksinimler yerel kapasiteyi aştığında kaynak yoğun çıkarımı bulut altyapısına aktarmanıza imkân tanır.
Docker Offload
Kubernetes üzerinde çalıştırma desteği de bir Helm chart’ı ve statik bir YAML dosyası olarak mevcuttur. Bu, yatay ölçekleme, yük dengeleme ve yüksek erişilebilirliğin gerekli olduğu üretim ölçeğindeki dağıtımlar için kapılar açar.
Hâlâ deneysel olsa da Kubernetes entegrasyonu, Docker Model Runner’ın, saniyede binlerce isteği birden çok kopya üzerinden sunduğunuz kurumsal düzeyde dağıtımlara doğru evrimini temsil eder.
Tüm bu entegrasyon seçenekleriyle birlikte aklınıza şu gelebilir: peki bu güvenli mi? Docker Model Runner, güvenlik için korumalı alan sağlayan izole ve kontrollü bir ortamda çalışır. Bu izolasyon, modellerin açıkça sağlananın ötesinde hassas sistem kaynaklarına erişmesini engeller.
Birincil güvenlik faydası veri gizliliğidir. Çıkarım istekleriniz altyapınızı asla terk etmez; bu da veri sızdırma risklerini ortadan kaldırır. Hassas verilerle çalışan kuruluşlar için bu yerel yürütme modeli, GDPR, HIPAA ve diğer gizlilik düzenlemelerine uyum için esastır.
Yöneticiler, ayrıntılı güvenlik kontrolü için ana makine tarafı TCP desteğini ve CORS’u yapılandırabilir. Kayıtlardaki model lisanslama meta verileri, kurumsal yönetişim için uyumluluk takibi ve denetim izlerini mümkün kılar.
Artık şunu düşünüyor olabilirsiniz: bu, hâlihazırda kullandığım araçlarla nasıl kıyaslanır? Docker Model Runner’ın Ollama ve NVIDIA NIM ile karşılaştırması şöyle:
|
Özellik |
Docker Model Runner |
Ollama |
NVIDIA NIM |
|
Performans |
Ollama’dan 1,00-1,12x daha hızlı |
Temel performans |
NVIDIA GPU’lar için yüksek düzeyde optimize |
|
Ekosistem Entegrasyonu |
Yerel Docker iş akışı, OCI artifact’leri |
Bağımsız araç, ayrı iş akışı |
Konteynerleştirilmiş, NVIDIA’ya özgü |
|
Model Özelleştirme |
Docker Hub’dan ön paketli modeller |
Özel Modelfile’lar, GGUF/Safetensors içe aktarma |
Yalnızca NVIDIA için optimize modeller |
|
Platform Desteği |
macOS, Windows, Linux |
macOS, Windows, Linux, Docker |
Yalnızca NVIDIA GPU’lu Linux |
|
Donanım Gereksinimleri |
Herhangi bir GPU (Metal, CUDA, Vulkan) veya CPU |
Herhangi bir GPU veya CPU |
NVIDIA GPU gerektirir |
|
Topluluk & SDK’lar |
Büyüyen, Docker ekosistemi odaklı |
Olgun, kapsamlı |
NVIDIA ekosistemi, kurumsal odaklı |
|
En Uygun |
Docker altyapısına sahip ekipler |
Bağımsız yapay zekâ projeleri, hızlı deneyler |
NVIDIA odaklı üretim dağıtımları |
Docker Model Runner için temel ayırt edici unsur ekosistem entegrasyonudur. Yapay zekâ modellerini konteynerlerle eşdeğer birer birinci sınıf varlık olarak ele alır ve Docker odaklı ekipler için araç dağınıklığını azaltır.
Ollama, daha fazla model özelleştirmesi ve kapsamlı SDK’larla olgun bir topluluk sunar. NVIDIA NIM, NVIDIA GPU’ları için en yüksek performansı sağlar; ancak diğer seçeneklerin esnekliği ve çapraz platform desteğinden yoksundur.
Kapanıştan önce, işler yolunda gitmediğinde neler olacağına değinelim.
Bu hata genellikle Docker CLI’ın eklenti çalıştırılabilir dosyasını bulamadığını gösterir.
Neden: Docker, beklenen CLI eklenti dizininde eklentiyi bulamıyor.
Çözüm: Büyük olasılıkla çalıştırılabilir dosyaya bir sembolik bağ (symlink) oluşturmanız gerekir. Spesifik komutlar için lütfen kurulum bölümüne geri dönün.
Şu anda, belirli özetleri kullanarak modelleri çekmek veya referans vermek başarısız olabilir.
Geçici çözüm: Modellere özetleri yerine etiket adlarıyla (örn. model:v1) başvurun.
Durum: Mühendislik ekibi, gelecekteki bir sürüm için doğru özet desteği üzerinde aktif olarak çalışıyor.
Modelleriniz yavaş çalışıyor veya GPU’yu kullanmıyorsa şu kontrolleri yapın:
Sürücüleri Doğrulayın: Ana makinenizin GPU sürücülerinin güncel olduğundan emin olun.
İzinleri Kontrol Edin: Docker’ın GPU kaynaklarına erişim iznine sahip olduğunu doğrulayın.
Linux (NVIDIA): NVIDIA Container Runtime’ın kurulu ve yapılandırılmış olduğundan emin olun.
Doğrulama: GPU’nun sistem tarafından görülebildiğini teyit etmek için şu komutu çalıştırın: nvidia-smi
Burada listelenmeyen bir sorunla karşılaşırsanız:
Issue açın: Hataları bildirin veya özellik isteğinde bulunun: resmi GitHub deposu.
Topluluk: Uç durumlar için hızlı geçici çözümler sunan aktif bir topluluk vardır.
Docker Model Runner, yapay zekâ geliştirmeyi daha erişilebilir kılma yönünde önemli bir adımdır. Model yönetimini Docker ekosistemine taşıyarak, yapay zekânın tarihsel olarak benimsenmesini yavaşlatan sürtünmeyi ortadan kaldırır.
Stratejik önem, kullanım kolaylığının ötesine uzanır. Veri gizliliği, maliyet kontrolü ve geliştirme hızının her zamankinden daha önemli olduğu bir çağda, yerel yapay zekâ çalıştırma giderek kritik hâle geliyor. Docker Model Runner, geliştiricilerin her gün kullandığı aynı Docker komutları ve iş akışlarıyla deney yapmayı ve yapay zekâ uygulamaları geliştirmeyi kolaylaştırır.
İleriye baktığımızda, platform; ek çıkarım kütüphaneleri desteği, gelişmiş yapılandırma seçenekleri ve dağıtık dağıtım yetenekleriyle evrilmeye devam ediyor. Konteynerleştirme ve yapay zekânın yakınsaması sektörün yöneldiği yer ve Docker Model Runner bu kesişimde konumlanarak, Docker kullanan milyonlarca geliştirici için gizlilik odaklı, maliyet etkin yapay zekâ geliştirmeyi gerçeğe dönüştürüyor.
Artık modelleri yerel Docker ortamınızda çalıştırdığınıza göre, bir sonraki adım bunların etrafında güvenilir bir hat (pipeline) kurmaktır. Model sürümleme, dağıtım ve yaşam döngüsü yönetiminin ilkelerini DataCamp üzerindeki MLOps Fundamentals Skill Track ile öğrenin.
Docker Kursları
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Program} other {Program}}
{count, plural, one {Program} other {Program}}
{count, plural, one {blog} other {blog}}
Abid Ali Awan
14 dk.
{count, plural, one {blog} other {blog}}
Dario Radečić
15 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Kurtis Pykes
8 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Adel Nehme



