
Corso
Introduzione a Docker
4 ore
52.3K
Man mano che l’IA generativa continua a trasformare lo sviluppo software, ho notato una sfida persistente: eseguire modelli di IA in locale resta più complesso del necessario.
Gli sviluppatori si scontrano con strumenti frammentati, problemi di compatibilità hardware e workflow che sembrano scollegati dall’ambiente di sviluppo quotidiano. Docker Model Runner è stato lanciato nell’aprile 2025 per rispondere a queste sfide, rendendo più semplice eseguire e testare modelli di IA in locale all’interno dei workflow Docker esistenti.
Docker Model Runner segna un passaggio dall’IA basata sul cloud a workflow locali e containerizzati, offrendo vantaggi come privacy dei dati, riduzione dei costi e iterazioni più rapide, il tutto integrato con l’ecosistema Docker. Per la mia esperienza con i deployment di IA, questi vantaggi sono fondamentali per i team che costruiscono applicazioni pronte per la produzione mantenendo il controllo sui dati sensibili.
Se sei alle prime armi con Docker, ti consiglio questo corso introduttivo su Docker.
Il serving tradizionale dei modelli di IA presenta diverse criticità che ho riscontrato in prima persona.
I modelli di IA contengono pesi matematici che, a differenza delle immagini Docker tradizionali, non traggono beneficio dalla compressione. Questo crea inefficienze di storage quando i modelli sono impacchettati insieme al runtime. Inoltre, configurare i motori di inferenza, gestire l’accelerazione hardware e mantenere strumenti separati per modelli e container applicativi aggiunge complessità inutile.
È proprio qui che entra in gioco Docker Model Runner. Invece di aggiungere un altro strumento allo stack, semplifica il pull, l’esecuzione e la distribuzione dei Large Language Model (LLM) direttamente da Docker Hub in formato conforme OCI (Open Container Initiative) format o da Hugging Face se i modelli sono disponibili in GPT-Generated Unified Format (GGUF). La piattaforma affronta il problema della frammentazione portando la gestione dei modelli nello stesso workflow che gli sviluppatori usano per i container.
Il contesto storico è importante. Con l’adozione dell’IA generativa in accelerazione, il settore ha visto una tendenza crescente verso workflow di IA sicuri e local-first. Le organizzazioni sono diventate sempre più attente a privacy dei dati, costi delle API e lock-in del fornitore legati ai servizi di IA nel cloud.
Docker ha collaborato con nomi influenti nell’IA e nello sviluppo software, tra cui Google, Continue, Dagger, Qualcomm Technologies, Hugging Face, Spring AI e VMware Tanzu AI Solutions, riconoscendo che gli sviluppatori avevano bisogno di un modo migliore per lavorare con i modelli di IA in locale senza rinunciare alle comodità delle pratiche di sviluppo moderne.
Prima di entrare in Docker Model Runner, ti illustro i requisiti di sistema necessari. La buona notizia è che se già usi Docker, sei a metà dell’opera. Docker Model Runner è ora generalmente disponibile e funziona con tutte le versioni di Docker, supportando macOS, Windows e Linux.
Sebbene Docker Model Runner sia stato rilasciato esclusivamente su Docker Desktop, da dicembre 2025 è compatibile con qualsiasi piattaforma che supporti Docker Engine.
Ecco cosa ti serve sulle diverse piattaforme:
|
Componente |
Requisito |
Note |
|
Sistema operativo |
macOS, Windows, Linux |
Sono supportate tutte le principali piattaforme |
|
Versione di Docker |
Docker Desktop Docker Engine |
Desktop per macOS/Windows Engine per Linux |
|
RAM |
8 GB minimo Consigliati 16 GB+ |
I modelli più grandi richiedono più memoria |
|
GPU (opzionale) |
Apple Silicon NVIDIA ARM/Qualcomm |
Offre un incremento prestazionale di 2-3x |
Requisiti di sistema per Docker Model Runner
Per l’accelerazione GPU, Docker Model Runner ora supporta diversi backend:
Apple Silicon (M1/M2/M3/M4): usa le API Metal per l’accelerazione GPU, configurata automaticamente.
GPU NVIDIA: richiede NVIDIA Container Runtime, supporta l’accelerazione CUDA.
ARM/Qualcomm: accelerazione hardware disponibile sui dispositivi compatibili.
Inoltre, Docker Model Runner supporta Vulkan da ottobre 2025, abilitando l’accelerazione hardware su una gamma molto più ampia di GPU, incluse le integrate e quelle di AMD, Intel e altri vendor.
Anche se puoi eseguire i modelli solo su CPU, il supporto GPU migliora drasticamente le prestazioni di inferenza. Parliamo della differenza tra attendere 10 secondi e 3 secondi per le risposte.
Nota importante: alcune funzionalità di llama.cpp potrebbero non essere pienamente supportate sulle GPU serie 6xx e il supporto per motori aggiuntivi come MLX o vLLM sarà aggiunto in futuro.
Qui la cosa si fa davvero interessante. Il design architetturale di Docker Model Runner si discosta dalla containerizzazione tradizionale in modi che potrebbero sorprenderti. Ti spiego come funziona sotto il cofano.
Docker Model Runner implementa un approccio ibrido che combina le capacità di orchestrazione di Docker con le prestazioni native dell’host per l’inferenza di IA. Cosa rende distintiva questa architettura? Ripensa in modo radicale come eseguiamo i carichi di lavoro di IA.
A differenza dei container Docker standard, il motore di inferenza in realtà non gira all’interno di un container. Il server di inferenza usa llama.cpp come engine, eseguendosi come processo nativo dell’host che carica i modelli su richiesta ed effettua l’inferenza direttamente sull’hardware.
Perché è importante? Questa scelta consente l’accesso diretto alle API Metal di Apple per l’accelerazione GPU ed evita l’overhead di eseguire l’inferenza dentro macchine virtuali. La separazione tra storage del modello ed esecuzione è intenzionale: i modelli sono archiviati separatamente e caricati in memoria solo quando servono, quindi scaricati dopo un periodo di inattività.
Facciamo ora uno zoom out per vedere come i pezzi si incastrano. A livello alto, Docker Model Runner è composto da tre componenti principali: il model runner, gli strumenti di distribuzione dei modelli e il plugin CLI per i modelli. Questa architettura modulare consente iterazioni più rapide e confini API più puliti tra le varie aree.
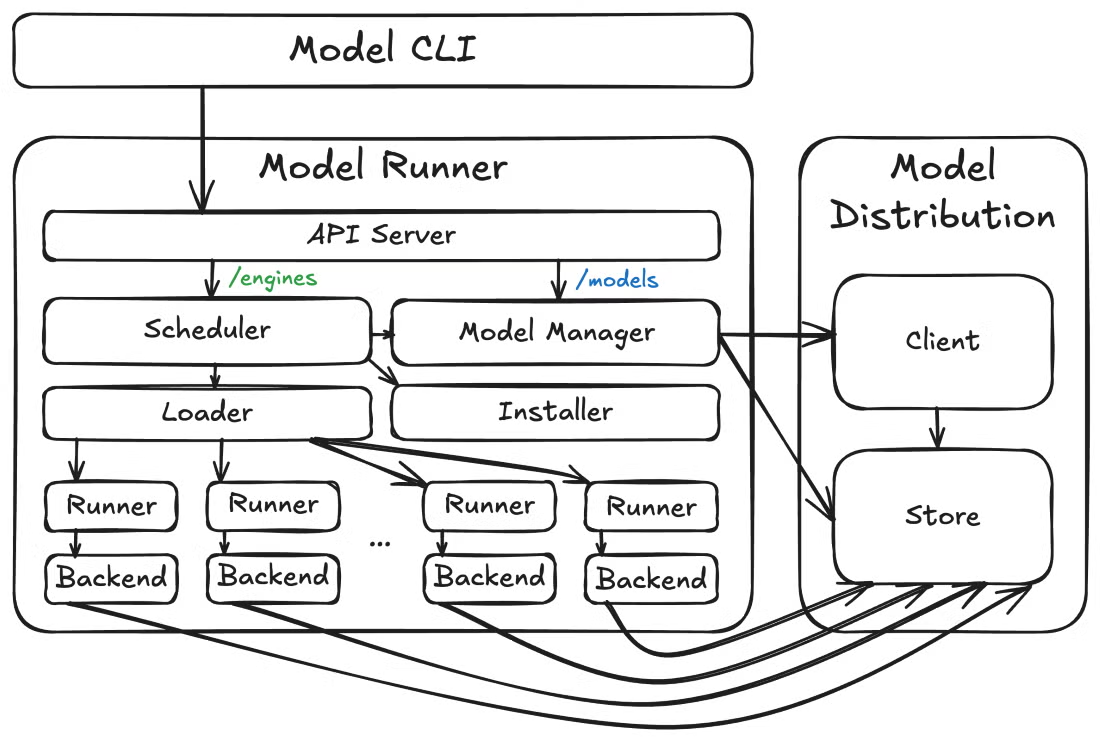
Architettura di Docker Model Runner
Oltre al cuore dell’architettura, Docker Model Runner anticipa anche le esigenze operative. Il Model Runner espone endpoint di metriche su /metrics, permettendoti di monitorare le prestazioni del modello, le statistiche delle richieste e l’uso delle risorse. Questa osservabilità integrata è cruciale per i deployment in produzione, dove serve visibilità sul comportamento del modello e sul consumo di risorse.
Capita l’architettura, probabilmente ti chiedi: cosa posso farci concretamente? Ti illustro le funzionalità che hanno reso Docker Model Runner interessante per i miei workflow di sviluppo IA.
Ecco una panoramica rapida delle capacità più rilevanti:
|
Funzionalità |
Vantaggio |
Ideale per |
|
Open source e gratuito |
Nessun costo di licenza Piena trasparenza |
Sperimentazione Apprendimento Uso in produzione |
|
Integrazione con Docker CLI |
Comandi familiari (docker model pull/run/list) |
Utenti Docker che non vogliono imparare nuovi strumenti |
|
Packaging conforme OCI |
Distribuzione standard dei modelli tramite registry |
Controllo versioni Gestione accessi |
|
Compatibilità con API OpenAI |
Sostituzione immediata delle API cloud |
Migrazione semplice dal cloud al locale |
|
Esecuzione sandboxed |
Ambiente isolato per la sicurezza |
Requisiti di conformità enterprise |
|
Accelerazione GPU |
Inferenza 2-3x più veloce |
Applicazioni real-time Alto throughput |
Funzionalità principali di Docker Model Runner
L’interfaccia a riga di comando si integra senza attriti con i workflow Docker esistenti. Userai comandi come docker model pull, docker model run e docker model list, seguendo gli stessi schemi che già conosci dal lavoro con i container.
L’interfaccia grafica di Docker Desktop offre un onboarding guidato per aiutare anche chi è alle prime armi con l’IA a pubblicare modelli senza intoppi, gestendo automaticamente risorse disponibili come RAM e GPU.
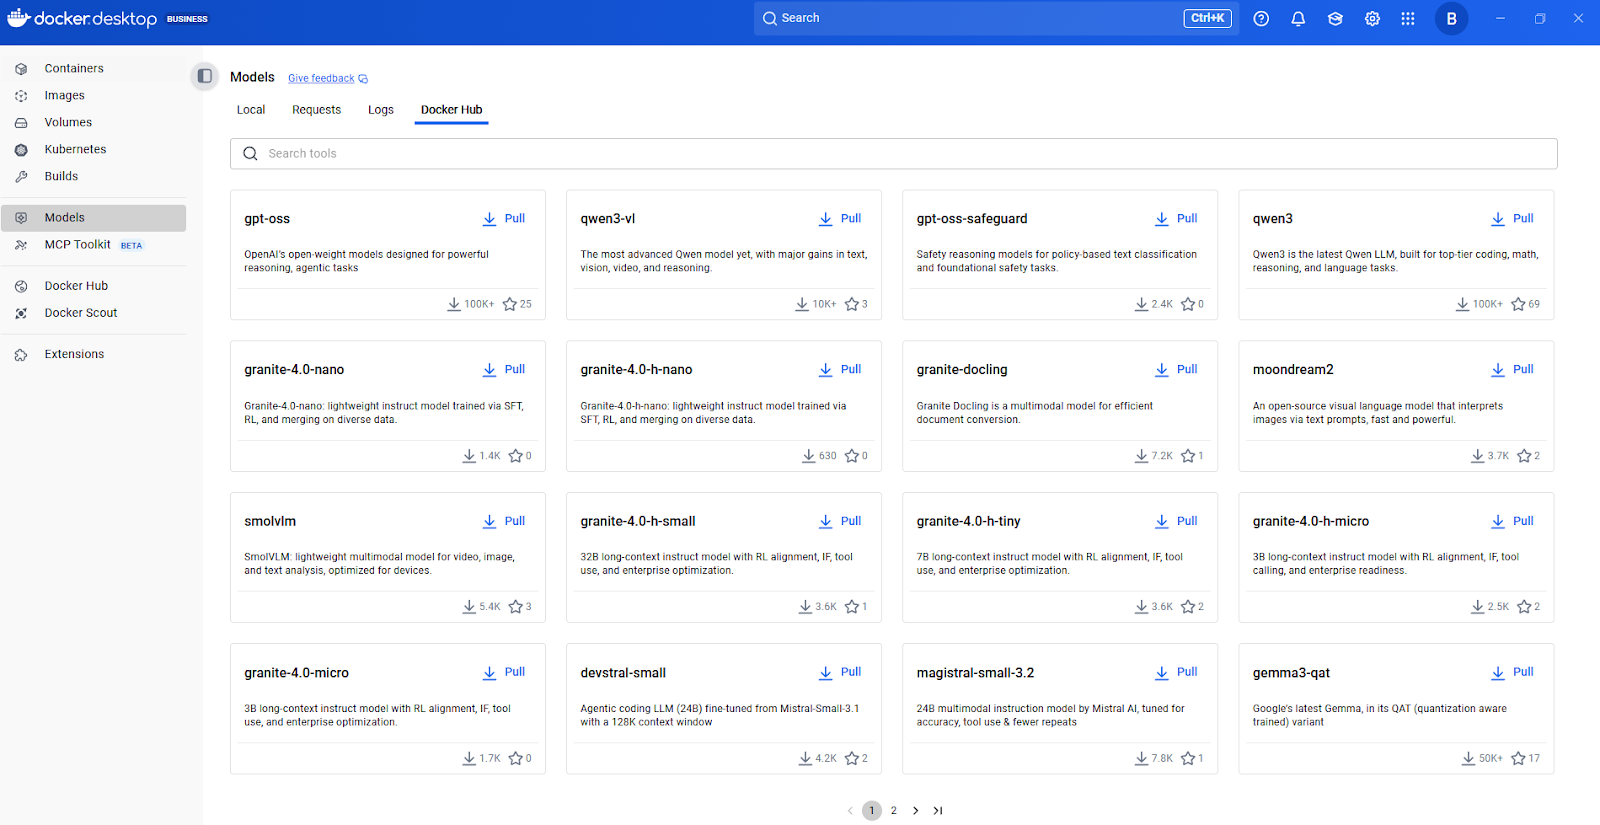
Docker Model Hub
Parliamo ora di come i modelli sono impacchettati e distribuiti. Docker Model Runner supporta modelli pacchettizzati OCI, permettendoti di archiviare e distribuire i modelli tramite qualsiasi registry compatibile OCI, incluso Docker Hub. Questo approccio standardizzato al packaging significa che puoi applicare le stesse pratiche di versioning, controllo accessi e distribuzione usate per le immagini dei container.
Per l’integrazione con le applicazioni, le capacità REST API sono particolarmente preziose. Docker Model Runner include un motore di inferenza basato su llama.cpp e accessibile tramite la familiare API OpenAI.
Questa compatibilità con OpenAI significa che il codice esistente scritto per l’API di OpenAI può funzionare con modelli locali con modifiche minime: è sufficiente puntare l’applicazione all’endpoint locale invece che all’API cloud. Questa flessibilità da sola può farti risparmiare settimane di refactoring.
Ti guido ora alla messa in opera di Docker Model Runner sul tuo sistema. Il processo di installazione è lineare, ma ci sono alcune considerazioni specifiche per piattaforma che vale la pena conoscere subito.
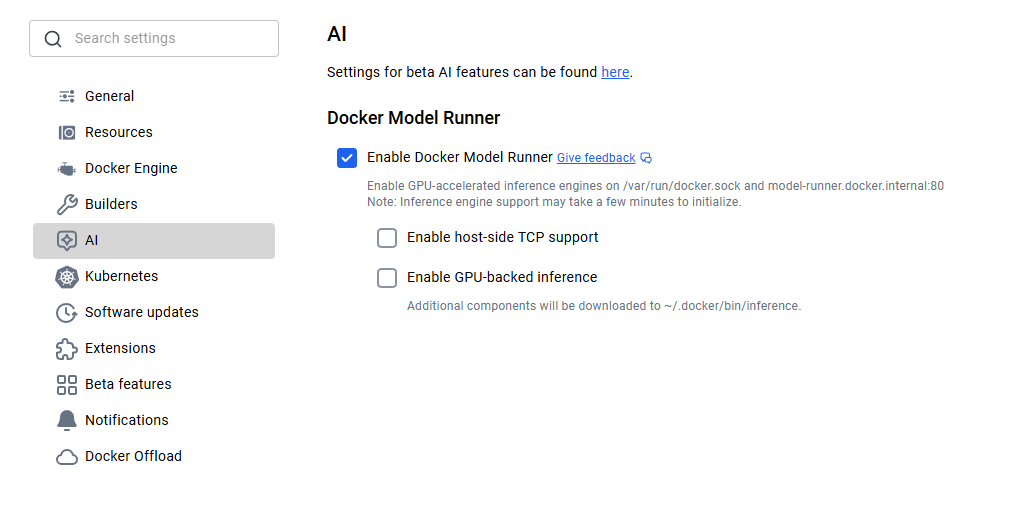
Per gli utenti macOS e Windows, Docker Model Runner è incluso in Docker Desktop 4.40 o superiore. Scarica semplicemente l’ultima versione dal sito ufficiale di Docker e installala. Una volta installato, dovrai abilitare Docker Model Runner nelle impostazioni. Vai su Settings > AI, seleziona l’opzione Docker Model Runner e il backend di inferenza GPU se il tuo computer supporta GPU NVIDIA.
Attivazione di Docker Model Runner
Gli utenti Linux hanno un’esperienza ancora più snella. Aggiorna il sistema e installa il plugin Docker Model Runner con i seguenti comandi.
sudo apt-get update
sudo apt-get install docker-model-plugin
Dopo l’installazione, verifica il funzionamento eseguendo docker model version.
Se sei su Apple Silicon, l’accelerazione GPU tramite Metal è configurata automaticamente e non richiede ulteriori setup. Per le GPU NVIDIA, assicurati di avere installato NVIDIA Container Runtime.
Con il supporto Vulkan, puoi ora sfruttare l’accelerazione hardware su GPU AMD, Intel e altre che supportano le API Vulkan. Il sistema rileva in modo intelligente il tuo hardware e applica l’accelerazione appropriata.
Una volta installato, scaricare un modello è semplicissimo. Ti basta prima effettuare il pull del modello e poi eseguirlo per interagirci:
docker model pull ai/smollm2
docker model run ai/smollm2
Se tutto è stato configurato correttamente, dovresti vedere il modello nell’elenco:
docker model listMODEL NAME
ai/smollm2Dopo aver installato Docker Model Runner e aver capito come effettuare il pull dei modelli, la domanda naturale è: da dove arrivano questi modelli e come li gestisco su larga scala? È qui che l’approccio di Docker Model Runner diventa particolarmente elegante.
Docker impacchetta i modelli come Artifact OCI, uno standard aperto che consente la distribuzione tramite gli stessi registry e workflow usati per i container. I team che già utilizzano registry Docker privati possono sfruttare la stessa infrastruttura per i modelli di IA. Docker Hub offre funzionalità enterprise come la Registry Access Management per controlli di accesso basati su policy.
L’integrazione con Hugging Face merita una menzione speciale. Gli sviluppatori possono usare Docker Model Runner come motore di inferenza locale per eseguire modelli su Hugging Face e filtrare i modelli supportati (è richiesto il formato GGUF) direttamente nell’interfaccia di Hugging Face. Questo semplifica notevolmente la discovery dei modelli.
docker model pull hf.co/bartowski/Llama-3.2-1B-Instruct-GGUFLa vera furbizia sta in come questa integrazione funziona sotto il cofano. Quando effettui il pull di un modello da Hugging Face in formato GGUF, Docker Model Runner lo impacchetta automaticamente come artifact OCI al volo. Questa conversione trasparente elimina passaggi manuali di packaging e accelera il percorso dalla discovery del modello al deployment.
Capire il meccanismo di distribuzione è utile, ma quali modelli puoi effettivamente eseguire? Ti mostro cosa è disponibile out-of-the-box e come trovarne altri.
Docker Model Runner offre una selezione curata di modelli pronti all’uso. SmolLM2 è una scelta popolare, perfetta per assistant di chat, estrazione di testo, rewriting e sintesi, con 360 milioni di parametri. Ho trovato questo modello particolarmente utile per sviluppo e test grazie alle dimensioni ridotte e all’inferenza veloce.
Per scoprire altri modelli, ti consiglio di partire dal catalogo dei modelli di IA su Docker Hub. Sfoglia i modelli disponibili, verifica la documentazione per i task supportati e i requisiti hardware, quindi esegui il pull con un semplice comando docker model pull.
I modelli vengono scaricati da Docker Hub la prima volta che li usi e sono archiviati in locale, caricati in memoria solo a runtime quando arriva una richiesta e scaricati quando non sono in uso per ottimizzare le risorse.
Questo approccio mantiene il sistema reattivo anche se hai più modelli scaricati. Non sei costretto a tenere tutto in RAM contemporaneamente.
Ogni scheda modello include informazioni sui livelli di quantizzazione (come Q4_0, Q8_0), che influiscono su dimensioni del modello e qualità dell’inferenza.
|
Livello di quantizzazione |
Descrizione |
Dimensione file |
Qualità |
Ideale per |
|
Q8_0 |
Quantizzazione a 8 bit |
Maggiore |
Qualità più alta |
Uso in produzione, task dove l’accuratezza è critica |
|
Q5_0 |
Quantizzazione a 5 bit |
Media |
Buon compromesso |
Uso generico, prestazioni bilanciate |
|
Q4_0 |
Quantizzazione a 4 bit |
Minore |
Accettabile |
Sviluppo, test, ambienti con risorse limitate |
Quantizzazione dei modelli
Un aspetto importante è il versioning dei modelli. Puoi specificare versioni esatte usando i tag (come Q4_0 o latest), in modo simile alle immagini Docker. Questo garantisce deployment riproducibili ed evita cambiamenti inattesi quando i modelli vengono aggiornati.
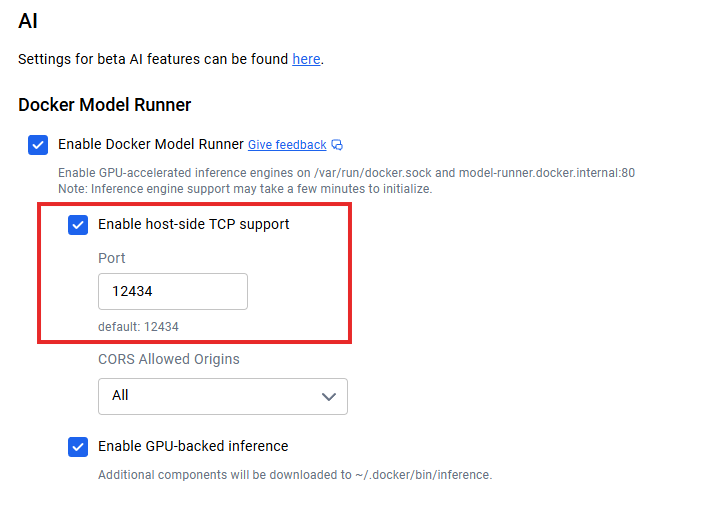
Una volta che hai i modelli in esecuzione in locale, la domanda diventa: come collego le mie applicazioni? Quando è abilitato il supporto TCP lato host (ad esempio tramite le impostazioni TCP di Docker Desktop), l’endpoint API predefinito gira su localhost:12434, esponendo endpoint compatibili con OpenAI.
Integrazione API di Docker Model Runner
Ecco un semplice esempio per effettuare una richiesta:
curl http://localhost:12434/engines/llama.cpp/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "ai/smollm2",
    "messages": [{"role": "user", "content": "Explain containerization"}],
    "stream": false
  }'
Per le architetture a microservizi, i container della tua applicazione possono comunicare con il servizio del modello usando i protocolli HTTP standard, senza SDK specifici. Lo streaming della risposta è supportato per le applicazioni real-time impostando "stream": true.
La documentazione REST API fornisce specifiche complete degli endpoint, opzioni dei parametri e schemi di risposta. Ti consiglio di consultare la documentazione ufficiale di Docker per i dettagli API più aggiornati, dato che la piattaforma evolve rapidamente.
Per ottenere prestazioni ottimali con Docker Model Runner è utile conoscere alcune strategie chiave. Condivido ciò che ho imparato lavorando con deployment di modelli locali.
Eseguendosi come processo a livello host con accesso diretto alla GPU, Model Runner ottiene un’ottimizzazione migliore rispetto alle soluzioni containerizzate. Questa scelta architetturale paga in termini di throughput e latenza, ma è comunque necessario un tuning adeguato per sfruttarla al massimo.
L’accelerazione hardware è la prima leva. Abilitare il supporto GPU fornisce in genere miglioramenti di 2-3x rispetto all’inferenza solo CPU. Oltre all’hardware, la quantizzazione del modello è la seconda leva principale. In genere parto da Q8_0 per la qualità migliore, poi passo a Q5_0 o Q4_0 se ho bisogno di più prestazioni.
L’endpoint di metriche integrato su /metrics consente il monitoraggio con Prometheus o il tuo stack di monitoring esistente. Per lo scaling, configura la lunghezza del contesto in base alle reali necessità invece di usare i valori massimi. Se la tua applicazione richiede solo 2048 token di contesto, non configurarla per 8192.
Uno dei punti di forza di Docker Model Runner è l’integrazione con il più ampio ecosistema Docker.
Docker Model Runner supporta Docker Compose. Questo significa che puoi definire applicazioni multi-servizio in cui un servizio è un modello di IA, gestendo l’intero stack con i familiari file Docker Compose. Ecco come si presenta:
services:
  app:
    image: my-app:latest
    models:
      - llm
      - embedding

models:
  llm:
    model: ai/smollm2
  embedding:
    model: ai/embeddinggemma
Puoi anche automatizzare i workflow CI/CD: avvia i modelli nell’ambiente di test, esegui test di integrazione su di essi e smonta tutto, il tutto all’interno dell’infrastruttura di pipeline esistente. Questo elimina il classico problema del “sul mio computer funziona” per le funzionalità di IA.
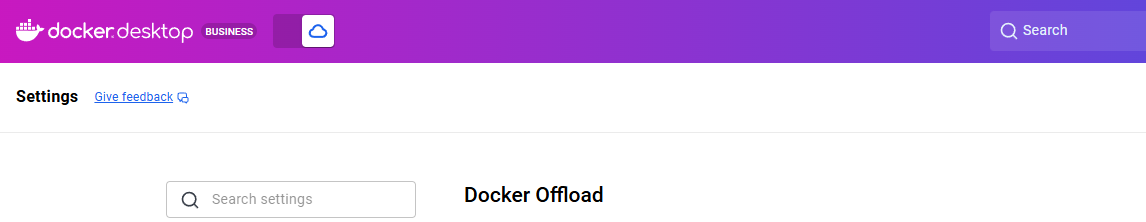
Un’altra integrazione interessante è Docker Offload, che estende il workflow locale al cloud quando necessario. Anche se è ancora una funzionalità Beta, ti consente di sviluppare in locale con Docker Model Runner e poi offloadare l’inferenza ad alto consumo di risorse su infrastruttura cloud quando i requisiti superano la capacità locale.
Docker Offload
È disponibile anche il supporto per l’esecuzione in Kubernetes tramite un chart Helm e un file YAML statico. Questo apre possibilità per deployment su scala di produzione con scaling orizzontale, bilanciamento del carico e alta disponibilità.
Sebbene ancora sperimentale, l’integrazione con Kubernetes rappresenta l’evoluzione di Docker Model Runner verso deployment di livello enterprise, dove si servono migliaia di richieste al secondo su più repliche.
Con tutte queste opzioni di integrazione potresti chiederti: ma è sicuro? Docker Model Runner gira in un ambiente isolato e controllato, fornendo sandboxing per la sicurezza. Questo isolamento impedisce ai modelli di accedere a risorse di sistema sensibili oltre a quelle esplicitamente fornite.
Il principale vantaggio in termini di sicurezza è la privacy dei dati. Le richieste di inferenza non lasciano mai la tua infrastruttura, eliminando i rischi di esfiltrazione dei dati. Per le organizzazioni che gestiscono dati sensibili, questo modello di esecuzione locale è essenziale per la conformità a GDPR, HIPAA e altre normative sulla privacy.
Gli amministratori possono configurare supporto TCP lato host e CORS per un controllo della sicurezza granulare. I metadati di licenza dei modelli nei registry abilitano il tracciamento della conformità e gli audit trail per la governance aziendale.
A questo punto potresti pensare: come si confronta con gli strumenti che già uso? Ecco come Docker Model Runner si posiziona rispetto a Ollama e NVIDIA NIM:
|
Funzionalità |
Docker Model Runner |
Ollama |
NVIDIA NIM |
|
Prestazioni |
Da 1,00 a 1,12x più veloce di Ollama |
Prestazioni baseline |
Altamente ottimizzato per GPU NVIDIA |
|
Integrazione con l’ecosistema |
Workflow Docker nativo, artifact OCI |
Strumento standalone, workflow separato |
Containerizzato, specifico per NVIDIA |
|
Personalizzazione dei modelli |
Modelli preconfezionati da Docker Hub |
Modelfile personalizzati, import GGUF/Safetensors |
Solo modelli ottimizzati NVIDIA |
|
Supporto piattaforme |
macOS, Windows, Linux |
macOS, Windows, Linux, Docker |
Solo Linux con GPU NVIDIA |
|
Requisiti hardware |
Qualsiasi GPU (Metal, CUDA, Vulkan) o CPU |
Qualsiasi GPU o CPU |
Richieste GPU NVIDIA |
|
Community e SDK |
In crescita, focus sull’ecosistema Docker |
Matura, ampia |
Ecosistema NVIDIA, orientato all’enterprise |
|
Ideale per |
Team con infrastruttura Docker |
Progetti di IA standalone, sperimentazione rapida |
Deployment in produzione focalizzati su NVIDIA |
Il principale elemento distintivo di Docker Model Runner è l’integrazione con l’ecosistema. Tratta i modelli di IA come risorse di prima classe accanto ai container, riducendo la proliferazione di strumenti per i team centrati su Docker.
Ollama offre maggiore personalizzazione dei modelli e una community matura con SDK estesi. NVIDIA NIM garantisce le massime prestazioni per GPU NVIDIA ma manca della flessibilità e del supporto multipiattaforma delle altre opzioni.
Prima di concludere, affrontiamo cosa succede quando qualcosa non funziona.
Questo errore in genere indica che la CLI Docker non riesce a trovare l’eseguibile del plugin.
Causa: Docker non trova il plugin nella directory dei plugin CLI prevista.
Soluzione: probabilmente devi creare un collegamento simbolico (symlink) all’eseguibile. Fai riferimento alla sezione installazione per i comandi specifici.
Attualmente, l’uso di digest specifici per effettuare il pull o fare riferimento ai modelli può fallire.
Workaround: fai riferimento ai modelli tramite il nome del tag (ad esempio, model:v1) invece che tramite il digest.
Stato: il team di engineering sta lavorando per un corretto supporto dei digest in una release futura.
Se i modelli risultano lenti o non utilizzano la GPU, esegui i seguenti controlli:
Verifica driver: assicurati che i driver GPU della macchina host siano aggiornati.
Controlla i permessi: verifica che Docker abbia i permessi per accedere alle risorse GPU.
Linux (NVIDIA): assicurati che NVIDIA Container Runtime sia installato e configurato.
Verifica: esegui il seguente comando per confermare che la GPU sia visibile al sistema: nvidia-smi
Se incontri un problema non elencato qui:
Apri una issue: segnala bug o richiedi funzionalità sul repository GitHub ufficiale.
Community: c’è una community attiva che spesso fornisce workaround rapidi per i casi limite.
Docker Model Runner rappresenta un passo avanti significativo nel rendere lo sviluppo di IA più accessibile. Portando la gestione dei modelli nell’ecosistema Docker, elimina gli attriti che storicamente hanno rallentato l’adozione dell’IA.
L’importanza strategica va oltre la comodità. In un’epoca in cui privacy dei dati, controllo dei costi e velocità di sviluppo contano più che mai, l’esecuzione locale dell’IA diventa sempre più cruciale. Docker Model Runner semplifica la sperimentazione e la creazione di applicazioni di IA usando gli stessi comandi e workflow Docker che gli sviluppatori già impiegano ogni giorno.
Guardando avanti, la piattaforma continua a evolvere con supporto per librerie di inferenza aggiuntive, opzioni di configurazione avanzate e capacità di deployment distribuiti. La convergenza tra containerizzazione e IA rappresenta la direzione del settore, e Docker Model Runner si colloca a questa intersezione, rendendo lo sviluppo di IA attento alla privacy e conveniente una realtà per milioni di sviluppatori che già usano Docker.
Ora che hai i modelli in esecuzione nel tuo ambiente Docker locale, il passo successivo è costruire una pipeline affidabile attorno ad essi. Apprendi i principi di versioning, deployment e gestione del ciclo di vita dei modelli con la Skill Track MLOps Fundamentals su DataCamp.
Corsi su Docker
Corso
Programma
Programma
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



