
कोर्स
Docker परिचय
4 घंटा
52.3K
जैसे-जैसे जनरेटिव AI सॉफ्टवेयर डेवलपमेंट को बदल रहा है, मैंने एक लगातार बनी रहने वाली चुनौती देखी है: लोकल पर AI मॉडल चलाना जितना आसान होना चाहिए, उतना नहीं है।
डेवलपर्स को बिखरे हुए टूलिंग, हार्डवेयर संगतता समस्याएँ, और ऐसे वर्कफ़्लो का सामना करना पड़ता है जो उनके रोज़मर्रा के डेवलपमेंट वातावरण से कटा हुआ लगता है। इन चुनौतियों से निपटने के लिए Docker Model Runner अप्रैल 2025 में लॉन्च किया गया, जिससे मौजूदा Docker वर्कफ़्लो के भीतर लोकल पर AI मॉडल चलाना और टेस्ट करना आसान हो गया।
Docker Model Runner क्लाउड-आधारित AI से लोकल, कंटेनराइज़्ड वर्कफ़्लो की ओर एक बदलाव का प्रतिनिधित्व करता है, जो डेटा गोपनीयता, लागत में कमी, और तेज़ इटरेशन जैसे लाभ प्रदान करता है—वह भी Docker इकोसिस्टम के साथ एकीकृत रहते हुए। AI डिप्लॉयमेंट्स पर काम करने के अपने अनुभव में, प्रोडक्शन-रेडी एप्लिकेशन बनाने वाली टीमों के लिए—और संवेदनशील डेटा पर नियंत्रण बनाए रखते हुए—ये फायदे बेहद अहम हैं।
यदि आप Docker में नए हैं, तो मैं यह Docker का परिचयात्मक कोर्स करने की सलाह देता/देती हूँ।
परंपरागत AI मॉडल सर्विंग कई चुनौतियाँ पेश करती है, जिनका सामना मैंने प्रत्यक्ष रूप से किया है।
AI मॉडल में गणितीय वेट्स होते हैं जिन्हें पारंपरिक Docker इमेज की तरह कंप्रेशन से लाभ नहीं मिलता। जब मॉडल को उनके रनटाइम के साथ पैकेज किया जाता है, तो इससे स्टोरेज की अक्षमताएँ पैदा होती हैं। साथ ही, इन्फ़रेंस इंजनों की सेटअप, हार्डवेयर एक्सेलेरेशन का प्रबंधन, और मॉडल बनाम एप्लिकेशन कंटेनर के लिए अलग-अलग टूलिंग बनाए रखना अनावश्यक जटिलता बढ़ाता है।
यहीं पर Docker Model Runner काम आता है। आपके स्टैक में एक और टूल जोड़ने के बजाय, यह सीधे Docker Hub से OCI-कंप्लायंट (Open Container Initiative) फॉर्मेट में, या Hugging Face से यदि मॉडल GPT-Generated Unified Format (GGUF) में उपलब्ध हों, बड़े लैंग्वेज मॉडल (LLMs) को पुल, रन, और वितरित करना आसान बनाता है। यह प्लेटफ़ॉर्म मॉडल मैनेजमेंट को उसी वर्कफ़्लो में लाकर फ्रैगमेंटेशन की समस्या का समाधान करता है, जिसका उपयोग डेवलपर्स कंटेनर्स के लिए करते हैं।
यहाँ ऐतिहासिक परिप्रेक्ष्य महत्वपूर्ण है। जैसे-जैसे जनरेटिव AI को अपनाना तेज़ हुआ, इंडस्ट्री में सुरक्षित, लोकल-फर्स्ट AI वर्कफ़्लो की ओर रुझान बढ़ा। संगठन क्लाउड-आधारित AI सेवाओं से जुड़े डेटा गोपनीयता, API लागत, और वेन्डर-लॉक-इन को लेकर अधिक चिंतित हो गए।
Docker ने Google, Continue, Dagger, Qualcomm Technologies, Hugging Face, Spring AI, और VMware Tanzu AI Solutions जैसे प्रभावशाली नामों के साथ साझेदारी की, यह मानते हुए कि डेवलपर्स को लोकल पर AI मॉडल के साथ काम करने के लिए एक बेहतर तरीका चाहिए—बिना आधुनिक डेवलपमेंट प्रथाओं की सुविधाओं का त्याग किए।
Docker Model Runner में उतरने से पहले, मैं आपको इसकी सिस्टम आवश्यकताओं से अवगत करा दूँ। अच्छी खबर यह है कि यदि आप पहले से ही Docker का उपयोग कर रहे हैं, तो आप आधा रास्ता तय कर चुके हैं। Docker Model Runner अब सामान्य रूप से उपलब्ध है और सभी Docker संस्करणों में काम करता है, तथा macOS, Windows और Linux प्लेटफ़ॉर्म का समर्थन करता है।
हालाँकि Docker Model Runner शुरू में केवल Docker Desktop पर जारी हुआ था, दिसंबर 2025 तक यह किसी भी ऐसे प्लेटफ़ॉर्म के साथ अनुकूल है जो Docker Engine को सपोर्ट करता है।
विभिन्न प्लेटफ़ॉर्म पर आपको यह चाहिए होगा:
|
घटक |
आवश्यकता |
टिप्पणियाँ |
|
ऑपरेटिंग सिस्टम |
macOS, Windows, Linux |
सभी प्रमुख प्लेटफ़ॉर्म समर्थित |
|
Docker संस्करण |
Docker Desktop Docker Engine |
macOS/Windows के लिए Desktop Linux के लिए Engine |
|
RAM |
न्यूनतम 8 GB 16 GB+ अनुशंसित |
बड़े मॉडल के लिए अधिक मेमोरी चाहिए |
|
GPU (वैकल्पिक) |
Apple Silicon NVIDIA ARM/Qualcomm |
2-3x प्रदर्शन बढ़त प्रदान करता है |
Docker Model Runner की सिस्टम आवश्यकताएँ
GPU एक्सेलेरेशन के लिए, Docker Model Runner अब कई बैकएंड्स को सपोर्ट करता है:
Apple Silicon (M1/M2/M3/M4): GPU एक्सेलेरेशन के लिए Metal API का उपयोग करता है, स्वतः कॉन्फ़िगर हो जाता है।
NVIDIA GPUs: NVIDIA Container Runtime आवश्यक, CUDA एक्सेलेरेशन सपोर्टेड।
ARM/Qualcomm: अनुकूल डिवाइस पर हार्डवेयर एक्सेलेरेशन उपलब्ध।
इसके अलावा, Docker Model Runner अक्टूबर 2025 से Vulkan सपोर्ट करता है, जिससे AMD, Intel और अन्य विक्रेताओं के इंटीग्रेटेड GPUs सहित कहीं व्यापक रेंज के GPUs पर हार्डवेयर एक्सेलेरेशन संभव होता है।
आप केवल CPU पर भी मॉडल चला सकते हैं, लेकिन GPU सपोर्ट इन्फ़रेंस प्रदर्शन को नाटकीय रूप से सुधारता है। अंतर लगभग 10 सेकंड बनाम 3 सेकंड के रिस्पॉन्स समय जैसा हो सकता है।
एक महत्वपूर्ण बात: कुछ llama.cpp फीचर्स 6xx सीरीज़ GPUs पर पूरी तरह सपोर्टेड नहीं हो सकते, और MLX या vLLM जैसे अतिरिक्त इंजनों का सपोर्ट भविष्य में जोड़ा जाएगा।
यहीं चीज़ें वास्तव में दिलचस्प हो जाती हैं। Docker Model Runner का आर्किटेक्चरल डिज़ाइन पारंपरिक कंटेनराइज़ेशन से अलग है, जो आपको चौंका सकता है। आइए समझते हैं कि पर्दे के पीछे यह वास्तव में कैसे काम करता है।
Docker Model Runner एक हाइब्रिड अप्रोच लागू करता है, जो Docker की ऑर्केस्ट्रेशन क्षमताओं को AI इन्फ़रेंस के लिए नेटिव होस्ट प्रदर्शन के साथ जोड़ता है। इस आर्किटेक्चर को विशिष्ट क्या बनाता है? यह मूल रूप से इस बात पर पुनर्विचार करता है कि हम AI वर्कलोड्स कैसे चलाते हैं।
स्टैंडर्ड Docker कंटेनरों के विपरीत, इन्फ़रेंस इंजन वास्तव में कंटेनर के अंदर नहीं चलता। इसके बजाय, इन्फ़रेंस सर्वर llama.cpp को इंजन के रूप में उपयोग करता है, जो एक नेटिव होस्ट प्रोसेस के रूप में चलता है—जो माँग पर मॉडल लोड करता है और सीधे आपके हार्डवेयर पर इन्फ़रेंस करता है।
यह क्यों मायने रखता है? यह डिज़ाइन चॉइस Apple के Metal API तक डायरेक्ट एक्सेस सक्षम करता है GPU एक्सेलेरेशन के लिए, और वर्चुअल मशीनों के अंदर इन्फ़रेंस चलाने के ओवरहेड से बचाता है। मॉडल स्टोरेज और एक्ज़ीक्यूशन का पृथक्करण जानबूझकर है: मॉडल अलग से स्टोर किए जाते हैं और केवल ज़रूरत पड़ने पर मेमोरी में लोड होते हैं, फिर निष्क्रियता की एक अवधि के बाद अनलोड हो जाते हैं।
अब, ज़ूम आउट करते हैं और देखते हैं कि ये हिस्से कैसे साथ काम करते हैं। उच्च स्तर पर, Docker Model Runner तीन प्रमुख कम्पोनेंट्स से बना है: मॉडल रनर, मॉडल डिस्ट्रीब्यूशन टूलिंग, और मॉडल CLI प्लगइन। यह मॉड्यूलर आर्किटेक्चर तेज़ इटरेशन और अलग-अलग चिंताओं के बीच क्लीन API बाउंड्रीज़ की अनुमति देता है।
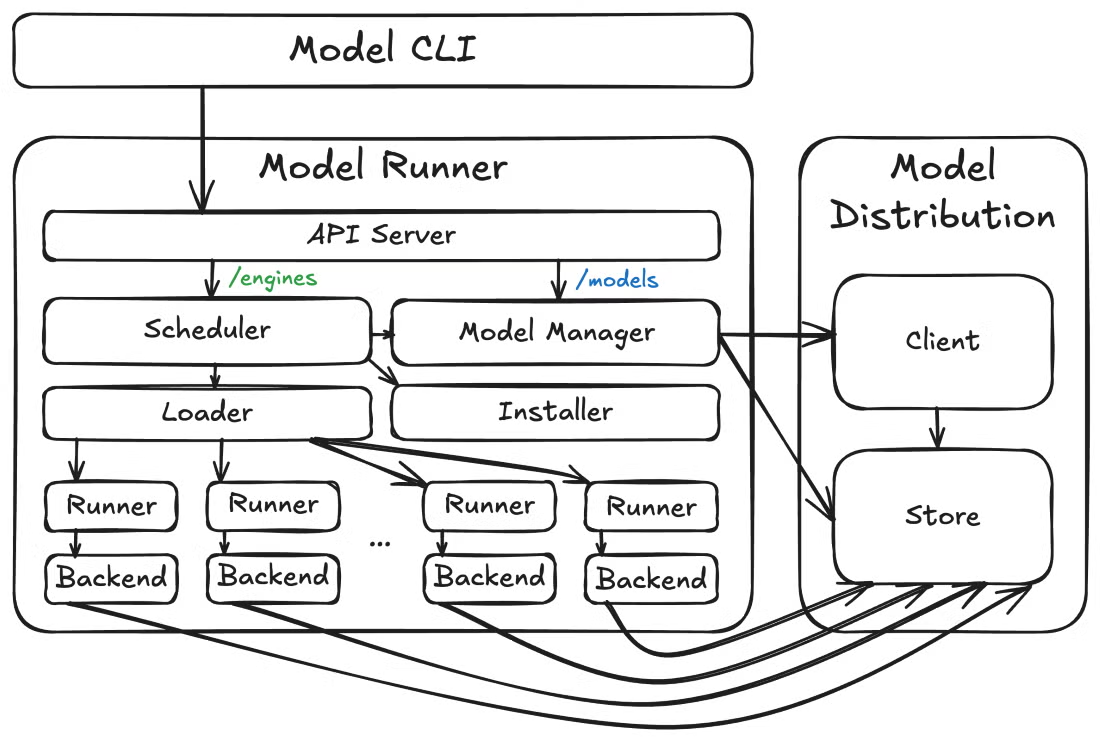
Docker Model Runner आर्किटेक्चर
कोर आर्किटेक्चर से आगे, Docker Model Runner ऑपरेशनल आवश्यकताओं का भी पूर्वानुमान लगाता है। Model Runner /metrics पर मेट्रिक्स एंडपॉइंट्स एक्सपोज़ करता है, जिससे आप मॉडल प्रदर्शन, रिक्वेस्ट आँकड़े, और संसाधन उपयोग की निगरानी कर सकते हैं। यह बिल्ट-इन ऑब्ज़र्बेबिलिटी प्रोडक्शन डिप्लॉयमेंट्स के लिए महत्वपूर्ण है, जहाँ आपको मॉडल के व्यवहार और संसाधन खपत पर नज़र रखने की आवश्यकता होती है।
जब आर्किटेक्चर समझ में आ गया है, तो आप सोच रहे होंगे: इससे वास्तव में किया क्या जा सकता है? मैं आपको उन फीचर्स के बारे में बताता/बताती हूँ, जिन्होंने मेरे AI डेवलपमेंट वर्कफ़्लोज़ में Docker Model Runner को आकर्षक बनाया है।
मुख्य क्षमताओं का एक त्वरित अवलोकन:
|
फ़ीचर |
लाभ |
उपयुक्त किनके लिए |
|
ओपन सोर्स और निःशुल्क |
कोई लाइसेंसिंग लागत नहीं पूर्ण पारदर्शिता |
प्रयोग सीखना प्रोडक्शन उपयोग |
|
Docker CLI एकीकरण |
परिचित कमांड्स (docker model pull/run/list) |
वे Docker उपयोगकर्ता जो नए टूल नहीं सीखना चाहते |
|
OCI-कंप्लायंट पैकेजिंग |
रजिस्ट्रियों के माध्यम से मानक मॉडल वितरण |
वर्ज़न कंट्रोल एक्सेस प्रबंधन |
|
OpenAI API संगतता |
क्लाउड APIs का ड्रॉप-इन रिप्लेसमेंट |
क्लाउड से लोकल में आसान माइग्रेशन |
|
सैंडबॉक्स्ड एक्ज़ीक्यूशन |
सुरक्षा के लिए आइसोलेटेड वातावरण |
एंटरप्राइज़ कंप्लायंस आवश्यकताएँ |
|
GPU एक्सेलेरेशन |
2-3x तेज़ इन्फ़रेंस |
रियल-टाइम एप्लिकेशन उच्च थ्रूपुट |
Docker Model Runner की मुख्य विशेषताएँ
कमांड-लाइन इंटरफ़ेस मौजूदा Docker वर्कफ़्लो के साथ सहजता से इंटीग्रेट होता है। आप कमांड्स जैसे docker model pull, docker model run, और docker model list का उपयोग करेंगे, उसी पैटर्न का अनुसरण करते हुए जिसे आप पहले से ही कंटेनर्स के साथ काम करते समय जानते हैं।
Docker Desktop में ग्राफ़िकल यूज़र इंटरफ़ेस गाइडेड ऑनबोर्डिंग प्रदान करता है ताकि पहली बार AI डेवलपर्स भी मॉडल सर्व करना आसानी से शुरू कर सकें, जहाँ RAM और GPU जैसे उपलब्ध संसाधनों का ऑटोमैटिक हैंडलिंग होता है।
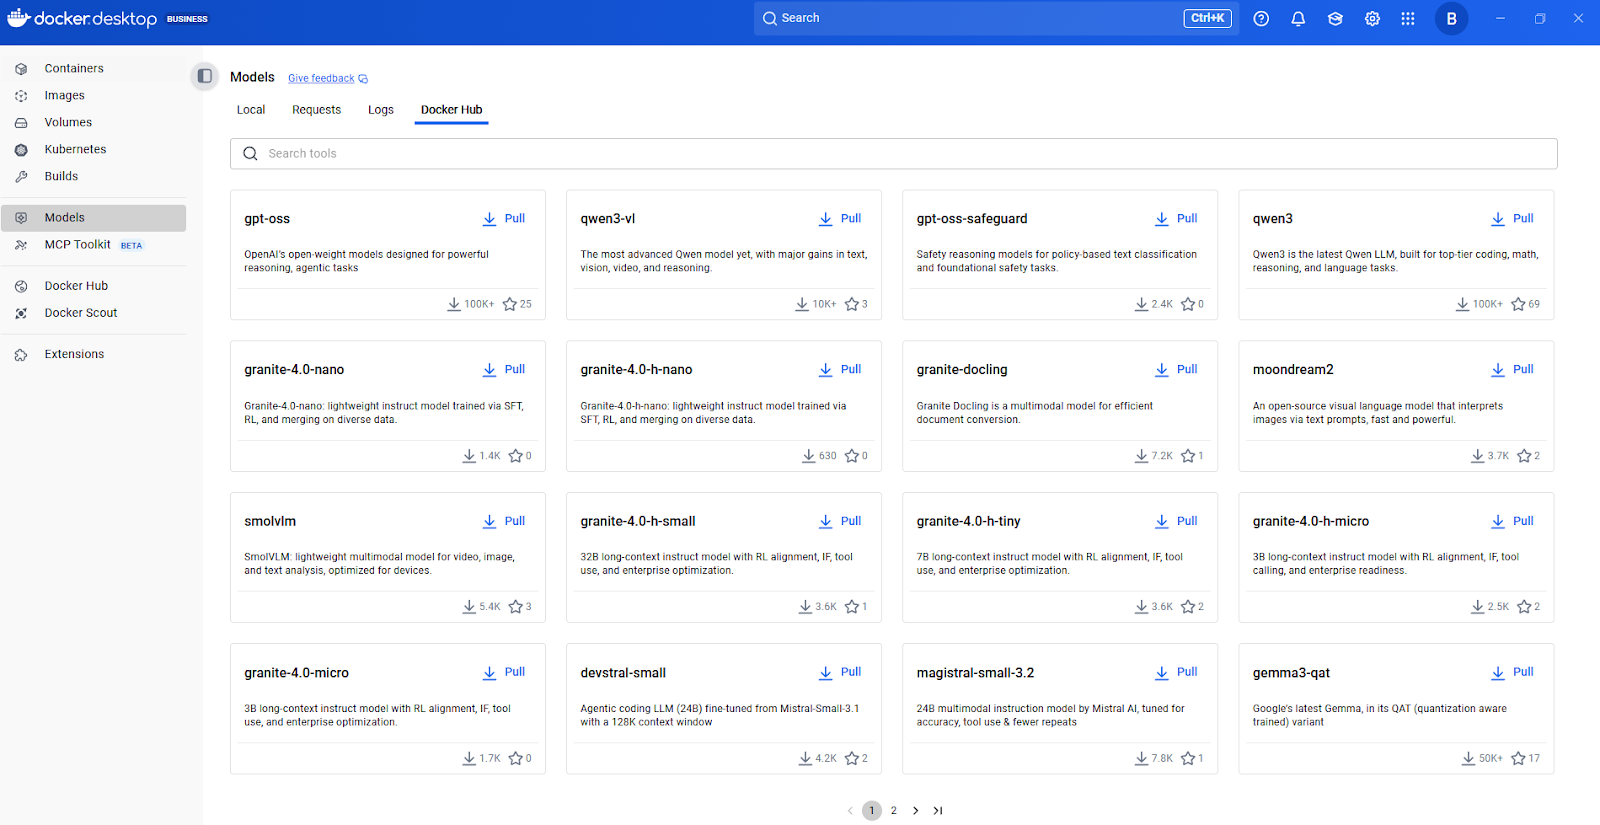
Docker Model Hub
अब बात करते हैं कि मॉडल कैसे पैकेज और वितरित किए जाते हैं। Docker Model Runner OCI-पैकेज्ड मॉडल को सपोर्ट करता है, जिससे आप किसी भी OCI-कंपैटिबल रजिस्ट्री (जिसमें Docker Hub भी शामिल है) के माध्यम से मॉडल स्टोर और वितरित कर सकते हैं। इस मानकीकृत पैकेजिंग का मतलब है कि आप वही वर्ज़निंग, एक्सेस कंट्रोल और डिस्ट्रीब्यूशन पैटर्न लागू कर सकते हैं जो कंटेनर इमेज के लिए उपयोग होते हैं।
एप्लिकेशन इंटीग्रेशन की बात करें, तो REST API क्षमताएँ विशेष रूप से मूल्यवान हैं। Docker Model Runner में llama.cpp पर आधारित एक इन्फ़रेंस इंजन शामिल है, जो परिचित OpenAI API के माध्यम से सुलभ है।
इस OpenAI संगतता का अर्थ है कि OpenAI के API के लिए लिखी गई मौजूदा कोडिंग लोकल मॉडल्स के साथ न्यूनतम बदलावों के साथ काम कर सकती है—बस अपने एप्लिकेशन को क्लाउड API की बजाय लोकल एंडपॉइंट पर पॉइंट करें। यह लचीलापन अकेले ही हफ्तों के रिफैक्टरिंग को बचा सकता है।
आइए मैं आपको आपके सिस्टम पर Docker Model Runner को चालू करने की प्रक्रिया से गुज़ारता/गुज़ारती हूँ। इंस्टॉलेशन प्रक्रिया सीधी है, लेकिन कुछ प्लेटफ़ॉर्म-विशिष्ट बातों को पहले से जानना उपयोगी है।
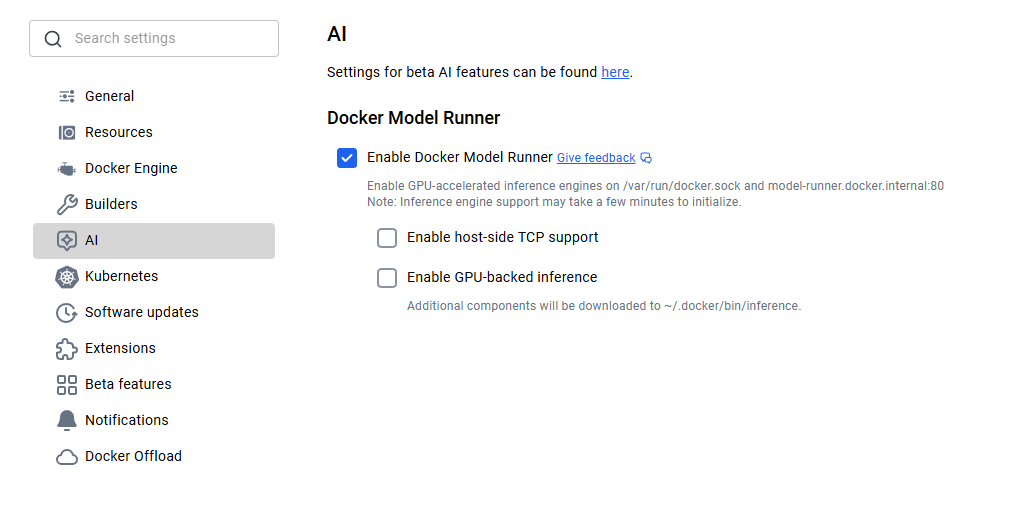
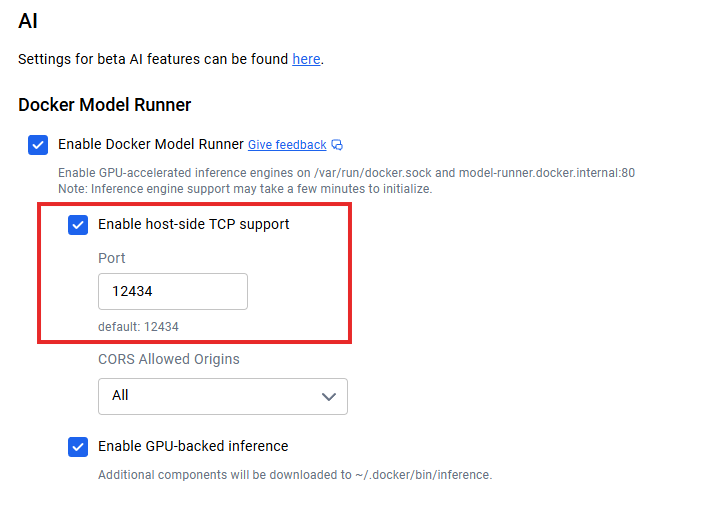
macOS और Windows उपयोगकर्ताओं के लिए, Docker Model Runner, Docker Desktop 4.40 या बाद के संस्करण में शामिल आता है। बस Docker की आधिकारिक वेबसाइट से नवीनतम संस्करण डाउनलोड करें और इंस्टॉल करें। इंस्टॉलेशन के बाद, आपको सेटिंग्स में Docker Model Runner को सक्षम करना होगा। Settings > AI पर जाएँ, और Docker Model Runner विकल्प चुनें, तथा यदि आपके कंप्यूटर में NVIDIA GPU सपोर्ट है तो GPU-बैकएंड इन्फ़रेंस भी चुनें।
Docker Model Runner Activation
Linux उपयोगकर्ताओं के लिए अनुभव और भी सरल है। अपना सिस्टम अपडेट करें और निम्न कमांड्स का उपयोग करके Docker Model Runner प्लगइन इंस्टॉल करें।
sudo apt-get update
sudo apt-get install docker-model-plugin
इंस्टॉलेशन के बाद, docker model version चलाकर जाँच लें कि सब ठीक से काम कर रहा है।
यदि आप Apple Silicon पर हैं, तो Metal के माध्यम से GPU एक्सेलेरेशन स्वतः कॉन्फ़िगर हो जाता है, और किसी अतिरिक्त सेटअप की आवश्यकता नहीं होती। NVIDIA GPUs के लिए, सुनिश्चित करें कि NVIDIA Container Runtime इंस्टॉल हो।
Vulkan सपोर्ट के साथ, अब आप AMD, Intel और अन्य GPUs पर जो Vulkan API को सपोर्ट करते हैं, हार्डवेयर एक्सेलेरेशन का लाभ उठा सकते हैं। सिस्टम आपके हार्डवेयर को इंटेलिजेंट तरीके से डिटेक्ट करता है और उपयुक्त एक्सेलेरेशन लागू करता है।
इंस्टॉल होने के बाद, कोई मॉडल डाउनलोड करना बहुत आसान हो जाता है। आपको बस पहले मॉडल पुल करना है और फिर उससे इंटरैक्ट करने के लिए रन करना है:
docker model pull ai/smollm2
docker model run ai/smollm2
यदि सब कुछ सही से सेटअप हो गया है, तो आपको सूची में मॉडल दिखना चाहिए:
docker model listMODEL NAME
ai/smollm2Docker Model Runner इंस्टॉल करने और मॉडल पुल करना समझ लेने के बाद, अगला स्वाभाविक प्रश्न है: ये मॉडल आते कहाँ से हैं, और आप इन्हें बड़े पैमाने पर कैसे मैनेज करते हैं? यहीं Docker Model Runner का तरीका विशेष रूप से सुरुचिपूर्ण हो जाता है।
Docker मॉडल्स को OCI आर्टिफैक्ट्स के रूप में पैकेज करता है—एक ओपन स्टैंडर्ड—जो कंटेनर्स के लिए इस्तेमाल होने वाली वही रजिस्ट्रियाँ और वर्कफ़्लो के माध्यम से वितरण की अनुमति देता है। जो टीमें पहले से निजी Docker रजिस्ट्रियाँ उपयोग कर रही हैं, वे AI मॉडल्स के लिए भी वही इंफ्रास्ट्रक्चर इस्तेमाल कर सकती हैं। Docker Hub नीति-आधारित एक्सेस कंट्रोल के लिए Registry Access Management जैसी एंटरप्राइज़ सुविधाएँ प्रदान करता है।
Hugging Face के साथ इंटीग्रेशन विशेष उल्लेख के योग्य है। डेवलपर्स Docker Model Runner को Hugging Face पर मॉडल चलाने के लिए लोकल इन्फ़रेंस इंजन के रूप में उपयोग कर सकते हैं, और समर्थित मॉडल्स (GGUF फ़ॉर्मेट आवश्यक) को सीधे Hugging Face इंटरफ़ेस में फ़िल्टर कर सकते हैं। इससे मॉडल डिस्कवरी काफी आसान हो जाती है।
docker model pull hf.co/bartowski/Llama-3.2-1B-Instruct-GGUFइस इंटीग्रेशन की अंदरूनी कार्यप्रणाली काफ़ी चतुर है। जब आप Hugging Face से GGUF फ़ॉर्मेट में कोई मॉडल पुल करते हैं, तो Docker Model Runner उसे अपने-आप ऑन-द-फ्लाई OCI आर्टिफैक्ट के रूप में पैकेज कर देता है। यह निर्बाध रूपांतरण मैनुअल पैकेजिंग चरणों को खत्म कर देता है और मॉडल डिस्कवरी से डिप्लॉयमेंट तक का समय तेज़ करता है।
डिस्ट्रीब्यूशन मैकेनिज़्म समझना अच्छा है, लेकिन वास्तव में आप कौन से मॉडल चला सकते हैं? आइए देखते हैं कि बॉक्स से बाहर क्या उपलब्ध है और और अधिक कैसे खोजें।
Docker Model Runner में तुरंत उपयोग के लिए क्यूरेटेड मॉडल्स का चयन मौजूद है। SmolLM2 एक लोकप्रिय विकल्प है—चैट असिस्टेंट्स, टेक्स्ट एक्सट्रैक्शन, रीराइटिंग और समरीकरण कार्यों के लिए उपयुक्त—जिसमें 360 मिलियन पैरामीटर्स हैं। अपने छोटे आकार और तेज़ इन्फ़रेंस के कारण, मैंने इस मॉडल को विकास और परीक्षण के लिए विशेष रूप से उपयोगी पाया है।
अतिरिक्त मॉडल्स खोजने के लिए, मैं Docker Hub के AI मॉडल कैटलॉग से शुरू करने की सलाह देता/देती हूँ। उपलब्ध मॉडल्स ब्राउज़ करें, उनके प्रलेखन में समर्थित कार्य और हार्डवेयर आवश्यकताओं की जाँच करें, फिर एक साधारण docker model pull कमांड से उन्हें पुल करें।
मॉडल्स पहली बार उपयोग पर Docker Hub से पुल होते हैं और लोकल में स्टोर हो जाते हैं, फिर केवल रनटाइम पर रिक्वेस्ट आने पर मेमोरी में लोड होते हैं और उपयोग न होने पर अनलोड होकर संसाधनों का इष्टतम उपयोग करते हैं।
यह अप्रोच आपके सिस्टम को उत्तरदायी बनाए रखता है, भले ही आपने कई मॉडल डाउनलोड कर रखे हों। आपको सब कुछ RAM में एक साथ रखने के लिए बाध्य नहीं किया जाता।
प्रत्येक मॉडल लिस्टिंग में क्वांटाइज़ेशन स्तरों (जैसे Q4_0, Q8_0) की जानकारी शामिल होती है, जो मॉडल के आकार और इन्फ़रेंस गुणवत्ता को प्रभावित करती है।
|
क्वांटाइज़ेशन स्तर |
विवरण |
फ़ाइल आकार |
गुणवत्ता |
सबसे उपयुक्त |
|
Q8_0 |
8-बिट क्वांटाइज़ेशन |
सबसे बड़ा |
उच्चतम गुणवत्ता |
प्रोडक्शन उपयोग, उच्च सटीकता वाले कार्य |
|
Q5_0 |
5-बिट क्वांटाइज़ेशन |
मध्यम |
अच्छा संतुलन |
जनरल-पर्पस, संतुलित प्रदर्शन |
|
Q4_0 |
4-बिट क्वांटाइज़ेशन |
सबसे छोटा |
स्वीकार्य |
डेवलपमेंट, टेस्टिंग, संसाधन-सीमित वातावरण |
मॉडल क्वांटाइज़ेशन
मॉडल वर्ज़निंग एक महत्वपूर्ण विचार है। आप टैग्स (जैसे Q4_0 या latest) का उपयोग करके सटीक वर्ज़न निर्दिष्ट कर सकते हैं—बिलकुल Docker इमेज की तरह। यह पुनरुत्पाद्य डिप्लॉयमेंट सुनिश्चित करता है और मॉडल अपडेट होने पर अनपेक्षित बदलावों से बचाता है।
जब आपके मॉडल्स लोकल पर चल रहे हों, तो अगला प्रश्न होता है: मैं अपने एप्लिकेशन्स को कैसे कनेक्ट करूँ? जब होस्ट-साइड TCP सपोर्ट सक्षम हो (उदा., Docker Desktop की TCP सेटिंग्स के माध्यम से), डिफ़ॉल्ट API एंडपॉइंट localhost:12434 पर चलता है और OpenAI-कंपैटिबल एंडपॉइंट्स एक्सपोज़ करता है।
Docker Model Runner API Integration
यहाँ एक साधारण रिक्वेस्ट का उदाहरण है:
curl http://localhost:12434/engines/llama.cpp/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "ai/smollm2",
    "messages": [{"role": "user", "content": "Explain containerization"}],
    "stream": false
  }'
माइक्रोसर्विस आर्किटेक्चर के लिए, आपके एप्लिकेशन कंटेनर्स मानक HTTP प्रोटोकॉल का उपयोग करके मॉडल सर्विस से संचार कर सकते हैं—किसी विशेष SDK की ज़रूरत नहीं। रियल-टाइम एप्लिकेशन्स के लिए "stream": true सेट करके रिस्पॉन्स स्ट्रीमिंग सपोर्टेड है।
REST API प्रलेखन पूर्ण एंडपॉइंट स्पेसिफ़िकेशन्स, पैरामीटर विकल्प, और रिस्पॉन्स स्कीमाज़ प्रदान करता है। प्लेटफ़ॉर्म तेज़ी से विकसित हो रहा है, इसलिए मैं सबसे ताज़ा API विवरण के लिए आधिकारिक Docker डॉक्यूमेंटेशन देखने की सलाह देता/देती हूँ।
Docker Model Runner से सर्वोत्तम प्रदर्शन प्राप्त करने के लिए कुछ प्रमुख रणनीतियों को समझना आवश्यक है। लोकल मॉडल डिप्लॉयमेंट्स के साथ काम करने से मैंने जो सीखा है, वह साझा करता/करती हूँ।
होस्ट-लेवल प्रोसेस के रूप में डायरेक्ट GPU एक्सेस के साथ चलकर, Model Runner कंटेनराइज़्ड समाधानों की तुलना में बेहतर प्रदर्शन अनुकूलन प्राप्त करता है। यह आर्किटेक्चरल निर्णय थ्रूपुट और लेटेंसी के लिहाज़ से लाभ देता है, लेकिन अधिकतम लाभ उठाने के लिए आपको ट्यूनिंग सही करनी होगी।
हार्डवेयर एक्सेलेरेशन आपका पहला ऑप्टिमाइज़ेशन लीवर है। GPU सपोर्ट सक्षम करने से आमतौर पर CPU-ओनली इन्फ़रेंस की तुलना में 2-3x प्रदर्शन सुधार मिलता है। हार्डवेयर से आगे, मॉडल क्वांटाइज़ेशन आपका दूसरा बड़ा डायल है। मैं आमतौर पर सर्वोत्तम गुणवत्ता के लिए Q8_0 से शुरू करता/करती हूँ, फिर बेहतर प्रदर्शन की आवश्यकता होने पर Q5_0 या Q4_0 की ओर बढ़ता/बढ़ती हूँ।
/metrics पर बिल्ट-इन मेट्रिक्स एंडपॉइंट Prometheus या आपके मौजूदा मॉनिटरिंग स्टैक के साथ मॉनिटरिंग की अनुमति देता है। स्केलिंग के लिए, अधिकतम मानों का उपयोग करने के बजाय वास्तविक आवश्यकताओं के आधार पर कॉन्टेक्स्ट लंबाई कॉन्फ़िगर करें। यदि आपके एप्लिकेशन को केवल 2048 टोकन का कॉन्टेक्स्ट चाहिए, तो 8192 कॉन्फ़िगर न करें।
Docker Model Runner का एक सबसे बड़ा लाभ यह है कि यह व्यापक Docker इकोसिस्टम के साथ कैसे इंटीग्रेट होता है।
Docker Model Runner, Docker Compose को सपोर्ट करता है। इसका अर्थ है कि आप ऐसे मल्टी-सर्विस एप्लिकेशन्स परिभाषित कर सकते हैं जहाँ एक सर्विस AI मॉडल हो, और पूरे स्टैक को परिचित Docker Compose फ़ाइलों से मैनेज कर सकते हैं। यह इस तरह दिखता है:
services:
  app:
    image: my-app:latest
    models:
      - llm
      - embedding

models:
  llm:
    model: ai/smollm2
  embedding:
    model: ai/embeddinggemma
आप CI/CD वर्कफ़्लोज़ को भी ऑटोमेट कर सकते हैं: अपने टेस्ट वातावरण में मॉडल्स स्पिन-अप करें, उनके खिलाफ इंटीग्रेशन टेस्ट चलाएँ, और सब कुछ टियर डाउन करें—वह भी अपने मौजूदा पाइपलाइन इंफ्रास्ट्रक्चर के भीतर। इससे AI फीचर्स के लिए "यह मेरी मशीन पर तो चलता है" वाली समस्या दूर होती है।
एक और दिलचस्प इंटीग्रेशन है Docker Offload, जो ज़रूरत पड़ने पर आपके लोकल वर्कफ़्लो को क्लाउड तक विस्तारित करता है। यद्यपि यह अभी Beta फीचर है, यह आपको Docker Model Runner के साथ लोकल पर डेवलप करने देता है, फिर आवश्यकता स्थानीय क्षमता से अधिक होने पर संसाधन-गहन इन्फ़रेंस को क्लाउड इंफ्रास्ट्रक्चर पर ऑफ़लोड करने देता है।
Docker Offload
Kubernetes में रनिंग के लिए सपोर्ट भी एक Helm चार्ट और एक स्टैटिक YAML फ़ाइल के रूप में उपलब्ध है। यह उन प्रोडक्शन-स्केल डिप्लॉयमेंट्स के लिए रास्ता खोलता है, जहाँ आपको हॉरिज़ॉन्टल स्केलिंग, लोड बैलेंसिंग और उच्च उपलब्धता की आवश्यकता होती है।
हालाँकि अभी प्रयोगात्मक है, Kubernetes इंटीग्रेशन Docker Model Runner के एंटरप्राइज़-ग्रेड डिप्लॉयमेंट्स की ओर विकास का प्रतिनिधित्व करता है—जहाँ आप कई प्रतियों में प्रति सेकंड हज़ारों रिक्वेस्ट सर्व कर रहे होते हैं।
इन सभी इंटीग्रेशन्स के साथ, आप सोच सकते हैं: लेकिन क्या यह सुरक्षित है? Docker Model Runner एक आइसोलेटेड, नियंत्रित वातावरण में चलता है, जो सुरक्षा के लिए सैंडबॉक्सिंग प्रदान करता है। यह आइसोलेशन मॉडल्स को संवेदनशील सिस्टम संसाधनों तक पहुँचने से रोकता है, सिवाय उन संसाधनों के जो स्पष्ट रूप से उपलब्ध कराए गए हों।
प्राथमिक सुरक्षा लाभ है डेटा गोपनीयता। आपकी इन्फ़रेंस रिक्वेस्ट आपके इंफ्रास्ट्रक्चर से बाहर नहीं जातीं, जिससे डेटा एक्सफ़िल्ट्रेशन का जोखिम समाप्त हो जाता है। संवेदनशील डेटा संभालने वाले संगठनों के लिए, यह लोकल एक्ज़ीक्यूशन मॉडल GDPR, HIPAA और अन्य गोपनीयता विनियमों के अनुपालन के लिए आवश्यक है।
एडमिन्स होस्ट-साइड TCP सपोर्ट और CORS को ग्रैन्युलर सुरक्षा नियंत्रण के लिए कॉन्फ़िगर कर सकते हैं। रजिस्ट्रियों में मॉडल लाइसेंसिंग मेटाडेटा एंटरप्राइज़ गवर्नेंस के लिए कंप्लायंस ट्रैकिंग और ऑडिट ट्रेल्स सक्षम करता है।
अब तक आप सोच रहे होंगे: यह उन टूल्स की तुलना में कैसा है जिन्हें मैं पहले से उपयोग कर रहा/रही हूँ? यहाँ Docker Model Runner, Ollama और NVIDIA NIM की तुलना दी गई है:
|
फ़ीचर |
Docker Model Runner |
Ollama |
NVIDIA NIM |
|
प्रदर्शन |
Ollama से 1.00-1.12x तेज़ |
बेसलाइन प्रदर्शन |
NVIDIA GPUs के लिए अत्यधिक अनुकूलित |
|
इकोसिस्टम इंटीग्रेशन |
नेटिव Docker वर्कफ़्लो, OCI आर्टिफैक्ट्स |
स्टैंडअलोन टूल, अलग वर्कफ़्लो |
कंटेनराइज़्ड, NVIDIA-विशिष्ट |
|
मॉडल कस्टमाइज़ेशन |
Docker Hub से प्री-पैकेज्ड मॉडल्स |
कस्टम Modelfiles, GGUF/Safetensors इम्पोर्ट |
केवल NVIDIA-ऑप्टिमाइज़्ड मॉडल्स |
|
प्लेटफ़ॉर्म सपोर्ट |
macOS, Windows, Linux |
macOS, Windows, Linux, Docker |
केवल NVIDIA GPUs वाले Linux |
|
हार्डवेयर आवश्यकताएँ |
कोई भी GPU (Metal, CUDA, Vulkan) या CPU |
कोई भी GPU या CPU |
NVIDIA GPUs आवश्यक |
|
कम्युनिटी और SDKs |
विकसित होती, Docker इकोसिस्टम फोकस |
परिपक्व, व्यापक |
NVIDIA इकोसिस्टम, एंटरप्राइज़-केंद्रित |
|
सबसे उपयुक्त |
Docker इंफ्रास्ट्रक्चर वाली टीमें |
स्टैंडअलोन AI प्रोजेक्ट्स, तेज़ प्रयोग |
NVIDIA-केंद्रित प्रोडक्शन डिप्लॉयमेंट्स |
Docker Model Runner का मुख्य अंतर इकोसिस्टम इंटीग्रेशन है। यह AI मॉडल्स को कंटेनर्स के साथ प्रथम-श्रेणी के नागरिकों की तरह ट्रीट करता है, जिससे Docker-केंद्रित टीमों के लिए टूल स्प्रॉल कम होता है।
Ollama अधिक मॉडल कस्टमाइज़ेशन और व्यापक SDKs के साथ परिपक्व कम्युनिटी प्रदान करता है। NVIDIA NIM NVIDIA GPUs के लिए सर्वोच्च प्रदर्शन देता है, पर अन्य विकल्पों की लचीलापन और क्रॉस-प्लेटफ़ॉर्म सपोर्ट का अभाव है।
समापन से पहले, आइए देखें कि जब चीज़ें काम न करें तो क्या करें।
यह त्रुटि आमतौर पर इंगित करती है कि Docker CLI प्लगइन एक्ज़ीक्यूटेबल को ढूँढ नहीं पा रहा है।
कारण: Docker अपेक्षित CLI प्लगइन डायरेक्टरी में प्लगइन नहीं ढूँढ पा रहा है।
समाधान: संभवतः आपको एक्ज़ीक्यूटेबल के लिए एक प्रतीकात्मक लिंक (symlink) बनाना होगा। कृपया विशिष्ट कमांड्स के लिए इंस्टॉलेशन अनुभाग देखें।
वर्तमान में, विशिष्ट डाइजेस्ट का उपयोग करके मॉडल्स को पुल या रेफ़र करना विफल हो सकता है।
वर्कअराउंड: डाइजेस्ट की बजाय टैग नाम (उदा., model:v1) से मॉडल्स को रेफ़र करें।
स्थिति: इंजीनियरिंग टीम भविष्य के रिलीज़ के लिए सही डाइजेस्ट सपोर्ट पर सक्रिय रूप से काम कर रही है।
यदि आपके मॉडल धीमे चल रहे हैं या GPU का उपयोग नहीं कर रहे हैं, तो निम्न जाँचें करें:
ड्राइवर्स सत्यापित करें: सुनिश्चित करें कि आपके होस्ट मशीन के GPU ड्राइवर्स अप टू डेट हैं।
अनुमतियाँ जाँचें: पुष्टि करें कि Docker को GPU संसाधनों तक पहुँच की अनुमति है।
Linux (NVIDIA): सुनिश्चित करें कि NVIDIA Container Runtime इंस्टॉल और कॉन्फ़िगर है।
सत्यापन: निम्न कमांड चलाएँ और जाँचें कि सिस्टम को GPU दिखाई दे रहा है: nvidia-smi
यदि आपको यहाँ सूचीबद्ध न की गई कोई समस्या मिलती है:
इश्यू दर्ज करें: आधिकारिक GitHub रिपोजिटरी पर बग रिपोर्ट करें या फीचर रिक्वेस्ट करें।
समुदाय: एक सक्रिय समुदाय है जो अक्सर एज केसों के लिए त्वरित वर्कअराउंड प्रदान करता है।
Docker Model Runner, AI डेवलपमेंट को अधिक सुलभ बनाने की दिशा में एक महत्वपूर्ण कदम है। मॉडल मैनेजमेंट को Docker इकोसिस्टम में लाकर, यह उस घर्षण को खत्म करता है जिसने ऐतिहासिक रूप से AI अपनाने की गति धीमी की है।
रणनीतिक महत्व सुविधा से आगे जाता है। ऐसे दौर में जब डेटा गोपनीयता, लागत नियंत्रण, और डेवलपमेंट वेलोसिटी पहले से कहीं अधिक मायने रखते हैं, लोकल AI एक्ज़ीक्यूशन तेजी से निर्णायक बनता जा रहा है। Docker Model Runner, उन्हीं Docker कमांड्स और वर्कफ़्लो के साथ AI एप्लिकेशन्स पर प्रयोग और निर्माण करना आसान बनाता है, जिन्हें डेवलपर्स रोज़ाना उपयोग करते हैं।
आगे देखते हुए, यह प्लेटफ़ॉर्म अतिरिक्त इन्फ़रेंस लाइब्रेरीज़, उन्नत कॉन्फ़िगरेशन विकल्पों, और डिस्ट्रीब्यूटेड डिप्लॉयमेंट क्षमताओं के समर्थन के साथ विकसित होता जा रहा है। कंटेनराइज़ेशन और AI का अभिसरण वहीं है जहाँ इंडस्ट्री जा रही है—और Docker Model Runner इस संगम पर खड़ा है, Docker का उपयोग कर रहे लाखों डेवलपर्स के लिए गोपनीयता-केंद्रित, किफ़ायती AI डेवलपमेंट को वास्तविकता बना रहा है।
अब जब आपके लोकल Docker वातावरण में मॉडल्स चल रहे हैं, अगला कदम उनके चारों ओर एक भरोसेमंद पाइपलाइन बनाना है। मॉडल वर्ज़निंग, डिप्लॉयमेंट, और लाइफसाइकल मैनेजमेंट के सिद्धांत सीखें—DataCamp पर MLOps Fundamentals स्किल ट्रैक के साथ।
Docker Courses
कोर्स
लर्निंग पाथ
लर्निंग पाथ