
Last chance! 50% off DataCamp Premium
Sale ends in
Alat ekstraksi PDF tradisional seperti pypdf atau PDFMiner memberi Anda teks mentah namun kehilangan struktur dokumen. Tabel menjadi teks acak, header bercampur dengan isi, dan gambar menghilang. Untuk sistem RAG, data berantakan ini berarti pengambilan yang buruk dan jawaban yang tidak andal. Docling adalah toolkit open-source dari IBM Research yang menggunakan model visi komputer untuk memahami tata letak dokumen, menjaga tabel, gambar, heading, dan strukturnya. Docling memproses dokumen hingga 30 kali lebih cepat dibanding metode berbasis OCR tradisional dan berjalan secara lokal di mesin Anda.
Dalam tutorial ini, kita akan menggunakan Docling untuk membangun Document Intelligence Assistant — aplikasi web Streamlit yang memungkinkan Anda mengunggah dokumen, memvisualisasikan strukturnya, dan mengajukan pertanyaan menggunakan chatbot bertenaga RAG. Anda akan mempelajari cara memproses dokumen multi-format dengan Docling, mengekstrak dan menampilkan tabel serta gambar, membangun vector store dengan ChromaDB, dan membuat agen percakapan dengan LangGraph. Di akhir, Anda akan memiliki aplikasi yang berfungsi untuk mengubah dokumen kompleks menjadi data terstruktur dan memungkinkan tanya jawab cerdas.
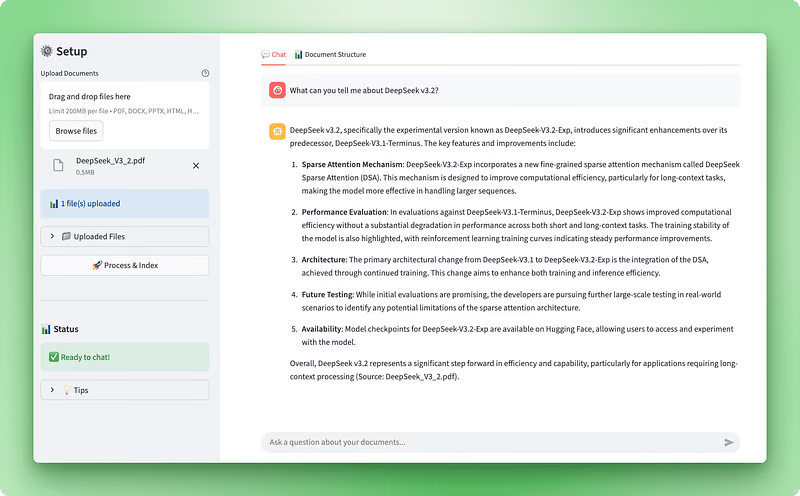
Pratinjau aplikasi:
Visualisasi struktur dokumen:
Sebelum memulai tutorial ini, Anda sebaiknya sudah memiliki:
Keterampilan teknis: Nyaman dengan kelas Python, dekorator, type hints, dan context manager. Kita akan menggunakan operasi async dan pola factory di seluruh bagian. Pemahaman tentang cara model bahasa besar bekerja dengan prompt, token, dan embedding diperlukan. Keakraban dengan sistem retrieval-augmented generation dan basis data vektor membantu namun tidak wajib — kami akan menjelaskan konsep inti sambil membangun.
Lingkungan pengembangan: Python 3.10 atau lebih baru dengan pip untuk manajemen paket. Editor kode seperti VS Code direkomendasikan. Anda memerlukan kunci API OpenAI dari platform.openai.com — biaya pemrosesan sekitar $0,10–0,20 per dokumen.
Komitmen waktu: Sediakan 60–90 menit untuk menyelesaikan tutorial, termasuk membaca penjelasan, menulis kode, dan menguji aplikasi. Tutorial ini mengasumsikan keterampilan Python tingkat menengah.
Kebanyakan alat pemrosesan dokumen memperlakukan PDF seperti file gambar atau aliran teks. Mereka menjalankan OCR pada setiap halaman atau mengekstrak teks biasa tanpa memahami apa yang dibaca. Docling mengambil pendekatan berbeda. Ini adalah toolkit open-source dari IBM Research yang menggunakan model visi komputer untuk memahami struktur dokumen seperti halnya manusia.
Saat Anda memasukkan dokumen ke Docling, dua model AI menganalisisnya:
Model-model ini memahami bahwa dokumen bukan hanya gumpalan teks. Dokumen memiliki hierarki, relasi, dan makna.
Pemahaman struktur ini penting untuk sistem RAG. Saat Anda membangun aplikasi retrieval-augmented generation, kualitas pemrosesan dokumen berdampak langsung pada akurasi pengambilan. Jika ekstraksi PDF Anda mengubah tabel finansial menjadi teks acak, pencarian vektor Anda akan mengambil sampah. Docling mempertahankan struktur, sehingga saat Anda melakukan chunking dan embedding dokumen, Anda bekerja dengan data yang bersih dan terorganisasi.
Docling mendukung berbagai format dokumen secara default:
Anda juga dapat mengaktifkan OCR untuk dokumen hasil pindaian menggunakan mesin seperti EasyOCR, Tesseract, atau RapidOCR. Toolkit ini mengekspor ke beberapa format termasuk Markdown (bagus untuk LLM), JSON (untuk pipeline data terstruktur), dan DocTags (format yang menangkap elemen kompleks seperti persamaan matematika dan blok kode).
Selain fleksibilitas format, Docling menawarkan keunggulan performa. Pemrosesan dokumen berbasis OCR tradisional lambat karena memperlakukan setiap halaman sebagai gambar yang perlu dikenali karakternya. Docling melewati langkah ini untuk dokumen digital, menawarkan pemrosesan yang jauh lebih cepat. Docling berjalan secara lokal di perangkat keras umum, jadi Anda tidak membayar biaya API atau mengirim dokumen sensitif ke layanan pihak ketiga. Kecepatan pemrosesan bervariasi berdasarkan kompleksitas dokumen, jumlah halaman, dan spesifikasi perangkat keras, dengan performa tipikal mulai dari kurang dari satu detik hingga beberapa detik per halaman pada perangkat modern.
IBM terus meningkatkan kapabilitas Docling. Mereka merilis Granite-Docling, model visi-bahasa dengan 258 juta parameter yang unggul pada tata letak kompleks dan menawarkan dukungan multibahasa eksperimental (dengan bahasa Inggris sebagai bahasa utama dan dukungan awal untuk Arab, Tionghoa, dan Jepang). Toolkit ini sekarang juga mendukung ekstraksi gambar dengan resolusi yang dapat dikonfigurasi, yang akan kita gunakan dalam aplikasi untuk menampilkan gambar aktual dari PDF berdampingan dengan konten teksnya.
Untuk kasus penggunaan kita, Docling masuk akal karena kita memerlukan data terstruktur, bukan hanya teks mentah. Jika Anda hanya butuh ekstraksi teks dasar, alat yang lebih sederhana seperti pypdf mungkin cukup. Namun karena kita membangun aplikasi AI yang memproses dokumen untuk analisis dan percakapan, pemrosesan sadar struktur milik Docling adalah pilihan yang lebih baik. Docling sangat berharga saat bekerja dengan dokumen teknis, makalah riset, atau laporan bisnis di mana tabel dan tata letak penting.
Sebelum kita mulai membangun pemroses dokumen, Anda perlu menyiapkan struktur proyek dan menginstal paket yang diperlukan. Bagian ini membahas penyiapan awal: membuat direktori, menginstal dependensi, dan mengonfigurasi kunci API Anda.
Mulailah dengan membuat direktori baru untuk proyek Anda:
mkdir docling-demo
cd docling-demo
Di dalam direktori ini, buat folder src/ untuk modul Python Anda:
mkdir src
touch src/__init__.py
File __init__.py memberi tahu Python bahwa src/ adalah sebuah paket, sehingga memungkinkan impor seperti from src.document_processor import DocumentProcessor.
Struktur proyek Anda:
docling-demo/
├── src/
│ └── __init__.pyBuat file requirements.txt di root proyek Anda:
docling>=2.55.0
langchain-docling>=0.1.0
langchain>=0.3.0
langchain-openai>=0.2.0
langgraph>=0.2.0
langchain-chroma>=0.1.0
streamlit>=1.28.0
streamlit-extras>=0.7.0
python-dotenv>=1.0.0
chromadb>=0.4.22
tiktoken>=0.5.0
pandas>=2.0.0
numpy<2
Kendala numpy<2 ada karena dependensi Docling (TensorFlow dan Transformers) memerlukan NumPy 1.x.
Instal paket-paket tersebut:
pip install -r requirements.txtInstalasi pertama memakan waktu beberapa menit karena Docling mengunduh model AI pra-latih (~500MB). Model-model ini menangani analisis tata letak dan pengenalan struktur tabel. Model disimpan di cache lokal, sehingga menjalankan ulang berikutnya lebih cepat.
Buat file .env untuk menyimpan kunci API OpenAI Anda:
OPENAI_API_KEY=your-openai-api-key-hereDapatkan kunci API Anda dari platform.openai.com. Anda akan membutuhkannya untuk embeddings dan agen chat.
Buat templat .env.example:
OPENAI_API_KEY=your-openai-api-key-hereTambahkan .gitignore untuk menghindari melakukan commit data sensitif:
# Environment variables
.env

# Python
__pycache__/
*.py[cod]
*.so
venv/
*.egg-info/

# Chroma
chroma_db/Buat app.py di root proyek Anda. Kita akan membangun file ini secara bertahap sepanjang tutorial. Untuk sekarang, tambahkan impor dan konfigurasi dasar:
import streamlit as st
from dotenv import load_dotenv

# Load environment variables
load_dotenv()

# Page configuration
st.set_page_config(
    page_title="Document Intelligence Assistant",
    page_icon="📄",
    layout="wide"
)

st.title("Document Intelligence Assistant")
st.write("Application setup complete. We'll build the functionality next.")
Uji penyiapan Anda:
streamlit run app.pyStreamlit membuka jendela peramban di http://localhost:8501 yang menampilkan halaman dasar Anda.
Struktur proyek akhir Anda (sebelum kita menambahkan skrip baru di bagian berikut):
docling-demo/
├── .env
├── .env.example
├── .gitignore
├── requirements.txt
├── app.py
└── src/
   └── __init__.py
Dengan lingkungan siap, kita bisa membangun pemroses dokumen yang menggunakan Docling untuk mengekstrak struktur dari file yang diunggah.
> Catatan: Bagian di bawah akan menguraikan skrip aplikasi dalam potongan. Jadi, untuk melihat gambaran utuh dan mengikuti dengan mudah, kami menyarankan membuka repositori GitHub untuk proyek ini di tab terpisah.
📄 Skrip lengkap: src/document_processor.py
Pemroses dokumen adalah tempat Docling bekerja. Komponen ini mengambil file yang diunggah dan mengubahnya menjadi data terstruktur yang dapat kita gunakan untuk RAG dan visualisasi. Kita memerlukan dua keluaran dari proses ini: teks markdown bersih untuk vector store dan objek dokumen Docling asli yang mempertahankan semua informasi struktural seperti tabel dan gambar.
Mari kita bangun ini dengan membuat file baru bernama document_processor.py di direktori src/ Anda. Kita akan membuat kelas DocumentProcessor yang mengonfigurasi pipeline pemrosesan Docling dan menangani unggahan file.
Docling memungkinkan Anda mengontrol cara memproses dokumen melalui opsi pipeline. Untuk PDF, Anda dapat menyalakan OCR untuk dokumen hasil pindaian, mengaktifkan pengenalan struktur tabel, dan mengekstrak gambar:
from docling.document_converter import DocumentConverter, PdfFormatOption
from docling.datamodel.base_models import InputFormat
from docling.datamodel.pipeline_options import PdfPipelineOptions
from langchain_core.documents import Document

class DocumentProcessor:
    def __init__(self):
        # Configure pipeline options for PDF processing
        pipeline_options = PdfPipelineOptions()
        pipeline_options.do_ocr = True
        pipeline_options.do_table_structure = True
        pipeline_options.generate_picture_images = True
        pipeline_options.images_scale = 2.0
Kita membuat objek PdfPipelineOptions untuk mengonfigurasi cara Docling memproses file PDF. Setiap opsi mengontrol kemampuan pemrosesan tertentu: do_ocr mengaktifkan optical character recognition untuk dokumen hasil pindaian, do_table_structure mengaktifkan deteksi dan parsing tabel, generate_picture_images memberi tahu Docling untuk mengekstrak gambar tersemat sebagai objek PIL, dan images_scale menetapkan pengali resolusi untuk gambar yang diekstraksi.
# Initialize converter with PDF options
self.converter = DocumentConverter(
    format_options={InputFormat.PDF: PdfFormatOption(pipeline_options=pipeline_options)}
)
DocumentConverter adalah mesin pemrosesan utama Docling. Kita menginisialisasinya dengan opsi pipeline PDF kita yang dibungkus dalam objek PdfFormatOption, yang mengaitkan pengaturan ini secara khusus dengan file input PDF.
Mari lihat apa yang dilakukan setiap opsi pipeline. Flag do_ocr mengaktifkan optical character recognition. Saat memproses PDF digital dengan lapisan teks tersemat, Docling secara otomatis melewati OCR untuk menghemat waktu. Untuk dokumen hasil pindaian atau gambar yang berisi teks, pengaturan ini memberi tahu Docling untuk menjalankan model visi guna mengekstrak teks.
Opsi do_table_structure mengaktifkan pengenalan struktur tabel. Tanpa ini, tabel diekstrak sebagai teks biasa dengan format yang hilang. Dengan ini aktif, Docling menggunakan model AI TableFormer untuk mengidentifikasi baris, kolom, header, dan relasi sel. Representasi terstruktur ini memungkinkan Anda mengekspor tabel sebagai pandas DataFrame nanti, menjaga format tabular.
Mengatur generate_picture_images ke True mengaktifkan ekstraksi gambar. Secara default, Docling hanya mencatat lokasi gambar tanpa mengekstrak gambar sebenarnya. Mengaktifkan ini memberi Anda objek gambar PIL yang bisa ditampilkan di UI atau diproses dengan model visi. Parameter images_scale mengontrol resolusi ekstraksi—nilai 2.0 menggandakan resolusi untuk kualitas lebih baik saat menampilkan gambar atau menjalankan analisis tambahan.
Dengan pipeline terkonfigurasi, kita dapat menambahkan metode yang memproses file yang diunggah melalui Streamlit. Metode ini menangani objek file Streamlit, menyimpannya sementara, menjalankan konversi Docling, dan mengembalikan markdown untuk RAG serta dokumen Docling untuk visualisasi:
import os
import tempfile
from typing import List, Any

def process_uploaded_files(self, uploaded_files) -> tuple[List[Document], List[Any]]:
    documents = []
    docling_docs = []
    temp_dir = tempfile.mkdtemp()

    try:
        for uploaded_file in uploaded_files:
            # Save uploaded file to temporary location
            temp_file_path = os.path.join(temp_dir, uploaded_file.name)
            with open(temp_file_path, "wb") as f:
                f.write(uploaded_file.getbuffer())
Streamlit menyediakan file yang diunggah sebagai objek file dalam memori, tetapi Docling memerlukan file aktual di disk untuk diproses. Kita membuat direktori sementara dan menulis setiap file yang diunggah ke sana, mempertahankan nama file aslinya.
# Process the document with Docling
result = self.converter.convert(temp_file_path)

# Export to markdown
markdown_content = result.document.export_to_markdown()
Panggilan converter.convert() menjalankan pipeline analisis dokumen penuh milik Docling. Docling mengidentifikasi tata letak dokumen, menerapkan OCR jika perlu, mendeteksi tabel dan gambar, dan membangun representasi terstruktur. Harapkan 20–30 detik untuk pemrosesan tanpa ekstraksi gambar, atau 40–60 detik dengan gambar diaktifkan.
Setelah konversi selesai, kita ekspor ke format markdown yang menghasilkan teks bersih dan ramah LLM dengan format yang terjaga — header tetap header, daftar tetap terstruktur, dan tabel dikonversi menjadi tabel markdown.
# Create LangChain document
doc = Document(
    page_content=markdown_content,
    metadata={
        "filename": uploaded_file.name,
        "file_type": uploaded_file.type,
        "source": uploaded_file.name,
    }
)

documents.append(doc)

# Store the Docling document for structure visualization
docling_docs.append({
    "filename": uploaded_file.name,
    "doc": result.document
})
Kita membuat dua representasi untuk setiap dokumen yang diproses. Objek Document LangChain berisi teks markdown sebagai page_content dengan metadata terkait—ini masuk ke vector store untuk RAG. Objek dokumen Docling asli disimpan terpisah bersama nama filenya, mempertahankan semua informasi struktural (tabel, gambar, hierarki) untuk visualisasi nanti.
finally:
    import shutil
    shutil.rmtree(temp_dir)

return documents, docling_docs
Blok finally memastikan file sementara dibersihkan terlepas dari apakah pemrosesan berhasil atau gagal. Kita mengembalikan tuple yang berisi kedua representasi dokumen: dokumen LangChain untuk sistem RAG dan dokumen Docling untuk visualisasi struktur.
Pemroses dokumen sekarang siap. Selanjutnya, kita akan membangun antarmuka Streamlit yang memungkinkan pengguna mengunggah file dan melihat status pemrosesan.
📄 Skrip lengkap: src/structure_visualizer.py
Sekarang kita dapat memproses dokumen dengan Docling, kita perlu cara untuk memvisualisasikan apa yang diekstrak. Objek dokumen Docling mentah berisi informasi struktural yang kaya (heading, tabel, gambar, dan metadata) tetapi bentuk aslinya tidak ramah pengguna. Kita akan membangun lapisan visualisasi yang mengubah data ini menjadi antarmuka interaktif dengan empat tampilan: dasbor ringkasan, kerangka hierarkis, tabel interaktif, dan gambar yang diekstrak.
Buat file baru bernama structure_visualizer.py di direktori src/ Anda. Komponen ini akan mengurai struktur dokumen Docling dan mengorganisasikannya untuk ditampilkan.
Mulailah dengan membuat kelas yang membungkus dokumen Docling dan menyediakan metode untuk mengekstrak berbagai elemen struktural:
from typing import List, Dict, Any
import pandas as pd
from docling_core.types.doc import DoclingDocument

class DocumentStructureVisualizer:
    def __init__(self, docling_document: DoclingDocument):
        self.doc = docling_document
Inisialisator menerima objek DoclingDocument (objek yang sama yang dikembalikan oleh DocumentConverter.convert()). Objek ini berisi semua yang diekstrak Docling dari dokumen. Atribut texts berisi semua elemen teks dengan label dan posisinya, tables menyimpan data tabel dengan informasi struktur, pictures menyimpan metadata gambar dan data gambar aktual, dan pages menyediakan informasi tingkat halaman.
Dokumen memiliki struktur yang melampaui paragraf. Heading menciptakan hierarki yang membantu pembaca menavigasi konten. Berikut cara mengekstrak hierarki ini:
def get_document_hierarchy(self) -> List[Dict[str, Any]]:
    hierarchy = []

    if not hasattr(self.doc, "texts") or not self.doc.texts:
        return hierarchy

    for item in self.doc.texts:
        label = getattr(item, "label", None)

        if label and "header" in label.lower():
            text = getattr(item, "text", "")
            prov = getattr(item, "prov", [])
            page_no = prov[0].page_no if prov else None

            hierarchy.append({
                "type": label,
                "text": text,
                "page": page_no,
                "level": self._infer_heading_level(label)
            })

    return hierarchy
Kita melakukan iterasi melalui semua item teks dalam dokumen, memfilter yang memiliki label mengandung header. Setiap item teks memiliki atribut label yang ditetapkan Docling selama analisis tata letak. Label umum termasuk section_header, page_header, title, dan text biasa. Atribut prov (kependekan dari provenance) berisi informasi posisi, termasuk halaman tempat elemen muncul. Kita mengekstrak teks heading, nomor halamannya, dan menyimpulkan tingkat hierarkinya dari tipe label.
Saat menampilkan kerangka, tingkat heading menentukan indentasi. Metode pembantu memetakan tipe label ke level numerik:
def _infer_heading_level(self, label: str) -> int:
    if "title" in label.lower():
        return 1
    elif "section" in label.lower():
        return 2
    elif "subsection" in label.lower():
        return 3
    else:
        return 4
Ini membuat hierarki di mana judul dokumen adalah level 1, header seksi level 2, subseksi level 3, dan header lainnya default ke level 4.
Dengan hierarki dokumen diekstraksi, mari tangani tabel. Berbeda dengan ekstraksi teks sederhana yang mengubah tabel menjadi string acak, Docling mempertahankan strukturnya sebagai salah satu fitur paling berharganya:
def get_tables_info(self) -> List[Dict[str, Any]]:
    tables_info = []

    if not hasattr(self.doc, "tables") or not self.doc.tables:
        return tables_info

    for i, table in enumerate(self.doc.tables, 1):
        try:
            df = table.export_to_dataframe(doc=self.doc)

            prov = getattr(table, "prov", [])
            page_no = prov[0].page_no if prov else None

            caption_text = getattr(table, "caption_text", None)
            caption = caption_text if caption_text and not callable(caption_text) else None

            tables_info.append({
                "table_number": i,
                "page": page_no,
                "caption": caption,
                "dataframe": df,
                "shape": df.shape,
                "is_empty": df.empty
            })
        except Exception as e:
            print(f"Warning: Could not process table {i}: {e}")
            continue

    return tables_info
Metode table.export_to_dataframe(doc=self.doc) mengonversi representasi tabel Docling menjadi pandas DataFrame. Kita mengekstrak keterangan (caption) dan nomor halaman jika tersedia.
Selain tabel, Docling dapat mengekstrak data gambar aktual dari dokumen. Ini adalah fitur yang lebih baru yang melampaui sekadar melacak posisi gambar — Docling mengambil byte gambar sebenarnya sehingga Anda dapat menampilkannya. (Kita mengaktifkan ini di opsi pipeline pemroses dokumen.)
def get_pictures_info(self) -> List[Dict[str, Any]]:
    pictures_info = []

    if not hasattr(self.doc, "pictures") or not self.doc.pictures:
        return pictures_info

    for i, pic in enumerate(self.doc.pictures, 1):
        prov = getattr(pic, "prov", [])

        if prov:
            page_no = prov[0].page_no
            bbox = prov[0].bbox

            caption_text = getattr(pic, "caption_text", None)
            caption = caption_text if caption_text and not callable(caption_text) else None

            pil_image = None
            try:
                if hasattr(pic, "image") and pic.image is not None:
                    if hasattr(pic.image, "pil_image"):
                        pil_image = pic.image.pil_image
            except Exception as e:
                print(f"Warning: Could not extract image {i}: {e}")

            pictures_info.append({
                "picture_number": i,
                "page": page_no,
                "caption": caption,
                "pil_image": pil_image,
                "bounding_box": {
                    "left": bbox.l,
                    "top": bbox.t,
                    "right": bbox.r,
                    "bottom": bbox.b
                } if bbox else None
            })

    return pictures_info
Setiap gambar memiliki informasi provenance, termasuk nomor halaman dan koordinat bounding box. Bounding box mendefinisikan posisi gambar pada halaman menggunakan koordinat kiri, atas, kanan, dan bawah.
Saat ekstraksi gambar diaktifkan, objek gambar memiliki atribut image yang berisi data gambar aktual. Kita mengakses gambar PIL melalui picture.image.pil_image, yang mengembalikan objek PIL Image yang dapat ditampilkan langsung oleh Streamlit dengan st.image(). Blok try-except menangani kasus di mana ekstraksi gambar gagal atau tidak diaktifkan, dengan mulus kembali hanya menampilkan metadata.
Visualizer membutuhkan satu metode lagi: ringkasan tingkat tinggi yang memberi pengguna gambaran struktur dokumen:
def get_document_summary(self) -> Dict[str, Any]:
    pages = getattr(self.doc, "pages", {})
    texts = getattr(self.doc, "texts", [])
    tables = getattr(self.doc, "tables", [])
    pictures = getattr(self.doc, "pictures", [])

    text_types = {}
    for item in texts:
        label = getattr(item, "label", "unknown")
        text_types[label] = text_types.get(label, 0) + 1

    return {
        "name": self.doc.name,
        "num_pages": len(pages) if pages else 0,
        "num_texts": len(texts),
        "num_tables": len(tables),
        "num_pictures": len(pictures),
        "text_types": text_types
    }
Kita menghitung jumlah halaman, elemen teks, tabel, dan gambar dalam dokumen. Kamus text_types merinci elemen teks berdasarkan labelnya, menunjukkan berapa banyak judul, header, paragraf, dan elemen lain yang diidentifikasi Docling. Ini memberi pengguna gambaran cepat tentang struktur dan kompleksitas dokumen.
Dengan visualizer selesai, mari integrasikan ke Streamlit dengan empat tab: Summary, Hierarchy, Tables, dan Images.
def render_structure_viz():
    st.title("📊 Document Structure")

    if not st.session_state.docling_docs:
        st.info("👈 Please upload and process your documents first!")
        return

    doc_names = [doc["filename"] for doc in st.session_state.docling_docs]
    selected_doc_name = st.selectbox("Select document to analyze:", doc_names)

    selected_doc_data = next(
        (doc for doc in st.session_state.docling_docs if doc["filename"] == selected_doc_name),
        None
    )

    if not selected_doc_data:
        return

    visualizer = DocumentStructureVisualizer(selected_doc_data["doc"])

    tab1, tab2, tab3, tab4 = st.tabs(["📑 Summary", "🏗️ Hierarchy", "📊 Tables", "🖼️ Images"])
Kita membuat dropdown untuk memungkinkan pengguna memilih dokumen mana yang akan dianalisis (berguna saat banyak file diunggah). Setelah mendapatkan dokumen Docling yang dipilih dari session state, kita membuat instance visualizer dan membuat empat tab untuk tampilan berbeda.
with tab1:
    st.subheader("Document Summary")
    summary = visualizer.get_document_summary()

    col1, col2, col3, col4 = st.columns(4)
    with col1:
        st.metric("Pages", summary["num_pages"])
    with col2:
        st.metric("Tables", summary["num_tables"])
    with col3:
        st.metric("Images", summary["num_pictures"])
    with col4:
        st.metric("Text Items", summary["num_texts"])

    st.subheader("Content Types")
    text_types_df = pd.DataFrame([
        {"Type": k, "Count": v}
        for k, v in sorted(summary["text_types"].items(), key=lambda x: -x[1])
    ])
    st.dataframe(text_types_df, use_container_width=True)

with tab2:
    st.subheader("Document Hierarchy")
    hierarchy = visualizer.get_document_hierarchy()

    if hierarchy:
        for item in hierarchy:
            indent = "  " * (item["level"] - 1)
            st.markdown(f"{indent}**{item['text']}** _(Page {item['page']})_")
    else:
        st.info("No hierarchical structure detected")

with tab3:
    st.subheader("Tables")
    tables_info = visualizer.get_tables_info()

    if tables_info:
        for table_data in tables_info:
            st.markdown(f"### Table {table_data['table_number']} (Page {table_data['page']})")

            if table_data["caption"]:
                st.caption(table_data["caption"])

            if not table_data["is_empty"]:
                st.dataframe(table_data["dataframe"], use_container_width=True)
            else:
                st.info("Table is empty")

            st.divider()
    else:
        st.info("No tables found in this document")

with tab4:
    st.subheader("Images")
    pictures_info = visualizer.get_pictures_info()

    if pictures_info:
        for pic_data in pictures_info:
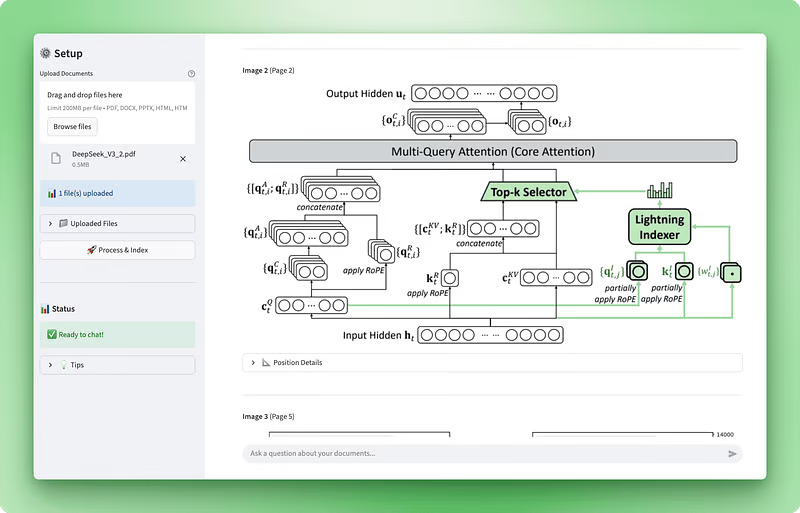
            st.markdown(f"**Image {pic_data['picture_number']}** (Page {pic_data['page']})")

            if pic_data["caption"]:
                st.caption(pic_data["caption"])

            if pic_data["pil_image"] is not None:
                st.image(pic_data["pil_image"], use_container_width=True)
            else:
                st.info("Image data not available")

            if pic_data["bounding_box"]:
                bbox = pic_data["bounding_box"]
                with st.expander("📐 Position Details"):
                    st.text(
                        f"Position: ({bbox['left']:.1f}, {bbox['top']:.1f}) - "
                        f"({bbox['right']:.1f}, {bbox['bottom']:.1f})"
                    )

            st.divider()
    else:
        st.info("No images found in this document")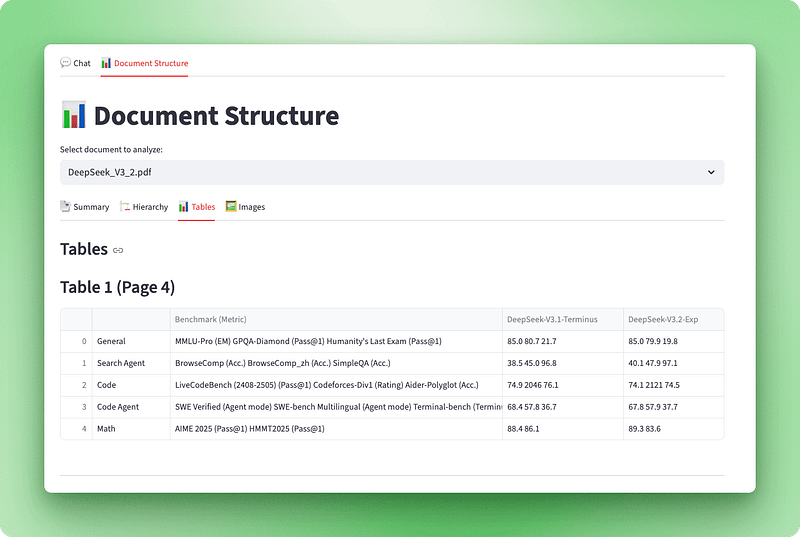
Visualizer struktur telah selesai. Pengguna dapat mengunggah dokumen dan langsung melihat anatominya — berapa banyak halaman, tabel, dan gambar yang dikandungnya, struktur hierarkis dengan heading dan seksi, tabel interaktif yang bisa dijelajahi, serta gambar aktual yang diekstrak dari dokumen. Transparansi ini membantu pengguna memahami apa yang diekstrak Docling dan membangun kepercayaan pada sistem.
Dengan pemrosesan dokumen dan visualisasi yang berfungsi, kita dapat membangun sistem RAG yang memungkinkan tanya jawab atas dokumen yang telah diproses ini.
📄 Skrip lengkap: src/vectorstore.py | src/tools.py
Dengan pemrosesan dokumen dan visualisasi selesai, kita dapat membangun kapabilitas Q&A. RAG (Retrieval Augmented Generation) memungkinkan pengguna mengajukan pertanyaan tentang dokumen mereka. Sistem mengonversi dokumen menjadi embedding, menyimpannya di basis data vektor, dan mengambil potongan relevan untuk menjawab pertanyaan.
Bagian ini membahas dua komponen: pengelola vector store yang melakukan chunking dan embedding dokumen, serta alat pencarian yang mengambil informasi relevan.
Vector store adalah tempat embedding dokumen berada. Saat pengguna mengajukan pertanyaan, kita mencari potongan relevan di store ini dan memberikannya ke LLM sebagai konteks.
Buat vectorstore.py di direktori src/ Anda:
from typing import List
from langchain_core.documents import Document
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings
from langchain_chroma import Chroma
Impor ini menghadirkan komponen LangChain untuk penanganan dokumen, pemecahan teks, pembuatan embedding, dan penyimpanan vektor ChromaDB. Berikut cara kerjanya bersama:
class VectorStoreManager:
    def __init__(self):
        self.embeddings = OpenAIEmbeddings(model="text-embedding-3-small")
        self.text_splitter = RecursiveCharacterTextSplitter(
            chunk_size=1000,
            chunk_overlap=100,
            length_function=len,
        )
Kita menginisialisasi dua komponen kunci. Model text-embedding-3-small dari OpenAI mengonversi teks menjadi vektor. Model ini lebih kecil dan lebih cepat daripada text-embedding-3-large, yang penting saat melakukan embedding ratusan potongan. RecursiveCharacterTextSplitter membagi dokumen menjadi potongan 1000 karakter dengan overlap 100 karakter, memastikan informasi penting di batas potongan tidak terpotong di tengah kalimat.
1000 karakter menyeimbangkan presisi dan konteks — potongan lebih kecil memberi pengambilan yang presisi namun kehilangan konteks, potongan lebih besar menjaga konteks namun menurunkan relevansi.
Tambahkan metode chunking:
def chunk_documents(self, documents: List[Document]) -> List[Document]:
    """Split documents into smaller chunks for better retrieval."""
    chunks = self.text_splitter.split_documents(documents)
    return chunks
Pemecah menangani metadata secara otomatis, mempertahankan informasi dari dokumen asli. Setiap potongan mengetahui dari file mana asalnya, yang menjadi penting saat agen mengutip sumber dalam jawabannya.
Sekarang tambahkan metode yang membuat vector store:
def create_vectorstore(self, chunks: List[Document]) -> Chroma:
    """Create a Chroma vector store from document chunks."""
    vectorstore = Chroma.from_documents(
        documents=chunks,
        embedding=self.embeddings,
        collection_name="documents"
    )
    return vectorstore
ChromaDB menangani pekerjaan berat. ChromaDB melakukan embedding setiap potongan menggunakan model embedding kita dan menyimpan vektor di memori. Saat Anda menjalankan pencarian kemiripan, ChromaDB menghitung cosine similarity antara vektor kueri dan semua vektor dokumen, mengembalikan kecocokan terdekat.
Dengan vector store siap menangani embedding, kita perlu memberi agen cara untuk menanyakannya. Tools adalah fungsi yang bisa dipanggil LLM saat membutuhkan informasi yang tidak dimilikinya.
Buat tools.py di direktori src/ Anda:
from typing import Annotated
from langchain_core.tools import tool

def create_search_tool(vectorstore):
    """Create a search tool that has access to the vector store."""
Fungsi factory ini menggunakan pola closure: menerima vector store dan mengembalikan tool yang dapat menelusurinya. Tool mempertahankan akses ke vector store tanpa perlu variabel global.
@tool
def search_documents(query: Annotated[str, "The search query or question about the documents"]) -> str:
    """Search the uploaded documents for relevant information."""
Dekorator @tool mengubah fungsi ini menjadi tool LangChain yang dapat dipanggil agen. Type hint Annotated mendeskripsikan parameter, membantu LLM memahami apa yang harus dilewatkan saat memanggil tool.
try:
   results = vectorstore.similarity_search(query, k=8)

   if not results:
      return "No relevant information found in the documents for this query."
Kita mengambil 8 potongan serupa (k=8) dari vector store. Ini memberi LLM cukup konteks tanpa membebani dengan informasi berulang. Jumlah yang tepat bergantung pada tipe dokumen—dokumen teknis dengan informasi padat mungkin lebih baik dengan potongan lebih sedikit (k=4–6), sementara dokumen naratif mungkin mendapatkan manfaat dari lebih banyak (k=10–12).
context_parts = []
for i, doc in enumerate(results, 1):
    source = doc.metadata.get("filename", doc.metadata.get("source", "Unknown source"))
    content = doc.page_content.strip()

    context_parts.append(
        f"[Source {i}: {source}]\n"
        f"Content: {content}\n"
    )

return "\n---\n".join(context_parts)
Kita memformat setiap potongan dengan nama file sumbernya, lalu menggabungkannya dengan pemisah. LLM menerima konteks terstruktur ini dan menggunakannya untuk menghasilkan jawaban sambil mengutip sumber.
except Exception as e:
    return f"Error searching documents: {str(e)}"

return search_documents
Penanganan galat memastikan agen menerima pesan yang jelas jika pencarian gagal, alih-alih crash. Fungsi mengembalikan tool yang terkonfigurasi siap digunakan agen.
Vector store dan alat pencarian sekarang siap. Selanjutnya, kita akan membangun agen LangGraph yang mengorkestrasi pengambilan dan generasi untuk menjawab pertanyaan pengguna.
📄 Skrip lengkap: src/agent.py
Alat pencarian dapat menanyakan vector store, tetapi membutuhkan koordinator yang cerdas. Agen LangGraph memutuskan kapan harus mencari, menafsirkan hasil, dan menghasilkan jawaban bahasa alami. Kita juga akan mengimplementasikan streaming untuk menampilkan progres secara real-time.
Agen menerima pertanyaan, memutuskan kapan mencari dokumen, dan menghasilkan jawaban berdasarkan konteks yang diambil.
Buat agent.py di direktori src/ Anda:
from typing import List
from langchain_core.tools import BaseTool
from langchain_openai import ChatOpenAI
from langgraph.prebuilt import create_react_agent
from langgraph.checkpoint.memory import MemorySaver
Kita mengimpor komponen untuk penanganan tool, model chat OpenAI, implementasi agen ReAct LangGraph, dan memori percakapan.
SYSTEM_PROMPT = """You are a helpful document intelligence assistant. You have access to documents that have been uploaded and processed.

GUIDELINES:
- Use the search_documents tool to find relevant information
- Keep it simple: one well-crafted search is usually sufficient
- Only search again if the first results are clearly incomplete
- Provide clear, accurate answers based on the document contents
- Always cite your sources with filenames
- If information isn't found, say so clearly
- Be concise but thorough

When answering:
1. Search the documents with a focused query
2. Synthesize a clear answer from the results
3. Include source citations (filenames)
4. Only search again if absolutely necessary
"""

def create_documentation_agent(tools: List[BaseTool], model_name: str = "gpt-4o-mini"):
    """Create a document intelligence assistant agent using LangGraph."""
    llm = ChatOpenAI(model=model_name, temperature=0)
    memory = MemorySaver()
Kita menggunakan gpt-4o-mini alih-alih gpt-5 karena lebih cepat dan lebih murah namun tetap mampu menangani Q&A dokumen dengan baik. Temperature disetel ke 0 untuk respons yang konsisten dan faktual. MemorySaver memberi agen memori percakapan, sehingga mengingat pertukaran sebelumnya dalam satu sesi.
agent = create_react_agent(
    llm,
    tools=tools,
    prompt=SYSTEM_PROMPT,
    checkpointer=memory
)

return agent
create_react_agent milik LangGraph mengimplementasikan pola ReAct (Reasoning + Acting). Agen bernalar tentang apa yang perlu dilakukan, mengambil tindakan menggunakan tools, mengamati hasil, dan mengulang sampai memperoleh jawaban. Pola ini bekerja baik untuk RAG karena agen dapat memutuskan kapan harus menelusur dan bagaimana menggunakan konteks yang diambil.
Agen sekarang dapat menelusur dan menghasilkan jawaban, namun pengguna tidak seharusnya menunggu 10 detik menatap layar kosong saat agen bekerja. Streaming menampilkan progres secara real-time — pertama indikator “thinking” muncul, lalu “searching”, kemudian jawaban muncul token demi token.
Perbarui fungsi render_chat() di app.py untuk melengkapi penanganan respons yang sebelumnya kita tandai TODO:
if prompt:
    st.session_state.messages.append({"role": "user", "content": prompt})
    with st.chat_message("user"):
        st.markdown(prompt)
Kita menambahkan pesan pengguna ke riwayat percakapan dan menampilkannya di antarmuka chat.
with st.chat_message("assistant"):
    status_placeholder = st.empty()
    message_placeholder = st.empty()

    try:
        config = {"configurable": {"thread_id": "document_chat"}}
Kita membuat placeholder untuk indikator status dan pesan respons. Konfigurasi mencakup thread ID yang digunakan LangGraph untuk mempertahankan memori percakapan lintas giliran.
def generate_response():
    """Generator that yields tokens from LangGraph stream."""
    status_placeholder.markdown("🤔 **Thinking...**")
    first_content_token = True
    tool_call_detected = False
    final_answer_started = False
Fungsi generator ini memproses output stream LangGraph. Kita melacak status dengan flag untuk menampilkan pesan status yang sesuai saat agen menjalankan alur kerjanya.
for msg, metadata in st.session_state.agent.stream(
    {"messages": [HumanMessage(content=prompt)]},
    config=config,
    stream_mode="messages",
):
    langgraph_node = metadata.get("langgraph_node", "")
Parameter stream_mode="messages" memberi kita token LLM nyata saat dihasilkan, bukan hanya output akhir. LangGraph memancarkan event sepanjang eksekusi agen—saat mulai berpikir, saat memanggil tools, dan saat menghasilkan teks.
if "tools" in langgraph_node.lower() or "tool" in langgraph_node.lower():
    if not tool_call_detected:
        status_placeholder.markdown("🔍 **Searching documents...**")
        tool_call_detected = True
    continue

if "agent" in langgraph_node.lower() and hasattr(msg, "content"):
    content = msg.content

if content:
    if first_content_token:
        status_placeholder.markdown("💬 **Generating answer...**")
        first_content_token = False
        final_answer_started = True

if final_answer_started:
    yield content
Ketika node agen mulai menghasilkan jawaban akhir, kita memperbarui status dan mulai mengalirkan token konten. Setiap token langsung ditampilkan, menciptakan efek mengetik yang mulus.
status_placeholder.empty()

with message_placeholder.container():
    full_response = st.write_stream(generate_response())
Setelah streaming selesai, kita menghapus indikator status. st.write_stream() milik Streamlit menangani tampilan token demi token secara otomatis, mengakumulasi token dan memperbarui UI dengan mulus. Hasilnya adalah pengalaman chat yang terasa responsif dan memberi keyakinan kepada pengguna bahwa sistem sedang bekerja.
st.session_state.messages.append({"role": "assistant", "content": full_response})

except Exception as e:
    st.error(f"Error generating response: {str(e)}")
Kita menyimpan respons lengkap ke riwayat pesan dan menangani kesalahan yang terjadi selama streaming.
Sistem RAG selesai. Pengguna kini dapat mengunggah dokumen, memprosesnya dengan Docling, mengeksplorasi strukturnya, dan bercakap secara alami tentang kontennya. Agen menelusur secara cerdas, mengutip sumber, dan mengalirkan jawaban untuk pengalaman yang mulus.
Document Intelligence Assistant Anda selesai. Sebelum melakukan deployment atau berbagi, Anda harus menguji aplikasi untuk memverifikasi semuanya bekerja dengan benar.
Mulai aplikasi dari root proyek Anda:
streamlit run app.pyStreamlit akan membuka jendela peramban di http://localhost:8501. Anda akan melihat sidebar dengan kontrol unggah dan dua tab di area utama.
Unggah dokumen PDF contoh dengan tabel dan gambar untuk menguji kemampuan pemrosesan penuh:
Perhatikan indikator pemrosesan:
Jika selesai, Anda akan melihat “✅ Ready to chat!” di bagian status.
Beralih ke tab “Document Structure” untuk memverifikasi Docling mengekstrak semuanya dengan benar:
Jika tabel tampil kosong atau gambar tidak muncul, periksa bahwa Anda mengaktifkan do_table_structure=True dan generate_picture_images=True di opsi pipeline.
Kembali ke tab “Chat” dan uji agen dengan pertanyaan contoh berikut:
Pertanyaan awal yang baik:
Pertanyaan spesifik dokumen (sesuaikan berdasarkan dokumen Anda):
Pertanyaan tindak lanjut untuk menguji memori percakapan:
Cari jawaban langsung dari dokumen Anda dengan kutipan sumber, aliran token yang mulus, dan indikator status (“Thinking…”, “Searching documents…”, “Generating answer…”). Waspadai respons generik yang bukan dari dokumen Anda, kutipan sumber yang hilang, respons lambat tanpa indikator status, atau galat tentang kunci API yang hilang.
Galat “No module named ‘docling’”
pip install docling langchain langchain-openai langchain-chroma langgraph streamlit streamlit-extras pandas python-dotenv
Galat “OpenAI API key not found”
Verifikasi file .env ada dengan OPENAI_API_KEY=your-key-here
Mulai ulang Streamlit
Pemrosesan memakan waktu lebih dari 60 detik
Agen memberi jawaban generik
Tabel tampil sebagai DataFrame kosong
Pastikan do_table_structure=True di PdfPipelineOptions
Coba PDF lain dengan tabel native
Aplikasi kini tervalidasi dan siap digunakan. Anda dapat mengujinya dengan dokumen Anda sendiri atau melakukan deployment agar dapat digunakan orang lain.
Sekarang Anda memiliki Document Intelligence Assistant yang berfungsi yang memproses PDF, dokumen Word, presentasi PowerPoint, dan file HTML sambil mempertahankan strukturnya. Docling mengekstrak teks, tabel, gambar, dan hierarki dokumen yang dapat dieksplorasi pengguna melalui tab interaktif. Sistem RAG, dipadukan dengan ChromaDB dan LangGraph, memungkinkan Q&A percakapan dengan kutipan sumber yang dialirkan secara real-time. Ini menunjukkan bagaimana pemrosesan dokumen yang sadar struktur meningkatkan kualitas pengambilan dibandingkan ekstraksi teks dasar. Kode sumber lengkap tersedia di repositori GitHub.
Fondasi ini membuka banyak arah pengembangan:
Untuk eksplorasi lebih dalam tentang sistem RAG dan aplikasi LLM, AI Engineering track kami membahas konsep dan pola yang Anda gunakan di sini.
Belajar bersama DataCamp
Kursus
Kursus
Program
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt




