
{count, plural, one {Kursus} other {Kursus}}
Pemrosesan Citra dengan Python
{hours} jam
57K
Menyalin teks dari gambar dan dokumen secara manual bisa sangat melelahkan dan memakan waktu. Untungnya, OCR (Optical Character Recognition) dapat mengotomatiskan proses ini, sehingga Anda dapat mengonversi gambar menjadi berkas teks yang dapat diedit dan dicari.
Teknik-teknik yang akan Anda pelajari dapat diterapkan pada banyak aplikasi:
Tutorial ini akan berfokus pada mesin Tesseract OCR dan API Python-nya — PyTesseract. Sebelum mulai menulis kode, mari meninjau singkat beberapa pustaka populer yang didedikasikan untuk OCR.
Karena OCR adalah masalah populer yang terus dikembangkan, banyak pustaka sumber terbuka mencoba menyelesaikannya. Di bagian ini, kita akan membahas yang paling populer karena kinerja dan akurasinya yang tinggi.
Tesseract OCR adalah mesin pengenalan karakter optik sumber terbuka yang paling populer di kalangan pengembang. Seperti alat lain dalam daftar ini, Tesseract dapat mengambil gambar berisi teks dan mengonversinya menjadi teks yang dapat diedit.
EasyOCR adalah pustaka Python yang dirancang untuk OCR (Optical Character Recognition) yang mudah digunakan. Sesuai namanya, pustaka ini menawarkan pendekatan ramah pengguna untuk mengekstrak teks dari gambar.
Keras-OCR adalah pustaka Python yang dibangun di atas Keras, kerangka kerja deep learning yang populer. Pustaka ini menyediakan model OCR siap pakai dan pipeline pelatihan end-to-end untuk membangun model OCR baru.
Berikut tabel yang merangkum perbedaan, kelebihan, dan kekurangannya:
|
Nama Paket |
Kelebihan |
Kekurangan |
|
Tesseract (pytesseract) |
Matang, banyak digunakan, dukungan luas |
Lebih lambat, akurasi lebih rendah pada tata letak kompleks |
|
EasyOCR |
Mudah digunakan, banyak model |
Akurasi lebih rendah, kustomisasi terbatas |
|
Keras-OCR |
Akurasi lebih tinggi, dapat disesuaikan |
Memerlukan GPU, kurva belajar lebih curam |
Dalam tutorial ini, kita akan berfokus pada PyTesseract, yakni API Python untuk Tesseract. Kita akan mempelajari cara mengekstrak teks dari gambar sederhana, cara menggambar bounding box di sekitar teks, dan melakukan studi kasus dengan dokumen hasil pindai.
PyTesseract berjalan di atas mesin Tesseract resmi, yang merupakan perangkat lunak CLI terpisah. Sebelum menginstal pytesseract, Anda harus memasang mesinnya terlebih dahulu. Di bawah ini adalah panduan instalasi untuk berbagai platform.
Untuk Ubuntu atau WSL2 (pilihan saya):
$ sudo apt update && sudo apt upgrade
$ sudo apt install tesseract-ocr
$ sudo apt install libtesseract-dev
Untuk Mac menggunakan Homebrew:
$ brew install tesseract
Untuk Windows, ikuti petunjuk dari halaman GitHub ini.
Selanjutnya, buat lingkungan virtual baru. Saya akan menggunakan Conda:
$ conda create -n ocr python==3.9 -y
$ conda activate ocr
Kemudian, Anda harus menginstal pytesseract untuk melakukan OCR dan opencv untuk manipulasi gambar:
$ pip install pytesseract
$ pip install opencv-python
Jika Anda mengikuti tutorial ini di Jupyter, jalankan perintah ini di sesi terminal yang sama agar lingkungan virtual baru Anda ditambahkan sebagai kernel:
$ pip install ipykernel
$ ipython kernel install --user --name=ocr
Sekarang, kita bisa mulai menulis kode.
Kita mulai dengan mengimpor pustaka yang diperlukan:
import cv2
import pytesseract
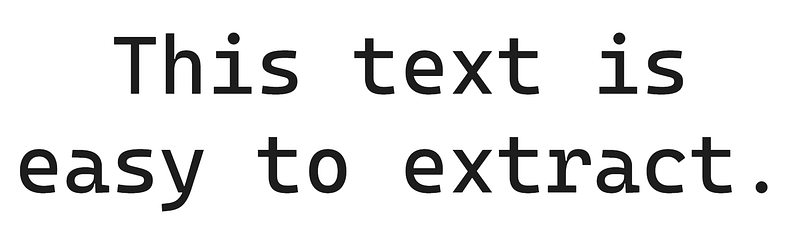
Tugas kita adalah membaca teks dari gambar berikut:
Pertama, kita menentukan path gambar dan memberikannya ke fungsi cv2.imread:
# Read image
easy_text_path = "images/easy_text.png"
easy_img = cv2.imread(easy_text_path)
Kemudian, kita meneruskan gambar yang dimuat ke fungsi image_to_string dari pytesseract untuk mengekstrak teks:
# Convert to text
text = pytesseract.image_to_string(easy_img)
print(text)
This text is
easy to extract.
Semudah itu! Mari mengubah apa yang baru saja kita lakukan menjadi sebuah fungsi:
def image_to_text(input_path):
   """
   A function to read text from images.
   """
   img = cv2.imread(input_path)
   text = pytesseract.image_to_string(img)

   return text.strip()
Mari gunakan fungsi tersebut pada gambar yang lebih menantang:
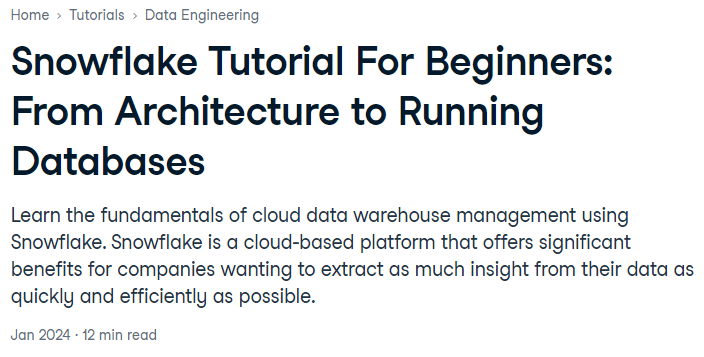
Gambar ini lebih menantang karena ada lebih banyak tanda baca dan teks dalam berbagai jenis font.
# Define image path
medium_text_path = "images/medium_text.png"

# Extract text
extracted_text = image_to_text(medium_text_path)
print(extracted_text)
Home > Tutorials » Data Engineering

Snowflake Tutorial For Beginners:
From Architecture to Running
Databases

Learn the fundamentals of cloud data warehouse management using
Snowflake. Snowflake is a cloud-based platform that offers significant
benefits for companies wanting to extract as much insight from their data as
quickly and efficiently as possible.

Jan 2024 - 12 min read
Fungsi kita bekerja hampir sempurna. Ada kekeliruan pada salah satu titik dan tanda “>”, tetapi hasilnya tetap dapat diterima.
Operasi umum dalam OCR adalah menggambar bounding box di sekitar teks. Operasi ini didukung di PyTesseract.
Pertama, kita meneruskan gambar yang dimuat ke fungsi image_to_data:
from pytesseract import Output

# Extract recognized data from easy text
data = pytesseract.image_to_data(easy_img, output_type=Output.DICT)
Bagian Output.DICT memastikan detail gambar dikembalikan sebagai kamus. Mari lihat isinya:
data{'level': [1, 2, 3, 4, 5, 5, 5, 4, 5, 5, 5],
'page_num': [1, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1],
'block_num': [0, 1, 1, 1, 1, 1, 1, 1, 1, 1, 1],
'par_num': [0, 0, 1, 1, 1, 1, 1, 1, 1, 1, 1],
'line_num': [0, 0, 0, 1, 1, 1, 1, 2, 2, 2, 2],
'word_num': [0, 0, 0, 0, 1, 2, 3, 0, 1, 2, 3],
'left': [0, 41, 41, 236, 236, 734, 1242, 41, 41, 534, 841],
'top': [0, 68, 68, 68, 68, 80, 68, 284, 309, 284, 284],
'width': [1658, 1550, 1550, 1179, 380, 383, 173, 1550, 381, 184, 750],
'height': [469, 371, 371, 128, 128, 116, 128, 155, 130, 117, 117],
'conf': [-1, -1, -1, -1, 96, 95, 95, -1, 96, 96, 96],
'text': ['', '', '', '', 'This', 'text', 'is', '', 'easy', 'to', 'extract.']}
Kamus tersebut memuat banyak informasi tentang gambar. Pertama, perhatikan kunci conf dan text. Keduanya memiliki panjang 11:
len(data["text"])11Ini berarti pytesseract menggambar 11 kotak. conf adalah confidence. Jika bernilai -1, maka kotak terkait digambar mengelilingi blok teks alih-alih kata per kata.
Sebagai contoh, jika Anda melihat empat nilai pertama dari width dan height, nilainya besar dibandingkan yang lain karena kotak-kotak tersebut digambar mengelilingi keseluruhan teks di tengah, lalu untuk setiap baris teks, serta keseluruhan gambar itu sendiri.
Selain itu:
left adalah jarak dari sudut kiri atas bounding box ke batas kiri gambar.top adalah jarak dari sudut kiri atas bounding box ke batas atas gambar.width dan height adalah lebar dan tinggi bounding box.Menggunakan informasi ini, mari kita gambar kotaknya di atas gambar di OpenCV.
Pertama, kita ekstrak lagi datanya dan panjangnya:
from pytesseract import Output

# Extract recognized data
data = pytesseract.image_to_data(easy_img, output_type=Output.DICT)
n_boxes = len(data["text"])
Lalu, kita membuat loop sebanyak jumlah kotak yang ditemukan:
for i in range(n_boxes):
   if data["conf"][i] == -1:
       continue
Di dalam loop, kita membuat kondisi yang melewati iterasi saat ini jika conf sama dengan -1. Melewatkan bounding box yang lebih besar akan menjaga gambar tetap bersih.
Lalu, kita mendefinisikan koordinat kotak saat ini, khususnya lokasi sudut kiri atas dan kanan bawah:
for i in range(n_boxes):
   if data["conf"][i] == -1:
       continue
   # Coordinates
   x, y = data["left"][i], data["top"][i]
   w, h = data["width"][i], data["height"][i]

   # Corners
   top_left = (x, y)
   bottom_right = (x + w, y + h)
Setelah mendefinisikan beberapa parameter kotak, seperti warna dan ketebalan kotak dalam piksel, kita meneruskan semua informasi ke fungsi cv2.rectangle:
for i in range(n_boxes):
   if data["conf"][i] == -1:
       continue
   # Coordinates
   x, y = data["left"][i], data["top"][i]
   w, h = data["width"][i], data["height"][i]

   # Corners
   top_left = (x, y)
   bottom_right = (x + w, y + h)

   # Box params
   green = (0, 255, 0)
   thickness = 3  # pixels

   cv2.rectangle(
       img=easy_img, pt1=top_left, pt2=bottom_right, color=green, thickness=thickness
   )
Fungsi tersebut akan menggambar kotak-kotak di atas gambar asli. Mari simpan gambarnya dan lihat:
# Save the image
output_image_path = "images/text_with_boxes.jpg"
cv2.imwrite(output_image_path, easy_img)
True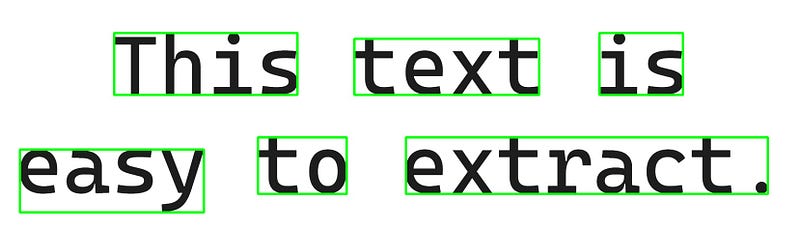
Hasilnya persis seperti yang kita inginkan!
Sekarang, mari kita masukkan semua yang telah kita lakukan ke dalam sebuah fungsi lagi:
def draw_bounding_boxes(input_img_path, output_path):
   img = cv2.imread(input_img_path)

   # Extract data
   data = pytesseract.image_to_data(img, output_type=Output.DICT)
   n_boxes = len(data["text"])

   for i in range(n_boxes):
       if data["conf"][i] == -1:
           continue
       # Coordinates
       x, y = data["left"][i], data["top"][i]
       w, h = data["width"][i], data["height"][i]

       # Corners
       top_left = (x, y)
       bottom_right = (x + w, y + h)

       # Box params
       green = (0, 255, 0)
       thickness = 1  # The function-version uses thinner lines

       cv2.rectangle(img, top_left, bottom_right, green, thickness)

   # Save the image with boxes
   cv2.imwrite(output_path, img)
Dan gunakan fungsinya pada teks tingkat menengah:
output_path = "images/medium_text_with_boxes.png"

draw_bounding_boxes(medium_text_path, output_path)
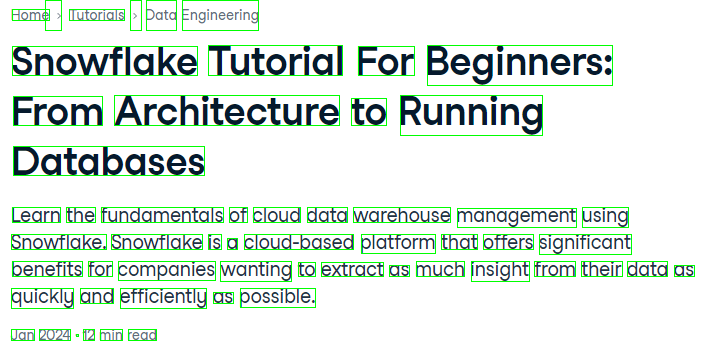
Bahkan untuk gambar yang lebih sulit, hasilnya sempurna!
Mari lakukan studi kasus pada contoh berkas PDF hasil pindai. Dalam praktiknya, sangat mungkin Anda akan bekerja dengan PDF hasil pindai alih-alih gambar, seperti ini:
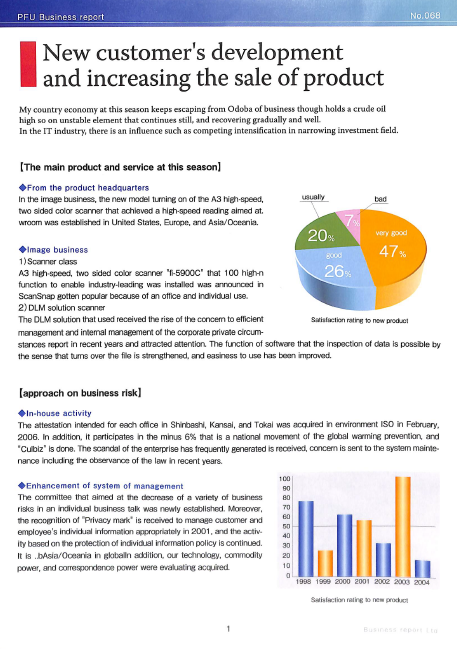
Anda dapat mengunduh PDF dari halaman GitHub saya ini.
Langkah berikutnya adalah memasang pustaka pdf2image, yang memerlukan perangkat lunak pemrosesan PDF bernama Poppler. Berikut petunjuk spesifik platform:
Untuk Mac:
$ brew install poppler
$ pip install pdf2image
Untuk Linux dan WSL2:
$ sudo apt-get install -y poppler-utils
$ pip install pdf2image
Untuk Windows, Anda dapat mengikuti petunjuknya dari dokumentasi PDF2Image.
Setelah instalasi, kita impor modul yang relevan:
import pathlib
from pathlib import Path

from pdf2image import convert_from_path
Fungsi convert_from_path mengonversi PDF yang diberikan menjadi serangkaian gambar. Berikut fungsi yang menyimpan setiap halaman berkas PDF sebagai gambar ke direktori tertentu:
def pdf_to_image(pdf_path, output_folder: str = "."):
   """
   A function to convert PDF files to images
   """
   # Create the output folder if it doesn't exist
   if not Path(output_folder).exists():
       Path(output_folder).mkdir()

   pages = convert_from_path(pdf_path, output_folder=output_folder, fmt="png")

   return pages
Mari jalankan pada dokumen kita:
pdf_path = "scanned_document.pdf"

pdf_to_image(pdf_path, output_folder="documents")
[<PIL.PngImagePlugin.PngImageFile image mode=RGB size=1662x2341>]
Keluaran berupa daftar yang berisi satu objek gambar PngImageFile. Mari lihat direktori documents:
$ ls documents
2d8f6922-99c4-4ef4-a475-ef81effe65a3-1.png
Gambarnya ada, jadi mari kita masukkan ke fungsi image_to_text yang kita buat di awal dan cetak beberapa ratus karakter pertama dari teks yang diekstrak:
scanned_img_path = "documents/2d8f6922-99c4-4ef4-a475-ef81effe65a3-1.png"

print(image_to_text(scanned_img_path)[:377])
PEU Business report

New customer's development
and increasing the sale of product

My country economy at this season keeps escaping from Odoba of business though holds a crude oil
high so on unstable element that continues still, and recovering gradually and well.
In the IT industry, there is an influence such as competing intensification in narrowing investment field.
Jika kita membandingkan teksnya dengan berkas, semuanya bekerja dengan baik — pemformatan dan spasi terjaga, dan teksnya akurat. Lalu, bagaimana cara membagikan teks yang diekstrak?
Cara terbaik untuk membagikan teks PDF yang diekstrak adalah sebagai berkas PDF lain! PyTesseract memiliki fungsi image_to_pdf_or_hocr yang mengambil gambar berisi teks dan mengonversinya menjadi berkas PDF mentah yang dapat dicari. Mari kita gunakan pada gambar hasil pindai kita:
raw_pdf = pytesseract.image_to_pdf_or_hocr(scanned_img_path)

with open("searchable_pdf.pdf", "w+b") as f:
   f.write(bytearray(raw_pdf))
Dan berikut tampilan searchable_pdf:
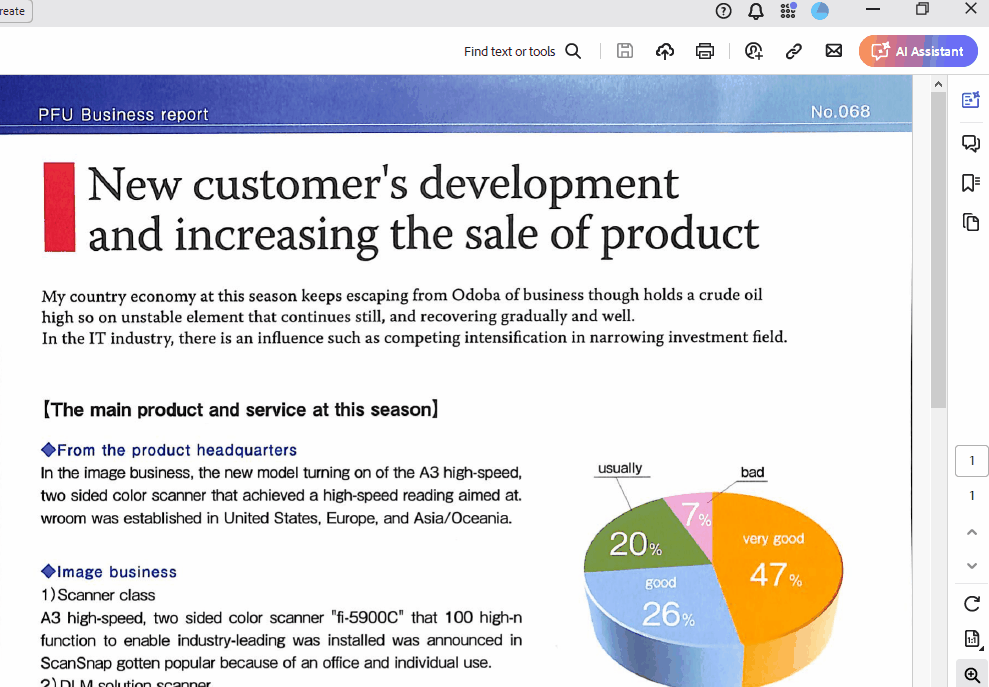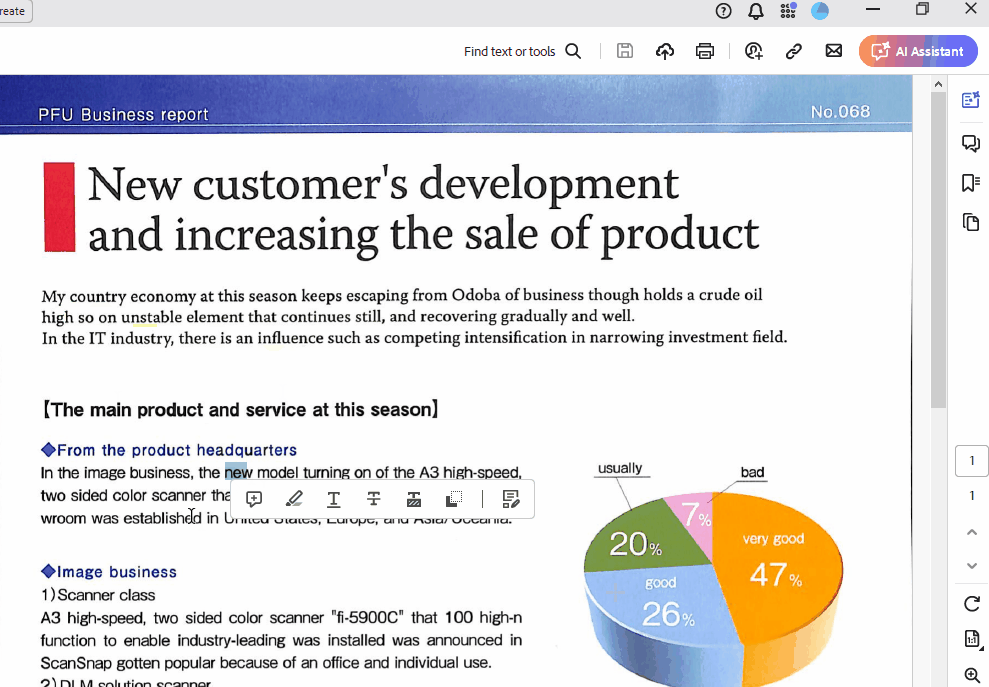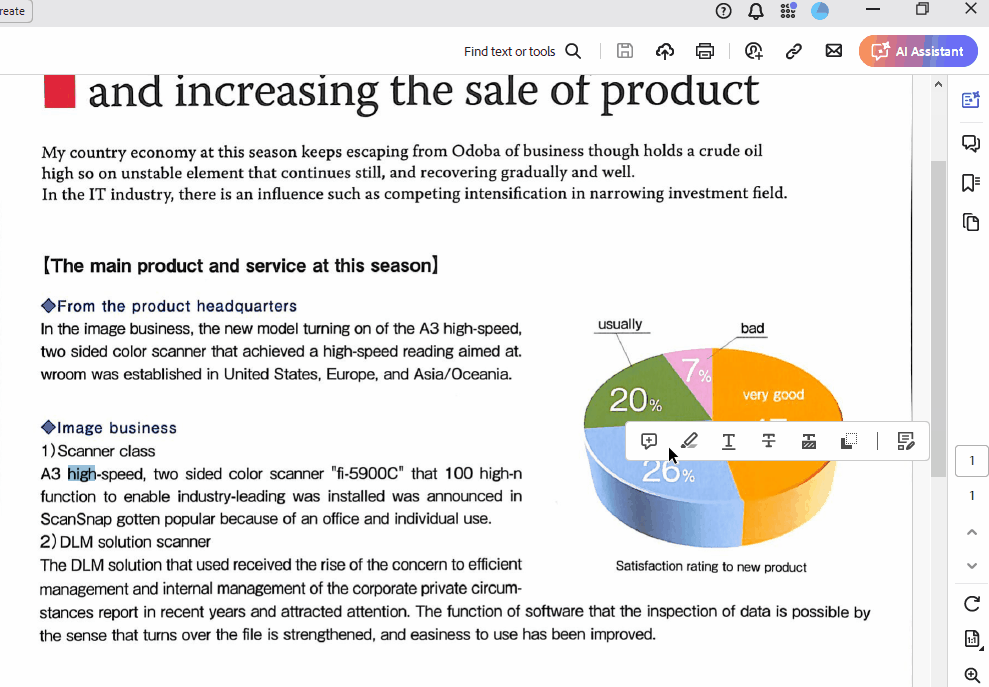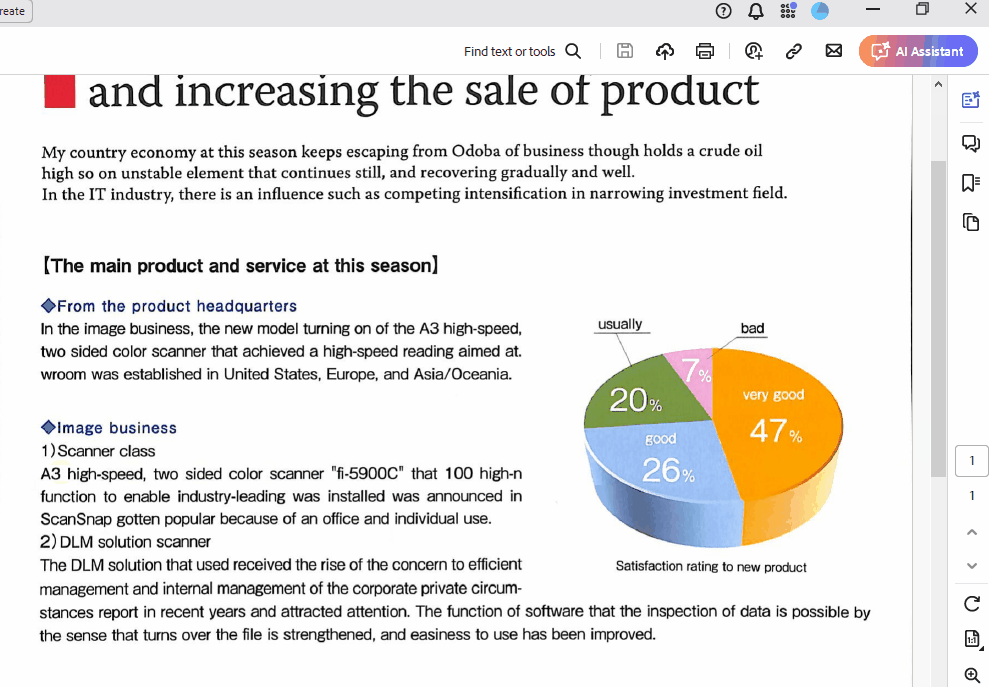
Seperti yang Anda lihat, saya dapat menyorot dan menyalin teks dari berkas tersebut. Selain itu, semua elemen PDF asli tetap terjaga.
Tidak ada pendekatan satu-ukuran-untuk-semua untuk OCR. Teknik-teknik yang kita bahas hari ini mungkin tidak bekerja pada jenis gambar lain. Saya sarankan Anda bereksperimen dengan berbagai teknik prapemrosesan gambar dan konfigurasi Tesseract untuk menemukan setelan optimal bagi gambar tertentu.
Faktor terpenting dalam OCR adalah kualitas gambar. Gambar yang dipindai dengan benar, tegak lurus, dan berkontras tinggi (hitam putih) cenderung bekerja paling baik dengan perangkat lunak OCR mana pun. Ingat, hanya karena Anda bisa membaca teksnya bukan berarti komputer Anda bisa.
Jika gambar Anda tidak memenuhi standar kualitas tinggi Tesseract dan keluarannya menjadi tidak jelas, ada beberapa langkah prapemrosesan yang dapat Anda lakukan.
Pertama, mulailah dengan mengonversi gambar berwarna ke grayscale. Ini dapat meningkatkan akurasi dengan menghilangkan variasi warna yang mungkin membingungkan proses pengenalan. Di OpenCV, tampilannya akan seperti ini:
def grayscale(image):
   """Converts an image to grayscale.

   Args:
       image: The input image in BGR format.

   Returns:
       The grayscale image.
   """
   return cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)
Tidak semua gambar, terutama dokumen hasil pindai, memiliki latar belakang yang bersih dan seragam. Selain itu, beberapa gambar mungkin berasal dari dokumen lama di mana halaman memburuk karena usia. Berikut contohnya:
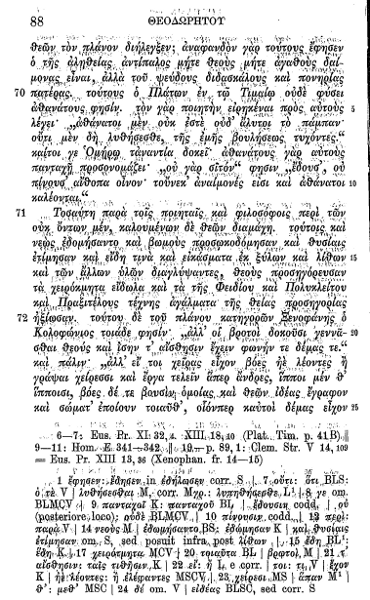
Terapkan teknik seperti filter denoising (misalnya median blur) untuk mengurangi artefak noise pada gambar yang dapat menyebabkan salah interpretasi selama OCR. Di OpenCV, Anda dapat menggunakan fungsi medianBlur:
def denoise(image):
   """Reduces noise in the image using a median blur filter.

   Args:
       image: The input grayscale image.

   Returns:
       The denoised image.
   """
   return cv2.medianBlur(image, 5)  # Adjust kernel size as needed
Dalam beberapa kasus, menajamkan gambar dapat mempertegas tepi dan meningkatkan pengenalan karakter, terutama untuk gambar buram atau beresolusi rendah. Penajaman dapat dilakukan dengan menerapkan filter Laplacian di OpenCV:
def sharpen(image):
   """Sharpens the image using a Laplacian filter.

   Args:
       image: The input grayscale image.

   Returns:
       The sharpened image (be cautious with sharpening).
   """
   kernel = np.array([[0, -1, 0], [-1, 5, -1], [0, -1, 0]])
   return cv2.filter2D(image, -1, kernel)
Untuk gambar tertentu, binerisasi (mengonversi gambar menjadi hitam putih) mungkin bermanfaat. Bereksperimenlah dengan berbagai teknik thresholding untuk menemukan pemisahan optimal antara latar depan (teks) dan latar belakang.
Namun, binerisasi bisa sensitif terhadap variasi pencahayaan dan tidak selalu diperlukan. Berikut contoh tampilan gambar yang telah dibinerisasi:
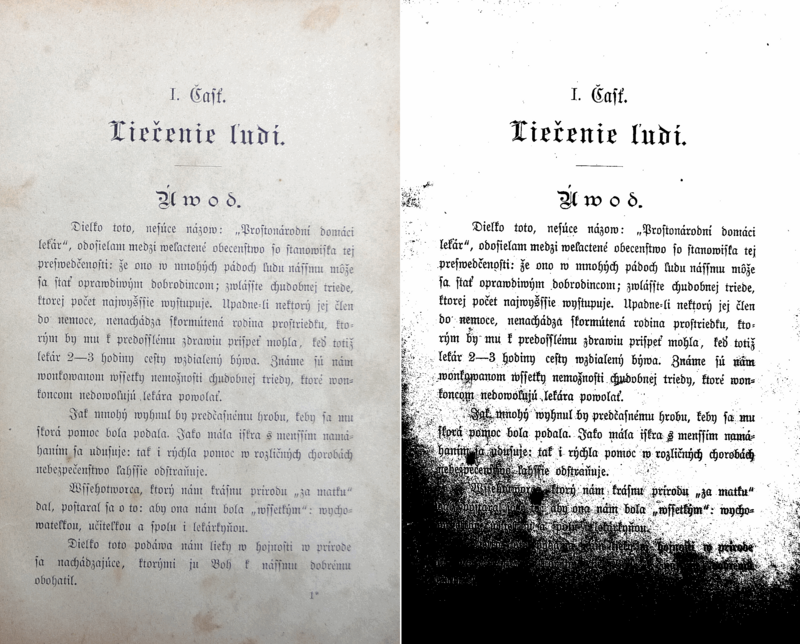
Untuk melakukan binerisasi di OpenCV, Anda dapat menggunakan fungsi adaptiveThreshold:
def binarize(image):
   """Binarizes the image using adaptive thresholding.

   Args:
       image: The input grayscale image.

   Returns:
       The binary image.
   """
   thresh = cv2.adaptiveThreshold(
       image, 255, cv2.ADAPTIVE_THRESH_MEAN_C, cv2.THRESH_BINARY, 11, 2
   )

   return thresh
Ada banyak teknik prapemrosesan lainnya, seperti:
Anda dapat mempelajari lebih lanjut tentang peningkatan kualitas gambar dari halaman dokumentasi Tesseract ini.
Dalam artikel ini, Anda telah mengambil langkah pertama untuk mempelajari masalah dinamis bernama OCR. Kita pertama-tama membahas cara mengekstrak teks dari gambar sederhana, lalu beralih ke gambar yang lebih sulit dengan pemformatan kompleks.
Kita juga mempelajari alur kerja end-to-end untuk mengekstrak teks dari PDF hasil pindai dan cara menyimpan teks yang diekstrak sebagai PDF lagi agar dapat dicari. Kita menutup artikel dengan beberapa kiat untuk meningkatkan kualitas gambar dengan OpenCV sebelum memprosesnya di Tesseract.
Jika Anda ingin mempelajari lebih lanjut tentang penyelesaian masalah terkait gambar, berikut beberapa sumber daya computer vision yang dapat Anda cek:
Lanjutkan Perjalanan Belajar Python Anda!
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Program} other {Program}}
{count, plural, one {Program} other {Program}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt




