
{count, plural, one {Corso} other {Corsi}}
Sviluppare applicazioni LLM con LangChain
{hours} ore
51.5K
Gli strumenti tradizionali di estrazione PDF come pypdf o PDFMiner ti danno testo grezzo ma perdono la struttura del documento. Le tabelle diventano testo confuso, le intestazioni si mescolano al corpo e le immagini scompaiono. Per i sistemi RAG, questi dati disordinati significano scarsa capacità di recupero e risposte inaffidabili. Docling è un toolkit open source di IBM Research che usa modelli di computer vision per comprendere l'impaginazione dei documenti, preservando tabelle, immagini, intestazioni e struttura. Elabora i documenti fino a 30 volte più velocemente dei metodi tradizionali basati su OCR e gira in locale sulla tua macchina.
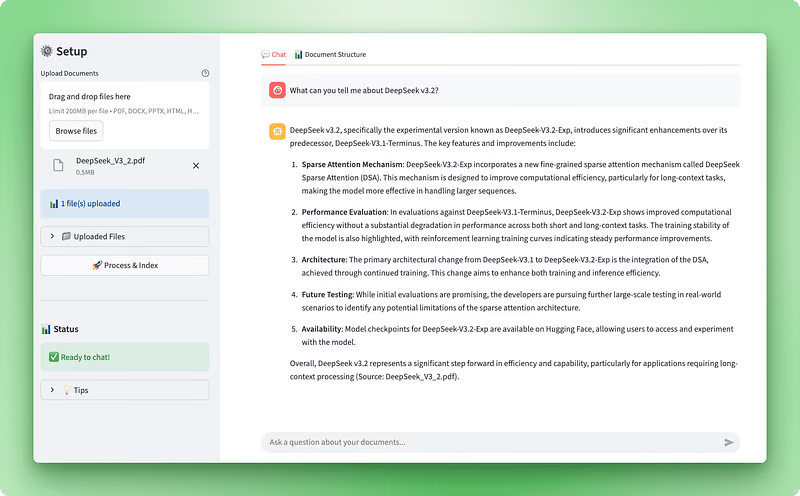
In questo tutorial useremo Docling per costruire un Document Intelligence Assistant — un'app web Streamlit che ti consente di caricare documenti, visualizzarne la struttura e fare domande usando un chatbot alimentato da RAG. Imparerai a processare documenti multi-formato con Docling, estrarre e mostrare tabelle e immagini, costruire un archivio vettoriale con ChromaDB e creare un agente conversazionale con LangGraph. Alla fine avrai un'applicazione funzionante che trasforma documenti complessi in dati strutturati e abilita il question answering intelligente.
Anteprima dell'applicazione:
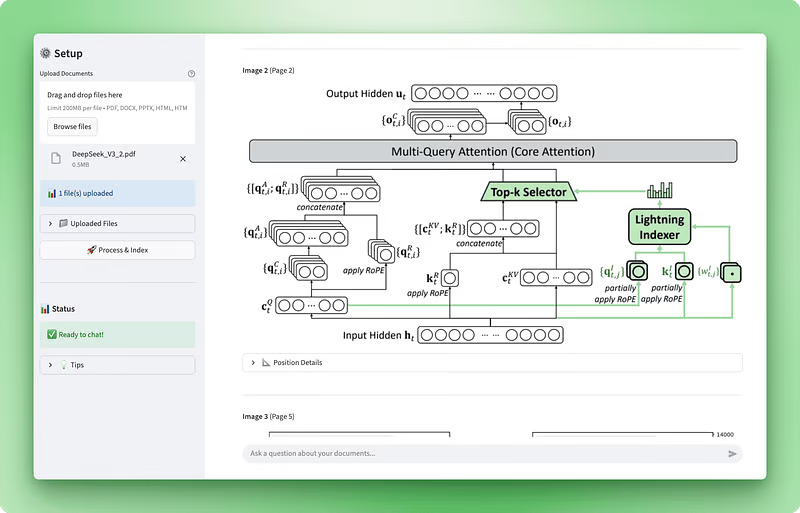
Visualizzazione della struttura del documento:
Prima di iniziare questo tutorial, dovresti avere:
Competenze tecniche: Familiarità con classi Python, decorator, type hints e context manager. Useremo operazioni async e pattern factory lungo tutto il percorso. È necessario comprendere come i large language model funzionano con prompt, token ed embedding. La familiarità con i sistemi di retrieval-augmented generation e i database vettoriali è utile ma non obbligatoria — spiegheremo i concetti base mentre costruiamo.
Ambiente di sviluppo: Python 3.10 o superiore con pip per la gestione dei pacchetti. È consigliato un editor come VS Code. Ti servirà una chiave API OpenAI da platform.openai.com — il costo di elaborazione è di circa $0,10–0,20 per documento.
Tempo necessario: Metti in conto 60–90 minuti per completare il tutorial, compresa la lettura delle spiegazioni, la scrittura del codice e il test dell'applicazione. Questo tutorial presuppone competenze intermedie in Python.
La maggior parte degli strumenti di elaborazione dei documenti tratta i PDF come immagini o flussi di testo. O eseguono l'OCR su ogni pagina o estraggono testo semplice senza capire cosa stanno leggendo. Docling adotta un approccio diverso. È un toolkit open source di IBM Research che usa modelli di computer vision per comprendere la struttura dei documenti come farebbe un essere umano.
Quando dai in pasto un documento a Docling, due modelli di AI lo analizzano:
Questi modelli capiscono che un documento non è solo un blocco di testo. Ha gerarchie, relazioni e significato.
Questa comprensione strutturale è fondamentale per i sistemi RAG. Quando costruisci applicazioni di retrieval-augmented generation, la qualità dell'elaborazione dei documenti influisce direttamente sulla precisione del recupero. Se l'estrazione da PDF trasforma una tabella finanziaria in testo confuso, la tua ricerca vettoriale recupererà spazzatura. Docling preserva la struttura, così quando suddividi ed esegui embedding dei documenti, lavori con dati puliti e organizzati.
Docling supporta diversi formati di documento nativamente:
Puoi anche abilitare l'OCR per documenti scansionati usando motori come EasyOCR, Tesseract o RapidOCR. Il toolkit esporta in diversi formati tra cui Markdown (ottimo per gli LLM), JSON (per pipeline di dati strutturati) e DocTags (un formato che cattura elementi complessi come formule matematiche e blocchi di codice).
Oltre alla flessibilità sui formati, Docling offre vantaggi prestazionali. L'elaborazione tradizionale dei documenti basata su OCR è lenta perché tratta ogni pagina come un'immagine da sottoporre a riconoscimento dei caratteri. Docling salta questo passaggio per i documenti digitali, offrendo un'elaborazione molto più veloce. Gira in locale su hardware comune, quindi non paghi costi API né invii documenti sensibili a servizi di terze parti. La velocità di elaborazione varia in base alla complessità del documento, al numero di pagine e alle specifiche dell'hardware, con prestazioni tipiche che vanno da meno di un secondo a diversi secondi per pagina su hardware moderno.
IBM ha continuato a migliorare le funzionalità di Docling. Ha rilasciato Granite-Docling, un modello vision-language da 258 milioni di parametri che eccelle con layout complessi e offre supporto multilingue sperimentale (con l'inglese come lingua principale e supporto iniziale per arabo, cinese e giapponese). Il toolkit ora supporta anche l'estrazione di immagini con risoluzione configurabile, che useremo nella nostra applicazione per mostrare le immagini reali dai PDF insieme al loro contenuto testuale.
Per il nostro caso d'uso, Docling ha senso perché ci serve dato strutturato, non solo testo grezzo. Se ti basta un'estrazione di testo di base, strumenti più semplici come pypdf potrebbero essere sufficienti. Ma dato che stiamo costruendo un'app di AI che elabora documenti per analisi e conversazione, l'elaborazione sensibile alla struttura di Docling è la scelta migliore. È particolarmente preziosa con documenti tecnici, paper di ricerca o report aziendali in cui tabelle e layout contano.
Prima di iniziare a costruire il processore di documenti, devi impostare la struttura del progetto e installare i pacchetti richiesti. Questa sezione copre il setup iniziale: creazione delle directory, installazione delle dipendenze e configurazione delle chiavi API.
Inizia creando una nuova directory per il tuo progetto:
mkdir docling-demo
cd docling-demo
All'interno di questa directory, crea una cartella src/ per i tuoi moduli Python:
mkdir src
touch src/__init__.py
Il file __init__.py indica a Python che src/ è un package, permettendo import come from src.document_processor import DocumentProcessor.
La struttura del tuo progetto:
docling-demo/
├── src/
│ └── __init__.pyCrea un file requirements.txt nella root del progetto:
docling>=2.55.0
langchain-docling>=0.1.0
langchain>=0.3.0
langchain-openai>=0.2.0
langgraph>=0.2.0
langchain-chroma>=0.1.0
streamlit>=1.28.0
streamlit-extras>=0.7.0
python-dotenv>=1.0.0
chromadb>=0.4.22
tiktoken>=0.5.0
pandas>=2.0.0
numpy<2
Il vincolo numpy<2 esiste perché le dipendenze di Docling (TensorFlow e Transformers) richiedono NumPy 1.x.
Installa i pacchetti:
pip install -r requirements.txtLa prima installazione richiede alcuni minuti perché Docling scarica modelli di AI pre-addestrati (circa 500MB). Questi modelli gestiscono l'analisi del layout e il riconoscimento della struttura delle tabelle. Vengono memorizzati in cache in locale, quindi le esecuzioni successive sono più rapide.
Crea un file .env per archiviare la tua chiave API OpenAI:
OPENAI_API_KEY=your-openai-api-key-hereRecupera la tua chiave API da platform.openai.com. Ti servirà per gli embedding e l'agente di chat.
Crea un template .env.example:
OPENAI_API_KEY=your-openai-api-key-hereAggiungi un .gitignore per evitare di fare commit di dati sensibili:
# Environment variables
.env

# Python
__pycache__/
*.py[cod]
*.so
venv/
*.egg-info/

# Chroma
chroma_db/Crea app.py nella root del progetto. Costruiremo questo file gradualmente nel corso del tutorial. Per ora, aggiungi import e configurazione di base:
import streamlit as st
from dotenv import load_dotenv

# Load environment variables
load_dotenv()

# Page configuration
st.set_page_config(
    page_title="Document Intelligence Assistant",
    page_icon="📄",
    layout="wide"
)

st.title("Document Intelligence Assistant")
st.write("Application setup complete. We'll build the functionality next.")
Testa il setup:
streamlit run app.pyStreamlit apre una finestra del browser su http://localhost:8501 mostrando la tua pagina di base.
La struttura finale del progetto (prima di aggiungere nuovi script nelle prossime sezioni):
docling-demo/
├── .env
├── .env.example
├── .gitignore
├── requirements.txt
├── app.py
└── src/
   └── __init__.py
Con l'ambiente pronto, possiamo costruire il processore di documenti che usa Docling per estrarre la struttura dai file caricati.
> Nota: Le sezioni seguenti suddivideranno gli script dell'applicazione in blocchi. Per avere una visione completa e seguire più facilmente, ti consigliamo di aprire il repository GitHub di questo progetto in una scheda separata.
📄 Script completo: src/document_processor.py
Il processore di documenti è dove Docling fa il suo lavoro. Questo componente prende i file caricati e li trasforma in dati strutturati che possiamo usare sia per RAG che per la visualizzazione. Ci servono due output da questo processo: testo markdown pulito per l'archivio vettoriale e l'oggetto documento originale di Docling che preserva tutte le informazioni strutturali come tabelle e immagini.
Costruiamolo creando un nuovo file chiamato document_processor.py nella directory src/. Creeremo una classe DocumentProcessor che configura la pipeline di elaborazione di Docling e gestisce i file caricati.
Docling ti permette di controllare come elabora i documenti tramite le opzioni della pipeline. Per i PDF, puoi attivare l'OCR per i documenti scansionati, abilitare il riconoscimento della struttura delle tabelle ed estrarre le immagini:
from docling.document_converter import DocumentConverter, PdfFormatOption
from docling.datamodel.base_models import InputFormat
from docling.datamodel.pipeline_options import PdfPipelineOptions
from langchain_core.documents import Document

class DocumentProcessor:
    def __init__(self):
        # Configure pipeline options for PDF processing
        pipeline_options = PdfPipelineOptions()
        pipeline_options.do_ocr = True
        pipeline_options.do_table_structure = True
        pipeline_options.generate_picture_images = True
        pipeline_options.images_scale = 2.0
Creiamo un oggetto PdfPipelineOptions per configurare come Docling elabora i file PDF. Ogni opzione controlla una specifica capacità di elaborazione: do_ocr abilita il riconoscimento ottico dei caratteri per i documenti scansionati, do_table_structure attiva il rilevamento e il parsing delle tabelle, generate_picture_images dice a Docling di estrarre le immagini incorporate come oggetti PIL e images_scale imposta il moltiplicatore di risoluzione per le immagini estratte.
# Initialize converter with PDF options
self.converter = DocumentConverter(
    format_options={InputFormat.PDF: PdfFormatOption(pipeline_options=pipeline_options)}
)
Il DocumentConverter è il motore principale di elaborazione di Docling. Lo inizializziamo con le nostre opzioni per i PDF, incapsulate in un oggetto PdfFormatOption, che associa queste impostazioni specificamente ai file di input PDF.
Vediamo cosa fa ogni opzione della pipeline. Il flag do_ocr attiva il riconoscimento ottico dei caratteri. Quando elabora PDF digitali con livelli di testo incorporati, Docling salta automaticamente l'OCR per risparmiare tempo. Per i documenti scansionati o le immagini contenenti testo, questa impostazione indica a Docling di eseguire i modelli di visione per estrarre il testo.
L'opzione do_table_structure abilita il riconoscimento della struttura delle tabelle. Senza questa opzione, le tabelle vengono estratte come semplice testo con la formattazione persa. Con essa attiva, Docling usa il modello AI TableFormer per identificare righe, colonne, intestazioni e relazioni tra celle. Questa rappresentazione strutturata consente poi di esportare le tabelle come pandas DataFrame, preservando il formato tabellare.
Impostare generate_picture_images su True abilita l'estrazione delle immagini. Per impostazione predefinita, Docling registra solo le posizioni delle immagini senza estrarre i file effettivi. Abilitando questa opzione ottieni oggetti immagine PIL da mostrare nella UI o da processare con modelli di visione. Il parametro images_scale controlla la risoluzione di estrazione — un valore di 2.0 raddoppia la risoluzione per una qualità migliore nella visualizzazione o in ulteriori analisi.
Con la pipeline configurata, possiamo aggiungere il metodo che elabora i file caricati tramite Streamlit. Questo metodo gestisce gli oggetti file di Streamlit, li salva temporaneamente, esegue la conversione di Docling e restituisce sia il markdown per RAG sia i documenti Docling per la visualizzazione:
import os
import tempfile
from typing import List, Any

def process_uploaded_files(self, uploaded_files) -> tuple[List[Document], List[Any]]:
    documents = []
    docling_docs = []
    temp_dir = tempfile.mkdtemp()

    try:
        for uploaded_file in uploaded_files:
            # Save uploaded file to temporary location
            temp_file_path = os.path.join(temp_dir, uploaded_file.name)
            with open(temp_file_path, "wb") as f:
                f.write(uploaded_file.getbuffer())
Streamlit fornisce i file caricati come oggetti in memoria, ma Docling ha bisogno di file effettivi su disco per elaborarli. Creiamo una directory temporanea e scriviamo al suo interno ciascun file caricato, preservando il nome originale.
# Process the document with Docling
result = self.converter.convert(temp_file_path)

# Export to markdown
markdown_content = result.document.export_to_markdown()
La chiamata converter.convert() esegue l'intera pipeline di analisi del documento di Docling. Identifica il layout, applica l'OCR se necessario, rileva tabelle e immagini e costruisce una rappresentazione strutturata. Aspettati 20–30 secondi per l'elaborazione senza estrazione immagini, o 40–60 secondi con immagini abilitate.
Dopo la conversione, esportiamo in formato markdown che produce testo pulito, adatto agli LLM, con la formattazione corretta preservata — le intestazioni restano intestazioni, le liste rimangono strutturate e le tabelle si trasformano in tabelle markdown.
# Create LangChain document
doc = Document(
    page_content=markdown_content,
    metadata={
        "filename": uploaded_file.name,
        "file_type": uploaded_file.type,
        "source": uploaded_file.name,
    }
)

documents.append(doc)

# Store the Docling document for structure visualization
docling_docs.append({
    "filename": uploaded_file.name,
    "doc": result.document
})
Creiamo due rappresentazioni di ogni documento elaborato. L'oggetto Document di LangChain contiene il testo markdown in page_content con i metadati associati — questo va nell'archivio vettoriale per RAG. L'oggetto documento originale di Docling viene archiviato separatamente con il suo nome file, preservando tutte le informazioni strutturali (tabelle, immagini, gerarchie) per la visualizzazione successiva.
finally:
    import shutil
    shutil.rmtree(temp_dir)

return documents, docling_docs
Il blocco finally garantisce che i file temporanei vengano eliminati indipendentemente dall'esito dell'elaborazione. Restituiamo una tupla con entrambe le rappresentazioni: i documenti LangChain per il sistema RAG e i documenti Docling per la visualizzazione della struttura.
Il processore di documenti è ora pronto. Successivamente costruiremo l'interfaccia Streamlit che consente agli utenti di caricare i file e vedere lo stato dell'elaborazione.
📄 Script completo: src/structure_visualizer.py
Ora che possiamo elaborare i documenti con Docling, ci serve un modo per visualizzare ciò che è stato estratto. L'oggetto documento grezzo di Docling contiene ricche informazioni strutturali (intestazioni, tabelle, immagini e metadati) ma non è user-friendly nella sua forma nativa. Costruiremo un livello di visualizzazione che trasforma questi dati in un'interfaccia interattiva con quattro viste: una dashboard di riepilogo, un'outline gerarchica, tabelle interattive e immagini estratte.
Crea un nuovo file chiamato structure_visualizer.py nella directory src/. Questo componente analizzerà la struttura del documento di Docling e la organizzerà per la visualizzazione.
Inizia creando una classe che incapsula un documento Docling e fornisce metodi per estrarre diversi elementi strutturali:
from typing import List, Dict, Any
import pandas as pd
from docling_core.types.doc import DoclingDocument

class DocumentStructureVisualizer:
    def __init__(self, docling_document: DoclingDocument):
        self.doc = docling_document
L'inizializzatore accetta un oggetto DoclingDocument (lo stesso oggetto restituito da DocumentConverter.convert()). Questo oggetto contiene tutto ciò che Docling ha estratto dal documento. L'attributo texts contiene tutti gli elementi di testo con le loro etichette e posizioni, tables contiene i dati delle tabelle con le informazioni di struttura, pictures memorizza i metadati delle immagini e i dati delle immagini effettive e pages fornisce informazioni a livello di pagina.
I documenti hanno una struttura che va oltre i paragrafi. Le intestazioni creano una gerarchia che aiuta a navigare i contenuti. Ecco come estrarre questa gerarchia:
def get_document_hierarchy(self) -> List[Dict[str, Any]]:
    hierarchy = []

    if not hasattr(self.doc, "texts") or not self.doc.texts:
        return hierarchy

    for item in self.doc.texts:
        label = getattr(item, "label", None)

        if label and "header" in label.lower():
            text = getattr(item, "text", "")
            prov = getattr(item, "prov", [])
            page_no = prov[0].page_no if prov else None

            hierarchy.append({
                "type": label,
                "text": text,
                "page": page_no,
                "level": self._infer_heading_level(label)
            })

    return hierarchy
Iteriamo su tutti gli elementi di testo nel documento, filtrando quelli con etichette che contengono header. Ogni elemento di testo ha un attributo label che Docling assegna durante l'analisi del layout. Etichette comuni includono section_header, page_header, title e text normale. L'attributo prov (abbreviazione di provenance) contiene informazioni di posizionamento, inclusa la pagina su cui compare l'elemento. Estraiamo il testo dell'intestazione, il numero di pagina e inferiamo il suo livello gerarchico dal tipo di etichetta.
Quando visualizzi l'outline, il livello dell'intestazione determina l'indentazione. Un metodo di supporto mappa i tipi di etichetta a livelli numerici:
def _infer_heading_level(self, label: str) -> int:
    if "title" in label.lower():
        return 1
    elif "section" in label.lower():
        return 2
    elif "subsection" in label.lower():
        return 3
    else:
        return 4
Questo crea una gerarchia in cui i titoli del documento sono livello 1, le intestazioni di sezione livello 2, le sottosezioni livello 3 e qualsiasi altra intestazione predefinita a livello 4.
Con la gerarchia del documento estratta, gestiamo le tabelle. Diversamente dall'estrazione di testo semplice che trasforma le tabelle in stringhe confuse, Docling ne preserva la struttura, una delle sue caratteristiche più preziose:
def get_tables_info(self) -> List[Dict[str, Any]]:
    tables_info = []

    if not hasattr(self.doc, "tables") or not self.doc.tables:
        return tables_info

    for i, table in enumerate(self.doc.tables, 1):
        try:
            df = table.export_to_dataframe(doc=self.doc)

            prov = getattr(table, "prov", [])
            page_no = prov[0].page_no if prov else None

            caption_text = getattr(table, "caption_text", None)
            caption = caption_text if caption_text and not callable(caption_text) else None

            tables_info.append({
                "table_number": i,
                "page": page_no,
                "caption": caption,
                "dataframe": df,
                "shape": df.shape,
                "is_empty": df.empty
            })
        except Exception as e:
            print(f"Warning: Could not process table {i}: {e}")
            continue

    return tables_info
Il metodo table.export_to_dataframe(doc=self.doc) converte la rappresentazione della tabella di Docling in un pandas DataFrame. Estraiamo didascalie e numeri di pagina quando disponibili.
Oltre alle tabelle, Docling può estrarre i dati effettivi delle immagini dai documenti. È una funzionalità più recente che va oltre il semplice tracciamento delle posizioni — recupera i byte reali delle immagini così puoi mostrarle. (L'abbiamo abilitata nelle opzioni della pipeline del processore di documenti.)
def get_pictures_info(self) -> List[Dict[str, Any]]:
    pictures_info = []

    if not hasattr(self.doc, "pictures") or not self.doc.pictures:
        return pictures_info

    for i, pic in enumerate(self.doc.pictures, 1):
        prov = getattr(pic, "prov", [])

        if prov:
            page_no = prov[0].page_no
            bbox = prov[0].bbox

            caption_text = getattr(pic, "caption_text", None)
            caption = caption_text if caption_text and not callable(caption_text) else None

            pil_image = None
            try:
                if hasattr(pic, "image") and pic.image is not None:
                    if hasattr(pic.image, "pil_image"):
                        pil_image = pic.image.pil_image
            except Exception as e:
                print(f"Warning: Could not extract image {i}: {e}")

            pictures_info.append({
                "picture_number": i,
                "page": page_no,
                "caption": caption,
                "pil_image": pil_image,
                "bounding_box": {
                    "left": bbox.l,
                    "top": bbox.t,
                    "right": bbox.r,
                    "bottom": bbox.b
                } if bbox else None
            })

    return pictures_info
Ogni immagine ha informazioni di provenienza, incluso il numero di pagina e le coordinate del bounding box. Il bounding box definisce la posizione dell'immagine sulla pagina usando coordinate sinistra, alto, destra e basso.
Quando l'estrazione delle immagini è abilitata, l'oggetto immagine ha un attributo image contenente i dati effettivi. Accediamo all'immagine PIL tramite picture.image.pil_image, che restituisce un oggetto PIL Image che Streamlit può mostrare direttamente con st.image(). Il blocco try-except gestisce i casi in cui l'estrazione fallisce o non è stata abilitata, ricadendo con grazia sulla sola visualizzazione dei metadati.
Al visualizzatore serve un ultimo metodo: un riepilogo di alto livello che dia agli utenti una panoramica della struttura del documento:
def get_document_summary(self) -> Dict[str, Any]:
    pages = getattr(self.doc, "pages", {})
    texts = getattr(self.doc, "texts", [])
    tables = getattr(self.doc, "tables", [])
    pictures = getattr(self.doc, "pictures", [])

    text_types = {}
    for item in texts:
        label = getattr(item, "label", "unknown")
        text_types[label] = text_types.get(label, 0) + 1

    return {
        "name": self.doc.name,
        "num_pages": len(pages) if pages else 0,
        "num_texts": len(texts),
        "num_tables": len(tables),
        "num_pictures": len(pictures),
        "text_types": text_types
    }
Contiamo il numero di pagine, elementi di testo, tabelle e immagini nel documento. Il dizionario text_types ripartisce gli elementi di testo per etichetta, mostrando quanti titoli, intestazioni, paragrafi e altri elementi Docling ha identificato. Questo dà rapidamente il senso della struttura e complessità del documento.
Con il visualizzatore completo, integriamolo in Streamlit con quattro tab: Summary, Hierarchy, Tables e Images.
def render_structure_viz():
    st.title("📊 Document Structure")

    if not st.session_state.docling_docs:
        st.info("👈 Please upload and process your documents first!")
        return

    doc_names = [doc["filename"] for doc in st.session_state.docling_docs]
    selected_doc_name = st.selectbox("Select document to analyze:", doc_names)

    selected_doc_data = next(
        (doc for doc in st.session_state.docling_docs if doc["filename"] == selected_doc_name),
        None
    )

    if not selected_doc_data:
        return

    visualizer = DocumentStructureVisualizer(selected_doc_data["doc"])

    tab1, tab2, tab3, tab4 = st.tabs(["📑 Summary", "🏗️ Hierarchy", "📊 Tables", "🖼️ Images"])
Creiamo un menu a discesa per permettere agli utenti di selezionare quale documento analizzare (utile quando vengono caricati più file). Dopo aver ottenuto il documento Docling selezionato dallo stato di sessione, istanziamo il visualizzatore e creiamo quattro tab per le diverse viste.
with tab1:
    st.subheader("Document Summary")
    summary = visualizer.get_document_summary()

    col1, col2, col3, col4 = st.columns(4)
    with col1:
        st.metric("Pages", summary["num_pages"])
    with col2:
        st.metric("Tables", summary["num_tables"])
    with col3:
        st.metric("Images", summary["num_pictures"])
    with col4:
        st.metric("Text Items", summary["num_texts"])

    st.subheader("Content Types")
    text_types_df = pd.DataFrame([
        {"Type": k, "Count": v}
        for k, v in sorted(summary["text_types"].items(), key=lambda x: -x[1])
    ])
    st.dataframe(text_types_df, use_container_width=True)

with tab2:
    st.subheader("Document Hierarchy")
    hierarchy = visualizer.get_document_hierarchy()

    if hierarchy:
        for item in hierarchy:
            indent = "  " * (item["level"] - 1)
            st.markdown(f"{indent}**{item['text']}** _(Page {item['page']})_")
    else:
        st.info("No hierarchical structure detected")

with tab3:
    st.subheader("Tables")
    tables_info = visualizer.get_tables_info()

    if tables_info:
        for table_data in tables_info:
            st.markdown(f"### Table {table_data['table_number']} (Page {table_data['page']})")

            if table_data["caption"]:
                st.caption(table_data["caption"])

            if not table_data["is_empty"]:
                st.dataframe(table_data["dataframe"], use_container_width=True)
            else:
                st.info("Table is empty")

            st.divider()
    else:
        st.info("No tables found in this document")

with tab4:
    st.subheader("Images")
    pictures_info = visualizer.get_pictures_info()

    if pictures_info:
        for pic_data in pictures_info:
            st.markdown(f"**Image {pic_data['picture_number']}** (Page {pic_data['page']})")

            if pic_data["caption"]:
                st.caption(pic_data["caption"])

            if pic_data["pil_image"] is not None:
                st.image(pic_data["pil_image"], use_container_width=True)
            else:
                st.info("Image data not available")

            if pic_data["bounding_box"]:
                bbox = pic_data["bounding_box"]
                with st.expander("📐 Position Details"):
                    st.text(
                        f"Position: ({bbox['left']:.1f}, {bbox['top']:.1f}) - "
                        f"({bbox['right']:.1f}, {bbox['bottom']:.1f})"
                    )

            st.divider()
    else:
        st.info("No images found in this document")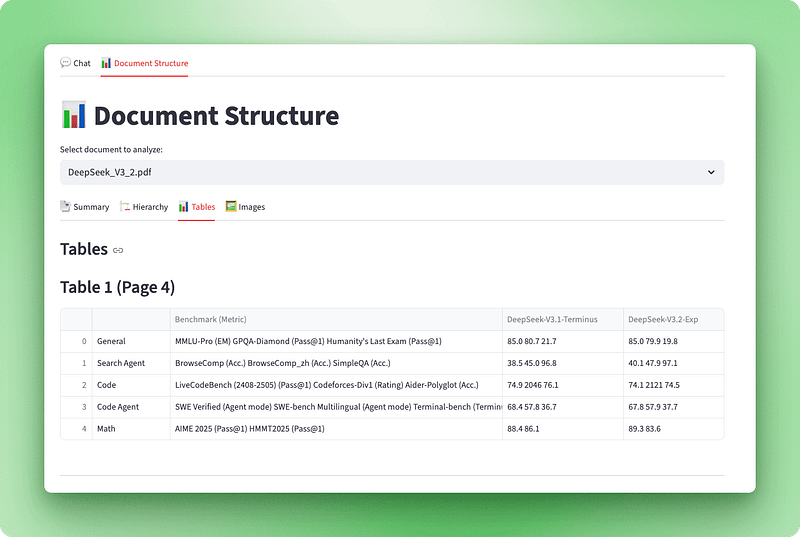
Il visualizzatore della struttura è completo. Gli utenti possono caricare un documento e vedere subito la sua anatomia — quante pagine, tabelle e immagini contiene, la sua struttura gerarchica con intestazioni e sezioni, tabelle interattive da esplorare e le immagini effettivamente estratte dal documento. Questa trasparenza aiuta a capire cosa ha estratto Docling e aumenta la fiducia nel sistema.
Con l'elaborazione e la visualizzazione dei documenti operative, possiamo costruire il sistema RAG che abilita il question answering su questi documenti elaborati.
📄 Script completi: src/vectorstore.py | src/tools.py
Con elaborazione e visualizzazione completate, possiamo costruire le capacità di Q&A. RAG (Retrieval Augmented Generation) consente agli utenti di fare domande sui loro documenti. Il sistema converte i documenti in embedding, li archivia in un database vettoriale e recupera i chunk rilevanti per rispondere alle domande.
Questa sezione copre due componenti: un gestore dell'archivio vettoriale che suddivide ed esegue embedding dei documenti e uno strumento di ricerca che recupera le informazioni rilevanti.
L'archivio vettoriale è dove vivono gli embedding dei documenti. Quando gli utenti fanno una domanda, cerchiamo in questo archivio i chunk rilevanti e li passiamo all'LLM come contesto.
Crea vectorstore.py nella directory src/:
from typing import List
from langchain_core.documents import Document
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_openai import OpenAIEmbeddings
from langchain_chroma import Chroma
Questi import portano i componenti di LangChain per la gestione dei documenti, la suddivisione del testo, la generazione degli embedding e l'archiviazione vettoriale con ChromaDB. Ecco come lavorano insieme:
class VectorStoreManager:
    def __init__(self):
        self.embeddings = OpenAIEmbeddings(model="text-embedding-3-small")
        self.text_splitter = RecursiveCharacterTextSplitter(
            chunk_size=1000,
            chunk_overlap=100,
            length_function=len,
        )
Inizializziamo due componenti chiave. Il modello text-embedding-3-small di OpenAI converte il testo in vettori. È più piccolo e veloce di text-embedding-3-large, il che conta quando si fanno embedding di centinaia di chunk. Il RecursiveCharacterTextSplitter suddivide i documenti in chunk da 1000 caratteri con sovrapposizione di 100, assicurando che le informazioni ai confini dei chunk non vengano tagliate a metà frase.
1000 caratteri bilanciano precisione e contesto — chunk più piccoli danno recuperi più precisi ma perdono contesto, chunk più grandi preservano il contesto ma diluiscono la pertinenza.
Aggiungi il metodo di suddivisione:
def chunk_documents(self, documents: List[Document]) -> List[Document]:
    """Split documents into smaller chunks for better retrieval."""
    chunks = self.text_splitter.split_documents(documents)
    return chunks
Lo splitter gestisce automaticamente i metadati, preservando le informazioni dei documenti originali. Ogni chunk sa da quale file proviene, aspetto importante quando l'agente cita le fonti nelle risposte.
Ora aggiungi il metodo che crea l'archivio vettoriale:
def create_vectorstore(self, chunks: List[Document]) -> Chroma:
    """Create a Chroma vector store from document chunks."""
    vectorstore = Chroma.from_documents(
        documents=chunks,
        embedding=self.embeddings,
        collection_name="documents"
    )
    return vectorstore
ChromaDB fa il lavoro pesante. Esegue l'embedding di ogni chunk usando il nostro modello di embedding e memorizza i vettori in memoria. Quando esegui una similarity search, ChromaDB calcola la similarità coseno tra il vettore della query e tutti i vettori dei documenti, restituendo le corrispondenze più vicine.
Con l'archivio vettoriale pronto per gestire gli embedding, dobbiamo dare all'agente un modo per interrogarlo. Gli strumenti sono funzioni che l'LLM può chiamare quando gli serve informazione che non ha.
Crea tools.py nella directory src/:
from typing import Annotated
from langchain_core.tools import tool

def create_search_tool(vectorstore):
    """Create a search tool that has access to the vector store."""
Questa factory function usa un pattern di closure: riceve un archivio vettoriale e restituisce uno strumento che può cercarlo. Lo strumento mantiene l'accesso all'archivio vettoriale senza bisogno di variabili globali.
@tool
def search_documents(query: Annotated[str, "The search query or question about the documents"]) -> str:
    """Search the uploaded documents for relevant information."""
Il decorator @tool trasforma questa funzione in uno strumento LangChain che l'agente può chiamare. Il type hint Annotated descrive il parametro, aiutando l'LLM a capire cosa passare quando invoca lo strumento.
try:
   results = vectorstore.similarity_search(query, k=8)

   if not results:
      return "No relevant information found in the documents for this query."
Recuperiamo 8 chunk simili (k=8) dall'archivio vettoriale. Questo dà all'LLM abbastanza contesto senza sovraccaricarlo con informazioni ridondanti. Il numero giusto dipende dal tipo di documento — i documenti tecnici densi potrebbero funzionare meglio con meno chunk (k=4–6), mentre i documenti narrativi potrebbero beneficiare di più (k=10–12).
context_parts = []
for i, doc in enumerate(results, 1):
    source = doc.metadata.get("filename", doc.metadata.get("source", "Unknown source"))
    content = doc.page_content.strip()

    context_parts.append(
        f"[Source {i}: {source}]\n"
        f"Content: {content}\n"
    )

return "\n---\n".join(context_parts)
Formattiamo ogni chunk con il nome del file sorgente, quindi li uniamo con separatori. L'LLM riceve questo contesto strutturato e lo usa per generare risposte citando le fonti.
except Exception as e:
    return f"Error searching documents: {str(e)}"

return search_documents
La gestione degli errori assicura che l'agente riceva un messaggio chiaro se la ricerca fallisce, invece di andare in crash. La funzione restituisce lo strumento configurato pronto per l'uso da parte dell'agente.
Ora l'archivio vettoriale e lo strumento di ricerca sono pronti. Successivamente costruiremo l'agente LangGraph che orchestra recupero e generazione per rispondere alle domande degli utenti.
📄 Script completo: src/agent.py
Lo strumento di ricerca può interrogare l'archivio vettoriale, ma serve un coordinatore intelligente. L'agente LangGraph decide quando cercare, interpreta i risultati e genera risposte in linguaggio naturale. Implementeremo anche lo streaming per mostrare i progressi in tempo reale.
L'agente riceve domande, decide quando cercare nei documenti e genera risposte basate sul contesto recuperato.
Crea agent.py nella directory src/:
from typing import List
from langchain_core.tools import BaseTool
from langchain_openai import ChatOpenAI
from langgraph.prebuilt import create_react_agent
from langgraph.checkpoint.memory import MemorySaver
Importiamo componenti per la gestione degli strumenti, i modelli di chat OpenAI, l'implementazione dell'agente ReAct di LangGraph e la memoria della conversazione.
SYSTEM_PROMPT = """You are a helpful document intelligence assistant. You have access to documents that have been uploaded and processed.

GUIDELINES:
- Use the search_documents tool to find relevant information
- Keep it simple: one well-crafted search is usually sufficient
- Only search again if the first results are clearly incomplete
- Provide clear, accurate answers based on the document contents
- Always cite your sources with filenames
- If information isn't found, say so clearly
- Be concise but thorough

When answering:
1. Search the documents with a focused query
2. Synthesize a clear answer from the results
3. Include source citations (filenames)
4. Only search again if absolutely necessary
"""

def create_documentation_agent(tools: List[BaseTool], model_name: str = "gpt-4o-mini"):
    """Create a document intelligence assistant agent using LangGraph."""
    llm = ChatOpenAI(model=model_name, temperature=0)
    memory = MemorySaver()
Usiamo gpt-4o-mini invece di gpt-5 perché è più veloce ed economico, pur gestendo bene il Q&A sui documenti. La temperatura è impostata a 0 per risposte coerenti e fattuali. Il MemorySaver fornisce memoria di conversazione, così l'agente ricorda gli scambi precedenti all'interno di una sessione.
agent = create_react_agent(
    llm,
    tools=tools,
    prompt=SYSTEM_PROMPT,
    checkpointer=memory
)

return agent
Il create_react_agent di LangGraph implementa il pattern ReAct (Reasoning + Acting). L'agente ragiona su cosa deve fare, agisce usando gli strumenti, osserva i risultati e ripete finché non ha una risposta. Questo pattern funziona bene per RAG perché l'agente può decidere quando cercare e come usare il contesto recuperato.
L'agente ora può cercare e generare risposte, ma gli utenti non dovrebbero aspettare 10 secondi fissando uno schermo vuoto mentre lavora. Lo streaming mostra i progressi in tempo reale — prima compare un indicatore di “thinking”, poi “searching”, quindi la risposta che appare token per token.
Aggiorna la tua funzione render_chat() in app.py per completare la gestione della risposta che avevamo segnato con TODO prima:
if prompt:
    st.session_state.messages.append({"role": "user", "content": prompt})
    with st.chat_message("user"):
        st.markdown(prompt)
Aggiungiamo il messaggio dell'utente alla cronologia della conversazione e lo mostriamo nell'interfaccia di chat.
with st.chat_message("assistant"):
    status_placeholder = st.empty()
    message_placeholder = st.empty()

    try:
        config = {"configurable": {"thread_id": "document_chat"}}
Creiamo placeholder per l'indicatore di stato e il messaggio di risposta. La config include un thread ID che LangGraph usa per mantenere la memoria della conversazione tra i turni.
def generate_response():
    """Generator that yields tokens from LangGraph stream."""
    status_placeholder.markdown("🤔 **Thinking...**")
    first_content_token = True
    tool_call_detected = False
    final_answer_started = False
Questa funzione generatrice elabora l'output in streaming di LangGraph. Tracciamo lo stato con flag per mostrare messaggi adeguati man mano che l'agente avanza nel suo flusso di lavoro.
for msg, metadata in st.session_state.agent.stream(
    {"messages": [HumanMessage(content=prompt)]},
    config=config,
    stream_mode="messages",
):
    langgraph_node = metadata.get("langgraph_node", "")
Il parametro stream_mode="messages" ci fornisce i token reali dell'LLM man mano che vengono generati, non solo gli output finali. LangGraph emette eventi durante l'esecuzione dell'agente — quando inizia a pensare, quando chiama strumenti e quando genera testo.
if "tools" in langgraph_node.lower() or "tool" in langgraph_node.lower():
    if not tool_call_detected:
        status_placeholder.markdown("🔍 **Searching documents...**")
        tool_call_detected = True
    continue

if "agent" in langgraph_node.lower() and hasattr(msg, "content"):
    content = msg.content

if content:
    if first_content_token:
        status_placeholder.markdown("💬 **Generating answer...**")
        first_content_token = False
        final_answer_started = True

if final_answer_started:
    yield content
Quando il nodo agent inizia a generare la risposta finale, aggiorniamo lo stato e iniziamo a emettere i token di contenuto. Ogni token viene mostrato immediatamente, creando un fluido effetto “digitazione”.
status_placeholder.empty()

with message_placeholder.container():
    full_response = st.write_stream(generate_response())
Dopo che lo streaming è completo, puliamo l'indicatore di stato. La funzione st.write_stream() di Streamlit gestisce automaticamente la visualizzazione token-per-token, accumulando i token e aggiornando l'interfaccia senza intoppi. Il risultato è un'esperienza di chat reattiva che dà fiducia che il sistema stia lavorando.
st.session_state.messages.append({"role": "assistant", "content": full_response})

except Exception as e:
    st.error(f"Error generating response: {str(e)}")
Salviamo la risposta completa nella cronologia dei messaggi e gestiamo eventuali errori che si verificano durante lo streaming.
Il sistema RAG è completo. Gli utenti possono ora caricare documenti, elaborarli con Docling, esplorarne la struttura e avere conversazioni naturali sui contenuti. L'agente cerca in modo intelligente, cita le fonti e trasmette le risposte in streaming per un'esperienza fluida.
Il tuo Document Intelligence Assistant è completo. Prima di distribuirlo o condividerlo, dovresti testare l'applicazione per verificare che tutto funzioni correttamente.
Avvia l'applicazione dalla root del progetto:
streamlit run app.pyStreamlit aprirà una finestra del browser su http://localhost:8501. Dovresti vedere la sidebar con i controlli di upload e due tab nell'area principale.
Carica un PDF di esempio con tabelle e immagini per testare tutte le funzionalità di elaborazione:
Osserva gli indicatori di elaborazione:
Al termine, vedrai “✅ Ready to chat!” nella sezione di stato.
Passa alla scheda “Document Structure” per verificare che Docling abbia estratto tutto correttamente:
Se le tabelle risultano vuote o le immagini non compaiono, controlla di aver abilitato do_table_structure=True e generate_picture_images=True nelle opzioni della pipeline.
Torna alla scheda “Chat” e testa l'agente con queste domande di esempio:
Buone domande iniziali:
Domande specifiche del documento (adatta in base al tuo documento):
Domande di follow-up per testare la memoria della conversazione:
Cerca risposte dirette dal tuo documento con citazioni delle fonti, streaming fluido dei token e indicatori di stato (“Thinking…”, “Searching documents…”, “Generating answer…”). Fai attenzione a risposte generiche non tratte dal tuo documento, citazioni mancanti delle fonti, risposte lente senza indicatori di stato o errori relativi alle chiavi API mancanti.
Errore “No module named ‘docling’”
pip install docling langchain langchain-openai langchain-chroma langgraph streamlit streamlit-extras pandas python-dotenv
Errore “OpenAI API key not found”
Verifica che il file .env esista con OPENAI_API_KEY=your-key-here
Riavvia Streamlit
L'elaborazione richiede più di 60 secondi
L'agente dà risposte generiche
Le tabelle compaiono come DataFrame vuoti
Conferma do_table_structure=True in PdfPipelineOptions
Prova un altro PDF con tabelle native
L'applicazione è ora validata e pronta all'uso. Puoi testarla con i tuoi documenti o distribuirla perché altri la utilizzino.
Ora hai un Document Intelligence Assistant funzionante che elabora PDF, documenti Word, presentazioni PowerPoint e file HTML preservandone la struttura. Docling estrae testo, tabelle, immagini e gerarchie del documento che gli utenti possono esplorare tramite tab interattive. Il sistema RAG, combinato con ChromaDB e LangGraph, abilita Q&A conversazionale con citazioni delle fonti trasmesse in tempo reale. Questo dimostra come l'elaborazione dei documenti sensibile alla struttura migliori la qualità del recupero rispetto all'estrazione di testo di base. Il codice sorgente completo è disponibile nel repository GitHub.
Questa base apre molte direzioni per estensioni future:
Per approfondire i sistemi RAG e le applicazioni LLM, il nostro percorso AI Engineering copre i concetti e i pattern che hai usato qui.
Impara con DataCamp
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min



