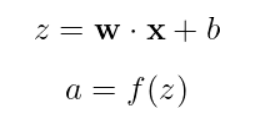Last chance! 50% off DataCamp Premium
Sale ends in
Jaringan saraf telah merevolusi kecerdasan buatan, menggerakkan segala hal mulai dari pengenalan gambar hingga pemrosesan bahasa alami. Di jantung model-model kuat ini terdapat proses fundamental bernama propagasi maju (forward propagation). Panduan ini akan membahas konsep inti tersebut, membawa Anda dari prinsip dasar hingga implementasi praktis.
Jika Anda mencari panduan praktik untuk banyak konsep yang kita bahas di sini, pastikan untuk melihat Deep Learning in Python skill track kami.
Propagasi maju adalah proses ketika jaringan saraf mengubah data masukan menjadi prediksi atau keluaran. Anggap ini sebagai fase “berpikir” dari jaringan saraf — saat diperlihatkan sebuah masukan (seperti gambar atau teks), propagasi maju adalah cara jaringan memproses informasi tersebut melalui lapisannya untuk menghasilkan suatu hasil.
Secara teknis, ini adalah perhitungan berurutan yang memindahkan data dari lapisan input, melalui lapisan tersembunyi, dan akhirnya ke lapisan output. Selama perjalanan ini, data diubah oleh koneksi berbobot dan fungsi aktivasi, memungkinkan jaringan menangkap pola yang kompleks.
Memahami propagasi maju krusial karena beberapa alasan:
Pada akhir panduan komprehensif ini, Anda akan:
Agar mendapatkan hasil maksimal dari panduan ini, sebaiknya Anda memiliki:
Jika Anda perlu memperkuat dasar-dasar, pertimbangkan sumber berikut:
Bahkan tanpa pengetahuan latar belakang yang luas, kami merancang panduan ini untuk membangun konsep secara progresif, sehingga jaringan saraf menjadi mudah diakses bagi pembelajar yang tekun. Mari kita mulai!
Untuk memahami propagasi maju, kita perlu mulai dari blok bangunan dasarnya. Mari mulai dari unit komputasi terkecil dalam jaringan saraf dan secara bertahap membangun ke struktur yang lebih kompleks.
Perjalanan jaringan saraf dimulai dengan kemiripan menarik dengan biologi. Sama seperti otak manusia terdiri dari miliaran neuron yang saling terhubung, jaringan saraf tiruan dibangun dari model matematika yang terinspirasi oleh sel biologis ini.
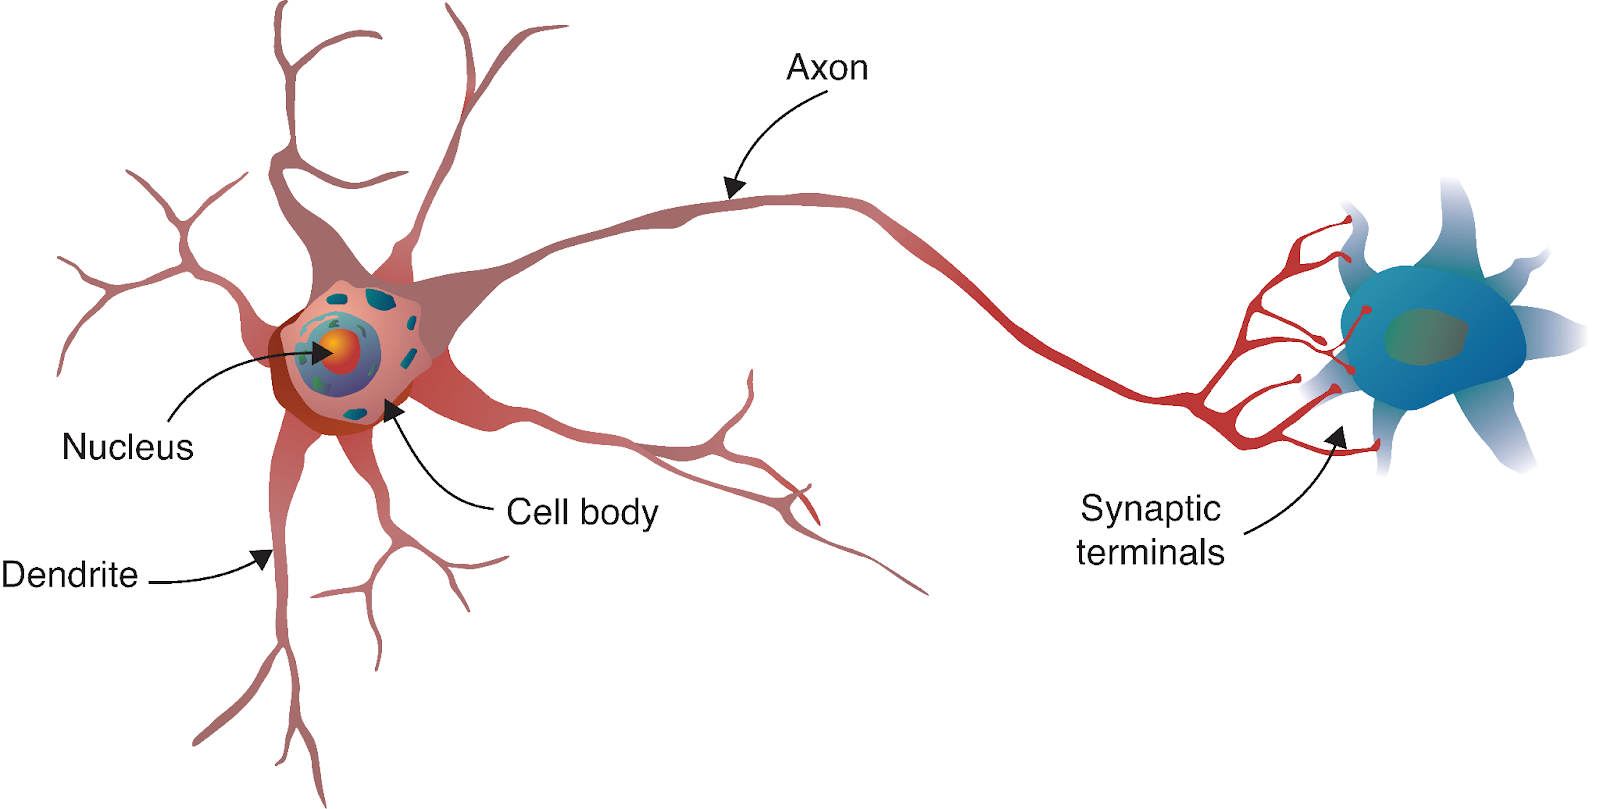
Sumber: Deep Learning - Visual Approach
Neuron biologis menerima sinyal dari neuron lain melalui dendrit, memproses sinyal-sinyal tersebut di badan sel, lalu mengirimkan hasilnya melalui akson ke neuron lain. Dalam model komputasional kita, kita mencerminkan proses ini dengan:
Mari memvisualisasikan sebuah neuron tunggal agar lebih konkret:
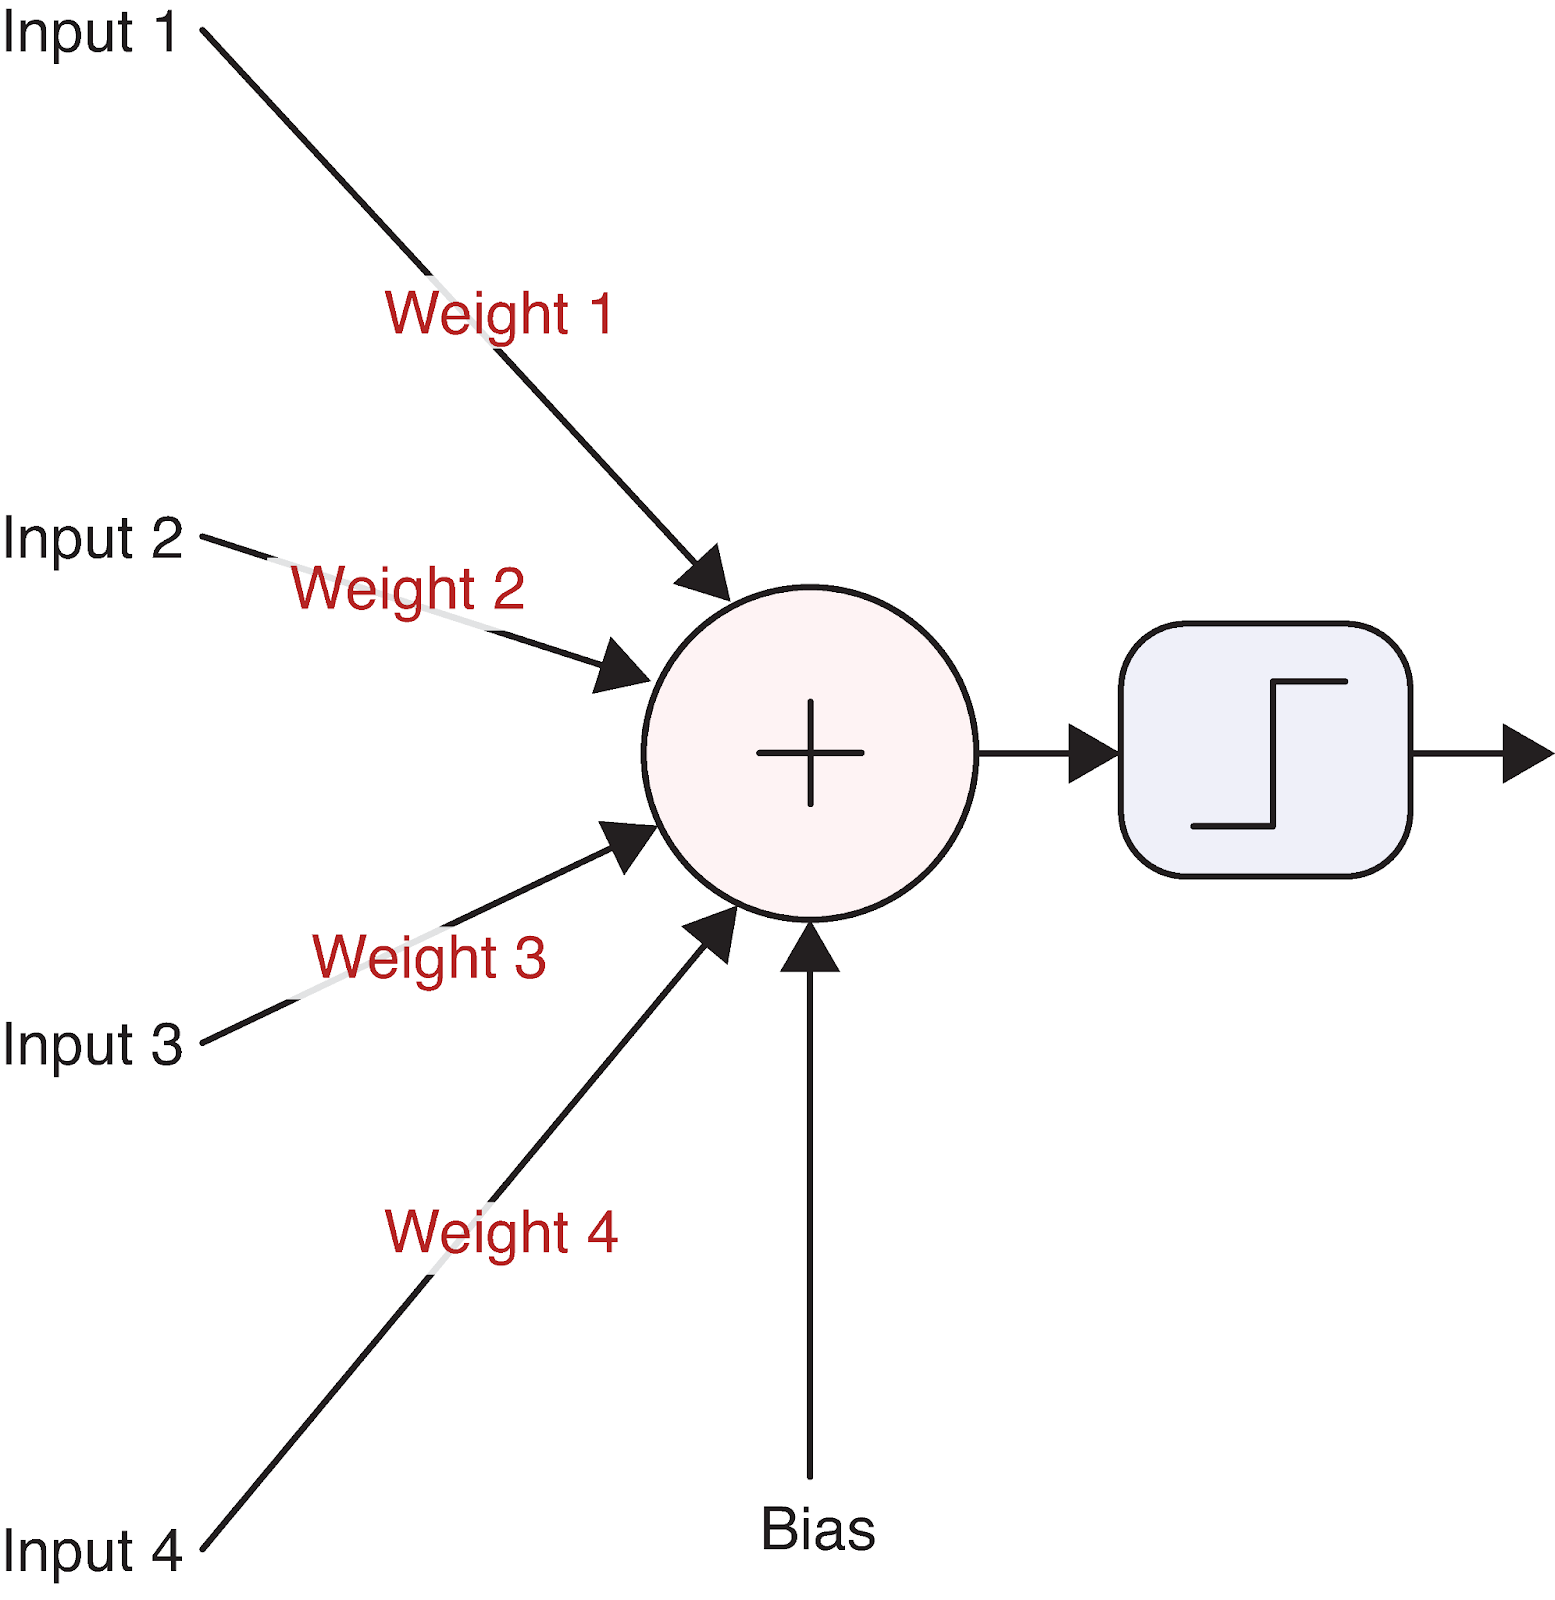
Sumber: Deep Learning - Visual Approach
Unit komputasi sederhana ini membentuk fondasi dari jaringan saraf yang paling kompleks sekalipun. Namun bagaimana tepatnya neuron mengubah input menjadi output? Di sinilah matematika berperan.
Operasi neuron dapat dijelaskan dengan persamaan yang lugas:
Memecahnya menjadi bagian-bagian:
Mari kita kerjakan contoh konkret dengan angka nyata. Misalkan kita punya neuron dengan tiga input:
Inputs: x = [2, 5, -1]
Weights: w = [0.5, -1, 2]
Bias: b = 0.5
Pertama, kita hitung jumlah berbobot ditambah bias:
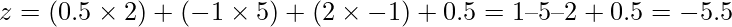
Selanjutnya, kita terapkan fungsi aktivasi. Mari gunakan fungsi ReLU (Rectified Linear Unit) yang populer, yang didefinisikan sebagai:
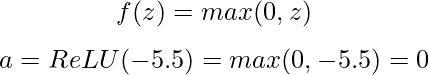
Dengan nilai pra-aktivasi negatif, neuron ReLU kita menghasilkan 0, artinya neuron tidak “menembak” untuk input ini.
Fungsi aktivasi penting karena memperkenalkan non-linearitas ke dalam jaringan. Tanpanya, jaringan saraf hanya bisa mempelajari hubungan linear, berapa pun banyaknya lapisan. Fungsi aktivasi umum meliputi:
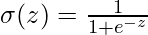 — Menghasilkan nilai antara 0 dan 1, berguna untuk klasifikasi biner
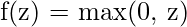 — Sederhana, efisien, dan membantu mengatasi masalah vanishing gradient
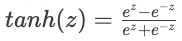 — Menghasilkan nilai antara -1 dan 1, sering digunakan di lapisan tersembunyi
Setiap fungsi aktivasi memiliki kekuatan dan kasus penggunaan masing-masing, yang akan kita jelajahi lebih lanjut saat mengimplementasikan jaringan saraf kita.
Neuron individual itu kuat, tetapi kekuatan sejati jaringan saraf muncul ketika neuron diorganisasikan ke dalam lapisan. Lapisan hanyalah sekumpulan neuron yang memproses input secara paralel. Biasanya ada tiga jenis lapisan dalam jaringan saraf:
Ketika kita memiliki beberapa neuron dalam satu lapisan, masing-masing menerima input yang sama tetapi dengan bobot dan bias yang berbeda, kita dapat merepresentasikannya secara efisien dengan operasi matriks. Mari lihat bagaimana ini bekerja.
Bayangkan kita memiliki lapisan dengan 3 nilai input dan 4 neuron. Setiap neuron memiliki seperangkat bobot dan biasnya sendiri:
Inputs: x = [x₁, x₂, x₃]
Weights for neuron 1: w₁ = [w₁₁, w₁₂, w₁₃]
Weights for neuron 2: w₂ = [w₂₁, w₂₂, w₂₃]
Weights for neuron 3: w₃ = [w₃₁, w₃₂, w₃₃]
Weights for neuron 4: w₄ = [w₄₁, w₄₂, w₄₃]
Biases: b = [b₁, b₂, b₃, b₄]
Kita dapat mengatur bobot-bobot ini ke dalam matriks W:
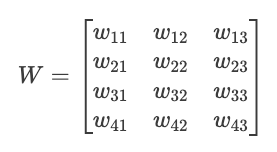
Kini kita dapat menghitung semua pra-aktivasi neuron sekaligus dengan satu perkalian matriks:
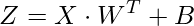
Di mana:
Kemudian kita terapkan fungsi aktivasi secara elemen-demi-elemen untuk mendapatkan keluaran akhir:
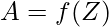
Representasi matriks ini bukan hanya keanggunan matematis; ini juga efisiensi komputasi. Perangkat keras modern (terutama GPU) dioptimalkan untuk operasi matriks, sehingga pendekatan ini jauh lebih cepat daripada menghitung keluaran setiap neuron secara individual.
Kemampuan untuk menumpuk lapisan-lapisan ini — dengan keluaran satu lapisan menjadi masukan bagi lapisan berikutnya — adalah yang memberi jaringan saraf kapasitas luar biasa untuk mempelajari pola kompleks. Saat kita menghubungkan blok bangunan ini, kita siap mengeksplorasi bagaimana propagasi maju bekerja di seluruh jaringan saraf.
Kini setelah kita memahami neuron dan lapisan secara individual, mari kita mundur selangkah dan melihat bagaimana propagasi maju bekerja di seluruh jaringan saraf. Di sinilah kekuatan sesungguhnya dari deep learning muncul.
Jaringan saraf lengkap terdiri dari lapisan input, satu atau lebih lapisan tersembunyi, dan lapisan output. Istilah “deep” dalam deep learning mengacu pada jaringan dengan banyak lapisan tersembunyi. Setiap lapisan mengubah data secara semakin abstrak, memungkinkan jaringan mempelajari representasi yang kompleks.
Pertimbangkan jaringan saraf sederhana dengan:
Secara visual, jaringan ini terlihat seperti:
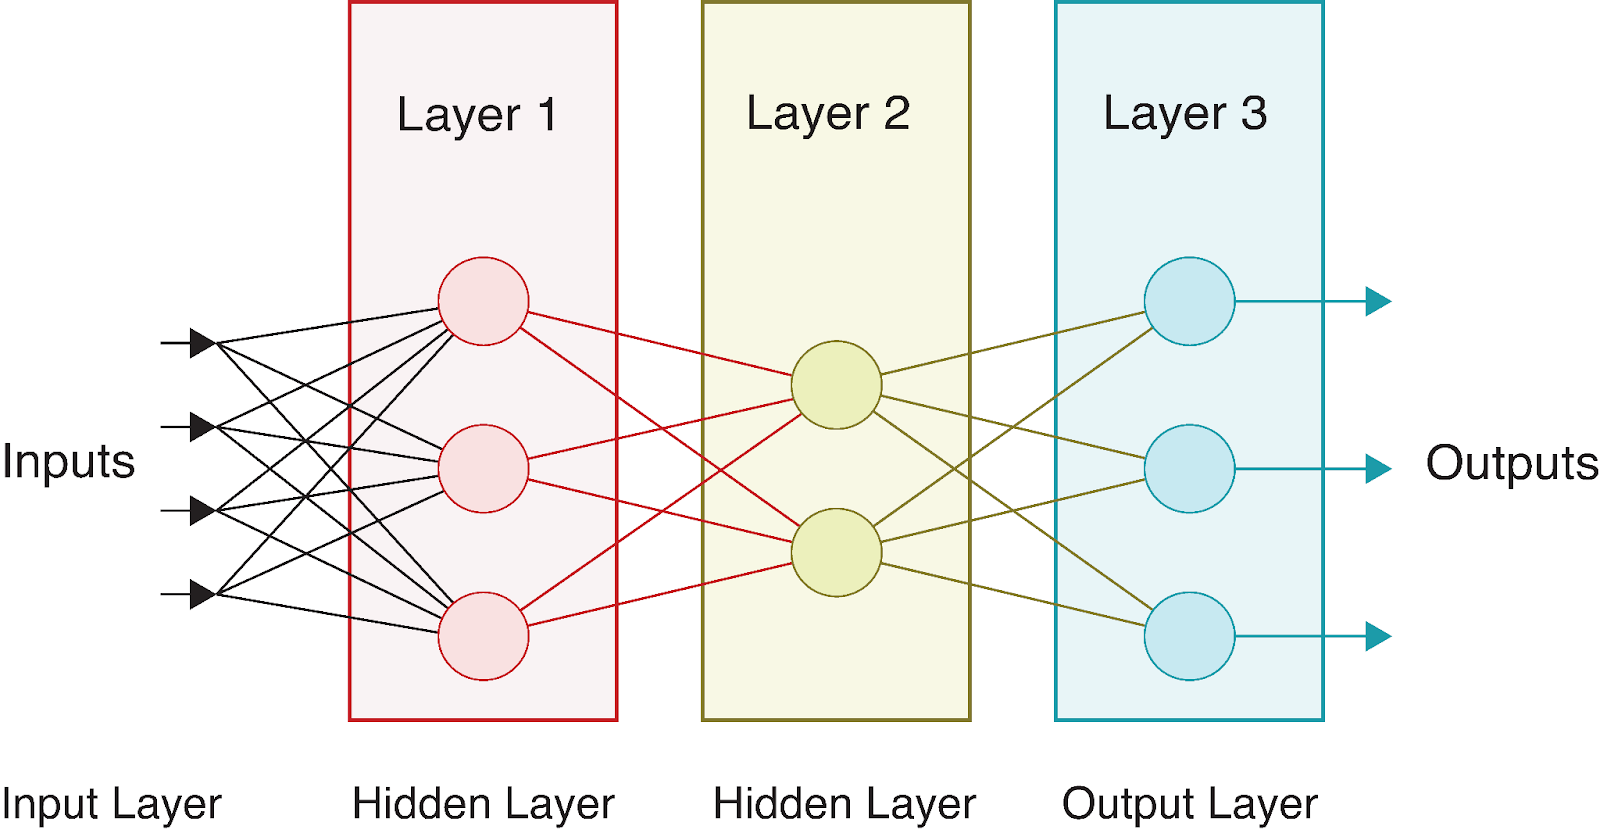
Saat data mengalir melalui jaringan ini, kita melakukan serangkaian perhitungan pada setiap lapisan. Jika kita nyatakan:
 (untuk lapisan tersembunyi) dan
 (untuk lapisan output)
 dan

Kita dapat menyatakan propagasi maju melalui seluruh jaringan ini sebagai:
1. Hitung pra-aktivasi lapisan tersembunyi:
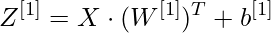
2. Terapkan fungsi aktivasi untuk mendapatkan keluaran lapisan tersembunyi:
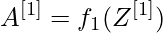
3. Hitung pra-aktivasi lapisan output:
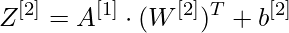
4. Terapkan fungsi aktivasi untuk mendapatkan keluaran akhir:
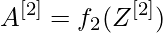
Keluaran akhir A^[2] merepresentasikan prediksi jaringan. Untuk masalah klasifikasi, ini bisa berupa probabilitas untuk setiap kelas; untuk regresi, bisa berupa nilai yang diprediksi.
Lapisan yang berbeda sering menggunakan fungsi aktivasi yang berbeda. Misalnya, lapisan tersembunyi umumnya menggunakan ReLU, sementara lapisan output dapat menggunakan:
Keindahan struktur multi-lapisan ini adalah setiap lapisan dapat mempelajari representasi aspek berbeda dari data. Lapisan awal biasanya mendeteksi fitur sederhana, sementara lapisan yang lebih dalam menggabungkannya menjadi pola yang lebih kompleks. Pembelajaran hierarkis inilah yang membuat jaringan saraf sangat kuat untuk tugas kompleks seperti pengenalan gambar dan ucapan.
Mari memformalkan proses propagasi maju menjadi sebuah algoritma. Untuk jaringan saraf dengan L lapisan, propagasi maju mengikuti langkah-langkah ini:
# Pseudocode for forward propagation
def forward_propagation(X, parameters):
   """
   X: Input data (batch_size, n_features)
   parameters: Dictionary containing weights and biases for each layer
   Returns: The final output and all intermediate activations
   """
   # Store all activations for later use (e.g., in backpropagation)
   activations = {'A0': X}  # A0 is the input

   # Loop through L-1 layers (excluding the output layer)
   for l in range(1, L):
       # Get previous activation
       A_prev = activations[f'A{l-1}']

       # Get weights and biases for current layer
       W = parameters[f'W{l}']
       b = parameters[f'b{l}']

       # Compute pre-activation
       Z = np.dot(A_prev, W.T) + b

       # Apply activation function (e.g., ReLU for hidden layers)
       A = relu(Z)

       # Store values for later use
       activations[f'Z{l}'] = Z
       activations[f'A{l}'] = A

   # Compute output layer (layer L)
   A_prev = activations[f'A{L-1}']
   W = parameters[f'W{L}']
   b = parameters[f'b{L}']

   # Compute pre-activation for output layer
   Z = np.dot(A_prev, W.T) + b

   # Apply output activation function (depends on the task)
   if task == 'binary_classification':
       A = sigmoid(Z)
   elif task == 'multiclass_classification':
       A = softmax(Z)
   elif task == 'regression':
       A = Z  # Linear activation

   # Store output layer values
   activations[f'Z{L}'] = Z
   activations[f'A{L}'] = A

   return A, activations
Algoritma ini menyoroti beberapa aspek penting dari propagasi maju:
Algoritma propagasi maju sangat sederhana, namun memungkinkan jaringan saraf untuk mendekati fungsi yang sangat kompleks. Ketika digabungkan dengan pelatihan yang tepat melalui backpropagation, proses sederhana ini memungkinkan jaringan belajar dari data dan membuat prediksi yang semakin akurat.
Mari telusuri contoh spesifik untuk semakin memantapkan pemahaman kita. Pertimbangkan input X = [0.5, -0.2, 0.1] yang melewati jaringan contoh kita dengan:
Untuk kesederhanaan, misalkan semua bobot bernilai 0,1 dan semua bias 0:
X = [0.5, -0.2, 0.1]
W[1] = [[0.1, 0.1, 0.1], [0.1, 0.1, 0.1], [0.1, 0.1, 0.1], [0.1, 0.1, 0.1]]
b[1] = [0, 0, 0, 0]
W[2] = [[0.1, 0.1, 0.1, 0.1], [0.1, 0.1, 0.1, 0.1]]
b[2] = [0, 0]
Mengikuti algoritma kita:
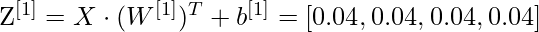
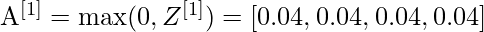
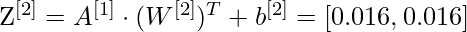
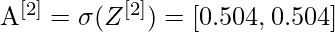
Ini memberi kita prediksi akhir. Dalam konteks klasifikasi biner, nilai-nilai sekitar 0,5 menunjukkan ketidakpastian antara dua kelas.
Pada bagian berikutnya, kita akan mengimplementasikan propagasi maju di Python untuk melihat perhitungan ini secara nyata.
Setelah memahami teori di balik propagasi maju, mari kita praktikkan dengan mengimplementasikannya di Python. Kita akan mulai dengan implementasi “dari nol” hanya menggunakan NumPy, lalu melihat bagaimana kerangka deep learning modern menyederhanakan proses ini.
NumPy menyediakan operasi array yang efisien sehingga kita dapat mengimplementasikan perhitungan matriks yang telah dibahas. Mari bangun kelas jaringan saraf sederhana yang melakukan propagasi maju melalui beberapa lapisan.
Pertama, kita perlu mengimpor pustaka yang diperlukan:
import numpy as np
import matplotlib.pyplot as plt

# For reproducibility
np.random.seed(42)
Sekarang, mari kita definisikan fungsi aktivasi yang akan kita gunakan dalam jaringan:
def relu(Z):
   """ReLU activation function: max(0, Z)"""
   return np.maximum(0, Z)

def sigmoid(Z):
   """Sigmoid activation function: 1/(1 + e^(-Z))"""
   return 1 / (1 + np.exp(-Z))

def softmax(Z):
   """Softmax activation function for multi-class classification"""
   # Subtract max for numerical stability (prevents overflow)
   exp_Z = np.exp(Z - np.max(Z, axis=1, keepdims=True))
   return exp_Z / np.sum(exp_Z, axis=1, keepdims=True)
Selanjutnya, mari buat kelas untuk jaringan saraf kita:
class NeuralNetwork:
   def __init__(self, layer_dims, activations):
       """
       Initialize a neural network with specified layer dimensions and activations

       Parameters:
       - layer_dims: List of integers representing the number of neurons in each layer
                    (including input and output layers)
       - activations: List of activation functions for each layer (excluding input layer)
       """
       self.L = len(layer_dims) - 1  # Number of layers (excluding input layer)
       self.layer_dims = layer_dims
       self.activations = activations
       self.parameters = {}

       # Initialize parameters (weights and biases)
       self.initialize_parameters()

   def initialize_parameters(self):
       """Initialize weights and biases with small random values"""
       for l in range(1, self.L + 1):
           # He initialization for weights - helps with training deep networks
           self.parameters[f'W{l}'] = np.random.randn(self.layer_dims[l], self.layer_dims[l-1]) * np.sqrt(2 / self.layer_dims[l-1])
           self.parameters[f'b{l}'] = np.zeros((self.layer_dims[l], 1))

   def forward_propagation(self, X):
       """
       Perform forward propagation through the network

       Parameters:
       - X: Input data (n_features, batch_size)

       Returns:
       - AL: Output of the network
       - caches: Dictionary containing all activations and pre-activations
       """
       caches = {}
       A = X  # Input layer activation
       caches['A0'] = X

       # Process through L-1 layers (excluding output layer)
       for l in range(1, self.L):
           A_prev = A

           # Get weights and biases for current layer
           W = self.parameters[f'W{l}']
           b = self.parameters[f'b{l}']

           # Forward propagation for current layer
           Z = np.dot(W, A_prev) + b

           # Apply activation function
           activation_function = self.activations[l-1]
           if activation_function == "relu":
               A = relu(Z)
           elif activation_function == "sigmoid":
               A = sigmoid(Z)

           # Store values for backpropagation
           caches[f'Z{l}'] = Z
           caches[f'A{l}'] = A

       # Output layer
       W = self.parameters[f'W{self.L}']
       b = self.parameters[f'b{self.L}']
       Z = np.dot(W, A) + b

       # Apply output activation function
       activation_function = self.activations[self.L-1]
       if activation_function == "sigmoid":
           AL = sigmoid(Z)
       elif activation_function == "softmax":
           AL = softmax(Z)
       elif activation_function == "linear":
           AL = Z  # No activation for regression

       # Store output layer values
       caches[f'Z{self.L}'] = Z
       caches[f'A{self.L}'] = AL

       return AL, caches
Kelas NeuralNetwork yang kita implementasikan di atas menyediakan kerangka lengkap untuk membuat dan menggunakan jaringan saraf dengan arsitektur yang dapat dikustomisasi. Mari uraikan komponen kuncinya:
forward_propagation yang baru saja kita implementasikan adalah inti dari kemampuan prediksi jaringan saraf. Metode ini:3. Fungsi aktivasi: Jaringan mendukung beberapa fungsi aktivasi, termasuk ReLU, sigmoid, dan softmax, sehingga dapat menangani berbagai jenis masalah (regresi atau klasifikasi).
4. Arsitektur yang fleksibel: Implementasi ini memungkinkan jaringan dengan kedalaman dan lebar arbitrer, sehingga cocok untuk beragam tugas machine learning.
Implementasi ini mengikuti pola desain jaringan saraf standar di mana data mengalir maju melalui jaringan, dengan setiap lapisan mengubah data sebelum meneruskannya ke lapisan berikutnya.
Sekarang mari uji implementasi kita dengan jaringan contoh kecil:
# Create a sample network
# Input layer: 3 features
# Hidden layer 1: 4 neurons with ReLU activation
# Output layer: 2 neurons with sigmoid activation (binary classification)
layer_dims = [3, 4, 2]
activations = ["relu", "sigmoid"]
nn = NeuralNetwork(layer_dims, activations)

# Create sample input data - 3 features for 5 examples
X = np.random.randn(3, 5)

# Perform forward propagation
output, caches = nn.forward_propagation(X)

print(f"Input shape: {X.shape}")
print(f"Output shape: {output.shape}")
print(f"Output values:\n{output}")Keluaran:
Input shape: (3, 5)
Output shape: (2, 5)
Output values:
[[0.00386784 0.54343014 0.39661893 0.5        0.51056934]
[0.11877049 0.32541093 0.44840699 0.5        0.45586633]]
Mari juga memvisualisasikan bagaimana data berubah saat mengalir melalui jaringan:
def visualize_activations(caches, example_idx=0):
   """Visualize the activations for a single example through the network"""
   plt.figure(figsize=(15, 6))

   # Plot input
   plt.subplot(1, 3, 1)
   plt.bar(range(caches['A0'].shape[0]), caches['A0'][:, example_idx])
   plt.title('Input Layer')
   plt.xlabel('Feature')
   plt.ylabel('Value')

   # Plot hidden layer activation
   plt.subplot(1, 3, 2)
   plt.bar(range(caches['A1'].shape[0]), caches['A1'][:, example_idx])
   plt.title('Hidden Layer (ReLU Activation)')
   plt.xlabel('Neuron')
   plt.ylabel('Activation')

   # Plot output layer
   plt.subplot(1, 3, 3)
   plt.bar(range(caches['A2'].shape[0]), caches['A2'][:, example_idx])
   plt.title('Output Layer (Sigmoid Activation)')
   plt.xlabel('Neuron')
   plt.ylabel('Activation')

   plt.tight_layout()
   plt.show()

# Visualize the first example
visualize_activations(caches)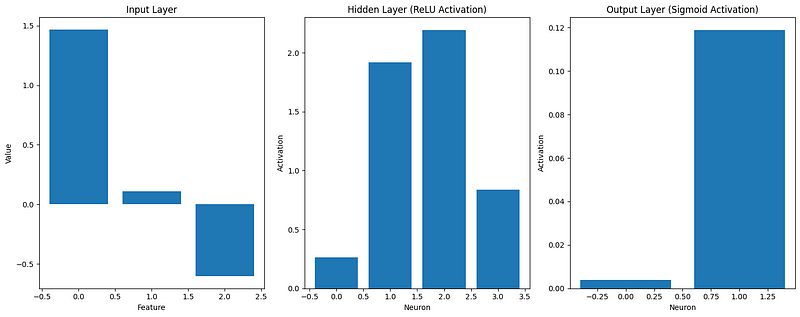
Visualisasi ini membantu kita memahami bagaimana data masukan diubah saat dipropagasikan melalui jaringan. Kita dapat melihat bahwa:
Implementasi “dari nol” kita menunjukkan prinsip inti propagasi maju, tetapi kerangka deep learning modern menyediakan alat yang lebih efisien dan fleksibel untuk membangun jaringan saraf.
Sekarang, mari kita implementasikan jaringan saraf yang sama menggunakan kerangka deep learning populer: TensorFlow dan PyTorch. Kerangka ini mengoptimalkan kinerja dan menyediakan abstraksi tingkat tinggi, sehingga lebih mudah membangun model yang kompleks.
Pertama, mari lihat implementasi TensorFlow/Keras:
import tensorflow as tf
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, Input

# For reproducibility
tf.random.set_seed(42)

# Create the same network architecture
tf_model = Sequential([
   Input(shape=(3,)),  # Input layer with 3 features
   Dense(4, activation='relu'),  # Hidden layer with 4 neurons
   Dense(2, activation='sigmoid')  # Output layer with 2 neurons
])

tf_model.summary()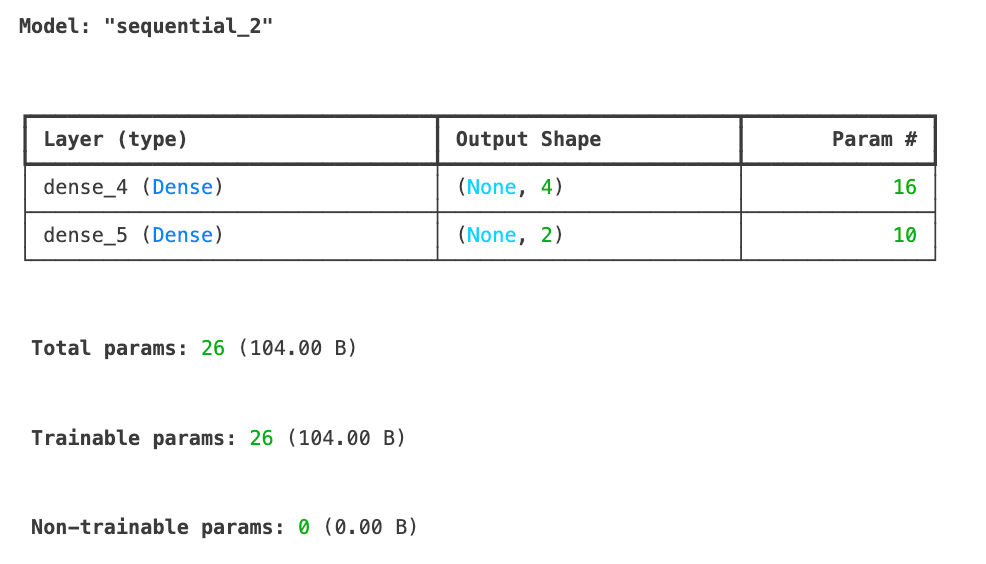
# Sample input data with the shape expected by Keras
X_tf = np.random.randn(5, 3)  # 5 examples, 3 features

# Forward propagation in TensorFlow
tf_output = tf_model.predict(X_tf)

print(f"TensorFlow output shape: {tf_output.shape}")
print(f"TensorFlow output values:\n{tf_output}")
TensorFlow output shape: (5, 2)
TensorFlow output values:
[[0.6855308 0.7139542 ]
[0.4952355 0.5231934 ]
[0.50174904 0.5198488 ]
[0.44331825 0.6860926 ]
[0.6624589 0.5385444 ]]Kita baru saja mengimplementasikan jaringan saraf menggunakan TensorFlow/Keras dan berhasil melakukan propagasi maju pada beberapa data contoh. Ringkasan model menunjukkan arsitektur kita dengan lapisan input yang menerima 3 fitur, lapisan tersembunyi dengan 4 neuron menggunakan aktivasi ReLU, dan lapisan output dengan 2 neuron menggunakan aktivasi sigmoid. Total, model memiliki 26 parameter yang dapat dilatih.
Hasil propagasi maju menunjukkan bentuk keluaran (5, 2) yang sesuai dengan 5 contoh input kita, masing-masing menghasilkan 2 nilai keluaran. Keluaran ini dibatasi antara 0 dan 1 karena fungsi aktivasi sigmoid di lapisan output.
Selanjutnya, mari lihat bagaimana kita dapat mengimplementasikan arsitektur jaringan saraf yang sama menggunakan PyTorch, kerangka deep learning populer lainnya, untuk membandingkan pendekatan.
import torch
import torch.nn as nn

# For reproducibility
torch.manual_seed(42)

# Create a network in PyTorch
class PyTorchNN(nn.Module):
   def __init__(self):
       super(PyTorchNN, self).__init__()
       self.hidden = nn.Linear(3, 4)  # 3 inputs, 4 hidden neurons
       self.relu = nn.ReLU()
       self.output = nn.Linear(4, 2)  # 4 inputs from hidden, 2 outputs
       self.sigmoid = nn.Sigmoid()

   def forward(self, x):
       x = self.relu(self.hidden(x))
       x = self.sigmoid(self.output(x))
       return x

# Instantiate the model
torch_model = PyTorchNN()

# Print model structure
print(torch_model)Keluaran:
PyTorchNN(
 (hidden): Linear(in_features=3, out_features=4, bias=True)
 (relu): ReLU()
 (output): Linear(in_features=4, out_features=2, bias=True)
 (sigmoid): Sigmoid()
)

```python
# Sample input data
X_torch = torch.randn(5, 3)  # 5 examples, 3 features

# Forward propagation in PyTorch
torch_output = torch_model(X_torch)

print(f"PyTorch output shape: {torch_output.shape}")
print(f"PyTorch output values:\n{torch_output}")Keluaran:
PyTorch output shape: torch.Size([5, 2])
PyTorch output values:
tensor([[0.4516, 0.4116],
       [0.4289, 0.4267],
       [0.4278, 0.4172],
       [0.3771, 0.4321],
       [0.5769, 0.3328]], grad_fn=<SigmoidBackward0>)
Mari bandingkan implementasi kita:
# Compare dimensions and structure of outputs
print("\nComparison of implementations:")
print(f"NumPy output shape: {output.shape}")
print(f"TensorFlow output shape: {tf_output.shape}")
print(f"PyTorch output shape: {torch_output.shape}")Keluaran:
Comparison of implementations:
NumPy output shape: (2, 5)
TensorFlow output shape: (5, 2)
PyTorch output shape: torch.Size([5, 2])
Perbedaan kunci antara implementasi kita:
Untuk jaringan sederhana, implementasi NumPy kita sudah memadai, tetapi seiring meningkatnya kompleksitas, kerangka deep learning menjadi esensial. Mereka menangani optimasi tingkat rendah dan menyediakan alat untuk seluruh alur kerja machine learning, dari pengembangan hingga deployment. Untuk mempelajari lebih lanjut tentang kerangka ini, lihat panduan terpisah kami:
Pada bagian berikutnya, kita akan membangun contoh lengkap yang menerapkan propagasi maju pada masalah dunia nyata.
Sekarang setelah kita mengimplementasikan propagasi maju baik dari nol maupun menggunakan kerangka populer, mari kita lihat aksinya pada masalah dunia nyata. Kita akan membangun contoh lengkap dan mengeksplorasi cara mengoptimalkan proses untuk kinerja yang lebih baik.
Mari terapkan pemahaman kita pada masalah machine learning klasik: pengenalan digit tulisan tangan menggunakan dataset MNIST. Dataset ini berisi 70.000 gambar digit tulisan tangan (0–9), masing-masing berukuran 28x28 piksel.
Pertama, mari muat dan siapkan datanya:
from tensorflow.keras.datasets import mnist
import numpy as np
import matplotlib.pyplot as plt

# Load MNIST dataset
(X_train, y_train), (X_test, y_test) = mnist.load_data()

# Normalize pixel values to range [0, 1]
X_train = X_train / 255.0
X_test = X_test / 255.0

# Reshape images to vectors (flatten 28x28 to 784)
X_train_flat = X_train.reshape(X_train.shape[0], -1).T  # Shape: (784, 60000)
X_test_flat = X_test.reshape(X_test.shape[0], -1).T     # Shape: (784, 10000)

# Convert labels to one-hot encoding
def one_hot_encode(y, num_classes=10):
   one_hot = np.zeros((num_classes, y.size))
   one_hot[y, np.arange(y.size)] = 1
   return one_hot

y_train_one_hot = one_hot_encode(y_train)  # Shape: (10, 60000)
y_test_one_hot = one_hot_encode(y_test)    # Shape: (10, 10000)

# Display sample images
plt.figure(figsize=(10, 5))
for i in range(5):
   plt.subplot(1, 5, i+1)
   plt.imshow(X_train[i], cmap='gray')
   plt.title(f"Label: {y_train[i]}")
   plt.axis('off')
plt.tight_layout()
plt.show()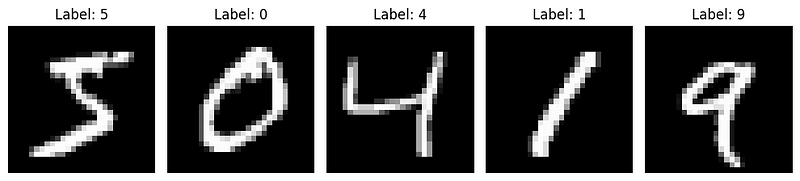
Sekarang, mari bangun jaringan saraf untuk tugas ini menggunakan implementasi NumPy kita. Kita akan membuat jaringan dengan:
# Define our network architecture
layer_dims = [784, 128, 10]
activations = ["relu", "softmax"]
nn = NeuralNetwork(layer_dims, activations)

# Take a small batch for demonstration
batch_size = 64
batch_indices = np.random.choice(X_train_flat.shape[1], batch_size, replace=False)
X_batch = X_train_flat[:, batch_indices]
y_batch = y_train_one_hot[:, batch_indices]

# Perform forward propagation
output, caches = nn.forward_propagation(X_batch)

# Compute accuracy
predictions = np.argmax(output, axis=0)
true_labels = np.argmax(y_batch, axis=0)
accuracy = np.mean(predictions == true_labels)

print(f"Batch accuracy: {accuracy:.4f}")

Out: Batch accuracy: 0.0781
Kita mendapatkan akurasi 7%, yang bahkan lebih buruk daripada menebak secara acak. Namun itu wajar karena kita hanya melakukan propagasi maju — belum ada pembelajaran yang terlibat.
Sekarang, mari visualisasikan bagaimana jaringan memproses sebuah gambar melalui setiap lapisan:
def visualize_network_processing(nn, image, label, caches):
   """Visualize network processing for a single image"""
   plt.figure(figsize=(15, 10))

   # Plot original image
   plt.subplot(2, 3, 1)
   plt.imshow(image.reshape(28, 28), cmap='gray')
   plt.title(f"Input Image (Digit: {label})")
   plt.axis('off')

   # Plot flattened input (first 100 values)
   plt.subplot(2, 3, 2)
   plt.bar(range(100), image.flatten()[:100])
   plt.title("Input Layer (first 100 pixels)")
   plt.xlabel("Pixel Index")
   plt.ylabel("Pixel Value")

   # Plot hidden layer activations (first 50 neurons)
   plt.subplot(2, 3, 3)
   hidden_activations = caches['A1'][:50, 0]
   plt.bar(range(len(hidden_activations)), hidden_activations)
   plt.title("Hidden Layer Activations (first 50 neurons)")
   plt.xlabel("Neuron Index")
   plt.ylabel("Activation")

   # Plot output layer activations
   plt.subplot(2, 3, 4)
   output_activations = caches['A2'][:, 0]
   plt.bar(range(10), output_activations)
   plt.xticks(range(10))
   plt.title("Output Layer Activations (Softmax)")
   plt.xlabel("Digit Class")
   plt.ylabel("Probability")

   # Plot prediction vs actual
   plt.subplot(2, 3, 5)
   prediction = np.argmax(output_activations)
   plt.bar(['Actual', 'Predicted'], [label, prediction], color=['blue', 'orange'])
   plt.title(f"Prediction: {prediction}, Actual: {label}")
   plt.ylabel("Digit")

   plt.tight_layout()
   plt.show()

# Visualize forward propagation for the first image in our batch
image_idx = 0
image = X_batch[:, image_idx].reshape(784, 1)
label = true_labels[image_idx]

visualize_network_processing(nn, image, label, caches)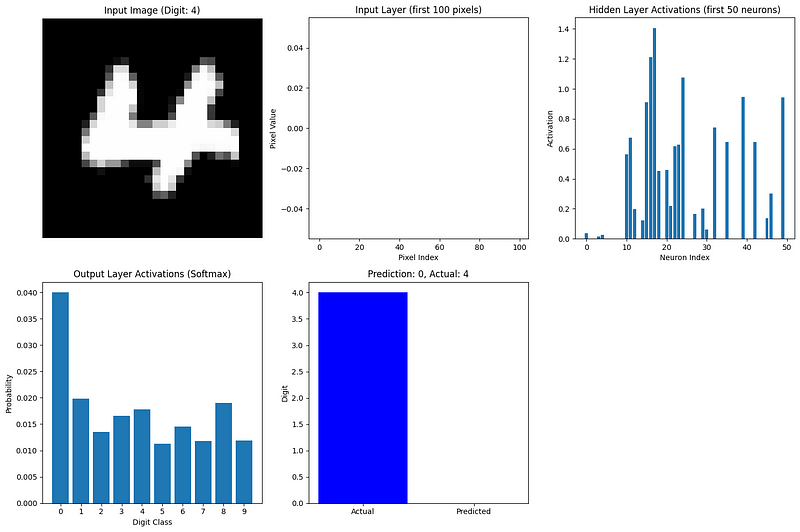
Visualisasi ini menunjukkan bagaimana informasi mengalir melalui jaringan kita:
Neuron output yang paling aktif sesuai dengan prediksi jaringan. Bahkan dengan bobot acak (karena kita belum melatih jaringan), kita dapat melihat bagaimana propagasi maju mengubah data masukan menjadi sebuah prediksi.
Untuk contoh yang lebih lengkap, kita akan melatih jaringan ini menggunakan backpropagation untuk menyesuaikan bobot dan bias, meningkatkan prediksi seiring waktu. Namun, bahkan tanpa pelatihan, contoh ini menunjukkan proses propagasi maju pada data nyata.
Seiring jaringan saraf menjadi lebih besar dan dataset semakin masif, mengoptimalkan propagasi maju menjadi krusial. Berikut strategi kunci untuk membuat propagasi maju lebih efisien:
Alih-alih memproses satu contoh pada satu waktu, kita menghitung propagasi maju pada batch contoh secara simultan. Ini memanfaatkan kemampuan pemrosesan paralel dari perangkat keras modern.
Menggunakan operasi matriks alih-alih loop secara dramatis mempercepat komputasi. Inilah alasan implementasi kita menggunakan operasi array NumPy.
Untuk jaringan besar, kita perlu berhati-hati dengan penggunaan memori. Tekniknya meliputi:
Graphics Processing Unit unggul dalam operasi matriks. Kerangka modern dapat memindahkan komputasi ke GPU secara mulus untuk peningkatan kecepatan yang signifikan:
# TensorFlow example of GPU acceleration
import tensorflow as tf

# Check for available GPUs
print("GPUs Available:", tf.config.list_physical_devices('GPU'))

# TensorFlow automatically uses available GPUs
with tf.device('/GPU:0'):  # Explicitly specify GPU if multiple are available
   # Computation runs on GPU if available
result = tf_model.predict(X_tf)Di luar GPU, perangkat keras seperti Tensor Processing Unit (TPU) dari Google dirancang khusus untuk operasi jaringan saraf.
Fungsi aktivasi dan arsitektur jaringan tertentu dirancang untuk efisiensi komputasi:
Kerangka deep learning mengimplementasikan banyak optimasi tingkat rendah:
Seiring jaringan menjadi lebih dalam dan lebih lebar, optimasi propagasi maju menjadi semakin penting. Arsitektur modern seperti ResNet, Transformer, dan EfficientNet menggabungkan pilihan desain khusus untuk membuat propagasi maju lebih efisien sekaligus mempertahankan atau meningkatkan akurasi model.
Pada bagian berikutnya, kita akan mengeksplorasi bagaimana propagasi maju terhubung ke propagasi mundur (backpropagation), melengkapi gambaran bagaimana jaringan saraf belajar.
Kita kini telah menjelajahi propagasi maju secara menyeluruh, tetapi ini hanyalah setengah dari cerita ketika berbicara tentang jaringan saraf. Mari kita tinjau secara singkat bagaimana propagasi maju terhubung dengan backpropagation, algoritma yang memungkinkan jaringan saraf belajar.
Propagasi maju dan backpropagation bekerja sebagai proses yang saling melengkapi dalam jaringan saraf:
Kedua proses ini tak terpisahkan dalam proses pembelajaran. Backpropagation tidak dapat terjadi tanpa terlebih dahulu melakukan propagasi maju, karena ia membutuhkan:
Anggap propagasi maju sebagai jaringan saraf membuat tebakan terbaiknya, berdasarkan pemahamannya saat ini, sementara backpropagation adalah cara ia menyempurnakan pemahaman itu berdasarkan kesalahannya.
Seluruh proses pembelajaran mengikuti pola siklik:
Yang membuat proses ini kuat adalah propagasi maju menyediakan konteks yang dibutuhkan untuk backpropagation. Selama propagasi maju, jaringan tidak hanya membuat prediksi tetapi juga melacak semua nilai dan keputusan perantara. Backpropagation kemudian menggunakan informasi ini untuk melakukan penyesuaian yang terarah.
Keindahan sistem ini adalah pembelajaran yang kompleks muncul dari dua proses yang relatif sederhana ini bekerja bersama. Propagasi maju itu lurus — hanyalah perkalian matriks dan fungsi aktivasi yang diterapkan secara berurutan. Backpropagation lebih kompleks namun mengikuti langsung dari prinsip kalkulus.
Bersama-sama, keduanya memungkinkan jaringan saraf mempelajari hampir semua pola asalkan memiliki cukup data dan sumber daya komputasi. Kemampuan belajar ini telah mendorong terobosan dalam visi komputer, pemrosesan bahasa alami, game, dan banyak domain lainnya.
Memahami propagasi maju secara menyeluruh, seperti yang telah kita lakukan dalam artikel ini, memberikan fondasi yang dibutuhkan untuk memahami proses pembelajaran lengkap dalam jaringan saraf. Jika Anda tertarik memperdalam aspek pembelajaran, panduan kami tentang backpropagation memberikan penjelasan mendetail tentang bagaimana jaringan belajar dari kesalahan.
Propagasi maju adalah proses mendasar yang memungkinkan jaringan saraf mengubah input menjadi prediksi. Seperti yang telah kita bahas, ini melibatkan perkalian matriks berurutan dan fungsi aktivasi yang secara progresif mengubah data melalui lapisan-lapisan jaringan. Memahami proses ini sangat penting baik Anda mengimplementasikan jaringan dari nol, menggunakan kerangka modern, maupun menelusuri kinerja model.
Dengan menguasai propagasi maju, Anda telah mengambil langkah signifikan menuju pembangunan dan pemahaman model deep learning yang dapat menangani masalah kompleks lintas domain.
Untuk melanjutkan perjalanan deep learning Anda, jelajahi sumber daya komprehensif dari DataCamp:
Untuk jalur pembelajaran terstruktur, Deep Learning in Python track menyediakan semua yang Anda butuhkan untuk mahir membangun dan menerapkan jaringan saraf untuk aplikasi dunia nyata.
Kursus Teratas di DataCamp
Kursus
Program
Kursus
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt