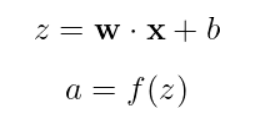

Corso
Deep Learning intermedio con PyTorch
4 ore
30K
Le reti neurali hanno rivoluzionato l’intelligenza artificiale, alimentando tutto, dal riconoscimento delle immagini all’elaborazione del linguaggio naturale. Al cuore di questi potenti modelli c’è un processo fondamentale chiamato propagazione in avanti. Questa guida ne esplorerà il concetto centrale, portandoti dai principi di base all’implementazione pratica.
Se cerchi una guida pratica a molti dei concetti trattati qui, dai un’occhiata al nostro percorso di competenze Deep Learning in Python.
La propagazione in avanti è il processo con cui una rete neurale trasforma i dati in ingresso in previsioni o output. Pensala come la fase di “ragionamento” di una rete neurale: quando le viene mostrato un input (come un’immagine o un testo), la propagazione in avanti è il modo in cui la rete elabora quell’informazione attraverso i suoi strati per produrre un risultato.
In termini tecnici, è il calcolo sequenziale che muove i dati dallo strato di input, attraverso gli strati nascosti, fino allo strato di output. Durante questo percorso, i dati vengono trasformati da connessioni pesate e funzioni di attivazione, permettendo alla rete di catturare pattern complessi.
Capire la propagazione in avanti è fondamentale per diversi motivi:
Alla fine di questa guida completa, sarai in grado di:
Per trarre il massimo da questa guida, dovresti avere:
Se vuoi rafforzare le basi, considera queste risorse:
Anche senza una solida base iniziale, abbiamo progettato questa guida per costruire i concetti in modo progressivo, rendendo le reti neurali accessibili a chi è determinato a imparare. Tuffiamoci!
Per capire la propagazione in avanti, dobbiamo partire dai suoi mattoni fondamentali. Iniziamo dall’unità di calcolo più piccola nelle reti neurali e costruiamo gradualmente strutture più complesse.
Il viaggio di una rete neurale inizia con un affascinante parallelo alla biologia. Proprio come il cervello umano è composto da miliardi di neuroni interconnessi, le reti neurali artificiali sono costruite su modelli matematici ispirati a queste cellule biologiche.
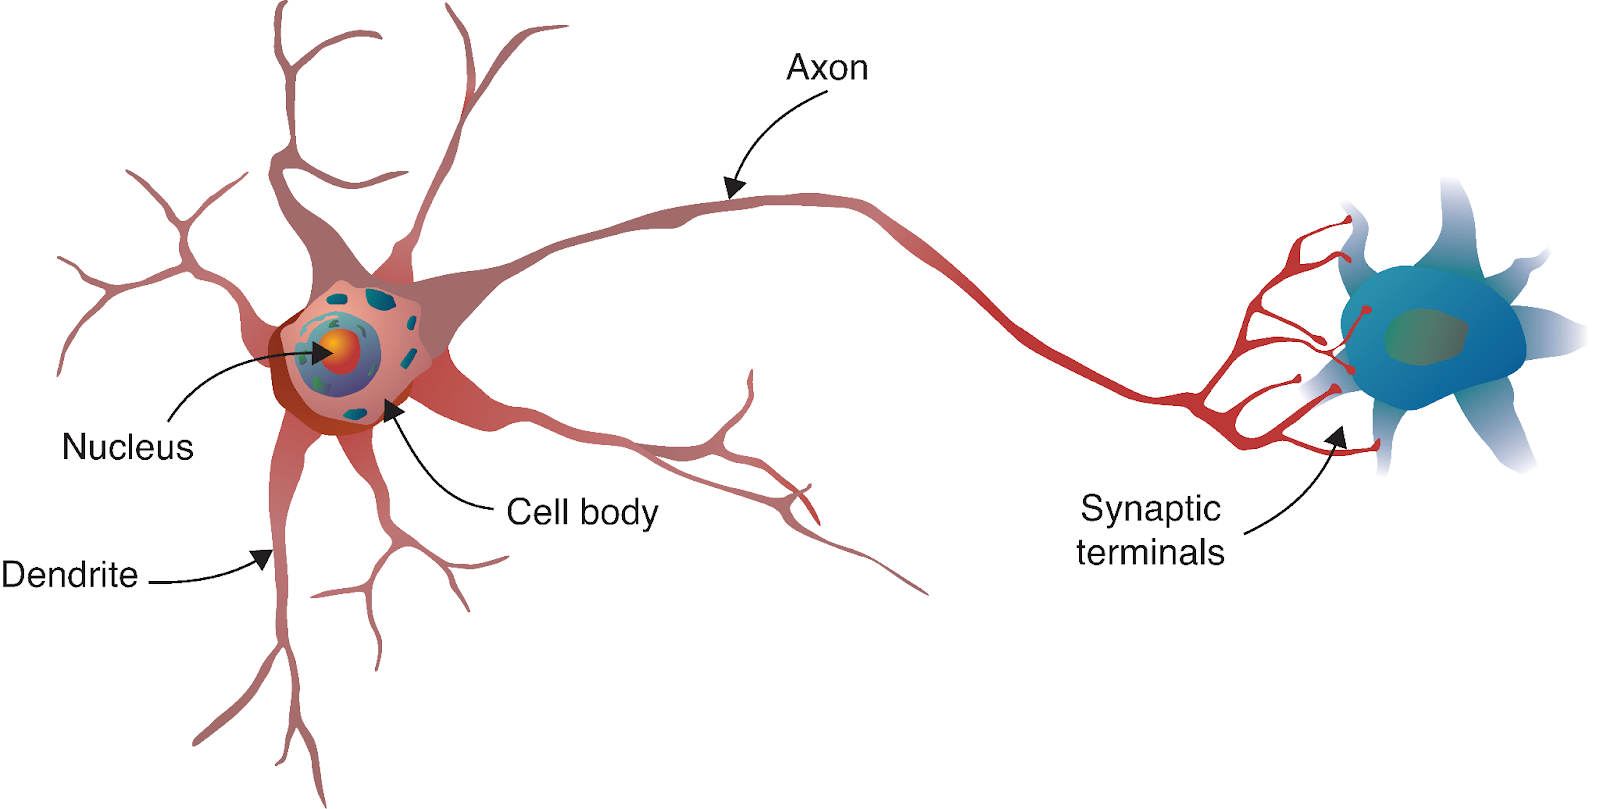
Fonte: Deep Learning - Visual Approach
Un neurone biologico riceve segnali da altri neuroni attraverso i dendriti, elabora questi segnali nel corpo cellulare e poi trasmette il risultato attraverso l’assone ad altri neuroni. Nel nostro modello computazionale, replichiamo questo processo con:
Visualizziamo un singolo neurone per rendere tutto più concreto:
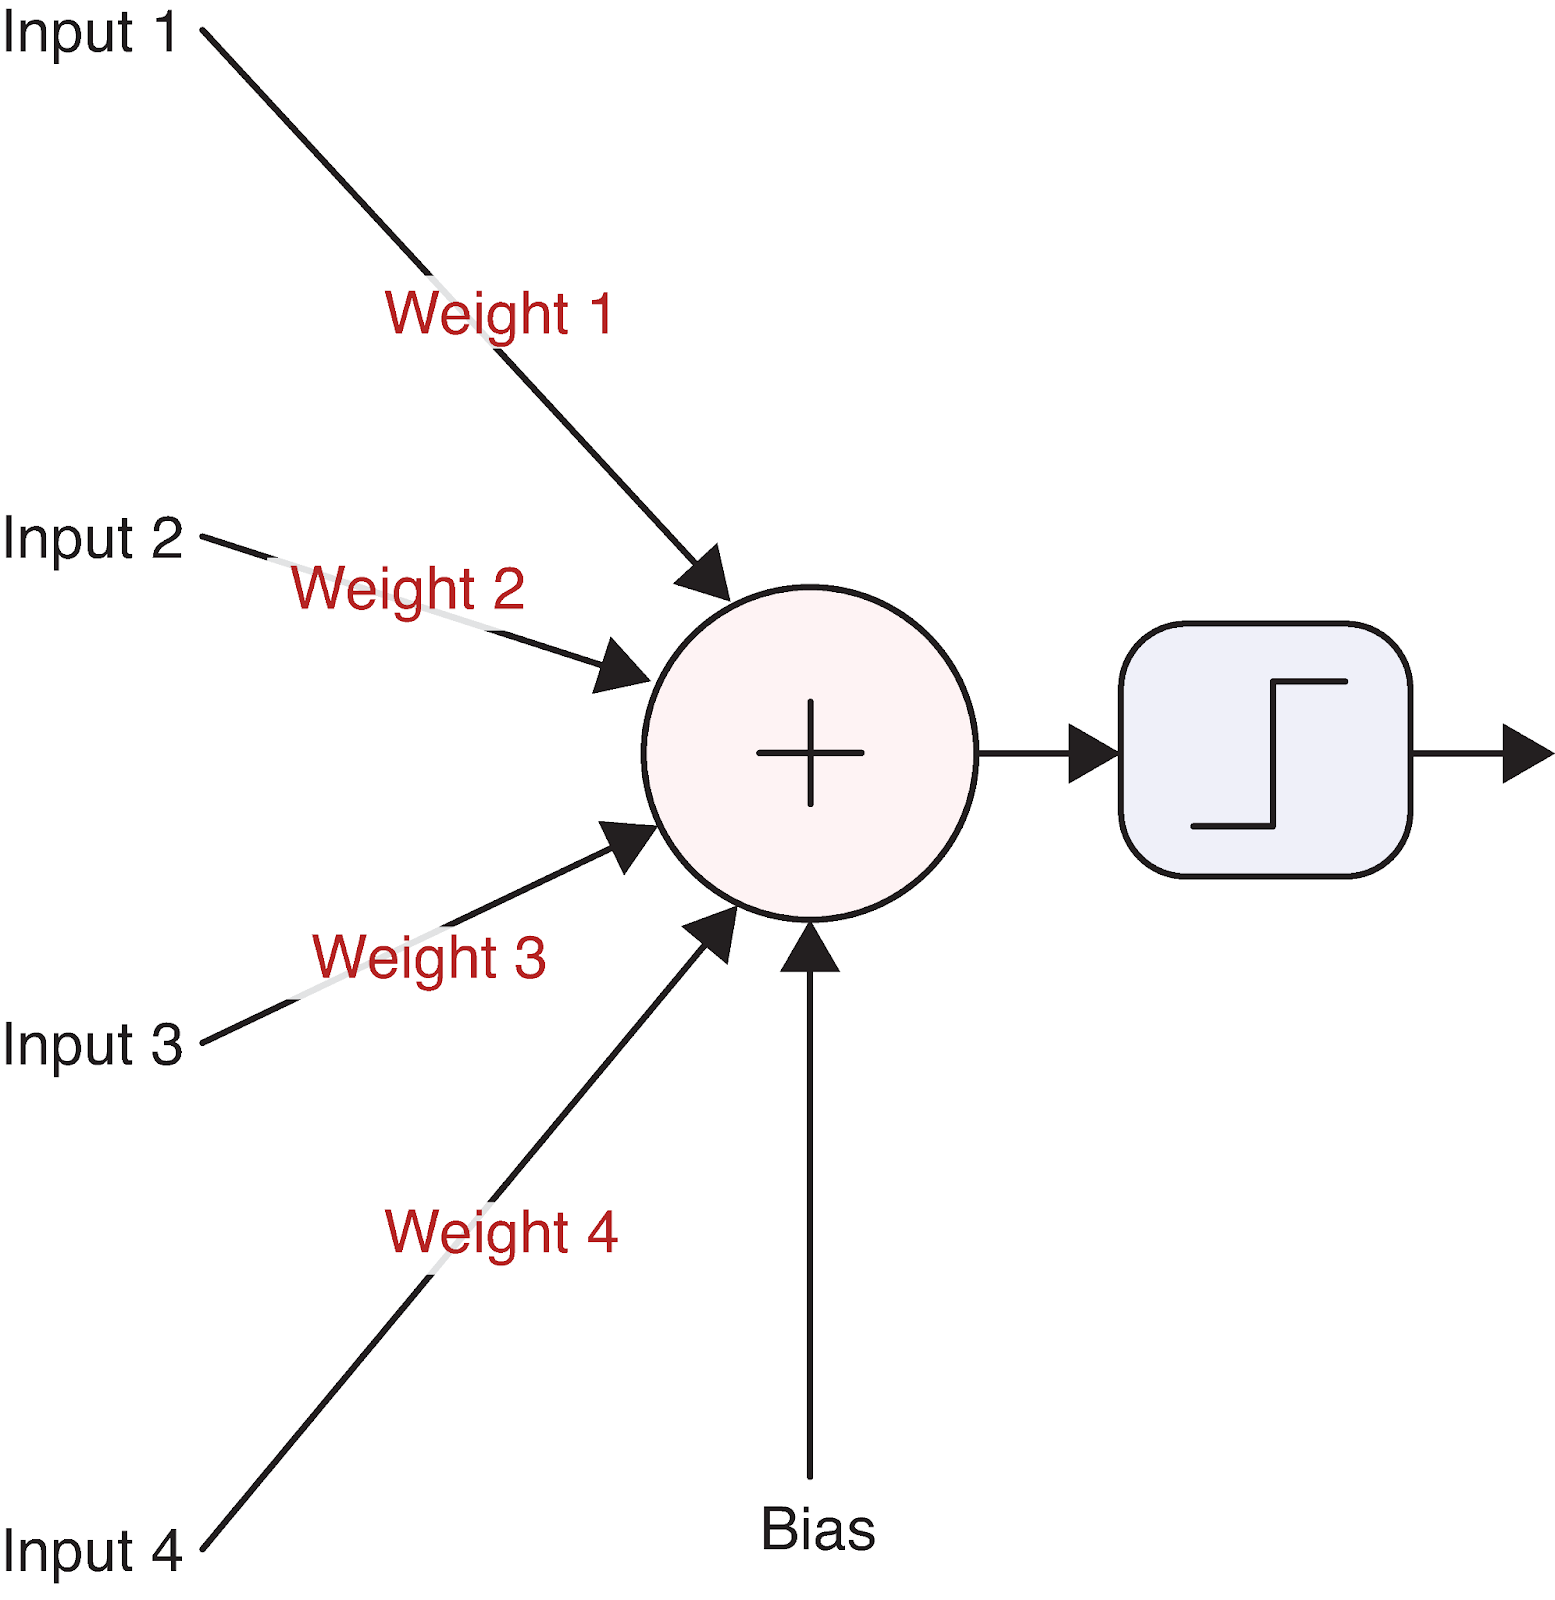
Fonte: Deep Learning - Visual Approach
Questa semplice unità computazionale è il fondamento anche delle reti neurali più complesse. Ma come fa esattamente un neurone a trasformare i suoi input in un output? Qui entra in gioco la matematica.
Il funzionamento di un neurone può essere descritto con un’equazione semplice:
Scomponiamola:
Vediamo un esempio concreto con numeri reali. Supponiamo di avere un neurone con tre input:
Inputs: x = [2, 5, -1]
Weights: w = [0.5, -1, 2]
Bias: b = 0.5
Per prima cosa calcoliamo la somma pesata più bias:
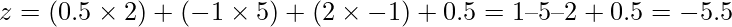
Poi applichiamo una funzione di attivazione. Usiamo la popolare funzione ReLU (Rectified Linear Unit), definita come:
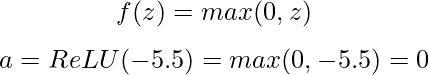
Con un valore di pre-attivazione negativo, il nostro neurone ReLU restituisce 0, il che significa che non “spara” per questo input specifico.
La funzione di attivazione è cruciale perché introduce non linearità nella rete. Senza di essa, le reti neurali sarebbero limitate ad apprendere solo relazioni lineari, indipendentemente dal numero di strati. Le funzioni di attivazione più comuni includono:
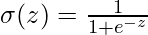 — Restituisce valori tra 0 e 1, utile per la classificazione binaria
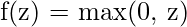 — Semplice, efficiente e aiuta con il problema del gradiente che svanisce
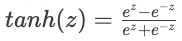 — Restituisce valori tra -1 e 1, spesso usata negli strati nascosti
Ogni funzione di attivazione ha punti di forza e casi d’uso, che esploreremo meglio quando implementeremo la nostra rete neurale.
I singoli neuroni sono potenti, ma la vera forza delle reti neurali emerge quando i neuroni vengono organizzati in strati. Uno strato è semplicemente un insieme di neuroni che elaborano gli input in parallelo. In genere, in una rete neurale ci sono tre tipi di strati:
Quando abbiamo più neuroni in uno strato, ciascuno che riceve gli stessi input ma con pesi e bias diversi, possiamo rappresentare il tutto in modo efficiente con operazioni tra matrici. Vediamo come funziona.
Immagina di avere uno strato con 3 valori di input e 4 neuroni. Ogni neurone ha il proprio set di pesi e bias:
Inputs: x = [x₁, x₂, x₃]
Weights for neuron 1: w₁ = [w₁₁, w₁₂, w₁₃]
Weights for neuron 2: w₂ = [w₂₁, w₂₂, w₂₃]
Weights for neuron 3: w₃ = [w₃₁, w₃₂, w₃₃]
Weights for neuron 4: w₄ = [w₄₁, w₄₂, w₄₃]
Biases: b = [b₁, b₂, b₃, b₄]
Possiamo organizzare questi pesi in una matrice W:
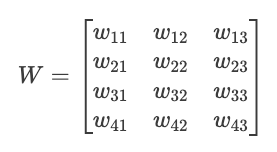
Ora possiamo calcolare tutte le pre-attivazioni dei neuroni in una volta con una singola moltiplicazione tra matrici:
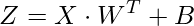
Dove:
Poi applichiamo la funzione di attivazione elemento per elemento per ottenere i nostri output finali:
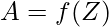
Questa rappresentazione matriciale non è solo eleganza matematica; è anche efficienza computazionale. L’hardware moderno (soprattutto le GPU) è ottimizzato per le operazioni tra matrici, rendendo questo approccio molto più veloce del calcolo dell’output di ogni neurone singolarmente.
La capacità di impilare questi strati — con l’output di uno strato che diventa l’input del successivo — è ciò che conferisce alle reti neurali la straordinaria capacità di apprendere pattern complessi. Collegando questi mattoni, siamo pronti a esplorare come funziona la propagazione in avanti in un’intera rete neurale.
Ora che comprendiamo neuroni e strati, facciamo un passo indietro e vediamo come la propagazione in avanti funziona attraverso un’intera rete neurale. È qui che emerge la vera potenza del deep learning.
Una rete neurale completa consiste in uno strato di input, uno o più strati nascosti e uno strato di output. Il termine “deep” in deep learning si riferisce a reti con molteplici strati nascosti. Ogni strato trasforma i dati in modi via via più astratti, permettendo alla rete di apprendere rappresentazioni complesse.
Consideriamo una semplice rete neurale con:
Visivamente, questa rete appare così:
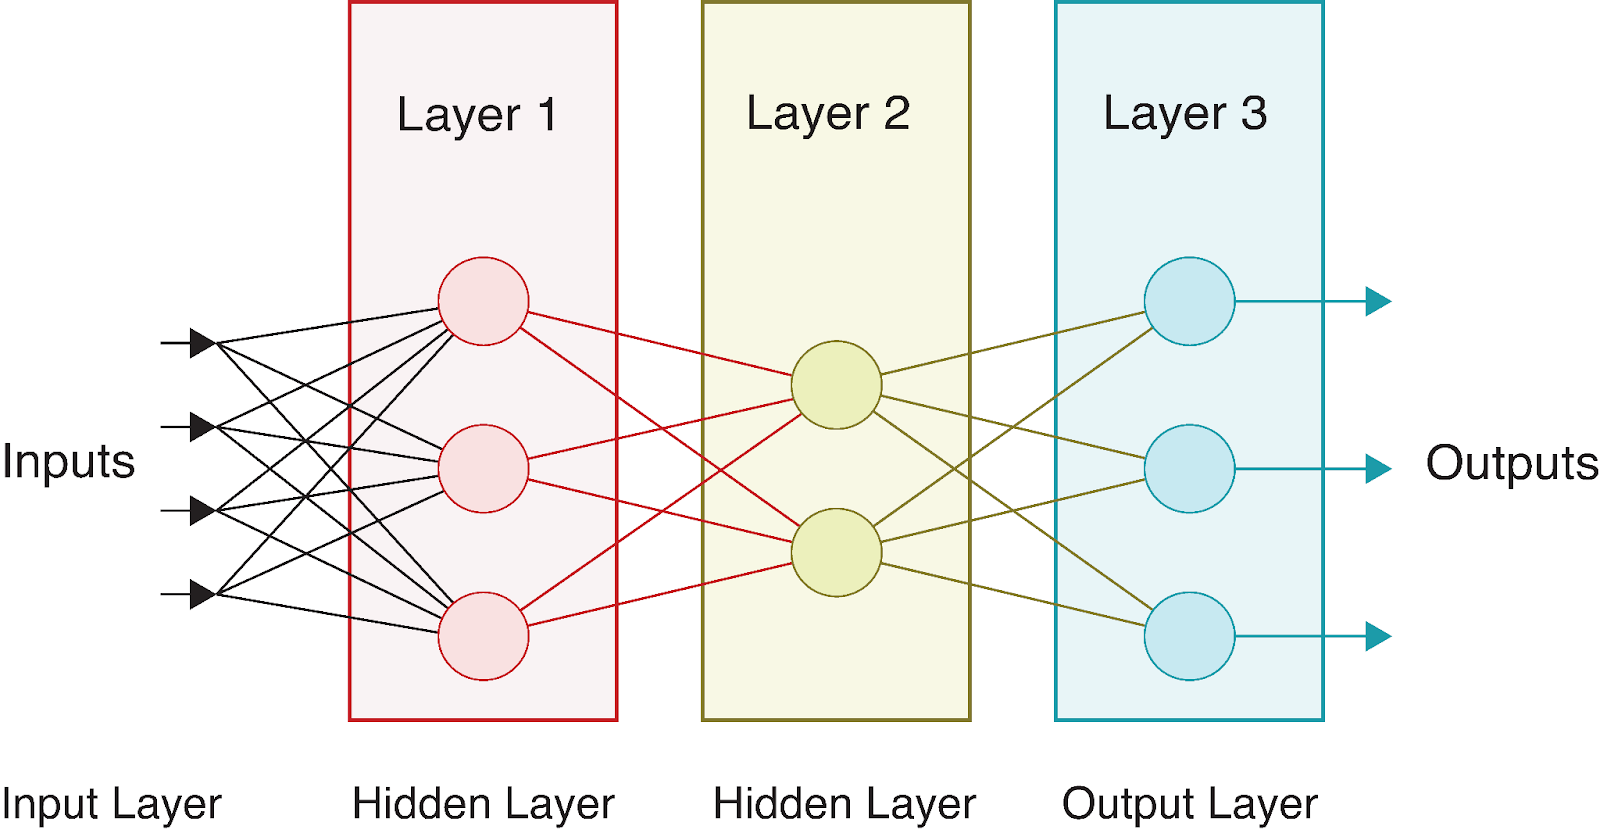
Mentre i dati scorrono attraverso questa rete, eseguiamo una serie di calcoli a ciascuno strato. Se indichiamo:
 (per lo strato nascosto) e
 (per lo strato di output)
 e

Possiamo esprimere la propagazione in avanti attraverso l’intera rete come:
1. Calcola le pre-attivazioni dello strato nascosto:
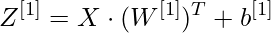
2. Applica la funzione di attivazione per ottenere gli output dello strato nascosto:
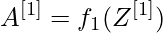
3. Calcola le pre-attivazioni dello strato di output:
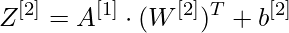
4. Applica la funzione di attivazione per ottenere gli output finali:
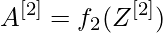
L’output finale A^[2] rappresenta la previsione della rete. Per problemi di classificazione, potrebbe essere una probabilità per ciascuna classe; per la regressione, i valori previsti.
Strati diversi usano spesso funzioni di attivazione differenti. Per esempio, gli strati nascosti usano comunemente ReLU, mentre gli strati di output possono usare:
La bellezza di questa struttura multilayer è che ogni strato può imparare a rappresentare aspetti diversi dei dati. Gli strati iniziali tipicamente rilevano caratteristiche semplici, mentre quelli più profondi combinano queste caratteristiche in pattern più complessi. Questo apprendimento gerarchico rende le reti neurali così potenti per compiti complessi come il riconoscimento di immagini e voce.
Formalizziamo il processo di propagazione in avanti in un algoritmo. Per una rete neurale con L strati, la propagazione in avanti segue questi passi:
# Pseudocode for forward propagation
def forward_propagation(X, parameters):
   """
   X: Input data (batch_size, n_features)
   parameters: Dictionary containing weights and biases for each layer
   Returns: The final output and all intermediate activations
   """
   # Store all activations for later use (e.g., in backpropagation)
   activations = {'A0': X}  # A0 is the input

   # Loop through L-1 layers (excluding the output layer)
   for l in range(1, L):
       # Get previous activation
       A_prev = activations[f'A{l-1}']

       # Get weights and biases for current layer
       W = parameters[f'W{l}']
       b = parameters[f'b{l}']

       # Compute pre-activation
       Z = np.dot(A_prev, W.T) + b

       # Apply activation function (e.g., ReLU for hidden layers)
       A = relu(Z)

       # Store values for later use
       activations[f'Z{l}'] = Z
       activations[f'A{l}'] = A

   # Compute output layer (layer L)
   A_prev = activations[f'A{L-1}']
   W = parameters[f'W{L}']
   b = parameters[f'b{L}']

   # Compute pre-activation for output layer
   Z = np.dot(A_prev, W.T) + b

   # Apply output activation function (depends on the task)
   if task == 'binary_classification':
       A = sigmoid(Z)
   elif task == 'multiclass_classification':
       A = softmax(Z)
   elif task == 'regression':
       A = Z  # Linear activation

   # Store output layer values
   activations[f'Z{L}'] = Z
   activations[f'A{L}'] = A

   return A, activations
Questo algoritmo mette in evidenza diversi aspetti importanti della propagazione in avanti:
L’algoritmo di propagazione in avanti è sorprendentemente semplice, eppure consente alle reti neurali di approssimare funzioni incredibilmente complesse. Quando viene combinato con un corretto addestramento tramite backpropagation, questo semplice processo permette alla rete di apprendere dai dati e fare previsioni sempre più accurate.
Percorriamo un esempio specifico per consolidare ulteriormente la comprensione. Considera l’input X = [0.5, -0.2, 0.1] che attraversa la nostra rete di esempio con:
Per semplicità, supponiamo che tutti i pesi siano 0,1 e tutti i bias siano 0:
X = [0.5, -0.2, 0.1]
W[1] = [[0.1, 0.1, 0.1], [0.1, 0.1, 0.1], [0.1, 0.1, 0.1], [0.1, 0.1, 0.1]]
b[1] = [0, 0, 0, 0]
W[2] = [[0.1, 0.1, 0.1, 0.1], [0.1, 0.1, 0.1, 0.1]]
b[2] = [0, 0]
Seguendo il nostro algoritmo:
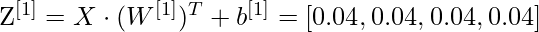
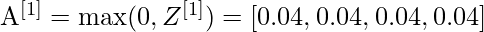
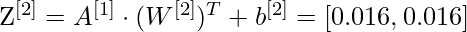
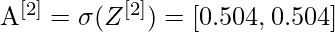
Questo ci dà la previsione finale. In un contesto di classificazione binaria, valori vicini a 0,5 indicherebbero incertezza tra le due classi.
Nella prossima sezione, implementeremo la propagazione in avanti in Python per vedere questi calcoli in azione.
Ora che comprendiamo la teoria dietro la propagazione in avanti, passiamo alla pratica implementandola in Python. Inizieremo con un’implementazione “da zero” usando solo NumPy, poi vedremo come i framework moderni semplificano il processo.
NumPy offre operazioni su array efficienti che ci permettono di implementare i calcoli tra matrici discussi. Costruiamo una semplice classe di rete neurale che effettua la propagazione in avanti attraverso più strati.
Per prima cosa, importiamo le librerie necessarie:
import numpy as np
import matplotlib.pyplot as plt

# For reproducibility
np.random.seed(42)
Ora, definiamo le funzioni di attivazione che useremo nella rete:
def relu(Z):
   """ReLU activation function: max(0, Z)"""
   return np.maximum(0, Z)

def sigmoid(Z):
   """Sigmoid activation function: 1/(1 + e^(-Z))"""
   return 1 / (1 + np.exp(-Z))

def softmax(Z):
   """Softmax activation function for multi-class classification"""
   # Subtract max for numerical stability (prevents overflow)
   exp_Z = np.exp(Z - np.max(Z, axis=1, keepdims=True))
   return exp_Z / np.sum(exp_Z, axis=1, keepdims=True)
Successivamente, creiamo una classe per la nostra rete neurale:
class NeuralNetwork:
   def __init__(self, layer_dims, activations):
       """
       Initialize a neural network with specified layer dimensions and activations

       Parameters:
       - layer_dims: List of integers representing the number of neurons in each layer
                    (including input and output layers)
       - activations: List of activation functions for each layer (excluding input layer)
       """
       self.L = len(layer_dims) - 1  # Number of layers (excluding input layer)
       self.layer_dims = layer_dims
       self.activations = activations
       self.parameters = {}

       # Initialize parameters (weights and biases)
       self.initialize_parameters()

   def initialize_parameters(self):
       """Initialize weights and biases with small random values"""
       for l in range(1, self.L + 1):
           # He initialization for weights - helps with training deep networks
           self.parameters[f'W{l}'] = np.random.randn(self.layer_dims[l], self.layer_dims[l-1]) * np.sqrt(2 / self.layer_dims[l-1])
           self.parameters[f'b{l}'] = np.zeros((self.layer_dims[l], 1))

   def forward_propagation(self, X):
       """
       Perform forward propagation through the network

       Parameters:
       - X: Input data (n_features, batch_size)

       Returns:
       - AL: Output of the network
       - caches: Dictionary containing all activations and pre-activations
       """
       caches = {}
       A = X  # Input layer activation
       caches['A0'] = X

       # Process through L-1 layers (excluding output layer)
       for l in range(1, self.L):
           A_prev = A

           # Get weights and biases for current layer
           W = self.parameters[f'W{l}']
           b = self.parameters[f'b{l}']

           # Forward propagation for current layer
           Z = np.dot(W, A_prev) + b

           # Apply activation function
           activation_function = self.activations[l-1]
           if activation_function == "relu":
               A = relu(Z)
           elif activation_function == "sigmoid":
               A = sigmoid(Z)

           # Store values for backpropagation
           caches[f'Z{l}'] = Z
           caches[f'A{l}'] = A

       # Output layer
       W = self.parameters[f'W{self.L}']
       b = self.parameters[f'b{self.L}']
       Z = np.dot(W, A) + b

       # Apply output activation function
       activation_function = self.activations[self.L-1]
       if activation_function == "sigmoid":
           AL = sigmoid(Z)
       elif activation_function == "softmax":
           AL = softmax(Z)
       elif activation_function == "linear":
           AL = Z  # No activation for regression

       # Store output layer values
       caches[f'Z{self.L}'] = Z
       caches[f'A{self.L}'] = AL

       return AL, caches
La classe NeuralNetwork che abbiamo implementato sopra fornisce un framework completo per creare e usare una rete neurale con architettura personalizzabile. Vediamone i componenti chiave:
forward_propagation che abbiamo appena implementato è il cuore della capacità di previsione della rete. Esso:3. Funzioni di attivazione: la rete supporta più funzioni di attivazione, tra cui ReLU, sigmoid e softmax, consentendole di gestire diversi tipi di problemi (regressione o classificazione).
4. Architettura flessibile: l’implementazione permette reti di qualunque profondità e ampiezza, rendendola adatta a un’ampia gamma di task di machine learning.
Questa implementazione segue il pattern standard delle reti neurali, in cui i dati scorrono in avanti attraverso la rete, con ogni strato che trasforma i dati prima di passarli al successivo.
Ora testiamo la nostra implementazione con una piccola rete di esempio:
# Create a sample network
# Input layer: 3 features
# Hidden layer 1: 4 neurons with ReLU activation
# Output layer: 2 neurons with sigmoid activation (binary classification)
layer_dims = [3, 4, 2]
activations = ["relu", "sigmoid"]
nn = NeuralNetwork(layer_dims, activations)

# Create sample input data - 3 features for 5 examples
X = np.random.randn(3, 5)

# Perform forward propagation
output, caches = nn.forward_propagation(X)

print(f"Input shape: {X.shape}")
print(f"Output shape: {output.shape}")
print(f"Output values:\n{output}")Output:
Input shape: (3, 5)
Output shape: (2, 5)
Output values:
[[0.00386784 0.54343014 0.39661893 0.5        0.51056934]
[0.11877049 0.32541093 0.44840699 0.5        0.45586633]]
Visualizziamo anche come i dati si trasformano mentre scorrono nella rete:
def visualize_activations(caches, example_idx=0):
   """Visualize the activations for a single example through the network"""
   plt.figure(figsize=(15, 6))

   # Plot input
   plt.subplot(1, 3, 1)
   plt.bar(range(caches['A0'].shape[0]), caches['A0'][:, example_idx])
   plt.title('Input Layer')
   plt.xlabel('Feature')
   plt.ylabel('Value')

   # Plot hidden layer activation
   plt.subplot(1, 3, 2)
   plt.bar(range(caches['A1'].shape[0]), caches['A1'][:, example_idx])
   plt.title('Hidden Layer (ReLU Activation)')
   plt.xlabel('Neuron')
   plt.ylabel('Activation')

   # Plot output layer
   plt.subplot(1, 3, 3)
   plt.bar(range(caches['A2'].shape[0]), caches['A2'][:, example_idx])
   plt.title('Output Layer (Sigmoid Activation)')
   plt.xlabel('Neuron')
   plt.ylabel('Activation')

   plt.tight_layout()
   plt.show()

# Visualize the first example
visualize_activations(caches)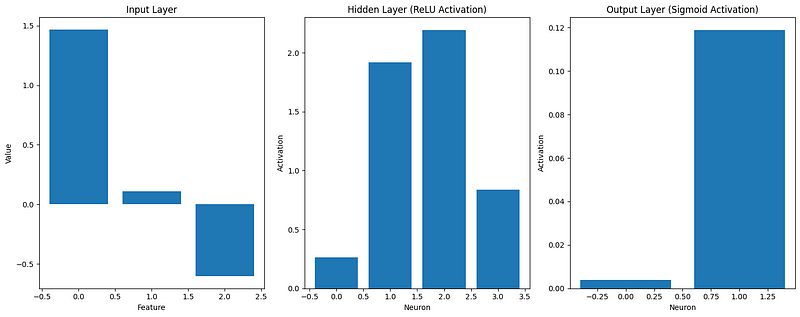
Questa visualizzazione aiuta a capire come i dati di input si trasformano mentre si propagano nella rete. Possiamo osservare che:
La nostra implementazione “da zero” mostra i principi fondamentali della propagazione in avanti, ma i framework di deep learning moderni offrono strumenti più efficienti e flessibili per costruire reti neurali.
Ora implementiamo la stessa rete neurale usando framework popolari: TensorFlow e PyTorch. Questi framework ottimizzano le prestazioni e forniscono astrazioni di alto livello, rendendo più semplice costruire modelli complessi.
Per prima cosa, vediamo l’implementazione con TensorFlow/Keras:
import tensorflow as tf
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, Input

# For reproducibility
tf.random.set_seed(42)

# Create the same network architecture
tf_model = Sequential([
   Input(shape=(3,)),  # Input layer with 3 features
   Dense(4, activation='relu'),  # Hidden layer with 4 neurons
   Dense(2, activation='sigmoid')  # Output layer with 2 neurons
])

tf_model.summary()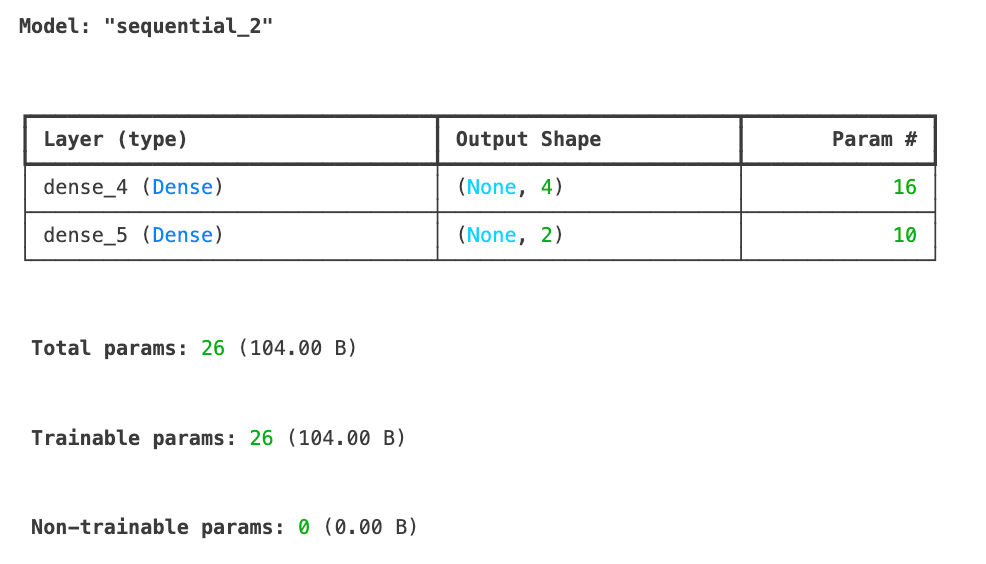
# Sample input data with the shape expected by Keras
X_tf = np.random.randn(5, 3)  # 5 examples, 3 features

# Forward propagation in TensorFlow
tf_output = tf_model.predict(X_tf)

print(f"TensorFlow output shape: {tf_output.shape}")
print(f"TensorFlow output values:\n{tf_output}")
TensorFlow output shape: (5, 2)
TensorFlow output values:
[[0.6855308 0.7139542 ]
[0.4952355 0.5231934 ]
[0.50174904 0.5198488 ]
[0.44331825 0.6860926 ]
[0.6624589 0.5385444 ]]Abbiamo appena implementato la nostra rete neurale usando TensorFlow/Keras ed eseguito con successo la propagazione in avanti su alcuni dati di esempio. Il riepilogo del modello mostra la nostra architettura: uno strato di input che accetta 3 feature, uno strato nascosto con 4 neuroni e attivazione ReLU e uno strato di output con 2 neuroni e attivazione sigmoid. In totale, il modello ha 26 parametri addestrabili.
I risultati della propagazione in avanti mostrano la forma dell’output (5, 2) corrispondente ai nostri 5 esempi in input, ognuno dei quali produce 2 valori in output. Questi output sono compresi tra 0 e 1 grazie alla funzione sigmoid nello strato di output.
Ora vediamo come possiamo implementare la stessa architettura con PyTorch, un altro popolare framework di deep learning, per confrontare gli approcci.
import torch
import torch.nn as nn

# For reproducibility
torch.manual_seed(42)

# Create a network in PyTorch
class PyTorchNN(nn.Module):
   def __init__(self):
       super(PyTorchNN, self).__init__()
       self.hidden = nn.Linear(3, 4)  # 3 inputs, 4 hidden neurons
       self.relu = nn.ReLU()
       self.output = nn.Linear(4, 2)  # 4 inputs from hidden, 2 outputs
       self.sigmoid = nn.Sigmoid()

   def forward(self, x):
       x = self.relu(self.hidden(x))
       x = self.sigmoid(self.output(x))
       return x

# Instantiate the model
torch_model = PyTorchNN()

# Print model structure
print(torch_model)Output:
PyTorchNN(
 (hidden): Linear(in_features=3, out_features=4, bias=True)
 (relu): ReLU()
 (output): Linear(in_features=4, out_features=2, bias=True)
 (sigmoid): Sigmoid()
)

```python
# Sample input data
X_torch = torch.randn(5, 3)  # 5 examples, 3 features

# Forward propagation in PyTorch
torch_output = torch_model(X_torch)

print(f"PyTorch output shape: {torch_output.shape}")
print(f"PyTorch output values:\n{torch_output}")Output:
PyTorch output shape: torch.Size([5, 2])
PyTorch output values:
tensor([[0.4516, 0.4116],
       [0.4289, 0.4267],
       [0.4278, 0.4172],
       [0.3771, 0.4321],
       [0.5769, 0.3328]], grad_fn=<SigmoidBackward0>)
Confrontiamo le nostre implementazioni:
# Compare dimensions and structure of outputs
print("\nComparison of implementations:")
print(f"NumPy output shape: {output.shape}")
print(f"TensorFlow output shape: {tf_output.shape}")
print(f"PyTorch output shape: {torch_output.shape}")Output:
Comparison of implementations:
NumPy output shape: (2, 5)
TensorFlow output shape: (5, 2)
PyTorch output shape: torch.Size([5, 2])
Le principali differenze tra le nostre implementazioni:
Per reti semplici, la nostra implementazione in NumPy va bene, ma con l’aumentare della complessità i framework di deep learning diventano essenziali. Gestiscono ottimizzazioni di basso livello e offrono strumenti per l’intero workflow di machine learning, dallo sviluppo al deployment. Per saperne di più su questi framework, consulta le nostre guide dedicate:
Nella prossima sezione, costruiremo un esempio completo che applica la propagazione in avanti a un problema reale.
Ora che abbiamo implementato la propagazione in avanti sia da zero che usando framework popolari, vediamola in azione su un problema reale. Costruiremo un esempio completo ed esploreremo come ottimizzare il processo per migliori prestazioni.
Applichiamo la nostra comprensione a un classico problema di machine learning: il riconoscimento di cifre scritte a mano con il dataset MNIST. Questo dataset contiene 70.000 immagini di cifre (0–9), ciascuna di 28x28 pixel.
Per prima cosa, carichiamo e prepariamo i dati:
from tensorflow.keras.datasets import mnist
import numpy as np
import matplotlib.pyplot as plt

# Load MNIST dataset
(X_train, y_train), (X_test, y_test) = mnist.load_data()

# Normalize pixel values to range [0, 1]
X_train = X_train / 255.0
X_test = X_test / 255.0

# Reshape images to vectors (flatten 28x28 to 784)
X_train_flat = X_train.reshape(X_train.shape[0], -1).T  # Shape: (784, 60000)
X_test_flat = X_test.reshape(X_test.shape[0], -1).T     # Shape: (784, 10000)

# Convert labels to one-hot encoding
def one_hot_encode(y, num_classes=10):
   one_hot = np.zeros((num_classes, y.size))
   one_hot[y, np.arange(y.size)] = 1
   return one_hot

y_train_one_hot = one_hot_encode(y_train)  # Shape: (10, 60000)
y_test_one_hot = one_hot_encode(y_test)    # Shape: (10, 10000)

# Display sample images
plt.figure(figsize=(10, 5))
for i in range(5):
   plt.subplot(1, 5, i+1)
   plt.imshow(X_train[i], cmap='gray')
   plt.title(f"Label: {y_train[i]}")
   plt.axis('off')
plt.tight_layout()
plt.show()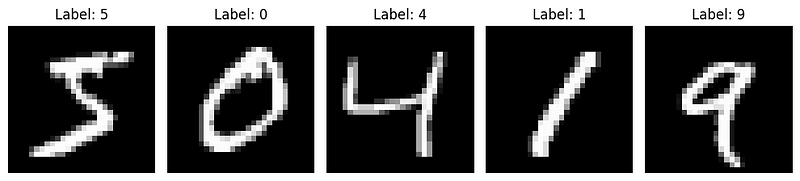
Ora costruiamo una rete neurale per questo task usando la nostra implementazione NumPy. Creeremo una rete con:
# Define our network architecture
layer_dims = [784, 128, 10]
activations = ["relu", "softmax"]
nn = NeuralNetwork(layer_dims, activations)

# Take a small batch for demonstration
batch_size = 64
batch_indices = np.random.choice(X_train_flat.shape[1], batch_size, replace=False)
X_batch = X_train_flat[:, batch_indices]
y_batch = y_train_one_hot[:, batch_indices]

# Perform forward propagation
output, caches = nn.forward_propagation(X_batch)

# Compute accuracy
predictions = np.argmax(output, axis=0)
true_labels = np.argmax(y_batch, axis=0)
accuracy = np.mean(predictions == true_labels)

print(f"Batch accuracy: {accuracy:.4f}")

Out: Batch accuracy: 0.0781
Abbiamo ottenuto un’accuratezza del 7%, peggiore persino di un modello che indovina a caso. Ma è previsto, dato che stiamo eseguendo solo la propagazione in avanti — non c’è alcun apprendimento.
Ora, visualizziamo come la rete elabora una singola immagine attraverso ciascuno strato:
def visualize_network_processing(nn, image, label, caches):
   """Visualize network processing for a single image"""
   plt.figure(figsize=(15, 10))

   # Plot original image
   plt.subplot(2, 3, 1)
   plt.imshow(image.reshape(28, 28), cmap='gray')
   plt.title(f"Input Image (Digit: {label})")
   plt.axis('off')

   # Plot flattened input (first 100 values)
   plt.subplot(2, 3, 2)
   plt.bar(range(100), image.flatten()[:100])
   plt.title("Input Layer (first 100 pixels)")
   plt.xlabel("Pixel Index")
   plt.ylabel("Pixel Value")

   # Plot hidden layer activations (first 50 neurons)
   plt.subplot(2, 3, 3)
   hidden_activations = caches['A1'][:50, 0]
   plt.bar(range(len(hidden_activations)), hidden_activations)
   plt.title("Hidden Layer Activations (first 50 neurons)")
   plt.xlabel("Neuron Index")
   plt.ylabel("Activation")

   # Plot output layer activations
   plt.subplot(2, 3, 4)
   output_activations = caches['A2'][:, 0]
   plt.bar(range(10), output_activations)
   plt.xticks(range(10))
   plt.title("Output Layer Activations (Softmax)")
   plt.xlabel("Digit Class")
   plt.ylabel("Probability")

   # Plot prediction vs actual
   plt.subplot(2, 3, 5)
   prediction = np.argmax(output_activations)
   plt.bar(['Actual', 'Predicted'], [label, prediction], color=['blue', 'orange'])
   plt.title(f"Prediction: {prediction}, Actual: {label}")
   plt.ylabel("Digit")

   plt.tight_layout()
   plt.show()

# Visualize forward propagation for the first image in our batch
image_idx = 0
image = X_batch[:, image_idx].reshape(784, 1)
label = true_labels[image_idx]

visualize_network_processing(nn, image, label, caches)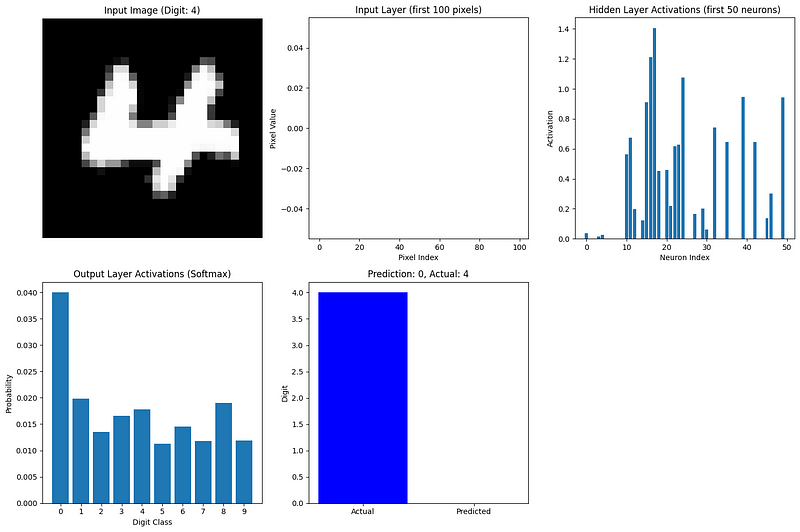
Questa visualizzazione mostra come l’informazione fluisce nella nostra rete:
Il neurone di output più attivo corrisponde alla previsione della rete. Anche con pesi casuali (poiché non abbiamo ancora addestrato la rete), possiamo vedere come la propagazione in avanti trasformi i dati di input in una previsione.
Per un esempio più completo, alleneremmo questa rete usando la backpropagation per adattare pesi e bias, migliorando le previsioni nel tempo. Tuttavia, anche senza addestramento, questo esempio mostra il processo di propagazione in avanti su dati reali.
Quando le reti neurali diventano più grandi e i dataset più estesi, ottimizzare la propagazione in avanti diventa cruciale. Ecco le strategie chiave per renderla più efficiente:
Invece di elaborare un esempio alla volta, eseguiamo la propagazione in avanti su batch di esempi simultaneamente. Questo sfrutta le capacità di elaborazione parallela dell’hardware moderno.
Usare operazioni tra matrici al posto dei loop velocizza enormemente i calcoli. Ecco perché la nostra implementazione usa le operazioni su array di NumPy.
Per reti di grandi dimensioni, bisogna fare attenzione all’uso della memoria. Tecniche utili includono:
Le GPU eccellono nelle operazioni tra matrici. I framework moderni possono spostare senza soluzione di continuità i calcoli sulle GPU per notevoli speedup:
# TensorFlow example of GPU acceleration
import tensorflow as tf

# Check for available GPUs
print("GPUs Available:", tf.config.list_physical_devices('GPU'))

# TensorFlow automatically uses available GPUs
with tf.device('/GPU:0'):  # Explicitly specify GPU if multiple are available
   # Computation runs on GPU if available
result = tf_model.predict(X_tf)Oltre alle GPU, hardware come le TPU (Tensor Processing Unit) di Google sono progettati specificamente per le operazioni delle reti neurali.
Alcune funzioni di attivazione e architetture di rete sono progettate per l’efficienza computazionale:
I framework di deep learning implementano numerose ottimizzazioni di basso livello:
Man mano che le reti diventano più profonde e ampie, l’ottimizzazione della propagazione in avanti diventa sempre più importante. Architetture moderne come ResNet, Transformer ed EfficientNet incorporano scelte progettuali specifiche per rendere la propagazione in avanti più efficiente mantenendo o migliorando l’accuratezza del modello.
Nella prossima sezione, vedremo come la propagazione in avanti si collega alla propagazione all’indietro (backpropagation), completando il quadro di come le reti neurali apprendono.
Abbiamo esplorato a fondo la propagazione in avanti, ma questa è solo metà della storia quando si parla di reti neurali. Esaminiamo brevemente come la propagazione in avanti si colleghi alla backpropagation, l’algoritmo che consente alle reti neurali di imparare.
Propagazione in avanti e backpropagation funzionano come processi complementari nelle reti neurali:
Questi due processi sono inseparabili nel processo di apprendimento. La backpropagation non può avvenire senza eseguire prima la propagazione in avanti, perché ha bisogno di:
Pensa alla propagazione in avanti come alla rete neurale che fa la sua migliore ipotesi, dato ciò che sa al momento, mentre la backpropagation è il modo in cui affina quella comprensione a partire dagli errori commessi.
L’intero processo di apprendimento segue uno schema ciclico:
Ciò che rende questo processo potente è che la propagazione in avanti fornisce il contesto necessario alla backpropagation. Durante la propagazione in avanti, la rete non solo produce previsioni ma tiene traccia di tutti i valori e le decisioni intermedie. La backpropagation usa poi queste informazioni per fare aggiustamenti mirati.
La bellezza di questo sistema è che un apprendimento complesso emerge da due processi relativamente semplici che lavorano insieme. La propagazione in avanti è lineare da seguire — sono solo moltiplicazioni tra matrici e funzioni di attivazione applicate in sequenza. La backpropagation è più complessa ma deriva direttamente dai principi del calcolo differenziale.
Insieme, permettono alle reti neurali di apprendere praticamente qualsiasi pattern, con dati e risorse computazionali sufficienti. Questa capacità di apprendimento ha alimentato progressi nella visione artificiale, nell’elaborazione del linguaggio naturale, nel game playing e in innumerevoli altri ambiti.
Comprendere a fondo la propagazione in avanti, come abbiamo fatto in questo articolo, fornisce le basi per cogliere l’intero processo di apprendimento nelle reti neurali. Se vuoi approfondire l’aspetto dell’apprendimento, la nostra guida sulla backpropagation offre un’esplorazione dettagliata di come le reti imparano dai propri errori.
La propagazione in avanti è il processo fondamentale che consente alle reti neurali di trasformare gli input in previsioni. Come abbiamo visto, comporta moltiplicazioni tra matrici e funzioni di attivazione sequenziali che trasformano progressivamente i dati attraverso gli strati della rete. Comprendere questo processo è cruciale sia che tu stia implementando reti da zero, usando framework moderni o risolvendo problemi di prestazioni del modello.
Padroneggiando la propagazione in avanti, hai compiuto un passo importante verso la costruzione e la comprensione di modelli di deep learning in grado di affrontare problemi complessi in vari domini.
Per proseguire il tuo percorso nel deep learning, esplora le risorse complete di DataCamp:
Per un percorso di apprendimento strutturato, il Deep Learning in Python track ti fornisce tutto ciò di cui hai bisogno per diventare competente nella costruzione e distribuzione di reti neurali per applicazioni reali.
I migliori corsi DataCamp
Corso
Programma
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



