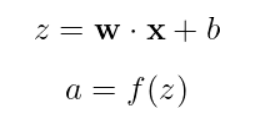

Kurs
Intermediate Deep Learning with PyTorch
4 sa
29.9K
Sinir ağları, görüntü tanımadan doğal dil işlemeye kadar pek çok alanda yapay zekayı dönüştürdü. Bu güçlü modellerin kalbinde, ileri yayılım (forward propagation) adı verilen temel bir süreç yer alır. Bu rehber, sizi temel ilkelerden pratik uygulamaya taşıyarak bu çekirdek kavramı ele alacaktır.
Burada ele aldığımız birçok kavrama yönelik uygulamalı bir rehber arıyorsanız, Python ile Derin Öğrenme beceri yolumuza mutlaka göz atın.
İleri yayılım, bir sinir ağının girdi verisini tahminlere veya çıktılara dönüştürdüğü süreçtir. Bunu, bir sinir ağının “düşünme” aşaması olarak düşünebilirsiniz — bir girdiyi (örneğin bir görüntü veya metin) gördüğünde, ağın bu bilgiyi katmanları boyunca işleyerek bir sonuç üretmesi ileri yayılımla olur.
Teknik olarak, veriyi girdi katmanından gizli katmanlara ve nihayetinde çıktı katmanına taşıyan sıralı bir hesaplamadır. Bu yolculuk sırasında veri, ağırlıklı bağlantılar ve aktivasyon fonksiyonlarıyla dönüştürülür; bu sayede ağ karmaşık örüntüleri yakalayabilir.
İleri yayılımı anlamak birkaç nedenle kritik öneme sahiptir:
Bu kapsamlı rehberin sonunda:
Bu rehberden en iyi şekilde yararlanmak için şunlara sahip olmalısınız:
Temelinizi güçlendirmek isterseniz şu kaynakları değerlendirin:
Kapsamlı bir geçmişe sahip olmasanız bile, bu rehberi kavramları kademeli olarak inşa edecek şekilde tasarladık; kararlı öğrenenler için sinir ağlarını ulaşılabilir kılıyoruz. Haydi başlayalım!
İleri yayılımı anlamak için temel yapı taşlarından başlamak gerekir. Sinir ağlarındaki en küçük hesaplama biriminden başlayıp kademeli olarak daha karmaşık yapılara ilerleyelim.
Sinir ağlarının yolculuğu, biyolojiyle dikkat çekici bir paralellik kurar. İnsan beyni milyarlarca bağlantılı nörondan oluşur; yapay sinir ağları da bu biyolojik hücrelerden esinlenen matematiksel modellerden inşa edilir.
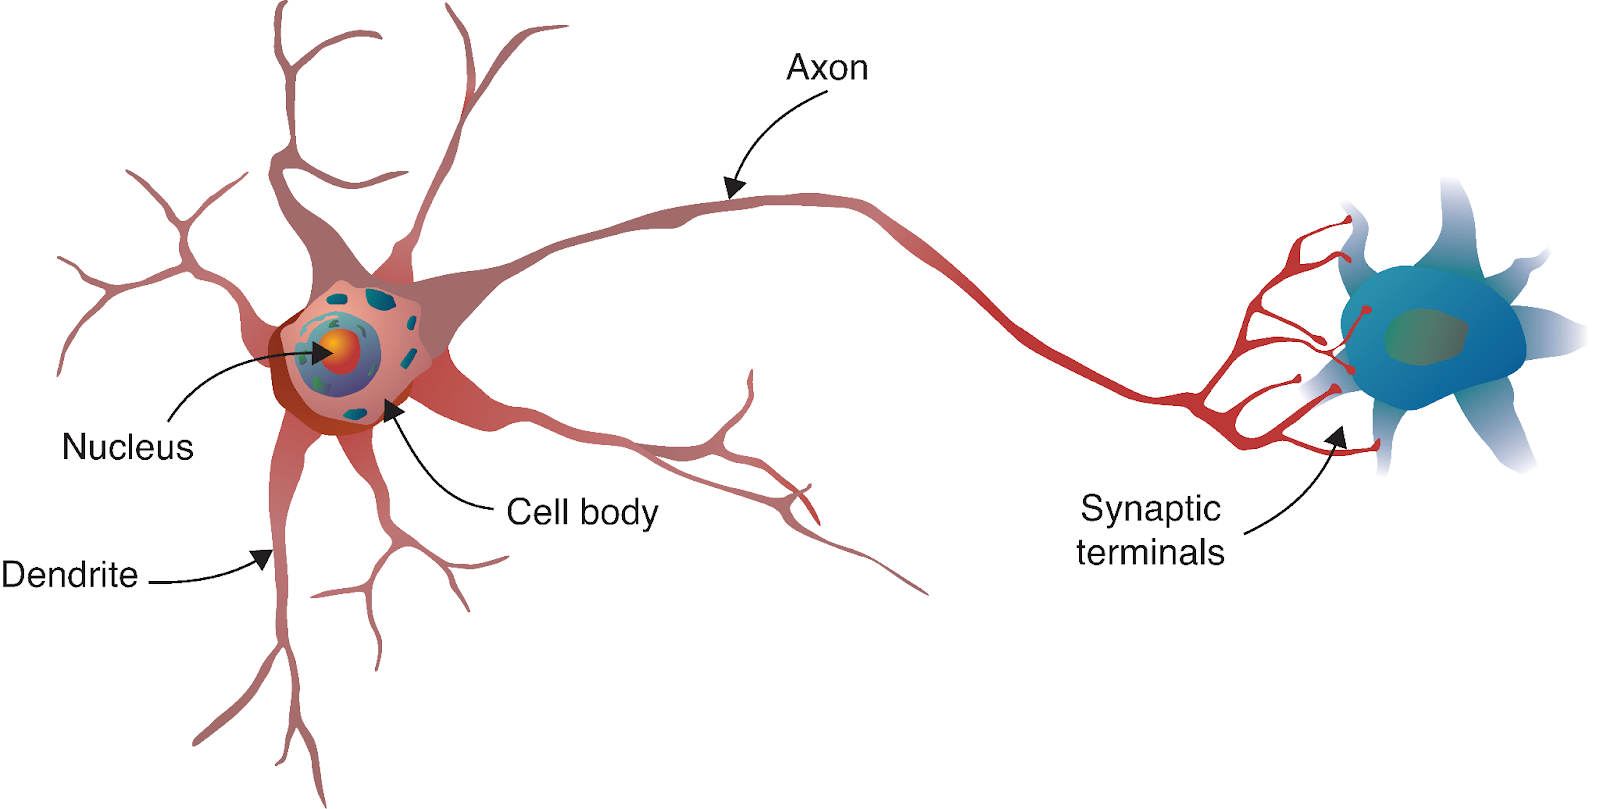
Kaynak: Deep Learning - Visual Approach
Biyolojik bir nöron, dendritler aracılığıyla diğer nöronlardan sinyaller alır, bu sinyalleri gövdesinde işler ve sonucu aksonu üzerinden diğer nöronlara iletir. Hesaplamalı modelimizde bu süreci şu bileşenlerle yansıtırız:
Bunu somutlaştırmak için tek bir nöronu görselleştirelim:
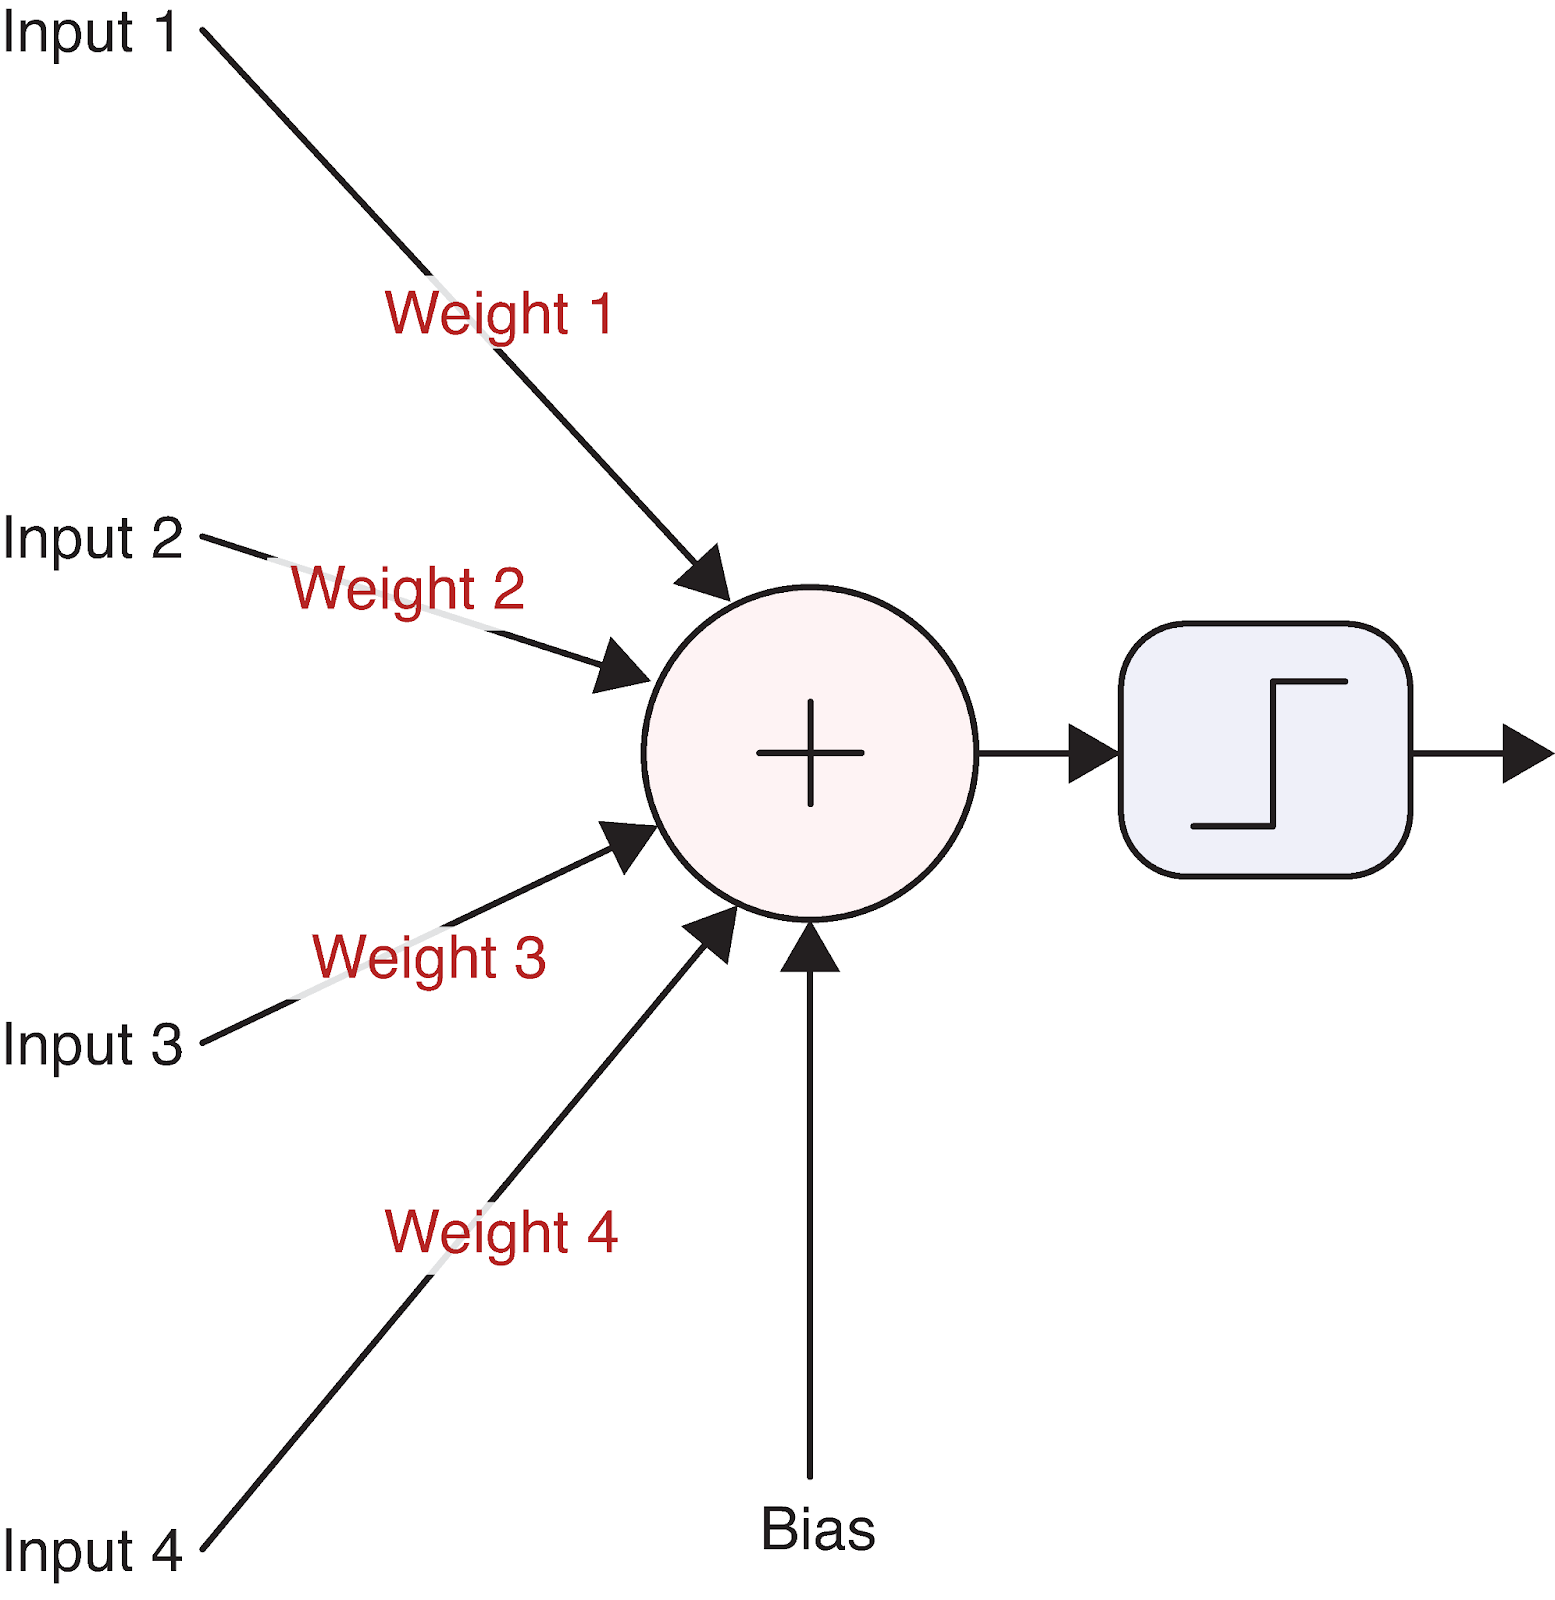
Kaynak: Deep Learning - Visual Approach
Bu basit hesaplama birimi, en karmaşık sinir ağlarının bile temelini oluşturur. Peki bir nöron girdilerini çıktıya tam olarak nasıl dönüştürür? İşte burada matematik devreye girer.
Bir nöronun işleyişi basit bir denklemle tanımlanabilir:
Bunu açalım:
Gerçek sayılarla somut bir örnek üzerinden ilerleyelim. Üç girdili bir nöronumuz olduğunu varsayalım:
Inputs: x = [2, 5, -1]
Weights: w = [0.5, -1, 2]
Bias: b = 0.5
Önce, ağırlıklı toplam artı bias’ı hesaplarız:
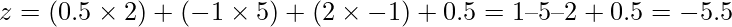
Sonra bir aktivasyon fonksiyonu uygularız. Popüler ReLU (Düzeltilmiş Doğrusal Birim) fonksiyonunu kullanalım; tanımı şöyledir:
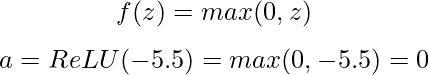
Negatif bir ön-aktivasyon değeriyle, ReLU nöronumuz 0 üretir; yani bu belirli girdi için “ateşlemez”.
Aktivasyon fonksiyonu kritiktir çünkü ağa doğrusal olmayanlık katar. O olmadan, kaç katman olursa olsun sinir ağları sadece doğrusal ilişkileri öğrenebilirdi. Yaygın aktivasyon fonksiyonları şunlardır:
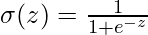 — 0 ile 1 arasında çıktı verir, ikili sınıflandırma için kullanışlıdır
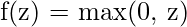 — Basit, verimli ve sönümlenen gradyan sorununa yardımcı olur
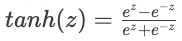 — -1 ile 1 arasında çıktı verir, sıklıkla gizli katmanlarda kullanılır
Her aktivasyon fonksiyonunun güçlü yönleri ve kullanım alanları vardır; sinir ağımızı uygularken bunları daha fazla inceleyeceğiz.
Tekil nöronlar güçlüdür, ancak sinir ağlarının gerçek gücü nöronlar katmanlar halinde düzenlendiğinde ortaya çıkar. Katman, girdileri paralel olarak işleyen nöronlar bütünüdür. Bir sinir ağında tipik olarak üç tür katman bulunur:
Bir katmanda birden fazla nöron olduğunda, her biri aynı girdileri alıp farklı ağırlık ve bias’larla çalıştığında, bunu matris işlemleriyle verimli biçimde temsil edebiliriz. Nasıl işlediğine bakalım.
3 girdi değeri ve 4 nöronlu bir katmana sahip olduğumuzu düşünün. Her nöronun kendi ağırlık ve bias seti vardır:
Inputs: x = [x₁, x₂, x₃]
Weights for neuron 1: w₁ = [w₁₁, w₁₂, w₁₃]
Weights for neuron 2: w₂ = [w₂₁, w₂₂, w₂₃]
Weights for neuron 3: w₃ = [w₃₁, w₃₂, w₃₃]
Weights for neuron 4: w₄ = [w₄₁, w₄₂, w₄₃]
Biases: b = [b₁, b₂, b₃, b₄]
Bu ağırlıkları bir W matrisinde düzenleyebiliriz:
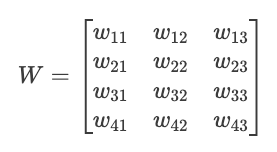
Artık tüm nöronların ön-aktivasyonlarını tek bir matris çarpımıyla aynı anda hesaplayabiliriz:
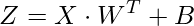
Burada:
Ardından eleman bazında aktivasyon fonksiyonunu uygulayıp nihai çıktıları elde ederiz:
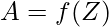
Bu matris temsili yalnızca matematiksel bir zarafet değildir; aynı zamanda hesaplama açısından da verimlidir. Modern donanımlar (özellikle GPU’lar) matris işlemleri için optimize edilmiştir; bu yaklaşım, her nöronun çıktısını tek tek hesaplamaktan çok daha hızlıdır.
Bu katmanları üst üste koyma yeteneği — bir katmanın çıktısının bir sonrakinin girdisi olması — sinir ağlarına karmaşık örüntüleri öğrenme gücünü verir. Bu yapı taşlarını birbirine bağladıkça, ileri yayılımın tüm bir sinir ağı boyunca nasıl çalıştığını keşfetmeye hazırız.
Artık tekil nöronları ve katmanları anladığımıza göre, ileri yayılımın tüm bir sinir ağı boyunca nasıl çalıştığına bakalım. Derin öğrenmenin gerçek gücü burada ortaya çıkar.
Tam bir sinir ağı; bir girdi katmanı, bir veya daha fazla gizli katman ve bir çıktı katmanından oluşur. Derin öğrenmedeki “derin” ifadesi, birden çok gizli katmana sahip ağları ifade eder. Her katman veriyi giderek daha soyut biçimlerde dönüştürür; bu sayede ağ, karmaşık temsilleri öğrenebilir.
Basit bir sinir ağı düşünelim:
Bu ağın görseli şöyledir:
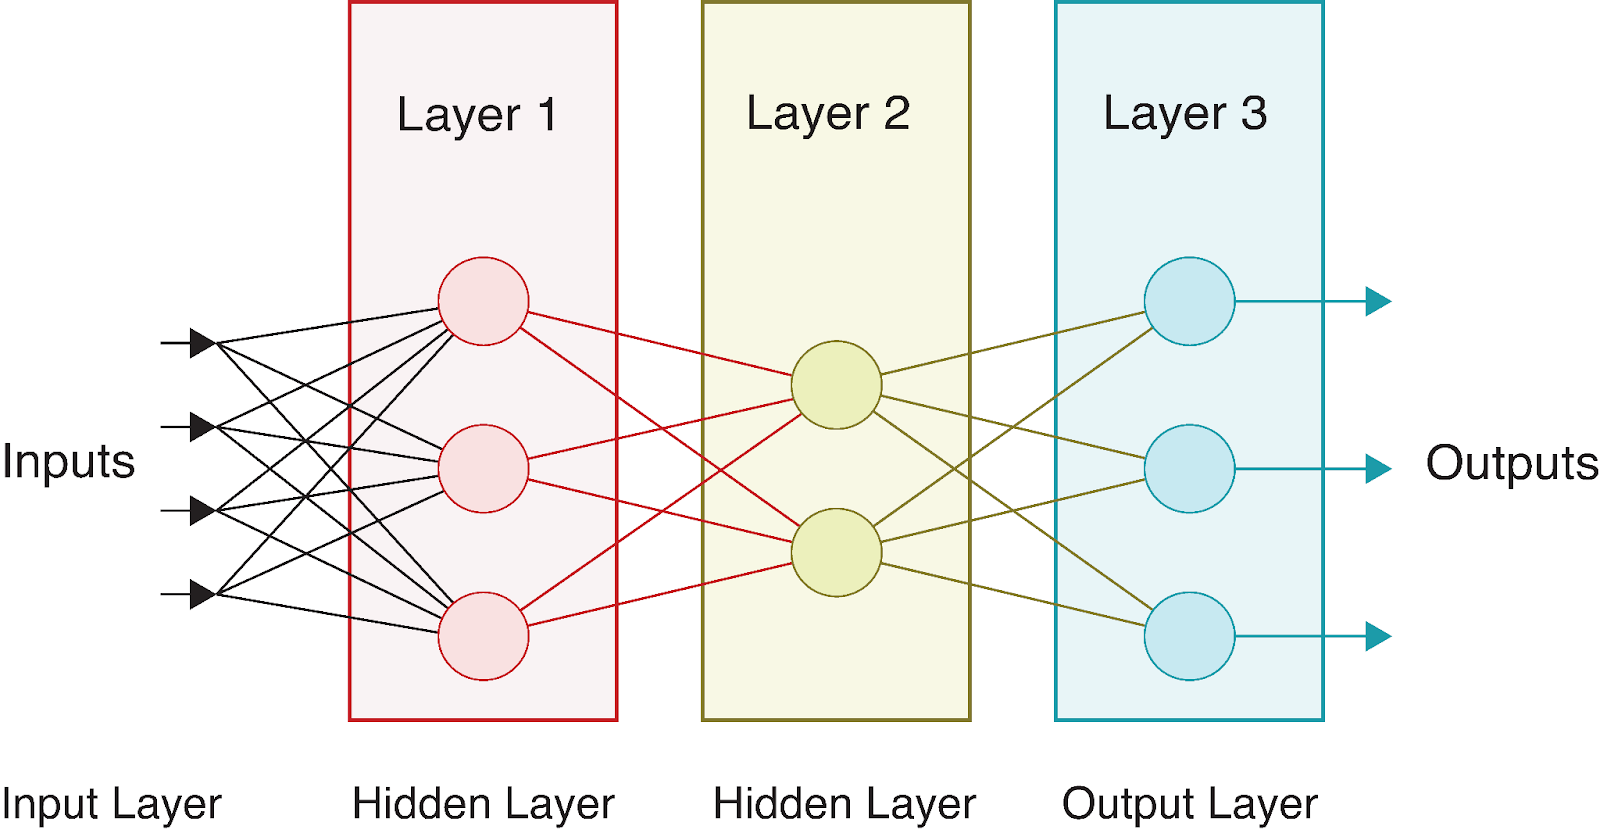
Veri bu ağdan akarken her katmanda bir dizi hesaplama yaparız. Şöyle gösterirsek:
 (gizli katman için) ve
 (çıktı katmanı için)
 ve

İleri yayılımı tüm ağ boyunca şöyle ifade edebiliriz:
1. Gizli katman ön-aktivasyonlarını hesaplayın:
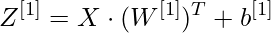
2. Aktivasyon fonksiyonunu uygulayarak gizli katman çıktısını elde edin:
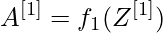
3. Çıktı katmanı ön-aktivasyonlarını hesaplayın:
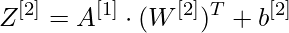
4. Nihai çıktıları elde etmek için aktivasyon fonksiyonunu uygulayın:
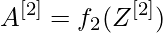
Nihai çıktı A^[2] ağın tahminini temsil eder. Sınıflandırma problemlerinde bu, her sınıf için olasılıklar olabilir; regresyonda ise tahmin edilen değerler olabilir.
Farklı katmanlar sıklıkla farklı aktivasyon fonksiyonları kullanır. Örneğin gizli katmanlarda yaygın olarak ReLU kullanılırken, çıktı katmanlarında şunlar tercih edilebilir:
Bu çok katmanlı yapının güzelliği, her katmanın verinin farklı yönlerini temsil etmeyi öğrenebilmesidir. Erken katmanlar genellikle basit özellikleri yakalarken; daha derin katmanlar bunları birleştirerek daha karmaşık örüntüler oluşturur. Bu hiyerarşik öğrenme, sinir ağlarını görüntü ve konuşma tanıma gibi karmaşık görevler için bu kadar güçlü kılar.
İleri yayılım sürecini bir algoritma haline getirelim. L katmanlı bir sinir ağı için ileri yayılım şu adımları izler:
# Pseudocode for forward propagation
def forward_propagation(X, parameters):
   """
   X: Input data (batch_size, n_features)
   parameters: Dictionary containing weights and biases for each layer
   Returns: The final output and all intermediate activations
   """
   # Store all activations for later use (e.g., in backpropagation)
   activations = {'A0': X}  # A0 is the input

   # Loop through L-1 layers (excluding the output layer)
   for l in range(1, L):
       # Get previous activation
       A_prev = activations[f'A{l-1}']

       # Get weights and biases for current layer
       W = parameters[f'W{l}']
       b = parameters[f'b{l}']

       # Compute pre-activation
       Z = np.dot(A_prev, W.T) + b

       # Apply activation function (e.g., ReLU for hidden layers)
       A = relu(Z)

       # Store values for later use
       activations[f'Z{l}'] = Z
       activations[f'A{l}'] = A

   # Compute output layer (layer L)
   A_prev = activations[f'A{L-1}']
   W = parameters[f'W{L}']
   b = parameters[f'b{L}']

   # Compute pre-activation for output layer
   Z = np.dot(A_prev, W.T) + b

   # Apply output activation function (depends on the task)
   if task == 'binary_classification':
       A = sigmoid(Z)
   elif task == 'multiclass_classification':
       A = softmax(Z)
   elif task == 'regression':
       A = Z  # Linear activation

   # Store output layer values
   activations[f'Z{L}'] = Z
   activations[f'A{L}'] = A

   return A, activations
Bu algoritma, ileri yayılımın birkaç önemli yönünü vurgular:
İleri yayılım algoritması şaşırtıcı derecede basittir; yine de sinir ağlarının inanılmaz derecede karmaşık fonksiyonları yaklaştırmasına olanak tanır. Doğru bir geri yayılım eğitimi ile birleştirildiğinde, bu basit süreç ağın veriden öğrenmesini ve giderek daha doğru tahminler yapmasını sağlar.
Anlayışımızı pekiştirmek için belirli bir örneği adım adım izleyelim. Girdi X = [0.5, -0.2, 0.1] değerinin şu örnek ağdan geçtiğini düşünün:
Basitleştirmek için tüm ağırlıkların 0.1 ve tüm bias’ların 0 olduğunu varsayalım:
X = [0.5, -0.2, 0.1]
W[1] = [[0.1, 0.1, 0.1], [0.1, 0.1, 0.1], [0.1, 0.1, 0.1], [0.1, 0.1, 0.1]]
b[1] = [0, 0, 0, 0]
W[2] = [[0.1, 0.1, 0.1, 0.1], [0.1, 0.1, 0.1, 0.1]]
b[2] = [0, 0]
Algoritmamızı izleyelim:
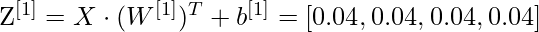
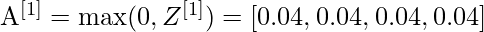
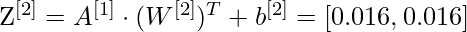
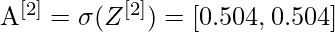
Bu, nihai tahminimizi verir. İkili sınıflandırma bağlamında 0.5’e yakın bu değerler, iki sınıf arasında bir belirsizliği işaret eder.
Bir sonraki bölümde, bu hesaplamaları eylem halinde görmek için ileri yayılımı Python’da uygulayacağız.
Artık ileri yayılımın teorisini anladığımıza göre, bunu Python’da uygulayalım. Yalnızca NumPy kullanarak “sıfırdan” bir uygulamayla başlayacak, ardından modern derin öğrenme çerçevelerinin bu süreci nasıl basitleştirdiğini göreceğiz.
NumPy, ele aldığımız matris hesaplamalarını uygulamamıza olanak tanıyan verimli dizi işlemleri sağlar. İleri yayılımı çoklu katmanlar boyunca gerçekleştiren basit bir sinir ağı sınıfı oluşturalım.
Önce gerekli kütüphaneleri içe aktarmamız gerekiyor:
import numpy as np
import matplotlib.pyplot as plt

# For reproducibility
np.random.seed(42)
Şimdi ağımızda kullanacağımız aktivasyon fonksiyonlarını tanımlayalım:
def relu(Z):
   """ReLU activation function: max(0, Z)"""
   return np.maximum(0, Z)

def sigmoid(Z):
   """Sigmoid activation function: 1/(1 + e^(-Z))"""
   return 1 / (1 + np.exp(-Z))

def softmax(Z):
   """Softmax activation function for multi-class classification"""
   # Subtract max for numerical stability (prevents overflow)
   exp_Z = np.exp(Z - np.max(Z, axis=1, keepdims=True))
   return exp_Z / np.sum(exp_Z, axis=1, keepdims=True)
Sonra sinir ağımız için bir sınıf oluşturalım:
class NeuralNetwork:
   def __init__(self, layer_dims, activations):
       """
       Initialize a neural network with specified layer dimensions and activations

       Parameters:
       - layer_dims: List of integers representing the number of neurons in each layer
                    (including input and output layers)
       - activations: List of activation functions for each layer (excluding input layer)
       """
       self.L = len(layer_dims) - 1  # Number of layers (excluding input layer)
       self.layer_dims = layer_dims
       self.activations = activations
       self.parameters = {}

       # Initialize parameters (weights and biases)
       self.initialize_parameters()

   def initialize_parameters(self):
       """Initialize weights and biases with small random values"""
       for l in range(1, self.L + 1):
           # He initialization for weights - helps with training deep networks
           self.parameters[f'W{l}'] = np.random.randn(self.layer_dims[l], self.layer_dims[l-1]) * np.sqrt(2 / self.layer_dims[l-1])
           self.parameters[f'b{l}'] = np.zeros((self.layer_dims[l], 1))

   def forward_propagation(self, X):
       """
       Perform forward propagation through the network

       Parameters:
       - X: Input data (n_features, batch_size)

       Returns:
       - AL: Output of the network
       - caches: Dictionary containing all activations and pre-activations
       """
       caches = {}
       A = X  # Input layer activation
       caches['A0'] = X

       # Process through L-1 layers (excluding output layer)
       for l in range(1, self.L):
           A_prev = A

           # Get weights and biases for current layer
           W = self.parameters[f'W{l}']
           b = self.parameters[f'b{l}']

           # Forward propagation for current layer
           Z = np.dot(W, A_prev) + b

           # Apply activation function
           activation_function = self.activations[l-1]
           if activation_function == "relu":
               A = relu(Z)
           elif activation_function == "sigmoid":
               A = sigmoid(Z)

           # Store values for backpropagation
           caches[f'Z{l}'] = Z
           caches[f'A{l}'] = A

       # Output layer
       W = self.parameters[f'W{self.L}']
       b = self.parameters[f'b{self.L}']
       Z = np.dot(W, A) + b

       # Apply output activation function
       activation_function = self.activations[self.L-1]
       if activation_function == "sigmoid":
           AL = sigmoid(Z)
       elif activation_function == "softmax":
           AL = softmax(Z)
       elif activation_function == "linear":
           AL = Z  # No activation for regression

       # Store output layer values
       caches[f'Z{self.L}'] = Z
       caches[f'A{self.L}'] = AL

       return AL, caches
Az önce uyguladığımız NeuralNetwork sınıfı, özelleştirilebilir mimariye sahip bir sinir ağı oluşturmak ve kullanmak için eksiksiz bir çerçeve sunar. Temel bileşenlerini inceleyelim:
forward_propagation yöntemi, sinir ağının tahmin yeteneğinin kalbidir. Şunları yapar:3. Aktivasyon fonksiyonları: Ağ, ReLU, sigmoid ve softmax dahil olmak üzere birden çok aktivasyon fonksiyonunu destekler; bu sayede farklı türde problemleri (regresyon veya sınıflandırma) ele alabilir.
4. Esnek mimari: Uygulama, istenen derinlik ve genişlikte ağlara olanak tanır; bu da onu çok çeşitli makine öğrenmesi görevleri için uygun kılar.
Bu uygulama, verinin ağ boyunca ileri yönde aktığı; her katmanın veriyi bir sonrakine iletmeden önce dönüştürdüğü standart sinir ağı tasarım kalıbını izler.
Şimdi küçük bir örnek ağ ile uygulamamızı test edelim:
# Create a sample network
# Input layer: 3 features
# Hidden layer 1: 4 neurons with ReLU activation
# Output layer: 2 neurons with sigmoid activation (binary classification)
layer_dims = [3, 4, 2]
activations = ["relu", "sigmoid"]
nn = NeuralNetwork(layer_dims, activations)

# Create sample input data - 3 features for 5 examples
X = np.random.randn(3, 5)

# Perform forward propagation
output, caches = nn.forward_propagation(X)

print(f"Input shape: {X.shape}")
print(f"Output shape: {output.shape}")
print(f"Output values:\n{output}")Çıktı:
Input shape: (3, 5)
Output shape: (2, 5)
Output values:
[[0.00386784 0.54343014 0.39661893 0.5        0.51056934]
[0.11877049 0.32541093 0.44840699 0.5        0.45586633]]
Verinin ağ boyunca ilerlerken nasıl dönüştüğünü de görselleştirelim:
def visualize_activations(caches, example_idx=0):
   """Visualize the activations for a single example through the network"""
   plt.figure(figsize=(15, 6))

   # Plot input
   plt.subplot(1, 3, 1)
   plt.bar(range(caches['A0'].shape[0]), caches['A0'][:, example_idx])
   plt.title('Input Layer')
   plt.xlabel('Feature')
   plt.ylabel('Value')

   # Plot hidden layer activation
   plt.subplot(1, 3, 2)
   plt.bar(range(caches['A1'].shape[0]), caches['A1'][:, example_idx])
   plt.title('Hidden Layer (ReLU Activation)')
   plt.xlabel('Neuron')
   plt.ylabel('Activation')

   # Plot output layer
   plt.subplot(1, 3, 3)
   plt.bar(range(caches['A2'].shape[0]), caches['A2'][:, example_idx])
   plt.title('Output Layer (Sigmoid Activation)')
   plt.xlabel('Neuron')
   plt.ylabel('Activation')

   plt.tight_layout()
   plt.show()

# Visualize the first example
visualize_activations(caches)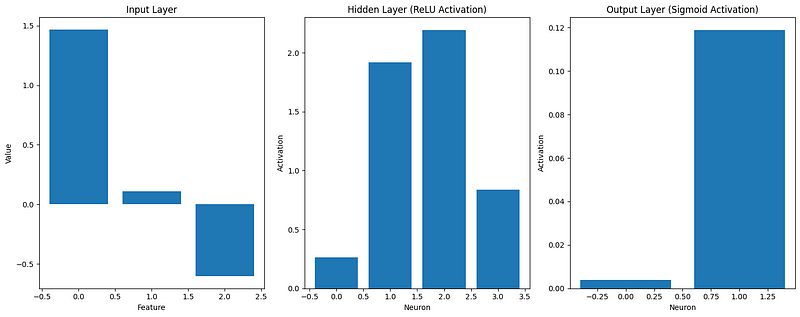
Bu görselleştirme, verinin ağ boyunca yayılırken nasıl dönüştüğünü anlamamıza yardımcı olur. Şunları görebiliriz:
“Sıfırdan” uygulamamız ileri yayılımın temel ilkelerini gösterir; ancak modern derin öğrenme çerçeveleri sinir ağları kurmak için daha verimli ve esnek araçlar sunar.
Şimdi aynı sinir ağını popüler derin öğrenme çerçeveleri olan TensorFlow ve PyTorch kullanarak uygulayalım. Bu çerçeveler performansı optimize eder ve yüksek seviyeli soyutlamalar sağlar; böylece karmaşık modelleri kurmak kolaylaşır.
Önce TensorFlow/Keras uygulamasına bakalım:
import tensorflow as tf
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, Input

# For reproducibility
tf.random.set_seed(42)

# Create the same network architecture
tf_model = Sequential([
   Input(shape=(3,)),  # Input layer with 3 features
   Dense(4, activation='relu'),  # Hidden layer with 4 neurons
   Dense(2, activation='sigmoid')  # Output layer with 2 neurons
])

tf_model.summary()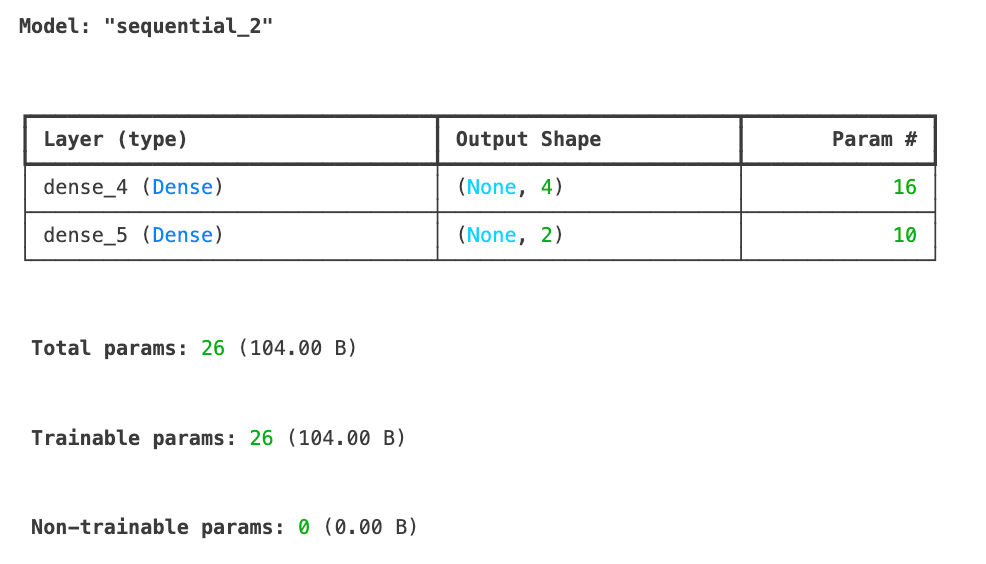
# Sample input data with the shape expected by Keras
X_tf = np.random.randn(5, 3)  # 5 examples, 3 features

# Forward propagation in TensorFlow
tf_output = tf_model.predict(X_tf)

print(f"TensorFlow output shape: {tf_output.shape}")
print(f"TensorFlow output values:\n{tf_output}")
TensorFlow output shape: (5, 2)
TensorFlow output values:
[[0.6855308 0.7139542 ]
[0.4952355 0.5231934 ]
[0.50174904 0.5198488 ]
[0.44331825 0.6860926 ]
[0.6624589 0.5385444 ]]Sinir ağımızı TensorFlow/Keras ile uyguladık ve örnek veri üzerinde başarıyla ileri yayılım gerçekleştirdik. Model özeti, 3 özelliği kabul eden bir girdi katmanı, ReLU aktivasyonlu 4 nöronlu bir gizli katman ve sigmoid aktivasyonlu 2 nöronlu bir çıktı katmanı bulunan mimariyi gösterir. Toplamda modelin 26 eğitilebilir parametresi vardır.
İleri yayılım sonuçları, 5 girdi örneğine karşılık (5, 2) çıktı şekli verdiğimizi gösterir; her örnek 2 çıktı değeri üretir. Bu çıktılar, çıktı katmanındaki sigmoid aktivasyonu nedeniyle 0 ile 1 arasında sınırlandırılmıştır.
Sırada, yaklaşımı karşılaştırmak için aynı sinir ağı mimarisini, bir başka popüler derin öğrenme çerçevesi olan PyTorch ile nasıl uygulayabileceğimize bakmak var.
import torch
import torch.nn as nn

# For reproducibility
torch.manual_seed(42)

# Create a network in PyTorch
class PyTorchNN(nn.Module):
   def __init__(self):
       super(PyTorchNN, self).__init__()
       self.hidden = nn.Linear(3, 4)  # 3 inputs, 4 hidden neurons
       self.relu = nn.ReLU()
       self.output = nn.Linear(4, 2)  # 4 inputs from hidden, 2 outputs
       self.sigmoid = nn.Sigmoid()

   def forward(self, x):
       x = self.relu(self.hidden(x))
       x = self.sigmoid(self.output(x))
       return x

# Instantiate the model
torch_model = PyTorchNN()

# Print model structure
print(torch_model)Çıktı:
PyTorchNN(
 (hidden): Linear(in_features=3, out_features=4, bias=True)
 (relu): ReLU()
 (output): Linear(in_features=4, out_features=2, bias=True)
 (sigmoid): Sigmoid()
)

```python
# Sample input data
X_torch = torch.randn(5, 3)  # 5 examples, 3 features

# Forward propagation in PyTorch
torch_output = torch_model(X_torch)

print(f"PyTorch output shape: {torch_output.shape}")
print(f"PyTorch output values:\n{torch_output}")Çıktı:
PyTorch output shape: torch.Size([5, 2])
PyTorch output values:
tensor([[0.4516, 0.4116],
       [0.4289, 0.4267],
       [0.4278, 0.4172],
       [0.3771, 0.4321],
       [0.5769, 0.3328]], grad_fn=<SigmoidBackward0>)
Uygulamalarımızı karşılaştıralım:
# Compare dimensions and structure of outputs
print("\nComparison of implementations:")
print(f"NumPy output shape: {output.shape}")
print(f"TensorFlow output shape: {tf_output.shape}")
print(f"PyTorch output shape: {torch_output.shape}")Çıktı:
Comparison of implementations:
NumPy output shape: (2, 5)
TensorFlow output shape: (5, 2)
PyTorch output shape: torch.Size([5, 2])
Uygulamalarımız arasındaki temel farklar:
Basit ağlar için NumPy uygulamamız iş görür; ancak karmaşıklık arttıkça derin öğrenme çerçeveleri vazgeçilmez hale gelir. Düşük seviyeli optimizasyonları ele alır ve geliştirmeden dağıtıma tüm makine öğrenmesi yaşam döngüsü için araçlar sunarlar. Bu çerçeveler hakkında daha fazla bilgi için ayrı rehberlerimize göz atın:
Bir sonraki bölümde, ileri yayılımı gerçek bir probleme uygulayan, tamamen çalışan bir örnek oluşturacağız.
İleri yayılımı hem sıfırdan hem de popüler çerçevelerle uyguladığımıza göre, bunu gerçek bir problem üzerinde görelim. Tam bir örnek kuracak ve daha iyi performans için süreci nasıl optimize edeceğimizi inceleyeceğiz.
Anlayışımızı, MNIST veri kümesini kullanarak el yazısı rakam tanıma gibi klasik bir makine öğrenmesi problemine uygulayalım. Bu veri kümesi, her biri 28x28 piksel olan 70.000 el yazısı rakam (0–9) görüntüsü içerir.
Önce veriyi yükleyip hazırlayalım:
from tensorflow.keras.datasets import mnist
import numpy as np
import matplotlib.pyplot as plt

# Load MNIST dataset
(X_train, y_train), (X_test, y_test) = mnist.load_data()

# Normalize pixel values to range [0, 1]
X_train = X_train / 255.0
X_test = X_test / 255.0

# Reshape images to vectors (flatten 28x28 to 784)
X_train_flat = X_train.reshape(X_train.shape[0], -1).T  # Shape: (784, 60000)
X_test_flat = X_test.reshape(X_test.shape[0], -1).T     # Shape: (784, 10000)

# Convert labels to one-hot encoding
def one_hot_encode(y, num_classes=10):
   one_hot = np.zeros((num_classes, y.size))
   one_hot[y, np.arange(y.size)] = 1
   return one_hot

y_train_one_hot = one_hot_encode(y_train)  # Shape: (10, 60000)
y_test_one_hot = one_hot_encode(y_test)    # Shape: (10, 10000)

# Display sample images
plt.figure(figsize=(10, 5))
for i in range(5):
   plt.subplot(1, 5, i+1)
   plt.imshow(X_train[i], cmap='gray')
   plt.title(f"Label: {y_train[i]}")
   plt.axis('off')
plt.tight_layout()
plt.show()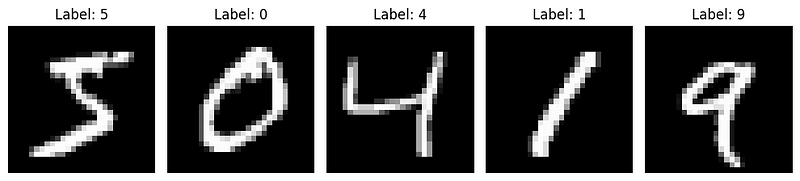
Şimdi, bu görev için NumPy uygulamamızı kullanarak bir sinir ağı kuralım. Aşağıdaki yapıda bir ağ oluşturacağız:
# Define our network architecture
layer_dims = [784, 128, 10]
activations = ["relu", "softmax"]
nn = NeuralNetwork(layer_dims, activations)

# Take a small batch for demonstration
batch_size = 64
batch_indices = np.random.choice(X_train_flat.shape[1], batch_size, replace=False)
X_batch = X_train_flat[:, batch_indices]
y_batch = y_train_one_hot[:, batch_indices]

# Perform forward propagation
output, caches = nn.forward_propagation(X_batch)

# Compute accuracy
predictions = np.argmax(output, axis=0)
true_labels = np.argmax(y_batch, axis=0)
accuracy = np.mean(predictions == true_labels)

print(f"Batch accuracy: {accuracy:.4f}")

Out: Batch accuracy: 0.0781
%7 doğruluk elde ettik; bu, rastgele tahmin yapan bir modelden bile daha kötüdür. Ancak bu beklenir; çünkü yalnızca ileri yayılım yapıyoruz — herhangi bir öğrenme yok.
Şimdi de ağın tek bir görüntüyü her katman boyunca nasıl işlediğini görselleştirelim:
def visualize_network_processing(nn, image, label, caches):
   """Visualize network processing for a single image"""
   plt.figure(figsize=(15, 10))

   # Plot original image
   plt.subplot(2, 3, 1)
   plt.imshow(image.reshape(28, 28), cmap='gray')
   plt.title(f"Input Image (Digit: {label})")
   plt.axis('off')

   # Plot flattened input (first 100 values)
   plt.subplot(2, 3, 2)
   plt.bar(range(100), image.flatten()[:100])
   plt.title("Input Layer (first 100 pixels)")
   plt.xlabel("Pixel Index")
   plt.ylabel("Pixel Value")

   # Plot hidden layer activations (first 50 neurons)
   plt.subplot(2, 3, 3)
   hidden_activations = caches['A1'][:50, 0]
   plt.bar(range(len(hidden_activations)), hidden_activations)
   plt.title("Hidden Layer Activations (first 50 neurons)")
   plt.xlabel("Neuron Index")
   plt.ylabel("Activation")

   # Plot output layer activations
   plt.subplot(2, 3, 4)
   output_activations = caches['A2'][:, 0]
   plt.bar(range(10), output_activations)
   plt.xticks(range(10))
   plt.title("Output Layer Activations (Softmax)")
   plt.xlabel("Digit Class")
   plt.ylabel("Probability")

   # Plot prediction vs actual
   plt.subplot(2, 3, 5)
   prediction = np.argmax(output_activations)
   plt.bar(['Actual', 'Predicted'], [label, prediction], color=['blue', 'orange'])
   plt.title(f"Prediction: {prediction}, Actual: {label}")
   plt.ylabel("Digit")

   plt.tight_layout()
   plt.show()

# Visualize forward propagation for the first image in our batch
image_idx = 0
image = X_batch[:, image_idx].reshape(784, 1)
label = true_labels[image_idx]

visualize_network_processing(nn, image, label, caches)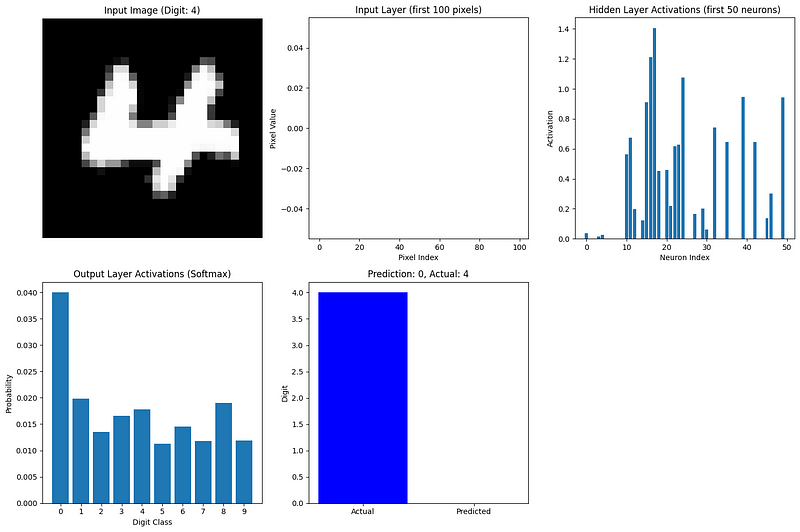
Bu görselleştirme, ağımız boyunca bilginin nasıl aktığını gösterir:
En yüksek etkinliğe sahip çıktı nöronu, ağın tahminine karşılık gelir. Henüz eğitmediğimiz için ağırlıklar rastgele olmasına rağmen, ileri yayılımın girdi verisini nasıl bir tahmine dönüştürdüğünü görebiliyoruz.
Daha eksiksiz bir örnek için, bu ağı geri yayılım kullanarak eğitip ağırlık ve bias’ları ayarlayarak tahminleri zamanla iyileştirirdik. Ancak eğitim olmadan bile bu örnek, ileri yayılım sürecini gerçek veride göstermektedir.
Sinir ağları büyüyüp veri kümeleri devasa hale geldikçe, ileri yayılımın optimize edilmesi kritik hale gelir. İleri yayılımı daha verimli kılmak için temel stratejiler şunlardır:
Tek tek örnekleri işlemek yerine, ileri yayılımı örnek yığınları üzerinde eşzamanlı olarak hesaplarız. Bu, modern donanımın paralel işleme yeteneklerinden yararlanır.
Döngüler yerine matris işlemlerini kullanmak hesaplamayı ciddi şekilde hızlandırır. Bu nedenle uygulamamızda NumPy’nin dizi işlemlerini kullandık.
Büyük ağlarda bellek kullanımına dikkat etmek gerekir. Teknikler arasında şunlar bulunur:
Grafik İşlem Birimleri, matris işlemlerinde mükemmeldir. Modern çerçeveler hesaplamayı GPU’lara sorunsuzca taşıyarak önemli hızlanmalar sağlar:
# TensorFlow example of GPU acceleration
import tensorflow as tf

# Check for available GPUs
print("GPUs Available:", tf.config.list_physical_devices('GPU'))

# TensorFlow automatically uses available GPUs
with tf.device('/GPU:0'):  # Explicitly specify GPU if multiple are available
   # Computation runs on GPU if available
result = tf_model.predict(X_tf)GPU’ların ötesinde, Google’ın TPU’ları (Tensor Processing Unit) gibi donanımlar özellikle sinir ağı işlemleri için tasarlanmıştır.
Belirli aktivasyon fonksiyonları ve ağ mimarileri hesaplama verimliliği için tasarlanmıştır:
Derin öğrenme çerçeveleri çok sayıda düşük seviyeli optimizasyon uygular:
Ağlar daha derin ve geniş hale geldikçe, ileri yayılım optimizasyonu giderek daha önemli olur. ResNet’ler, Transformer’lar ve EfficientNet’ler gibi modern mimariler, ileri yayılımı daha verimli kılarken model doğruluğunu koruyan veya artıran tasarım tercihleri içerir.
Bir sonraki bölümde, ileri yayılımın geri yayılımla (backpropagation) nasıl bağlantılı olduğunu inceleyerek sinir ağlarının nasıl öğrendiğine dair resmi tamamlayacağız.
Artık ileri yayılımı etraflıca inceledik; ancak bu, sinir ağları söz konusu olduğunda hikayenin yalnızca yarısıdır. İleri yayılımın, sinir ağlarının öğrenmesini sağlayan geri yayılımla nasıl bağlantılandığını kısaca ele alalım.
İleri yayılım ve geri yayılım sinir ağlarında birbirini tamamlayan süreçlerdir:
Bu iki süreç, öğrenme sürecinde ayrılmaz bir bütündür. Geri yayılım, önce ileri yayılım yapılmadan gerçekleşemez; çünkü şunlara ihtiyaç duyar:
İleri yayılımı, ağın mevcut anlayışına göre en iyi tahminini yapması; geri yayılımı da hatalarına dayanarak bu anlayışı rafine etmesi olarak düşünebilirsiniz.
Tüm öğrenme süreci döngüsel bir deseni izler:
Bu süreci güçlü kılan, ileri yayılımın geri yayılım için gerekli bağlamı sağlamasıdır. İleri yayılım sırasında ağ yalnızca tahmin yapmakla kalmaz; tüm ara değerleri ve kararları da kaydeder. Geri yayılım, ardından bu bilgileri kullanarak hedefli ayarlamalar yapar.
Bu sistemin güzelliği, iki nispeten basit sürecin birlikte çalışmasından karmaşık öğrenmenin ortaya çıkmasıdır. İleri yayılım basittir — arka arkaya uygulanan matris çarpımları ve aktivasyon fonksiyonlarıdır. Geri yayılım daha karmaşıktır; ancak doğrudan kalkülüs ilkelerinden türetilir.
Birlikte, yeterli veri ve hesaplama kaynağı sağlandığında sinir ağlarının neredeyse her türlü örüntüyü öğrenmesini mümkün kılarlar. Bu öğrenme yeteneği; bilgisayarlı görü, doğal dil işleme, oyun oynama ve sayısız başka alanda atılımları mümkün kılmıştır.
Bu makalede yaptığımız gibi ileri yayılımı derinlemesine anlamak, sinir ağlarındaki tam öğrenme sürecini kavramak için gereken temeli sağlar. Öğrenme yönüne daha derin dalmak isterseniz, geri yayılım rehberimiz, ağların hatalarından nasıl öğrendiğine dair ayrıntılı bir inceleme sunar.
İleri yayılım, sinir ağlarının girdileri tahminlere dönüştürmesini sağlayan temel süreçtir. İncelediğimiz gibi, ağın katmanları boyunca veriyi kademeli olarak dönüştüren sıralı matris çarpımları ve aktivasyon fonksiyonlarını içerir. Bu süreci anlamak; ağları sıfırdan uygular, modern çerçeveler kullanır veya model performansını sorun giderirken kritik öneme sahiptir.
İleri yayılımı ustalaştırarak, farklı alanlarda karmaşık problemleri ele alabilen derin öğrenme modelleri kurma ve anlama yolunda önemli bir adım attınız.
Derin öğrenme yolculuğunuza devam etmek için DataCamp’in kapsamlı kaynaklarını keşfedin:
Yapılandırılmış bir öğrenme yolu için, Python ile Derin Öğrenme yolu, gerçek dünyadaki uygulamalar için sinir ağlarını kurma ve dağıtma konusunda yetkin hale gelmeniz için gereken her şeyi sunar.
En İyi DataCamp Kursları
Kurs
Program
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




