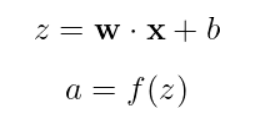Last chance! 50% off DataCamp Premium
Sale ends in
न्यूरल नेटवर्क्स ने आर्टिफ़िशियल इंटेलिजेंस में क्रांति ला दी है—इमेज़ रिकग्निशन से लेकर नेचुरल लैंग्वेज प्रोसेसिंग तक। इन शक्तिशाली मॉडलों के केंद्र में एक बुनियादी प्रक्रिया होती है जिसे फ़ॉरवर्ड प्रोपेगेशन कहते हैं। यह गाइड इस मूल अवधारणा को समझाएगा—बुनियादी सिद्धांतों से लेकर व्यावहारिक कार्यान्वयन तक।
यदि आप यहाँ कवर की गई कई अवधारणाओं पर हैंड्स-ऑन गाइड चाहते हैं, तो हमारा Deep Learning in Python स्किल ट्रैक ज़रूर देखें।
फ़ॉरवर्ड प्रोपेगेशन वह प्रक्रिया है जिसमें एक न्यूरल नेटवर्क इनपुट डेटा को भविष्यवाणियों या आउटपुट में बदलता है। इसे नेटवर्क के “सोचने” के चरण के रूप में समझें—जब उसे कोई इनपुट (जैसे इमेज या टेक्स्ट) दिखाया जाता है, तो फ़ॉरवर्ड प्रोपेगेशन यह दर्शाता है कि परतों के माध्यम से जानकारी कैसे बहती है और परिणाम उत्पन्न होता है।
तकनीकी रूप से, यह क्रमिक गणना है जो डेटा को इनपुट लेयर से छिपी परतों के माध्यम से आउटपुट लेयर तक ले जाती है। इस दौरान, डेटा वेटेड कनेक्शनों और एक्टिवेशन फ़ंक्शनों द्वारा रूपांतरित होता है, जिससे नेटवर्क जटिल पैटर्न पकड़ पाता है।
फ़ॉरवर्ड प्रोपेगेशन को समझना कई कारणों से आवश्यक है:
इस व्यापक गाइड के अंत तक, आप:
इस गाइड का पूरा लाभ उठाने के लिए, आपके पास होना चाहिए:
यदि आपको अपनी नींव को मजबूत करने की ज़रूरत है, तो इन संसाधनों पर विचार करें:
व्यापक पृष्ठभूमि ज्ञान न होने पर भी, हमने इस गाइड को चरण-बद्ध तरीके से अवधारणाएँ बनाने के लिए तैयार किया है, ताकि दृढ़ इच्छाशक्ति वाले सीखने वालों के लिए न्यूरल नेटवर्क सुलभ हों। आइए शुरू करें!
फ़ॉरवर्ड प्रोपेगेशन को समझने के लिए हमें इसके मूल घटकों से शुरू करना होगा। आइए न्यूरल नेटवर्क में सबसे छोटे गणनात्मक यूनिट से शुरुआत करें और धीरे-धीरे अधिक जटिल संरचनाओं तक पहुँचें।
न्यूरल नेटवर्क की यात्रा जीवविज्ञान के समानांतर से शुरू होती है। जैसे मानव मस्तिष्क अरबों इंटरकनेक्टेड न्यूरॉन्स से बना है, वैसे ही कृत्रिम न्यूरल नेटवर्क जैविक कोशिकाओं से प्रेरित गणितीय मॉडलों से निर्मित होते हैं।
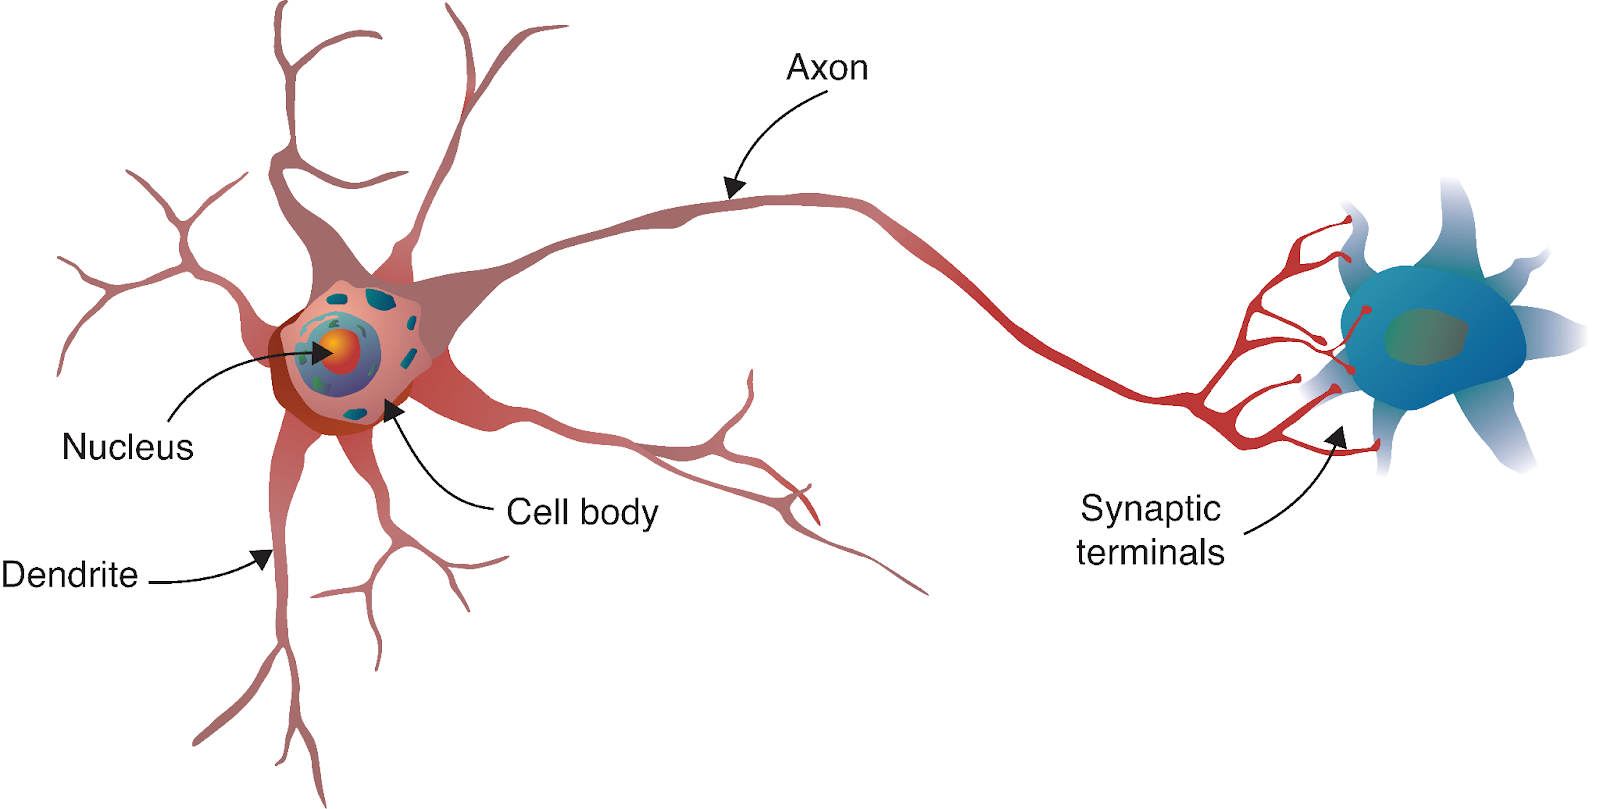
स्रोत: Deep Learning - Visual Approach
एक जैविक न्यूरॉन डेंड्राइट्स के माध्यम से अन्य न्यूरॉन्स से सिग्नल प्राप्त करता है, उन्हें अपने सेल बॉडी में प्रोसेस करता है, और फिर एक्सॉन के ज़रिए परिणाम आगे भेजता है। हमारे कम्प्यूटेशनल मॉडल में, हम इस प्रक्रिया को निम्न रूप में दर्शाते हैं:
इसे ठोस बनाने के लिए एकल न्यूरॉन को विज़ुअलाइज़ करें:
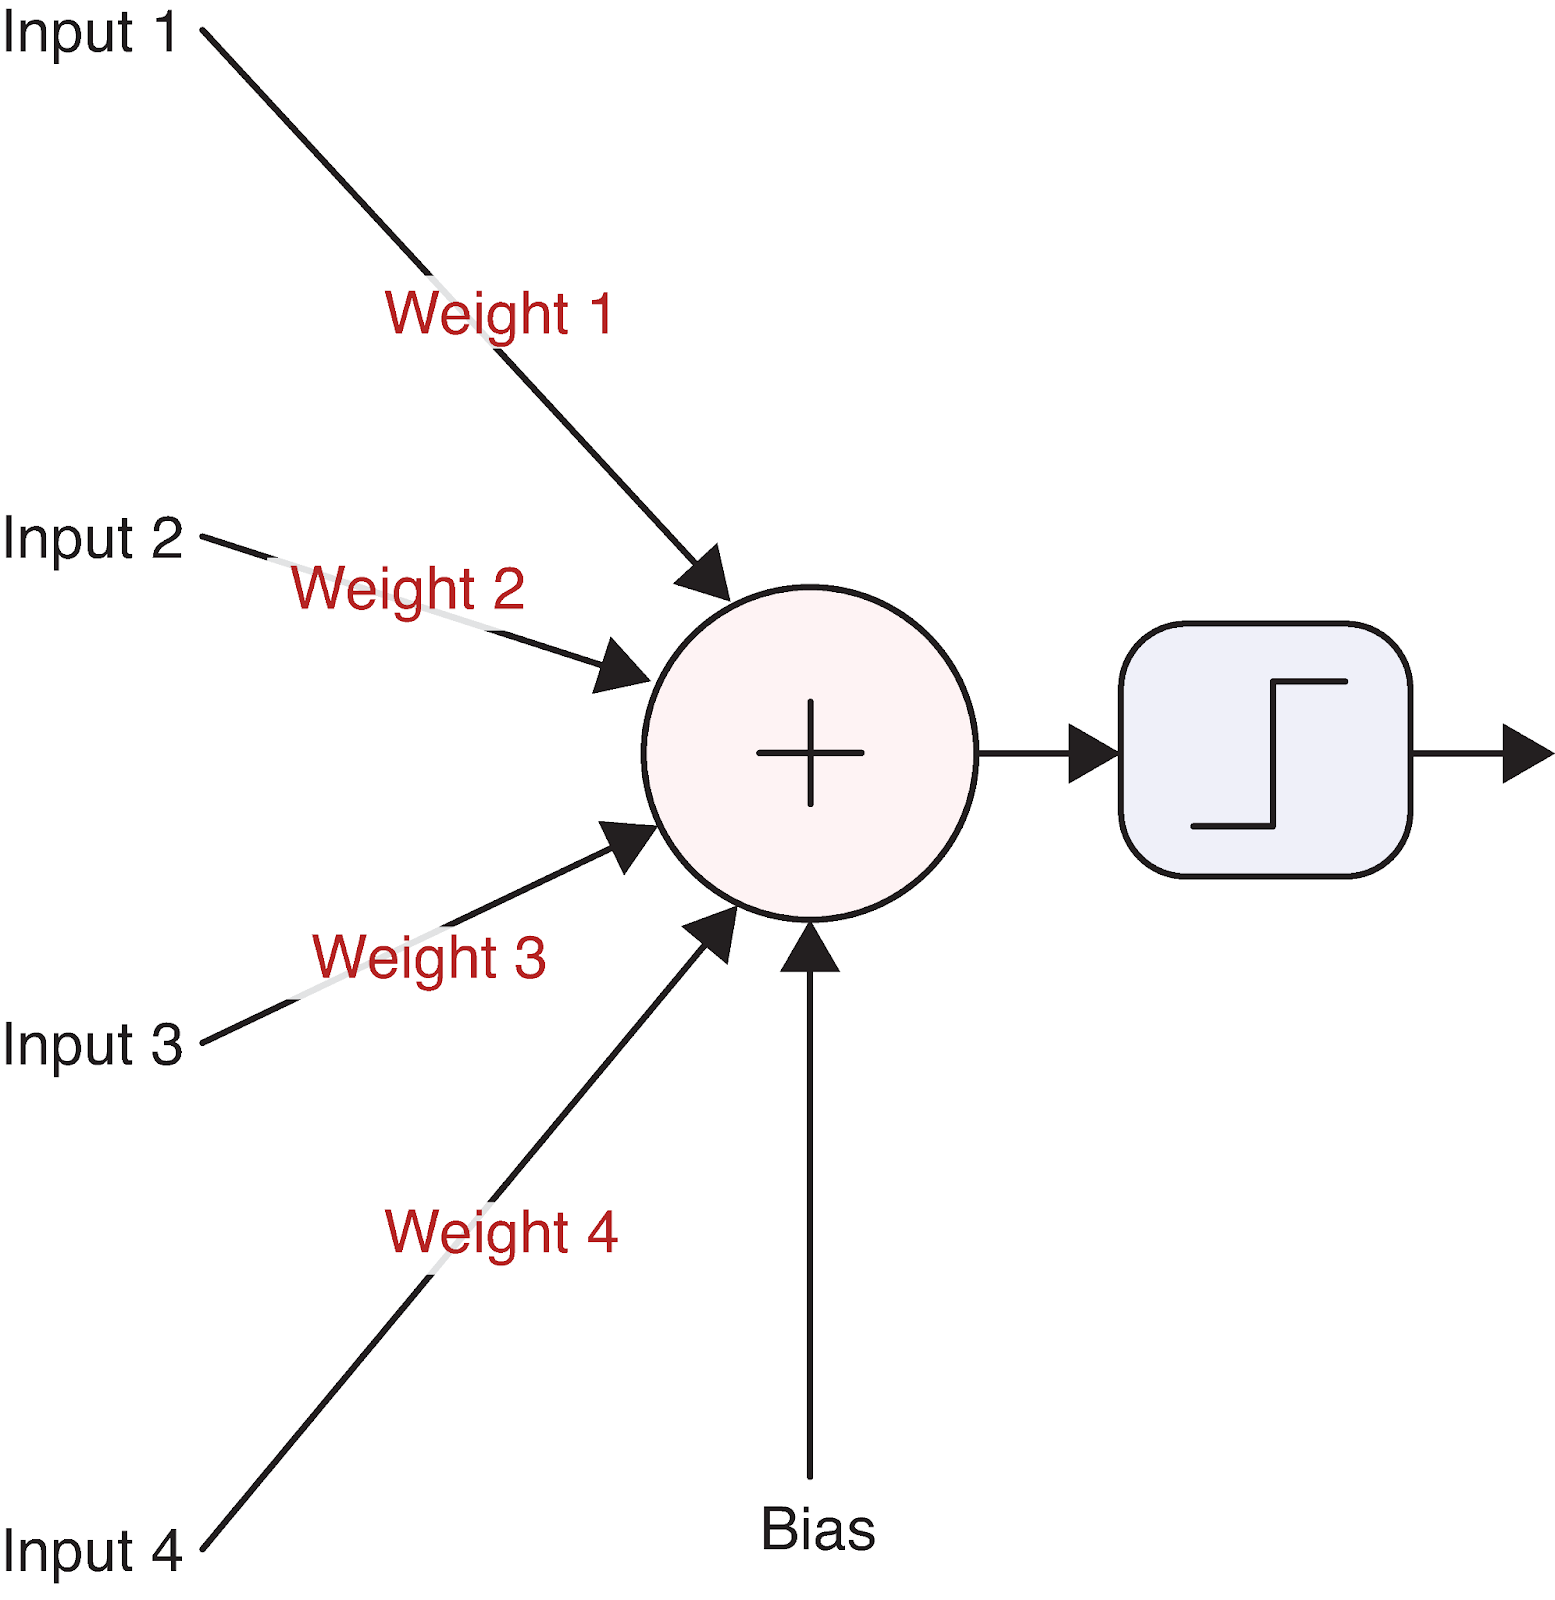
स्रोत: Deep Learning - Visual Approach
यह सरल गणनात्मक यूनिट सबसे जटिल न्यूरल नेटवर्क्स की भी नींव है। लेकिन न्यूरॉन अपने इनपुट्स को आउटपुट में बदलता कैसे है? यहीं गणित काम आता है।
न्यूरॉन का संचालन एक सीधे-सादे समीकरण से व्यक्त किया जा सकता है:
इसे भागों में समझें:
आइए वास्तविक संख्याओं के साथ एक ठोस उदाहरण पर काम करें। मान लें हमारे पास तीन इनपुट वाला एक न्यूरॉन है:
Inputs: x = [2, 5, -1]
Weights: w = [0.5, -1, 2]
Bias: b = 0.5
पहले, हम वेटेड सम प्लस बायस निकालते हैं:
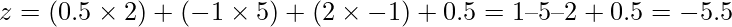
अगला, हम एक एक्टिवेशन फ़ंक्शन लागू करते हैं। चलिए प्रचलित ReLU (Rectified Linear Unit) फ़ंक्शन का उपयोग करते हैं, जो इस प्रकार परिभाषित है:
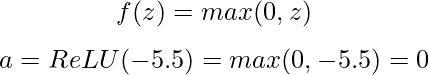
नकारात्मक प्री-एक्टिवेशन मान होने पर, हमारा ReLU न्यूरॉन 0 आउटपुट देता है, यानी यह इस इनपुट के लिए “फ़ायर” नहीं करता।
एक्टिवेशन फ़ंक्शन अहम है क्योंकि यह नेटवर्क में नॉन-लिनियरिटी लाता है। इसके बिना, चाहे कितनी भी परतें हों, नेटवर्क केवल रैखिक संबंध ही सीख पाएगा। आम एक्टिवेशन फ़ंक्शनों में शामिल हैं:
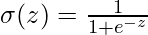 — आउटपुट 0 और 1 के बीच; बाइनरी वर्गीकरण में उपयोगी
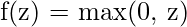 — सरल, कुशल और vanishing gradient समस्या में सहायक
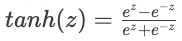 — आउटपुट -1 और 1 के बीच; अक्सर हिडन लेयर्स में
हर एक्टिवेशन फ़ंक्शन की अपनी खूबियाँ और उपयोग-परिस्थितियाँ हैं, जिन्हें हम अपने न्यूरल नेटवर्क के कार्यान्वयन में और देखेंगे।
व्यक्तिगत न्यूरॉन्स शक्तिशाली होते हैं, लेकिन असली ताकत तब आती है जब इन्हें परतों में संगठित किया जाता है। एक लेयर समानांतर में इनपुट प्रोसेस करने वाले न्यूरॉन्स का संग्रह है। प्रायः न्यूरल नेटवर्क में तीन प्रकार की परतें होती हैं:
जब किसी लेयर में कई न्यूरॉन होते हैं, जो समान इनपुट लेते हैं किंतु अलग वेट्स/बायस रखते हैं, तो हम इसे मैट्रिक्स ऑपरेशनों से कुशलतापूर्वक दर्शा सकते हैं। देखें यह कैसे काम करता है।
मान लें हमारे पास 3 इनपुट मान और 4 न्यूरॉन्स वाली एक लेयर है। प्रत्येक न्यूरॉन के अपने वेट्स और बायस हैं:
Inputs: x = [x₁, x₂, x₃]
Weights for neuron 1: w₁ = [w₁₁, w₁₂, w₁₃]
Weights for neuron 2: w₂ = [w₂₁, w₂₂, w₂₃]
Weights for neuron 3: w₃ = [w₃₁, w₃₂, w₃₃]
Weights for neuron 4: w₄ = [w₄₁, w₄₂, w₄₃]
Biases: b = [b₁, b₂, b₃, b₄]
हम इन वेट्स को एक मैट्रिक्स W में व्यवस्थित कर सकते हैं:
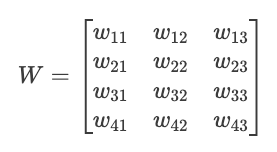
अब हम एक ही मैट्रिक्स गुणन के साथ सभी न्यूरॉन्स के प्री-एक्टिवेशन एक साथ निकाल सकते हैं:
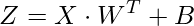
जहाँ:
फिर हम एलिमेंट-वाइज़ एक्टिवेशन फ़ंक्शन लागू करके अंतिम आउटपुट पाते हैं:
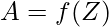
यह मैट्रिक्स निरूपण केवल गणितीय सुंदरता ही नहीं, बल्कि संगणनात्मक दक्षता भी है। आधुनिक हार्डवेयर (खासकर GPUs) मैट्रिक्स ऑपरेशनों के लिए अनुकूलित होते हैं, जिससे यह तरीका प्रत्येक न्यूरॉन का आउटपुट अलग-अलग निकालने की तुलना में कहीं तेज़ है।
इन परतों को स्टैक करने की क्षमता—जहाँ एक परत का आउटपुट अगली परत का इनपुट बनता है—न्यूरल नेटवर्क्स को जटिल पैटर्न सीखने की अद्भुत क्षमता देती है। अब जब हमने ये बिल्डिंग ब्लॉक्स जोड़ दिए हैं, तो पूरी नेटवर्क में फ़ॉरवर्ड प्रोपेगेशन कैसे काम करता है, यह देखने को तैयार हैं।
अब जब हम व्यक्तिगत न्यूरॉन्स और लेयर्स समझ चुके हैं, तो देखें कि पूरा न्यूरल नेटवर्क फ़ॉरवर्ड प्रोपेगेशन कैसे करता है। यहीं डीप लर्निंग की असली शक्ति दिखती है।
एक पूरा न्यूरल नेटवर्क इनपुट लेयर, एक या अधिक हिडन लेयर्स, और एक आउटपुट लेयर से बना होता है। डीप लर्निंग में “डीप” का मतलब होता है कि नेटवर्क में कई हिडन लेयर्स हैं। हर परत डेटा को और अधिक अमूर्त तरीकों से बदलती है, जिससे नेटवर्क जटिल प्रतिनिधित्व सीख पाता है।
एक सरल नेटवर्क पर विचार करें जिसमें:
दृश्य रूप में, यह नेटवर्क इस तरह दिखता है:
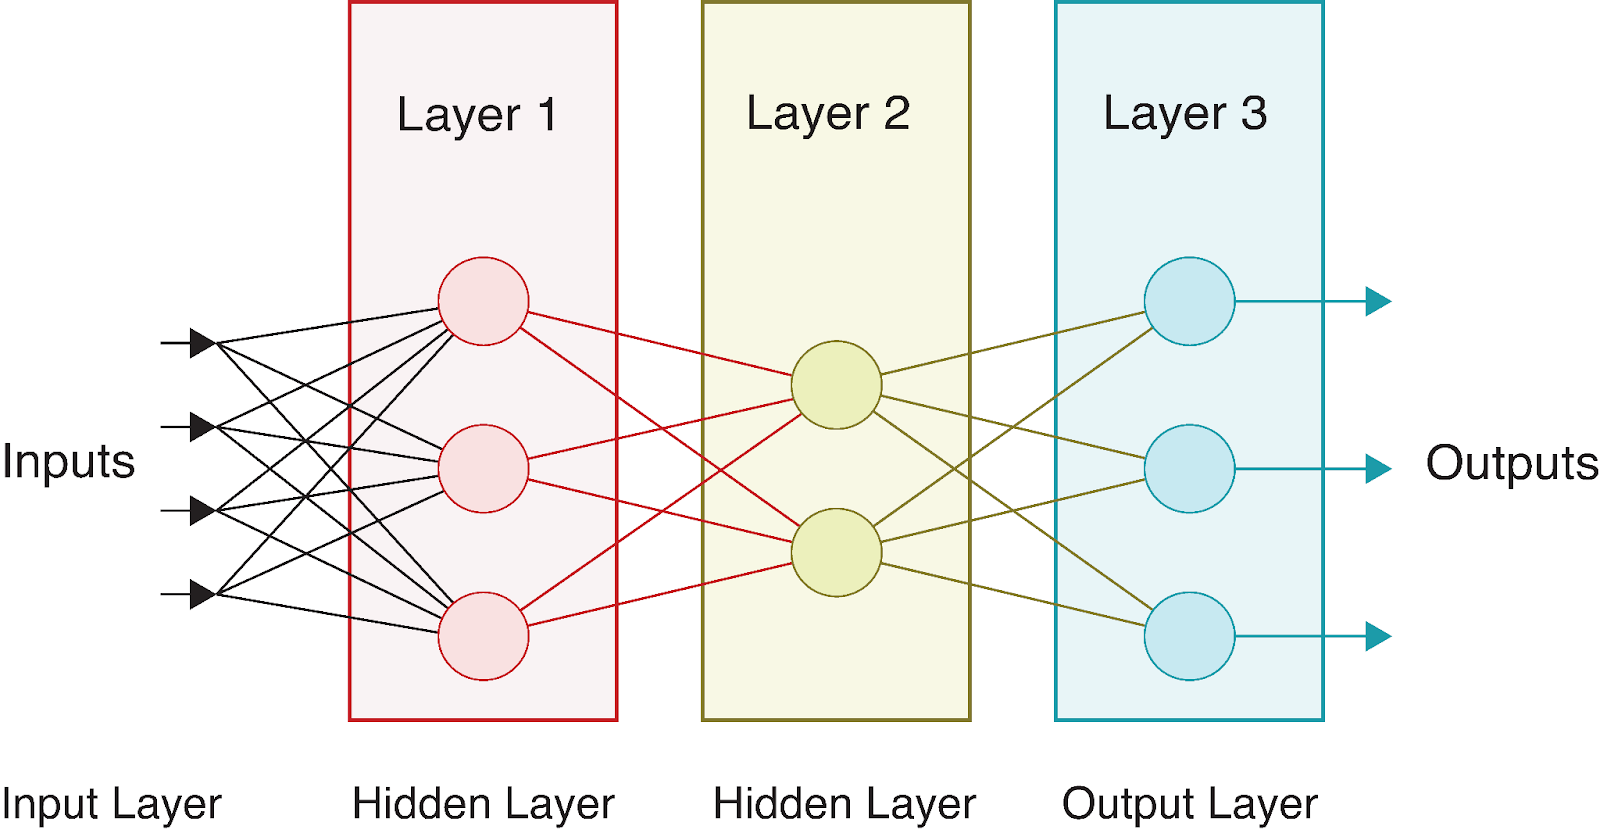
जैसे-जैसे डेटा इस नेटवर्क से होकर गुजरता है, हम हर परत पर कई गणनाएँ करते हैं। यदि हम निरूपित करें:
 (हिडन लेयर के लिए) और
 (आउटपुट लेयर के लिए)
 और

तो पूरे नेटवर्क में फ़ॉरवर्ड प्रोपेगेशन को हम इस प्रकार व्यक्त कर सकते हैं:
1. हिडन लेयर प्री-एक्टिवेशन की गणना:
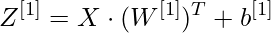
2. एक्टिवेशन फ़ंक्शन लगाकर हिडन लेयर आउटपुट पाना:
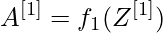
3. आउटपुट लेयर प्री-एक्टिवेशन की गणना:
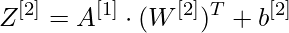
4. अंतिम आउटपुट पाने के लिए एक्टिवेशन फ़ंक्शन लगाना:
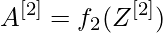
अंतिम आउटपुट A^[2] नेटवर्क की भविष्यवाणी का प्रतिनिधित्व करता है। वर्गीकरण में यह प्रत्येक श्रेणी की संभावनाएँ हो सकती हैं; रिग्रेशन में अनुमानित मान।
अलग-अलग परतें प्रायः अलग एक्टिवेशन फ़ंक्शन्स का प्रयोग करती हैं। उदाहरण के लिए, हिडन लेयर्स में सामान्यतः ReLU उपयोग होता है, जबकि आउटपुट लेयर में हो सकते हैं:
इस बहु-परत संरचना की खूबसूरती यह है कि प्रत्येक परत डेटा के अलग-अलग पहलुओं का प्रतिनिधित्व सीख सकती है। शुरुआती परतें सरल फ़ीचर्स पकड़ती हैं, जबकि गहरी परतें इन्हें जोड़कर अधिक जटिल पैटर्न बनाती हैं। यही पदानुक्रमित सीखना इमेज और स्पीच रिकग्निशन जैसे जटिल कार्यों में न्यूरल नेटवर्क्स को शक्तिशाली बनाता है।
आइए फ़ॉरवर्ड प्रोपेगेशन प्रक्रिया को एक एल्गोरिद्म में औपचारिक बनाएँ। L लेयर्स वाले एक न्यूरल नेटवर्क के लिए, फ़ॉरवर्ड प्रोपेगेशन के चरण इस प्रकार हैं:
# Pseudocode for forward propagation
def forward_propagation(X, parameters):
   """
   X: Input data (batch_size, n_features)
   parameters: Dictionary containing weights and biases for each layer
   Returns: The final output and all intermediate activations
   """
   # Store all activations for later use (e.g., in backpropagation)
   activations = {'A0': X}  # A0 is the input

   # Loop through L-1 layers (excluding the output layer)
   for l in range(1, L):
       # Get previous activation
       A_prev = activations[f'A{l-1}']

       # Get weights and biases for current layer
       W = parameters[f'W{l}']
       b = parameters[f'b{l}']

       # Compute pre-activation
       Z = np.dot(A_prev, W.T) + b

       # Apply activation function (e.g., ReLU for hidden layers)
       A = relu(Z)

       # Store values for later use
       activations[f'Z{l}'] = Z
       activations[f'A{l}'] = A

   # Compute output layer (layer L)
   A_prev = activations[f'A{L-1}']
   W = parameters[f'W{L}']
   b = parameters[f'b{L}']

   # Compute pre-activation for output layer
   Z = np.dot(A_prev, W.T) + b

   # Apply output activation function (depends on the task)
   if task == 'binary_classification':
       A = sigmoid(Z)
   elif task == 'multiclass_classification':
       A = softmax(Z)
   elif task == 'regression':
       A = Z  # Linear activation

   # Store output layer values
   activations[f'Z{L}'] = Z
   activations[f'A{L}'] = A

   return A, activations
यह एल्गोरिद्म फ़ॉरवर्ड प्रोपेगेशन के कई महत्वपूर्ण पहलुओं को रेखांकित करता है:
फ़ॉरवर्ड प्रोपेगेशन एल्गोरिद्म आश्चर्यजनक रूप से सरल है, फिर भी यह न्यूरल नेटवर्क्स को अत्यंत जटिल फ़ंक्शन्स का सन्निकटन करने देता है। जब इसे बैकप्रोपेगेशन के उपयुक्त प्रशिक्षण से जोड़ा जाता है, तो यही सरल प्रक्रिया नेटवर्क को डेटा से सीखने और लगातार अधिक सटीक भविष्यवाणियाँ करने में सक्षम बनाती है।
समझ को और पक्का करने के लिए एक विशिष्ट उदाहरण ट्रेस करें। इनपुट X = [0.5, -0.2, 0.1] को हमारे उदाहरण नेटवर्क से गुज़रते हुए मानें, जिसमें:
सरलता के लिए, मान लें सभी वेट्स 0.1 हैं और सभी बायस 0:
X = [0.5, -0.2, 0.1]
W[1] = [[0.1, 0.1, 0.1], [0.1, 0.1, 0.1], [0.1, 0.1, 0.1], [0.1, 0.1, 0.1]]
b[1] = [0, 0, 0, 0]
W[2] = [[0.1, 0.1, 0.1, 0.1], [0.1, 0.1, 0.1, 0.1]]
b[2] = [0, 0]
हमारे एल्गोरिद्म का पालन करते हुए:
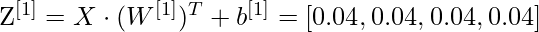
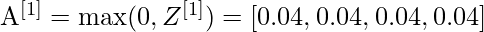
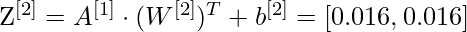
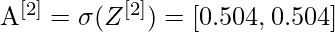
यह हमें अंतिम भविष्यवाणी देता है। बाइनरी वर्गीकरण के संदर्भ में, 0.5 के आस-पास के मान दो श्रेणियों के बीच अनिश्चितता दर्शाते हैं।
अगले भाग में, हम Python में फ़ॉरवर्ड प्रोपेगेशन लागू करेंगे ताकि इन गणनाओं को क्रिया में देखें।
अब जब हम फ़ॉरवर्ड प्रोपेगेशन का सिद्धांत समझ गए हैं, तो आइए इसे Python में लागू करें। हम केवल NumPy का उपयोग करके “स्क्रैच से” कार्यान्वयन से शुरू करेंगे, फिर देखेंगे कि आधुनिक डीप लर्निंग फ़्रेमवर्क्स इस प्रक्रिया को कैसे सरल बनाते हैं।
NumPy कुशल ऐरे ऑपरेशन्स प्रदान करता है, जिनसे हम चर्चा किए गए मैट्रिक्स कैलकुलेशन्स लागू कर सकते हैं। आइए एक सरल न्यूरल नेटवर्क क्लास बनाते हैं जो कई परतों के माध्यम से फ़ॉरवर्ड प्रोपेगेशन करता है।
सबसे पहले, आवश्यक लाइब्रेरीज़ आयात करें:
import numpy as np
import matplotlib.pyplot as plt

# For reproducibility
np.random.seed(42)
अब, वे एक्टिवेशन फ़ंक्शन्स परिभाषित करें जो हम अपने नेटवर्क में उपयोग करेंगे:
def relu(Z):
   """ReLU activation function: max(0, Z)"""
   return np.maximum(0, Z)

def sigmoid(Z):
   """Sigmoid activation function: 1/(1 + e^(-Z))"""
   return 1 / (1 + np.exp(-Z))

def softmax(Z):
   """Softmax activation function for multi-class classification"""
   # Subtract max for numerical stability (prevents overflow)
   exp_Z = np.exp(Z - np.max(Z, axis=1, keepdims=True))
   return exp_Z / np.sum(exp_Z, axis=1, keepdims=True)
अगला, अपने न्यूरल नेटवर्क के लिए एक क्लास बनाएँ:
class NeuralNetwork:
   def __init__(self, layer_dims, activations):
       """
       Initialize a neural network with specified layer dimensions and activations

       Parameters:
       - layer_dims: List of integers representing the number of neurons in each layer
                    (including input and output layers)
       - activations: List of activation functions for each layer (excluding input layer)
       """
       self.L = len(layer_dims) - 1  # Number of layers (excluding input layer)
       self.layer_dims = layer_dims
       self.activations = activations
       self.parameters = {}

       # Initialize parameters (weights and biases)
       self.initialize_parameters()

   def initialize_parameters(self):
       """Initialize weights and biases with small random values"""
       for l in range(1, self.L + 1):
           # He initialization for weights - helps with training deep networks
           self.parameters[f'W{l}'] = np.random.randn(self.layer_dims[l], self.layer_dims[l-1]) * np.sqrt(2 / self.layer_dims[l-1])
           self.parameters[f'b{l}'] = np.zeros((self.layer_dims[l], 1))

   def forward_propagation(self, X):
       """
       Perform forward propagation through the network

       Parameters:
       - X: Input data (n_features, batch_size)

       Returns:
       - AL: Output of the network
       - caches: Dictionary containing all activations and pre-activations
       """
       caches = {}
       A = X  # Input layer activation
       caches['A0'] = X

       # Process through L-1 layers (excluding output layer)
       for l in range(1, self.L):
           A_prev = A

           # Get weights and biases for current layer
           W = self.parameters[f'W{l}']
           b = self.parameters[f'b{l}']

           # Forward propagation for current layer
           Z = np.dot(W, A_prev) + b

           # Apply activation function
           activation_function = self.activations[l-1]
           if activation_function == "relu":
               A = relu(Z)
           elif activation_function == "sigmoid":
               A = sigmoid(Z)

           # Store values for backpropagation
           caches[f'Z{l}'] = Z
           caches[f'A{l}'] = A

       # Output layer
       W = self.parameters[f'W{self.L}']
       b = self.parameters[f'b{self.L}']
       Z = np.dot(W, A) + b

       # Apply output activation function
       activation_function = self.activations[self.L-1]
       if activation_function == "sigmoid":
           AL = sigmoid(Z)
       elif activation_function == "softmax":
           AL = softmax(Z)
       elif activation_function == "linear":
           AL = Z  # No activation for regression

       # Store output layer values
       caches[f'Z{self.L}'] = Z
       caches[f'A{self.L}'] = AL

       return AL, caches
उपरोक्त NeuralNetwork क्लास एक कस्टमाइज़ेबल आर्किटेक्चर के साथ न्यूरल नेटवर्क बनाने और उपयोग करने के लिए पूर्ण ढाँचा देती है। इसके प्रमुख घटक इस प्रकार हैं:
forward_propagation मेथड लागू किया, वही नेटवर्क की भविष्यवाणी क्षमता का हृदय है। यह:3. एक्टिवेशन फ़ंक्शन्स: नेटवर्क ReLU, sigmoid, और softmax सहित कई एक्टिवेशन फ़ंक्शन्स का समर्थन करता है, जिससे यह रिग्रेशन और वर्गीकरण दोनों प्रकार की समस्याएँ संभाल सकता है।
4. लचीला आर्किटेक्चर: यह कार्यान्वयन मनचाही गहराई और चौड़ाई वाले नेटवर्क बनाने देता है, जो विभिन्न मशीन लर्निंग कार्यों के लिए उपयुक्त है।
यह कार्यान्वयन उस मानक पैटर्न का अनुसरण करता है जहाँ डेटा नेटवर्क में आगे की ओर बहता है, और प्रत्येक परत डेटा को बदलकर अगली परत को पास करती है।
अब एक छोटे उदाहरण नेटवर्क के साथ अपने कार्यान्वयन का परीक्षण करें:
# Create a sample network
# Input layer: 3 features
# Hidden layer 1: 4 neurons with ReLU activation
# Output layer: 2 neurons with sigmoid activation (binary classification)
layer_dims = [3, 4, 2]
activations = ["relu", "sigmoid"]
nn = NeuralNetwork(layer_dims, activations)

# Create sample input data - 3 features for 5 examples
X = np.random.randn(3, 5)

# Perform forward propagation
output, caches = nn.forward_propagation(X)

print(f"Input shape: {X.shape}")
print(f"Output shape: {output.shape}")
print(f"Output values:\n{output}")आउटपुट:
Input shape: (3, 5)
Output shape: (2, 5)
Output values:
[[0.00386784 0.54343014 0.39661893 0.5        0.51056934]
[0.11877049 0.32541093 0.44840699 0.5        0.45586633]]
आइए यह भी विज़ुअलाइज़ करें कि नेटवर्क से गुजरते हुए डेटा कैसे रूपांतरित होता है:
def visualize_activations(caches, example_idx=0):
   """Visualize the activations for a single example through the network"""
   plt.figure(figsize=(15, 6))

   # Plot input
   plt.subplot(1, 3, 1)
   plt.bar(range(caches['A0'].shape[0]), caches['A0'][:, example_idx])
   plt.title('Input Layer')
   plt.xlabel('Feature')
   plt.ylabel('Value')

   # Plot hidden layer activation
   plt.subplot(1, 3, 2)
   plt.bar(range(caches['A1'].shape[0]), caches['A1'][:, example_idx])
   plt.title('Hidden Layer (ReLU Activation)')
   plt.xlabel('Neuron')
   plt.ylabel('Activation')

   # Plot output layer
   plt.subplot(1, 3, 3)
   plt.bar(range(caches['A2'].shape[0]), caches['A2'][:, example_idx])
   plt.title('Output Layer (Sigmoid Activation)')
   plt.xlabel('Neuron')
   plt.ylabel('Activation')

   plt.tight_layout()
   plt.show()

# Visualize the first example
visualize_activations(caches)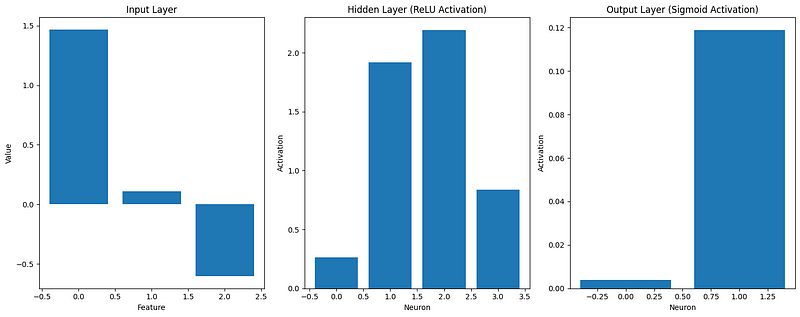
यह विज़ुअलाइज़ेशन दिखाता है कि नेटवर्क से गुजरते हुए इनपुट डेटा कैसे रूपांतरित होता है। हम देख सकते हैं कि:
हमारा “स्क्रैच से” कार्यान्वयन फ़ॉरवर्ड प्रोपेगेशन के मूल सिद्धांत दर्शाता है, लेकिन आधुनिक फ़्रेमवर्क्स न्यूरल नेटवर्क बनाने के लिए अधिक कुशल और लचीले उपकरण देते हैं।
अब, लोकप्रिय डीप लर्निंग फ़्रेमवर्क्स—TensorFlow और PyTorch—का उपयोग करके वही न्यूरल नेटवर्क लागू करें। ये फ़्रेमवर्क्स प्रदर्शन को अनुकूलित करते हैं और उच्च-स्तर के एब्स्ट्रैक्शंस देते हैं, जिससे जटिल मॉडल बनाना आसान होता है।
पहले, TensorFlow/Keras का कार्यान्वयन देखें:
import tensorflow as tf
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, Input

# For reproducibility
tf.random.set_seed(42)

# Create the same network architecture
tf_model = Sequential([
   Input(shape=(3,)),  # Input layer with 3 features
   Dense(4, activation='relu'),  # Hidden layer with 4 neurons
   Dense(2, activation='sigmoid')  # Output layer with 2 neurons
])

tf_model.summary()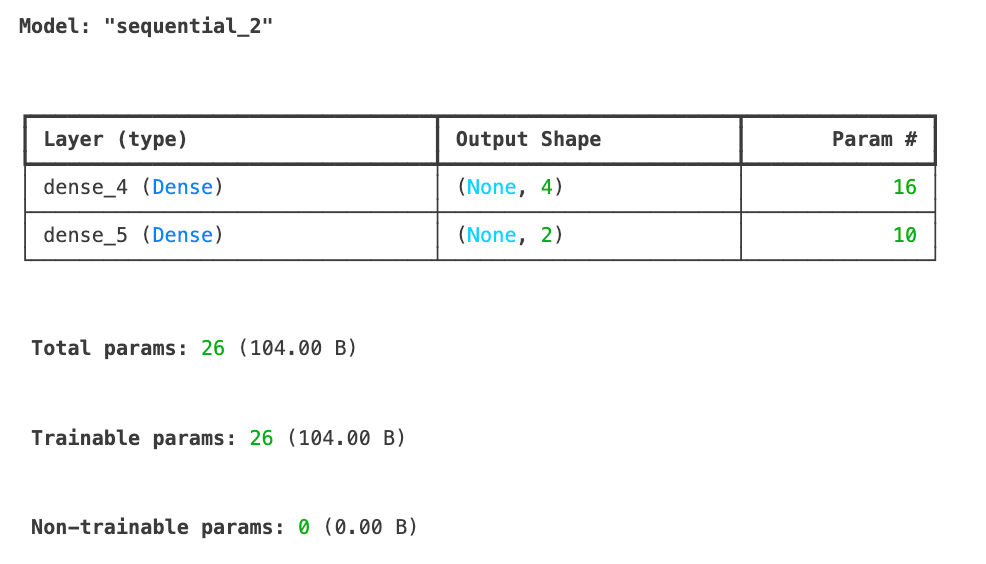
# Sample input data with the shape expected by Keras
X_tf = np.random.randn(5, 3)  # 5 examples, 3 features

# Forward propagation in TensorFlow
tf_output = tf_model.predict(X_tf)

print(f"TensorFlow output shape: {tf_output.shape}")
print(f"TensorFlow output values:\n{tf_output}")
TensorFlow output shape: (5, 2)
TensorFlow output values:
[[0.6855308 0.7139542 ]
[0.4952355 0.5231934 ]
[0.50174904 0.5198488 ]
[0.44331825 0.6860926 ]
[0.6624589 0.5385444 ]]अभी हमने TensorFlow/Keras का उपयोग करके अपना न्यूरल नेटवर्क लागू किया और कुछ नमूना डेटा पर फ़ॉरवर्ड प्रोपेगेशन सफलतापूर्वक किया। मॉडल समरी हमारी आर्किटेक्चर दिखाती है—3 फ़ीचर्स लेने वाला इनपुट लेयर, 4 न्यूरॉन्स वाला ReLU हिडन लेयर, और 2 न्यूरॉन्स वाला sigmoid आउटपुट लेयर। कुल मिलाकर मॉडल में 26 ट्रेन करने योग्य पैरामीटर्स हैं।
फ़ॉरवर्ड प्रोपेगेशन के परिणाम आउटपुट शेप (5, 2) दिखाते हैं—हमारे 5 इनपुट उदाहरणों के लिए प्रत्येक में 2 आउटपुट मान। आउटपुट लेयर में sigmoid होने के कारण ये मान 0 और 1 के बीच सीमित होते हैं।
अब देखते हैं कि PyTorch का उपयोग करके वही आर्किटेक्चर कैसे बनाया जा सकता है, ताकि तरीकों की तुलना की जा सके।
import torch
import torch.nn as nn

# For reproducibility
torch.manual_seed(42)

# Create a network in PyTorch
class PyTorchNN(nn.Module):
   def __init__(self):
       super(PyTorchNN, self).__init__()
       self.hidden = nn.Linear(3, 4)  # 3 inputs, 4 hidden neurons
       self.relu = nn.ReLU()
       self.output = nn.Linear(4, 2)  # 4 inputs from hidden, 2 outputs
       self.sigmoid = nn.Sigmoid()

   def forward(self, x):
       x = self.relu(self.hidden(x))
       x = self.sigmoid(self.output(x))
       return x

# Instantiate the model
torch_model = PyTorchNN()

# Print model structure
print(torch_model)आउटपुट:
PyTorchNN(
 (hidden): Linear(in_features=3, out_features=4, bias=True)
 (relu): ReLU()
 (output): Linear(in_features=4, out_features=2, bias=True)
 (sigmoid): Sigmoid()
)

```python
# Sample input data
X_torch = torch.randn(5, 3)  # 5 examples, 3 features

# Forward propagation in PyTorch
torch_output = torch_model(X_torch)

print(f"PyTorch output shape: {torch_output.shape}")
print(f"PyTorch output values:\n{torch_output}")आउटपुट:
PyTorch output shape: torch.Size([5, 2])
PyTorch output values:
tensor([[0.4516, 0.4116],
       [0.4289, 0.4267],
       [0.4278, 0.4172],
       [0.3771, 0.4321],
       [0.5769, 0.3328]], grad_fn=<SigmoidBackward0>)
अब अपने कार्यान्वयनों की तुलना करें:
# Compare dimensions and structure of outputs
print("\nComparison of implementations:")
print(f"NumPy output shape: {output.shape}")
print(f"TensorFlow output shape: {tf_output.shape}")
print(f"PyTorch output shape: {torch_output.shape}")आउटपुट:
Comparison of implementations:
NumPy output shape: (2, 5)
TensorFlow output shape: (5, 2)
PyTorch output shape: torch.Size([5, 2])
हमारे कार्यान्वयनों के बीच मुख्य अंतर:
सरल नेटवर्क्स के लिए हमारा NumPy कार्यान्वयन पर्याप्त है, लेकिन जटिलता बढ़ने पर डीप लर्निंग फ़्रेमवर्क्स आवश्यक हो जाते हैं। वे लो-लेवल अनुकूलन सँभालते हैं और विकास से लेकर तैनाती तक पूरे वर्कफ़्लो के लिए टूल्स देते हैं। इन फ़्रेमवर्क्स पर और जानने के लिए ये अलग गाइड देखें:
अगले भाग में, हम एक संपूर्ण कार्यशील उदाहरण बनाएँगे जो वास्तविक समस्या पर फ़ॉरवर्ड प्रोपेगेशन लागू करता है।
अब जब हमने फ़ॉरवर्ड प्रोपेगेशन को स्क्रैच से और लोकप्रिय फ़्रेमवर्क्स के साथ लागू कर लिया है, तो इसे वास्तविक समस्या पर क्रिया में देखें। हम एक संपूर्ण उदाहरण बनाएँगे और बेहतर प्रदर्शन के लिए प्रक्रिया को अनुकूलित करना देखेंगे।
हाथ से लिखे अंकों की पहचान (MNIST डेटासेट) जैसी क्लासिक समस्या पर अपना ज्ञान लागू करें। इस डेटासेट में 70,000 इमेज़ (0–9) हैं, प्रत्येक 28x28 पिक्सेल।
पहले डेटा लोड और तैयार करें:
from tensorflow.keras.datasets import mnist
import numpy as np
import matplotlib.pyplot as plt

# Load MNIST dataset
(X_train, y_train), (X_test, y_test) = mnist.load_data()

# Normalize pixel values to range [0, 1]
X_train = X_train / 255.0
X_test = X_test / 255.0

# Reshape images to vectors (flatten 28x28 to 784)
X_train_flat = X_train.reshape(X_train.shape[0], -1).T  # Shape: (784, 60000)
X_test_flat = X_test.reshape(X_test.shape[0], -1).T     # Shape: (784, 10000)

# Convert labels to one-hot encoding
def one_hot_encode(y, num_classes=10):
   one_hot = np.zeros((num_classes, y.size))
   one_hot[y, np.arange(y.size)] = 1
   return one_hot

y_train_one_hot = one_hot_encode(y_train)  # Shape: (10, 60000)
y_test_one_hot = one_hot_encode(y_test)    # Shape: (10, 10000)

# Display sample images
plt.figure(figsize=(10, 5))
for i in range(5):
   plt.subplot(1, 5, i+1)
   plt.imshow(X_train[i], cmap='gray')
   plt.title(f"Label: {y_train[i]}")
   plt.axis('off')
plt.tight_layout()
plt.show()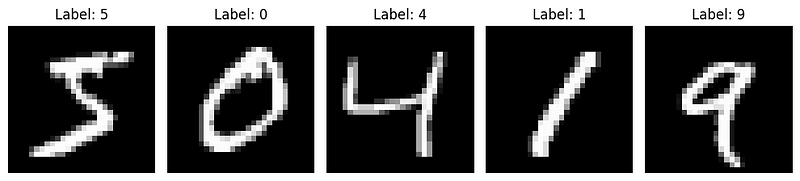
अब, अपने NumPy कार्यान्वयन से इस कार्य के लिए एक न्यूरल नेटवर्क बनाएँ। हम यह नेटवर्क बनाएँगे:
# Define our network architecture
layer_dims = [784, 128, 10]
activations = ["relu", "softmax"]
nn = NeuralNetwork(layer_dims, activations)

# Take a small batch for demonstration
batch_size = 64
batch_indices = np.random.choice(X_train_flat.shape[1], batch_size, replace=False)
X_batch = X_train_flat[:, batch_indices]
y_batch = y_train_one_hot[:, batch_indices]

# Perform forward propagation
output, caches = nn.forward_propagation(X_batch)

# Compute accuracy
predictions = np.argmax(output, axis=0)
true_labels = np.argmax(y_batch, axis=0)
accuracy = np.mean(predictions == true_labels)

print(f"Batch accuracy: {accuracy:.4f}")

Out: Batch accuracy: 0.0781
हमें 7% सटीकता मिली, जो यादृच्छिक अनुमान से भी कम है। लेकिन यह अपेक्षित है क्योंकि हम केवल फ़ॉरवर्ड प्रोपेगेशन कर रहे हैं—अभी किसी तरह का सीखना (ट्रेनिंग) शामिल नहीं है।
अब देखें कि नेटवर्क एक एकल इमेज़ को हर परत से गुजरते हुए कैसे प्रोसेस करता है:
def visualize_network_processing(nn, image, label, caches):
   """Visualize network processing for a single image"""
   plt.figure(figsize=(15, 10))

   # Plot original image
   plt.subplot(2, 3, 1)
   plt.imshow(image.reshape(28, 28), cmap='gray')
   plt.title(f"Input Image (Digit: {label})")
   plt.axis('off')

   # Plot flattened input (first 100 values)
   plt.subplot(2, 3, 2)
   plt.bar(range(100), image.flatten()[:100])
   plt.title("Input Layer (first 100 pixels)")
   plt.xlabel("Pixel Index")
   plt.ylabel("Pixel Value")

   # Plot hidden layer activations (first 50 neurons)
   plt.subplot(2, 3, 3)
   hidden_activations = caches['A1'][:50, 0]
   plt.bar(range(len(hidden_activations)), hidden_activations)
   plt.title("Hidden Layer Activations (first 50 neurons)")
   plt.xlabel("Neuron Index")
   plt.ylabel("Activation")

   # Plot output layer activations
   plt.subplot(2, 3, 4)
   output_activations = caches['A2'][:, 0]
   plt.bar(range(10), output_activations)
   plt.xticks(range(10))
   plt.title("Output Layer Activations (Softmax)")
   plt.xlabel("Digit Class")
   plt.ylabel("Probability")

   # Plot prediction vs actual
   plt.subplot(2, 3, 5)
   prediction = np.argmax(output_activations)
   plt.bar(['Actual', 'Predicted'], [label, prediction], color=['blue', 'orange'])
   plt.title(f"Prediction: {prediction}, Actual: {label}")
   plt.ylabel("Digit")

   plt.tight_layout()
   plt.show()

# Visualize forward propagation for the first image in our batch
image_idx = 0
image = X_batch[:, image_idx].reshape(784, 1)
label = true_labels[image_idx]

visualize_network_processing(nn, image, label, caches)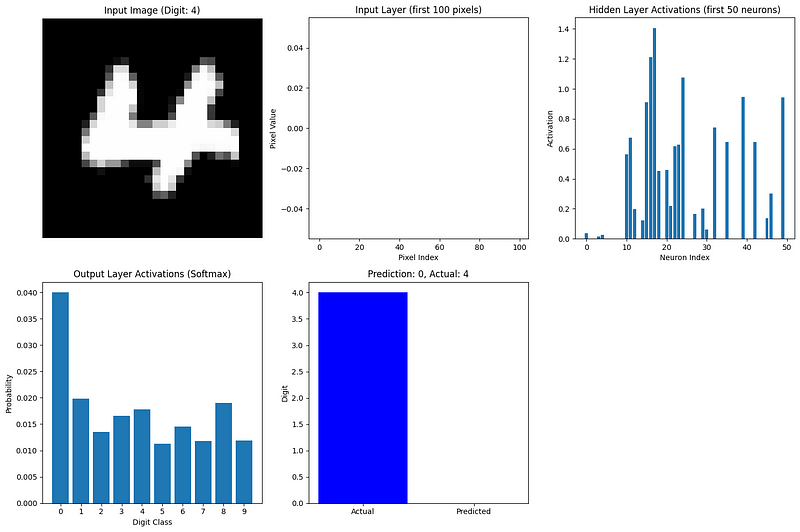
यह विज़ुअलाइज़ेशन दिखाता है कि सूचना हमारे नेटवर्क से कैसे बहती है:
सबसे सक्रिय आउटपुट न्यूरॉन नेटवर्क की भविष्यवाणी से मेल खाता है। भले ही वेट्स यादृच्छिक हों (क्योंकि हमने अभी तक ट्रेनिंग नहीं की), हम देख सकते हैं कि फ़ॉरवर्ड प्रोपेगेशन इनपुट डेटा को भविष्यवाणी में कैसे बदलता है।
पूरा उदाहरण बनाने के लिए, हम बैकप्रोपेगेशन से इस नेटवर्क को प्रशिक्षित करेंगे—वेट्स और बायस समायोजित करके समय के साथ भविष्यवाणियाँ सुधारी जाएँगी। पर बिना प्रशिक्षण के भी, यह उदाहरण वास्तविक डेटा पर फ़ॉरवर्ड प्रोपेगेशन की प्रक्रिया दर्शाता है।
जैसे-जैसे नेटवर्क बड़े और डेटासेट विशाल होते जाते हैं, फ़ॉरवर्ड प्रोपेगेशन का अनुकूलन अहम हो जाता है। यहाँ कुछ प्रमुख रणनीतियाँ हैं:
एक समय में एक उदाहरण प्रोसेस करने के बजाय, हम एक साथ उदाहरणों के बैच पर फ़ॉरवर्ड प्रोपेगेशन करते हैं। इससे आधुनिक हार्डवेयर की पैरेलल प्रोसेसिंग क्षमता का लाभ मिलता है।
लूप्स की जगह मैट्रिक्स ऑपरेशन्स का उपयोग गणना को बहुत तेज़ कर देता है। इसलिए हमारे कार्यान्वयन में NumPy ऐरे ऑपरेशन्स का उपयोग किया गया।
बड़े नेटवर्क्स में मेमोरी उपयोग का ध्यान रखना पड़ता है। तकनीकों में शामिल हैं:
ग्राफ़िक्स प्रोसेसिंग यूनिट्स मैट्रिक्स ऑपरेशनों में निपुण होती हैं। आधुनिक फ़्रेमवर्क्स सरलता से गणना को GPU पर ले जा सकते हैं, जिससे बड़ा स्पीडअप मिलता है:
# TensorFlow example of GPU acceleration
import tensorflow as tf

# Check for available GPUs
print("GPUs Available:", tf.config.list_physical_devices('GPU'))

# TensorFlow automatically uses available GPUs
with tf.device('/GPU:0'):  # Explicitly specify GPU if multiple are available
   # Computation runs on GPU if available
result = tf_model.predict(X_tf)GPUs से आगे, Google के Tensor Processing Units (TPUs) जैसे हार्डवेयर विशेष रूप से न्यूरल नेटवर्क ऑपरेशन्स के लिए बनाए गए हैं।
कुछ एक्टिवेशन फ़ंक्शन्स और नेटवर्क आर्किटेक्चर संगणनात्मक दक्षता के लिए डिज़ाइन किए गए हैं:
डीप लर्निंग फ़्रेमवर्क्स कई लो-लेवल अनुकूलन लागू करते हैं:
जैसे-जैसे नेटवर्क गहरे और चौड़े होते जाते हैं, फ़ॉरवर्ड प्रोपेगेशन का अनुकूलन और महत्वपूर्ण होता जाता है। ResNets, Transformers और EfficientNets जैसी आधुनिक आर्किटेक्चर्स फ़ॉरवर्ड प्रोपेगेशन को अधिक कुशल बनाने के लिए विशेष डिज़ाइन विकल्पों को शामिल करती हैं, जबकि मॉडल सटीकता बरकरार या बेहतर रहती है।
अगले भाग में, हम देखेंगे कि फ़ॉरवर्ड प्रोपेगेशन का बैकप्रोपेगेशन से क्या संबंध है—यही पूरी सीखने की प्रक्रिया को पूर्ण करता है।
हमने अब फ़ॉरवर्ड प्रोपेगेशन को विस्तार से देखा है, पर न्यूरल नेटवर्क्स के संदर्भ में यह कहानी का केवल आधा हिस्सा है। आइए संक्षेप में देखें कि फ़ॉरवर्ड प्रोपेगेशन का बैकप्रोपेगेशन से कैसा संबंध है—यही एल्गोरिद्म नेटवर्क को सीखने में सक्षम बनाता है।
फ़ॉरवर्ड प्रोपेगेशन और बैकप्रोपेगेशन न्यूरल नेटवर्क्स में पूरक प्रक्रियाएँ हैं:
ये दोनों प्रक्रियाएँ सीखने में अविभाज्य हैं। बैकप्रोपेगेशन फ़ॉरवर्ड प्रोपेगेशन के बिना नहीं हो सकता, क्योंकि उसे चाहिए:
फ़ॉरवर्ड प्रोपेगेशन को ऐसे समझें जैसे नेटवर्क अपनी मौजूदा समझ के आधार पर सर्वोत्तम अनुमान लगा रहा है, जबकि बैकप्रोपेगेशन उन गलतियों के आधार पर उस समझ को परिष्कृत करता है।
पूरी सीखने की प्रक्रिया एक चक्रीय पैटर्न का अनुसरण करती है:
इस प्रक्रिया की शक्ति इसलिए है क्योंकि फ़ॉरवर्ड प्रोपेगेशन बैकप्रोपेगेशन के लिए आवश्यक संदर्भ प्रदान करता है। फ़ॉरवर्ड चरण में, नेटवर्क न केवल भविष्यवाणी करता है बल्कि सभी मध्यवर्ती मानों और निर्णयों का हिसाब भी रखता है। बैकप्रोपेगेशन फिर इन्हीं सूचनाओं का उपयोग लक्षित समायोजन करने में करता है।
इस व्यवस्था की खूबसूरती यह है कि दो अपेक्षाकृत सरल प्रक्रियाओं के साथ मिलकर जटिल सीखना उभरता है। फ़ॉरवर्ड प्रोपेगेशन सीधा है—बस क्रम से मैट्रिक्स गुणन और एक्टिवेशन फ़ंक्शन्स। बैकप्रोपेगेशन अधिक जटिल है, पर सीधे-सीधे कलन सिद्धांतों से निकलता है।
मिलकर, ये न्यूरल नेटवर्क्स को पर्याप्त डेटा और कम्प्यूटेशनल संसाधनों के साथ लगभग किसी भी पैटर्न को सीखने में सक्षम बनाते हैं। इसी सीखने की क्षमता ने कंप्यूटर विज़न, नेचुरल लैंग्वेज प्रोसेसिंग, गेम-प्लेइंग और असंख्य अन्य क्षेत्रों में प्रगति को गति दी है।
इस लेख में फ़ॉरवर्ड प्रोपेगेशन को गहराई से समझना—पूरी सीखने की प्रक्रिया को समझने की नींव देता है। सीखने के पहलू में और गहराई से जाने के लिए, हमारे backpropagation गाइड में देखें कि नेटवर्क्स अपनी गलतियों से कैसे सीखते हैं।
फ़ॉरवर्ड प्रोपेगेशन वह आधारभूत प्रक्रिया है जो न्यूरल नेटवर्क्स को इनपुट्स को भविष्यवाणियों में बदलने देती है। जैसा कि हमने देखा, इसमें क्रमिक मैट्रिक्स गुणन और एक्टिवेशन फ़ंक्शन शामिल हैं जो डेटा को परत-दर-परत रूपांतरित करते हैं। चाहे आप स्क्रैच से नेटवर्क लागू कर रहे हों, आधुनिक फ़्रेमवर्क्स का उपयोग कर रहे हों, या मॉडल प्रदर्शन को ट्रबलशूट कर रहे हों—इस प्रक्रिया को समझना अत्यंत महत्वपूर्ण है।
फ़ॉरवर्ड प्रोपेगेशन में महारत हासिल करके, आपने गहन शिक्षण मॉडलों को बनाने और समझने की दिशा में एक महत्वपूर्ण कदम उठा लिया है—जो विभिन्न क्षेत्रों में जटिल समस्याओं को सुलझा सकते हैं।
अपनी डीप लर्निंग यात्रा जारी रखने के लिए, DataCamp के व्यापक संसाधन देखें:
एक संरचित लर्निंग पाथ के लिए, Deep Learning in Python ट्रैक आपको वास्तविक अनुप्रयोगों के लिए न्यूरल नेटवर्क बनाना और तैनात करना सिखाने हेतु आवश्यक सब कुछ प्रदान करता है।
शीर्ष DataCamp कोर्स
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {कोर्स} other {कोर्स}}