
Last chance! 50% off DataCamp Premium
Sale ends in
GPTCache adalah kerangka kerja open-source untuk aplikasi model bahasa besar (LLM) seperti ChatGPT. Ia menyimpan respons LLM yang sebelumnya dihasilkan untuk kueri serupa. Alih-alih bergantung pada LLM, aplikasi memeriksa cache untuk menemukan respons yang relevan agar menghemat waktu Anda.
Panduan ini membahas cara kerja GPTCache dan bagaimana Anda dapat menggunakannya secara efektif dalam proyek Anda.
GPTCache adalah sistem caching yang dirancang untuk meningkatkan kinerja dan efisiensi model bahasa besar (LLM) seperti GPT-3. Sistem ini membantu LLM menyimpan kueri yang sebelumnya dihasilkan untuk menghemat waktu dan upaya.
Ketika kueri serupa muncul kembali, LLM dapat menampilkan respons yang disimpan di cache alih-alih mengembangkan yang baru dari awal.
Berbeda dari alat lain, GPTCache bekerja dengan caching semantik. Cache semantik menyimpan tujuan dari suatu kueri/permintaan. Hasilnya, ketika kueri yang tersimpan sebelumnya dipanggil kembali, hasilnya mengurangi beban kerja server dan meningkatkan tingkat hit cache.
Gagasan utama di balik GPTCache adalah menyimpan dan menggunakan kembali perhitungan perantara yang dihasilkan selama proses inferensi LLM. Melakukannya memberikan beberapa manfaat:
Kebanyakan LLM mengenakan biaya per permintaan berdasarkan jumlah token yang diproses. Di sinilah GPTCache berguna. Ia meminimalkan jumlah panggilan API LLM dengan menyajikan respons yang sebelumnya dihasilkan untuk kueri serupa. Akibatnya, ini menghemat biaya dengan mengurangi pengeluaran panggilan LLM tambahan.
Mengambil respons dari cache jauh lebih cepat daripada menghasilkan dari awal dengan melakukan kueri ke LLM. Ini meningkatkan kecepatan dan memperbaiki waktu respons. Respons yang efisien mengurangi beban pada LLM itu sendiri dan membebaskan ruang yang dapat dialokasikan untuk tugas lain.
Misalkan Anda mencari pertanyaan untuk konten Anda. Setiap pertanyaan yang Anda ajukan membutuhkan waktu lama bagi AI untuk menjawab. Mengapa? Karena sebagian besar layanan LLM menerapkan batas permintaan dalam periode tertentu. Melewati batas ini akan memblokir permintaan lebih lanjut hingga batas diatur ulang, yang menyebabkan gangguan layanan.
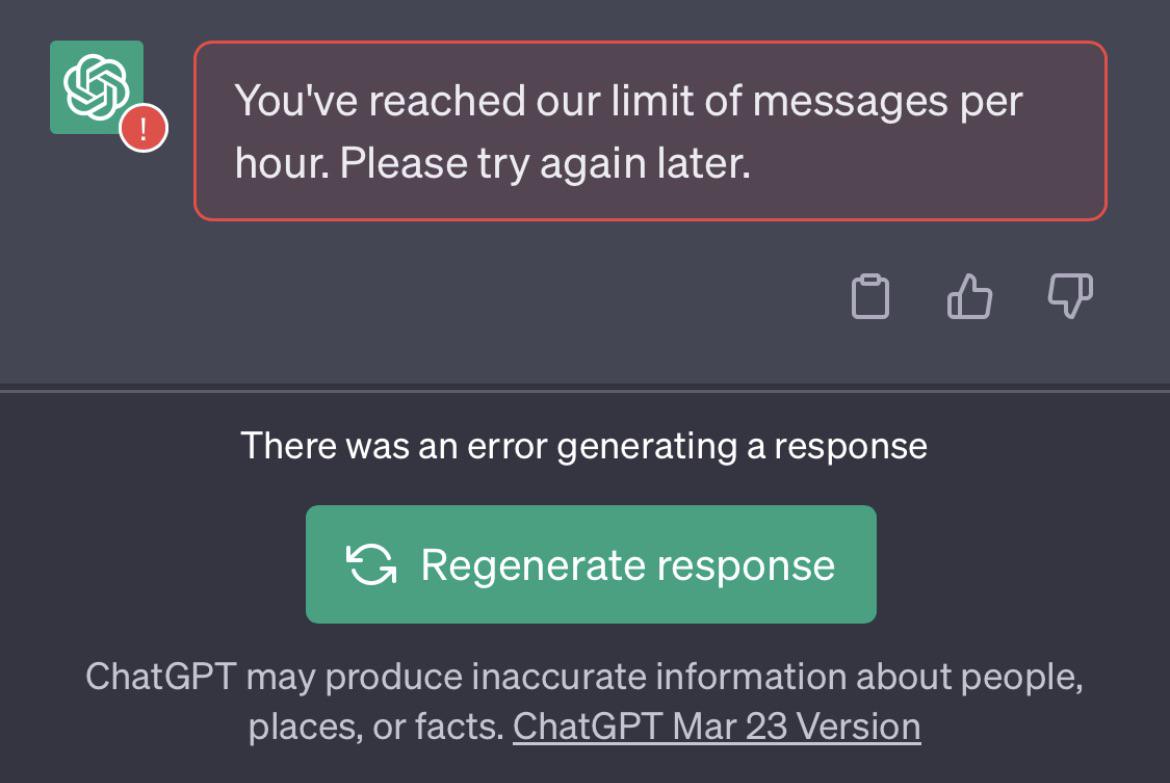
ChatGPT dapat mencapai batas pembuatan respons
Untuk menghindari masalah ini, GPTchache menyimpan jawaban sebelumnya untuk pertanyaan serupa. Saat Anda meminta sesuatu, ia dengan cepat memeriksa ingatannya dan menyajikan informasi seketika. Hasilnya, Anda mendapatkan respons dalam waktu yang lebih singkat dari biasanya.
Singkatnya, dengan memanfaatkan respons yang di-cache, GPTCache memastikan aplikasi berbasis LLM menjadi responsif dan efisien—seperti yang Anda harapkan dari alat modern mana pun.
Berikut cara menginstal GPTCache secara langsung:
Instal paket GPTCache menggunakan kode berikut.
! pip install -q gptcacheSelanjutnya, impor GPTCache ke aplikasi Anda.
from gptcache import GPTCache
cache = GPTCache()
# keep the mode default
Itu saja, selesai!
Anda dapat mengintegrasikan GPTCache dengan LLM melalui LLM Adapter. Untuk saat ini, ia kompatibel hanya dengan dua adapter model bahasa besar:
Berikut cara mengintegrasikannya dengan kedua adapter tersebut:
Untuk mengintegrasikan GPTCache dengan OpenAI, inisialisasi cache dan impor openai dari gptcache.adapter.
from gptcache import cache
from gptcache.adapter import openai

cache.init()
cache.set_openai_key()
Sebelum Anda menjalankan contoh kode, atur variabel lingkungan OPENAI_API_KEY dengan mengeksekusi echo $OPENAI_API_KEY.
Jika belum diatur, Anda dapat mengaturnya dengan menggunakan export OPENAI_API_KEY=YOUR_API_KEY pada sistem Unix/Linux/MacOS atau set OPENAI_API_KEY=YOUR_API_KEY pada sistem Windows.
Lalu, jika Anda menanyakan dua pertanyaan yang sama persis kepada ChatGPT, jawaban untuk pertanyaan kedua akan diambil dari cache alih-alih menanyakan ChatGPT lagi.
Berikut contoh kode untuk cache penelusuran serupa:
import time


def response_text(openai_resp):
    return openai_resp['choices'][0]['message']['content']

print("Cache loading.....")

# To use GPTCache, that's all you need
# -------------------------------------------------
from gptcache import cache
from gptcache.adapter import openai

cache.init()
cache.set_openai_key()
# -------------------------------------------------

question = "what's github"
for _ in range(2):
    start_time = time.time()
    response = openai.ChatCompletion.create(
      model='gpt-3.5-turbo',
      messages=[
        {
            'role': 'user',
            'content': question
        }
      ],
    )
    print(f'Question: {question}')
    print("Time consuming: {:.2f}s".format(time.time() - start_time))
    print(f'Answer: {response_text(response)}\n')
Berikut yang akan Anda lihat pada output:
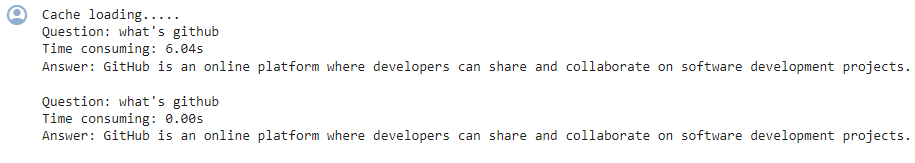
Pada percobaan kedua, GPT memerlukan waktu hampir 0 detik untuk menjawab pertanyaan yang sama
Jika Anda ingin memanfaatkan LLM yang berbeda, coba adapter LangChain. Berikut cara mengintegrasikan GPTCahe dengan LangChain:
from langchain.globals import set_llm_cache
from langchain_openai import OpenAI

# To make the caching really obvious, lets use a slower model.
llm = OpenAI(model_name="gpt-3.5-turbo-instruct", n=2, best_of=2)
Pelajari cara membangun aplikasi LLM dengan Langchain.
Mari kita lihat bagaimana GPTCache dapat mendukung proyek Anda.
LLM dapat menjadi tidak efektif karena kompleksitas dan variasi bawaan pada kueri LLM, yang menghasilkan tingkat hit cache yang rendah.
Untuk mengatasi keterbatasan ini, GPTCache mengadopsi strategi caching semantik. Caching semantik menyimpan kueri yang mirip atau terkait—meningkatkan kemungkinan hit cache dan memperbaiki efisiensi caching secara keseluruhan.
GPTCache memanfaatkan algoritme embedding untuk mengonversi kueri menjadi representasi numerik yang disebut embedding. Embedding ini disimpan dalam penyimpanan vektor, sehingga memungkinkan pencarian kemiripan yang efisien. Proses ini memungkinkan GPTCache mengidentifikasi dan mengambil kueri yang mirip atau terkait dari penyimpanan cache.
Dengan desain modularnya, Anda dapat menyesuaikan implementasi cache semantik sesuai kebutuhan Anda.
Namun—terkadang hit cache palsu dan cache miss dapat terjadi dalam cache semantik. Untuk memantau kinerja ini, GPTCache menyediakan tiga metrik kinerja:
Semua elemen data dasar seperti kueri awal, prompt, respons, dan stempel waktu akses disimpan dalam 'data manager'. Saat ini GPTCache mendukung opsi penyimpanan cache berikut:
Saat ini belum mendukung basis data ‘NoSQL’, tetapi perencanaannya akan segera diintegrasikan.
Namun, GPTCache dapat menghapus data dari penyimpanan cache berdasarkan batas atau jumlah tertentu. Untuk mengelola ukuran cache, Anda dapat menerapkan kebijakan penghapusan Least Recently Used (LRU) atau pendekatan First In, First Out (FIFO).
GPTCache menggunakan fungsi ‘evaluation’ untuk menilai apakah respons yang di-cache menjawab kueri pengguna. Untuk melakukannya, fungsi ini menerima tiga masukan:
Anda juga dapat menggunakan dua fungsi lainnya:
Sekarang setelah Anda memahami cara kerja GPTCache, berikut beberapa praktik terbaik dan kiat agar Anda mendapatkan manfaatnya.
Ada beberapa langkah yang dapat Anda ambil untuk mengoptimalkan kinerja GPTCache, seperti diuraikan di bawah ini.
Cara Anda membuat prompt untuk LLM memengaruhi seberapa baik GPTCache bekerja. Jadi, jaga konsistensi frasa Anda untuk meningkatkan peluang mencapai cache.
Misalnya, gunakan frasa yang konsisten seperti "Saya tidak bisa masuk ke akun saya." Dengan begitu, GPTCache lebih efisien mengenali masalah serupa, seperti "Lupa kata sandi" atau "Masalah login akun".
Pantau metrik bawaan seperti rasio hit, recall, dan latensi untuk menganalisis kinerja cache Anda. Rasio hit yang lebih tinggi menunjukkan bahwa cache lebih efektif menyajikan konten yang diminta dari data yang tersimpan, membantu Anda memahami efektivitasnya.
Untuk menskalakan GPTCache bagi aplikasi LLM yang lebih besar, terapkan pendekatan cache bersama yang memanfaatkan cache yang sama untuk kelompok pengguna dengan profil serupa. Buat profil pengguna dan klasifikasikan untuk mengidentifikasi kelompok pengguna yang mirip.
Memanfaatkan cache bersama untuk pengguna dalam kelompok profil yang sama memberikan hasil yang baik terkait efisiensi dan skalabilitas cache.
Ini karena pengguna dalam kelompok profil yang sama cenderung memiliki kueri terkait yang dapat memanfaatkan respons yang di-cache. Namun, Anda harus menerapkan teknik pemrofilan dan klasifikasi pengguna yang tepat untuk mengelompokkan pengguna dan memaksimalkan manfaat cache bersama secara akurat.
Jika Anda mengalami kesulitan dengan GPTCache, ada beberapa langkah yang dapat diambil untuk menelusuri masalahnya.
GPTCache bergantung pada respons cache yang terbaru. Jika respons LLM yang mendasari atau intent pengguna berubah seiring waktu, respons yang di-cache dapat menjadi tidak akurat atau tidak relevan.
Untuk menghindarinya, tetapkan waktu kedaluwarsa untuk entri cache berdasarkan frekuensi pembaruan yang diharapkan dari LLM dan segarkan cache secara berkala.
Meskipun GPTCache dapat meningkatkan efisiensi, ketergantungan berlebihan pada respons yang di-cache dapat mengarah pada informasi yang tidak akurat jika cache tidak di-invalidasi dengan benar.
Untuk tujuan ini, pastikan aplikasi Anda sesekali mengambil respons terbaru dari LLM, bahkan untuk kueri yang serupa. Ini menjaga akurasi dan kualitas respons saat menangani informasi yang penting atau sensitif terhadap waktu.
Kualitas dan relevansi respons yang di-cache memengaruhi pengalaman pengguna. Jadi, Anda sebaiknya menggunakan metrik evaluasi untuk menilai kualitas respons yang di-cache sebelum menyajikannya kepada pengguna.
Dengan memahami potensi jebakan ini dan solusinya, Anda dapat memastikan GPTCache secara efektif meningkatkan kinerja dan efisiensi biaya aplikasi bertenaga LLM Anda—tanpa mengorbankan akurasi atau pengalaman pengguna.
GPTCache adalah alat yang andal untuk mengoptimalkan kinerja dan efisiensi biaya aplikasi LLM. Diperlukan konfigurasi, pemantauan, dan strategi evaluasi cache yang tepat agar Anda mendapatkan respons yang akurat dan relevan.
Jika Anda baru mengenal LLM, sumber daya berikut mungkin membantu:
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt




