GPTCache, ChatGPT जैसे बड़े भाषा मॉडल (LLM) ऐप्लिकेशनों के लिए एक ओपन-सोर्स फ़्रेमवर्क है। यह समान प्रश्नों के लिए पहले से जनरेट हुई LLM प्रतिक्रियाओं को संग्रहीत करता है। LLM पर निर्भर रहने के बजाय, ऐप्लिकेशन समय बचाने के लिए कैश में प्रासंगिक प्रतिक्रिया ढूंढता है।
यह गाइड बताता है कि GPTCache कैसे काम करता है और आप इसे अपने प्रोजेक्ट्स में प्रभावी ढंग से कैसे इस्तेमाल कर सकते हैं।
GPTCache क्या है?
GPTCache एक कैशिंग सिस्टम है जो बड़े भाषा मॉडलों (LLMs) जैसे GPT-3 के प्रदर्शन और दक्षता में सुधार करने के लिए बनाया गया है। यह LLMs को पहले से जनरेट हुए प्रश्नों को संग्रहीत करने में मदद करता है ताकि समय और मेहनत बचे।
जब कोई समान प्रश्न दोबारा आता है, तो LLM शुरुआत से नया उत्तर तैयार करने के बजाय कैश की गई प्रतिक्रिया ले सकता है।
अन्य टूल्स से अलग, GPTCache सैमांटिक कैशिंग पर काम करता है। सैमांटिक कैश क्वेरी/रिक्वेस्ट के उद्देश्य को रखते हैं। नतीजतन, जब पहले से संग्रहीत प्रश्नों को पुनः बुलाया जाता है, तो उनके परिणाम सर्वर के वर्कलोड को कम करते हैं और कैश हिट रेट में सुधार करते हैं।
GPTCache के उपयोग के लाभ
GPTCache के पीछे मुख्य विचार यह है कि LLM के इंफरेंस प्रोसेस के दौरान जनरेट हुई इंटरमीडिएट कम्प्यूटेशनों को संग्रहीत और पुन: प्रयोग किया जाए। ऐसा करने के कई लाभ हैं:
LLM API कॉल्स पर लागत बचत
अधिकांश LLM प्रति अनुरोध प्रोसेस किए गए टोकन्स की संख्या के आधार पर शुल्क लेते हैं। यहीं GPTCache उपयोगी साबित होता है। यह समान प्रश्नों के लिए पहले से जनरेट प्रतिक्रियाएँ सर्व करके LLM API कॉल्स की संख्या कम कर देता है। नतीजतन, अतिरिक्त LLM कॉल खर्चों में कटौती कर लागत बचती है।
प्रतिक्रिया समय और दक्षता में सुधार
LLM से क्वेरी करके शुरुआत से उत्तर बनाने की तुलना में कैश से प्रतिक्रिया निकालना काफी तेज होता है। यह गति बढ़ाता है और प्रतिक्रिया समय सुधारता है। कुशल प्रतिक्रियाएँ स्वयं LLM पर बोझ कम करती हैं और अन्य कार्यों के लिए संसाधन मुक्त करती हैं।
तेज़ ऐप प्रदर्शन से बेहतर उपयोगकर्ता अनुभव
मान लीजिए आप अपने कंटेंट के लिए सवाल खोज रहे हैं। हर सवाल का जवाब देने में AI को बहुत समय लगता है। क्यों? क्योंकि अधिकांश LLM सेवाएँ निर्धारित अवधियों में अनुरोध सीमाएँ लागू करती हैं। इन सीमाओं से अधिक होने पर, सीमा रीसेट होने तक आगे के अनुरोध ब्लॉक हो जाते हैं, जिससे सेवा में बाधा आती है।
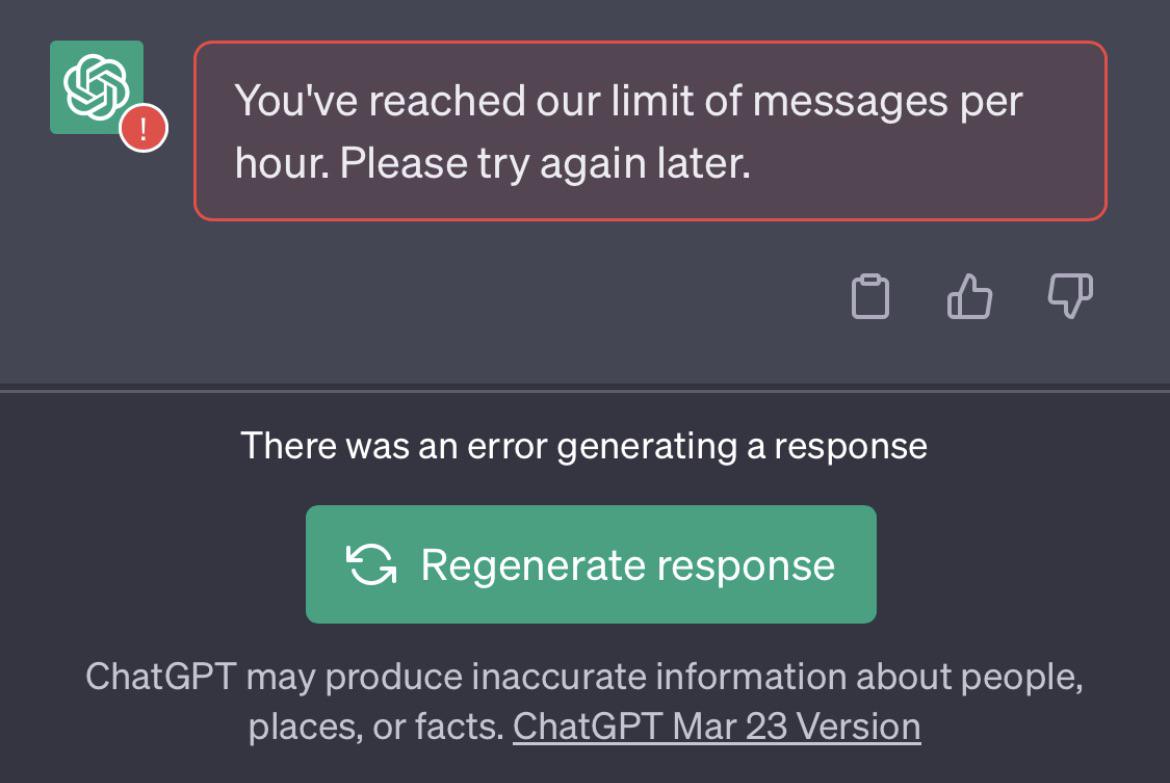
ChatGPT अपनी प्रतिक्रिया जनरेट करने की सीमा तक पहुँच सकता है
इन समस्याओं से बचने के लिए, GPTchache समान प्रश्नों के पिछले उत्तरों को कैश करता है। जब आप कुछ पूछते हैं, यह तेज़ी से अपनी मेमोरी जाँचता है और तुरंत जानकारी दे देता है। नतीजतन, आपको सामान्य से कम समय में उत्तर मिल जाता है।
सीधे शब्दों में, कैश की गई प्रतिक्रियाओं का लाभ उठाकर, GPTCache यह सुनिश्चित करता है कि LLM-आधारित ऐप्लिकेशन प्रतिक्रियाशील और सक्षम बनें—बिल्कुल वैसा ही जैसा आप किसी आधुनिक टूल से उम्मीद करते हैं।
GPTCache सेट अप करना
यहाँ बताया गया है कि आप GPTCache सीधे कैसे इंस्टॉल कर सकते हैं:
इंस्टॉलशन और कॉन्फ़िगरेशन
इस कोड का उपयोग करके GPTCache पैकेज इंस्टॉल करें।
! pip install -q gptcacheअब, अपने ऐप्लिकेशन में GPTCache इम्पोर्ट करें।
from gptcache import GPTCache
cache = GPTCache()
# keep the mode default
बस इतना ही, आप तैयार हैं!
LLMs के साथ इंटीग्रेशन
आप GPTCache को इसके LLM Adapter के जरिए LLMs के साथ इंटीग्रेट कर सकते हैं। अभी के लिए, यह केवल दो बड़े भाषा मॉडल अडैप्टर के साथ संगत है:
- OpenAI
- Langchain
यहाँ बताया गया है कि आप इसे दोनों अडैप्टर के साथ कैसे इंटीग्रेट कर सकते हैं:
OpenAI ChatGPT API के साथ GPTCache
OpenAI के साथ GPTCache इंटीग्रेट करने के लिए, कैश इनिशियलाइज़ करें और gptcache.adapter से openai इम्पोर्ट करें।
from gptcache import cache
from gptcache.adapter import openai

cache.init()
cache.set_openai_key()
उदाहरण कोड चलाने से पहले, echo $OPENAI_API_KEY चलाकर OPENAI_API_KEY एनवायरनमेंट वेरिएबल सेट करें।
यदि यह पहले से सेट नहीं है, तो आप Unix/Linux/MacOS सिस्टम पर export OPENAI_API_KEY=YOUR_API_KEY या Windows सिस्टम पर set OPENAI_API_KEY=YOUR_API_KEY का उपयोग करके सेट कर सकते हैं।
फिर, यदि आप ChatGPT से एक ही सवाल दो बार पूछते हैं, तो यह दूसरी बार का उत्तर कैश से प्राप्त करेगा, ChatGPT से दोबारा पूछे बिना।
यहाँ समान खोज कैश के लिए एक उदाहरण कोड है:
import time


def response_text(openai_resp):
    return openai_resp['choices'][0]['message']['content']

print("Cache loading.....")

# To use GPTCache, that's all you need
# -------------------------------------------------
from gptcache import cache
from gptcache.adapter import openai

cache.init()
cache.set_openai_key()
# -------------------------------------------------

question = "what's github"
for _ in range(2):
    start_time = time.time()
    response = openai.ChatCompletion.create(
      model='gpt-3.5-turbo',
      messages=[
        {
            'role': 'user',
            'content': question
        }
      ],
    )
    print(f'Question: {question}')
    print("Time consuming: {:.2f}s".format(time.time() - start_time))
    print(f'Answer: {response_text(response)}\n')
आउटपुट में आप यह देखेंगे:
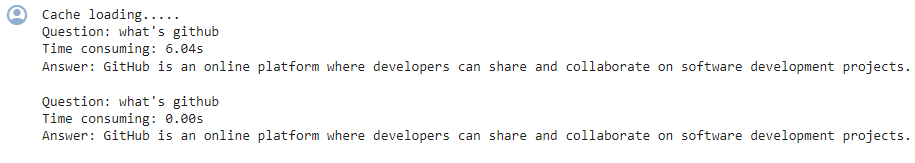
दूसरी बार, GPT ने वही प्रश्न का उत्तर देने में लगभग 0 सेकंड लिए
LangChain के साथ GPTCache
यदि आप कोई अलग LLM उपयोग करना चाहते हैं, तो LangChain अडैप्टर आज़माएँ। यहाँ बताया गया है कि आप LangChain के साथ GPTCahe को कैसे इंटीग्रेट कर सकते हैं:
from langchain.globals import set_llm_cache
from langchain_openai import OpenAI

# To make the caching really obvious, lets use a slower model.
llm = OpenAI(model_name="gpt-3.5-turbo-instruct", n=2, best_of=2)
Langchain के साथ LLM ऐप्लिकेशन बनाना सीखें।
अपने प्रोजेक्ट्स में GPTCache का उपयोग
आइए देखें कि GPTCache आपके प्रोजेक्ट्स को कैसे सहयोग दे सकता है।
बेसिक ऑपरेशंस
LLM क्वेरीज़ की अंतर्निहित जटिलता और विविधता के कारण LLMs अप्रभावी हो सकते हैं, जिससे कैश हिट रेट कम हो जाता है।
इस सीमा को पार करने के लिए, GPTCache सैमांटिक कैशिंग रणनीतियाँ अपनाता है। सैमांटिक कैशिंग समान या संबंधित क्वेरीज़ को संग्रहीत करता है—जिससे कैश हिट की संभावना बढ़ती है और समग्र कैशिंग दक्षता में सुधार होता है।
GPTCache क्वेरीज़ को संख्यात्मक निरूपणों, जिन्हें एंबेडिंग्स कहा जाता है, में बदलने के लिए एंबेडिंग एल्गोरिदम का लाभ उठाता है। ये एंबेडिंग्स एक वेक्टर स्टोर में संग्रहीत होती हैं, जो कुशल समानता खोज सक्षम करती हैं। यह प्रक्रिया GPTCache को कैश स्टोरेज से समान या संबंधित क्वेरीज़ की पहचान और पुनर्प्राप्ति करने देती है।
इसके मॉड्युलर डिज़ाइन के साथ, आप अपनी आवश्यकताओं के अनुसार सैमांटिक कैश इम्प्लीमेंटेशंस को कस्टमाइज़ कर सकते हैं।
हालाँकि—कभी-कभी सैमांटिक कैश में गलत कैश हिट्स और कैश मिसेस हो सकती हैं। इस प्रदर्शन की निगरानी के लिए, GPTCache तीन परफॉर्मेंस मेट्रिक्स प्रदान करता है:
- हिट रेशियो यह मापता है कि अनुरोधों को पूरा करने में कैश कितना सफल है। उच्च मान बेहतर प्रदर्शन दर्शाते हैं।
- लेटेंसी कैश से डेटा पुनर्प्राप्त करने में लगने वाले समय को दर्शाती है—जहाँ कम होना बेहतर है।
- रीकॉल सही तरीके से सर्व की गई कैश क्वेरीज़ का अनुपात दिखाता है। अधिक प्रतिशत बेहतर सटीकता को दर्शाते हैं।
एडवांस्ड फीचर्स
प्रारंभिक क्वेरीज़, प्रॉम्प्ट्स, प्रतिक्रियाएँ और एक्सेस टाइमस्टैम्प जैसी सभी बुनियादी डेटा इकाइयाँ एक 'डेटा मैनेजर' में संग्रहीत होती हैं। GPTCache वर्तमान में निम्नलिखित कैश स्टोरेज विकल्पों का समर्थन करता है:
- SQLite
- MySQL
- PostgreSQL डेटाबेस
यह अभी ‘NoSQL’ डेटाबेस को सपोर्ट नहीं करता है, लेकिन इसे जल्द ही शामिल करने की योजना है।
इविक्शन नीतियों का उपयोग
साथ ही, GPTCache निर्दिष्ट सीमा या संख्या के आधार पर कैश स्टोरेज से डेटा हटा सकता है। कैश का आकार प्रबंधित करने के लिए, आप या तो Least Recently Used (LRU) इविक्शन पॉलिसी या First In, First Out (FIFO) दृष्टिकोण लागू कर सकते हैं।
- LRU इविक्शन पॉलिसी हाल में सबसे कम एक्सेस की गई वस्तुओं को हटाती है।
- वहीं, FIFO इविक्शन पॉलिसी सबसे लंबे समय से मौजूद कैश्ड आइटम्स को हटा देती है।
प्रतिक्रिया प्रदर्शन का मूल्यांकन
GPTCache किसी कैश की गई प्रतिक्रिया द्वारा उपयोगकर्ता क्वेरी के समाधान का आकलन करने के लिए एक ‘इवैलुएशन’ फ़ंक्शन का उपयोग करता है। ऐसा करने के लिए, यह तीन इनपुट लेता है:
- उपयोगकर्ता का डेटा के लिए अनुरोध
- मूल्यांकित की जा रही कैश्ड डेटा
- उपयोगकर्ता-परिभाषित पैरामीटर्स (यदि कोई हों)
आप दो अन्य फ़ंक्शनों का भी उपयोग कर सकते हैं:
- ‘log_time_func’ आपको ‘एंबेडिंग्स’ जनरेट करने या कैश ‘खोजें’ करने जैसे गहन कार्यों की अवधि रिकॉर्ड और रिपोर्ट करने देता है। यह प्रदर्शन विशेषताओं की निगरानी में मदद करता है।
- ‘similarity_threshold’ के साथ, आप यह थ्रेशहोल्ड परिभाषित कर सकते हैं कि कब दो एंबेडिंग वेक्टर (टेक्स्ट डेटा के उच्च-आयामी निरूपण) पर्याप्त रूप से समान माने जाएँ।
GPTCache: सर्वोत्तम प्रथाएँ और समस्या निवारण
अब जब आप जानते हैं कि GPTCache कैसे काम करता है, तो यहाँ कुछ सर्वोत्तम प्रथाएँ और सुझाव दिए गए हैं ताकि आप इसके फायदे उठा सकें।
GPTCache प्रदर्शन का अनुकूलन
GPTCache के प्रदर्शन को अनुकूलित करने के लिए आप कई कदम उठा सकते हैं, जैसा कि नीचे बताया गया है।
1. अपने प्रॉम्प्ट्स स्पष्ट रखें
आप LLM को कैसे प्रॉम्प्ट करते हैं, यह प्रभावित करता है कि GPTCache कितना अच्छा काम करता है। इसलिए, कैश तक पहुँचने की संभावना बढ़ाने के लिए अपनी वाक्य रचना सुसंगत रखें।
उदाहरण के लिए, "मैं अपने खाते में लॉग इन नहीं कर पा रहा/रही हूँ" जैसी सुसंगत वाक्य रचना का उपयोग करें। इस तरह, GPTCache "पासवर्ड भूल गया/गई" या "खाते में लॉगिन की समस्या" जैसे समान मुद्दों को अधिक कुशलता से पहचानता है।
2. बिल्ट-इन ट्रैकिंग मेट्रिक्स का उपयोग करें
हिट रेशियो, रीकॉल और लेटेंसी जैसे बिल्ट-इन मेट्रिक्स की निगरानी करें ताकि अपने कैश के प्रदर्शन का विश्लेषण कर सकें। उच्च हिट रेशियो इंगित करता है कि कैश संग्रहीत डेटा से अनुरोधित सामग्री को अधिक प्रभावी ढंग से सर्व कर रहा है, जिससे इसकी प्रभावशीलता समझने में मदद मिलती है।
3. बड़े उपयोगकर्ता आधार वाले LLM ऐप्स के लिए GPTCache का स्केलिंग
बड़े LLM ऐप्लिकेशनों के लिए GPTCache को स्केल करने के लिए, साझा कैश दृष्टिकोण लागू करें जो समान प्रोफ़ाइल वाले उपयोगकर्ता समूहों के लिए एक ही कैश का उपयोग करे। उपयोगकर्ता प्रोफाइल बनाएँ और उन्हें वर्गीकृत करें ताकि समान उपयोगकर्ता समूहों की पहचान की जा सके।
उसी प्रोफ़ाइल समूह के उपयोगकर्ताओं के लिए साझा कैश का लाभ उठाने से कैश दक्षता और स्केलेबिलिटी के संदर्भ में अच्छे परिणाम मिलते हैं।
ऐसा इसलिए है क्योंकि एक ही प्रोफ़ाइल समूह के उपयोगकर्ताओं के प्रश्न आमतौर पर संबंधित होते हैं, जो कैश की गई प्रतिक्रियाओं से लाभ उठा सकते हैं। हालाँकि, उपयोगकर्ताओं को सही ढंग से समूहबद्ध करने और साझा कैशिंग के लाभों को अधिकतम करने के लिए आपको सही उपयोगकर्ता प्रोफाइलिंग और वर्गीकरण तकनीकों का उपयोग करना होगा।
आम GPTCache समस्याओं का समस्या निवारण
यदि आप GPTCache के साथ संघर्ष कर रहे हैं, तो समस्याओं के समाधान के लिए आप कई कदम उठा सकते हैं।
1. कैश अमान्यकरण
GPTCache नवीनतम कैश प्रतिक्रियाओं पर निर्भर करता है। यदि समय के साथ अंतर्निहित LLM की प्रतिक्रियाएँ या उपयोगकर्ता का इरादा बदलता है, तो कैश की गई प्रतिक्रियाएँ गलत या अप्रासंगिक हो सकती हैं।
इससे बचने के लिए, LLM के अपेक्षित अपडेट फ़्रीक्वेंसी के आधार पर कैश एंट्रीज़ के लिए समाप्ति समय सेट करें और कैश को नियमित रूप से रिफ्रेश करें।
2. कैश्ड प्रतिक्रियाओं पर अत्यधिक निर्भरता
हालाँकि GPTCache दक्षता में सुधार कर सकता है, लेकिन कैश्ड प्रतिक्रियाओं पर अत्यधिक निर्भरता, यदि कैश सही ढंग से अमान्य नहीं किया गया है, तो गलत जानकारी का कारण बन सकती है।
इसके लिए, सुनिश्चित करें कि आपका ऐप्लिकेशन समान क्वेरीज़ के लिए भी समय-समय पर LLM से नई प्रतिक्रियाएँ प्राप्त करे। यह विशेष रूप से महत्वपूर्ण या समय-संवेदी जानकारी से निपटते समय प्रतिक्रियाओं की सटीकता और गुणवत्ता बनाए रखता है।
3. कैश गुणवत्ता की अनदेखी
कैश की गई प्रतिक्रिया की गुणवत्ता और प्रासंगिकता उपयोगकर्ता अनुभव को प्रभावित करती है। इसलिए, उपयोगकर्ताओं को सर्व करने से पहले कैश की गई प्रतिक्रियाओं की गुणवत्ता का आकलन करने के लिए इवैलुएशन मेट्रिक्स का उपयोग करें।
इन संभावित समस्याओं और उनके समाधानों को समझकर, आप सुनिश्चित कर सकते हैं कि GPTCache आपके LLM-समर्थित ऐप्लिकेशनों के प्रदर्शन और लागत-दक्षता में प्रभावी ढंग से सुधार करे—बिना सटीकता या उपयोगकर्ता अनुभव से समझौता किए।
समापन
GPTCache, LLM ऐप्लिकेशनों के प्रदर्शन और लागत-दक्षता को अनुकूलित करने के लिए एक शक्तिशाली टूल है। सटीक और प्रासंगिक प्रतिक्रियाएँ प्राप्त करने के लिए उचित कॉन्फ़िगरेशन, मॉनिटरिंग और कैश इवैलुएशन रणनीतियाँ आवश्यक हैं।
यदि आप LLMs में नए हैं, तो ये संसाधन सहायक हो सकते हैं:
