GPTCache é um framework open source para aplicações com modelos de linguagem de grande porte (LLM), como o ChatGPT. Ele armazena respostas de LLM já geradas para consultas semelhantes. Em vez de depender do LLM a cada vez, a aplicação verifica o cache em busca de uma resposta relevante para economizar seu tempo.
Este guia explica como o GPTCache funciona e como você pode usá-lo com eficiência nos seus projetos.
O que é o GPTCache?
GPTCache é um sistema de cache criado para melhorar o desempenho e a eficiência de modelos de linguagem de grande porte (LLMs) como o GPT-3. Ele ajuda LLMs a armazenar consultas e respostas já geradas para economizar tempo e processamento.
Quando surge uma consulta semelhante, o LLM pode recuperar a resposta em cache em vez de gerar uma nova do zero.
Diferente de outras ferramentas, o GPTCache trabalha com cache semântico. Caches semânticos preservam a intenção de uma consulta/solicitação. Assim, quando consultas armazenadas são recuperadas, o resultado reduz a carga do servidor e melhora as taxas de acerto do cache.
Vantagens de usar o GPTCache
A ideia central do GPTCache é armazenar e reutilizar os cálculos intermediários gerados durante o processo de inferência de um LLM. Isso traz vários benefícios:
Economia em chamadas de API de LLM
A maioria dos LLMs cobra por solicitação com base no número de tokens processados. É aí que o GPTCache ajuda: ele reduz o número de chamadas à API do LLM ao servir respostas já geradas para consultas semelhantes. Como resultado, você diminui custos com chamadas desnecessárias.
Tempo de resposta e eficiência melhores
Buscar uma resposta no cache é muito mais rápido do que gerá-la do zero consultando o LLM. Isso acelera a execução e melhora o tempo de resposta. Respostas mais eficientes aliviam a carga do próprio LLM e liberam recursos para outras tarefas.
Experiência do usuário aprimorada com desempenho mais rápido
Imagine que você está pesquisando perguntas para seu conteúdo. Cada pergunta leva uma eternidade para a IA responder. Por quê? Porque muitos serviços de LLM impõem limites de requisições em períodos definidos. Ao exceder esses limites, novas solicitações ficam bloqueadas até a redefinição, causando interrupções.
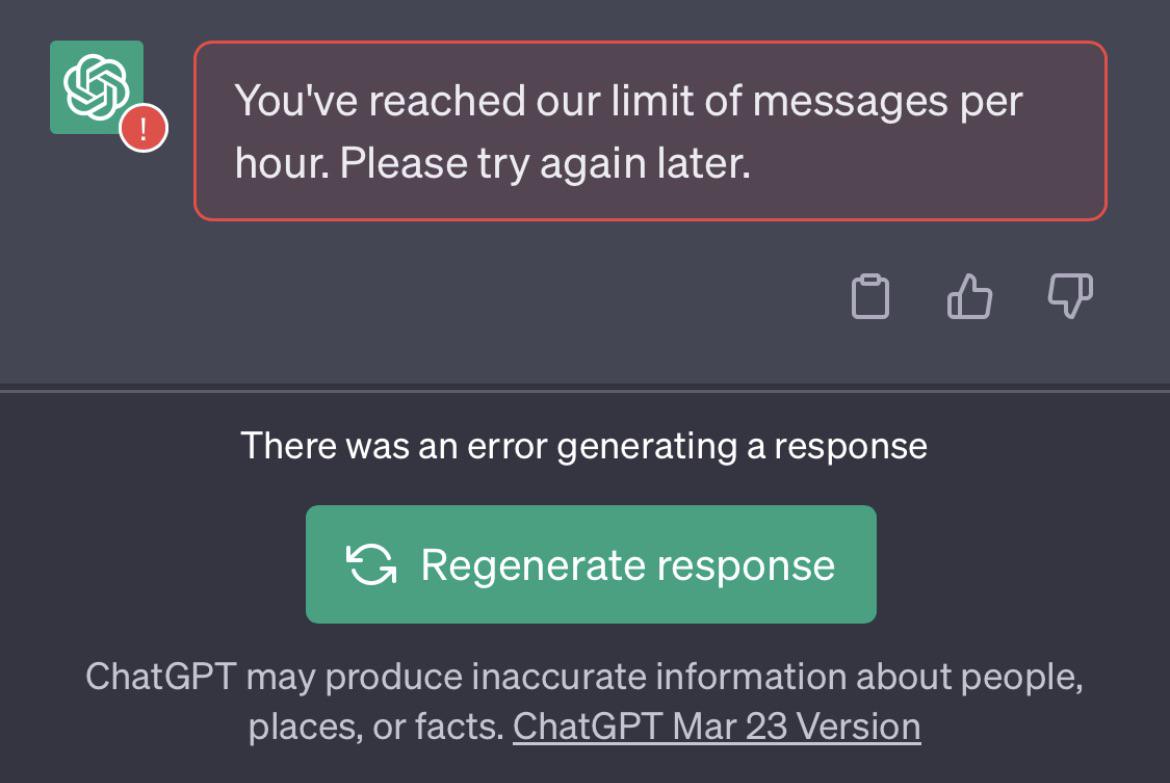
O ChatGPT pode atingir o limite de geração de respostas
Para evitar esses problemas, o GPTCache guarda respostas anteriores para perguntas semelhantes. Quando você pede algo, ele rapidamente consulta a memória e entrega a informação em instantes. Assim, você recebe a resposta muito mais rápido que o normal.
Em resumo, ao aproveitar respostas em cache, o GPTCache torna aplicações baseadas em LLM mais responsivas e eficientes — como você espera de qualquer ferramenta moderna.
Configurando o GPTCache
Veja como instalar o GPTCache diretamente:
Instalação e configuração
Instale o pacote GPTCache com este comando.
! pip install -q gptcacheDepois, importe o GPTCache para sua aplicação.
from gptcache import GPTCache
cache = GPTCache()
# mantenha o modo padrão
Pronto, é só isso!
Integração com LLMs
Você pode integrar o GPTCache aos LLMs por meio do LLM Adapter. Por enquanto, ele é compatível com apenas dois adapters de modelos de linguagem:
- OpenAI
- Langchain
Veja como integrar com ambos:
GPTCache com a API do ChatGPT (OpenAI)
Para integrar o GPTCache com a OpenAI, inicialize o cache e importe openai de gptcache.adapter.
from gptcache import cache
from gptcache.adapter import openai

cache.init()
cache.set_openai_key()
Antes de executar o exemplo, defina a variável de ambiente OPENAI_API_KEY executando echo $OPENAI_API_KEY.
Se ela ainda não estiver definida, você pode configurá-la com export OPENAI_API_KEY=YOUR_API_KEY em sistemas Unix/Linux/MacOS ou set OPENAI_API_KEY=YOUR_API_KEY no Windows.
Depois, se você fizer duas perguntas idênticas ao ChatGPT, a resposta da segunda será recuperada do cache em vez de consultar o ChatGPT novamente.
Aqui vai um exemplo de código para cache por similaridade:
import time


def response_text(openai_resp):
    return openai_resp['choices'][0]['message']['content']

print("Cache loading.....")

# To use GPTCache, that's all you need
# -------------------------------------------------
from gptcache import cache
from gptcache.adapter import openai

cache.init()
cache.set_openai_key()
# -------------------------------------------------

question = "what's github"
for _ in range(2):
    start_time = time.time()
    response = openai.ChatCompletion.create(
      model='gpt-3.5-turbo',
      messages=[
        {
            'role': 'user',
            'content': question
        }
      ],
    )
    print(f'Question: {question}')
    print("Time consuming: {:.2f}s".format(time.time() - start_time))
    print(f'Answer: {response_text(response)}\n')
Veja o que você verá na saída:
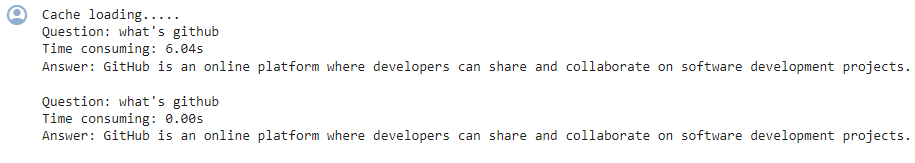
Na segunda vez, o GPT levou praticamente 0 segundo para responder a mesma pergunta
GPTCache com LangChain
Se quiser utilizar um LLM diferente, experimente o adapter do LangChain. Veja como integrar o GPTCache ao LangChain:
from langchain.globals import set_llm_cache
from langchain_openai import OpenAI

# To make the caching really obvious, lets use a slower model.
llm = OpenAI(model_name="gpt-3.5-turbo-instruct", n=2, best_of=2)
Aprenda a construir aplicações com LLM usando LangChain.
Usando o GPTCache nos seus projetos
Vamos ver como o GPTCache pode apoiar seus projetos.
Operações básicas
LLMs podem se tornar ineficientes por conta da complexidade e variabilidade inerentes às consultas, o que resulta em uma baixa taxa de acertos no cache.
Para contornar essa limitação, o GPTCache adota estratégias de cache semântico. O cache semântico armazena consultas semelhantes ou relacionadas — aumentando a probabilidade de acertos e elevando a eficiência geral do cache.
O GPTCache usa algoritmos de embedding para converter consultas em representações numéricas chamadas embeddings. Esses embeddings são armazenados em um repositório vetorial, permitindo buscas por similaridade eficientes. Esse processo possibilita identificar e recuperar consultas semelhantes ou relacionadas do armazenamento em cache.
Com um design modular, você pode personalizar a implementação de cache semântico conforme suas necessidades.
No entanto — às vezes ocorrem falsos acertos e perdas (misses) no cache semântico. Para monitorar o desempenho, o GPTCache oferece três métricas:
- Taxa de acerto (hit ratio) mede o sucesso do cache em atender requisições. Quanto maior, melhor.
- Latência indica o tempo para recuperar dados do cache — quanto menor, melhor.
- Revocação (recall) mostra a proporção de consultas corretamente atendidas pelo cache. Percentuais maiores indicam melhor precisão.
Recursos avançados
Todos os dados básicos, como consultas iniciais, prompts, respostas e carimbos de data/hora de acesso, são armazenados em um "gerenciador de dados". O GPTCache atualmente oferece suporte às seguintes opções de armazenamento de cache:
- SQLite
- MySQL
- Bancos PostgreSQL.
Ainda não há suporte a bancos ‘NoSQL’, mas ele está nos planos para ser incorporado em breve.
Usando políticas de remoção (eviction)
O GPTCache pode remover dados do armazenamento de cache com base em um limite ou contagem definidos. Para gerenciar o tamanho do cache, você pode aplicar a política LRU (Least Recently Used) ou FIFO (First In, First Out).
- LRU remove os itens acessados há mais tempo.
- Já a política FIFO descarta os itens em cache que estão lá há mais tempo.
Avaliando o desempenho das respostas
O GPTCache usa uma função de ‘avaliação’ para verificar se uma resposta em cache atende à consulta do usuário. Para isso, ela considera três entradas:
- a solicitação do usuário
- os dados em cache que estão sendo avaliados
- parâmetros definidos pelo usuário (se houver)
Você também pode usar duas outras funções:
- log_time_func permite registrar e informar a duração de tarefas intensivas, como gerar embeddings ou executar buscas no cache. Isso ajuda a monitorar características de desempenho.
- Com similarity_threshold, você define o limite a partir do qual dois vetores de embedding (representações textuais de alta dimensão) são considerados suficientemente semelhantes para corresponder.
Boas práticas e solução de problemas no GPTCache
Agora que você já sabe como o GPTCache funciona, veja algumas boas práticas e dicas para aproveitar ao máximo.
Otimizando o desempenho do GPTCache
Há várias ações que você pode adotar para otimizar o desempenho do GPTCache, como as listadas abaixo.
1. Deixe seus prompts claros
A forma como você escreve seus prompts impacta diretamente o desempenho do GPTCache. Mantenha a redação consistente para aumentar as chances de acerto no cache.
Por exemplo, use sempre formulações consistentes como "Não consigo fazer login na minha conta". Assim, o GPTCache reconhece com mais facilidade problemas semelhantes, como "Esqueci minha senha" ou "Problemas para acessar a conta".
2. Use as métricas nativas de acompanhamento
Monitore métricas como taxa de acerto, recall e latência para analisar o desempenho do cache. Uma taxa de acerto mais alta indica que o cache está servindo melhor o conteúdo solicitado a partir dos dados armazenados — ajudando você a entender sua efetividade.
3. Escalando o GPTCache para aplicações de LLM com grande base de usuários
Para escalar o GPTCache em aplicações maiores, implemente um cache compartilhado que utilize o mesmo cache para grupos de usuários com perfis semelhantes. Crie perfis de usuário e classifique-os para identificar grupos similares.
Aproveitar um cache compartilhado para usuários do mesmo grupo de perfil traz ótimos resultados em eficiência e escalabilidade.
Isso porque usuários de um mesmo grupo tendem a ter consultas relacionadas que se beneficiam de respostas em cache. Porém, é essencial aplicar técnicas adequadas de criação de perfis e classificação para agrupar usuários corretamente e extrair o máximo do cache compartilhado.
Solucionando problemas comuns no GPTCache
Se você estiver enfrentando dificuldades com o GPTCache, há algumas ações que podem ajudar a diagnosticar e resolver os problemas.
1. Invalidação do cache
O GPTCache depende de respostas atualizadas. Se as respostas do LLM ou a intenção do usuário mudarem com o tempo, as respostas em cache podem ficar imprecisas ou irrelevantes.
Para evitar isso, defina tempos de expiração para as entradas em cache com base na frequência esperada de atualização do LLM e faça a atualização periódica do cache.
2. Dependência excessiva do cache
Embora o GPTCache aumente a eficiência, depender demais do cache pode levar a informações desatualizadas se a invalidação não for feita corretamente.
Por isso, garanta que sua aplicação ocasionalmente busque respostas novas do LLM, mesmo para consultas semelhantes. Isso mantém a precisão e a qualidade das respostas em cenários críticos ou sensíveis ao tempo.
3. Ignorar a qualidade do cache
A qualidade e a relevância das respostas em cache impactam a experiência do usuário. Use métricas de avaliação para verificar a qualidade das respostas antes de entregá-las aos usuários.
Ao entender esses possíveis problemas e suas soluções, você garante que o GPTCache aumente o desempenho e a relação custo-benefício das suas aplicações com LLM — sem comprometer a precisão ou a experiência do usuário.
Fechamento
O GPTCache é uma ferramenta poderosa para otimizar o desempenho e reduzir custos em aplicações com LLM. Configuração adequada, monitoramento e estratégias de avaliação do cache são essenciais para garantir respostas precisas e relevantes.
Se você está começando com LLMs, estes recursos podem ajudar: