GPTCache è un framework open source per applicazioni basate su large language model (LLM) come ChatGPT. Memorizza le risposte LLM generate in precedenza per query simili. Invece di affidarsi all'LLM, l'applicazione controlla la cache per trovare una risposta pertinente e farti risparmiare tempo.
Questa guida spiega come funziona GPTCache e come usarlo in modo efficace nei tuoi progetti.
Che cos'è GPTCache?
GPTCache è un sistema di caching progettato per migliorare le prestazioni e l'efficienza dei large language models (LLM) come GPT-3. Aiuta gli LLM a memorizzare le query generate in precedenza per risparmiare tempo e risorse.
Quando si presenta di nuovo una query simile, l'LLM può recuperare la risposta in cache invece di svilupparne una nuova da zero.
A differenza di altri strumenti, GPTCache si basa sul caching semantico. Le cache semantiche conservano l'obiettivo di una query/richiesta. Di conseguenza, quando si richiamano le query memorizzate in precedenza, il loro risultato riduce il carico sul server e migliora i tassi di hit della cache.
Vantaggi dell'uso di GPTCache
L'idea alla base di GPTCache è memorizzare e riutilizzare i calcoli intermedi generati durante il processo di inferenza di un LLM. Farlo offre diversi vantaggi:
Risparmio sui costi delle chiamate API agli LLM
La maggior parte degli LLM addebita una tariffa per richiesta in base al numero di token elaborati. È qui che GPTCache torna utile. Riduce il numero di chiamate API all'LLM servendo risposte precedentemente generate per query simili. Di conseguenza, si risparmia sui costi riducendo le chiamate superflue all'LLM.
Tempi di risposta ed efficienza migliori
Recuperare la risposta da una cache è molto più veloce che generarla da zero interrogando l'LLM. Questo velocizza l'esecuzione e migliora i tempi di risposta. Risposte più efficienti riducono il carico sull'LLM stesso e liberano risorse che possono essere allocate ad altri compiti.
Esperienza utente migliore grazie a prestazioni più rapide
Supponiamo che tu stia cercando domande per il tuo contenuto. Ogni domanda che fai richiede un’eternità per ottenere una risposta dall’AI. Perché? Perché molti servizi LLM impongono limiti di richieste in periodi prestabiliti. Superare questi limiti blocca ulteriori richieste finché il limite non si resetta, causando interruzioni del servizio.
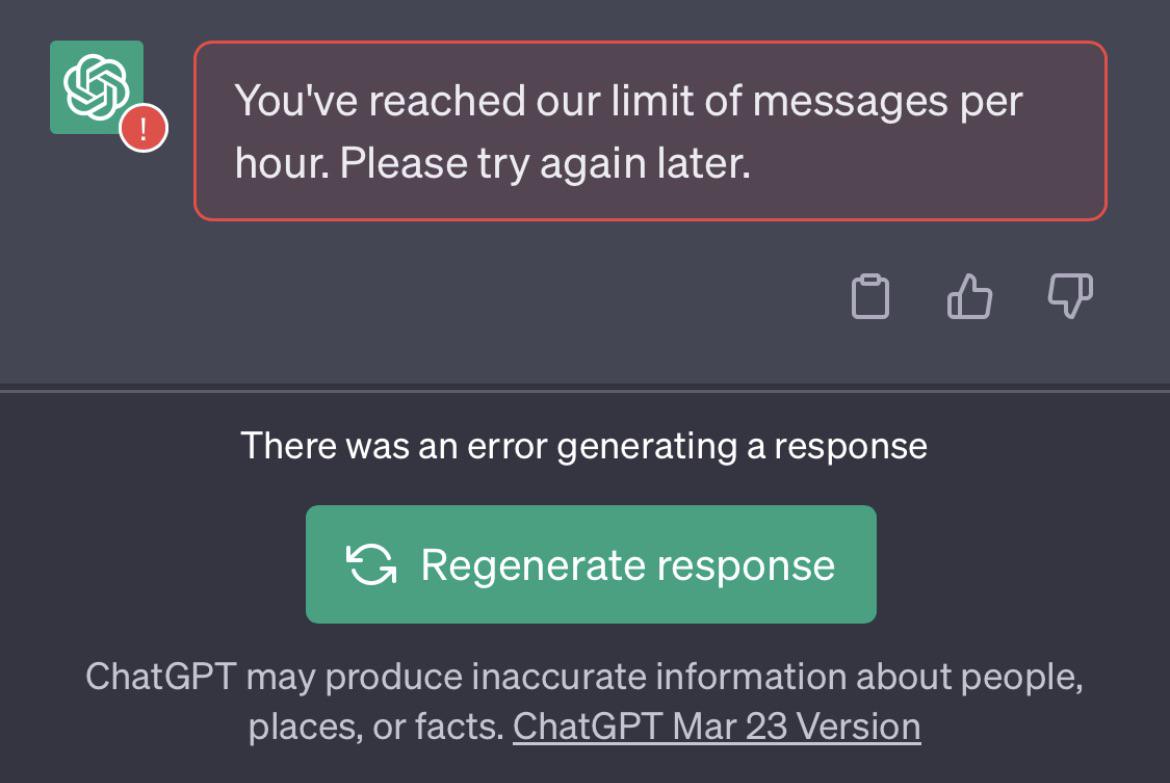
ChatGPT può raggiungere il limite di generazione della risposta
Per evitare questi problemi, GPTchache memorizza in cache le risposte precedenti a domande simili. Quando chiedi qualcosa, controlla rapidamente la sua memoria e ti fornisce l'informazione in un attimo. Di conseguenza, ottieni la risposta in meno tempo del solito.
In poche parole, sfruttando le risposte in cache, GPTCache rende le applicazioni basate su LLM reattive ed efficienti—proprio come ti aspetteresti da qualsiasi strumento moderno.
Configurare GPTCache
Ecco come installare direttamente GPTCache:
Installazione e configurazione
Installa il pacchetto GPTCache usando questo codice.
! pip install -q gptcachePoi importa GPTCache nella tua applicazione.
from gptcache import GPTCache
cache = GPTCache()
# keep the mode default
Ecco fatto, hai finito!
Integrazione con gli LLM
Puoi integrare GPTCache con gli LLM tramite il suo LLM Adapter. Al momento è compatibile solo con due adapter per large language model:
- OpenAI
- Langchain
Ecco come integrarlo con entrambi gli adapter:
GPTCache con l'API ChatGPT di OpenAI
Per integrare GPTCache con OpenAI, inizializza la cache e importa openai da gptcache.adapter.
from gptcache import cache
from gptcache.adapter import openai

cache.init()
cache.set_openai_key()
Prima di eseguire il codice di esempio, imposta la variabile d'ambiente OPENAI_API_KEY eseguendo echo $OPENAI_API_KEY.
Se non è già impostata, puoi farlo con export OPENAI_API_KEY=YOUR_API_KEY su sistemi Unix/Linux/MacOS o con set OPENAI_API_KEY=YOUR_API_KEY su sistemi Windows.
Poi, se fai a ChatGPT due volte la stessa domanda, la seconda volta recupererà la risposta dalla cache invece di interrogare di nuovo ChatGPT.
Ecco un esempio di codice per la cache di ricerche simili:
import time


def response_text(openai_resp):
    return openai_resp['choices'][0]['message']['content']

print("Cache loading.....")

# To use GPTCache, that's all you need
# -------------------------------------------------
from gptcache import cache
from gptcache.adapter import openai

cache.init()
cache.set_openai_key()
# -------------------------------------------------

question = "what's github"
for _ in range(2):
    start_time = time.time()
    response = openai.ChatCompletion.create(
      model='gpt-3.5-turbo',
      messages=[
        {
            'role': 'user',
            'content': question
        }
      ],
    )
    print(f'Question: {question}')
    print("Time consuming: {:.2f}s".format(time.time() - start_time))
    print(f'Answer: {response_text(response)}\n')
Ecco cosa vedrai in output:
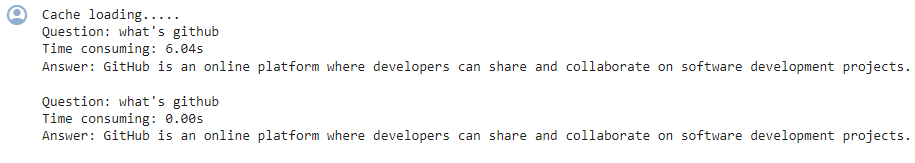
La seconda volta, GPT ha impiegato quasi 0 secondi per rispondere alla stessa domanda
GPTCache con LangChain
Se vuoi utilizzare un LLM diverso, prova l’adapter LangChain. Ecco come integrare GPTCahe con LangChain:
from langchain.globals import set_llm_cache
from langchain_openai import OpenAI

# To make the caching really obvious, lets use a slower model.
llm = OpenAI(model_name="gpt-3.5-turbo-instruct", n=2, best_of=2)
Scopri come creare applicazioni LLM con Langchain.
Usare GPTCache nei tuoi progetti
Vediamo come GPTCache può supportare i tuoi progetti.
Operazioni di base
Gli LLM possono risultare inefficaci a causa della complessità intrinseca e della variabilità delle query, con conseguente basso tasso di hit in cache.
Per superare questo limite, GPTCache adotta strategie di caching semantico. Il caching semantico memorizza query simili o correlate—aumentando la probabilità di hit e migliorando l'efficienza complessiva della cache.
GPTCache sfrutta algoritmi di embedding per convertire le query in rappresentazioni numeriche chiamate embedding. Questi embedding sono memorizzati in un archivio vettoriale, consentendo ricerche per similarità efficienti. Questo processo permette a GPTCache di identificare e recuperare dal deposito della cache query simili o correlate.
Grazie al design modulare, puoi personalizzare le implementazioni della cache semantica in base alle tue esigenze.
Tuttavia—talvolta in una cache semantica possono verificarsi falsi positivi e mancate corrispondenze. Per monitorare queste prestazioni, GPTCache fornisce tre metriche:
- Hit ratio misura il tasso di successo di una cache nel soddisfare le richieste. Valori più alti indicano prestazioni migliori.
- Latency indica il tempo necessario per recuperare i dati dalla cache: più basso è, meglio è.
- Recall mostra la quota di query in cache servite correttamente. Percentuali più alte riflettono maggiore accuratezza.
Funzionalità avanzate
Tutti gli elementi dati di base, come query iniziali, prompt, risposte e timestamp di accesso, sono archiviati in un "data manager". Attualmente GPTCache supporta le seguenti opzioni di archiviazione della cache:
- SQLite
- MySQL
- Database PostgreSQL.
Non supporta ancora i database "NoSQL", ma è previsto che vengano integrati a breve.
Uso delle politiche di espulsione
GPTCache può comunque rimuovere dati dall'archiviazione della cache in base a un limite o a un conteggio specificato. Per gestire le dimensioni della cache, puoi implementare una politica di espulsione Least Recently Used (LRU) o un approccio First In, First Out (FIFO).
- Politica LRU espelle gli elementi meno recenti in termini di accesso.
- La politica FIFO, invece, scarta gli elementi in cache presenti da più tempo.
Valutazione delle prestazioni delle risposte
GPTCache utilizza una funzione di "evaluation" per valutare se una risposta in cache risponde a una query dell'utente. Per farlo, prende in input tre elementi:
- la richiesta dell'utente
- i dati in cache da valutare
- parametri definiti dall'utente (se presenti)
Puoi anche usare altre due funzioni:
- log_time_func ti consente di registrare e riportare la durata di attività intensive come la generazione di embedding o l'esecuzione di ricerche nella cache. Aiuta a monitorare le caratteristiche prestazionali.
- Con similarity_threshold puoi definire la soglia per determinare quando due vettori di embedding (rappresentazioni ad alta dimensionalità di dati testuali) sono sufficientemente simili da essere considerati corrispondenti.
Buone pratiche e troubleshooting per GPTCache
Ora che sai come funziona GPTCache, ecco alcune buone pratiche e consigli per trarne il massimo.
Ottimizzare le prestazioni di GPTCache
Ci sono diversi passaggi che puoi seguire per ottimizzare le prestazioni di GPTCache, come illustrato di seguito.
1. Chiarisci i tuoi prompt
Il modo in cui imposti i prompt per l'LLM incide sull'efficacia di GPTCache. Quindi, mantieni una formulazione coerente per aumentare le probabilità di colpire la cache.
Per esempio, usa formulazioni coerenti come "Non riesco ad accedere al mio account". In questo modo, GPTCache riconosce in modo più efficiente problemi simili, come "Ho dimenticato la password" o "Problemi di accesso all'account".
2. Usa le metriche di tracciamento integrate
Monitora le metriche integrate come hit ratio, recall e latency per analizzare le prestazioni della cache. Un hit ratio più alto indica che la cache serve in modo più efficace i contenuti richiesti dai dati memorizzati, aiutandoti a valutarne l'efficacia.
3. Scalare GPTCache per applicazioni LLM con grandi basi utenti
Per scalare GPTCache su applicazioni LLM più grandi, implementa un approccio di cache condivisa che utilizzi la stessa cache per gruppi di utenti con profili simili. Crea profili utente e classificazioni per identificare gruppi di utenti affini.
Sfruttare una cache condivisa per utenti dello stesso gruppo di profilo offre un buon ritorno in termini di efficienza e scalabilità della cache.
Questo perché gli utenti all'interno dello stesso gruppo di profilo tendono ad avere query correlate che possono beneficiare di risposte in cache. Tuttavia, devi applicare tecniche appropriate di profilazione e classificazione degli utenti per raggrupparli correttamente e massimizzare i vantaggi del caching condiviso.
Risoluzione dei problemi comuni di GPTCache
Se riscontri difficoltà con GPTCache, ci sono diversi passaggi che puoi seguire per diagnosticare i problemi.
1. Invalidazione della cache
GPTCache si basa su risposte in cache aggiornate. Se le risposte dell'LLM sottostante o l'intento dell'utente cambiano nel tempo, le risposte in cache possono diventare inaccurate o irrilevanti.
Per evitarlo, imposta tempi di scadenza per le voci in cache in base alla frequenza di aggiornamento prevista dell'LLM e aggiorna regolarmente la cache.
2. Eccessiva dipendenza dalle risposte in cache
Sebbene GPTCache possa migliorare l'efficienza, un'eccessiva dipendenza dalle risposte in cache può portare a informazioni inesatte se la cache non viene invalidata correttamente.
A questo scopo, assicurati che l'applicazione recuperi di tanto in tanto risposte fresche dall'LLM, anche per query simili. Questo mantiene l'accuratezza e la qualità delle risposte quando si gestiscono informazioni critiche o sensibili al tempo.
3. Ignorare la qualità della cache
La qualità e la pertinenza delle risposte in cache incidono sull'esperienza utente. Dovresti quindi usare metriche di valutazione per verificare la qualità delle risposte in cache prima di servirle agli utenti.
Capendo questi potenziali problemi e le relative soluzioni, puoi garantire che GPTCache migliori efficacemente le prestazioni e la convenienza economica delle tue applicazioni basate su LLM—senza compromettere accuratezza o esperienza utente.
Conclusioni
GPTCache è uno strumento potente per ottimizzare le prestazioni e la convenienza economica delle applicazioni LLM. Sono necessarie una corretta configurazione, un monitoraggio costante e strategie di valutazione della cache per assicurarti risposte accurate e pertinenti.
Se sei alle prime armi con gli LLM, queste risorse possono aiutarti:




