GPTCache est un framework open source pour les applications de grands modèles de langage (LLM) comme ChatGPT. Il conserve les réponses déjà générées par le LLM pour des requêtes similaires. Plutôt que de solliciter à nouveau le LLM, l'application vérifie le cache pour trouver une réponse pertinente et vous faire gagner du temps.
Ce guide explique le fonctionnement de GPTCache et comment l'utiliser efficacement dans vos projets.
Qu'est-ce que GPTCache ?
GPTCache est un système de mise en cache conçu pour améliorer les performances et l'efficacité des grands modèles de langage (LLM) comme GPT-3. Il aide les LLM à stocker les requêtes et réponses générées précédemment afin d'économiser du temps et des ressources.
Lorsqu'une requête similaire se présente, le LLM peut récupérer la réponse en cache au lieu d'en produire une nouvelle depuis zéro.
Contrairement à d'autres outils, GPTCache repose sur la mise en cache sémantique. Les caches sémantiques retiennent l'objectif d'une requête/demande. Ainsi, quand des requêtes déjà stockées sont rappelées, leurs résultats allègent la charge serveur et améliorent le taux de hits du cache.
Avantages de l'utilisation de GPTCache
L'idée centrale de GPTCache est de stocker et de réutiliser les calculs intermédiaires générés lors de l'inférence d'un LLM. À la clé : plusieurs bénéfices :
Réduction des coûts liés aux appels API des LLM
La plupart des LLM facturent chaque requête en fonction du nombre de jetons traités. C'est là que GPTCache est utile : il limite le nombre d'appels API au LLM en servant des réponses déjà générées pour des requêtes similaires. Résultat : des économies en évitant des appels supplémentaires au LLM.
Temps de réponse et efficacité améliorés
Récupérer une réponse depuis un cache est nettement plus rapide que la générer à partir du LLM. Cela accélère l'affichage et améliore les temps de réponse. Des réponses efficaces déchargent également le LLM et libèrent des ressources pour d'autres tâches.
Expérience utilisateur améliorée grâce à des applications plus rapides
Supposons que vous cherchiez des questions pour votre contenu. Chaque question met une éternité à obtenir une réponse de l'IA. Pourquoi ? Parce que la plupart des services LLM imposent des limites de requêtes dans des périodes définies. Dépasser ces limites bloque les requêtes jusqu'au réarmement, ce qui entraîne des interruptions de service.
ChatGPT peut atteindre une limite de génération de réponses
Pour éviter ces problèmes, GPTchache met en cache les réponses précédentes à des questions similaires. Quand vous demandez quelque chose, il consulte rapidement sa mémoire et vous livre l'information en un clin d'œil. Vous obtenez ainsi votre réponse bien plus vite que d'habitude.
En bref, en s'appuyant sur des réponses en cache, GPTCache rend les applications fondées sur des LLM réactives et performantes — exactement comme vous l'attendez d'un outil moderne.
Configuration de GPTCache
Voici comment installer directement GPTCache :
Installation et configuration
Installez le package GPTCache avec le code suivant.
! pip install -q gptcacheEnsuite, importez GPTCache dans votre application.
from gptcache import GPTCache
cache = GPTCache()
# keep the mode default
Et c'est tout !
Intégration avec des LLM
Vous pouvez intégrer GPTCache aux LLM via son adaptateur LLM. À ce jour, il est compatible avec deux adaptateurs de grands modèles de langage :
- OpenAI
- Langchain
Voici comment l'intégrer avec ces deux adaptateurs :
GPTCache avec l'API OpenAI ChatGPT
Pour intégrer GPTCache à OpenAI, initialisez le cache et importez openai depuis gptcache.adapter.
from gptcache import cache
from gptcache.adapter import openai

cache.init()
cache.set_openai_key()
Avant d'exécuter l'exemple de code, définissez la variable d'environnement OPENAI_API_KEY en exécutant echo $OPENAI_API_KEY.
Si elle n'est pas encore définie, vous pouvez la définir avec export OPENAI_API_KEY=YOUR_API_KEY sur Unix/Linux/MacOS ou set OPENAI_API_KEY=YOUR_API_KEY sur Windows.
Ensuite, si vous posez deux fois exactement la même question à ChatGPT, la réponse à la seconde sera récupérée depuis le cache au lieu de solliciter à nouveau ChatGPT.
Voici un exemple de code pour une recherche de similarité avec cache :
import time


def response_text(openai_resp):
    return openai_resp['choices'][0]['message']['content']

print("Cache loading.....")

# To use GPTCache, that's all you need
# -------------------------------------------------
from gptcache import cache
from gptcache.adapter import openai

cache.init()
cache.set_openai_key()
# -------------------------------------------------

question = "what's github"
for _ in range(2):
    start_time = time.time()
    response = openai.ChatCompletion.create(
      model='gpt-3.5-turbo',
      messages=[
        {
            'role': 'user',
            'content': question
        }
      ],
    )
    print(f'Question: {question}')
    print("Time consuming: {:.2f}s".format(time.time() - start_time))
    print(f'Answer: {response_text(response)}\n')
Voici ce que vous verrez en sortie :
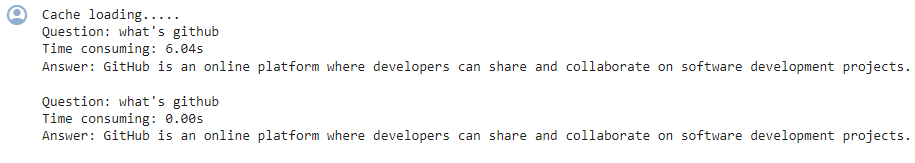
La deuxième fois, GPT a répondu en quasi 0 seconde à la même question
GPTCache avec LangChain
Si vous souhaitez utiliser un autre LLM, essayez l'adaptateur LangChain. Voici comment intégrer GPTCahe à LangChain :
from langchain.globals import set_llm_cache
from langchain_openai import OpenAI

# To make the caching really obvious, lets use a slower model.
llm = OpenAI(model_name="gpt-3.5-turbo-instruct", n=2, best_of=2)
Apprenez à créer des applications LLM avec LangChain.
Utiliser GPTCache dans vos projets
Voyons comment GPTCache peut soutenir vos projets.
Fonctionnalités de base
Les LLM peuvent perdre en efficacité en raison de la complexité et de la variabilité inhérentes des requêtes, ce qui entraîne un faible taux de hits du cache.
Pour y remédier, GPTCache adopte des stratégies de mise en cache sémantique. La mise en cache sémantique stocke des requêtes similaires ou liées — ce qui augmente la probabilité de hits et améliore l'efficacité globale du cache.
GPTCache s'appuie sur des algorithmes d'embarquement pour convertir les requêtes en représentations numériques appelées embeddings. Ces embeddings sont stockés dans un magasin vectoriel afin de permettre des recherches de similarité efficaces. Ce processus permet à GPTCache d'identifier et de récupérer des requêtes similaires ou apparentées depuis le cache.
Grâce à sa conception modulaire, vous pouvez personnaliser la mise en cache sémantique selon vos besoins.
Cependant, des faux positifs (hits) et des loupés (misses) peuvent survenir avec un cache sémantique. Pour suivre ces performances, GPTCache propose trois indicateurs :
- Taux de hits (hit ratio) mesure la part de requêtes satisfaites par le cache. Plus il est élevé, mieux c'est.
- Latence indique le temps nécessaire pour récupérer les données dans le cache : plus c'est bas, mieux c'est.
- Rappel (recall) reflète la proportion de requêtes correctement servies par le cache. Des pourcentages plus élevés indiquent une meilleure précision.
Fonctionnalités avancées
Tous les éléments de base — requêtes initiales, invites, réponses et horodatages d'accès — sont stockés dans un « gestionnaire de données ». GPTCache prend actuellement en charge les stockages de cache suivants :
- SQLite
- MySQL
- Bases PostgreSQL.
Les bases « NoSQL » ne sont pas encore prises en charge, mais leur intégration est prévue.
Utiliser des politiques d'éviction
GPTCache peut supprimer des données du cache en fonction d'une limite ou d'un compteur défini. Pour maîtriser la taille du cache, vous pouvez appliquer soit une politique LRU (Least Recently Used), soit une approche FIFO (First In, First Out).
- LRU évince les éléments les moins récemment consultés.
- La politique FIFO élimine les éléments en cache présents depuis le plus longtemps.
Évaluer la pertinence des réponses
GPTCache utilise une fonction d'« évaluation » pour vérifier si une réponse en cache répond bien à la requête de l'utilisateur. Elle prend trois entrées :
- la demande de l'utilisateur
- la donnée en cache évaluée
- des paramètres définis par l'utilisateur (le cas échéant)
Vous pouvez aussi utiliser deux autres fonctions :
- log_time_func permet d'enregistrer et de rapporter la durée de tâches intensives comme la génération d'embeddings ou les recherches dans le cache, afin de suivre les caractéristiques de performance.
- Avec similarity_threshold, vous définissez le seuil à partir duquel deux vecteurs d'embedding (représentations textuelles de haute dimension) sont jugés suffisamment similaires pour correspondre.
Bonnes pratiques et dépannage pour GPTCache
Maintenant que vous connaissez le fonctionnement de GPTCache, voici des bonnes pratiques et conseils pour en tirer le meilleur parti.
Optimiser les performances de GPTCache
Plusieurs actions permettent d'optimiser les performances de GPTCache, comme indiqué ci-dessous.
1. Clarifiez vos invites
La façon dont vous formulez vos prompts influe sur l'efficacité de GPTCache. Gardez une phraséologie cohérente pour augmenter vos chances de hit dans le cache.
Par exemple, utilisez une tournure constante comme « Je ne peux pas me connecter à mon compte ». De cette manière, GPTCache repère plus facilement des problématiques proches comme « Mot de passe oublié » ou « Problèmes de connexion au compte ».
2. Exploitez les indicateurs intégrés
Surveillez les indicateurs intégrés comme le taux de hits, le rappel et la latence pour analyser la performance de votre cache. Un taux de hits élevé signifie que le cache sert plus efficacement les contenus demandés à partir des données stockées.
3. Faire passer GPTCache à l'échelle pour des applications LLM à grand volume
Pour monter en charge, mettez en place un cache partagé qui utilise le même cache pour des groupes d'utilisateurs aux profils similaires. Créez des profils et classez les utilisateurs pour identifier des groupes proches.
Exploiter un cache partagé pour un même groupe de profils améliore l'efficacité du cache et sa capacité à évoluer.
En effet, les utilisateurs d'un même groupe ont tendance à poser des requêtes apparentées qui bénéficient de réponses en cache. Il est toutefois essentiel d'appliquer des techniques adéquates de profilage et de classification pour regrouper les utilisateurs et maximiser les gains du cache partagé.
Dépanner les problèmes courants de GPTCache
Si vous rencontrez des difficultés avec GPTCache, voici quelques pistes de dépannage.
1. Invalidation du cache
GPTCache repose sur des réponses en cache à jour. Si les réponses du LLM sous-jacent ou l'intention de l'utilisateur évoluent, les réponses en cache peuvent devenir inexactes ou obsolètes.
Pour éviter cela, définissez des durées d'expiration des entrées en fonction de la fréquence prévisible de mise à jour du LLM et actualisez régulièrement le cache.
2. Surdépendance au cache
Même si GPTCache améliore l'efficacité, s'y fier excessivement peut conduire à des informations inexactes si le cache n'est pas correctement invalidé.
Veillez donc à ce que votre application récupère périodiquement des réponses fraîches du LLM, y compris pour des requêtes similaires. Cela préserve la précision et la qualité des réponses, notamment pour des informations critiques ou sensibles au temps.
3. Négliger la qualité du cache
La qualité et la pertinence des réponses en cache impactent l'expérience utilisateur. Utilisez des métriques d'évaluation pour mesurer la qualité des réponses avant de les servir.
En comprenant ces écueils potentiels et leurs solutions, vous garantissez que GPTCache améliore efficacement les performances et la maîtrise des coûts de vos applications propulsées par des LLM — sans compromettre la précision ni l'expérience utilisateur.
En résumé
GPTCache est un outil puissant pour optimiser les performances et les coûts des applications LLM. Une bonne configuration, un suivi attentif et des stratégies d'évaluation du cache sont nécessaires pour garantir des réponses exactes et pertinentes.
Si vous débutez avec les LLM, ces ressources peuvent vous aider :