GPTCache es un framework de código abierto para aplicaciones con grandes modelos de lenguaje (LLM) como ChatGPT. Almacena respuestas de LLM generadas previamente para consultas similares. En lugar de depender siempre del LLM, la aplicación consulta la caché para encontrar una respuesta relevante y ahorrarte tiempo.
En esta guía verás cómo funciona GPTCache y cómo puedes sacarle partido en tus proyectos.
¿Qué es GPTCache?
GPTCache es un sistema de caché diseñado para mejorar el rendimiento y la eficiencia de los grandes modelos de lenguaje (LLM) como GPT-3. Ayuda a los LLM a guardar consultas y respuestas generadas previamente para ahorrar tiempo y esfuerzo.
Cuando surge una consulta similar, el LLM puede recuperar la respuesta almacenada en la caché en lugar de crear una nueva desde cero.
A diferencia de otras herramientas, GPTCache se basa en caché semántica. Las cachés semánticas retienen el objetivo de una consulta o petición. Así, al recuperar consultas almacenadas, se reduce la carga del servidor y mejoran las tasas de acierto de la caché.
Ventajas de usar GPTCache
La idea principal de GPTCache es almacenar y reutilizar los cálculos intermedios generados durante la inferencia de un LLM. Esto aporta varios beneficios:
Ahorro en costes de llamadas a la API del LLM
La mayoría de LLM cobran una tarifa por petición en función del número de tokens procesados. Ahí es donde GPTCache resulta muy útil: minimiza llamadas a la API sirviendo respuestas ya generadas para consultas similares. Como consecuencia, reduce el gasto en llamadas adicionales al LLM.
Mejor tiempo de respuesta y eficiencia
Recuperar una respuesta desde la caché es mucho más rápido que generarla desde cero consultando al LLM. Aumenta la velocidad y mejora los tiempos de respuesta. Respuestas más eficientes reducen la carga sobre el propio LLM y liberan recursos para otras tareas.
Mejor experiencia de usuario gracias a un rendimiento más rápido
Imagina que buscas preguntas para tu contenido. Cada pregunta tarda una eternidad en responderse con IA. ¿Por qué? Porque muchos servicios de LLM imponen límites de peticiones por periodos. Si superas esos límites, se bloquean nuevas peticiones hasta que se restablezcan, lo que provoca interrupciones del servicio.
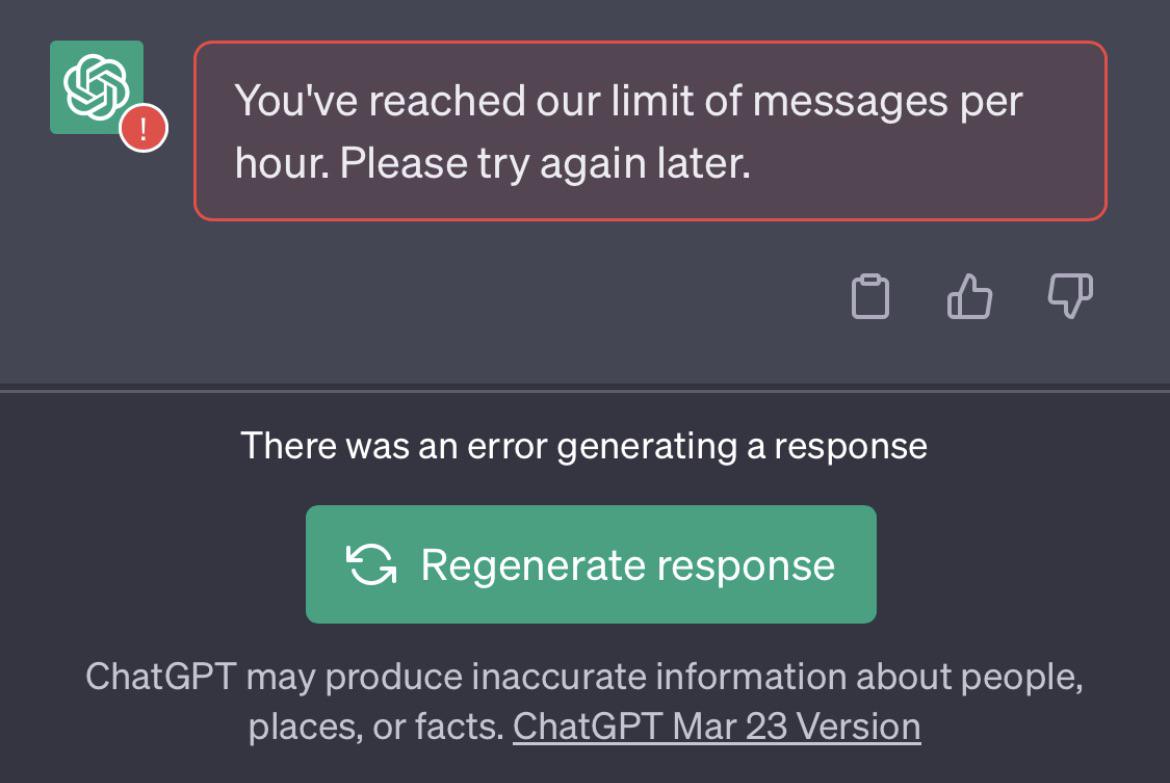
ChatGPT puede alcanzar su límite de generación de respuestas
Para evitar estos problemas, GPTchache almacena respuestas previas a preguntas similares. Cuando pides algo, comprueba su memoria al instante y te entrega la información al momento. Así, recibes la respuesta en menos tiempo del habitual.
En pocas palabras, al aprovechar respuestas en caché, GPTCache hace que las aplicaciones basadas en LLM sean ágiles y eficientes, como esperas de cualquier herramienta moderna.
Configuración de GPTCache
Así puedes instalar GPTCache directamente:
Instalación y configuración
Instala el paquete GPTCache con este código.
! pip install -q gptcacheDespués, importa GPTCache en tu aplicación.
from gptcache import GPTCache
cache = GPTCache()
# keep the mode default
¡Listo, ya lo tienes!
Integración con LLM
Puedes integrar GPTCache con LLM mediante su LLM Adapter. A día de hoy, es compatible con dos adaptadores de grandes modelos de lenguaje:
- OpenAI
- Langchain
Así puedes integrarlo con ambos adaptadores:
GPTCache con la API de OpenAI ChatGPT
Para integrar GPTCache con OpenAI, inicializa la caché e importa openai desde gptcache.adapter.
from gptcache import cache
from gptcache.adapter import openai

cache.init()
cache.set_openai_key()
Antes de ejecutar el ejemplo, establece la variable de entorno OPENAI_API_KEY ejecutando echo $OPENAI_API_KEY.
Si no está definida, puedes hacerlo con export OPENAI_API_KEY=YOUR_API_KEY en sistemas Unix/Linux/MacOS o set OPENAI_API_KEY=YOUR_API_KEY en Windows.
Luego, si haces dos veces la misma pregunta a ChatGPT, la segunda respuesta se recuperará de la caché en lugar de volver a preguntarle a ChatGPT.
Aquí tienes un ejemplo de caché por búsqueda de similitud:
import time


def response_text(openai_resp):
    return openai_resp['choices'][0]['message']['content']

print("Cache loading.....")

# To use GPTCache, that's all you need
# -------------------------------------------------
from gptcache import cache
from gptcache.adapter import openai

cache.init()
cache.set_openai_key()
# -------------------------------------------------

question = "what's github"
for _ in range(2):
    start_time = time.time()
    response = openai.ChatCompletion.create(
      model='gpt-3.5-turbo',
      messages=[
        {
            'role': 'user',
            'content': question
        }
      ],
    )
    print(f'Question: {question}')
    print("Time consuming: {:.2f}s".format(time.time() - start_time))
    print(f'Answer: {response_text(response)}\n')
Esto es lo que verás en la salida:
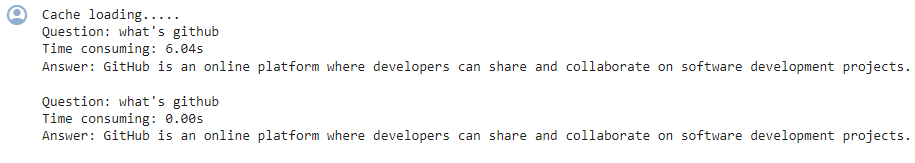
La segunda vez, GPT tardó prácticamente 0 segundos en responder a la misma pregunta
GPTCache con LangChain
Si quieres usar un LLM diferente, prueba el adaptador de LangChain. Así puedes integrar GPTCahe con LangChain:
from langchain.globals import set_llm_cache
from langchain_openai import OpenAI

# To make the caching really obvious, lets use a slower model.
llm = OpenAI(model_name="gpt-3.5-turbo-instruct", n=2, best_of=2)
Aprende a crear aplicaciones LLM con LangChain.
Cómo usar GPTCache en tus proyectos
Veamos cómo GPTCache puede ayudar en tus proyectos.
Operaciones básicas
Los LLM pueden perder eficacia por la complejidad y variabilidad inherentes de sus consultas, lo que provoca una baja tasa de acierto en caché.
Para superar esta limitación, GPTCache adopta estrategias de caché semántica. La caché semántica almacena consultas similares o relacionadas, aumentando la probabilidad de aciertos y mejorando la eficiencia global.
GPTCache utiliza algoritmos de embeddings para convertir consultas en representaciones numéricas llamadas embeddings. Estos embeddings se guardan en un vector store, lo que permite búsquedas por similitud eficientes. Así, GPTCache identifica y recupera consultas similares o relacionadas desde el almacenamiento en caché.
Gracias a su diseño modular, puedes personalizar las implementaciones de caché semántica según tus necesidades.
Ahora bien, en una caché semántica a veces pueden producirse falsos aciertos y fallos. Para vigilar su rendimiento, GPTCache ofrece tres métricas clave:
- Hit ratio: mide el porcentaje de peticiones resueltas por la caché. Cuanto más alto, mejor.
- Latencia: indica el tiempo necesario para recuperar datos de la caché; cuanto menor, mejor.
- Recall: muestra la proporción de consultas atendidas correctamente desde la caché. Valores altos reflejan mayor precisión.
Funciones avanzadas
Todos los elementos básicos de datos —consultas iniciales, prompts, respuestas y marcas de tiempo de acceso— se almacenan en un "gestor de datos". GPTCache admite actualmente estas opciones de almacenamiento de caché:
- SQLite
- MySQL
- Bases de datos PostgreSQL
Aún no es compatible con bases de datos «NoSQL», pero está previsto incorporarlas próximamente.
Uso de políticas de expulsión
GPTCache puede eliminar datos del almacenamiento en caché en función de un límite o un recuento específicos. Para gestionar el tamaño de la caché, puedes aplicar una política de expulsión Least Recently Used (LRU) o un enfoque First In, First Out (FIFO).
- Política LRU: expulsa los elementos a los que se accedió hace más tiempo.
- La política FIFO descarta los elementos que llevan más tiempo en la caché.
Evaluación del rendimiento de las respuestas
GPTCache utiliza una función de «evaluación» para determinar si una respuesta en caché cubre la consulta del usuario. Para ello, toma tres entradas:
- la solicitud del usuario
- los datos en caché a evaluar
- parámetros definidos por el usuario (si los hay)
También puedes usar otras dos funciones:
- log_time_func te permite registrar e informar la duración de tareas costosas como generar embeddings o realizar búsquedas en la caché. Ayuda a monitorizar el rendimiento.
- Con similarity_threshold defines el umbral a partir del cual dos vectores de embedding (representaciones de texto de alta dimensión) se consideran lo bastante similares como para emparejarlos.
Buenas prácticas y resolución de problemas con GPTCache
Ahora que ya sabes cómo funciona GPTCache, aquí tienes algunas buenas prácticas y consejos para sacarle todo el partido.
Optimizar el rendimiento de GPTCache
Puedes seguir varios pasos para optimizar el rendimiento de GPTCache, como los que se indican a continuación.
1. Aclara tus prompts
Cómo formulas tus prompts influye en el rendimiento de GPTCache. Mantén una redacción consistente para aumentar las probabilidades de acertar en la caché.
Por ejemplo, utiliza frases coherentes como "No puedo iniciar sesión en mi cuenta". Así, GPTCache reconocerá con más facilidad incidencias similares como "He olvidado mi contraseña" o "Problemas de inicio de sesión".
2. Usa las métricas integradas
Supervisa métricas como hit ratio, recall y latencia para analizar el rendimiento de tu caché. Un hit ratio alto indica que la caché sirve más contenido desde los datos almacenados, lo que te ayuda a entender su eficacia.
3. Escalar GPTCache para aplicaciones con muchos usuarios
Para escalar GPTCache en aplicaciones de mayor tamaño, implementa una caché compartida que utilice la misma caché para grupos de usuarios con perfiles similares. Crea perfiles de usuario y clasifícalos para identificar grupos afines.
Aprovechar una caché compartida para usuarios del mismo grupo de perfil mejora la eficiencia y la escalabilidad.
Esto se debe a que los usuarios dentro de un mismo grupo tienden a tener consultas relacionadas que se benefician de respuestas en caché. Eso sí, aplica técnicas adecuadas de perfilado y clasificación para agrupar usuarios y maximizar las ventajas de la caché compartida.
Solución de problemas comunes en GPTCache
Si te estás encontrando problemas con GPTCache, hay varios pasos que puedes seguir para solucionarlos.
1. Invalidación de la caché
GPTCache depende de respuestas en caché actualizadas. Si cambian con el tiempo las respuestas del LLM o la intención del usuario, las respuestas almacenadas pueden volverse inexactas o irrelevantes.
Para evitarlo, establece tiempos de expiración para las entradas en caché según la frecuencia prevista de actualización del LLM y actualiza la caché con regularidad.
2. Exceso de confianza en las respuestas en caché
Aunque GPTCache mejora la eficiencia, depender en exceso de respuestas en caché puede derivar en información incorrecta si no se invalidan a tiempo.
Por ello, asegúrate de que tu aplicación obtenga de vez en cuando respuestas nuevas del LLM, incluso para consultas similares. Así mantendrás la precisión y calidad cuando trates información crítica o sensible al tiempo.
3. Ignorar la calidad de la caché
La calidad y relevancia de las respuestas almacenadas afecta a la experiencia de usuario. Utiliza métricas de evaluación para comprobar la calidad de las respuestas en caché antes de servirlas.
Si comprendes estos posibles escollos y sus soluciones, te asegurarás de que GPTCache mejora el rendimiento y la rentabilidad de tus aplicaciones con LLM sin comprometer la precisión ni la experiencia de usuario.
Conclusión
GPTCache es una herramienta potente para optimizar el rendimiento y los costes de aplicaciones con LLM. Requiere una configuración adecuada, monitorización y estrategias de evaluación de la caché para garantizar respuestas precisas y relevantes.
Si estás empezando con los LLM, estos recursos pueden ayudarte: