GPTCache ist ein Open-Source-Framework für Anwendungen mit großen Sprachmodellen (LLMs) wie ChatGPT. Es speichert zuvor generierte LLM-Antworten auf ähnliche Anfragen. Anstatt sich jedes Mal auf das LLM zu verlassen, prüft die Anwendung den Cache auf eine passende Antwort – und spart dir so Zeit.
Diese Anleitung zeigt, wie GPTCache funktioniert und wie du es in deinen Projekten effektiv einsetzt.
Was ist GPTCache?
GPTCache ist ein Caching-System, das die Leistung und Effizienz von Large Language Models (LLMs) wie GPT-3 verbessert. Es hilft, zuvor generierte Antworten zu speichern, um Zeit und Rechenaufwand zu reduzieren.
Taucht später eine ähnliche Anfrage auf, kann das LLM die zwischengespeicherte Antwort abrufen, statt eine komplett neue zu erzeugen.
Im Unterschied zu vielen Tools setzt GPTCache auf semantisches Caching. Dabei wird die inhaltliche Absicht einer Anfrage gespeichert. So lassen sich bei erneut auftretenden, inhaltlich ähnlichen Fragen Serverlast reduzieren und die Cache-Trefferquote steigern.
Vorteile der Nutzung von GPTCache
Die Grundidee hinter GPTCache ist es, Zwischenergebnisse aus der Inferenz eines LLMs zu speichern und wiederzuverwenden. Das bringt mehrere Vorteile:
Kosteneinsparungen bei LLM-API-Aufrufen
Die meisten LLMs berechnen Gebühren pro Anfrage, abhängig von der Anzahl verarbeiteter Tokens. Hier spielt GPTCache seine Stärken aus: Es reduziert die Zahl der API-Aufrufe, indem es für ähnliche Anfragen bereits erzeugte Antworten ausliefert. So sinken die Kosten für zusätzliche LLM-Calls.
Schnellere Antwortzeiten und höhere Effizienz
Eine Antwort aus dem Cache abzurufen ist deutlich schneller, als sie über das LLM neu zu generieren. Das beschleunigt die Anwendung und verbessert die Antwortzeiten. Effiziente Antworten entlasten zudem das LLM und schaffen Kapazitäten für andere Aufgaben.
Bessere User Experience dank schnellerer Performance
Stell dir vor, du suchst Fragen für deinen Content. Jede Frage braucht ewig, bis die KI antwortet. Warum? Weil viele LLM-Dienste Anfragelimits pro Zeitraum durchsetzen. Wenn du diese Limits überschreitest, sind weitere Anfragen blockiert, bis das Limit zurückgesetzt wird – mit entsprechenden Unterbrechungen.
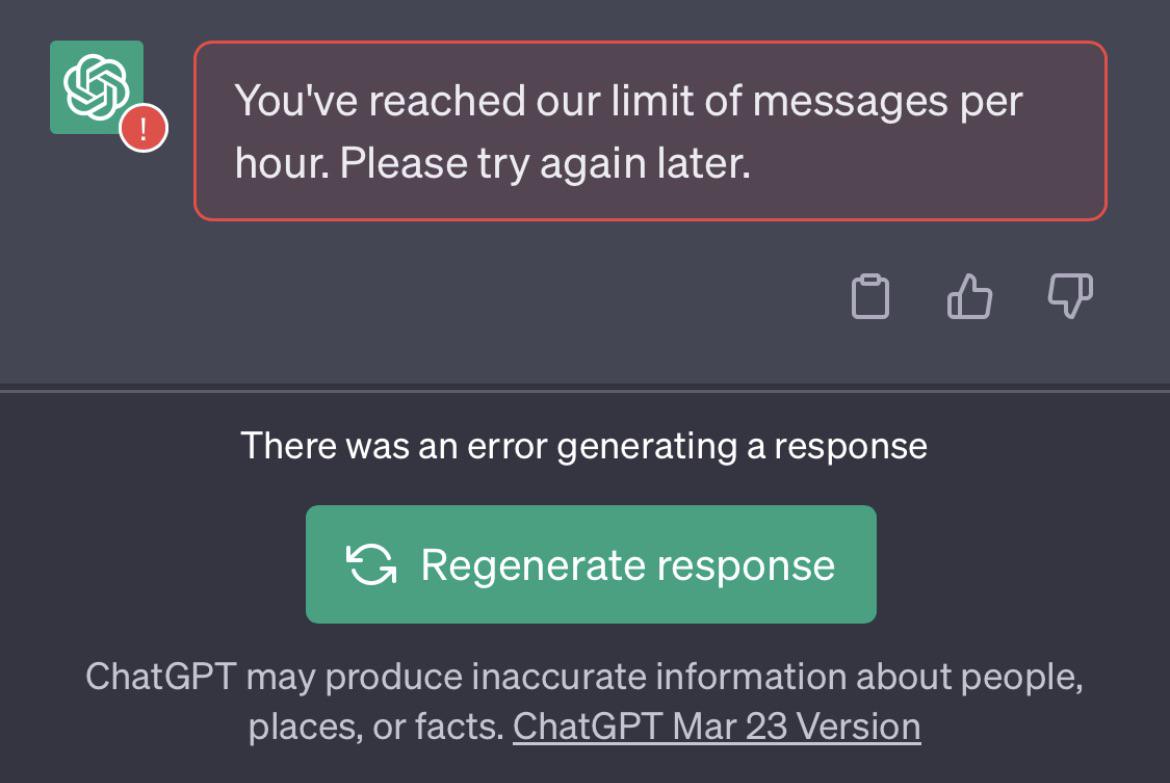
ChatGPT kann das Limit zur Antwortgenerierung erreichen
Um das zu vermeiden, speichert GPTchache frühere Antworten auf ähnliche Fragen. Wenn du etwas fragst, prüft es blitzschnell den Speicher und liefert dir die Information sofort. So erhältst du deine Antwort deutlich schneller als üblich.
Kurz gesagt: Durch die Nutzung zwischengespeicherter Antworten macht GPTCache LLM-basierte Anwendungen reaktionsschnell und effizient – so, wie du es von modernen Tools erwartest.
GPTCache einrichten
So installierst du GPTCache direkt:
Installation und Konfiguration
Installiere das GPTCache-Paket mit diesem Code.
! pip install -q gptcacheImportiere anschließend GPTCache in deine Anwendung.
from gptcache import GPTCache
cache = GPTCache()
# keep the mode default
Das war’s schon.
Integration mit LLMs
Du kannst GPTCache über den LLM Adapter mit LLMs integrieren. Aktuell ist es mit zwei Adaptern für große Sprachmodelle kompatibel:
- OpenAI
- Langchain
So integrierst du beide Adapter:
GPTCache mit der OpenAI ChatGPT API
Um GPTCache mit OpenAI zu verbinden, initialisierst du den Cache und importierst openai aus gptcache.adapter.
from gptcache import cache
from gptcache.adapter import openai

cache.init()
cache.set_openai_key()
Bevor du den Beispielcode ausführst, setze die Umgebungsvariable OPENAI_API_KEY, indem du echo $OPENAI_API_KEY ausführst.
Falls sie noch nicht gesetzt ist, kannst du sie unter Unix/Linux/macOS mit export OPENAI_API_KEY=YOUR_API_KEY oder unter Windows mit set OPENAI_API_KEY=YOUR_API_KEY setzen.
Wenn du dann ChatGPT zweimal exakt dieselbe Frage stellst, wird die Antwort auf die zweite Frage aus dem Cache geholt, statt ChatGPT erneut zu fragen.
Hier ein Beispielcode für semantisches Such-Caching:
import time


def response_text(openai_resp):
    return openai_resp['choices'][0]['message']['content']

print("Cache loading.....")

# To use GPTCache, that's all you need
# -------------------------------------------------
from gptcache import cache
from gptcache.adapter import openai

cache.init()
cache.set_openai_key()
# -------------------------------------------------

question = "what's github"
for _ in range(2):
    start_time = time.time()
    response = openai.ChatCompletion.create(
      model='gpt-3.5-turbo',
      messages=[
        {
            'role': 'user',
            'content': question
        }
      ],
    )
    print(f'Question: {question}')
    print("Time consuming: {:.2f}s".format(time.time() - start_time))
    print(f'Answer: {response_text(response)}\n')
Das siehst du in der Ausgabe:
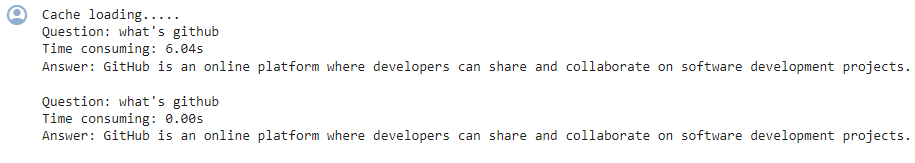
Beim zweiten Mal brauchte GPT fast 0 Sekunden für dieselbe Frage.
GPTCache mit LangChain
Wenn du ein anderes LLM nutzen möchtest, probiere den LangChain-Adapter. So integrierst du GPTCahe mit LangChain:
from langchain.globals import set_llm_cache
from langchain_openai import OpenAI

# To make the caching really obvious, lets use a slower model.
llm = OpenAI(model_name="gpt-3.5-turbo-instruct", n=2, best_of=2)
Erfahre, wie du LLM-Anwendungen mit LangChain baust.
GPTCache in deinen Projekten einsetzen
Schauen wir uns an, wie GPTCache deine Projekte unterstützen kann.
Grundlegende Funktionen
LLMs können durch die inhärente Komplexität und Variabilität von Anfragen an Wirksamkeit verlieren – die Folge ist eine niedrige Cache-Trefferquote.
Um das zu umgehen, setzt GPTCache auf semantisches Caching. Dabei werden ähnliche oder verwandte Anfragen gespeichert – das steigert die Trefferwahrscheinlichkeit und die gesamte Caching-Effizienz.
GPTCache nutzt Embedding-Algorithmen, um Anfragen in numerische Repräsentationen, sogenannte Embeddings, zu überführen. Diese werden in einem Vektorspeicher abgelegt, was effiziente Ähnlichkeitssuchen ermöglicht. So kann GPTCache ähnliche oder verwandte Anfragen im Cache identifizieren und abrufen.
Dank des modularen Designs kannst du semantische Cache-Implementierungen an deine Anforderungen anpassen.
Allerdings können in einem semantischen Cache auch falsche Treffer oder verpasste Treffer auftreten. Zur Überwachung stellt GPTCache drei Kennzahlen bereit:
- Hit Ratio misst, wie häufig der Cache Anfragen erfolgreich bedient. Je höher, desto besser.
- Latenz gibt an, wie lange das Abrufen aus dem Cache dauert – je niedriger, desto besser.
- Recall zeigt den Anteil korrekt bedienter Cache-Anfragen. Ein höherer Wert bedeutet höhere Genauigkeit.
Erweiterte Funktionen
Alle Basisdaten wie ursprüngliche Anfragen, Prompts, Antworten und Zugriffszeitstempel werden in einem „Data Manager“ gespeichert. GPTCache unterstützt derzeit folgende Speicheroptionen für den Cache:
- SQLite
- MySQL
- PostgreSQL-Datenbanken
„NoSQL“-Datenbanken werden noch nicht unterstützt, sind aber geplant.
Eviction-Policies nutzen
GPTCache kann Daten anhand eines festgelegten Limits oder einer Anzahl aus dem Cache entfernen. Zur Steuerung der Cache-Größe kannst du entweder eine Least-Recently-Used-(LRU)-Policy oder First-In-First-Out (FIFO) einsetzen.
- LRU-Policy entfernt die Elemente, auf die am längsten nicht zugegriffen wurde.
- Die FIFO-Policy verwirft die Einträge, die am längsten im Cache liegen.
Antwortqualität bewerten
GPTCache nutzt eine „Evaluation“-Funktion, um zu prüfen, ob eine zwischengespeicherte Antwort die Nutzeranfrage abdeckt. Dafür benötigt sie drei Eingaben:
- Die Anfrage des Nutzers
- Die zu bewertenden Cache-Daten
- Optionale, vom Nutzer definierte Parameter
Zudem stehen dir zwei weitere Funktionen zur Verfügung:
- log_time_func erfasst und protokolliert die Dauer rechenintensiver Aufgaben wie das Erzeugen von Embeddings oder das Durchführen von Cache-Suchen. So behältst du die Performance im Blick.
- Mit similarity_threshold legst du fest, ab welchem Schwellenwert zwei Embedding-Vektoren (hochdimensionale Textrepräsentationen) als ausreichend ähnlich gelten.
Best Practices und Troubleshooting für GPTCache
Jetzt, da du weißt, wie GPTCache funktioniert, kommen hier Best Practices und Tipps, damit du maximal profitierst.
GPTCache-Leistung optimieren
Mit den folgenden Maßnahmen holst du mehr aus GPTCache heraus:
1. Prompts klar formulieren
Wie du dein LLM anleitest, beeinflusst die Wirksamkeit von GPTCache. Halte daher deine Formulierungen konsistent, um die Cache-Trefferquote zu erhöhen.
Nutze zum Beispiel eine einheitliche Formulierung wie „Ich kann mich nicht in mein Konto einloggen.“ So erkennt GPTCache verwandte Anliegen wie „Passwort vergessen“ oder „Probleme beim Login“ leichter.
2. Eingebaute Metriken nutzen
Überwache Metriken wie Hit Ratio, Recall und Latenz, um die Cache-Leistung zu analysieren. Eine hohe Hit Ratio zeigt, dass der Cache Anfragen häufig aus gespeicherten Daten bedienen kann – ein guter Indikator für die Effektivität.
3. GPTCache für große Nutzerzahlen skalieren
Für größere LLM-Anwendungen bietet sich ein Shared-Cache-Ansatz an, bei dem Nutzergruppen mit ähnlichen Profilen denselben Cache verwenden. Lege Nutzerprofile an und klassifiziere sie, um ähnliche Gruppen zu bilden.
Ein gemeinsamer Cache für Nutzer derselben Profilgruppe steigert Effizienz und Skalierbarkeit.
Denn Nutzer innerhalb einer Profilgruppe stellen oft verwandte Fragen, die von zwischengespeicherten Antworten profitieren. Wichtig ist dabei, sauberes Profiling und eine passende Klassifikation einzusetzen, um die Gruppen korrekt zu bilden und den Nutzen maximal auszuschöpfen.
Häufige GPTCache-Probleme beheben
Wenn du mit GPTCache Schwierigkeiten hast, helfen diese Schritte beim Troubleshooting:
1. Cache-Invalidierung
GPTCache ist auf aktuelle zwischengespeicherte Antworten angewiesen. Ändern sich die Antworten des zugrunde liegenden LLMs oder die Nutzerintention, können Caches veralten oder irrelevant werden.
Setze daher Ablaufzeiten für Cache-Einträge, orientiert an der erwarteten Aktualisierungshäufigkeit des LLMs, und frische den Cache regelmäßig auf.
2. Zu starke Abhängigkeit vom Cache
Auch wenn GPTCache effizienter macht, kann eine zu starke Abhängigkeit zu ungenauen Informationen führen, wenn Einträge nicht rechtzeitig invalidiert werden.
Stelle sicher, dass deine Anwendung regelmäßig frische Antworten vom LLM abruft – auch bei ähnlichen Anfragen. So bleiben Genauigkeit und Qualität bei kritischen oder zeitabhängigen Informationen gewahrt.
3. Cache-Qualität ignorieren
Qualität und Relevanz zwischengespeicherter Antworten prägen die User Experience. Nutze Bewertungsmetriken, um die Cache-Qualität zu prüfen, bevor Antworten ausgespielt werden.
Wenn du diese Fallstricke kennst und adressierst, steigerst du die Performance und Kosteneffizienz deiner LLM-Anwendungen mit GPTCache – ohne Genauigkeit oder Nutzererlebnis zu opfern.
Fazit
GPTCache ist ein starkes Tool, um Leistung und Kosteneffizienz von LLM-Anwendungen zu optimieren. Mit der richtigen Konfiguration, Überwachung und Bewertung des Caches erhältst du präzise und relevante Antworten.
Wenn du neu im Umgang mit LLMs bist, helfen dir diese Ressourcen weiter: