GPTCache, ChatGPT gibi büyük dil modeli (LLM) uygulamaları için açık kaynaklı bir çerçevedir. Benzer sorgular için daha önce üretilmiş LLM yanıtlarını depolar. Uygulama, LLM’e başvurmak yerine zamandan tasarruf etmek için uygun bir yanıt olup olmadığını önbellekte kontrol eder.
Bu rehber, GPTCache’in nasıl çalıştığını ve projelerinizde onu nasıl etkili bir şekilde kullanabileceğinizi inceler.
GPTCache nedir?
GPTCache, GPT-3 gibi büyük dil modellerinin (LLM) performansını ve verimliliğini artırmak için tasarlanmış bir önbellekleme sistemidir. Zaman ve emek tasarrufu için daha önce oluşturulan sorguları depolamaya yardımcı olur.
Benzer bir sorgu tekrar geldiğinde, LLM sıfırdan yeni bir yanıt üretmek yerine önbellekteki yanıtı sunabilir.
Diğer araçlardan farklı olarak GPTCache, anlamsal önbellekleme ile çalışır. Anlamsal önbellekler bir sorgu/isteğin amacını tutar. Sonuç olarak, daha önce depolanan sorgular geri çağrıldığında, sonuçları sunucu iş yükünü azaltır ve önbellek isabet oranlarını iyileştirir.
GPTCache Kullanmanın Faydaları
GPTCache’in arkasındaki temel fikir, bir LLM’in çıkarım süreci sırasında üretilen ara hesaplamaları depolamak ve yeniden kullanmaktır. Bunu yapmak çeşitli faydalar sağlar:
LLM API çağrılarında maliyet tasarrufu
Çoğu LLM, işlenen belirteç sayısına göre istek başına belirli bir ücret alır. İşte bu noktada GPTCache işe yarar. Benzer sorgular için daha önce üretilmiş yanıtları sunarak LLM API çağrılarının sayısını en aza indirir. Sonuç olarak, ek LLM çağrı maliyetlerini azaltarak tasarruf sağlar.
Yanıt süresi ve verimlilikte iyileşme
Yanıtı önbellekten almak, LLM’i sorgulayarak sıfırdan üretmekten çok daha hızlıdır. Bu da hızı artırır ve yanıt sürelerini iyileştirir. Verimli yanıtlar, LLM’in üzerindeki yükü azaltır ve diğer görevlere ayrılabilecek alanı serbest bırakır.
Daha hızlı uygulama performansıyla gelişmiş kullanıcı deneyimi
Diyelim ki içeriğiniz için sorular arıyorsunuz. Sorduğunuz her soruya yapay zekânın yanıt vermesi çok uzun sürüyor. Neden? Çünkü çoğu LLM hizmeti, belirli zaman dilimlerinde istek sınırları uygular. Bu sınırların aşılması, limit sıfırlanana kadar daha fazla isteği engeller ve hizmet kesintilerine yol açar.
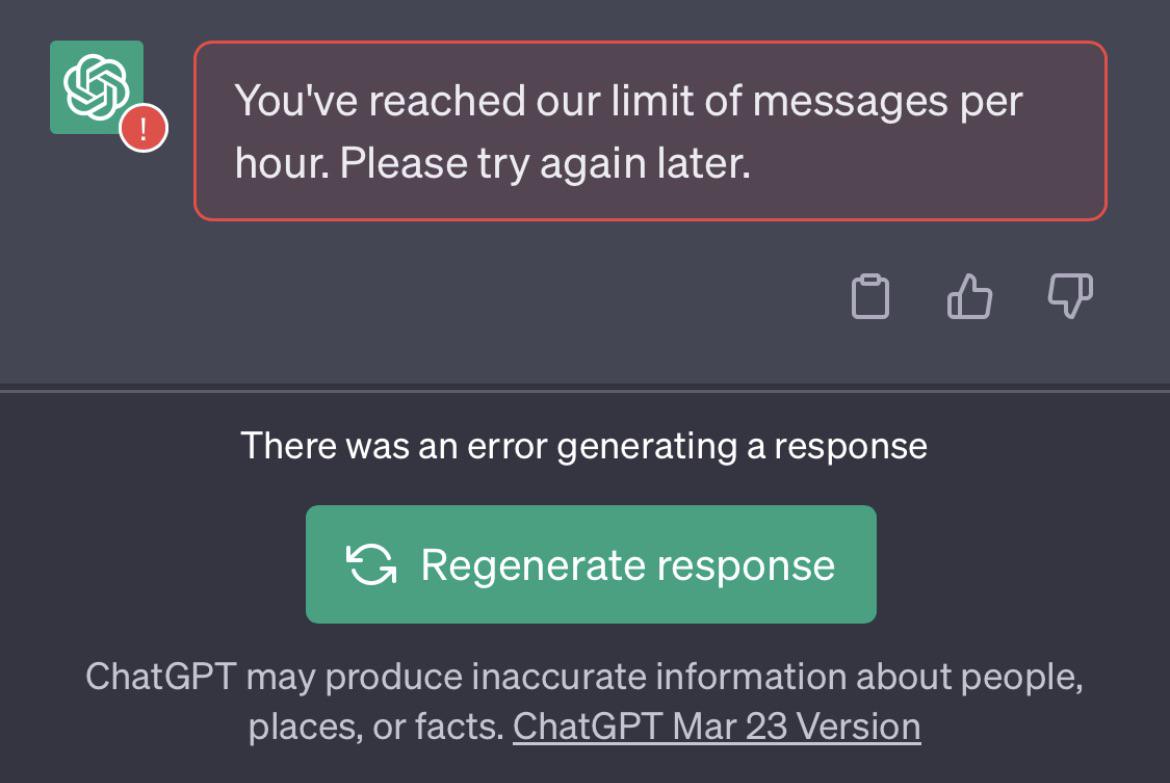
ChatGPT, yanıt üretme sınırına ulaşabilir
Bu sorunlardan kaçınmak için GPTchache benzer sorulara verilen önceki yanıtları önbelleğe alır. Bir şey sorduğunuzda, hafızasını hızla kontrol eder ve bilgiyi anında iletir. Sonuç olarak, yanıtınızı normalden daha kısa sürede alırsınız.
Kısacası, önbelleğe alınmış yanıtlardan yararlanarak GPTCache, LLM tabanlı uygulamaların modern bir araçtan bekleneceği gibi duyarlı ve verimli olmasını sağlar.
GPTCache’i Kurma
GPTCache’i doğrudan şu şekilde kurabilirsiniz:
Kurulum ve yapılandırma
GPTCache paketini şu kodla yükleyin.
! pip install -q gptcacheArdından GPTCache’i uygulamanıza aktarın.
from gptcache import GPTCache
cache = GPTCache()
# keep the mode default
Hepsi bu, işlem tamam!
LLM’lerle entegrasyon
GPTCache’i LLM’lerle LLM Adaptörü aracılığıyla entegre edebilirsiniz. Şu an için yalnızca iki büyük dil modeli adaptörüyle uyumludur:
- OpenAI
- Langchain
Her iki adaptörle de şu şekilde entegre edebilirsiniz:
OpenAI ChatGPT API ile GPTCache
GPTCache’i OpenAI ile entegre etmek için önbelleği başlatın ve gptcache.adapter içinden openai öğesini içe aktarın.
from gptcache import cache
from gptcache.adapter import openai

cache.init()
cache.set_openai_key()
Örnek kodu çalıştırmadan önce, echo $OPENAI_API_KEY komutunu yürüterek OPENAI_API_KEY ortam değişkenini ayarlayın.
Henüz ayarlı değilse, Unix/Linux/MacOS sistemlerinde export OPENAI_API_KEY=YOUR_API_KEY veya Windows sistemlerinde set OPENAI_API_KEY=YOUR_API_KEY komutuyla ayarlayabilirsiniz.
Sonrasında, ChatGPT’ye birebir aynı iki soruyu sorarsanız, ikinci sorunun yanıtı ChatGPT’ye tekrar sormak yerine önbellekten alınır.
Benzer arama önbelleği için örnek bir kod:
import time


def response_text(openai_resp):
    return openai_resp['choices'][0]['message']['content']

print("Cache loading.....")

# To use GPTCache, that's all you need
# -------------------------------------------------
from gptcache import cache
from gptcache.adapter import openai

cache.init()
cache.set_openai_key()
# -------------------------------------------------

question = "what's github"
for _ in range(2):
    start_time = time.time()
    response = openai.ChatCompletion.create(
      model='gpt-3.5-turbo',
      messages=[
        {
            'role': 'user',
            'content': question
        }
      ],
    )
    print(f'Question: {question}')
    print("Time consuming: {:.2f}s".format(time.time() - start_time))
    print(f'Answer: {response_text(response)}\n')
Çıktıda göreceğiniz şudur:
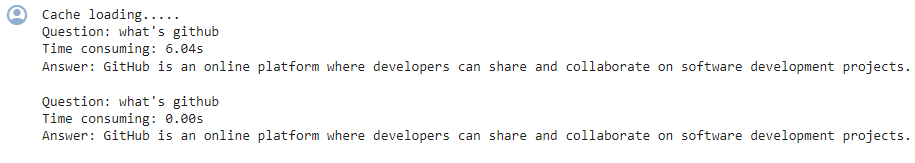
İkinci seferde, GPT aynı soruya yanıt vermek için neredeyse 0 saniye harcadı
LangChain ile GPTCache
Farklı bir LLM kullanmak isterseniz, LangChain adaptörünü deneyin. GPTCahe’i LangChain ile şu şekilde entegre edebilirsiniz:
from langchain.globals import set_llm_cache
from langchain_openai import OpenAI

# To make the caching really obvious, lets use a slower model.
llm = OpenAI(model_name="gpt-3.5-turbo-instruct", n=2, best_of=2)
Langchain ile LLM uygulamalarını nasıl kuracağınızı öğrenin.
Projelerinizde GPTCache Kullanımı
GPTCache’in projelerinizi nasıl destekleyebileceğine bakalım.
Temel işlemler
LLM sorgularının doğasında bulunan karmaşıklık ve değişkenlik nedeniyle LLM’ler etkisiz hale gelebilir; bu da düşük önbellek isabet oranına yol açar.
Bu sınırlamanın üstesinden gelmek için GPTCache anlamsal önbellekleme stratejileri benimser. Anlamsal önbellekleme, benzer veya ilişkili sorguları depolayarak önbellek isabet olasılığını artırır ve genel önbellekleme verimliliğini yükseltir.
GPTCache, sorguları gömme olarak adlandırılan sayısal temsillere dönüştürmek için yerleştirme algoritmalarından yararlanır. Bu gömmeler bir vektör deposunda saklanır ve verimli benzerlik aramalarını mümkün kılar. Bu süreç, GPTCache’in önbellek depolamasından benzer veya ilişkili sorguları belirlemesini ve geri getirmesini sağlar.
Modüler tasarımı sayesinde, anlamsal önbellek uygulamalarını gereksinimlerinize göre özelleştirebilirsiniz.
Bununla birlikte — bazen anlamsal bir önbellekte yanlış isabetler ve kaçırmalar meydana gelebilir. Bu performansı izlemek için GPTCache üç performans metriği sunar:
- İsabet oranı, bir önbelleğin istekleri karşılama başarısını ölçer. Daha yüksek değerler daha iyi performansı gösterir.
- Gecikme, verinin önbellekten alınması için geçen süreyi belirtir; ne kadar düşükse o kadar iyidir.
- Geri çağırma (recall), doğru sunulan önbellek sorgularının oranını gösterir. Daha yüksek yüzdeler daha iyi doğruluğu yansıtır.
Gelişmiş özellikler
İlk sorgular, istemler, yanıtlar ve erişim zaman damgaları gibi tüm temel veri öğeleri bir ‘veri yöneticisi’nde saklanır. GPTCache şu anda aşağıdaki önbellek depolama seçeneklerini destekler:
- SQLite
- MySQL
- PostgreSQL veritabanları.
Henüz ‘NoSQL’ veritabanını desteklemiyor, ancak yakında eklenmesi planlanıyor.
Kayıt çıkarma (eviction) ilkelerini kullanma
Bununla birlikte, GPTCache belirli bir sınıra veya sayıya göre önbellek depolamasından verileri kaldırabilir. Önbellek boyutunu yönetmek için En Son Kullanılmayan (LRU) kayıt çıkarma ilkesini veya İlk Giren İlk Çıkar (FIFO) yaklaşımını uygulayabilirsiniz.
- LRU kayıt çıkarma ilkesi, en son erişilen öğeleri en sona bırakıp en uzun süredir erişilmeyenleri çıkarır.
- Buna karşılık, FIFO kayıt çıkarma ilkesi en uzun süredir önbellekte bulunan öğeleri siler.
Yanıt performansını değerlendirme
GPTCache, önbelleğe alınmış bir yanıtın bir kullanıcı sorgusunu karşılayıp karşılamadığını değerlendirmek için bir ‘değerlendirme’ işlevi kullanır. Bunu yapmak için üç girdi alır:
- kullanıcının veri talebi
- değerlendirilen önbelleğe alınmış veri
- kullanıcı tanımlı parametreler (varsa)
İki başka işlevi de kullanabilirsiniz:
- ‘log_time_func’, ‘gömme’ oluşturma veya önbellek ‘arama’ gibi yoğun görevlerin süresini kaydetmenize ve raporlamanıza olanak tanır. Bu, performans özelliklerini izlemenize yardımcı olur.
- ‘similarity_threshold’ ile iki gömme vektörünün (metin verilerinin yüksek boyutlu temsilleri) eşleşecek kadar benzer kabul edilmesi için eşik değeri tanımlayabilirsiniz.
GPTCache En İyi Uygulamalar ve Sorun Giderme
Artık GPTCache’in nasıl çalıştığını bildiğinize göre, avantajlarından yararlanmanızı sağlayacak bazı en iyi uygulamalar ve ipuçları aşağıdadır.
GPTCache performansını optimize etme
GPTCache’in performansını optimize etmek için aşağıda özetlenen çeşitli adımları atabilirsiniz.
1. İstemlerinizi netleştirin
LLM’i nasıl yönlendirdiğiniz, GPTCache’in ne kadar iyi çalıştığını etkiler. Bu nedenle, önbelleğe ulaşma şansınızı artırmak için ifadelerinizi tutarlı tutun.
Örneğin, "Hesabıma giriş yapamıyorum." gibi tutarlı ifadeler kullanın. Bu şekilde GPTCache, "Şifremi unuttum" veya "Hesap girişi sorunları" gibi benzer meseleleri daha verimli biçimde tanır.
2. Yerleşik izleme metriklerini kullanın
Önbelleğinizin performansını analiz etmek için isabet oranı, geri çağırma ve gecikme gibi yerleşik metrikleri izleyin. Daha yüksek bir isabet oranı, önbelleğin istenen içeriği depolanan verilerden daha etkili biçimde sunduğunu gösterir ve etkinliğini anlamanıza yardımcı olur.
3. Geniş kullanıcı tabanına sahip LLM uygulamaları için GPTCache’i ölçeklendirme
Daha büyük LLM uygulamaları için GPTCache’i ölçeklendirmek üzere, benzer profillere sahip kullanıcı gruplarının aynı önbelleği kullandığı paylaşımlı bir önbellek yaklaşımı uygulayın. Kullanıcı profilleri oluşturun ve benzer kullanıcı gruplarını belirlemek için sınıflandırın.
Aynı profil grubundaki kullanıcılar için paylaşımlı önbellekten yararlanmak, önbellek verimliliği ve ölçeklenebilirlik açısından iyi sonuç verir.
Bunun nedeni, aynı profil grubundaki kullanıcıların, önbelleğe alınmış yanıtlardan fayda sağlayabilecek ilişkili sorgulara sahip olma eğilimidir. Ancak, kullanıcıları doğru şekilde gruplamak ve paylaşımlı önbelleklemenin faydalarını en üst düzeye çıkarmak için doğru kullanıcı profilleme ve sınıflandırma tekniklerini kullanmanız gerekir.
Yaygın GPTCache sorunlarının giderilmesi
GPTCache ile zorlanıyorsanız, sorunları gidermek için birkaç adım atabilirsiniz.
1. Önbellek geçersiz kılma
GPTCache, güncel önbellek yanıtlarına dayanır. Altta yatan LLM’in yanıtları veya kullanıcının niyeti zaman içinde değişirse, önbelleğe alınmış yanıtlar yanlış veya ilgisiz hale gelebilir.
Bunu önlemek için, LLM’in beklenen güncelleme sıklığına göre önbelleğe alınmış girdiler için sona erme süreleri belirleyin ve önbelleği düzenli olarak yenileyin.
2. Önbelleğe aşırı güvenme
GPTCache verimliliği artırabilse de, önbelleğe aşırı güvenmek, önbellek düzgün biçimde geçersiz kılınmazsa yanlış bilgilere yol açabilir.
Bu amaçla, uygulamanızın benzer sorgular için bile ara sıra LLM’den taze yanıtlar almasını sağlayın. Bu, özellikle kritik veya zamana duyarlı bilgilerle çalışırken yanıtların doğruluğunu ve kalitesini korur.
3. Önbellek kalitesini göz ardı etme
Önbelleğe alınmış yanıtın kalitesi ve uygunluğu, kullanıcı deneyimini etkiler. Bu nedenle, kullanıcılara sunmadan önce önbelleğe alınmış yanıtların kalitesini değerlendirmek için ölçütler kullanmalısınız.
Bu olası tuzakları ve çözümlerini anlayarak, GPTCache’in LLM destekli uygulamalarınızın performansını ve maliyet etkinliğini, doğruluk veya kullanıcı deneyiminden ödün vermeden etkili bir şekilde iyileştirmesini sağlayabilirsiniz.
Kapanış
GPTCache, LLM uygulamalarının performansını ve maliyet etkinliğini optimize etmek için güçlü bir araçtır. Doğru yapılandırma, izleme ve önbellek değerlendirme stratejileri, doğru ve ilgili yanıtlar almanızı sağlamak için gereklidir.
LLM’lere yeniyseniz, şu kaynaklar yardımcı olabilir:




