GPTCache is een open-source framework voor toepassingen met grote taalmodellen (LLM’s) zoals ChatGPT. Het slaat eerder gegenereerde LLM-antwoorden op bij soortgelijke vragen. In plaats van op het LLM te vertrouwen, checkt de applicatie de cache op een relevant antwoord om je tijd te besparen.
In deze gids lees je hoe GPTCache werkt en hoe je het effectief inzet in je projecten.
Wat is GPTCache?
GPTCache is een cachesysteem dat is ontworpen om de prestaties en efficiëntie van grote taalmodellen (LLM’s) zoals GPT-3 te verbeteren. Het helpt LLM’s om eerder gegenereerde vragen op te slaan om tijd en moeite te besparen.
Wanneer er opnieuw een soortgelijke vraag binnenkomt, kan het LLM het gecachte antwoord ophalen in plaats van helemaal opnieuw een nieuw antwoord te formuleren.
In tegenstelling tot andere tools werkt GPTCache met semantische caching. Semantische caches houden het doel van een vraag/verzoek vast. Daardoor wordt bij het terugroepen van eerder opgeslagen vragen de serverbelasting verlaagd en de cache-hitratio verbeterd.
Voordelen van GPTCache gebruiken
Het kernidee achter GPTCache is het opslaan en hergebruiken van de tussenresultaten die tijdens het inferentieproces van een LLM worden gegenereerd. Dat heeft meerdere voordelen:
Kostenbesparing op LLM-API-calls
De meeste LLM’s rekenen per verzoek een specifieke vergoeding op basis van het aantal verwerkte tokens. Dan komt GPTCache goed van pas. Het minimaliseert het aantal LLM-API-calls door eerder gegenereerde antwoorden te serveren voor soortgelijke vragen. Zo bespaar je kosten door onnodige LLM-calls te verminderen.
Verbeterde responstijd en efficiëntie
Een antwoord uit een cache ophalen is aanzienlijk sneller dan het vanaf nul genereren door het LLM te bevragen. Dat verhoogt de snelheid en verbetert de responstijden. Efficiënte antwoorden verlagen de belasting van het LLM zelf en maken capaciteit vrij voor andere taken.
Betere gebruikerservaring dankzij snellere app-prestaties
Stel dat je vragen voor je content zoekt. Elke vraag die je stelt, kost het AI-systeem erg veel tijd om te beantwoorden. Hoe komt dat? Omdat de meeste LLM-diensten verzoeklimieten hanteren binnen vaste perioden. Als je daar overheen gaat, worden verdere verzoeken geblokkeerd tot de limiet is gereset, wat leidt tot onderbrekingen.
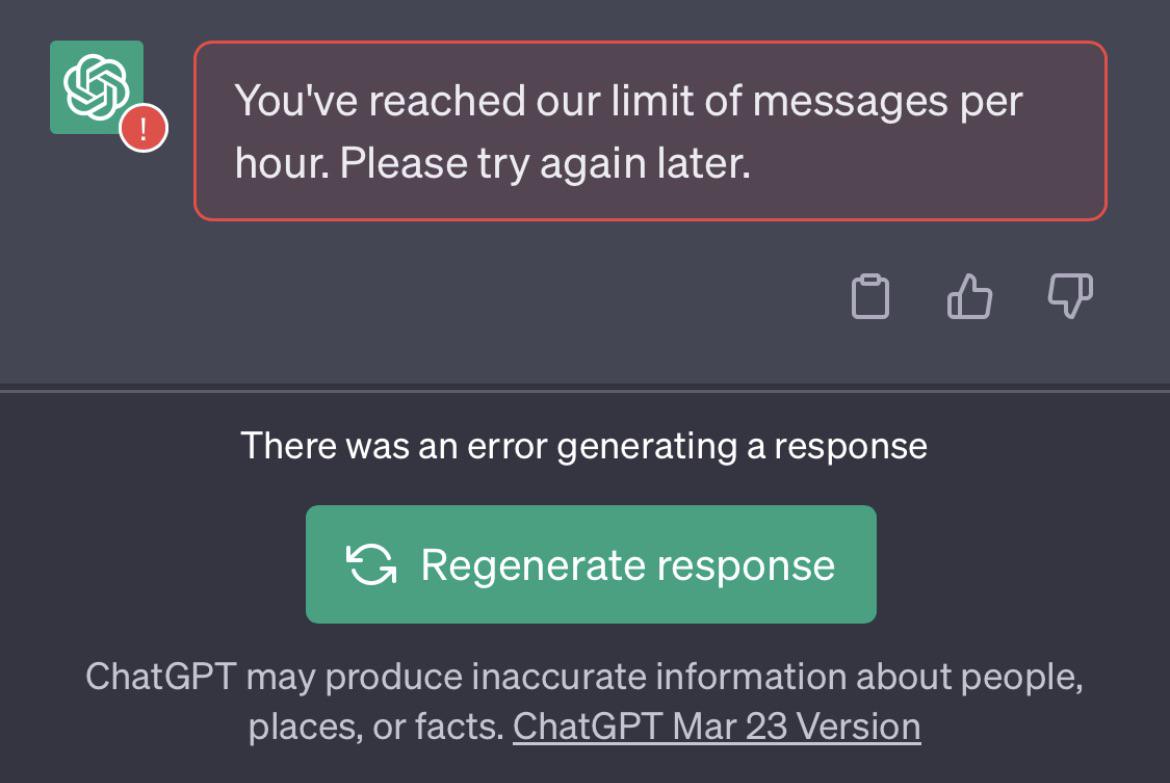
ChatGPT kan de limiet voor het genereren van antwoorden bereiken
Om dit te voorkomen, cachet GPTchache eerdere antwoorden op vergelijkbare vragen. Wanneer je iets vraagt, checkt het razendsnel zijn geheugen en levert de informatie in een oogwenk. Zo krijg je je antwoord sneller dan normaal.
Kortom: door gecachte antwoorden te benutten, zorgt GPTCache ervoor dat LLM-gebaseerde applicaties responsief en efficiënt worden—precies wat je van een moderne tool verwacht.
GPTCache instellen
Zo installeer je GPTCache direct:
Installatie en configuratie
Installeer het GPTCache-pakket met deze code.
! pip install -q gptcacheImporteer daarna GPTCache in je applicatie.
from gptcache import GPTCache
cache = GPTCache()
# keep the mode default
Dat is alles: je bent klaar!
Integratie met LLM’s
Je kunt GPTCache integreren met LLM’s via de LLM-adapter. Op dit moment is het alleen compatibel met twee adapters voor grote taalmodellen:
- OpenAI
- Langchain
Zo integreer je het met beide adapters:
GPTCache met de OpenAI ChatGPT API
Om GPTCache met OpenAI te integreren, initialiseer je de cache en importeer je openai uit gptcache.adapter.
from gptcache import cache
from gptcache.adapter import openai

cache.init()
cache.set_openai_key()
Voordat je de voorbeeldcode draait, stel je de omgevingsvariabele OPENAI_API_KEY in door echo $OPENAI_API_KEY uit te voeren.
Als die nog niet is ingesteld, kun je dat doen met export OPENAI_API_KEY=YOUR_API_KEY op Unix/Linux/MacOS-systemen of set OPENAI_API_KEY=YOUR_API_KEY op Windows-systemen.
Als je daarna ChatGPT twee keer exact dezelfde vraag stelt, haalt het bij de tweede keer het antwoord uit de cache in plaats van ChatGPT opnieuw te bevragen.
Hier is een voorbeeldcode voor een vergelijkingscache:
import time


def response_text(openai_resp):
    return openai_resp['choices'][0]['message']['content']

print("Cache loading.....")

# To use GPTCache, that's all you need
# -------------------------------------------------
from gptcache import cache
from gptcache.adapter import openai

cache.init()
cache.set_openai_key()
# -------------------------------------------------

question = "what's github"
for _ in range(2):
    start_time = time.time()
    response = openai.ChatCompletion.create(
      model='gpt-3.5-turbo',
      messages=[
        {
            'role': 'user',
            'content': question
        }
      ],
    )
    print(f'Question: {question}')
    print("Time consuming: {:.2f}s".format(time.time() - start_time))
    print(f'Answer: {response_text(response)}\n')
Dit is wat je in de output ziet:
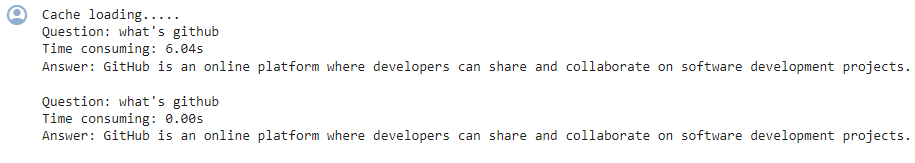
De tweede keer deed GPT er bijna 0 seconden over om dezelfde vraag te beantwoorden
GPTCache met LangChain
Wil je een ander LLM gebruiken, probeer dan de LangChain-adapter. Zo integreer je GPTCahe met LangChain:
from langchain.globals import set_llm_cache
from langchain_openai import OpenAI

# To make the caching really obvious, lets use a slower model.
llm = OpenAI(model_name="gpt-3.5-turbo-instruct", n=2, best_of=2)
Leer hoe je LLM-applicaties bouwt met Langchain.
GPTCache gebruiken in je projecten
Laten we bekijken hoe GPTCache je projecten kan ondersteunen.
Basisbewerkingen
LLM’s kunnen ineffectief worden door de inherente complexiteit en variabiliteit van LLM-vragen, wat resulteert in een lage cache-hitratio.
Om deze beperking te overwinnen, past GPTCache semantische cachingstrategieën toe. Semantische caching slaat soortgelijke of gerelateerde vragen op—waardoor de kans op cache-hits toeneemt en de algehele cache-efficiëntie verbetert.
GPTCache maakt gebruik van embedding-algoritmen om vragen om te zetten in numerieke representaties, zogeheten embeddings. Deze embeddings worden opgeslagen in een vectorstore, wat efficiënte gelijkeniszoekacties mogelijk maakt. Zo kan GPTCache soortgelijke of gerelateerde vragen identificeren en ophalen uit de cachestorage.
Dankzij het modulaire ontwerp kun je semantische cache-implementaties aanpassen aan je eigen eisen.
Toch kunnen er in een semantische cache soms foutieve cache-hits en cache-misses optreden. Om die prestaties te monitoren, biedt GPTCache drie prestatiestatistieken:
- Hitratio meet het succespercentage van een cache in het afhandelen van verzoeken. Hogere waarden duiden op betere prestaties.
- Latentie geeft de tijd aan die nodig is om data uit de cache op te halen; lager is beter.
- Recall toont het aandeel correct bediende cache-vragen. Hogere percentages weerspiegelen betere nauwkeurigheid.
Geavanceerde functies
Alle basiselementen zoals de oorspronkelijke vragen, prompts, antwoorden en toegangstijdstempels worden opgeslagen in een ‘datamanager’. GPTCache ondersteunt momenteel de volgende cache-opslagopties:
- SQLite
- MySQL
- PostgreSQL-databases.
‘NoSQL’-databases worden nog niet ondersteund, maar staan gepland om binnenkort te worden toegevoegd.
Gebruik van eviction policies
GPTCache kan echter data uit de cachestorage verwijderen op basis van een opgegeven limiet of aantal. Om de cachegrootte te beheren, kun je ofwel een Least Recently Used (LRU)-eviction policy of een First In, First Out (FIFO)-benadering toepassen.
- LRU-eviction policy verwijdert items die het langst niet zijn benaderd.
- De FIFO-eviction policy verwijdert juist de gecachte items die het langst aanwezig zijn.
Antwoordprestaties evalueren
GPTCache gebruikt een ‘evaluatie’-functie om te beoordelen of een gecacht antwoord een gebruikersvraag dekt. Daarvoor neemt het drie inputs:
- het verzoek van de gebruiker
- de gecachte data die wordt geëvalueerd
- gebruikersgedefinieerde parameters (indien aanwezig)
Je kunt ook twee andere functies gebruiken:
- log_time_func laat je de duur registreren en rapporteren van intensieve taken zoals het genereren van embeddings of het uitvoeren van cache-searches. Dit helpt bij het monitoren van prestatiekenmerken.
- Met similarity_threshold kun je de drempel definiëren voor wanneer twee embeddingvectoren (hoogdimensionale representaties van tekstdata) voldoende op elkaar lijken om te worden gematcht.
Best practices en troubleshooting voor GPTCache
Nu je weet hoe GPTCache werkt, volgen hier enkele best practices en tips om er maximaal van te profiteren.
GPTCache-prestaties optimaliseren
Je kunt verschillende stappen nemen om de prestaties van GPTCache te optimaliseren, zoals hieronder beschreven.
1. Verduidelijk je prompts
Hoe je je LLM aanstuurt, beïnvloedt hoe goed GPTCache werkt. Houd je bewoordingen dus consistent om je kans op een cache-hit te vergroten.
Gebruik bijvoorbeeld consequente formuleringen zoals "Ik kan niet inloggen op mijn account." Zo herkent GPTCache soortgelijke issues, zoals "Wachtwoord vergeten" of "Problemen met inloggen op account", efficiënter.
2. Gebruik de ingebouwde trackingstatistieken
Monitor ingebouwde statistieken zoals hitratio, recall en latentie om de prestaties van je cache te analyseren. Een hogere hitratio geeft aan dat de cache aangevraagde content effectiever vanuit de opgeslagen data bedient, wat je helpt de effectiviteit te begrijpen.
3. GPTCache opschalen voor LLM-applicaties met grote gebruikersbases
Om GPTCache op te schalen voor grotere LLM-toepassingen, implementeer je een gedeelde cache-aanpak die dezelfde cache gebruikt voor gebruikersgroepen met vergelijkbare profielen. Maak gebruikersprofielen en classificeer ze om vergelijkbare groepen te identificeren.
Een gedeelde cache benutten voor gebruikers binnen hetzelfde profiel levert goede resultaten op qua cache-efficiëntie en schaalbaarheid.
Dat komt omdat gebruikers binnen dezelfde profielgroep vaak gerelateerde vragen hebben die baat hebben bij gecachte antwoorden. Je moet echter wel de juiste technieken voor gebruikersprofilering en -classificatie toepassen om gebruikers nauwkeurig te groeperen en de voordelen van gedeelde caching te maximaliseren.
Veelvoorkomende GPTCache-problemen oplossen
Loop je vast met GPTCache, dan kun je verschillende stappen nemen om problemen te verhelpen.
1. Cache-invalidatie
GPTCache is afhankelijk van actuele cache-antwoorden. Als de antwoorden van het onderliggende LLM of de intentie van de gebruiker in de loop van de tijd verandert, kunnen gecachte antwoorden onnauwkeurig of irrelevant worden.
Stel daarom vervaltijden in voor gecachte items op basis van de verwachte updatefrequentie van het LLM en ververs de cache regelmatig.
2. Te veel leunen op gecachte antwoorden
Hoewel GPTCache de efficiëntie kan verbeteren, kan overmatig vertrouwen op gecachte antwoorden leiden tot onnauwkeurige informatie als de cache niet goed wordt geïnvalideerd.
Zorg er daarom voor dat je applicatie af en toe verse antwoorden ophaalt bij het LLM, zelfs voor soortgelijke vragen. Dit behoudt de nauwkeurigheid en kwaliteit van antwoorden bij kritieke of tijdgevoelige informatie.
3. Cachekwaliteit negeren
De kwaliteit en relevantie van het gecachte antwoord beïnvloedt de gebruikerservaring. Gebruik daarom evaluatiestatistieken om de kwaliteit van gecachte antwoorden te beoordelen voordat je ze aan gebruikers serveert.
Door deze mogelijke valkuilen en hun oplossingen te begrijpen, kun je ervoor zorgen dat GPTCache de prestaties en kostenefficiëntie van je LLM-gestuurde applicaties effectief verbetert—zonder in te leveren op nauwkeurigheid of gebruikerservaring.
Afronding
GPTCache is een krachtige tool om de prestaties en kostenefficiëntie van LLM-applicaties te optimaliseren. Een juiste configuratie, monitoring en strategieën voor cache-evaluatie zijn nodig om nauwkeurige en relevante antwoorden te garanderen.
Ben je nieuw met LLM’s? Deze bronnen helpen je op weg:


