
Last chance! 50% off DataCamp Premium
Sale ends in
Data adalah fondasi organisasi modern, tetapi besarnya volume informasi yang dikumpulkan dan disimpan bisa menjadi tantangan untuk dikelola. Kunci keberhasilan terletak pada mengatur dan menganalisis data secara efektif untuk menemukan wawasan berharga yang mendorong pengambilan keputusan yang tepat.
Di sinilah data warehousing berperan. Ini adalah solusi andal yang memungkinkan bisnis mengonsolidasikan dan mengoptimalkan data mereka untuk analisis yang efisien. Dan ketika berbicara tentang data warehousing, AWS Redshift menonjol sebagai pilihan utama.
Dalam artikel ini, kami akan membahas seluk-beluk AWS Redshift, beserta fitur utama, manfaat, dan praktik terbaik untuk penyiapan, pemuatan data, kueri, penyetelan kinerja, keamanan, dan integrasi.
Baik Anda seorang profesional data maupun pemimpin bisnis yang ingin memaksimalkan data Anda, artikel ini akan memberikan pengetahuan dan alat yang Anda butuhkan untuk sukses dengan AWS Redshift.
Data warehousing adalah proses mengumpulkan, menyimpan, dan mengelola sejumlah besar data terstruktur dari berbagai sumber dalam suatu organisasi.
Tujuan utama data warehouse adalah menyediakan repositori informasi terpusat yang mudah diakses, dianalisis, dan digunakan untuk pelaporan serta pengambilan keputusan.
Data warehouse dirancang untuk mendukung kueri kompleks dan analisis data, memungkinkan bisnis memperoleh wawasan berharga dari data mereka.
Mengadopsi data warehouse dapat memberikan banyak manfaat bagi organisasi:
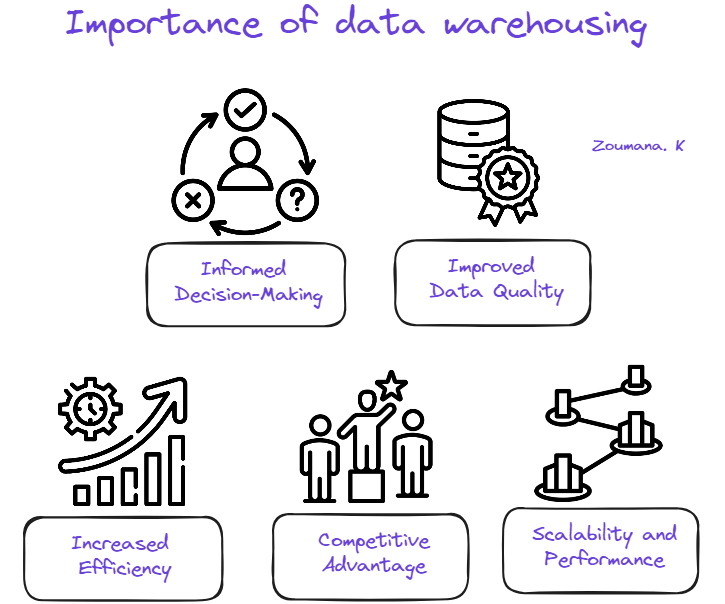
Pentingnya Data Warehousing
AWS Redshift adalah layanan data warehousing berbasis cloud yang dikelola sepenuhnya dan memungkinkan penyimpanan serta analisis kumpulan data berskala petabyte. Dengan AWS Redshift Serverless, pengguna dapat mengakses dan menganalisis data tanpa perlu konfigurasi manual data warehouse terprovisi.
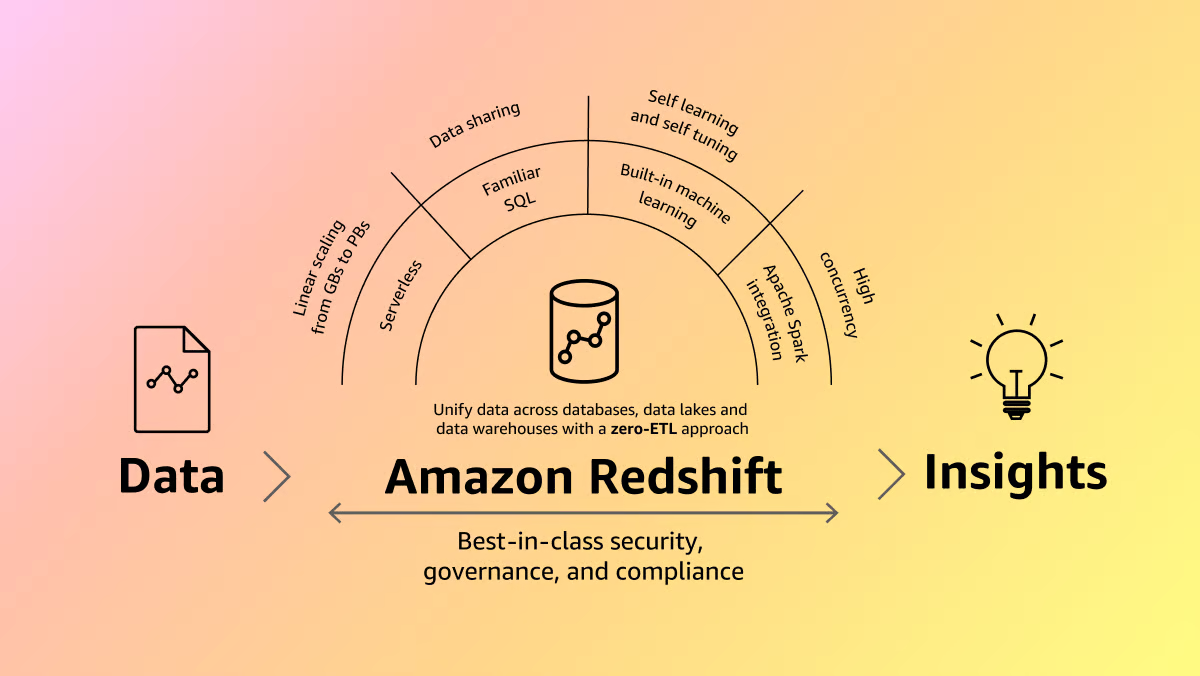
Amazon Redshift (Sumber)
Layanan ini secara otomatis menyediakan sumber daya dan melakukan penskalaan kapasitas data warehouse secara cerdas untuk memastikan kinerja cepat, bahkan untuk beban kerja yang paling menuntut dan tidak terduga. Pengguna hanya membayar sumber daya yang digunakan, karena tidak ada biaya saat data warehouse tidak aktif.
AWS Redshift memungkinkan pengguna memuat data dan langsung mulai melakukan kueri menggunakan Amazon Redshift query editor v2 atau alat business intelligence (BI) pilihan mereka. Layanan ini menawarkan rasio harga-kinerja terbaik dan fitur SQL yang familier dalam lingkungan yang mudah digunakan dan tanpa administrasi.
Terlepas dari ukuran dataset, AWS Redshift menghadirkan kinerja kueri yang cepat menggunakan alat berbasis SQL dan aplikasi business intelligence yang umum digunakan saat ini.
AWS Redshift menyediakan berbagai fitur dan manfaat untuk membantu organisasi menyimpan, mengelola, dan menganalisis volume data besar secara efisien. Beberapa fitur dan manfaat utamanya digambarkan di bawah ini:
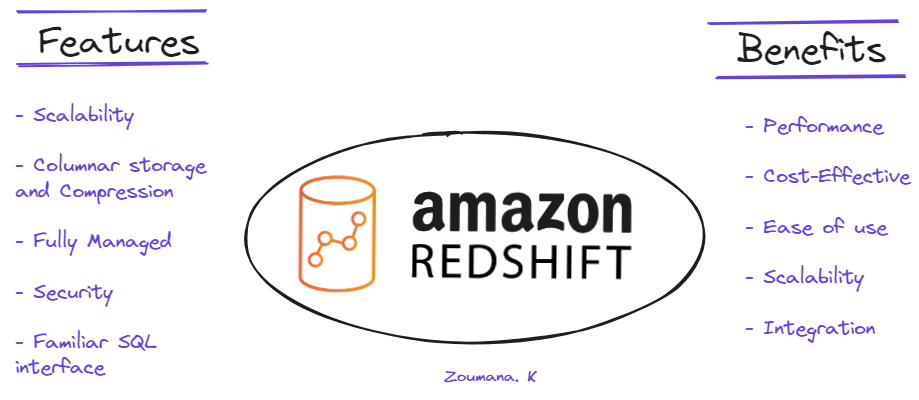
Fitur dan Manfaat AWS Redshift
Bagian sebelumnya berfokus pada pemahaman umum tentang Redshift. Sekarang, kita akan membahas aspek teknisnya.
Bagian ini pertama-tama menjelaskan prasyarat utama untuk berhasil menyiapkan AWS Redshift, kemudian memandu proses langkah demi langkah dalam membuat klaster Redshift. Bagian terakhir lebih menitikberatkan pada penjelasan rinci pengaturan kunci klaster, seperti jenis node, jumlah node, dan konfigurasi keamanan.
Sebelum masuk ke detail kasus penggunaan, mari kita bahas terlebih dahulu prasyarat yang diperlukan untuk implementasi yang berhasil:
Bagian ini menyediakan semua langkah untuk membuat klaster Redshift melalui AWS Management Console dalam 11 langkah sederhana, seperti yang ditunjukkan di bawah ini:
1. Cari Redshift dari konsol, lalu pilih “Amazon Redshift”:
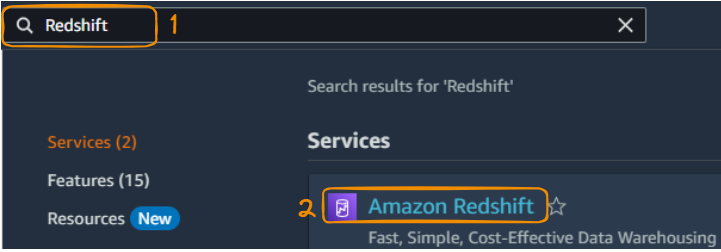
Cari dan pilih Redshift dari Management Console
2. Pilih tombol “Create Cluster” untuk mulai membuat klaster.
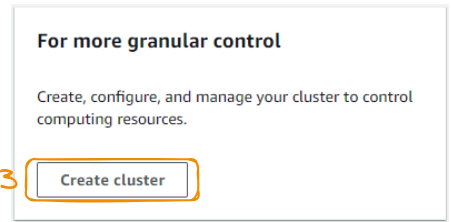
Tombol pembuatan klaster
3. Dari tindakan di atas, kita dapat mengonfigurasi klaster dengan memberikan informasi seperti pengenal klaster, ukuran klaster, jenis node, pilihan availability zone, jumlah node.
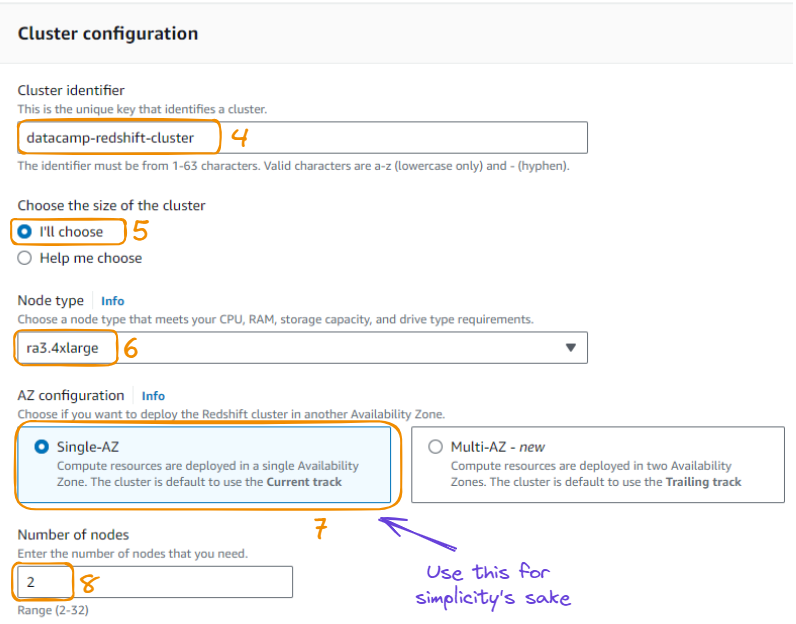
Konfigurasi klaster dalam 8 langkah
4. Alih-alih menggunakan data contoh seperti yang disarankan pada halaman yang sama, kami menggunakan data dari bucket S3 untuk memuat data ke Redshift.
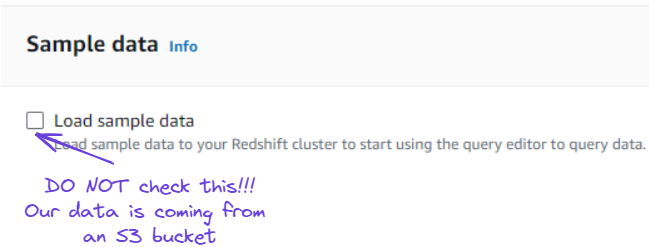
Abaikan opsi memuat data contoh
5. Kami memiliki opsi untuk mendefinisikan izin klaster dengan menyediakan peran IAM. Bagian ini dapat diabaikan dan ditangani nanti.
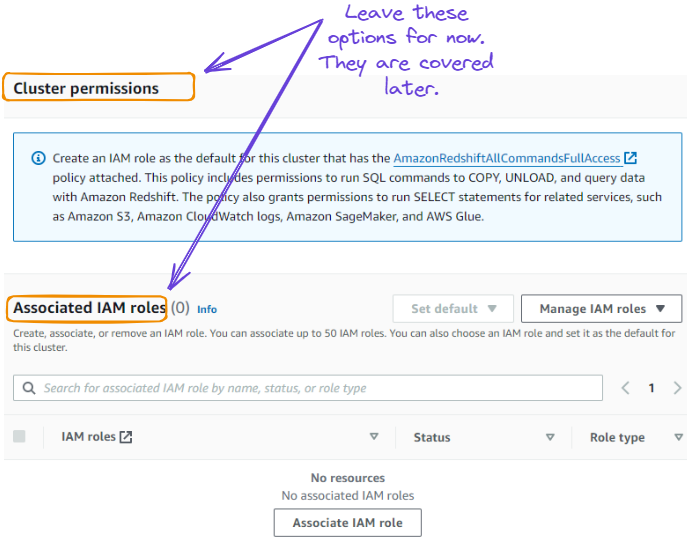
Abaikan izin klaster dan peran IAM
6. Biarkan konfigurasi bawaan untuk jaringan, keamanan, cadangan, pemeliharaan, lalu pilih tombol “Create cluster” untuk membuat klaster.
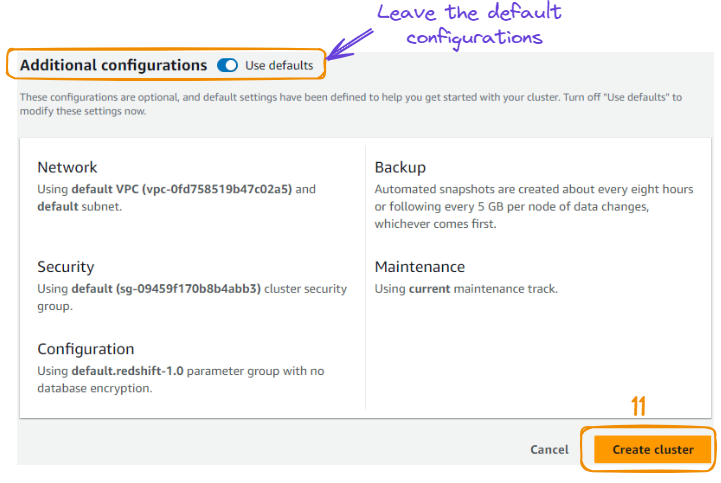
Pembuatan klaster
7. Setelah tindakan di atas, kita diarahkan ke halaman baru yang menampilkan klaster yang baru dibuat. Pembuatan klaster mungkin memerlukan beberapa menit, dan dapat dilihat pada bagian “Status” yang awalnya “Creating” sebelum menjadi “Available”.
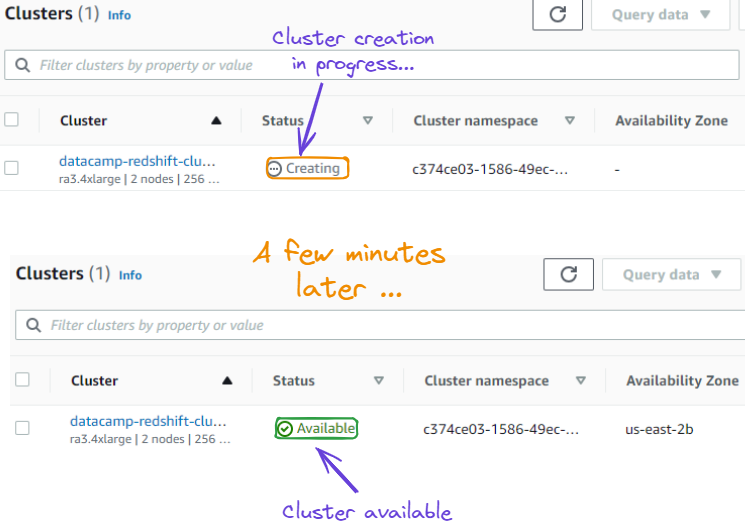
Status klaster dari “Creating” ke “Available”
Kita kini telah berhasil membuat klaster Redshift. Bagian ini memandu Anda melalui semua langkah, mulai dari memilih dataset PDB (Produk Domestik Bruto) Negara, Regional, dan Dunia yang tersedia di DataLab kami hingga mengunggahnya ke bucket S3.
Data kami awalnya bersumber dari dataset World Bank. Ini berisi PDB dari negara, kawasan, dan dunia yang diukur dalam Dolar AS saat ini ($). Kawasan merujuk pada kumpulan negara, seperti Eropa, serta Asia Tengah.
Sepuluh observasi pertama dari data terlihat seperti ini:
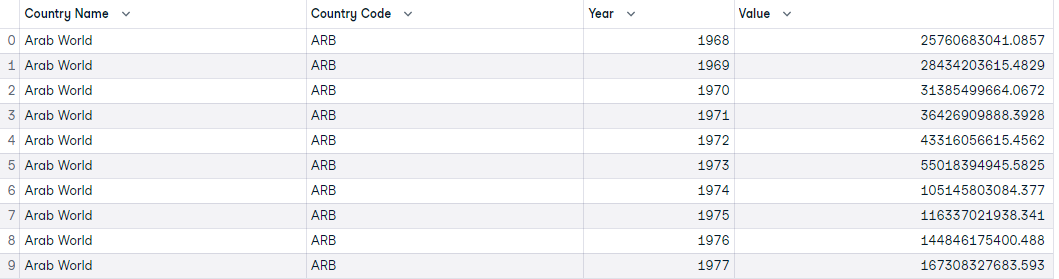
Sepuluh observasi pertama dari data PDB
Agar interaksi antara S3 dan Redshift berhasil, kita perlu terlebih dahulu membuat peran IAM sebelum membuat bucket S3 untuk menyimpan data.
Manfaat membuat peran IAM adalah membangun koneksi antara klaster Redshift kita dan bucket S3 tempat data berada.
Pembuatan peran IAM dilakukan sebagai berikut:
Dari Management Console, cari “IAM” dan pilih logo “IAM” dari hasil pencarian.
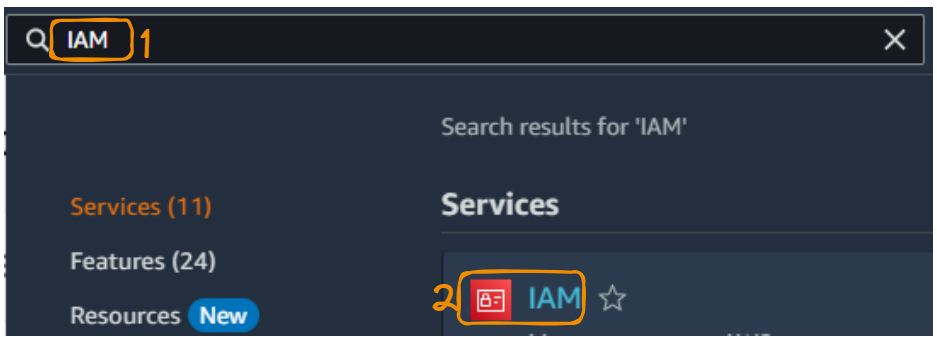
Layanan IAM dari Management Console
Pilih “Roles” untuk menampilkan semua peran yang mungkin, lalu pilih “Create role” untuk membuat peran baru.
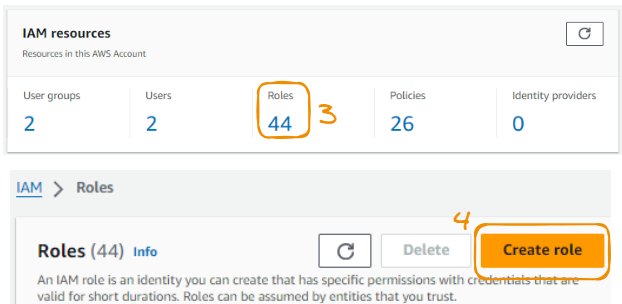
Mulai membuat peran baru
Pilih “AWS service” dari “Trusted entity type,” lalu “Redshift” sebagai “Use case,” dan “Next” untuk melanjutkan.
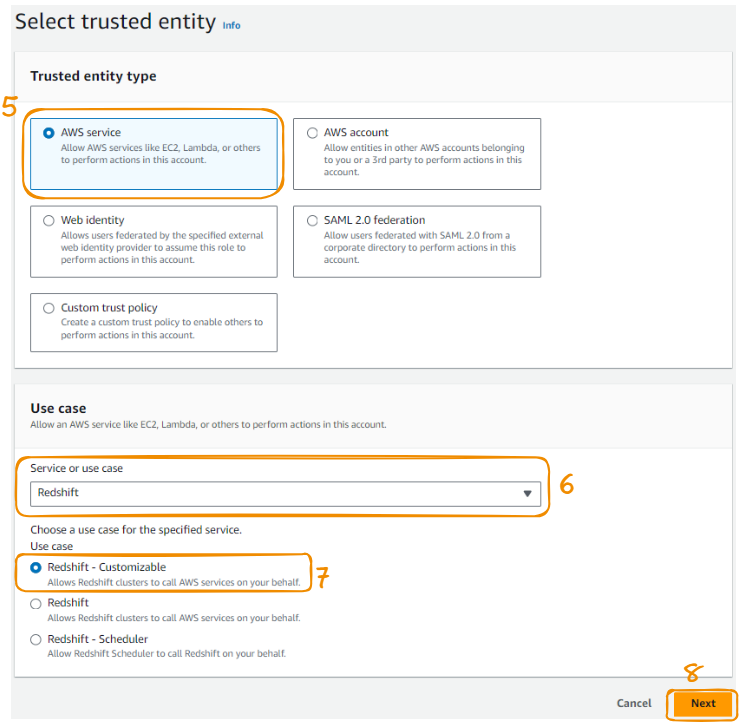
Langkah 5 hingga 8 pembuatan peran AMI
Cari “S3FullAccess” dari tab pencarian, lalu centang opsi tersebut dan pilih “Next.”
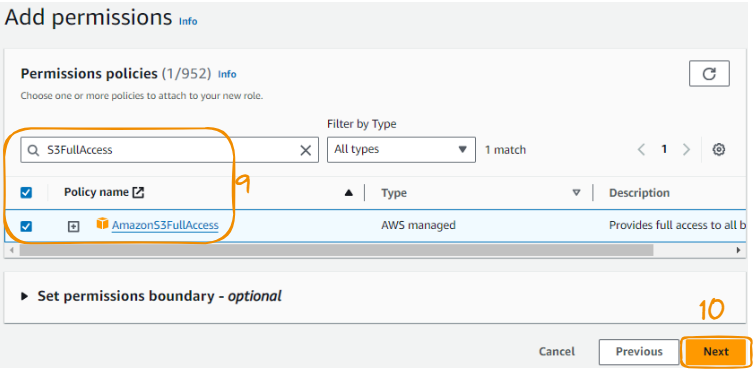
Langkah 9 hingga 10 pembuatan peran AMI
Terakhir, beri nama peran, tinjau, dan pilih tombol “Create role” untuk menyelesaikan pembuatan peran.
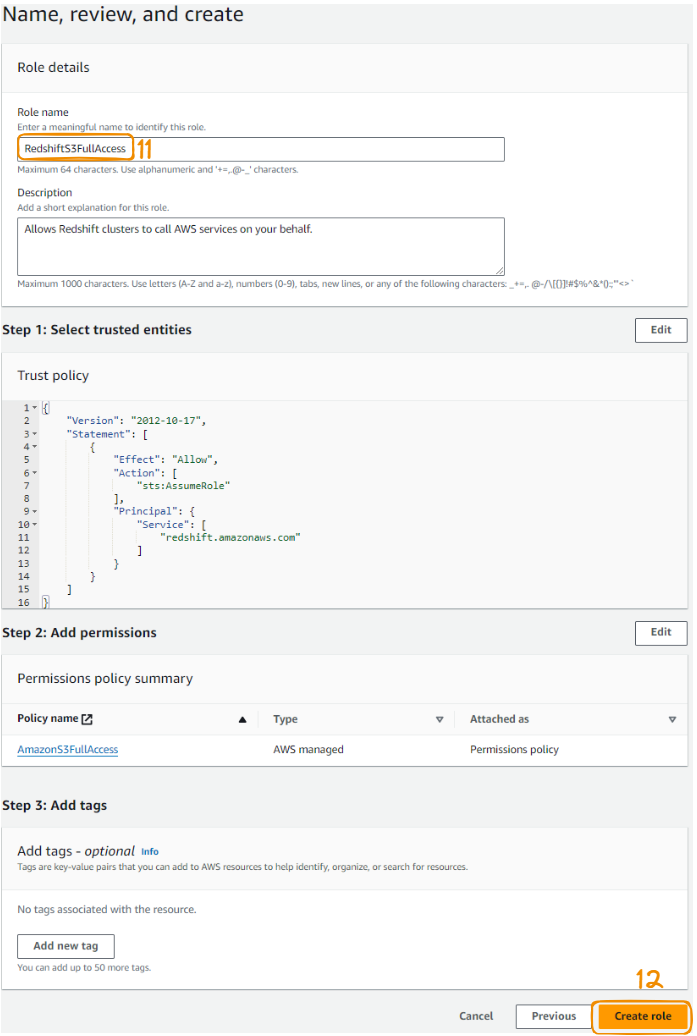
Langkah 11 hingga 12 pembuatan peran AMI
Setelah semuanya berhasil, pesan hijau berikut yang mengonfirmasi pembuatan peran akan ditampilkan di pojok atas.
Pesan konfirmasi pembuatan peran
Sekarang kita memiliki peran IAM, peran tersebut dapat digunakan untuk ditautkan ke klaster Redshift yang awalnya dibuat, dan itu dapat dilakukan sebagai berikut:
Dari bagian klaster, pilih klaster datacamp yang dibuat, dan di bawah bagian “Actions” pilih “Manage IAM roles.”
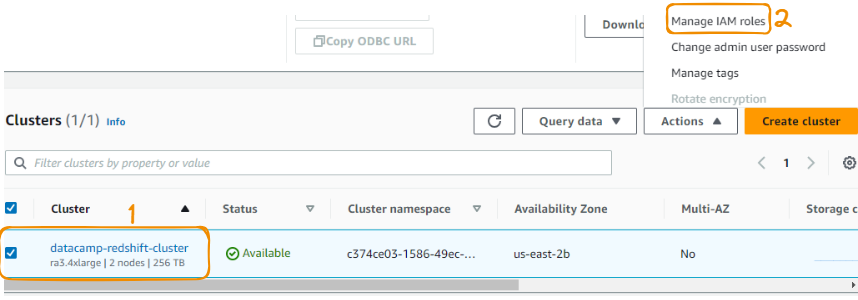
Menautkan peran IAM ke Redshift langkah 1 hingga 2
Di bawah bagian ini, pilih peran IAM yang sebelumnya dibuat dan simpan perubahannya.
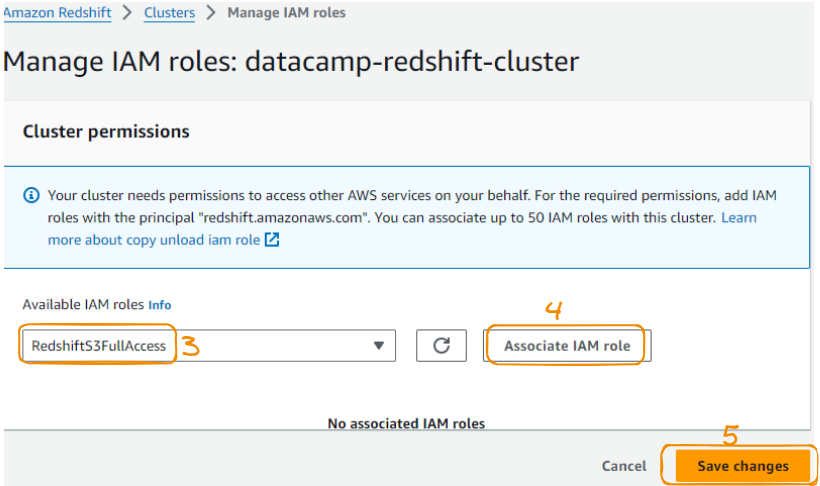
Menautkan peran IAM ke Redshift langkah 3 hingga 4
Banyak alat dapat digunakan untuk mengkueri data dari Redshift. Beberapa di antaranya sudah menjadi bagian dari layanan AWS atau bersifat eksternal. Dalam cakupan tutorial ini kami menggunakan query editor dari Redshift Dashboard.
Agar dapat menggunakannya, kita terlebih dahulu perlu membuat koneksi ke Query editor sebagai berikut, dimulai dari opsi “Query in query editor” pada tab “Query data”:
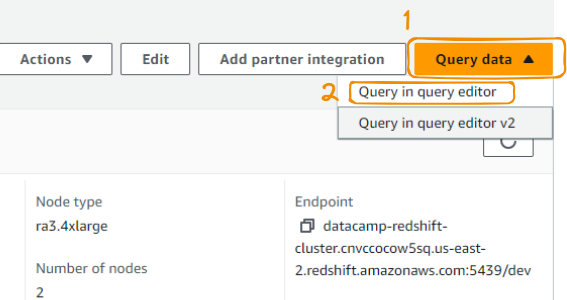
Query editor dari query data
Tindakan di atas mengarahkan ke halaman berikut, tempat kita dapat terhubung ke database setelah memberinya nama, bersama dengan nama pengguna seperti berikut:
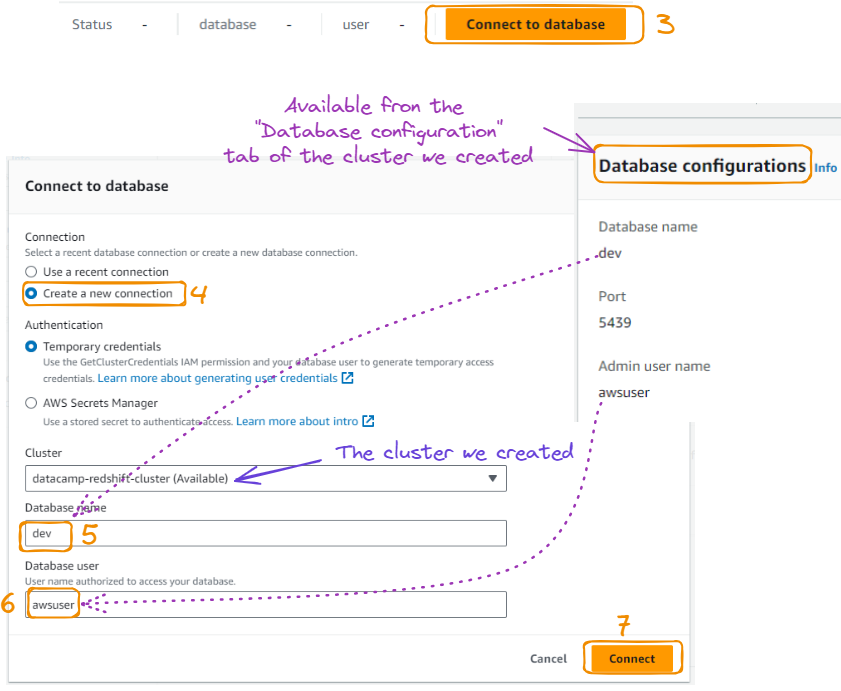
Koneksi database dari query editor
Setelah menekan tombol “Connect”, kita dapat melihat tab hijau “Connected” di bagian atas dan informasi database di sebelah kiri.
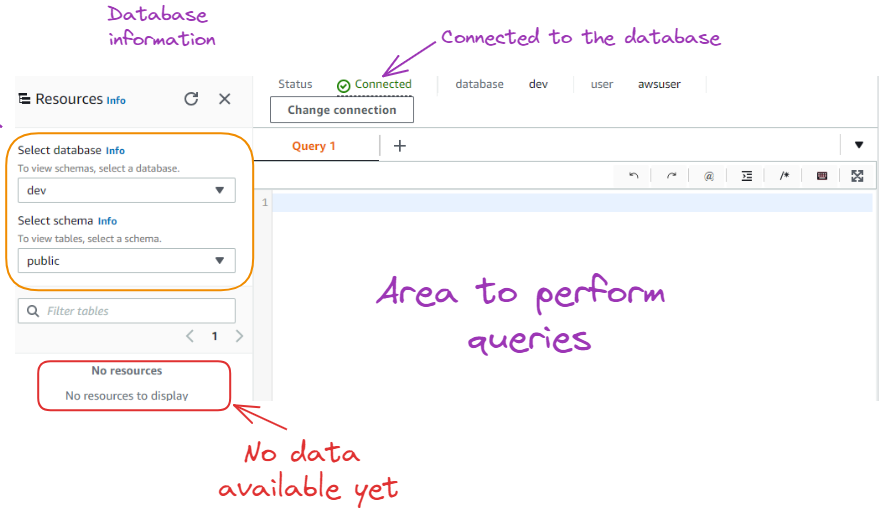
Hasil setelah tersambung ke database
Seperti terlihat di atas, belum ada sumber daya/data yang tersedia di database. Sebelum mengimpor data, kita perlu terlebih dahulu membuat tabel dengan karakteristik yang sama seperti data yang diimpor.
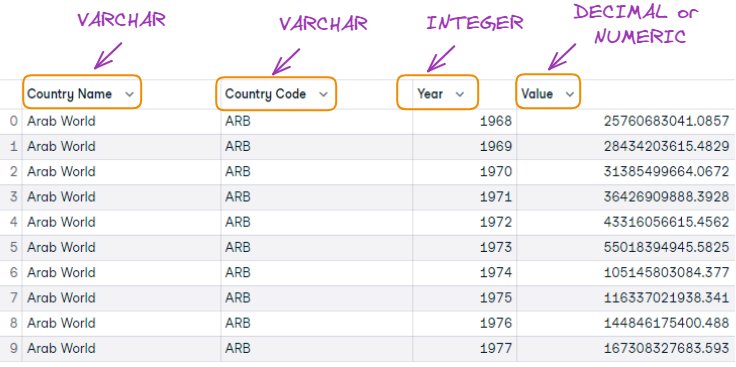
Kecocokan 10 observasi pertama dan format kolom tabel
Tabel dibuat menggunakan kueri SQL berikut:
CREATE TABLE gdp_data (
id INTEGER PRIMARY KEY,
country_name VARCHAR(255),
country_code VARCHAR(10),
year INTEGER,
value DECIMAL(20,2)
);
Berikut penjelasan kueri SQL dalam satu butir untuk tiap kolom:
id INTEGER PRIMARY KEY: Membuat kolom bernama "id" dengan tipe data INTEGER dan menetapkannya sebagai primary key tabel, memastikan nilai unik untuk setiap baris.country_name VARCHAR(255): Membuat kolom bernama "country_name" dengan tipe data VARCHAR, dapat menyimpan string hingga 255 karakter.country_code VARCHAR(10): Membuat kolom bernama "country_code" dengan tipe data VARCHAR, dapat menyimpan string hingga 10 karakter.year INTEGER: Membuat kolom bernama "year" dengan tipe data INTEGER, cocok untuk menyimpan bilangan bulat (dalam hal ini, tahun).value DECIMAL(20,2): Membuat kolom bernama "value" dengan tipe data DECIMAL, dapat menyimpan angka desimal dengan presisi 20 digit dan 2 tempat desimal.Sekarang, jalankan kueri untuk membuat tabel:
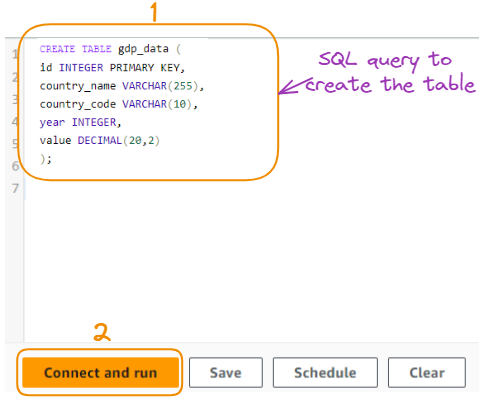
Kueri untuk membuat tabel
Kueri ini membuat tabel bernama "gdp_data" dengan kolom yang ditentukan untuk menyimpan data PDB seperti ditunjukkan di bawah:
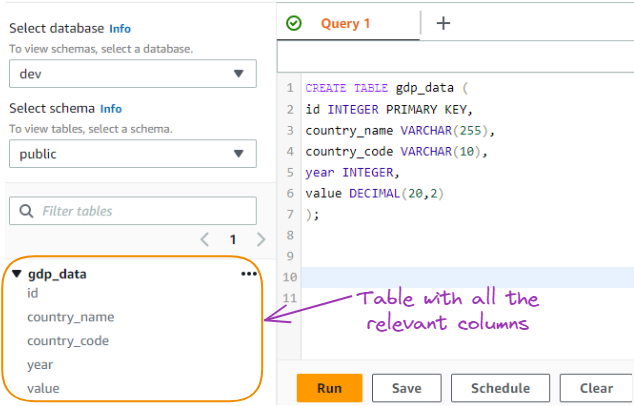
Tabel data PDB yang dibuat dari kueri SQL
Data akan diimpor ke tabel dari bucket S3. Pada bagian ini kami membahas semua langkah pembuatan bucket dan pengunggahan data.
Temukan layanan S3 dari Management Console, pilih logo yang sesuai, dan beri nama sambil membiarkan yang lainnya tetap default:
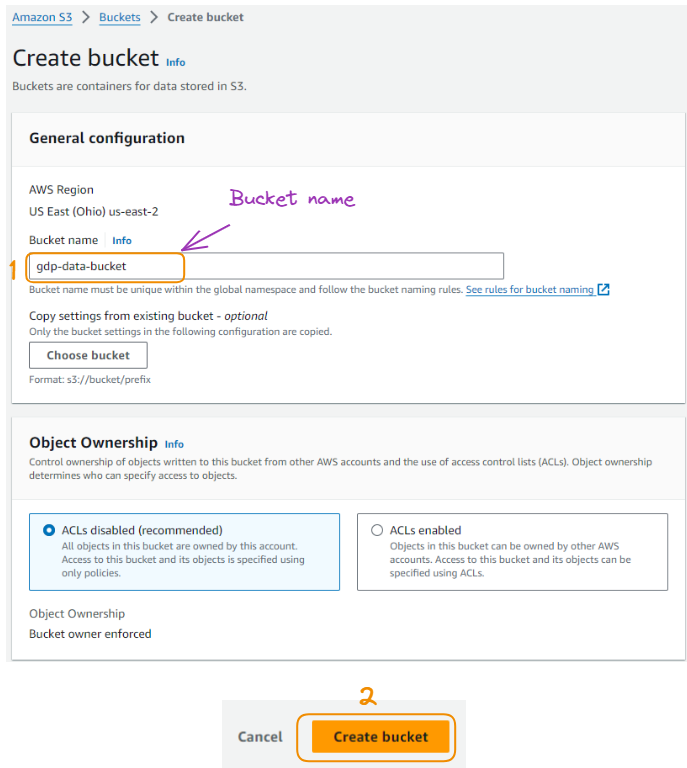
Pembuatan bucket S3
Setelah bucket dibuat, bucket tersebut akan tersedia dalam daftar semua bucket yang pernah dibuat.
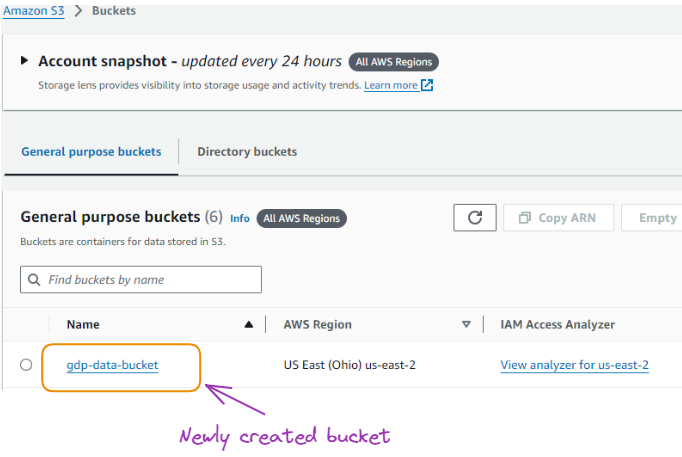
Bucket yang baru dibuat
Dari sana kita dapat memilih nama bucket, dan mengunggah data PDB yang diunduh secara lokal dalam format CSV.
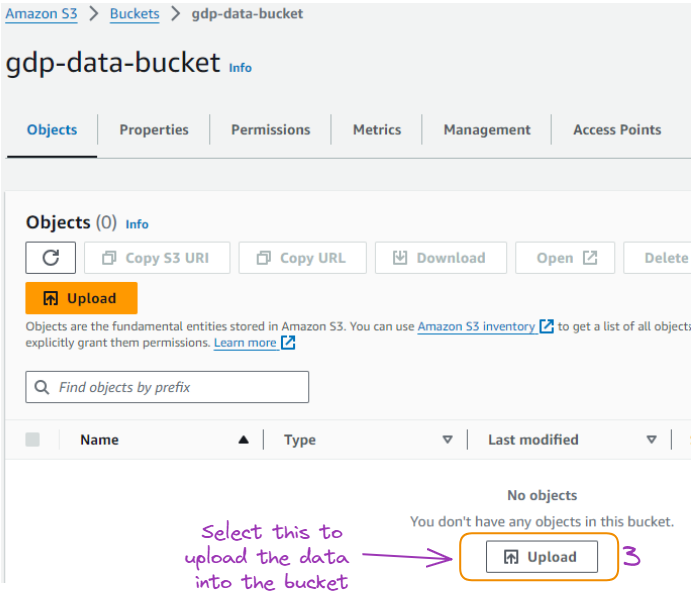
Halaman untuk mengunggah data ke bucket
Setelah berhasil mengimpor data, data akan tersedia seperti yang ditunjukkan di bawah:
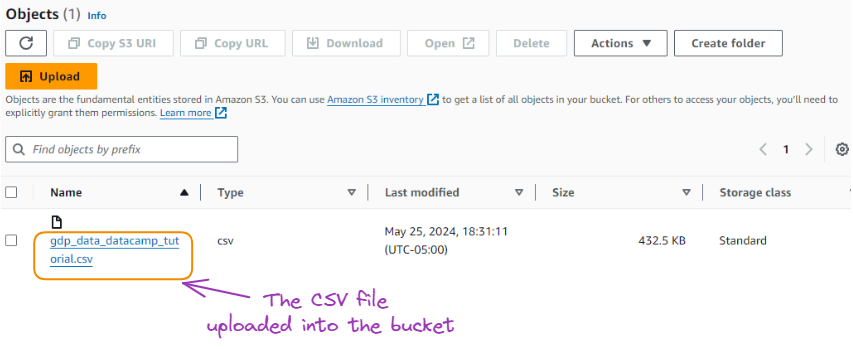
CSV yang diunggah ke bucket
Selamat telah sampai sejauh ini!
Bagian ini menjelaskan cara menyalin data dari S3 ke Redshift sebagai berikut.
COPY gdp_data (id, country_name, country_code, year, value)
FROM 's3://gdp-data-bucket/gdp/gdp_data.csv'
IAM_ROLE 'arn:aws:iam::654654631565:role/RedshiftS3FullAccess'
CSV
IGNOREHEADER 1;
Mari pahami apa yang terjadi di sini:
Kode yang sama dari editor ditampilkan di bawah, dan operasi salin berhasil dilakukan setelah beberapa detik:
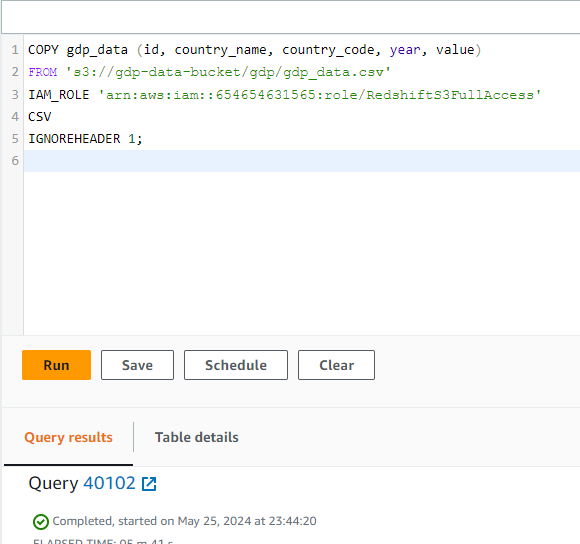
Tugas COPY selesai
Alih-alih mengunggah semua data dari CSV asli, hanya sampel acak seratus observasi yang diunggah demi kesederhanaan. Kita dapat melihat pratinjau data dengan memilih opsi “Preview data” sebagai berikut:
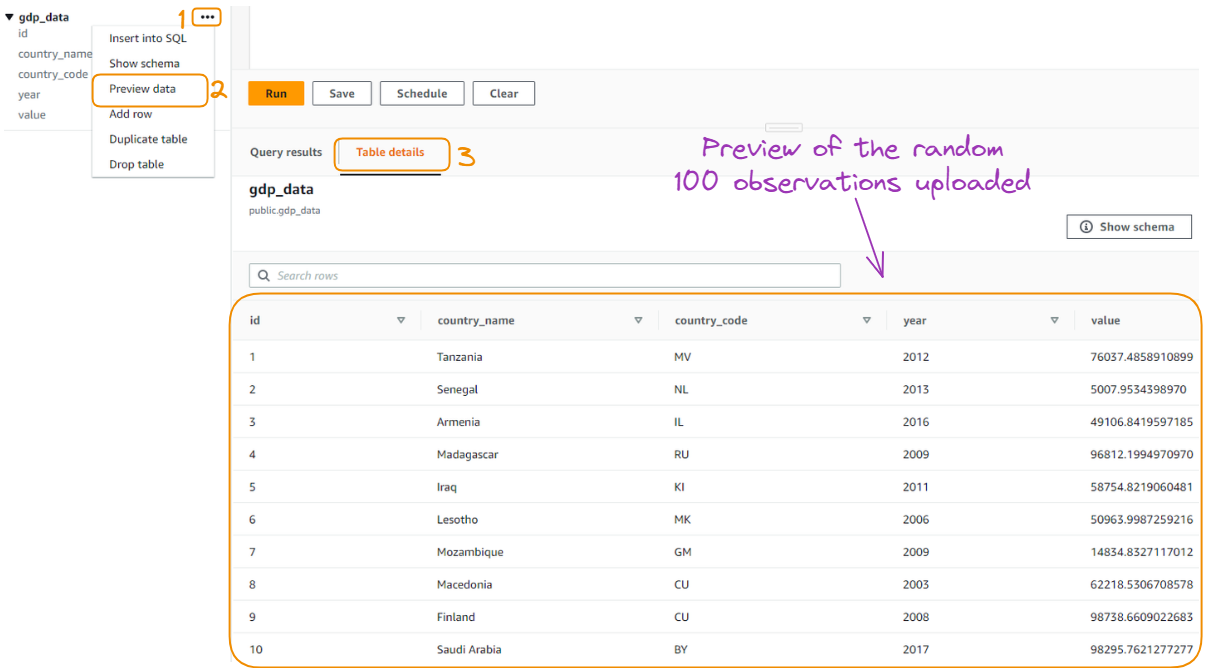
Pratinjau 100 observasi yang diunggah secara acak
Pratinjau data hanya menampilkan sepuluh observasi pertama. Namun, kita mungkin ingin berinteraksi lebih jauh dengan data untuk mendapatkan lebih banyak wawasan; di sinilah kemampuan SQL sangat bermanfaat.
Pada bagian ini, kita menelusuri data melalui beberapa kueri SQL untuk mengeksplorasi data.
Kami menggunakan lima kueri SQL untuk berinteraksi dengan data yang disimpan di database, dimulai dengan kueri yang paling umum digunakan: memilih data.
Pilih semua data
SELECT *
FROM gdp_data;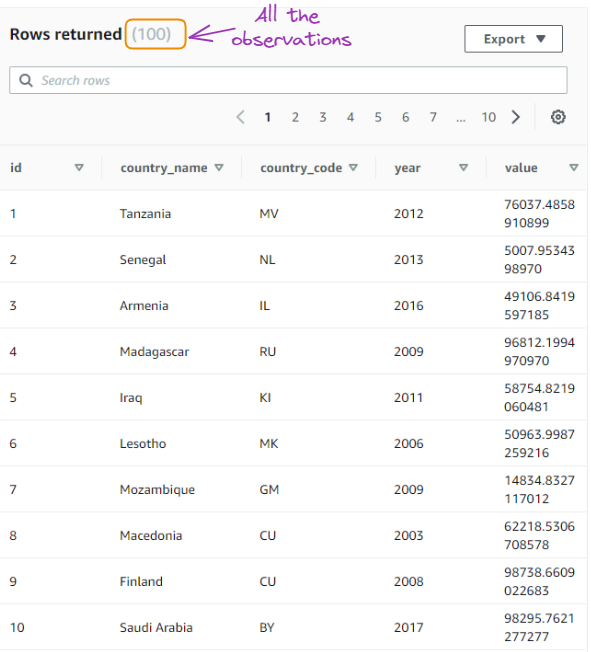
Hasil kueri pertama
Pilih data untuk negara tertentu:
SELECT * FROM gdp_data
WHERE country_name = 'Senegal';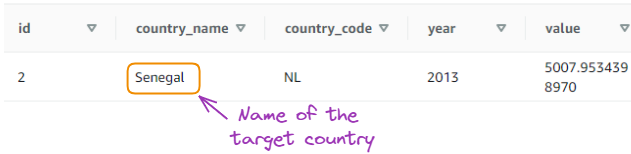
Hasil kueri kedua
Hitung nilai PDB rata-rata untuk tahun tertentu:
SELECT year, AVG(value) as average_gdp
FROM gdp_data
WHERE year = 2020
GROUP BY year;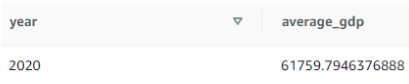
Hasil kueri ketiga
Temukan 5 negara dengan PDB tertinggi pada tahun tertentu:
SELECT country_name, value
FROM gdp_data
WHERE year = 2020
ORDER BY value DESC
LIMIT 5;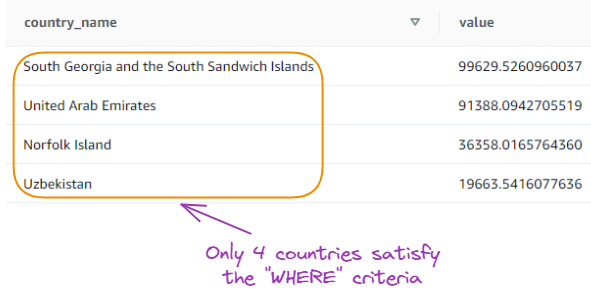
Hasil kueri keempat
Hitung jumlah catatan per tahun:
SELECT year, COUNT(*) as record_count
FROM gdp_data
GROUP BY year
ORDER BY year;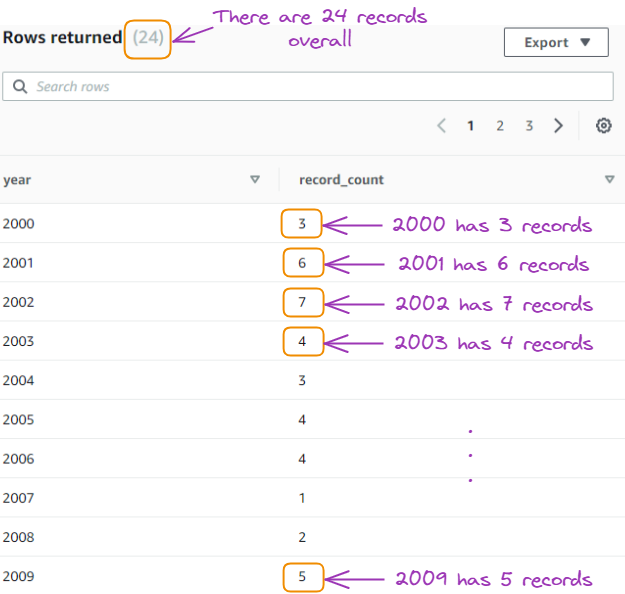
Hasil kueri kelima
Kueri di atas memberikan pemahaman dasar tentang data, dan bagian ini berfokus pada tiga teknik kueri lanjutan.
Menghitung total berjalan: Kueri ini menghitung total berjalan nilai PDB untuk setiap negara, diurutkan berdasarkan tahun.
SELECT
    country_name,
    year,
    value,
    SUM(value) OVER (PARTITION BY country_name ORDER BY year) as running_total
FROM gdp_data;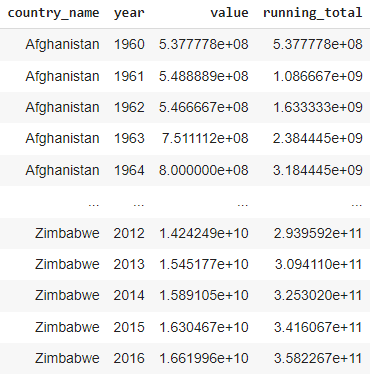
Hasil total berjalan
CTE untuk pemfilteran dan agregasi: kueri ini menggunakan CTE untuk memfilter data agar hanya menyertakan catatan dari tahun 2020 ke atas dan kemudian menghitung nilai PDB rata-rata untuk setiap negara.
WITH recent_data AS (
    SELECT
        country_name,
        year,
        value
    FROM gdp_data
    WHERE year >= 2020
)
SELECT
    country_name,
    AVG(value) as average_gdp
FROM gdp_data
GROUP BY country_name;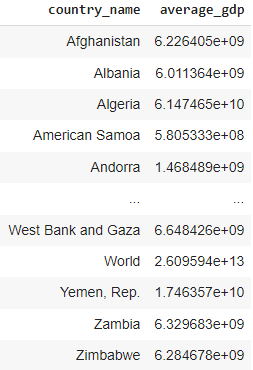
Hasil dari CTE
Menghitung pertumbuhan PDB dari tahun ke tahun: dengan kueri ini, kita menghitung pertumbuhan PDB tahun-ke-tahun untuk setiap negara.
SELECT
    a.country_name,
    a.year,
    a.value as current_year_value,
    b.value as previous_year_value,
    (a.value - b.value) / b.value * 100 as growth_percentage
FROM gdp_data a
JOIN gdp_data b
    ON a.country_name = b.country_name
    AND a.year = b.year + 1;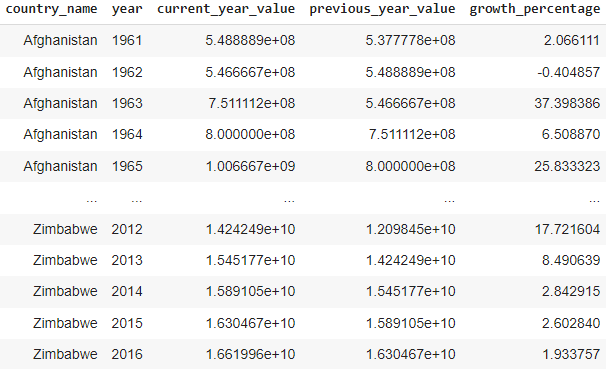
Hasil kueri self-join
Untuk memastikan kinerja optimal dan efektivitas biaya, penting untuk memahami faktor-faktor yang memengaruhi kinerja Redshift dan menerapkan praktik terbaik untuk menyetel klaster kita.
Pada bagian ini, kami akan membahas aspek kunci penyetelan kinerja Redshift kami dan memberikan wawasan berdasarkan informasi klaster yang disediakan.
Kinerja di Amazon Redshift dipengaruhi oleh banyak faktor, mulai dari konfigurasi perangkat keras hingga teknik pengoptimalan kueri, sehingga memahami faktor-faktor ini sangat penting untuk mengidentifikasi hambatan dan membuat keputusan yang lebih baik guna meningkatkan kinerja klaster.
Kami telah mengonfigurasi klaster Redshift yang terdiri dari dua node ra3.4xlarge, dan data yang digunakan hanya 391 KB.
Selain itu, gambar berikut menunjukkan bahwa penggunaan CPU klaster kami tetap mendekati 0% sepanjang periode waktu, yang menunjukkan bahwa klaster tidak banyak digunakan dan mungkin terlalu besar untuk beban kerja kami saat ini.
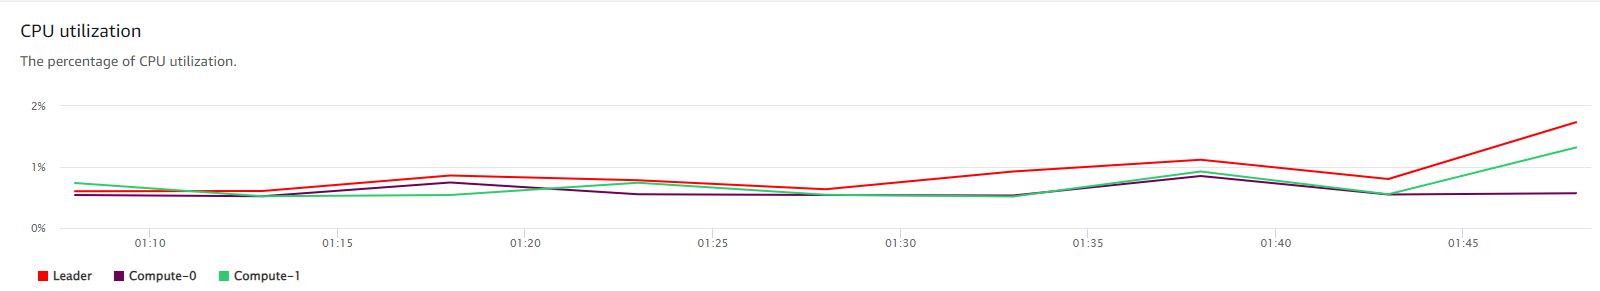
Penggunaan CPU klaster kami
Beberapa faktor kunci yang memengaruhi kinerja Redshift meliputi:
Untuk mengoptimalkan kinerja klaster, penting untuk mengikuti praktik terbaik dalam desain tabel dan manajemen data. Meskipun dataset kecil, menerapkan praktik ini dapat menjadi fondasi yang kuat untuk pertumbuhan dan efisiensi kinerja di masa depan.
Pemantauan dan pemeliharaan klaster secara berkala sangat penting untuk memastikan kinerja optimal dan efisiensi biaya. Gambar berikut memberikan rincian biaya Redshift bulanan kami, yang mengungkap peluang pengoptimalan biaya.
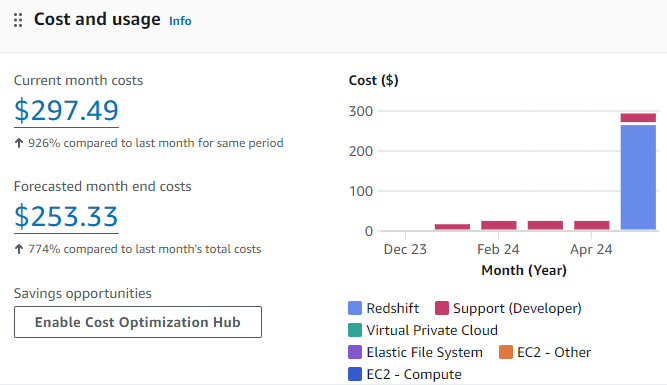
Grafik biaya dan penggunaan untuk kasus penggunaan Redshift saat ini
Berdasarkan gambar di atas, klaster Redshift kami tampak berlebihan untuk dataset kecil saat ini, sehingga menyebabkan pemanfaatan rendah dan inefisiensi biaya.
Dengan menggunakan alat AWS seperti Amazon CloudWatch dan AWS Management Console, kita dapat memantau metrik kinerja utama, termasuk penggunaan CPU dan kinerja kueri. Wawasan ini dapat membantu kami mengidentifikasi potensi masalah dan membuat keputusan berbasis data untuk pengoptimalan klaster.
Mengacu pada pemanfaatan klaster yang rendah, kami dapat mempertimbangkan strategi pengoptimalan biaya berikut:
Seiring pertumbuhan volume data dan perkembangan beban kerja, terus pantau kinerja klaster dan evaluasi kembali penentuan ukuran instans serta strategi pengoptimalan Anda.
Saat bekerja dengan data sensitif di Amazon Redshift, memastikan standar tertinggi keamanan dan kepatuhan adalah hal penting. Seiring meningkatnya persyaratan regulasi dan kebutuhan untuk melindungi informasi sensitif, penerapan langkah keamanan yang tangguh dan kepatuhan terhadap pedoman menjadi aspek krusial dalam mengelola klaster Redshift kami.
Kepatuhan terhadap regulasi khusus industri dan undang-undang perlindungan data merupakan prioritas utama bagi organisasi yang menangani data sensitif. Amazon Redshift menyediakan fitur dan kapabilitas untuk membantu kami memenuhi persyaratan kepatuhan tersebut secara efektif.
Selain pertimbangan kepatuhan, menerapkan praktik terbaik untuk keamanan data di Amazon Redshift sangat penting untuk melindungi informasi sensitif Anda dari akses tidak sah dan potensi pelanggaran.
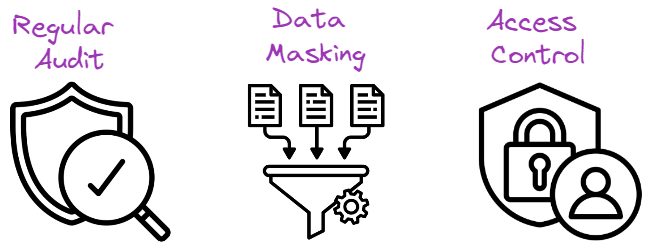
Praktik terbaik untuk keamanan data
Melakukan audit keamanan secara rutin sangat penting untuk mengidentifikasi kerentanan, menilai efektivitas langkah keamanan yang ada, dan memastikan kepatuhan berkelanjutan. Pertimbangkan praktik audit berikut:
Data masking adalah teknik yang melibatkan penyamaran elemen data sensitif sambil mempertahankan struktur dan format data. Dengan menyamarkan informasi sensitif, kita dapat melindunginya dari akses tidak sah dan menjaga privasi data. Berikut beberapa pendekatan untuk masking data di Amazon Redshift:
Menerapkan mekanisme kontrol akses yang kuat sangat penting untuk memastikan hanya individu yang berwenang yang dapat mengakses data sensitif di klaster Amazon Redshift kami. Mekanisme tersebut dapat diterapkan sebagai berikut:
Dalam artikel ini, kami telah membahas dasar-dasar dan aspek lanjutan penggunaan Amazon Redshift untuk data warehousing. Kami mulai dengan memahami pentingnya data warehousing dan bagaimana Amazon Redshift menyediakan solusi yang andal, skalabel, dan hemat biaya untuk menganalisis dataset besar menggunakan SQL.
Kemudian, kami menelusuri proses penyiapan klaster Amazon Redshift, termasuk prasyarat, pembuatan klaster, dan pengaturan konfigurasi. Kami juga membahas detail pemuatan data ke Redshift menggunakan AWS S3 dan perintah COPY, dengan contoh sintaks dan penjelasannya.
Selanjutnya, kami membahas hal-hal penting dalam melakukan kueri data di Redshift, mulai dari kueri SQL dasar hingga teknik lanjutan seperti fungsi window dan join kompleks. Kami juga membahas penyetelan kinerja di Redshift, menyoroti praktik terbaik untuk mengoptimalkan kinerja kueri, seperti gaya distribusi, kunci pengurutan, dan pengodean kompresi.
Terakhir, kami menekankan pentingnya keamanan dan kepatuhan di Amazon Redshift, mencakup fitur keamanan seperti enkripsi dan kontrol akses, serta pertimbangan kepatuhan.
Bagi siapa pun yang ingin memperluas pengetahuan dan keterampilan dalam bekerja dengan Amazon Redshift dan AWS, ada baiknya mengeksplorasi sumber daya DataCamp berikut:
Dengan menguasai Amazon Redshift dan memanfaatkan kapabilitasnya, pengguna dapat membuka wawasan berharga dari data mereka dan membuat keputusan berbasis data.
Lanjutkan Perjalanan Data Engineering Anda Hari Ini!
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Program} other {Program}}
{count, plural, one {Program} other {Program}}
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt




