
Cursus
Data Engineering begrijpen
2 uur
375.5K
Data is de basis van moderne organisaties, maar het enorme volume aan informatie dat wordt verzameld en opgeslagen, kan lastig te beheren zijn. Succes hangt af van het effectief organiseren en analyseren van deze data om waardevolle inzichten te ontdekken die gefundeerde besluitvorming mogelijk maken.
Hier komt datawarehousing om de hoek kijken. Het is een krachtige oplossing waarmee bedrijven hun data kunnen consolideren en optimaliseren voor efficiënte analyses. En als het om datawarehousing gaat, springt AWS Redshift eruit als topkeuze.
In dit artikel duiken we in de details van AWS Redshift, inclusief de belangrijkste features, voordelen en best practices voor het opzetten, laden van data, query’s draaien, performance tuning, security en integraties.
Of je nu een dataprofessional bent of een businessleider die het maximale uit data wil halen, dit artikel geeft je de kennis en tools om succesvol te zijn met AWS Redshift.
Datawarehousing is het proces van het verzamelen, opslaan en beheren van grote hoeveelheden gestructureerde data uit verschillende bronnen binnen een organisatie.
Het primaire doel van een datawarehouse is om een centrale bron van informatie te bieden die eenvoudig toegankelijk, analyseerbaar en bruikbaar is voor rapportage en besluitvorming.
Datawarehouses zijn ontworpen om complexe queries en data-analyses te ondersteunen, zodat bedrijven waardevolle inzichten uit hun data kunnen halen.
Het adopteren van een datawarehouse kan organisaties een groot aantal voordelen opleveren:
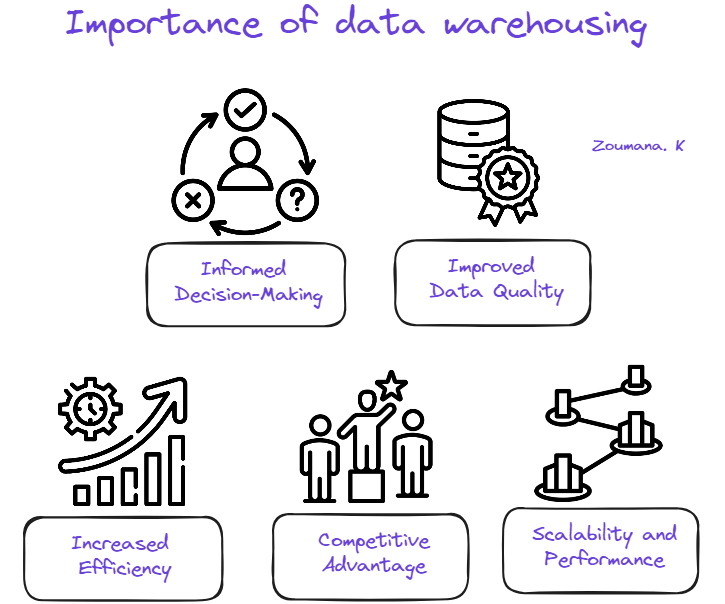
Belang van datawarehousing
AWS Redshift is een volledig beheerde, cloudgebaseerde datawarehousingservice waarmee datasets op petabyteschaal kunnen worden opgeslagen en geanalyseerd. Met AWS Redshift Serverless kunnen gebruikers data benaderen en analyseren zonder handmatige configuratie van een geprovisioneerd datawarehouse.
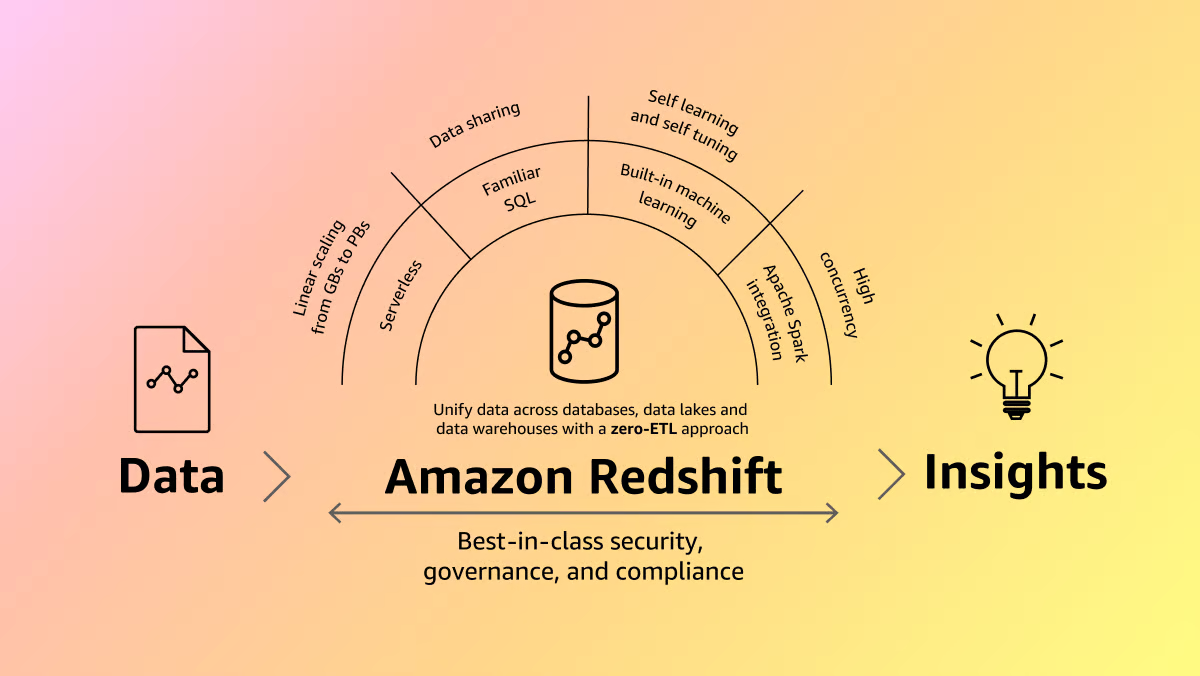
Amazon Redshift (Bron)
De service voorziet automatisch in resources en schaalt de capaciteit van het datawarehouse intelligent om snelle performance te garanderen, zelfs bij de meest veeleisende en onvoorspelbare workloads. Gebruikers betalen alleen voor de resources die ze gebruiken; er zijn geen kosten wanneer het datawarehouse idle is.
AWS Redshift stelt gebruikers in staat om data te laden en direct te beginnen met query’s draaien via de Amazon Redshift query editor v2 of hun favoriete business intelligence (BI)-tool. De service biedt de beste prijs-prestatieverhouding en vertrouwde SQL-features in een gebruiksvriendelijke omgeving zonder beheerlast.
Ongeacht de grootte van de dataset levert AWS Redshift snelle queryprestaties met dezelfde SQL-gebaseerde tools en BI-applicaties die vandaag de dag gangbaar zijn.
AWS Redshift biedt meerdere features en voordelen om organisaties te helpen grote hoeveelheden data efficiënt op te slaan, te beheren en te analyseren. Enkele van de belangrijkste features en voordelen zijn hieronder weergegeven:
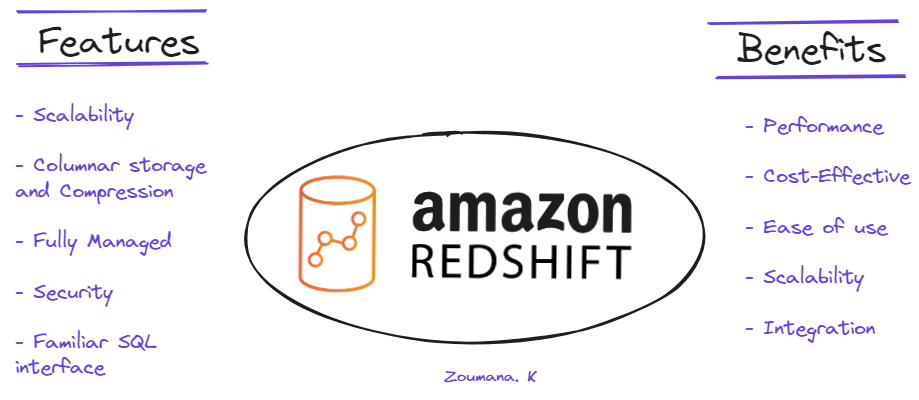
Features en voordelen van AWS Redshift
De vorige secties focusten vooral op een algemeen begrip van Redshift. Nu bekijken we de technische aspecten.
Deze sectie laat eerst de belangrijkste vereisten zien om AWS Redshift succesvol op te zetten, vervolgens doorlopen we stap voor stap het proces van het creëren van een Redshift-cluster. Het laatste deel zoomt in op de belangrijkste clusterinstellingen, zoals nodetypen, aantal nodes en securityconfiguratie.
Voordat we in de details van de use case duiken, lopen we eerst de vereisten door voor een succesvolle implementatie:
Deze sectie geeft alle stappen om via de AWS Management Console een Redshift-cluster te maken in 11 eenvoudige stappen, zoals hieronder geïllustreerd:
1. Zoek Redshift in de console en selecteer “Amazon Redshift”:
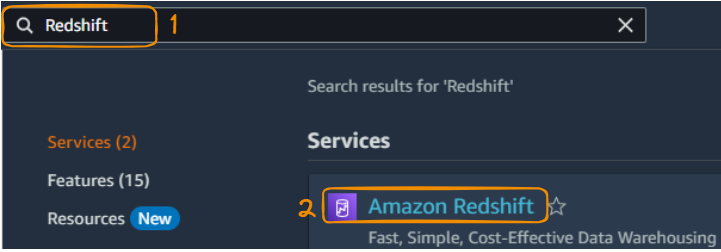
Zoek en selecteer Redshift vanuit de Management Console
2. Selecteer de knop “Create Cluster” om te beginnen met het aanmaken van een cluster.
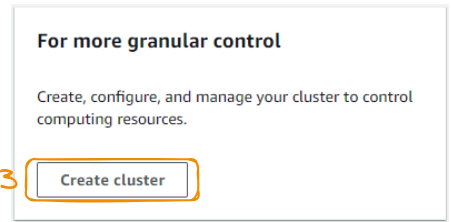
Knop voor het aanmaken van een cluster
3. Vanuit de bovenstaande actie kunnen we het cluster configureren door informatie op te geven zoals clusteridentifier, de grootte van het cluster, het nodetype, keuze voor availability zone, aantal nodes.
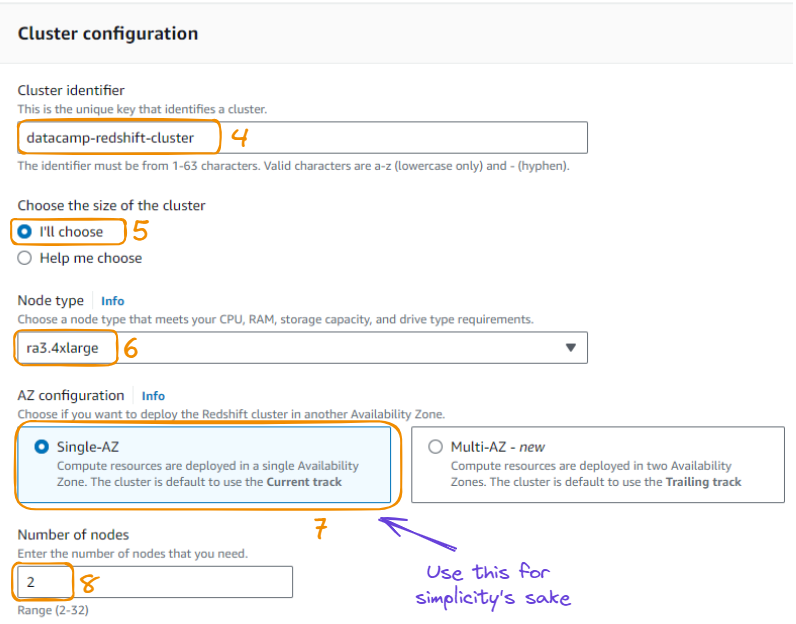
Clusterconfiguratie in 8 stappen
4. In plaats van voorbeelddata te gebruiken zoals op dezelfde pagina wordt voorgesteld, gebruiken we data uit een S3-bucket om data in Redshift te laden.
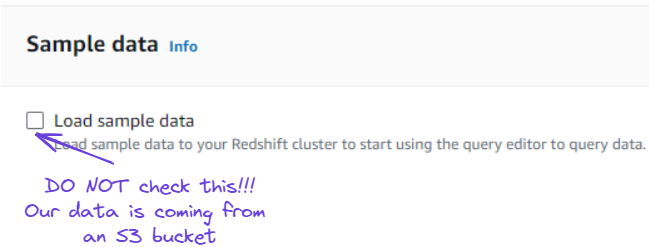
Optie om geen voorbeelddata te laden
5. We hebben de optie om de permissies van het cluster te definiëren door IAM-rollen op te geven. Deze sectie kan worden overgeslagen en later opgepakt.
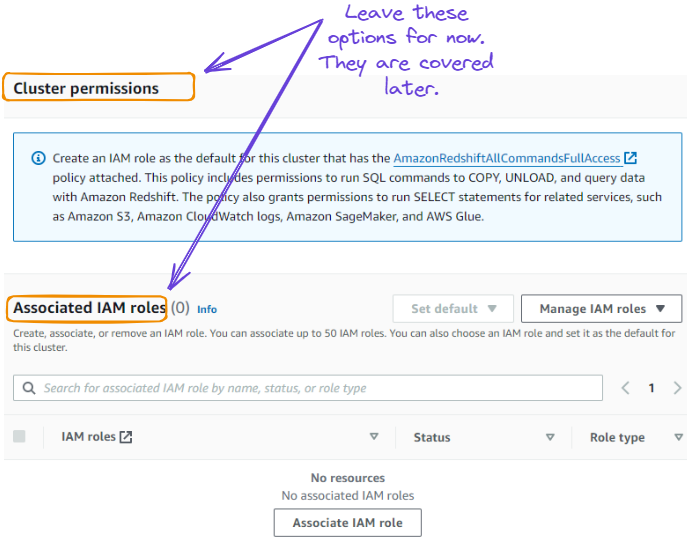
Negeer clusterpermissies en IAM-rollen
6. Laat de standaardconfiguraties staan voor netwerk, security, back-up en onderhoud, en selecteer de knop “Create cluster” om het cluster te maken.
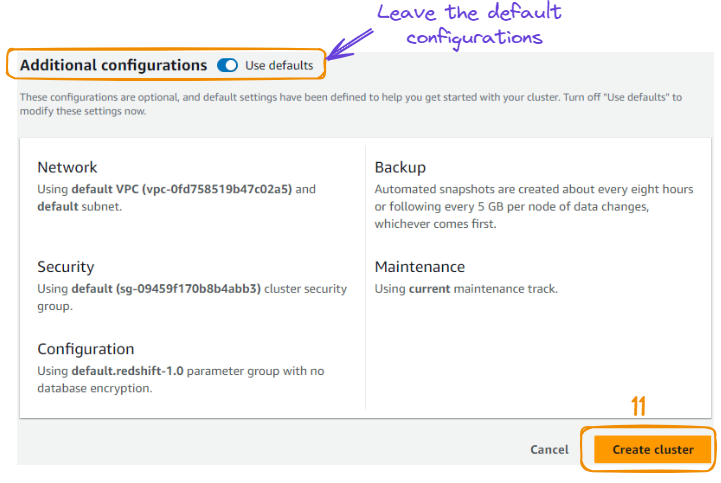
Aanmaken van het cluster
7. Na de bovenstaande actie worden we doorgestuurd naar een nieuwe pagina met het zojuist aangemaakte cluster. Het kan een paar minuten duren om het cluster succesvol te maken; dit is te zien in de sectie “Status”, die eerst “Creating” is en daarna “Available” wordt.
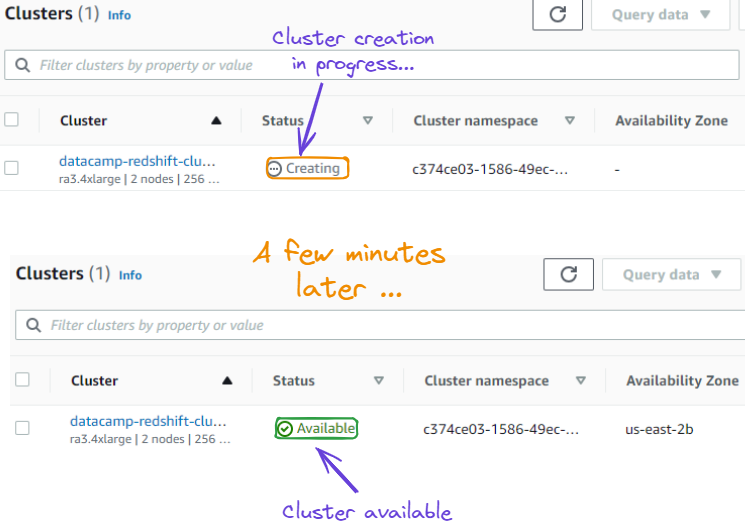
Clusterstatus van “Creating” naar “Available”
We hebben nu met succes onze Redshift-clusters aangemaakt. Deze sectie leidt je door alle stappen: van het kiezen van de Country-, Regional- en World GDP (bruto binnenlands product)-dataset die beschikbaar is op onze DataLab tot het uploaden in een S3-bucket.
Onze data is oorspronkelijk afkomstig uit de dataset van de Wereldbank. Het gaat over het bbp van landen, regio’s en de wereld, gemeten in actuele Amerikaanse dollars ($). Regio’s verwijzen naar verzamelingen van landen, zoals Europa en Centraal-Azië.
De eerste tien observaties van de data zien er zo uit:
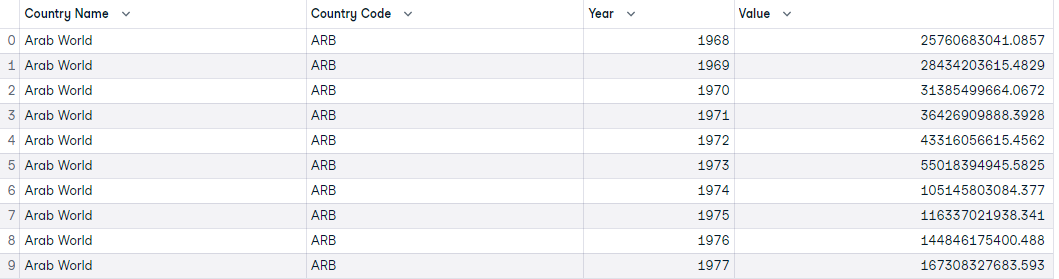
Eerste tien observaties van de bbp-data
Voor een succesvolle interactie tussen S3 en Redshift moeten we eerst een IAM-rol aanmaken voordat we een S3-bucket creëren om data op te slaan.
Het voordeel van het aanmaken van een IAM-rol is dat hiermee een verbinding wordt gelegd tussen ons Redshift-cluster en de S3-bucket waar de data zich bevindt.
De IAM-rol wordt als volgt aangemaakt:
Zoek vanuit de Management Console op “IAM” en selecteer het “IAM”-logo in de zoekresultaten.
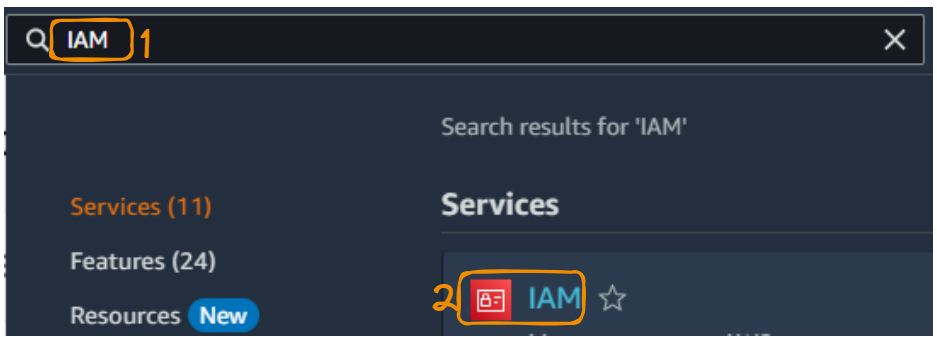
IAM-service vanuit de Management Console
Selecteer “Roles” om alle mogelijke rollen weer te geven, en kies “Create role” om een nieuwe rol te maken.
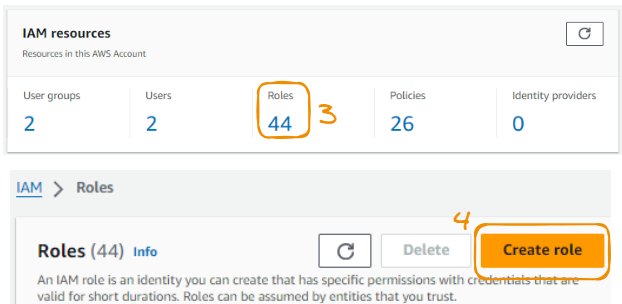
Begin met het aanmaken van een nieuwe rol
Kies “AWS service” bij “Trusted entity type”, vervolgens “Redshift” bij “Use case”, en “Next” om verder te gaan.
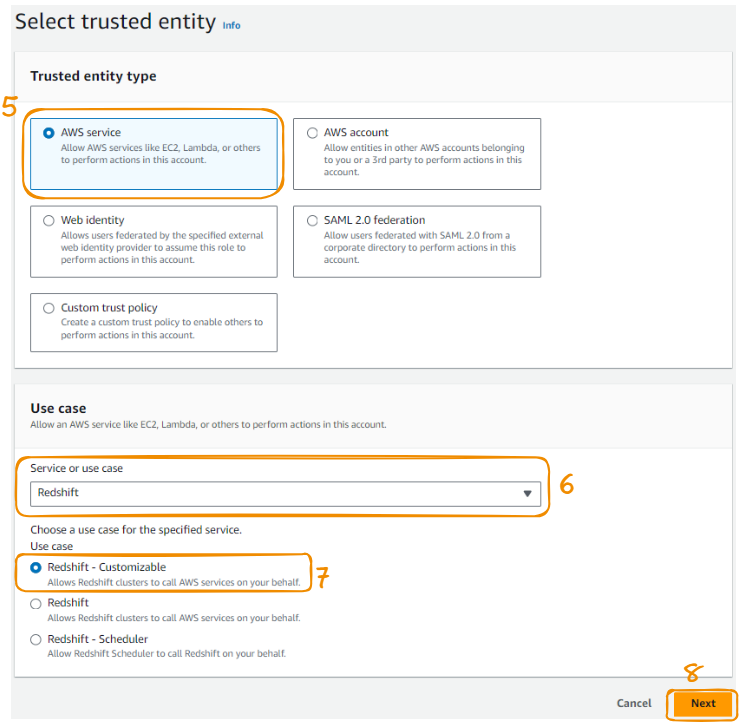
Stappen 5 t/m 8 van het aanmaken van de AMI-rol
Zoek “S3FullAccess” via het zoekveld, vink de optie aan en selecteer “Next”.
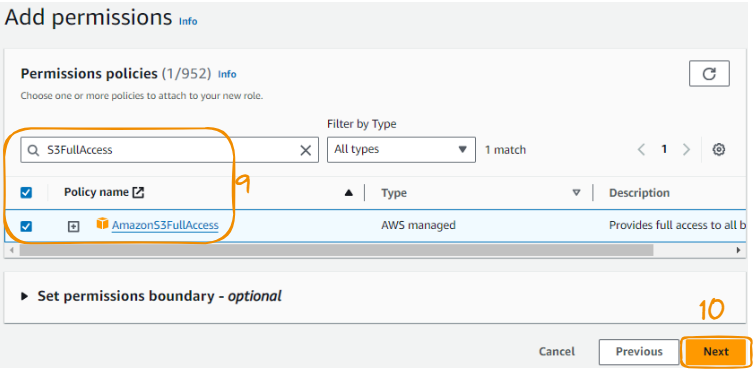
Stappen 9 t/m 10 van het aanmaken van de AMI-rol
Geef tot slot de rol een naam, controleer de instellingen en kies de knop “Create role” om het aanmaken van de rol te voltooien.
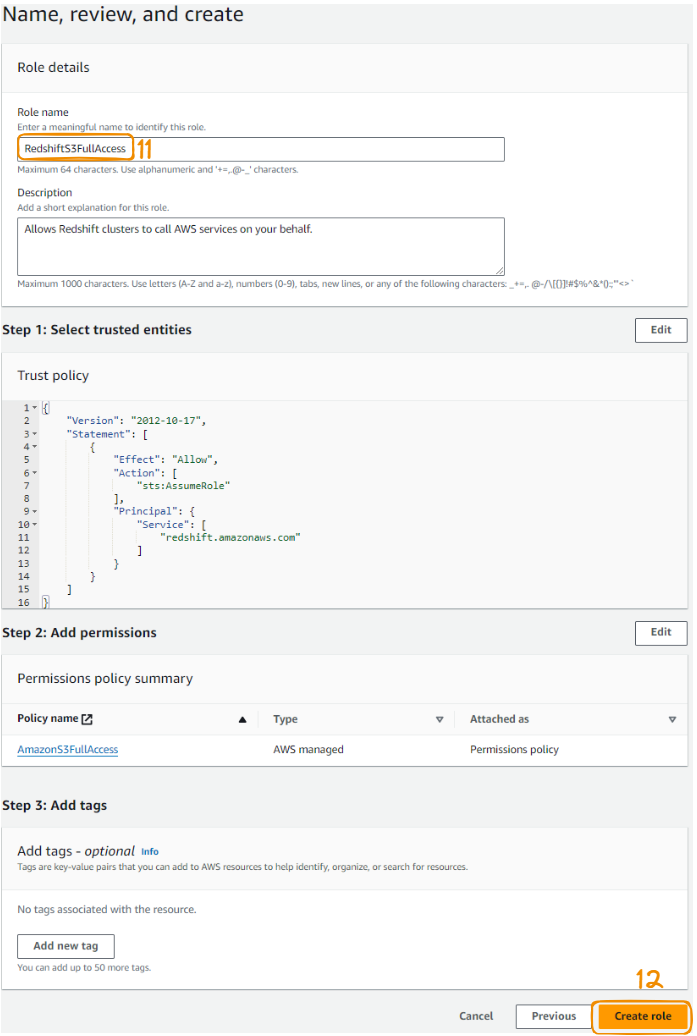
Stappen 11 t/m 12 van het aanmaken van de AMI-rol
Als alles succesvol is, verschijnt het volgende groene bericht ter bevestiging van het aanmaken van de rol in de bovenhoek.
Bevestigingsbericht voor het aanmaken van de rol
Nu we de IAM-rol hebben, kunnen we deze koppelen aan het eerder aangemaakte Redshift-cluster. Dat doe je als volgt:
Selecteer in de clusteroverzichtssectie het aangemaakte datacamp-cluster en kies onder “Actions” voor “Manage IAM roles”.
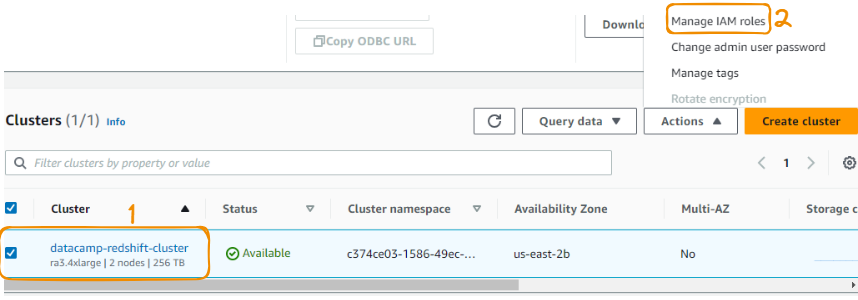
IAM-rol koppelen aan Redshift, stappen 1 t/m 2
Kies in deze sectie de eerder aangemaakte IAM-rol en sla de wijzigingen op.
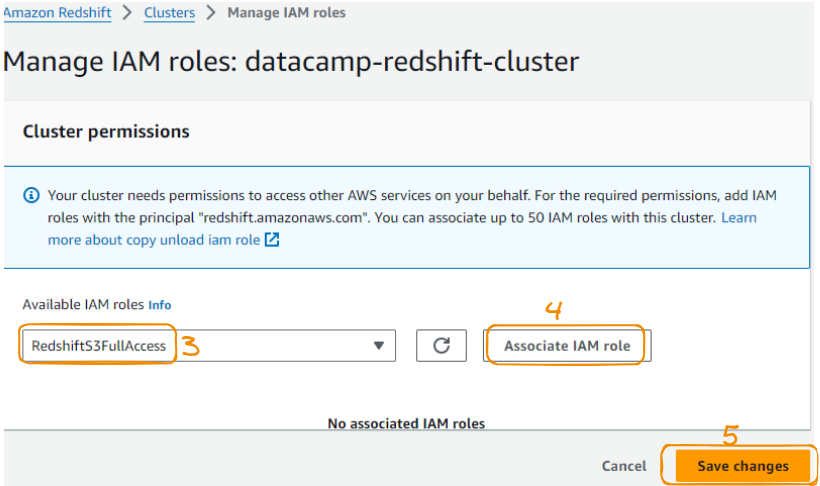
IAM-rol koppelen aan Redshift, stappen 3 t/m 4
Er zijn meerdere tools om data uit Redshift te bevragen. Sommige tools maken al deel uit van AWS-services, andere zijn extern. In de scope van deze tutorial gebruiken we de query editor vanuit het Redshift-dashboard.
Om deze te gebruiken, moeten we eerst een verbinding aanmaken met de Query editor, te beginnen met de optie “Query in query editor” op het tabblad “Query data”:
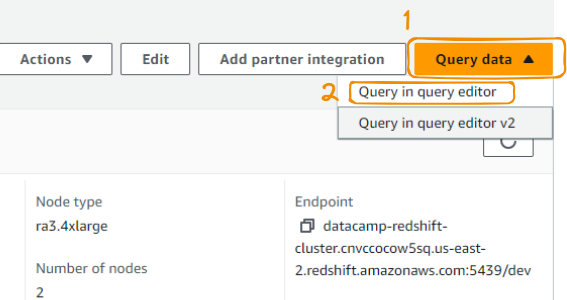
Query editor vanuit Query data
De bovenstaande actie leidt naar de volgende pagina, waar we verbinding met de database kunnen maken na het geven van een naam, samen met een gebruikersnaam, zoals hieronder:
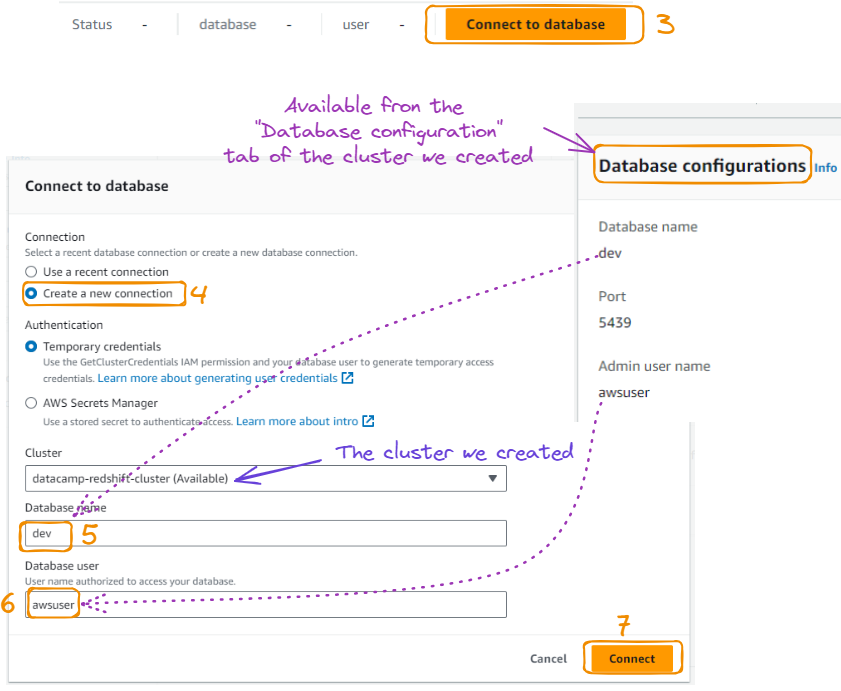
Databaseverbinding vanuit de query editor
Na het klikken op de knop “Connect” zien we bovenaan het groene tabblad “Connected” en de database-informatie links.
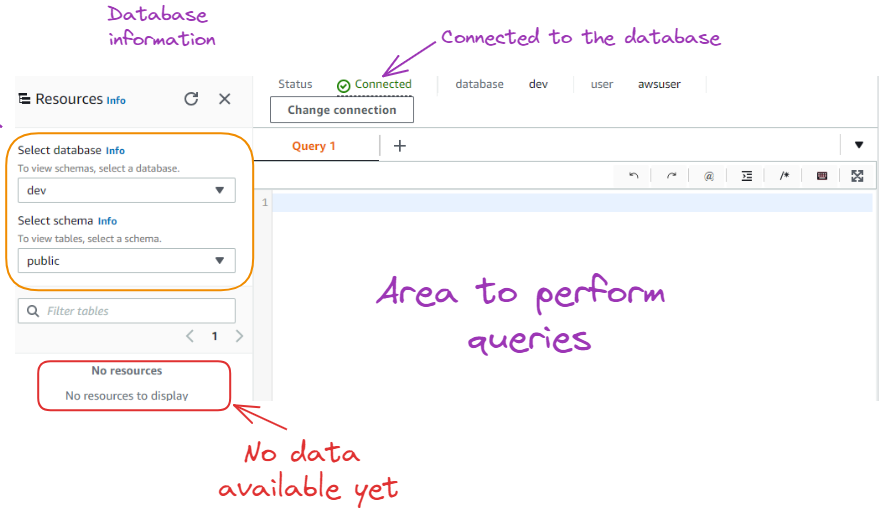
Resultaat na verbinden met de database
Zoals we hierboven zien, zijn er nog geen resources/data beschikbaar in de database. Voordat we data importeren, moeten we eerst een tabel maken met dezelfde kenmerken als de te importeren data.
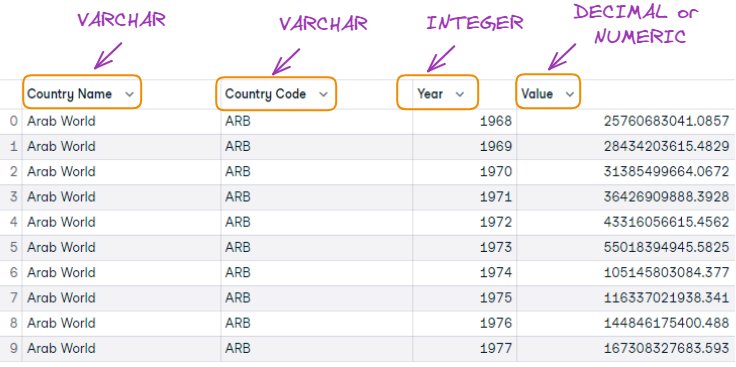
Eerste 10 observaties en overeenkomend tabelkolomformaat
De tabel wordt aangemaakt met de volgende SQL-query:
CREATE TABLE gdp_data (
id INTEGER PRIMARY KEY,
country_name VARCHAR(255),
country_code VARCHAR(10),
year INTEGER,
value DECIMAL(20,2)
);
Hier volgt per kolom in één bullet een uitleg van de SQL-query:
id INTEGER PRIMARY KEY: Maakt een kolom met de naam "id" met het datatype INTEGER en stelt deze in als primary key van de tabel, wat unieke waarden per rij garandeert.country_name VARCHAR(255): Maakt een kolom met de naam "country_name" met het datatype VARCHAR, geschikt voor strings tot 255 tekens.country_code VARCHAR(10): Maakt een kolom met de naam "country_code" met het datatype VARCHAR, geschikt voor strings tot 10 tekens.year INTEGER: Maakt een kolom met de naam "year" met het datatype INTEGER, geschikt voor gehele getallen (in dit geval jaren).value DECIMAL(20,2): Maakt een kolom met de naam "value" met het datatype DECIMAL, geschikt voor decimale getallen met een precisie van 20 cijfers en 2 decimalen.Nu draaien we de query om de tabel te maken:
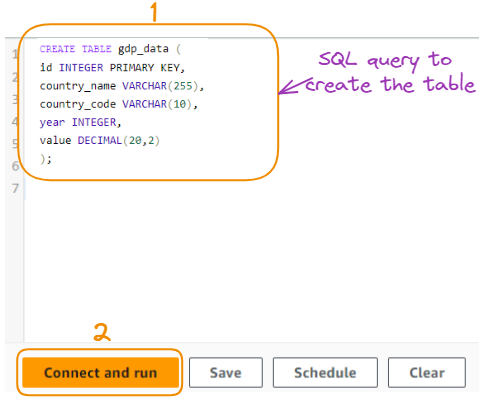
Query om de tabel te maken
Deze query maakt een tabel met de naam "gdp_data" met de opgegeven kolommen om bbp-data op te slaan, zoals hieronder weergegeven:
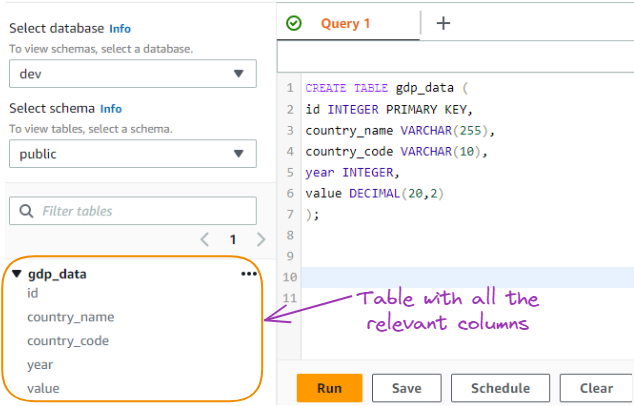
Bbp-tabel aangemaakt via SQL-query
De data wordt in de tabel geïmporteerd vanuit een S3-bucket. In deze sectie behandelen we alle stappen van het aanmaken van de bucket en het uploaden van de data.
Zoek de S3-service in de Management Console, selecteer het bijbehorende logo en geef de bucket een naam, terwijl je de rest op standaard laat:
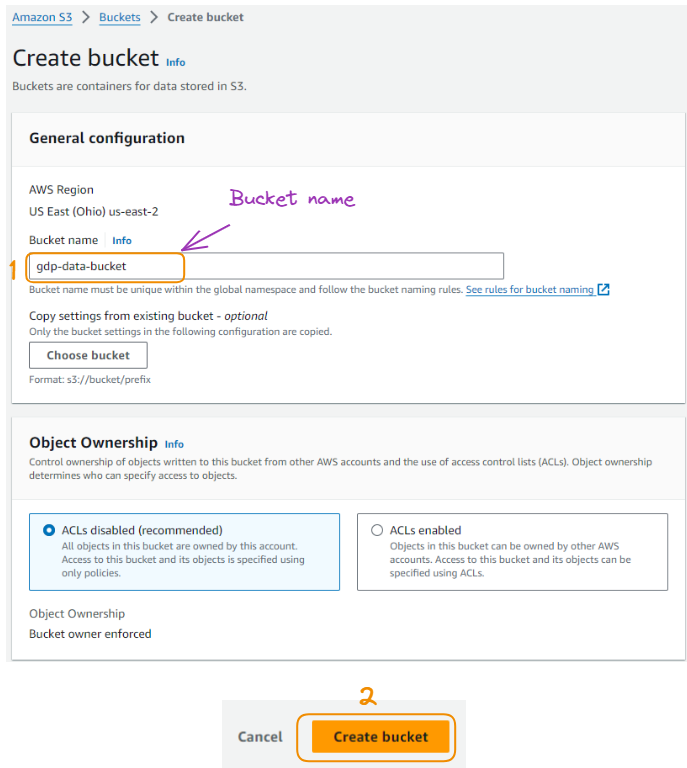
Aanmaken van een S3-bucket
Zodra de bucket is aangemaakt, verschijnt deze in de lijst met alle eerder aangemaakte buckets.
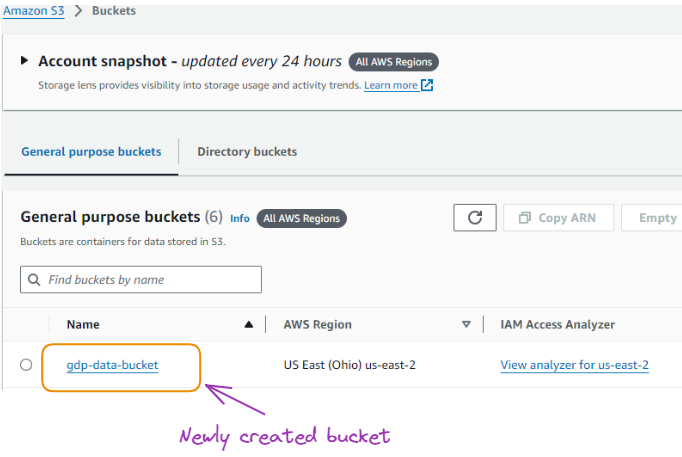
De nieuw aangemaakte bucket
Van daaruit kunnen we de bucketnaam selecteren en de lokaal gedownloade bbp-data in CSV-formaat uploaden.
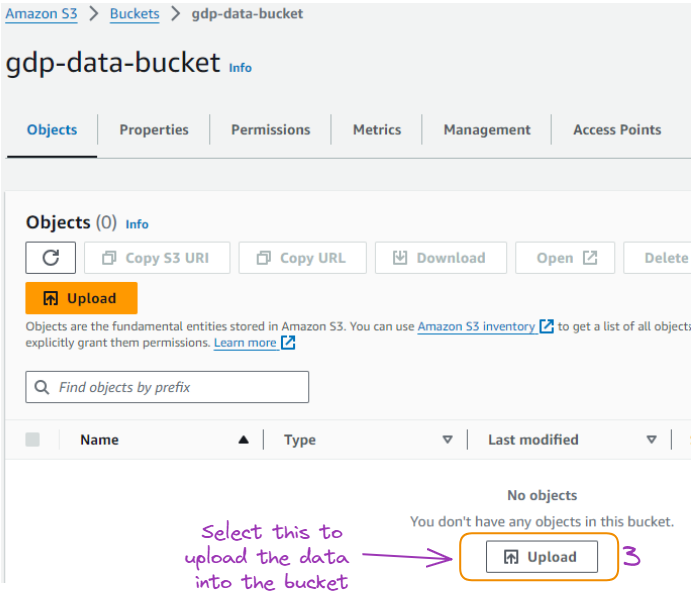
Pagina om data naar de bucket te uploaden
Na het succesvol importeren van de data is deze beschikbaar zoals hieronder te zien:
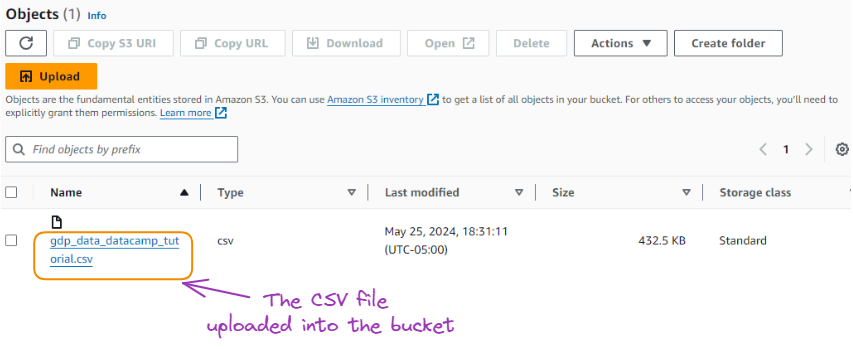
De CSV geüpload in de bucket
Gefeliciteerd dat je zo ver bent gekomen!
Deze sectie laat zien hoe je de data vanuit S3 naar Redshift kopieert, als volgt.
COPY gdp_data (id, country_name, country_code, year, value)
FROM 's3://gdp-data-bucket/gdp/gdp_data.csv'
IAM_ROLE 'arn:aws:iam::654654631565:role/RedshiftS3FullAccess'
CSV
IGNOREHEADER 1;
Laten we begrijpen wat hier gebeurt:
Dezelfde code uit de editor staat hieronder, en de kopieeractie werd na enkele seconden succesvol uitgevoerd:
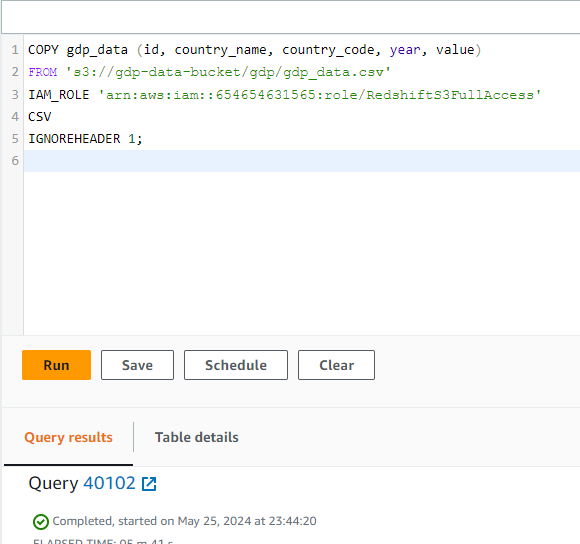
COPY-taak voltooid
In plaats van alle data uit de originele CSV te uploaden, is voor de eenvoud slechts een willekeurige steekproef van honderd observaties geüpload. We kunnen een preview van de data bekijken via de optie “Preview data” zoals hieronder:
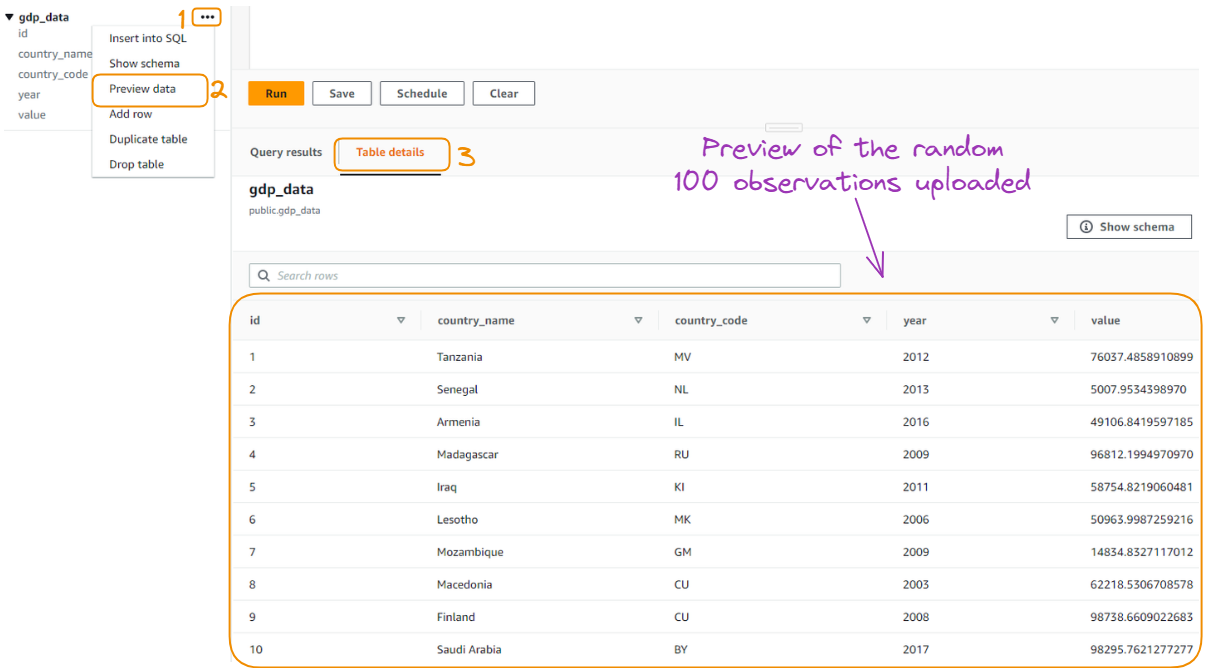
Preview van de willekeurig geüploade 100 observaties
De preview laat alleen de eerste tien observaties van de data zien. Maar vaak wil je meer met je data interacteren om extra inzicht te krijgen; dan zijn SQL-vaardigheden handig.
In deze sectie verkennen we de data met enkele SQL-query’s.
We gebruiken vijf SQL-query’s om te interacteren met de in onze database opgeslagen data, beginnend met de meest gebruikte query: het selecteren van data.
Selecteer alle data
SELECT *
FROM gdp_data;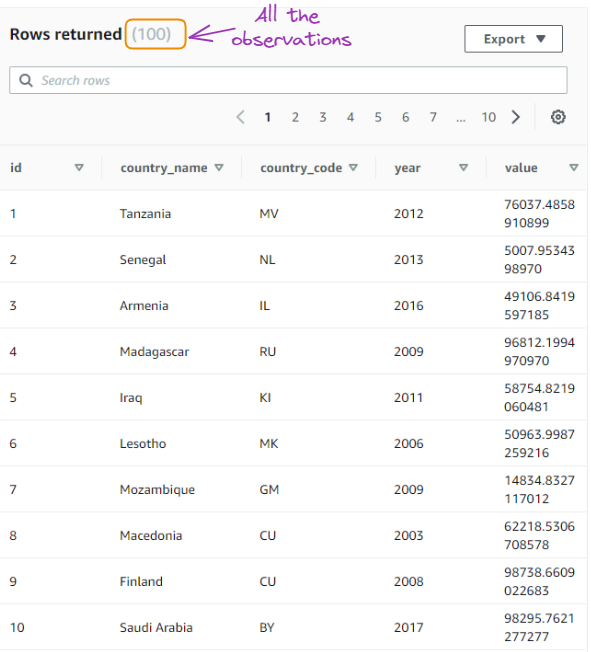
Resultaat van de eerste query
Selecteer data voor een specifiek land:
SELECT * FROM gdp_data
WHERE country_name = 'Senegal';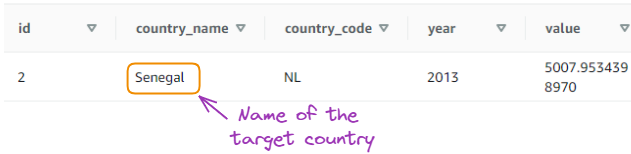
Resultaat van de tweede query
Bereken de gemiddelde bbp-waarde voor een specifiek jaar:
SELECT year, AVG(value) as average_gdp
FROM gdp_data
WHERE year = 2020
GROUP BY year;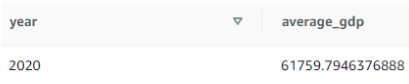
Resultaat van de derde query
Zoek de top 5 landen met het hoogste bbp in een specifiek jaar:
SELECT country_name, value
FROM gdp_data
WHERE year = 2020
ORDER BY value DESC
LIMIT 5;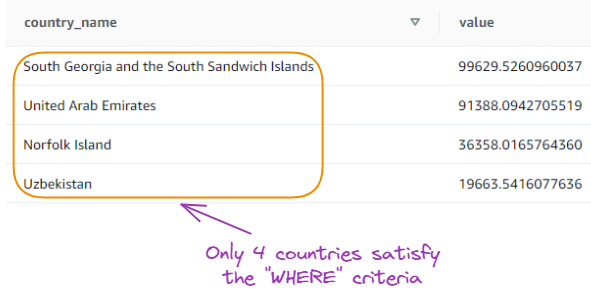
Resultaat van de vierde query
Tel het aantal records per jaar:
SELECT year, COUNT(*) as record_count
FROM gdp_data
GROUP BY year
ORDER BY year;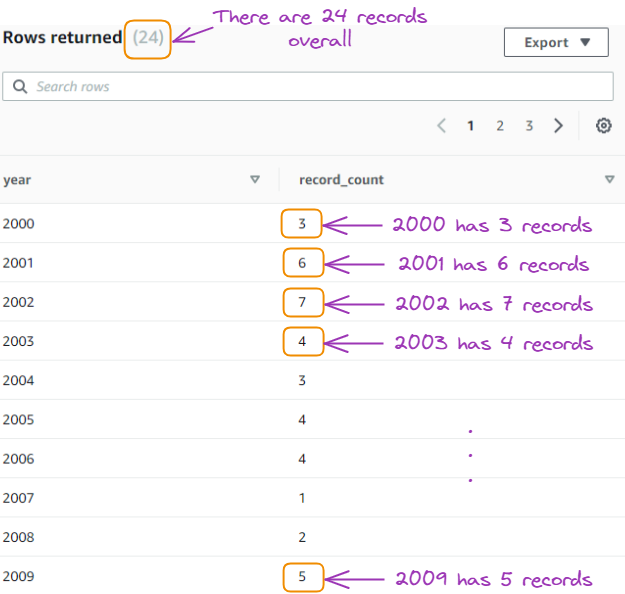
Resultaat van de vijfde query
De bovenstaande queries gaven een basisinzicht in de data, en deze sectie focust op drie geavanceerde querytechnieken.
Lopende som berekenen: deze query berekent de lopende som van bbp-waarden per land, gesorteerd op jaar.
SELECT
    country_name,
    year,
    value,
    SUM(value) OVER (PARTITION BY country_name ORDER BY year) as running_total
FROM gdp_data;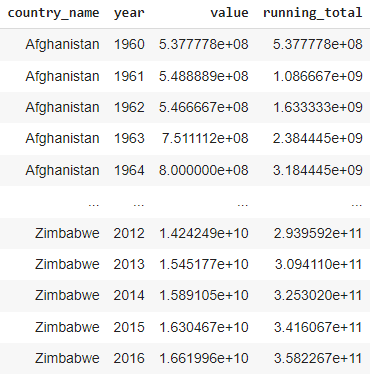
Resultaat van de lopende som
CTE’s voor filtering en aggregatie: deze query gebruikt een CTE om de data te filteren op records vanaf 2020 en berekent vervolgens de gemiddelde bbp-waarde per land.
WITH recent_data AS (
    SELECT
        country_name,
        year,
        value
    FROM gdp_data
    WHERE year >= 2020
)
SELECT
    country_name,
    AVG(value) as average_gdp
FROM gdp_data
GROUP BY country_name;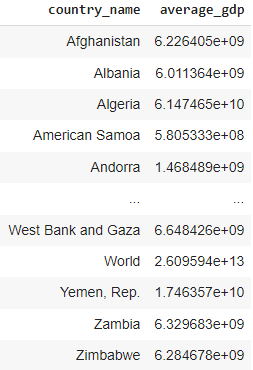
Resultaat van de CTE’s
Jaar-op-jaar bbp-groei berekenen: met deze query berekenen we de jaar-op-jaar bbp-groei per land.
SELECT
    a.country_name,
    a.year,
    a.value as current_year_value,
    b.value as previous_year_value,
    (a.value - b.value) / b.value * 100 as growth_percentage
FROM gdp_data a
JOIN gdp_data b
    ON a.country_name = b.country_name
    AND a.year = b.year + 1;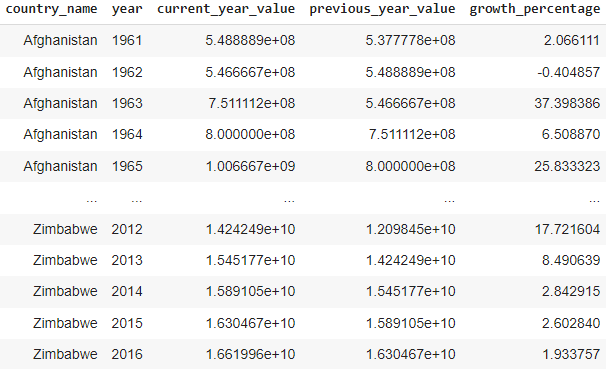
Resultaat van de self-joinquery
Om optimale prestaties en kostenefficiëntie te waarborgen, is het essentieel om de factoren die de performance van Redshift beïnvloeden te begrijpen en best practices te implementeren voor het tunen van ons cluster.
In deze sectie verkennen we de belangrijkste aspecten van onze Redshift-performancetuning en geven we inzichten op basis van de verstrekte clusterinformatie.
De performance van Amazon Redshift wordt beïnvloed door meerdere factoren, variërend van hardwareconfiguraties tot query-optimalisatietechnieken. Het begrijpen van deze factoren is cruciaal om knelpunten te identificeren en betere beslissingen te nemen om de prestaties van ons cluster te verbeteren.
We hebben een Redshift-cluster geconfigureerd dat bestaat uit twee ra3.4xlarge-nodes, en de gebruikte data is slechts 391 KB.
Bovendien laat de volgende afbeelding zien dat de CPU-belasting van ons cluster gedurende de hele periode dicht bij 0% blijft. Dit duidt erop dat het cluster niet zwaar wordt gebruikt en mogelijk overgeprovisioneerd is voor onze huidige workload.
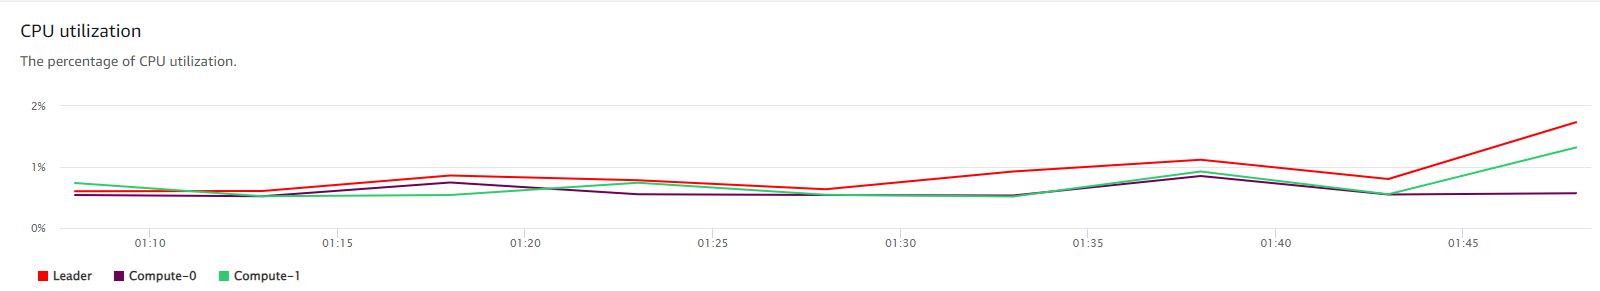
CPU-gebruik van ons cluster
Enkele belangrijke factoren die de performance van Redshift beïnvloeden zijn:
Om de prestaties van ons cluster te optimaliseren, is het belangrijk om best practices te volgen in tabelontwerp en databeheer. Zelfs met een kleine dataset kan het toepassen van deze praktijken een solide basis leggen voor toekomstige groei en performance-efficiëntie.
Regelmatige monitoring en onderhoud van het cluster zijn essentieel om optimale prestaties en kostenefficiëntie te waarborgen. De volgende afbeelding geeft een uitsplitsing van onze maandelijkse Redshift-kosten en laat kansen voor kostenoptimalisatie zien.
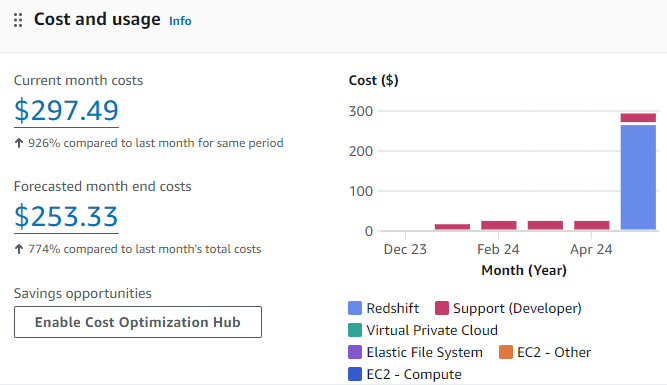
Kosten- en gebruiksgrafiek voor de huidige Redshift-usecase
Op basis van de bovenstaande afbeelding lijkt ons Redshift-cluster overgeprovisioneerd voor onze huidige kleine dataset, wat resulteert in lage benutting en inefficiënte kosten.
Met AWS-tools zoals Amazon CloudWatch en de AWS Management Console kunnen we belangrijke performancemetrics monitoren, waaronder CPU-belasting en queryprestaties. Deze inzichten helpen ons potentiële problemen te identificeren en datagedreven beslissingen te nemen voor clusteroptimalisatie.
Gezien de lage benutting van ons cluster kunnen we de volgende strategieën voor kostenoptimalisatie overwegen:
Naarmate het datavolume groeit en de workload evolueert, blijf je de performance van ons cluster monitoren en evalueer je onze instance-sizing en optimalisatiestrategieën opnieuw.
Bij het werken met gevoelige data in Amazon Redshift is het belangrijk om de hoogste normen voor security en compliance te waarborgen. Nu organisaties worden geconfronteerd met toenemende regelgeving en de noodzaak om gevoelige informatie te beschermen, worden het implementeren van robuuste beveiligingsmaatregelen en het naleven van compliance-richtlijnen cruciale aspecten van het beheer van ons Redshift-cluster.
Naleving van sectorspecifieke regelgeving en privacywetgeving is topprioriteit voor organisaties die met gevoelige data omgaan. Amazon Redshift biedt features en mogelijkheden die ons helpen om effectief aan deze compliancevereisten te voldoen.
Naast compliance-overwegingen is het implementeren van best practices voor databeveiliging in Amazon Redshift cruciaal om gevoelige informatie te beschermen tegen ongeautoriseerde toegang en potentiële datalekken.
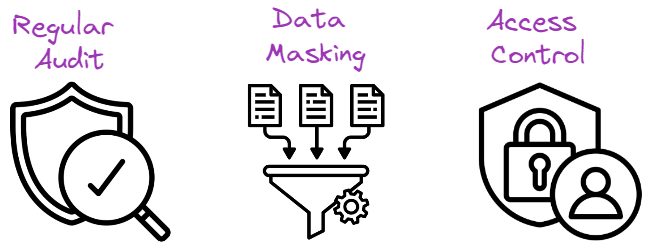
Best practices voor databeveiliging
Het uitvoeren van regelmatige security-audits is essentieel om kwetsbaarheden te identificeren, de effectiviteit van bestaande beveiligingsmaatregelen te beoordelen en continue naleving te garanderen. Overweeg de volgende auditpraktijken:
Datamasking is een techniek waarbij gevoelige data-elementen worden afgeschermd, terwijl de structuur en het formaat van de data behouden blijven. Door gevoelige informatie te maskeren, beschermen we deze tegen ongeautoriseerde toegang en behouden we dataprivacy. Hieronder enkele benaderingen voor masking in Amazon Redshift:
Het implementeren van sterke toegangscontrolemechanismen is cruciaal om te waarborgen dat alleen geautoriseerde personen toegang hebben tot gevoelige data in ons Amazon Redshift-cluster. Dergelijke mechanismen kunnen als volgt worden toegepast:
In dit artikel hebben we de basis en geavanceerde aspecten van het gebruik van Amazon Redshift voor datawarehousing verkend. We begonnen met het belang van datawarehousing en hoe Amazon Redshift een krachtige, schaalbare en kosteneffectieve oplossing biedt voor het analyseren van grote datasets met SQL.
Vervolgens hebben we het proces doorlopen van het opzetten van een Amazon Redshift-cluster, inclusief de vereisten, het aanmaken van het cluster en de configuratie-instellingen. Ook zijn we ingegaan op het laden van data in Redshift met AWS S3 en het COPY-commando, inclusief syntaxvoorbeelden en uitleg.
Daarnaast hebben we de essentie van het bevragen van data in Redshift behandeld, van basis-SQL-query’s tot geavanceerde technieken zoals windowfuncties en complexe joins. We bespraken ook performance tuning in Redshift, met best practices voor het optimaliseren van queryprestaties, zoals distributiestijlen, sort keys en compressie-encoding.
Tot slot hebben we het belang van security en compliance in Amazon Redshift benadrukt, met securityfeatures zoals encryptie en toegangsbeheer, evenals compliance-overwegingen.
Voor iedereen die zijn kennis en vaardigheden wil uitbreiden in het werken met Amazon Redshift en AWS, zijn de volgende DataCamp-resources de moeite waard:
Door Amazon Redshift te beheersen en de mogelijkheden optimaal te benutten, kunnen gebruikers waardevolle inzichten uit hun data ontsluiten en datagedreven beslissingen nemen.
Zet vandaag je data-engineeringreis voort!
Cursus
Leerpad
Leerpad
blog
Adel Nehme
15 min

