
कोर्स
डेटा इंजीनियरिंग को समझना
2 घंटा
375.1K
डेटा आधुनिक संगठनों की नींव है, लेकिन एकत्र और संग्रहीत की जा रही सूचनाओं की बड़ी मात्रा का प्रबंधन करना चुनौतीपूर्ण हो सकता है। सफलता की कुंजी इस डेटा को प्रभावी ढंग से व्यवस्थित और विश्लेषित करने में निहित है, ताकि मूल्यवान अंतर्दृष्टियाँ खोजी जा सकें जो सूचित निर्णय लेने को आगे बढ़ाती हैं।
यहीं पर डेटा वेयरहाउसिंग काम आता है। यह एक शक्तिशाली समाधान है जो व्यवसायों को अपने डेटा को समेकित और अनुकूलित करने में सक्षम बनाता है, ताकि कुशलतापूर्वक विश्लेषण किया जा सके। और डेटा वेयरहाउसिंग की बात हो तो AWS Redshift शीर्ष विकल्पों में से एक है।
इस लेख में, हम AWS Redshift के विवरणों का अन्वेषण करेंगे, साथ ही इसकी प्रमुख विशेषताएँ, लाभ, और सेटअप, डेटा लोडिंग, क्वेरी करना, प्रदर्शन ट्यूनिंग, सुरक्षा, और इंटीग्रेशन के लिए सर्वोत्तम प्रथाओं को भी कवर करेंगे।
चाहे आप डेटा प्रोफेशनल हों या कोई बिज़नेस लीडर जो अपने डेटा का अधिकतम लाभ उठाना चाहते हैं, यह लेख आपको AWS Redshift में सफल होने के लिए आवश्यक ज्ञान और टूल प्रदान करेगा।
डेटा वेयरहाउसिंग किसी संगठन के भीतर विभिन्न स्रोतों से बड़े पैमाने पर स्ट्रक्चर्ड डेटा को एकत्रित करने, संग्रहीत करने, और प्रबंधित करने की प्रक्रिया है।
डेटा वेयरहाउस का प्राथमिक लक्ष्य एक केंद्रीकृत रिपॉज़िटरी प्रदान करना है जिसे आसानी से एक्सेस, विश्लेषित, और रिपोर्टिंग तथा निर्णय लेने के उद्देश्यों के लिए उपयोग किया जा सके।
डेटा वेयरहाउस जटिल क्वेरी और डेटा विश्लेषण का समर्थन करने के लिए डिज़ाइन किए जाते हैं, जिससे व्यवसाय अपने डेटा से मूल्यवान अंतर्दृष्टियाँ प्राप्त कर सकें।
डेटा वेयरहाउस अपनाने से संगठनों को कई महत्वपूर्ण लाभ मिल सकते हैं:
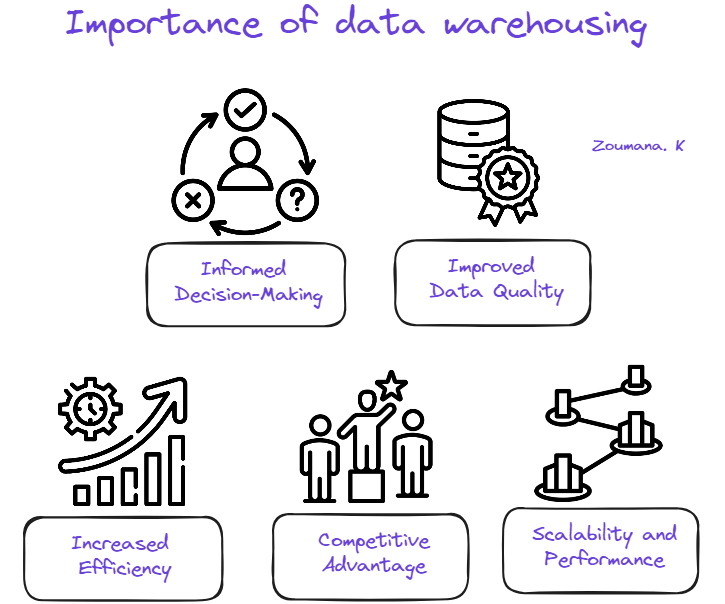
डेटा वेयरहाउसिंग का महत्व
AWS Redshift एक पूर्ण-प्रबंधित, क्लाउड-आधारित डेटा वेयरहाउसिंग सेवा है जो पेटाबाइट-स्तरीय डेटासेट्स के संग्रहण और विश्लेषण की अनुमति देती है। AWS Redshift Serverless के साथ, उपयोगकर्ता बिना किसी प्राविज़न्ड डेटा वेयरहाउस को मैन्युअली कॉन्फ़िगर किए डेटा तक पहुँच और उसका विश्लेषण कर सकते हैं।
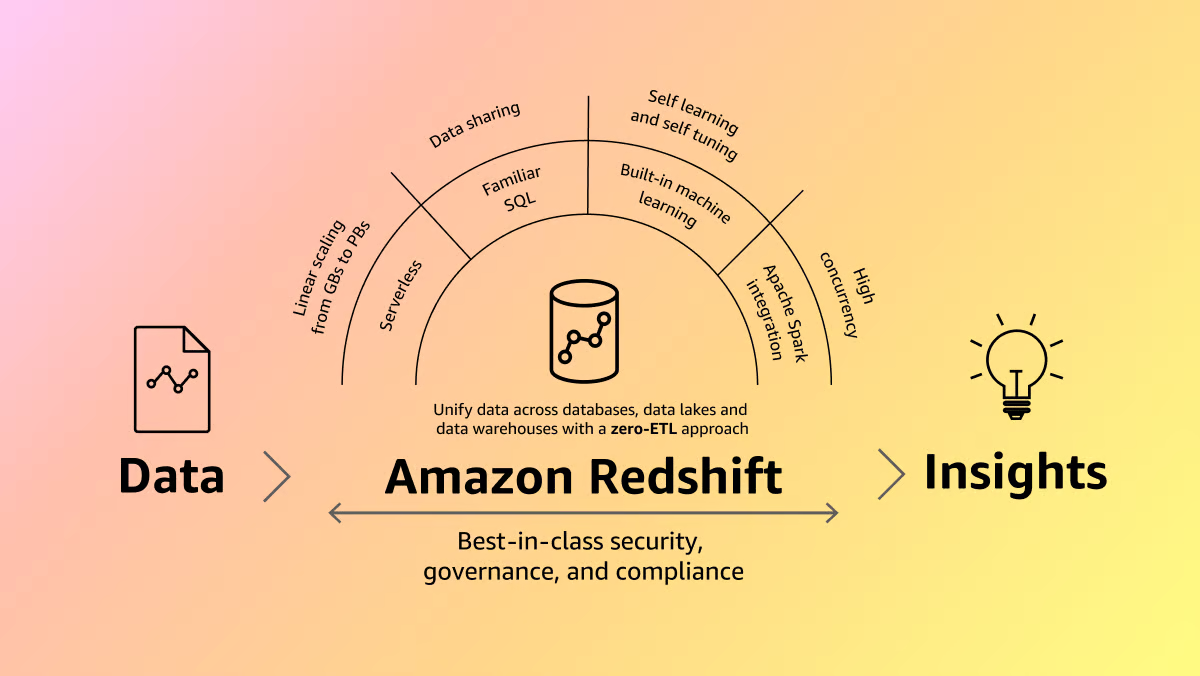
Amazon Redshift (Source)
यह सेवा स्वचालित रूप से संसाधन प्रावधान करती है और सबसे अधिक मांग वाले और अप्रत्याशित वर्कलोड के लिए भी तेज़ प्रदर्शन सुनिश्चित करने हेतु डेटा वेयरहाउस क्षमता को बुद्धिमानी से स्केल करती है। उपयोगकर्ता केवल उपयोग किए गए संसाधनों के लिए भुगतान करते हैं, क्योंकि डेटा वेयरहाउस के निष्क्रिय रहने पर कोई शुल्क नहीं लगता।
AWS Redshift उपयोगकर्ताओं को Amazon Redshift query editor v2 या उनकी पसंद के बिज़नेस इंटेलिजेंस (BI) टूल का उपयोग करके तुरंत डेटा लोड करने और क्वेरी शुरू करने में सक्षम बनाता है। सेवा एक आसान, शून्य-प्रशासन वातावरण में सर्वोत्तम मूल्य-प्रदर्शन और परिचित SQL सुविधाएँ प्रदान करती है।
डेटासेट के आकार की परवाह किए बिना, AWS Redshift आज आमतौर पर उपयोग किए जाने वाले वही SQL-आधारित टूल्स और बिज़नेस इंटेलिजेंस एप्लिकेशन के जरिए तेज़ क्वेरी प्रदर्शन देता है।
AWS Redshift संगठनों को बड़े पैमाने पर डेटा को कुशलतापूर्वक संग्रहीत, प्रबंधित, और विश्लेषित करने में मदद करने के लिए कई विशेषताएँ और लाभ प्रदान करता है। कुछ प्रमुख विशेषताएँ और लाभ नीचे दर्शाए गए हैं:
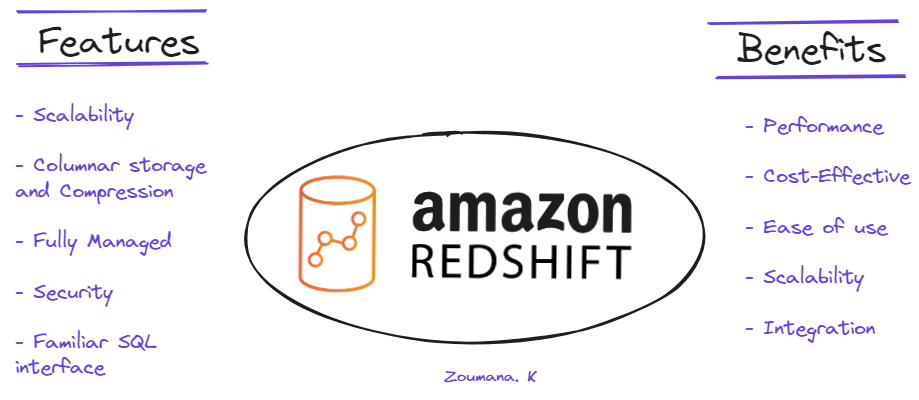
AWS Redshift की विशेषताएँ और लाभ
पिछले अनुभाग मुख्य रूप से Redshift की समग्र समझ पर केंद्रित थे। अब, हम तकनीकी पहलुओं का अन्वेषण करेंगे।
यह अनुभाग पहले AWS Redshift को सफलतापूर्वक सेटअप करने के लिए मुख्य पूर्वापेक्षाएँ दर्शाता है, फिर Redshift क्लस्टर बनाने की चरण-दर-चरण प्रक्रिया बताता है। अंतिम भाग नोड प्रकार, नोड की संख्या, और सुरक्षा कॉन्फ़िगरेशन जैसे प्रमुख क्लस्टर सेटिंग्स की विस्तृत व्याख्या पर केंद्रित है।
उपयोग-केस के विवरण में जाने से पहले, आइए सफल इम्प्लीमेंटेशन के लिए आवश्यक पूर्वापेक्षाएँ देख लें:
यह अनुभाग AWS Management Console के माध्यम से 11 सरल चरणों में Redshift क्लस्टर बनाने के सभी कदम प्रदान करता है, जैसा कि नीचे दर्शाया गया है:
1. कंसोल से Redshift खोजें, और “Amazon Redshift” चुनें:
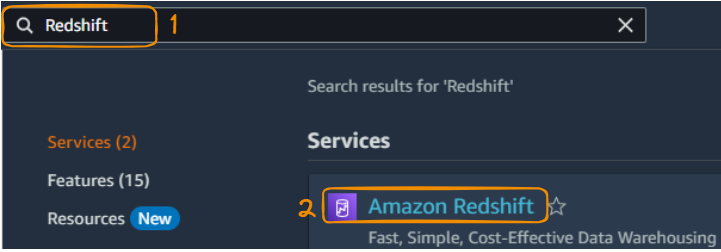
Management Console से Redshift खोजें और चुनें
2. क्लस्टर बनाना शुरू करने के लिए “Create Cluster” बटन चुनें।
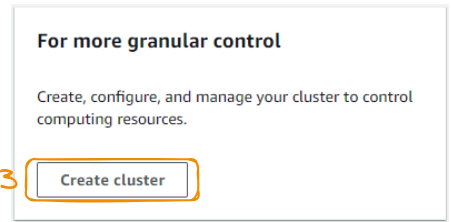
Create cluster बटन
3. उपर्युक्त कार्रवाई से, हम क्लस्टर आइडेंटिफ़ायर, क्लस्टर का आकार, नोड प्रकार, उपलब्धता ज़ोन का चुनाव, नोड्स की संख्या जैसी जानकारी देकर क्लस्टर को कॉन्फ़िगर कर सकते हैं।
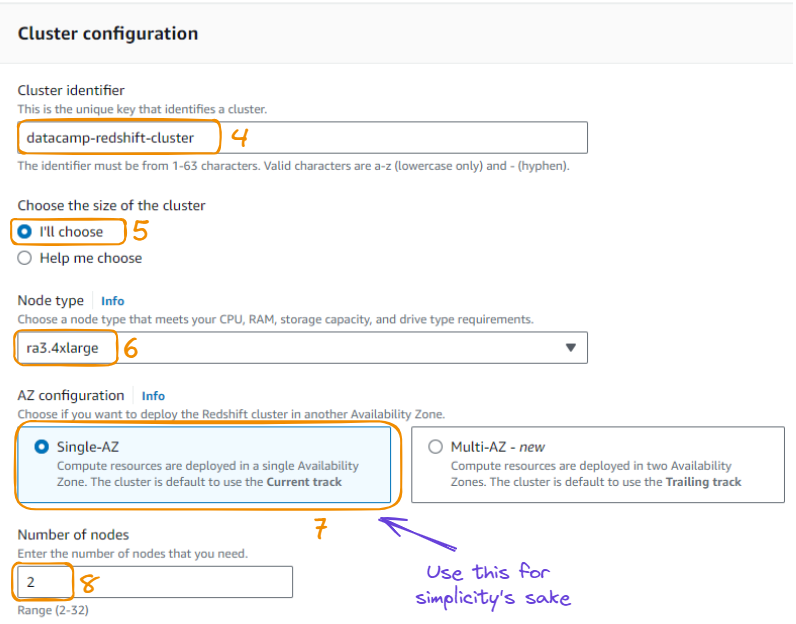
8 चरणों में क्लस्टर कॉन्फ़िगरेशन
4. ऊपर वाली ही पेज पर सुझाए गए सैंपल डेटा के बजाय, हम Redshift में डेटा लोड करने के लिए S3 बकेट से डेटा का उपयोग कर रहे हैं।
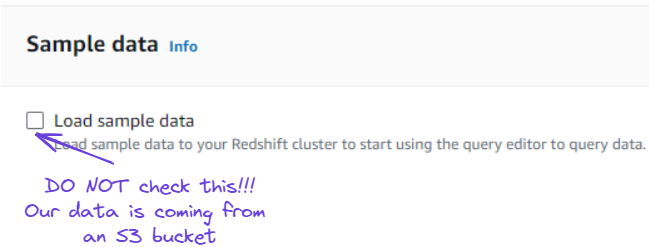
सैंपल डेटा लोडिंग विकल्प को अनदेखा करें
5. हमारे पास IAM रोल्स प्रदान करके क्लस्टर्स की परमिशन परिभाषित करने का विकल्प है। इस सेक्शन को अभी अनदेखा किया जा सकता है और आगे जाकर निपटाया जा सकता है।
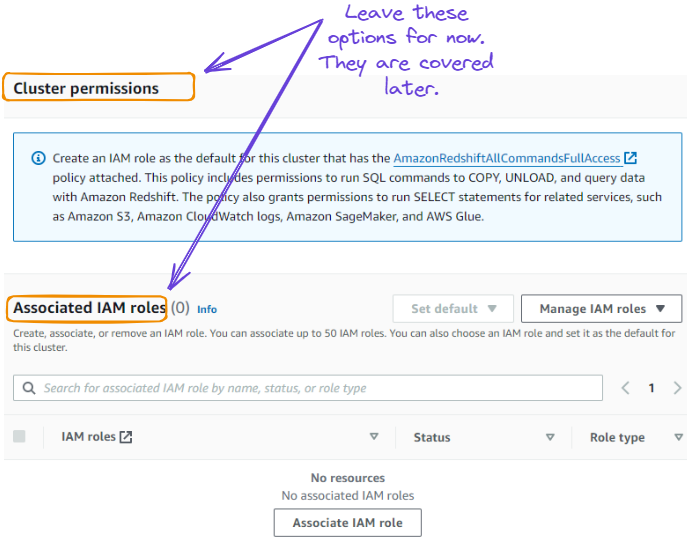
क्लस्टर परमिशन और IAM रोल्स को अनदेखा करें
6. नेटवर्क, सुरक्षा, बैकअप, मेंटेनेंस के लिए डिफ़ॉल्ट कॉन्फ़िगरेशन ही रहने दें, और क्लस्टर बनाने के लिए “Create cluster” बटन चुनें।
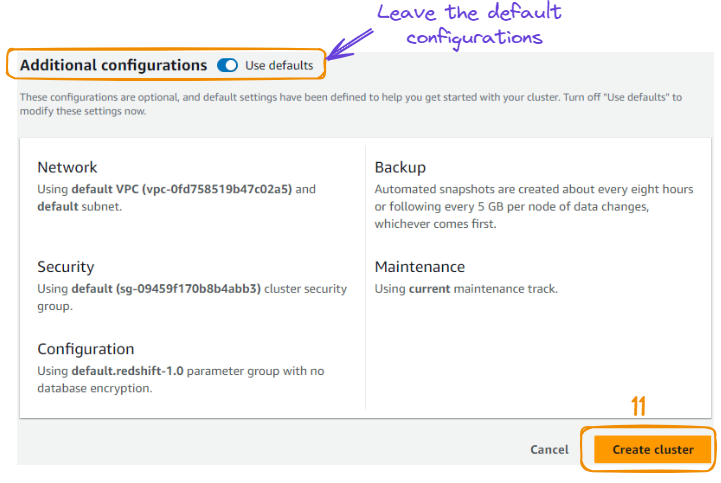
क्लस्टर का निर्माण
7. उपर्युक्त कार्रवाई के बाद, हमें नए बनाए गए क्लस्टर को दिखाने वाले नए पेज पर रीडायरेक्ट कर दिया जाता है। क्लस्टर को सफलतापूर्वक बनने में कुछ मिनट लग सकते हैं, और इसे “Status” सेक्शन में देखा जा सकता है, जो पहले “Creating” और बाद में “Available” होता है।
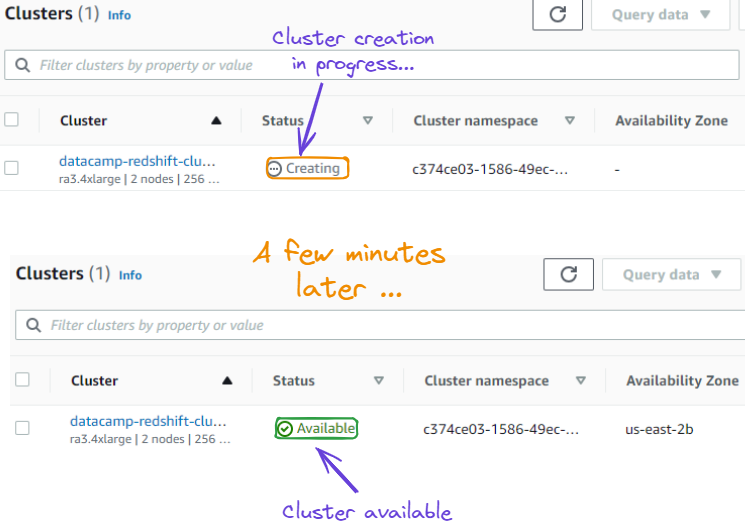
“Creating” से “Available” तक क्लस्टर की स्थिति
अब हमने अपने Redshift क्लस्टर्स सफलतापूर्वक बना लिए हैं। यह अनुभाग आपको हमारे DataLab पर उपलब्ध Country, Regional, और World GDP (सकल घरेलू उत्पाद) डेटासेट चुनने से लेकर उसे S3 बकेट में अपलोड करने तक के सभी चरणों से मार्गदर्शन करेगा।
हमारा डेटा मूल रूप से World Bank डेटासेट से लिया गया है। यह देशों, क्षेत्रों और विश्व का GDP है, जिसे वर्तमान अमेरिकी डॉलर ($) में मापा गया है। क्षेत्र (Regions) से तात्पर्य देशों के समूहों से है, जैसे यूरोप और सेंट्रल एशिया।
डेटा के पहले दस ऑब्ज़र्वेशंस इस प्रकार दिखते हैं:
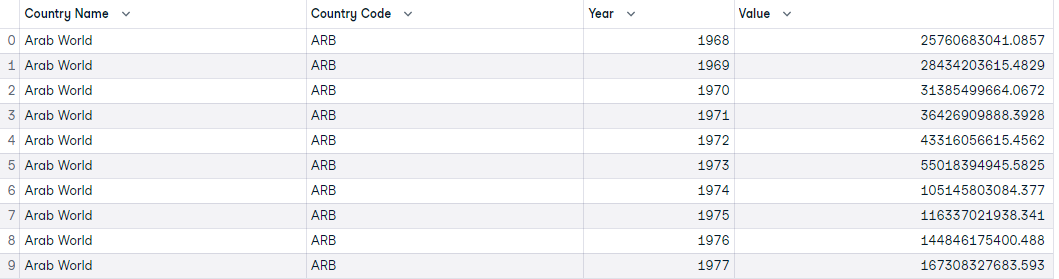
GDP डेटा के पहले दस ऑब्ज़र्वेशंस
S3 और Redshift के बीच सफल इंटरेक्शन के लिए हमें पहले डेटा स्टोर करने के लिए S3 बकेट बनाने से पहले एक IAM रोल बनाना होगा।
IAM रोल बनाने का लाभ यह है कि यह हमारे Redshift क्लस्टर और उस S3 बकेट के बीच कनेक्शन बनाता है जहाँ डेटा रहता है।
IAM रोल बनाना इस प्रकार किया जाता है:
Management Console से “IAM” खोजें और सर्च परिणाम से “IAM” लोगो चुनें।
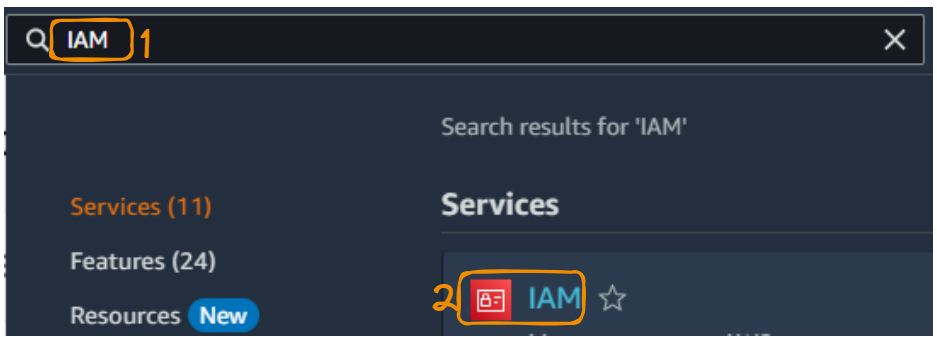
Management Console से IAM सेवा
“Roles” चुनें ताकि सभी संभावित रोल दिखाई दें, और नया रोल बनाने के लिए “Create role” चुनें।
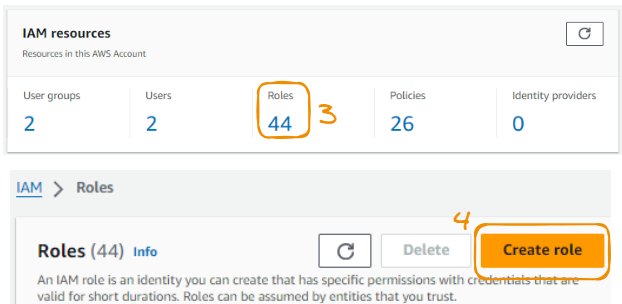
नया रोल बनाना शुरू करें
“Trusted entity type” में “AWS service” चुनें, फिर “Use case” के रूप में “Redshift” चुनें, और जारी रखने के लिए “Next” चुनें।
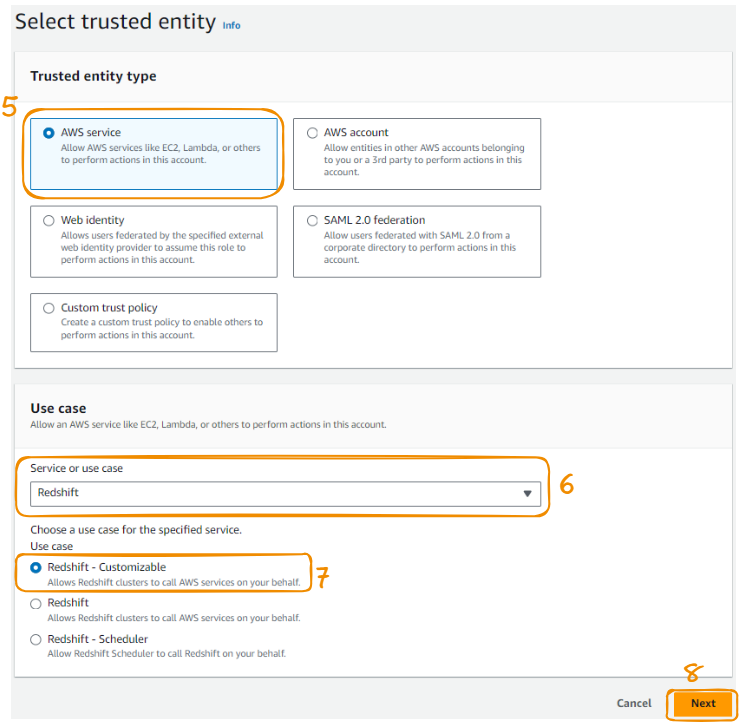
AMI रोल निर्माण के चरण 5 से 8
सर्च टैब से “S3FullAccess” ढूँढें, फिर विकल्प को चेक करें और “Next” चुनें।
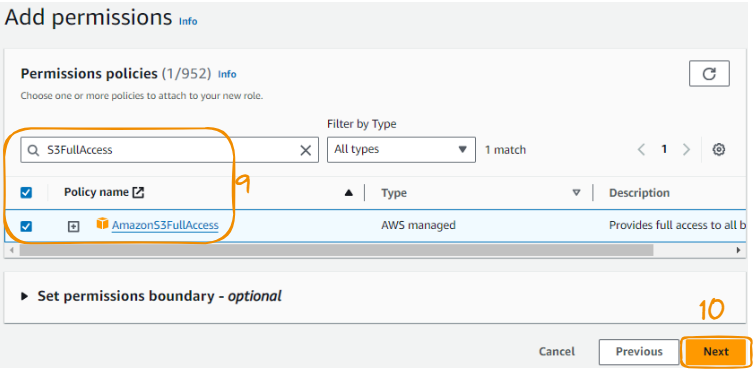
AMI रोल निर्माण के चरण 9 से 10
अंत में, रोल का नाम दें, समीक्षा करें, और निर्माण को अंतिम रूप देने के लिए “Create role” बटन चुनें।
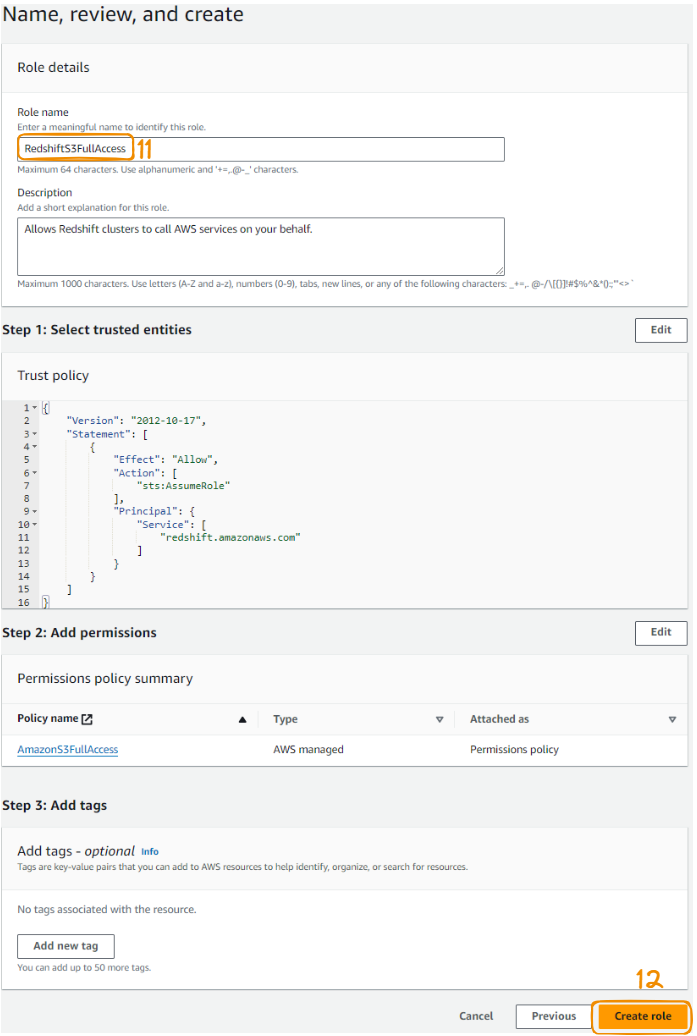
AMI रोल निर्माण के चरण 11 से 12
सब कुछ सफल होने पर, नीचे दिखाया गया हरा संदेश शीर्ष कोने में दिखाई देता है जो रोल निर्माण की पुष्टि करता है।
रोल निर्माण की पुष्टि संदेश
अब जबकि हमारे पास IAM रोल है, इसे प्रारंभ में बनाए गए Redshift क्लस्टर से लिंक करने के लिए इस्तेमाल किया जा सकता है, और यह इस प्रकार किया जा सकता है:
क्लस्टर्स सेक्शन से, बनाए गए datacamp क्लस्टर का चयन करें, और “Actions” सेक्शन के अंतर्गत “Manage IAM roles” चुनें।
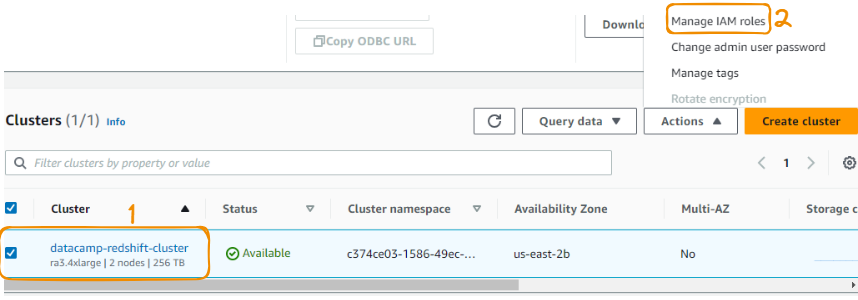
Redshift से IAM रोल लिंक करने के चरण 1 से 2
इस सेक्शन के अंतर्गत, पहले से बनाए गए IAM रोल को चुनें और बदलाव सहेजें।
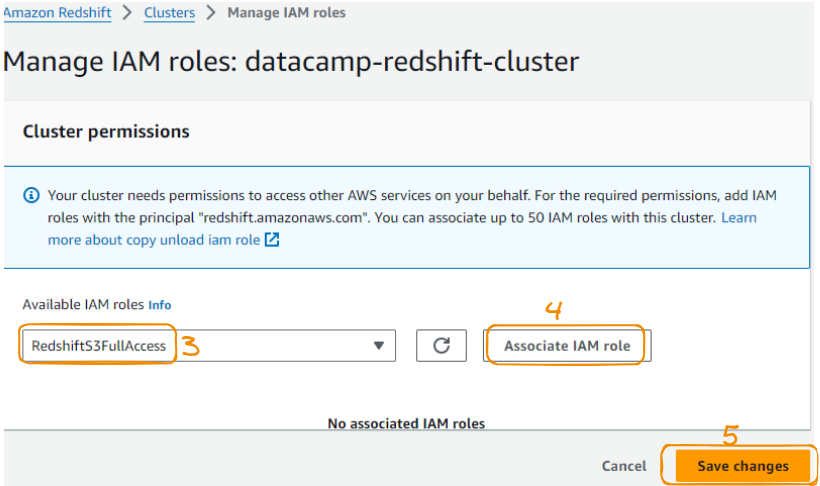
Redshift से IAM रोल लिंक करने के चरण 3 से 4
Redshift से डेटा क्वेरी करने के लिए कई टूल्स का उपयोग किया जा सकता है। इनमें से कुछ AWS सेवाओं का हिस्सा होते हैं और कुछ बाहरी होते हैं। इस ट्यूटोरियल के दायरे में हम Redshift डैशबोर्ड के क्वेरी एडिटर का उपयोग कर रहे हैं।
इसे उपयोग करने के लिए, हमें पहले “Query data” टैब से “Query in query editor” विकल्प से शुरू करते हुए Query editor से कनेक्शन बनाना होगा, इस प्रकार:
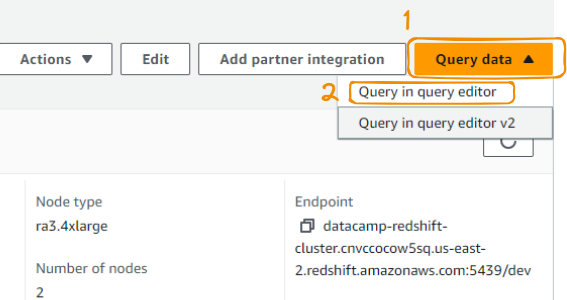
Query data से Query editor
उपर्युक्त कार्रवाई निम्न पेज पर ले जाती है, जहाँ हम उसे नाम देकर और एक यूज़रनेम प्रदान करके डेटाबेस से कनेक्ट कर सकते हैं, इस प्रकार:
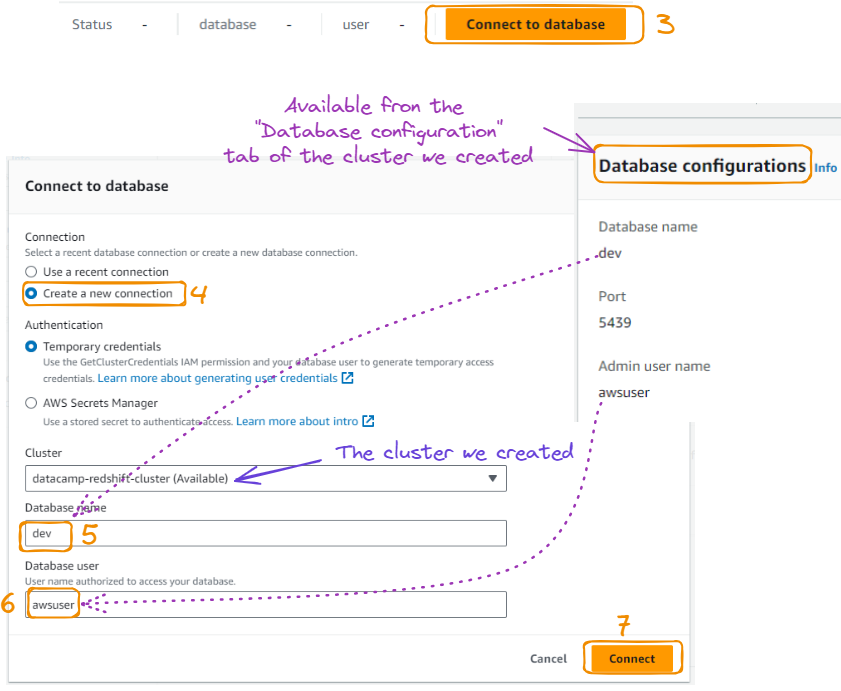
Query editor से डेटाबेस कनेक्शन
“Connect” बटन दबाने के बाद, हम शीर्ष पर हरा “Connected” टैब और बाएँ ओर डेटाबेस जानकारी देख सकते हैं।
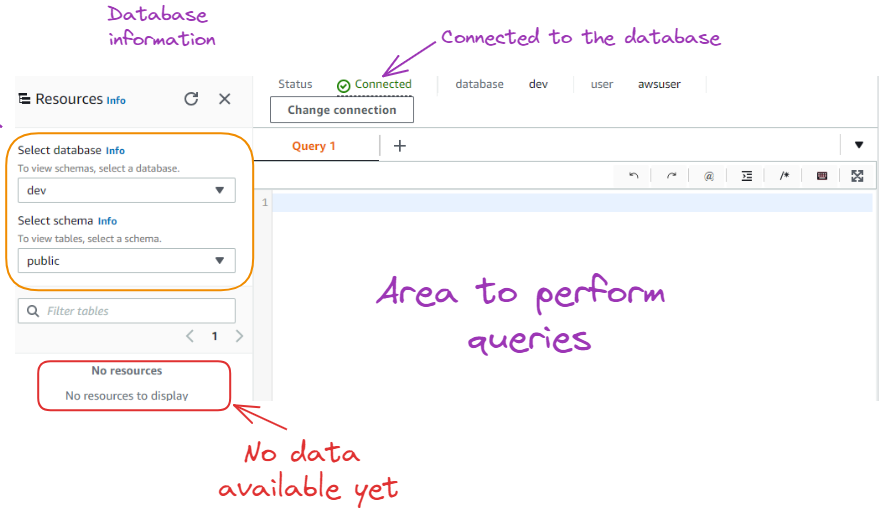
डेटाबेस से कनेक्ट होने के बाद का परिणाम
जैसा कि ऊपर देखा जा सकता है, अभी डेटाबेस में कोई संसाधन/डेटा उपलब्ध नहीं है। डेटा इम्पोर्ट करने से पहले, हमें पहले उसी विशेषताओं वाली एक टेबल बनानी होगी जैसा कि इम्पोर्ट किए जा रहे डेटा में है।
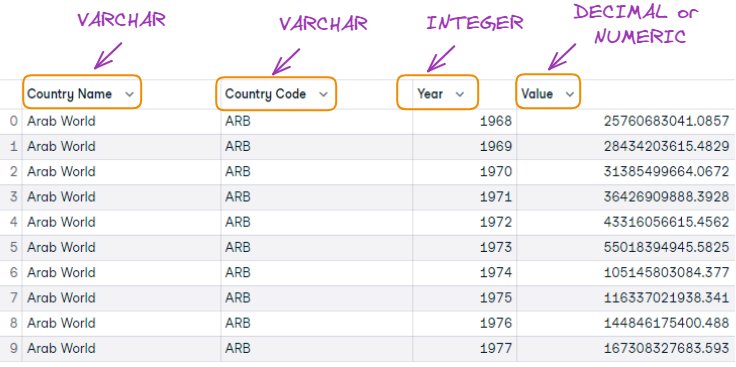
पहले 10 ऑब्ज़र्वेशंस और टेबल कॉलम फ़ॉर्मैट का मिलान
टेबल निम्न SQL क्वेरी का उपयोग करके बनाई जाती है:
CREATE TABLE gdp_data (
id INTEGER PRIMARY KEY,
country_name VARCHAR(255),
country_code VARCHAR(10),
year INTEGER,
value DECIMAL(20,2)
);
यहाँ प्रत्येक कॉलम के लिए एक बुलेट पॉइंट में SQL क्वेरी की व्याख्या दी गई है:
id INTEGER PRIMARY KEY: "id" नाम का कॉलम बनाता है जिसका डेटा प्रकार INTEGER है और इसे टेबल का प्राइमरी की सेट करता है, जिससे प्रत्येक पंक्ति के लिए मान अद्वितीय रहते हैं।country_name VARCHAR(255): "country_name" नाम का कॉलम बनाता है जिसका डेटा प्रकार VARCHAR है, जो अधिकतम 255 वर्णों के स्ट्रिंग्स संग्रहीत कर सकता है।country_code VARCHAR(10): "country_code" नाम का कॉलम बनाता है जिसका डेटा प्रकार VARCHAR है, जो अधिकतम 10 वर्णों के स्ट्रिंग्स संग्रहीत कर सकता है।year INTEGER: "year" नाम का कॉलम बनाता है जिसका डेटा प्रकार INTEGER है, जो पूर्णांक (इस मामले में वर्ष) संग्रहीत करने के लिए उपयुक्त है।value DECIMAL(20,2): "value" नाम का कॉलम बनाता है जिसका डेटा प्रकार DECIMAL है, जो 20 अंकों की प्रिसीजन और 2 दशमलव स्थानों के साथ दशमलव संख्याएँ संग्रहीत कर सकता है।अब, हम टेबल बनाने के लिए क्वेरी चलाते हैं:
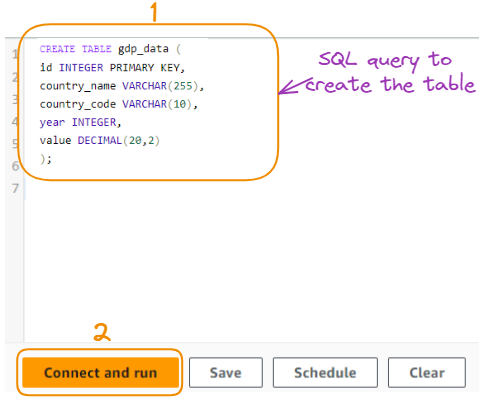
टेबल बनाने की क्वेरी
यह क्वेरी नीचे दिखाए अनुसार निर्दिष्ट कॉलमों के साथ "gdp_data" नाम की टेबल बनाती है ताकि GDP डेटा संग्रहीत किया जा सके:
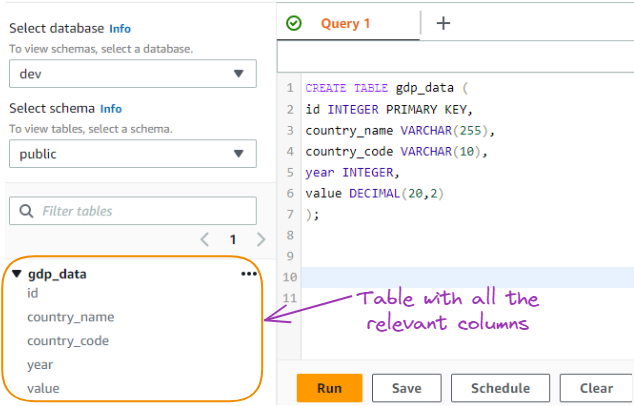
SQL क्वेरी से बनाई गई GDP डेटा टेबल
डेटा S3 बकेट से टेबल में इम्पोर्ट किया जाएगा। इस अनुभाग में हम बकेट बनाने और डेटा अपलोड करने के सभी चरण कवर करते हैं।
Management Console से S3 सेवा ढूँढें, संबंधित लोगो चुनें, और इसे नाम दें, बाकी सब कुछ डिफ़ॉल्ट ही रहने दें:
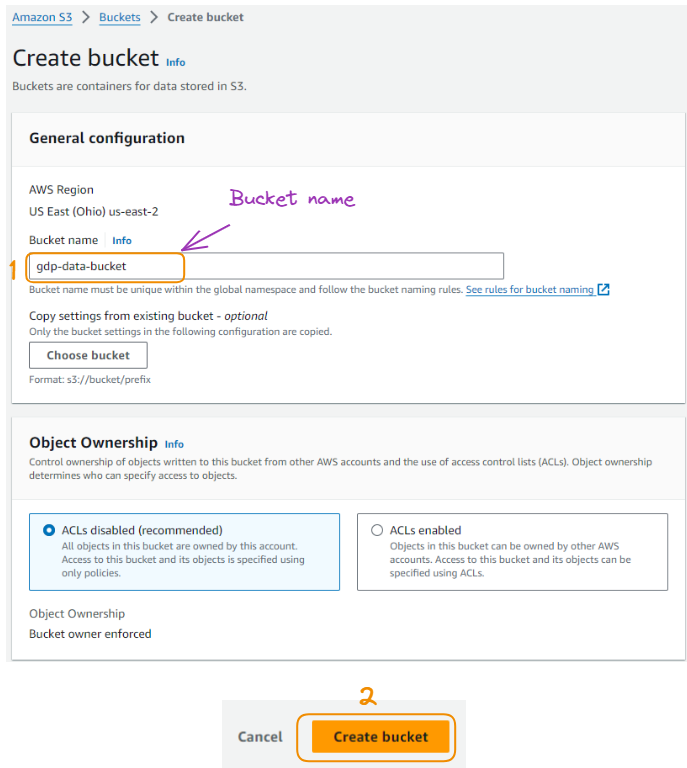
S3 बकेट निर्माण
एक बार बकेट बन जाने पर, यह पहले बनाए गए सभी बकेट्स की सूची में उपलब्ध हो जाता है।
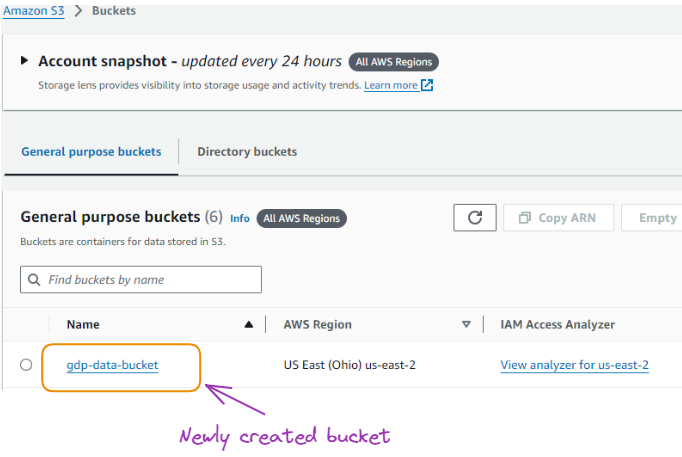
नया बनाया गया बकेट
वहाँ से हम बकेट नाम चुन सकते हैं, और स्थानीय रूप से डाउनलोड किए गए GDP डेटा को CSV फ़ॉर्मैट में अपलोड कर सकते हैं।
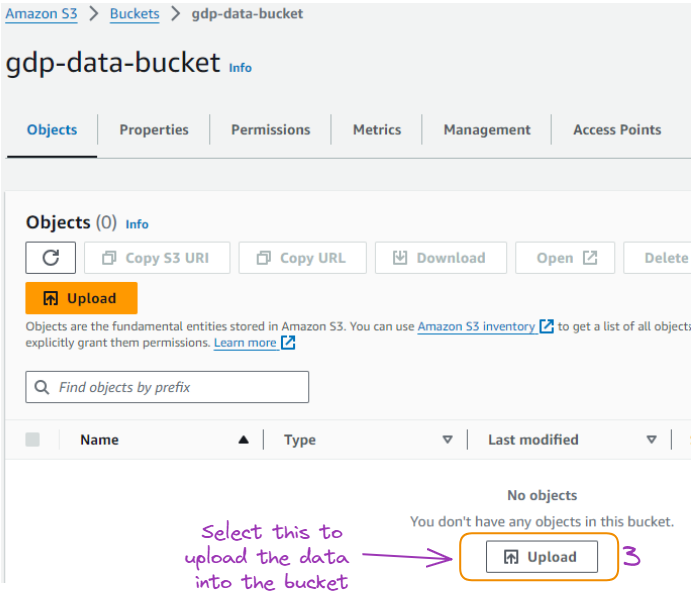
बकेट में डेटा अपलोड करने का पेज
डेटा सफलतापूर्वक इम्पोर्ट होने के बाद, यह नीचे दिखाए अनुसार उपलब्ध हो जाता है:
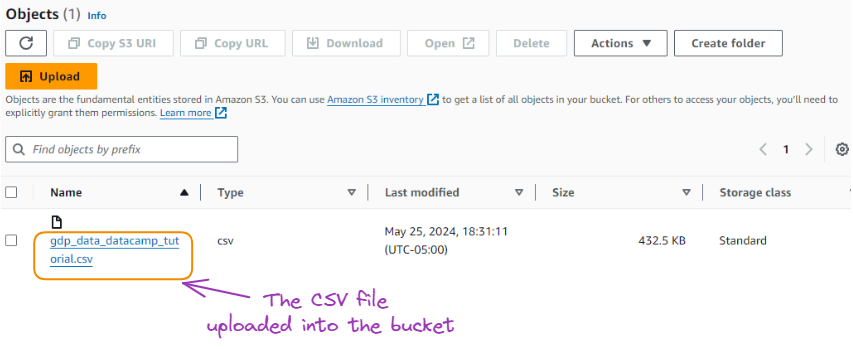
बकेट में अपलोड किया गया CSV
यहाँ तक पहुँचने के लिए बधाई!
यह अनुभाग नीचे दिए अनुसार S3 से Redshift में डेटा कॉपी करने का तरीका दर्शाता है।
COPY gdp_data (id, country_name, country_code, year, value)
FROM 's3://gdp-data-bucket/gdp/gdp_data.csv'
IAM_ROLE 'arn:aws:iam::654654631565:role/RedshiftS3FullAccess'
CSV
IGNOREHEADER 1;
आइए समझते हैं कि यहाँ क्या हो रहा है:
एडिटर से वही कोड नीचे दिया गया है, और कुछ सेकंड बाद कॉपी ऑपरेशन सफलतापूर्वक पूरा हो गया:
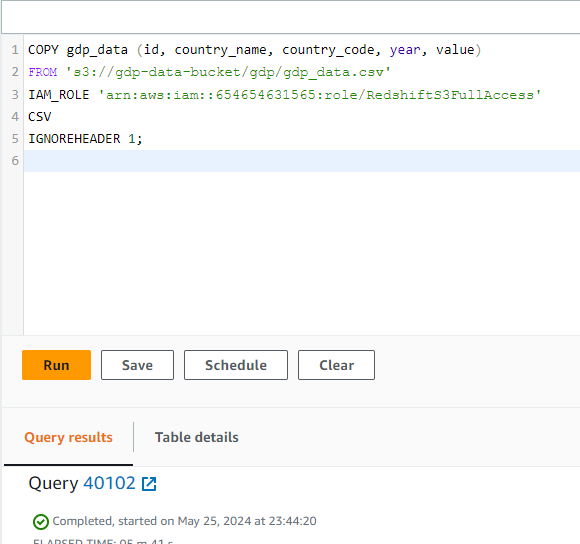
COPY कार्य पूर्ण
सरलता के लिए, मूल CSV से सारा डेटा अपलोड करने के बजाय केवल सौ रैंडम ऑब्ज़र्वेशंस का सैंपल अपलोड किया गया। हम “Preview data” विकल्प चुनकर डेटा का प्रीव्यू देख सकते हैं, इस प्रकार:
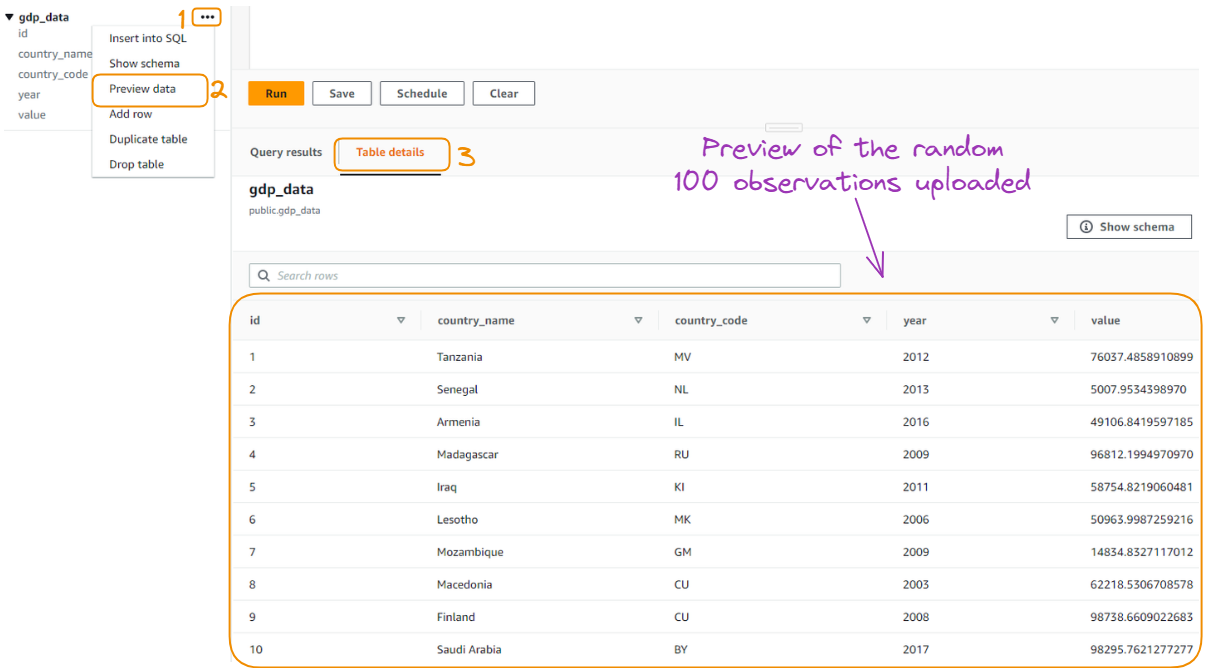
रैंडमली अपलोड किए गए 100 ऑब्ज़र्वेशंस का प्रीव्यू
डेटा का प्रीव्यू लेना केवल पहले दस ऑब्ज़र्वेशंस दिखाता है। हालाँकि, हमें अधिक अंतर्दृष्टि पाने के लिए अपने डेटा के साथ अधिक इंटरेक्ट करने की आवश्यकता हो सकती है—यहीं SQL कौशल उपयोगी साबित होते हैं।
इस अनुभाग में, हम कुछ SQL क्वेरी के माध्यम से डेटा का अन्वेषण करते हैं।
हम अपने डेटाबेस में संग्रहीत डेटा के साथ इंटरेक्ट करने के लिए पाँच SQL क्वेरी का उपयोग कर रहे हैं, सबसे सामान्य क्वेरी से शुरू करते हुए: डेटा का चयन करना।
सारा डेटा चुनें
SELECT *
FROM gdp_data;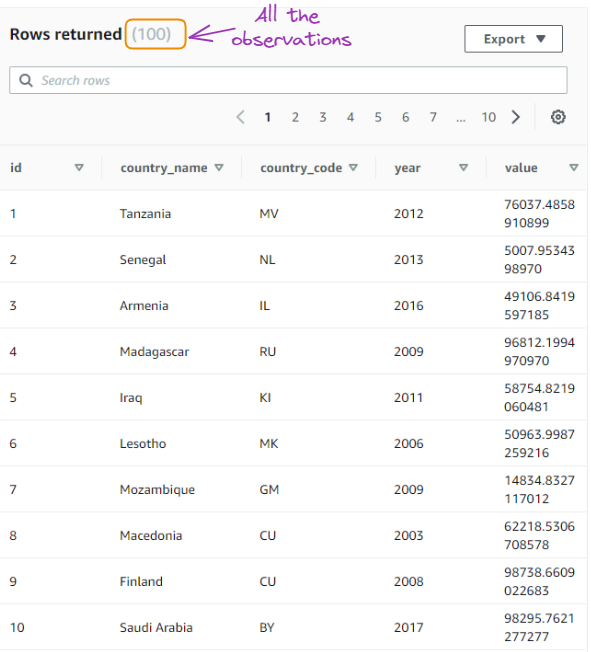
पहली क्वेरी का परिणाम
किसी विशिष्ट देश के लिए डेटा चुनें:
SELECT * FROM gdp_data
WHERE country_name = 'Senegal';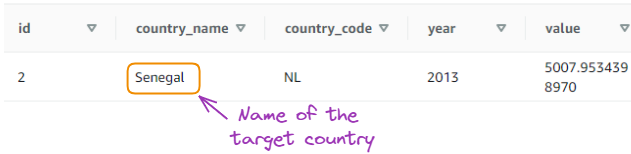
दूसरी क्वेरी का परिणाम
किसी विशिष्ट वर्ष के लिए औसत GDP मान की गणना करें:
SELECT year, AVG(value) as average_gdp
FROM gdp_data
WHERE year = 2020
GROUP BY year;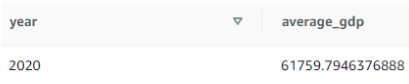
तीसरी क्वेरी का परिणाम
किसी विशिष्ट वर्ष में सर्वाधिक GDP वाले शीर्ष 5 देशों को खोजें:
SELECT country_name, value
FROM gdp_data
WHERE year = 2020
ORDER BY value DESC
LIMIT 5;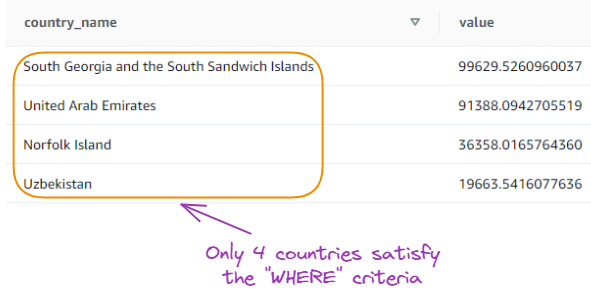
चौथी क्वेरी का परिणाम
प्रति वर्ष रिकॉर्ड की संख्या गिनें:
SELECT year, COUNT(*) as record_count
FROM gdp_data
GROUP BY year
ORDER BY year;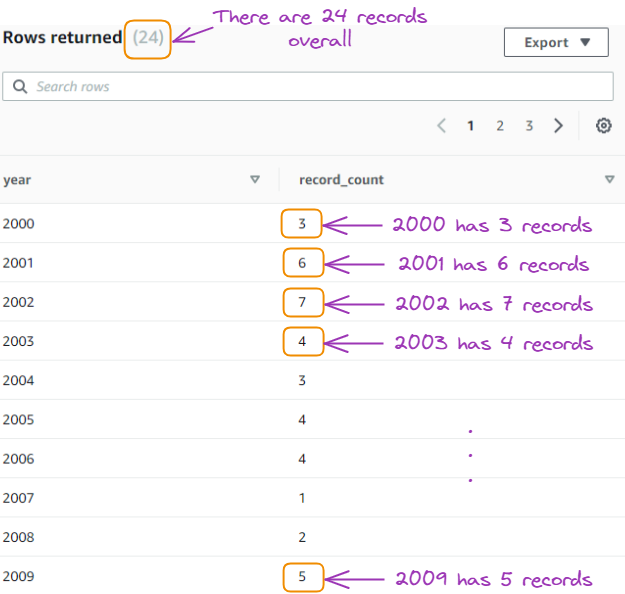
पाँचवीं क्वेरी का परिणाम
उपर्युक्त क्वेरी ने डेटा की बुनियादी समझ प्रदान की, और यह अनुभाग तीन उन्नत क्वेरी तकनीकों को कवर करने पर केंद्रित है।
रनिंग टोटल की गणना: यह क्वेरी प्रत्येक देश के लिए वर्ष के अनुसार ऑर्डर कर के GDP मानों का रनिंग टोटल गणना करती है।
SELECT
    country_name,
    year,
    value,
    SUM(value) OVER (PARTITION BY country_name ORDER BY year) as running_total
FROM gdp_data;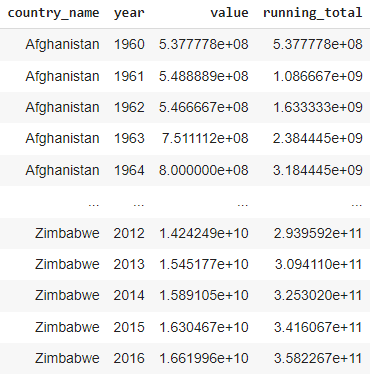
रनिंग टोटल का परिणाम
फ़िल्टरिंग और एग्रीगेशन के लिए CTEs: यह क्वेरी CTE का उपयोग करके डेटा को 2020 से आगे के रिकॉर्ड तक फ़िल्टर करती है और फिर प्रत्येक देश के लिए औसत GDP मान की गणना करती है।
WITH recent_data AS (
    SELECT
        country_name,
        year,
        value
    FROM gdp_data
    WHERE year >= 2020
)
SELECT
    country_name,
    AVG(value) as average_gdp
FROM gdp_data
GROUP BY country_name;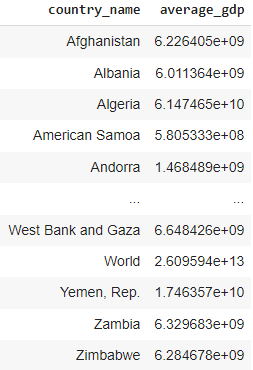
CTEs से प्राप्त परिणाम
वर्ष-दर-वर्ष GDP वृद्धि की गणना: इस क्वेरी के साथ, हम प्रत्येक देश के लिए वर्ष-दर-वर्ष GDP वृद्धि की गणना करते हैं।
SELECT
    a.country_name,
    a.year,
    a.value as current_year_value,
    b.value as previous_year_value,
    (a.value - b.value) / b.value * 100 as growth_percentage
FROM gdp_data a
JOIN gdp_data b
    ON a.country_name = b.country_name
    AND a.year = b.year + 1;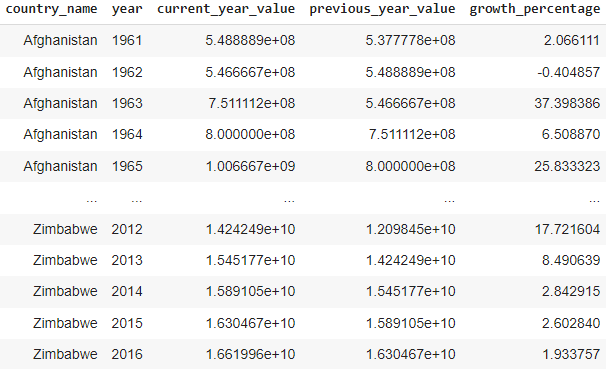
सेल्फ-जॉइन क्वेरी का परिणाम
इष्टतम प्रदर्शन और लागत-प्रभावशीलता सुनिश्चित करने के लिए, Redshift के प्रदर्शन को प्रभावित करने वाले कारकों को समझना और अपने क्लस्टर के लिए सर्वोत्तम प्रथाओं को लागू करना आवश्यक है।
इस अनुभाग में, हम अपने Redshift प्रदर्शन ट्यूनिंग के प्रमुख पहलुओं का अन्वेषण करेंगे और दिए गए क्लस्टर सूचना के आधार पर अंतर्दृष्टियाँ प्रदान करेंगे।
Amazon Redshift में प्रदर्शन कई कारकों से प्रभावित होता है, जो हार्डवेयर कॉन्फ़िगरेशन से लेकर क्वेरी अनुकूलन तकनीकों तक फैले होते हैं, इसलिए इन कारकों को समझना बाधाओं की पहचान करने और अपने क्लस्टर के प्रदर्शन को बेहतर बनाने के लिए बेहतर निर्णय लेने में महत्वपूर्ण है।
हमने दो ra3.4xlarge नोड्स वाला एक Redshift क्लस्टर कॉन्फ़िगर किया है, और उपयोग किया जा रहा डेटा केवल 391 KB है।
साथ ही, निम्न छवि से पता चलता है कि हमारे क्लस्टर का CPU उपयोग पूरे समय के दौरान 0% के करीब बना रहता है, जो इंगित करता है कि क्लस्टर का भारी उपयोग नहीं हो रहा है और वर्तमान वर्कलोड के लिए संभवतः अधिक-प्राविज़न्ड है।
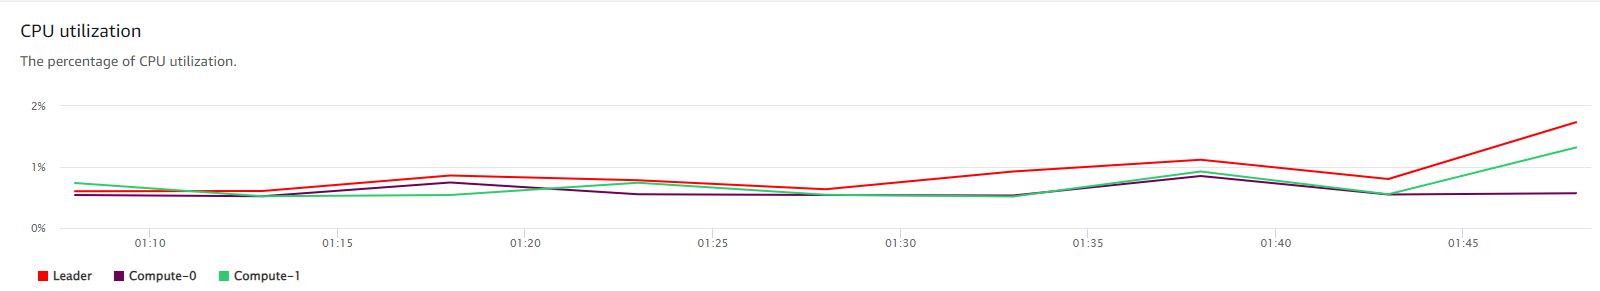
हमारे क्लस्टर का CPU उपयोग
Redshift के प्रदर्शन को प्रभावित करने वाले कई प्रमुख कारकों में शामिल हैं:
अपने क्लस्टर के प्रदर्शन को अनुकूलित करने के लिए, टेबल डिज़ाइन और डेटा प्रबंधन में सर्वोत्तम प्रथाओं का पालन करना महत्वपूर्ण है। छोटे डेटासेट के साथ भी, इन प्रथाओं को लागू करना भविष्य की वृद्धि और प्रदर्शन दक्षता के लिए ठोस नींव रख सकता है।
क्लस्टर की नियमित मॉनिटरिंग और मेंटेनेंस इष्टतम प्रदर्शन और लागत-प्रभावशीलता सुनिश्चित करने के लिए आवश्यक है। निम्न छवि हमारे मासिक Redshift खर्चों का ब्रेकडाउन प्रदान करती है, जो लागत अनुकूलन के अवसरों का खुलासा करती है।
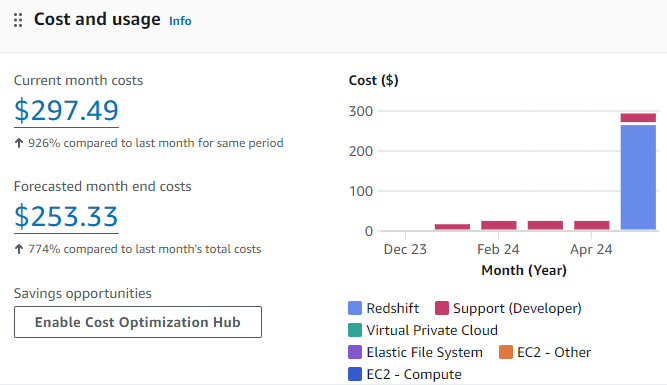
वर्तमान Redshift उपयोग-केस के लिए लागत और उपयोग ग्राफ़िक
उपर्युक्त छवि के आधार पर, हमारे छोटे डेटासेट के लिए हमारा Redshift क्लस्टर अधिक-प्राविज़न्ड प्रतीत होता है, जिसके परिणामस्वरूप कम उपयोग और लागत अक्षमताएँ हैं।
Amazon CloudWatch और AWS Management Console जैसे AWS टूल्स का उपयोग करके, हम CPU उपयोग और क्वेरी प्रदर्शन सहित प्रमुख प्रदर्शन मीट्रिक्स की निगरानी कर सकते हैं। ये अंतर्दृष्टियाँ हमें संभावित मुद्दों की पहचान करने और क्लस्टर अनुकूलन के लिए डेटा-आधारित निर्णय लेने में मदद कर सकती हैं।
हमारे क्लस्टर के कम उपयोग को देखते हुए, हम निम्नलिखित लागत अनुकूलन रणनीतियों पर विचार कर सकते हैं:
जैसे-जैसे डेटा वॉल्यूम बढ़ता है और वर्कलोड विकसित होता है, अपने क्लस्टर के प्रदर्शन की निरंतर निगरानी करें और तदनुसार अपने इंस्टेंस साइजिंग और अनुकूलन रणनीतियों का पुनर्मूल्यांकन करें।
Amazon Redshift में संवेदनशील डेटा के साथ काम करते समय, उच्चतम स्तर की सुरक्षा और अनुपालन सुनिश्चित करना महत्वपूर्ण है। चूँकि संगठन बढ़ती नियामक आवश्यकताओं और संवेदनशील जानकारी की सुरक्षा की जरूरतों का सामना कर रहे हैं, मज़बूत सुरक्षा उपाय लागू करना और अनुपालन दिशानिर्देशों का पालन करना हमारे Redshift क्लस्टर के प्रबंधन के महत्वपूर्ण पहलू बन जाते हैं।
उद्योग-विशिष्ट विनियमों और डेटा संरक्षण कानूनों के साथ अनुपालन, संवेदनशील डेटा से निपटने वाले संगठनों के लिए सर्वोच्च प्राथमिकता है। Amazon Redshift हमें इन अनुपालन आवश्यकताओं को प्रभावी ढंग से पूरा करने में मदद करने के लिए सुविधाएँ और क्षमताएँ प्रदान करता है।
अनुपालन विचारों के अलावा, Amazon Redshift में डेटा सुरक्षा के लिए सर्वोत्तम प्रथाओं को लागू करना आपकी संवेदनशील जानकारी को अनधिकृत पहुँच और संभावित उल्लंघनों से बचाने के लिए महत्वपूर्ण है।
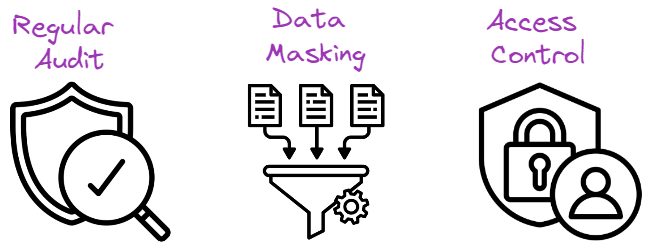
डेटा सुरक्षा के लिए सर्वोत्तम प्रथाएँ
नियमित सुरक्षा ऑडिट करना कमजोरियों की पहचान करने, मौजूदा सुरक्षा उपायों की प्रभावशीलता का आकलन करने, और सतत अनुपालन सुनिश्चित करने के लिए आवश्यक है। निम्न ऑडिट प्रथाओं पर विचार करें:
डेटा मास्किंग एक तकनीक है जिसमें डेटा की संरचना और फ़ॉर्मैट को बनाए रखते हुए संवेदनशील डेटा तत्वों को मास्क किया जाता है। संवेदनशील जानकारी को मास्क करके, हम उसे अनधिकृत पहुँच से सुरक्षित रख सकते हैं और डेटा गोपनीयता बनाए रख सकते हैं। Amazon Redshift में डेटा मास्क करने के कुछ तरीके नीचे दिए गए हैं:
मज़बूत एक्सेस नियंत्रण तंत्र लागू करना महत्वपूर्ण है ताकि केवल अधिकृत व्यक्ति ही हमारे Amazon Redshift क्लस्टर में संवेदनशील डेटा तक पहुँच सकें। ऐसे तंत्र इस प्रकार लागू किए जा सकते हैं:
इस लेख में, हमने डेटा वेयरहाउसिंग के लिए Amazon Redshift के उपयोग के बुनियादी और उन्नत पहलुओं का अन्वेषण किया। हमने डेटा वेयरहाउसिंग के महत्व को समझने से शुरुआत की और देखा कि Amazon Redshift SQL का उपयोग करके बड़े डेटासेट का विश्लेषण करने के लिए एक शक्तिशाली, स्केलेबल, और लागत-प्रभावी समाधान कैसे प्रदान करता है।
इसके बाद, हमने Amazon Redshift क्लस्टर सेटअप करने की प्रक्रिया पर चर्चा की, जिसमें पूर्वापेक्षाएँ, क्लस्टर निर्माण, और कॉन्फ़िगरेशन सेटिंग्स शामिल थीं। हमने AWS S3 और COPY कमांड का उपयोग करके Redshift में डेटा लोड करने के विवरण, सिंटैक्स उदाहरणों और व्याख्याओं सहित कवर किया।
आगे, हमने Redshift में डेटा क्वेरी करने की आवश्यकताओं को कवर किया—बेसिक SQL क्वेरी से लेकर विंडो फ़ंक्शंस और जटिल जॉइन्स जैसी उन्नत तकनीकों तक। हमने Redshift में प्रदर्शन ट्यूनिंग पर भी चर्चा की, जिसमें डिस्ट्रीब्यूशन स्टाइल्स, सॉर्ट कीज़, और कंप्रेशन एनकोडिंग जैसी क्वेरी प्रदर्शन अनुकूलन की सर्वोत्तम प्रथाएँ बताईं।
अंत में, हमने Amazon Redshift में सुरक्षा और अनुपालन के महत्व पर ज़ोर दिया, एन्क्रिप्शन और एक्सेस नियंत्रण जैसी सुरक्षा सुविधाओं के साथ-साथ अनुपालन विचारों को भी कवर किया।
जो भी Amazon Redshift और AWS के साथ काम करने में अपना ज्ञान और कौशल बढ़ाने में रुचि रखते हैं, वे निम्न DataCamp संसाधनों का अन्वेषण कर सकते हैं:
Amazon Redshift में महारत हासिल करके और उसकी क्षमताओं का लाभ उठाकर, उपयोगकर्ता अपने डेटा से मूल्यवान अंतर्दृष्टियाँ अनलॉक कर सकते हैं और डेटा-आधारित निर्णय ले सकते हैं।
आज ही अपनी डेटा इंजीनियरिंग यात्रा जारी रखें!
कोर्स
लर्निंग पाथ
लर्निंग पाथ