
Last chance! 50% off DataCamp Premium
Sale ends in
Veri, modern kuruluşların temelidir; ancak toplanan ve saklanan büyük miktardaki bilgiyi yönetmek zorlayıcı olabilir. Başarının anahtarı, bu veriyi etkili biçimde düzenleyip analiz ederek, bilinçli karar almayı sağlayan değerli içgörüler keşfetmektir.
İşte veri ambarı tam bu noktada devreye girer. İşletmelerin verilerini konsolide edip verimli analiz için optimize etmelerini sağlayan güçlü bir çözümdür. Veri ambarı söz konusu olduğunda ise AWS Redshift öne çıkan bir seçenektir.
Bu makalede, AWS Redshift’in ayrıntılarını; temel özellikleri, faydaları ve kurulum, veri yükleme, sorgulama, performans ayarı, güvenlik ve entegrasyonlar için en iyi uygulamalarla birlikte ele alacağız.
İster bir veri uzmanı olun ister verinizden en iyi şekilde yararlanmak isteyen bir iş lideri, bu makale AWS Redshift ile başarılı olmanız için gerekli bilgi ve araçları sağlayacaktır.
Veri ambarı, bir kuruluş içindeki çeşitli kaynaklardan gelen büyük miktarda yapılandırılmış veriyi toplama, depolama ve yönetme sürecidir.
Bir veri ambarının birincil amacı, raporlama ve karar verme için kolayca erişilebilen, analiz edilebilen merkezi bir bilgi deposu sağlamaktır.
Veri ambarları, karmaşık sorguları ve veri analizini destekleyecek şekilde tasarlanmıştır; işletmelerin verilerinden değerli içgörüler elde etmelerini mümkün kılar.
Bir veri ambarı benimsemek kuruluşlara önemli ölçüde fayda sağlayabilir:
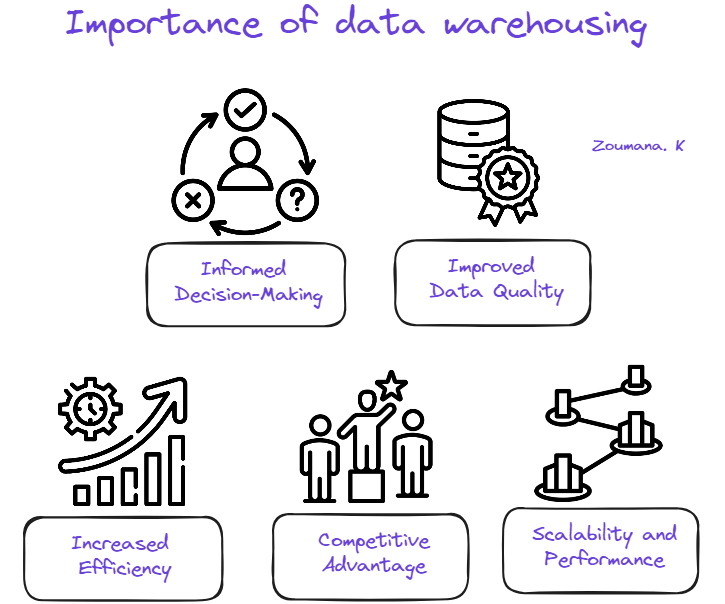
Veri Ambarının Önemi
AWS Redshift, petabayt ölçeğindeki veri kümelerinin depolanmasına ve analizine olanak tanıyan, tamamen yönetilen bulut tabanlı bir veri ambarı hizmetidir. AWS Redshift Serverless ile kullanıcılar, sağlanan bir veri ambarını elle yapılandırmaya gerek kalmadan verilere erişip analiz yapabilir.
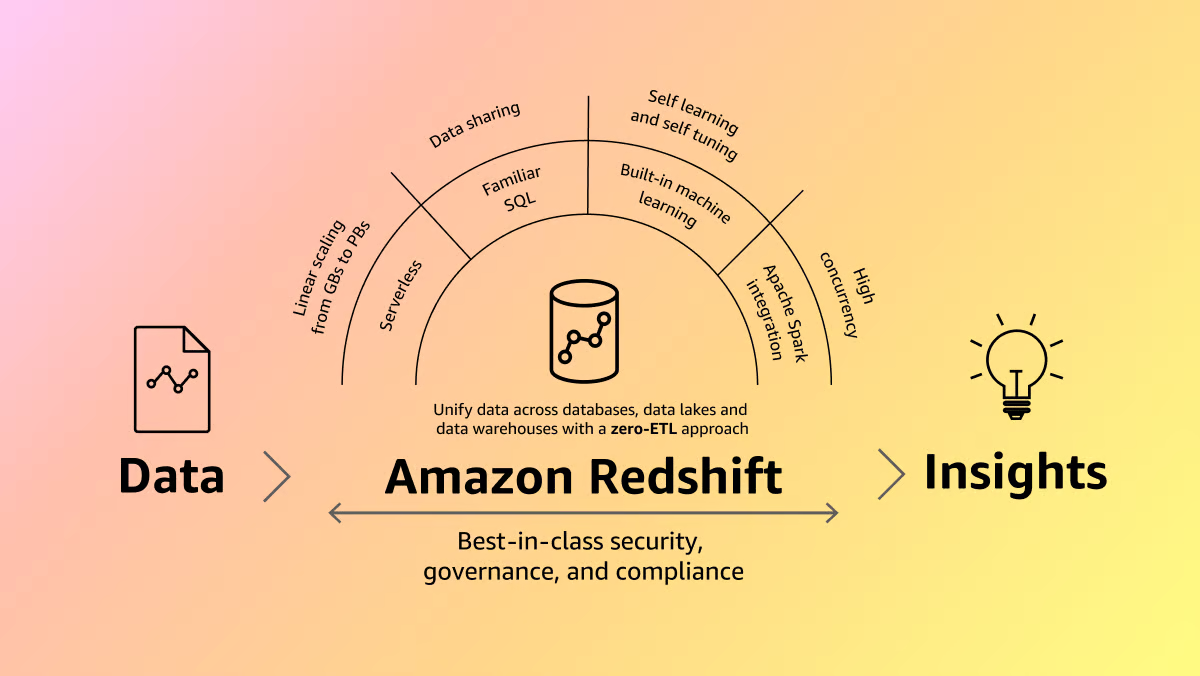
Amazon Redshift (Kaynak)
Hizmet, kaynakları otomatik olarak sağlarken veri ambarı kapasitesini akıllıca ölçeklendirir; böylece en zorlu ve öngörülemeyen iş yüklerinde bile hızlı performans sağlar. Veri ambarı boşta olduğunda ücret oluşmadığından, kullanıcılar yalnızca kullandıkları kaynaklar için ödeme yapar.
AWS Redshift, Amazon Redshift query editor v2 veya tercih edilen iş zekâsı (BI) aracı aracılığıyla verileri yükleyip anında sorgulamaya başlamayı sağlar. Hizmet, kullanımı kolay ve yönetimsiz bir ortamda en iyi fiyat-performans oranını ve tanıdık SQL özelliklerini sunar.
Veri kümesinin boyutu ne olursa olsun, AWS Redshift yaygın olarak kullanılan SQL tabanlı araçlar ve iş zekâsı uygulamalarıyla hızlı sorgu performansı sunar.
AWS Redshift, kuruluşların büyük veri hacimlerini verimli şekilde depolamasına, yönetmesine ve analiz etmesine yardımcı olmak için çok sayıda özellik ve fayda sağlar. Başlıcaları aşağıda gösterilmiştir:
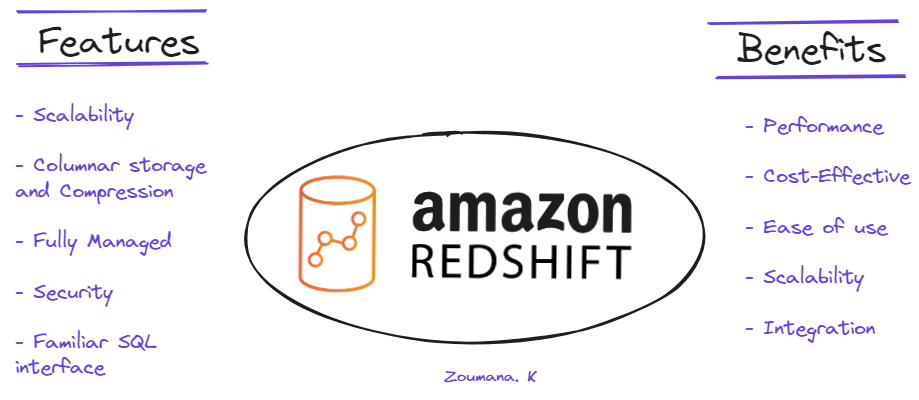
AWS Redshift Özellikleri ve Faydaları
Önceki bölümler ağırlıklı olarak Redshift’e genel bir bakışa odaklandı. Şimdi teknik yönleri inceleyeceğiz.
Bu bölümde önce AWS Redshift’i başarıyla kurmak için ana önkoşullar ele alınır; ardından bir Redshift kümesi oluşturmanın adım adım süreci anlatılır. Son kısımda ise düğüm tipleri, düğüm sayısı ve güvenlik yapılandırması gibi temel küme ayarlarının ayrıntıları açıklanır.
Uygulama ayrıntılarına dalmadan önce, başarılı bir uygulama için gereken önkoşulları gözden geçirelim:
Bu bölüm, AWS Management Console üzerinden bir Redshift kümesini oluşturmak için aşağıda gösterildiği gibi 11 basit adımın tamamını sunar:
1. Konsolda Redshift’i arayın ve “Amazon Redshift”i seçin:
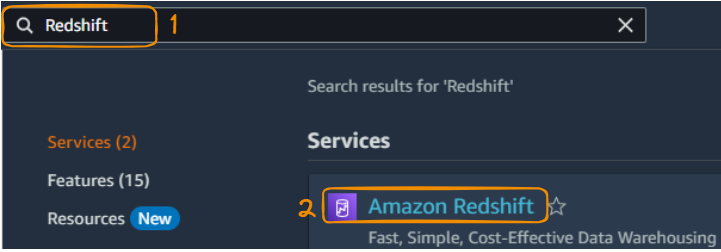
Yönetim Konsolundan Redshift’i arayın ve seçin
2. Bir küme oluşturmaya başlamak için “Create Cluster” düğmesini seçin.
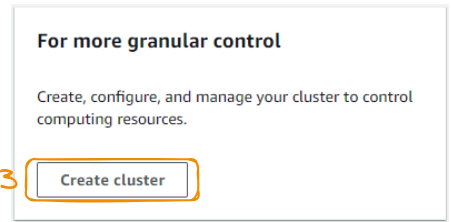
Küme oluşturma düğmesi
3. Yukarıdaki işlemden sonra, küme tanımlayıcısı, küme boyutu, düğüm tipi, erişilebilirlik bölgesi seçimi, düğüm sayısı gibi bilgiler vererek kümeyi yapılandırabiliriz.
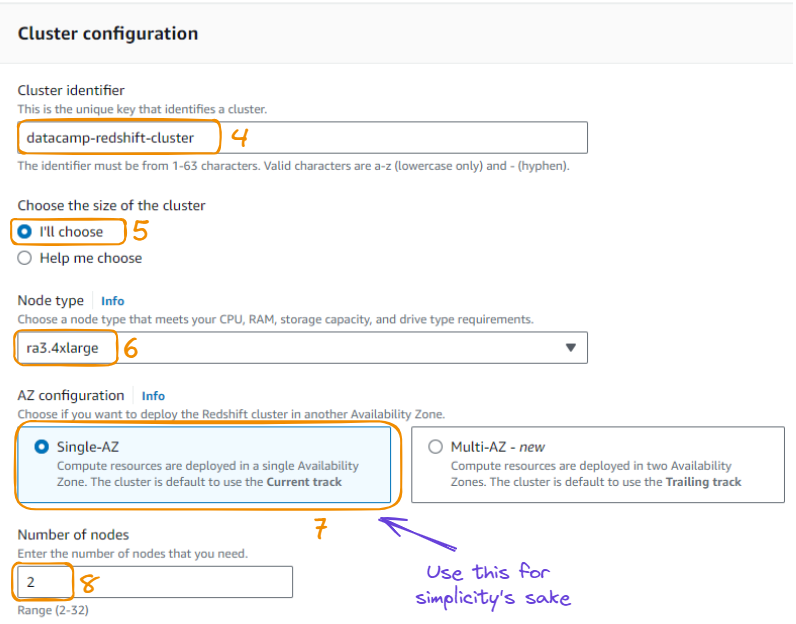
8 adımda küme yapılandırması
4. Yukarıdaki sayfada önerilen örnek veriyi kullanmak yerine, verileri Redshift’e yüklemek için S3 kovasındaki verileri kullanıyoruz.
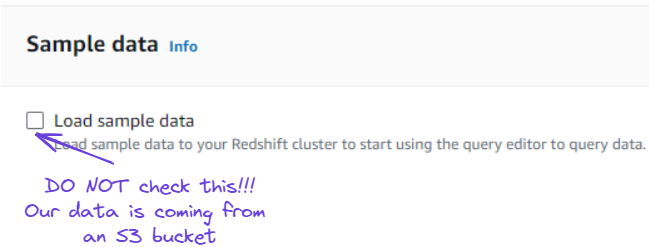
Örnek veri yükleme seçeneğini yoksayın
5. IAM rolleri sağlayarak kümenin izinlerini tanımlama seçeneğimiz vardır. Bu bölüm şimdilik atlanabilir ve daha sonra ele alınabilir.
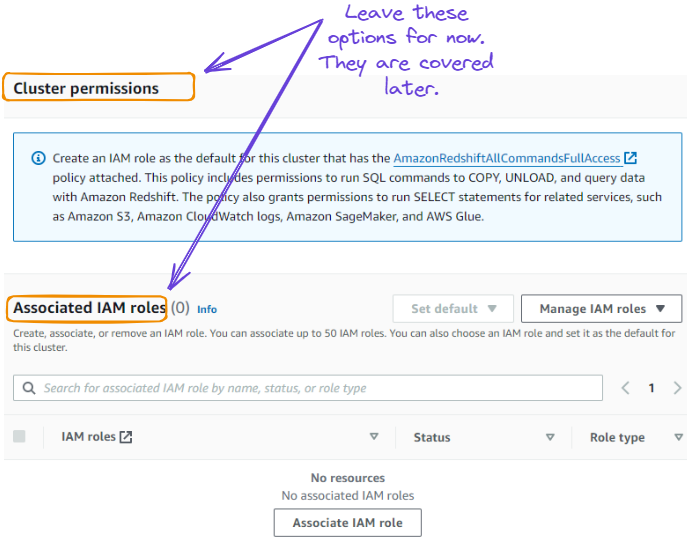
Küme izinleri ve IAM rollerini yoksayın
6. Ağ, güvenlik, yedekleme ve bakım için varsayılan yapılandırmaları bırakın ve kümeyi oluşturmak için “Create cluster” düğmesini seçin.
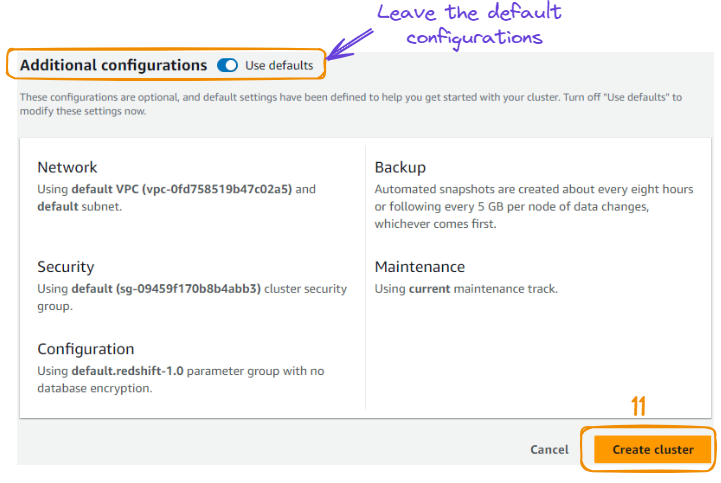
Kümenin oluşturulması
7. Bu işlemin ardından, yeni oluşturulan kümeyi gösteren yeni bir sayfaya yönlendiriliriz. Kümenin başarıyla oluşturulması birkaç dakika sürebilir; bu durum “Status” bölümünde önce “Creating”, ardından “Available” olarak görülür.
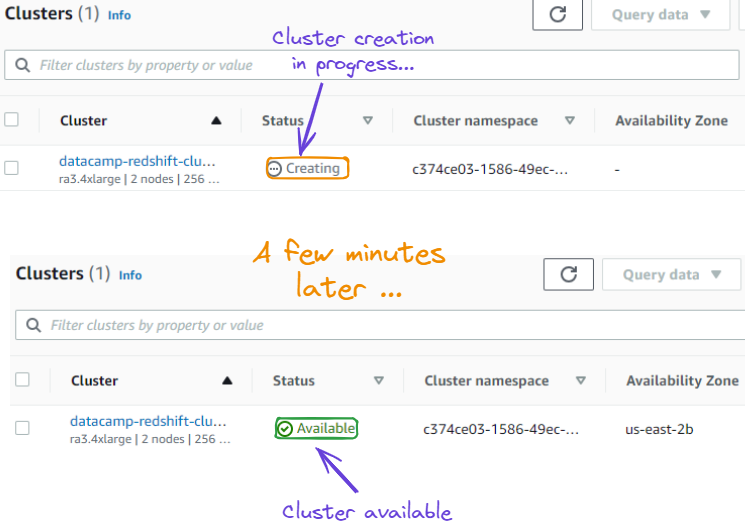
Küme durumu: “Creating”den “Available”a
Artık Redshift kümelerimizi başarıyla oluşturduk. Bu bölüm, DataLab’imizde bulunan Ülke, Bölge ve Dünya GSYH (Gayri Safi Yurt İçi Hasıla) veri setini seçmekten S3 kovasına yüklemeye kadar tüm adımlarda size rehberlik eder.
Verimiz aslen Dünya Bankası veri setinden gelmektedir. Ülkeler, bölgeler ve dünya için cari ABD Doları ($) cinsinden ölçülen GSYH hakkındadır. Bölgeler, Avrupa ve Orta Asya gibi ülke gruplarını ifade eder.
Verinin ilk on gözlemi şu şekildedir:
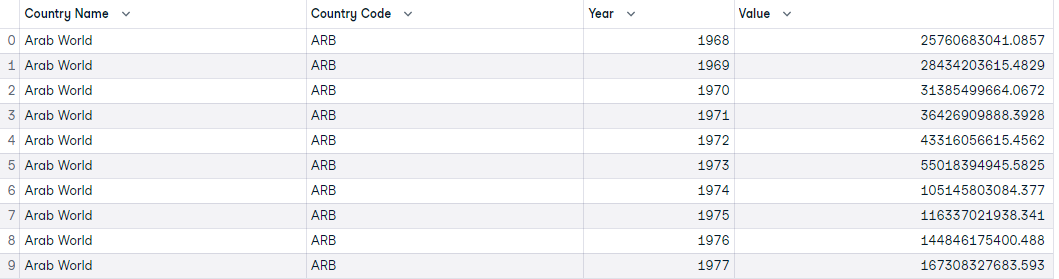
GSYH verisinin ilk on gözlemi
S3 ve Redshift arasında başarılı bir etkileşim için önce veriyi depolayacağımız bir S3 kovası oluşturmadan önce bir IAM rolü oluşturmamız gerekir.
Bir IAM rolü oluşturmanın faydası, Redshift kümemiz ile verinin bulunduğu S3 kovası arasında bir bağlantı kurmasıdır.
IAM rolü oluşturma şu şekilde yapılır:
Management Console’dan “IAM”i arayın ve arama sonucundan “IAM” logosunu seçin.
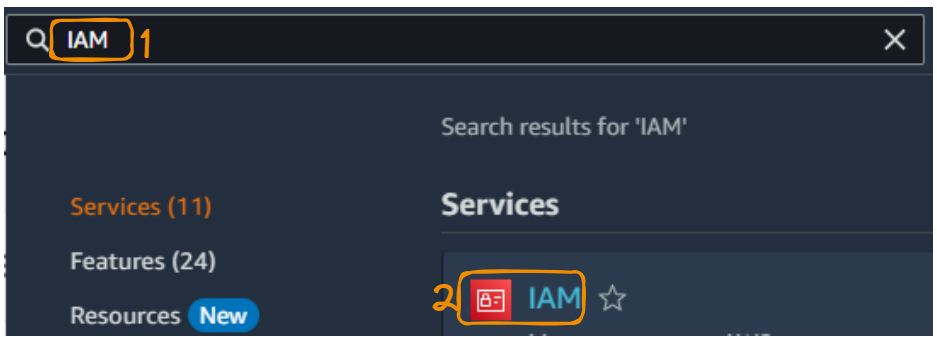
Management Console’dan IAM hizmeti
“Roles”u seçerek tüm olası rolleri görüntüleyin ve yeni bir rol oluşturmak için “Create role”u seçin.
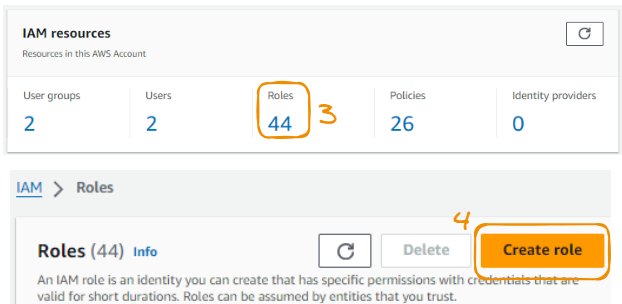
Yeni rol oluşturmaya başlama
“Trusted entity type” bölümünden “AWS service”i, “Use case” olarak “Redshift”i seçin ve devam etmek için “Next”e tıklayın.
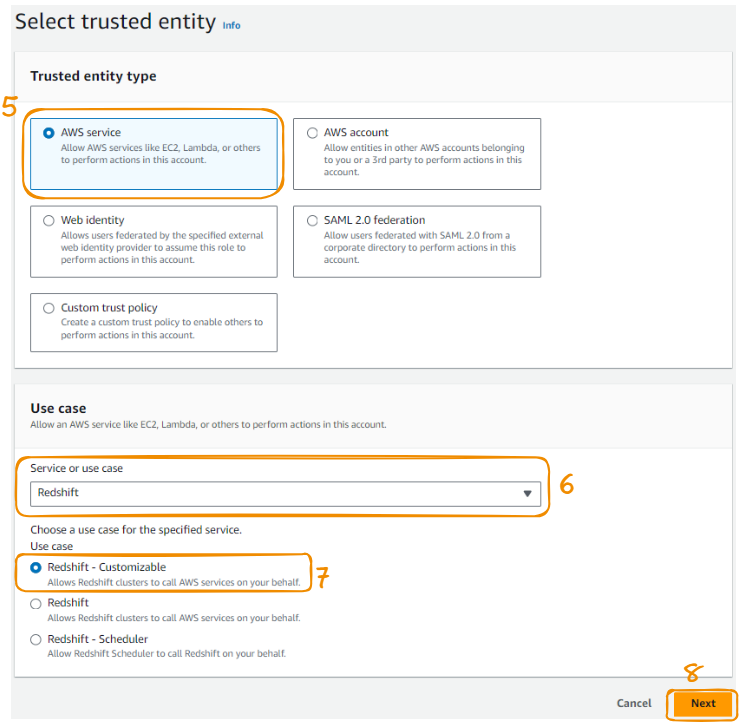
AMI rol oluşturmanın 5–8. adımları
Arama sekmesinde “S3FullAccess”i bulun, seçeneği işaretleyin ve “Next”i seçin.
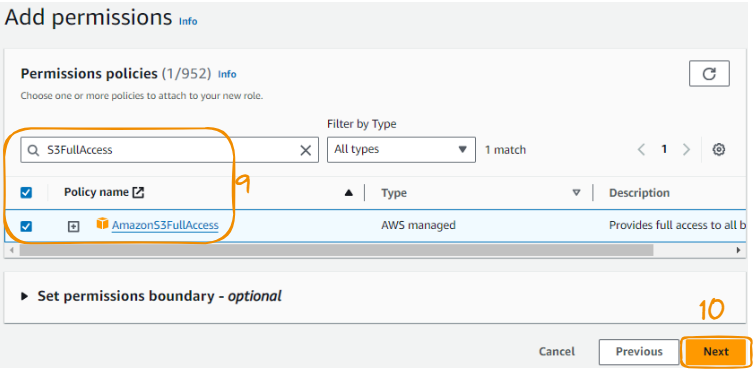
AMI rol oluşturmanın 9–10. adımları
Son olarak rolü adlandırın, gözden geçirin ve rol oluşturmayı tamamlamak için “Create role” düğmesini seçin.
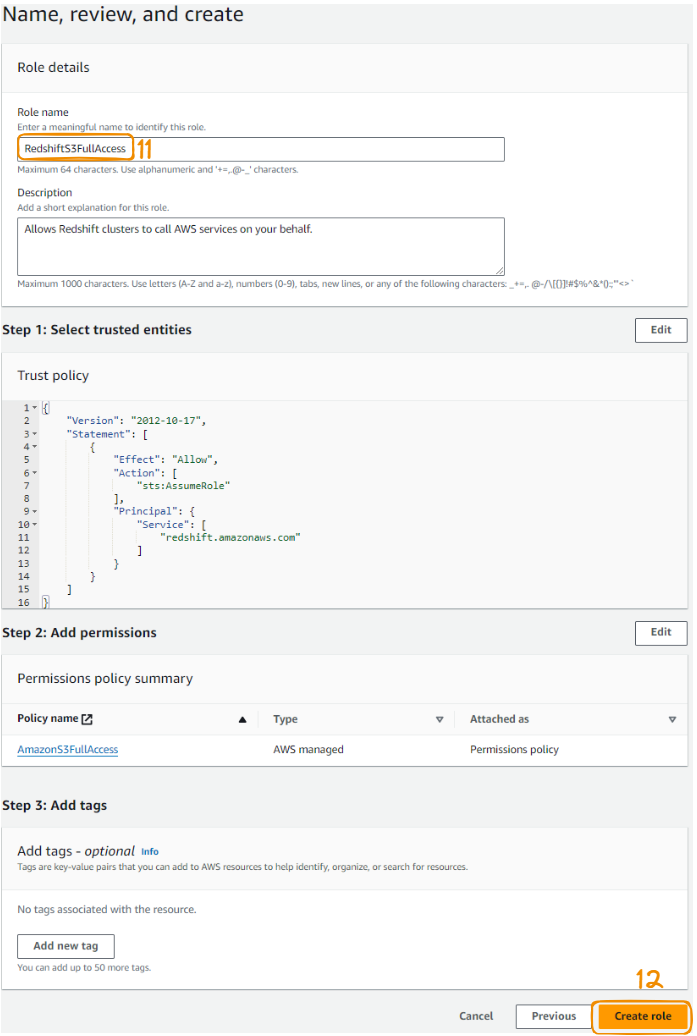
AMI rol oluşturmanın 11–12. adımları
Her şey başarıyla tamamlandığında, rol oluşturmayı doğrulayan aşağıdaki yeşil mesaj sağ üst köşede görüntülenir.
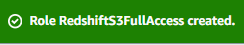
Rol oluşturma onay mesajı
Artık bir IAM rolümüz olduğuna göre, bunu başlangıçta oluşturulan Redshift kümesine bağlayabiliriz; şu şekilde yapılır:
Kümeler bölümünden oluşturduğunuz datacamp kümesini seçin ve “Actions” bölümünde “Manage IAM roles”u seçin.
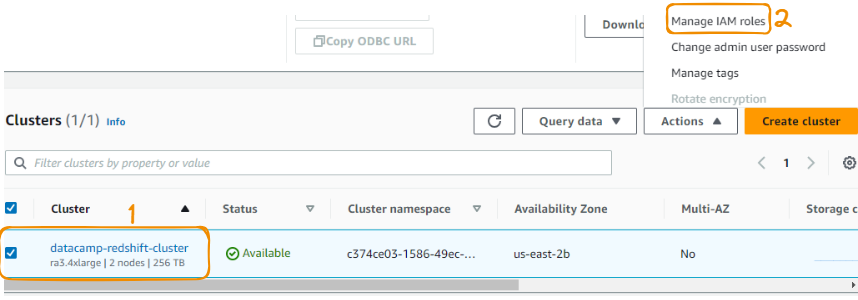
IAM rolünü Redshift’e bağlama adım 1–2
Bu bölümde, daha önce oluşturulan IAM rolünü seçin ve değişiklikleri kaydedin.
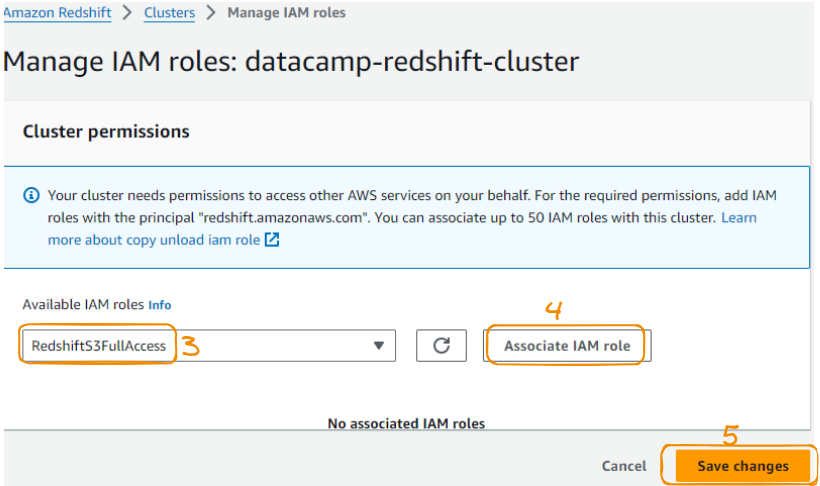
IAM rolünü Redshift’e bağlama adım 3–4
Redshift’ten veri sorgulamak için kullanılabilecek birden fazla araç vardır. Bunların bir kısmı AWS hizmetlerinin parçasıdır, bir kısmı ise haricidir. Bu eğitim kapsamında Redshift Dashboard’daki sorgu düzenleyicisini kullanıyoruz.
Bunu kullanabilmek için önce “Query data” sekmesindeki “Query in query editor” seçeneğinden başlayarak Query editor’a bir bağlantı oluşturmalıyız:
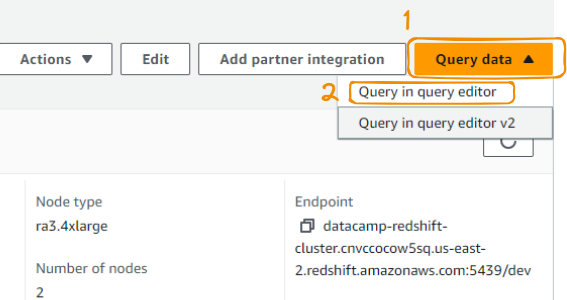
Query data’dan sorgu düzenleyici
Yukarıdaki işlem bizi aşağıdaki sayfaya götürür; burada bir ad ve kullanıcı adı vererek veritabanına bağlanabiliriz:
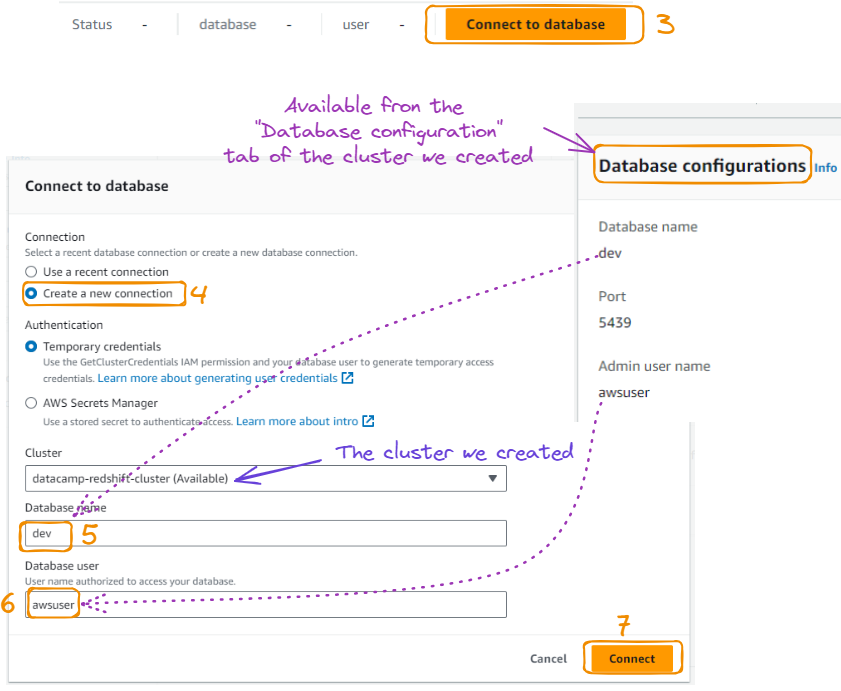
Sorgu düzenleyiciden veritabanı bağlantısı
“Connect” düğmesine bastıktan sonra üstte yeşil “Connected” sekmesini ve solda veritabanı bilgilerini görebiliriz.
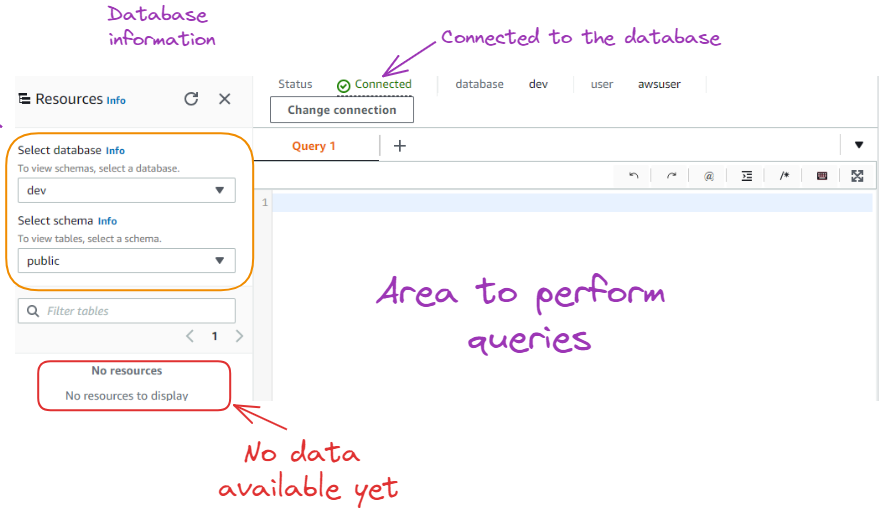
Veritabanına bağlandıktan sonra oluşan sonuç
Yukarıda görüldüğü gibi, veritabanında henüz kaynak/veri yok. Veriyi içe aktarmadan önce, içe aktarılacak verinin özellikleriyle aynı özelliklere sahip bir tablo oluşturmamız gerekir.
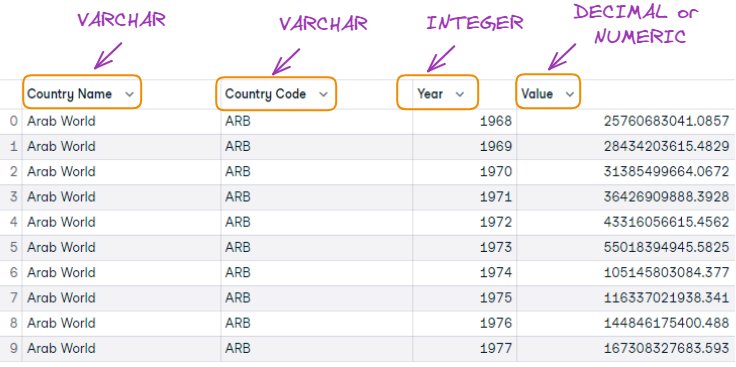
İlk 10 gözlem ve tablo sütun biçimi eşleşmesi
Tablo aşağıdaki SQL sorgusu ile oluşturulur:
CREATE TABLE gdp_data (
id INTEGER PRIMARY KEY,
country_name VARCHAR(255),
country_code VARCHAR(10),
year INTEGER,
value DECIMAL(20,2)
);
SQL sorgusunun sütun başına bir madde halinde açıklaması şöyledir:
id INTEGER PRIMARY KEY: “id” adlı bir sütun oluşturur; veri türü INTEGER’dır ve tablo için birincil anahtar olarak atanır; her satır için benzersiz değerleri zorunlu kılar.country_name VARCHAR(255): “country_name” adlı bir sütun oluşturur; VARCHAR veri türündedir ve 255 karaktere kadar metin saklayabilir.country_code VARCHAR(10): “country_code” adlı bir sütun oluşturur; VARCHAR veri türündedir ve 10 karaktere kadar metin saklayabilir.year INTEGER: “year” adlı bir sütun oluşturur; veri türü INTEGER’dır ve tam sayılar (bu örnekte yıllar) için uygundur.value DECIMAL(20,2): “value” adlı bir sütun oluşturur; veri türü DECIMAL’dır; 20 basamaklı ve 2 ondalık haneli sayıları saklayabilir.Şimdi tabloyu oluşturmak için sorguyu çalıştıralım:
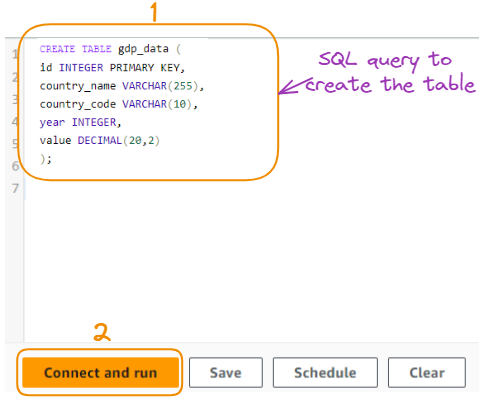
Tabloyu oluşturma sorgusu
Bu sorgu, aşağıda gösterildiği gibi GSYH verilerini saklamak için belirtilen sütunlara sahip "gdp_data" adlı bir tablo oluşturur:
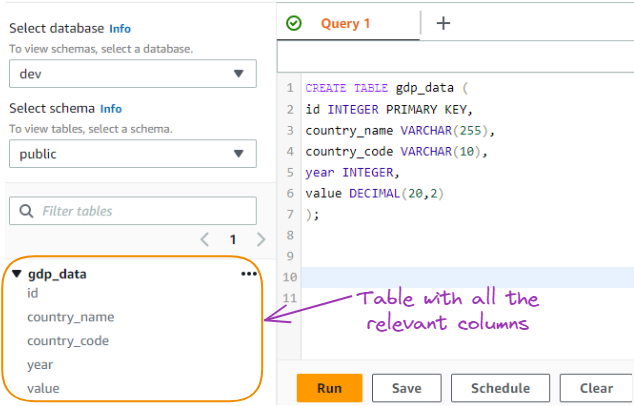
SQL sorgusuyla oluşturulan GSYH veri tablosu
Veri tabloya bir S3 kovasından içe aktarılacaktır. Bu bölümde kovayı oluşturma ve veriyi yükleme adımlarının tümünü ele alıyoruz.
Management Console’da S3 hizmetini bulun, ilgili logoyu seçin ve her şeyi varsayılanda bırakarak bir ad verin:
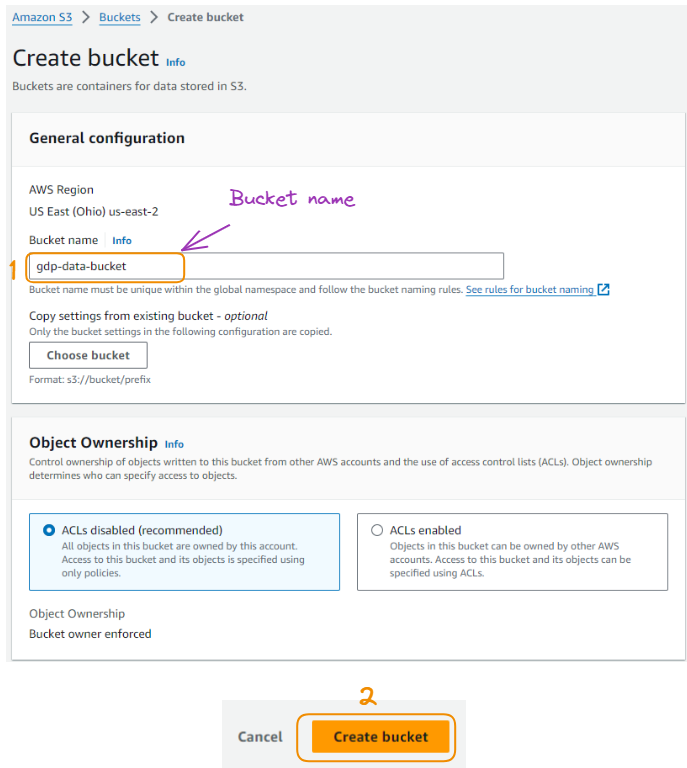
S3 kovası oluşturma
Kova oluşturulduktan sonra geçmişte oluşturulan tüm kovaların listesinde görünür hale gelir.
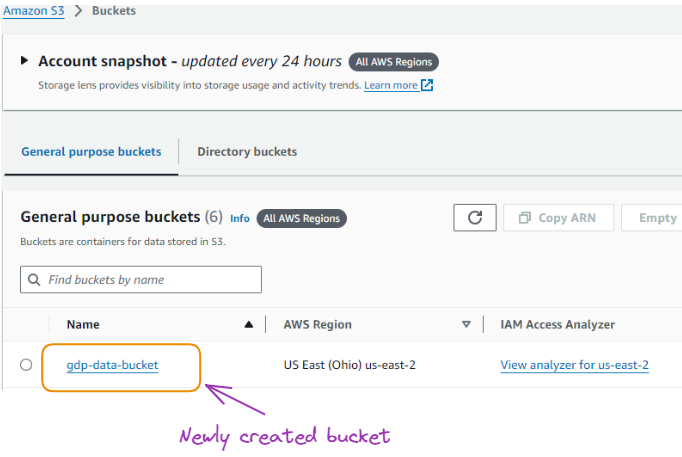
Yeni oluşturulan kova
Buradan kova adını seçip, yerel olarak indirdiğimiz CSV biçimindeki GSYH verisini yükleyebiliriz.
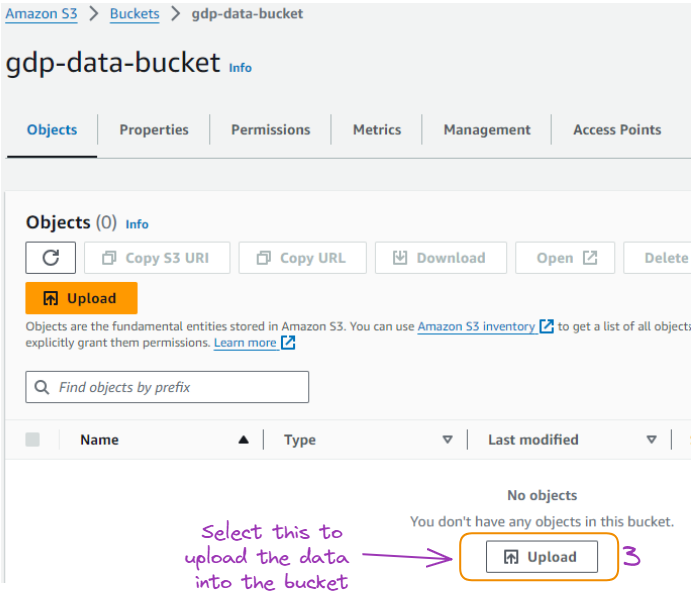
Kovaya veri yükleme sayfası
Veri başarıyla içe aktarıldıktan sonra aşağıda görüldüğü gibi erişilebilir olur:
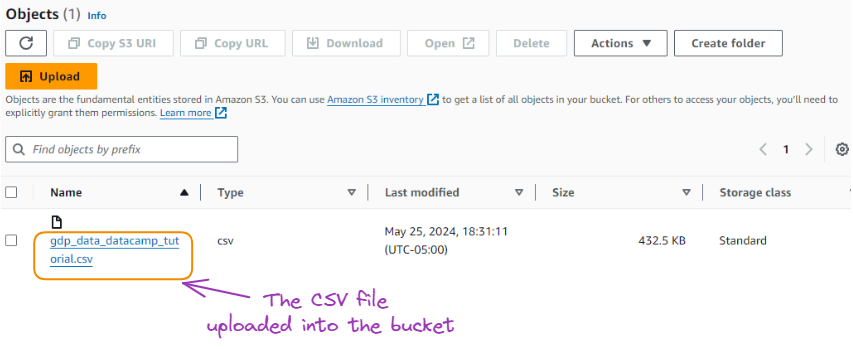
Kovaya yüklenen CSV
Buraya kadar geldiğiniz için tebrikler!
Bu bölüm, veriyi S3’ten Redshift’e aşağıdaki şekilde kopyalamanın nasıl yapıldığını gösterir.
COPY gdp_data (id, country_name, country_code, year, value)
FROM 's3://gdp-data-bucket/gdp/gdp_data.csv'
IAM_ROLE 'arn:aws:iam::654654631565:role/RedshiftS3FullAccess'
CSV
IGNOREHEADER 1;
Burada neler olduğuna bakalım:
Aşağıda düzenleyicideki aynı kod verilmiştir; kopyalama işlemi birkaç saniye sonra başarıyla tamamlandı:
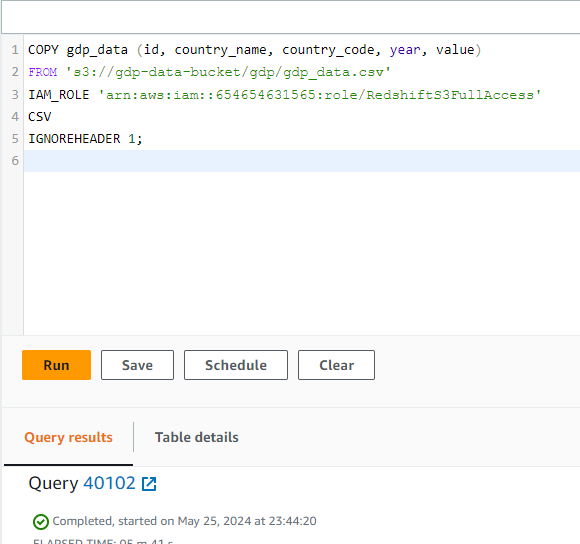
COPY görevi tamamlandı
Basitlik adına, orijinal CSV’deki tüm verileri yüklemek yerine rastgele seçilmiş yüz gözlem yüklendi. Aşağıdaki gibi “Preview data” seçeneğini seçerek verinin ön izlemesini alabiliriz:
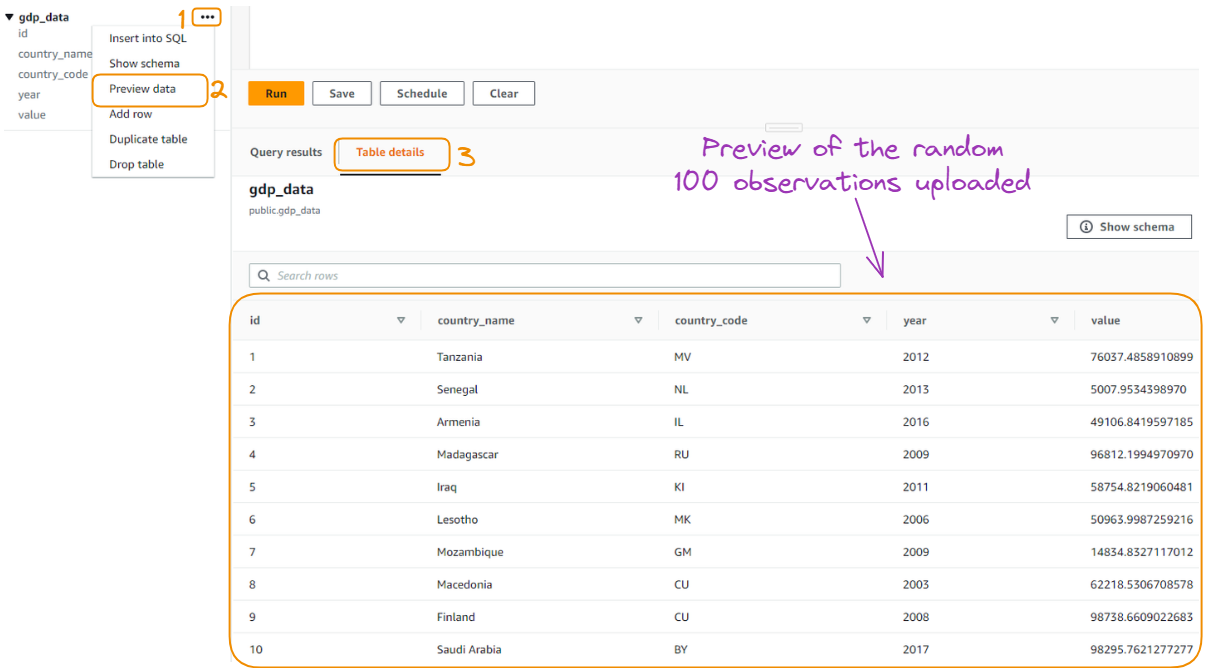
Rastgele yüklenen 100 gözlemin ön izlemesi
Veri ön izlemesi yalnızca ilk on gözlemi gösterir. Ancak daha fazla içgörü elde etmek için verimizle daha fazla etkileşime girmek isteyebiliriz; bu noktada SQL becerileri faydalı olur.
Bu bölümde, veriyi keşfetmek için bazı SQL sorguları üzerinden ilerliyoruz.
Veritabanımızda depolanan verilerle etkileşim kurmak için en yaygın kullanılan sorgudan, yani veriyi seçmeden başlayarak beş SQL sorgusu kullanıyoruz.
Tüm veriyi seçin
SELECT *
FROM gdp_data;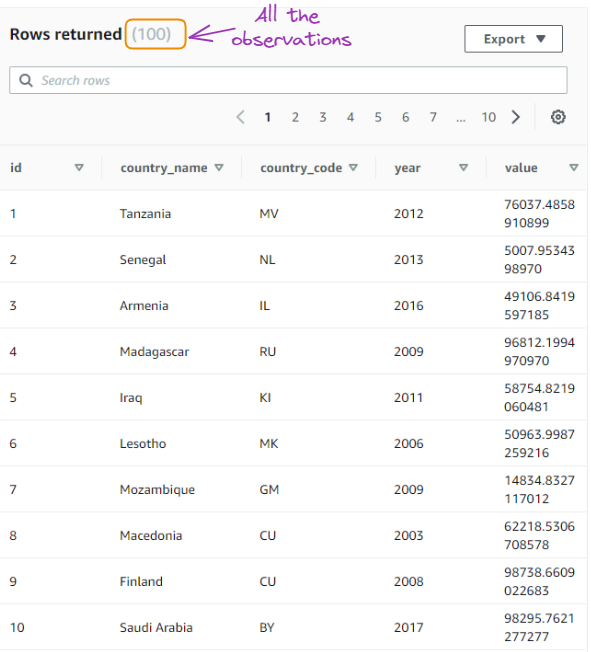
İlk sorgunun sonucu
Belirli bir ülke için veriyi seçin:
SELECT * FROM gdp_data
WHERE country_name = 'Senegal';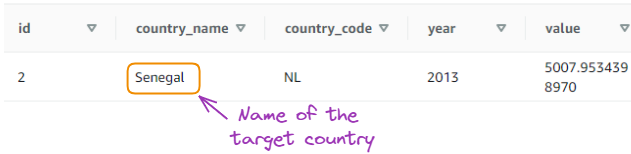
İkinci sorgunun sonucu
Belirli bir yıl için ortalama GSYH değerini hesaplayın:
SELECT year, AVG(value) as average_gdp
FROM gdp_data
WHERE year = 2020
GROUP BY year;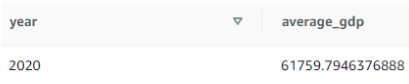
Üçüncü sorgunun sonucu
Belirli bir yılda en yüksek GSYH’ye sahip ilk 5 ülkeyi bulun:
SELECT country_name, value
FROM gdp_data
WHERE year = 2020
ORDER BY value DESC
LIMIT 5;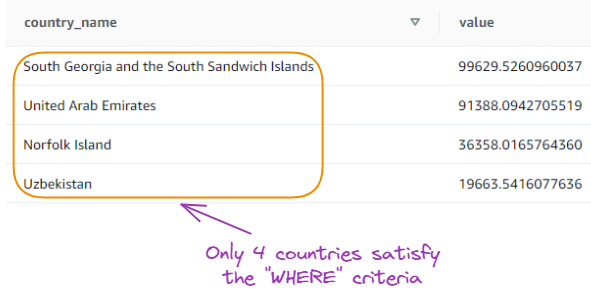
Dördüncü sorgunun sonucu
Yıl başına kayıt sayısını sayın:
SELECT year, COUNT(*) as record_count
FROM gdp_data
GROUP BY year
ORDER BY year;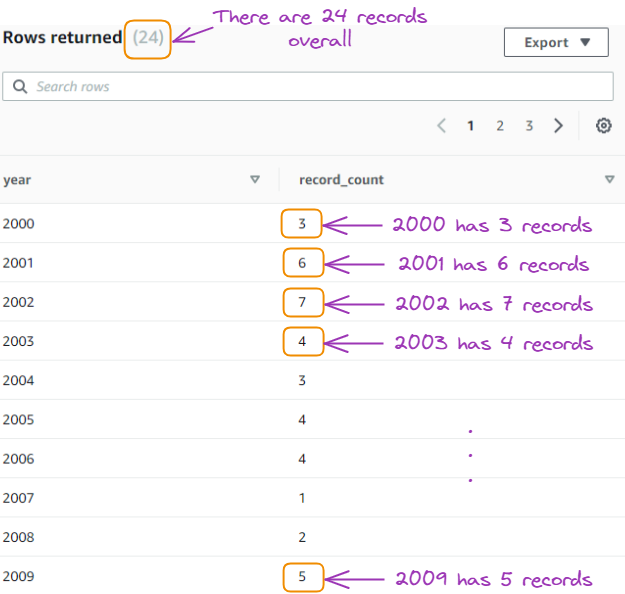
Beşinci sorgunun sonucu
Yukarıdaki sorgular veriye dair temel bir anlayış sağladı; bu bölümde ise üç ileri düzey sorgulama tekniğine odaklanıyoruz.
Kümülatif toplamın hesaplanması: Bu sorgu, yıl bazında sıralanmış şekilde her ülke için GSYH değerlerinin kümülatif toplamını hesaplar.
SELECT
    country_name,
    year,
    value,
    SUM(value) OVER (PARTITION BY country_name ORDER BY year) as running_total
FROM gdp_data;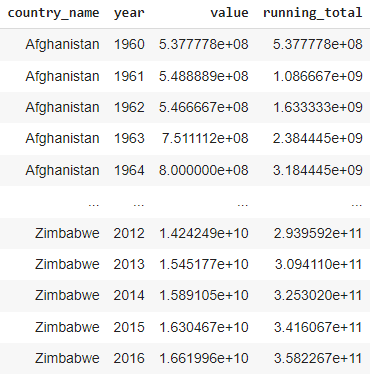
Kümülatif toplam sonucu
Filtreleme ve toplama için CTE’ler: Bu sorgu, veriyi 2020 yılından itibaren olan kayıtlarla sınırlandırmak için bir CTE kullanır ve ardından her ülke için ortalama GSYH değerini hesaplar.
WITH recent_data AS (
    SELECT
        country_name,
        year,
        value
    FROM gdp_data
    WHERE year >= 2020
)
SELECT
    country_name,
    AVG(value) as average_gdp
FROM gdp_data
GROUP BY country_name;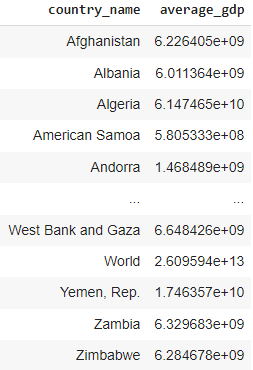
CTE’lerden elde edilen sonuç
Yıla göre GSYH büyümesini hesaplama: Bu sorguyla her ülke için yıllık GSYH büyümesini hesaplıyoruz.
SELECT
    a.country_name,
    a.year,
    a.value as current_year_value,
    b.value as previous_year_value,
    (a.value - b.value) / b.value * 100 as growth_percentage
FROM gdp_data a
JOIN gdp_data b
    ON a.country_name = b.country_name
    AND a.year = b.year + 1;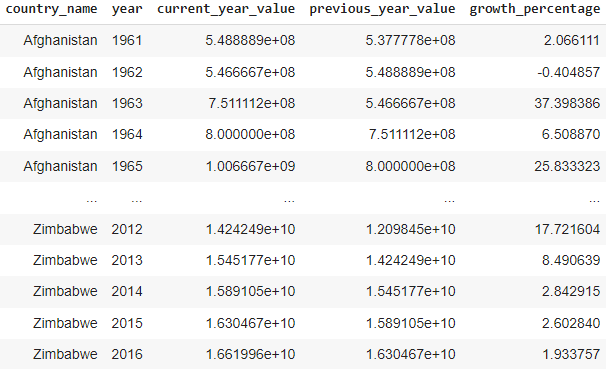
Self-join sorgusunun sonucu
En iyi performansı ve maliyet etkinliğini sağlamak için Redshift’in performansını etkileyen faktörleri anlamak ve kümemiz için en iyi uygulamaları hayata geçirmek esastır.
Bu bölümde, Redshift performans ayarının temel yönlerini inceleyecek ve sağlanan küme bilgilerine dayanarak içgörüler sunacağız.
Amazon Redshift’te performans; donanım yapılandırmalarından sorgu iyileştirme tekniklerine kadar pek çok faktörden etkilenir. Bu faktörleri anlamak, darboğazları tespit edip kümemizin performansını iyileştirmek için daha iyi kararlar almada kritik öneme sahiptir.
İki adet ra3.4xlarge düğümünden oluşan bir Redshift kümesi yapılandırdık ve kullanılan veri yalnızca 391 KB.
Ayrıca aşağıdaki görsel, kümenin CPU kullanımının tüm süre boyunca %0’a yakın seyrettiğini; yani kümenin yoğun kullanılmadığını ve mevcut iş yükümüz için fazla sağlanmış olabileceğini gösteriyor.
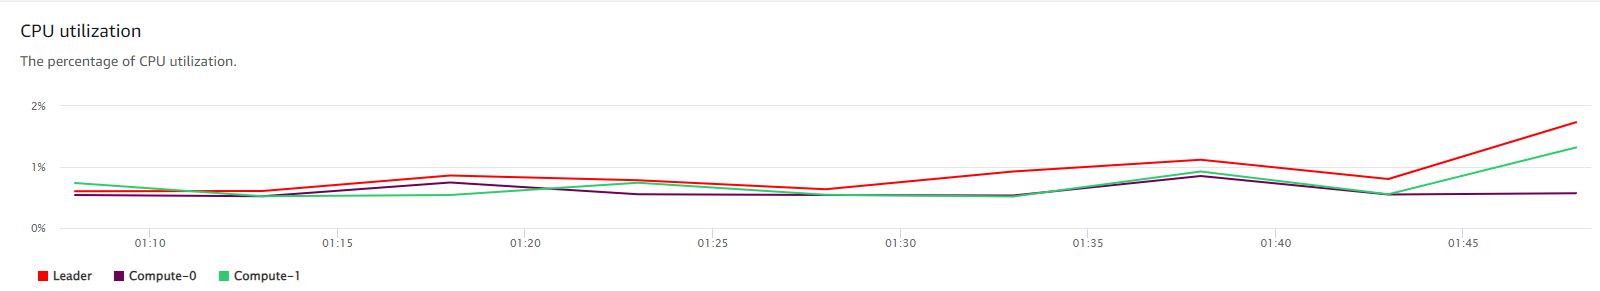
Kümemizin CPU Kullanımı
Redshift’in performansını etkileyen başlıca faktörler şunlardır:
Kümemizin performansını optimize etmek için tablo tasarımı ve veri yönetiminde en iyi uygulamaları takip etmek önemlidir. Küçük bir veri kümesiyle bile bu uygulamaları hayata geçirmek, gelecekteki büyüme ve performans verimliliği için sağlam bir temel oluşturur.
Kümenin düzenli izlenmesi ve bakımı, en iyi performans ve maliyet verimliliğini sağlamak için esastır. Aşağıdaki görsel, aylık Redshift maliyetlerimizin dökümünü sunarak maliyet optimizasyonu fırsatlarını ortaya koyuyor.
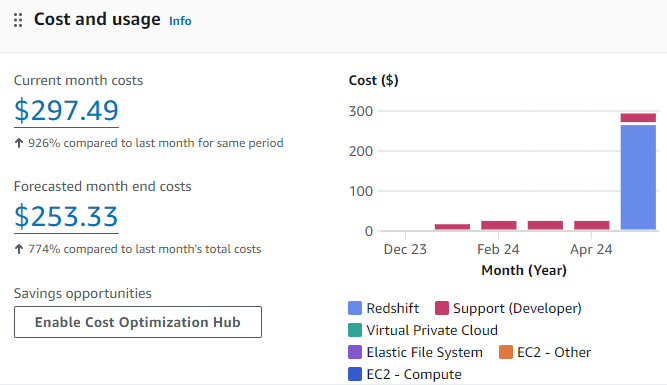
Mevcut Redshift kullanım durumuna ilişkin maliyet ve kullanım grafiği
Yukarıdaki görsele göre, Redshift kümemiz mevcut küçük veri kümemiz için fazla sağlanmış görünmekte; bu da düşük kullanım ve maliyet verimsizlikleriyle sonuçlanmaktadır.
Amazon CloudWatch ve AWS Management Console gibi AWS araçlarını kullanarak CPU kullanımı ve sorgu performansı dahil kilit performans metriklerini izleyebiliriz. Bu içgörüler, olası sorunları belirlememize ve küme optimizasyonu için veriye dayalı kararlar almamıza yardımcı olabilir.
Kümemizin düşük kullanımını göz önünde bulundurarak şu maliyet optimizasyonu stratejilerini değerlendirebiliriz:
Veri hacmi büyüdükçe ve iş yükü geliştikçe, kümemizin performansını sürekli izleyin ve buna göre örnek boyutlandırmayı ve optimizasyon stratejilerini yeniden değerlendirin.
Amazon Redshift’te hassas verilerle çalışırken en yüksek güvenlik ve uyum standartlarını sağlamak önemlidir. Kuruluşlar artan düzenleyici gereksinimlerle ve hassas bilgileri koruma ihtiyacıyla karşı karşıya olduğundan, sağlam güvenlik önlemleri uygulamak ve uyum yönergelerine bağlı kalmak Redshift kümemizi yönetmenin kritik yönleridir.
Sektöre özgü düzenlemelere ve veri koruma yasalarına uyum, hassas verilerle uğraşan kuruluşlar için önceliklidir. Amazon Redshift, bu uyum gereksinimlerini etkin biçimde karşılamamıza yardımcı olacak özellikler ve yetenekler sağlar.
Uyumun yanı sıra, Amazon Redshift’te veri güvenliği için en iyi uygulamaları hayata geçirmek; hassas bilgilerin yetkisiz erişime ve olası ihlallere karşı korunması açısından kritik öneme sahiptir.
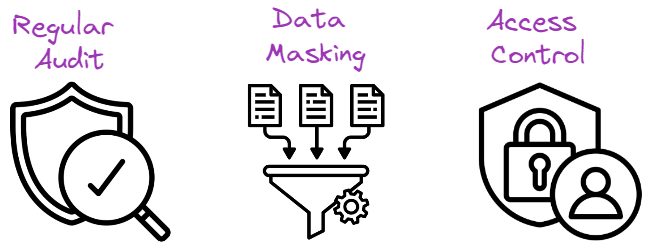
Veri güvenliği için en iyi uygulamalar
Düzenli güvenlik denetimleri yapmak; güvenlik açıklarını belirlemek, mevcut güvenlik önlemlerinin etkinliğini değerlendirmek ve sürekli uyumu sağlamak için gereklidir. Aşağıdaki denetim uygulamalarını göz önünde bulundurun:
Veri maskeleme, verinin yapısını ve biçimini korurken hassas öğelerin maskelenmesini içeren bir tekniktir. Hassas bilgileri maskeleyerek yetkisiz erişime karşı koruyabilir ve veri gizliliğini sürdürebiliriz. Amazon Redshift’te veri maskeleme için bazı yaklaşımlar aşağıdadır:
Güçlü erişim kontrol mekanizmaları uygulamak, Amazon Redshift kümemizdeki hassas verilere yalnızca yetkili kişilerin erişmesini sağlamak için kritiktir. Bu mekanizmalar şu şekilde uygulanabilir:
Bu makalede, veri ambarı için Amazon Redshift kullanımının temel ve ileri düzey yönlerini inceledik. Veri ambarının önemini ve Amazon Redshift’in SQL kullanarak büyük veri kümelerini analiz etmek için güçlü, ölçeklenebilir ve maliyet etkin bir çözüm sunduğunu anlayarak başladık.
Ardından, önkoşullar, küme oluşturma ve yapılandırma ayarları dahil olmak üzere bir Amazon Redshift kümesi kurma sürecini adım adım ele aldık. Ayrıca, AWS S3 ve COPY komutunu kullanarak Redshift’e veri yüklemenin ayrıntılarına, sözdizimi örnekleri ve açıklamalarıyla birlikte değindik.
Buna ek olarak, Redshift’te veriyi sorgulamanın esaslarını; temel SQL sorgularından pencere işlevleri ve karmaşık birleştirmeler gibi ileri tekniklere kadar ele aldık. Redshift’te performans ayarını tartışarak, dağıtım stilleri, sıralama anahtarları ve sıkıştırma kodlaması gibi sorgu performansını optimize etmeye yönelik en iyi uygulamaların altını çizdik.
Son olarak, Amazon Redshift’te güvenlik ve uyumun önemini vurguladık; şifreleme ve erişim kontrolü gibi güvenlik özelliklerinin yanı sıra uyumla ilgili hususları ele aldık.
Amazon Redshift ve AWS ile çalışma konusundaki bilgi ve becerilerini genişletmek isteyenler için aşağıdaki DataCamp kaynaklarını incelemek faydalı olacaktır:
Amazon Redshift’i ustalıkla kullanarak ve yeteneklerinden yararlanarak, kullanıcılar verilerinden değerli içgörüler ortaya çıkarabilir ve veriye dayalı kararlar alabilir.
Veri Mühendisliği Yolculuğunuza Bugün Devam Edin!
Kurs
Program
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme




