
Khóa học
Tìm hiểu Data Engineering
2 giờ
377.9K
Dữ liệu là nền tảng của các tổ chức hiện đại, nhưng khối lượng thông tin khổng lồ được thu thập và lưu trữ có thể khó quản lý. Chìa khóa thành công nằm ở việc tổ chức và phân tích dữ liệu hiệu quả để khám phá những thông tin giá trị giúp đưa ra quyết định sáng suốt.
Đó là lúc kho dữ liệu phát huy tác dụng. Đây là một giải pháp mạnh mẽ cho phép doanh nghiệp hợp nhất và tối ưu hóa dữ liệu để phân tích hiệu quả. Và khi nói đến kho dữ liệu, AWS Redshift nổi bật như một lựa chọn hàng đầu.
Trong bài viết này, chúng ta sẽ khám phá chi tiết AWS Redshift, cùng các tính năng cốt lõi, lợi ích và thực tiễn tốt nhất cho việc thiết lập, nạp dữ liệu, truy vấn, tinh chỉnh hiệu năng, bảo mật và tích hợp.
Dù bạn là chuyên gia dữ liệu hay lãnh đạo doanh nghiệp muốn khai thác tối đa dữ liệu của mình, bài viết này sẽ cung cấp kiến thức và công cụ cần thiết để bạn thành công với AWS Redshift.
Kho dữ liệu là quy trình thu thập, lưu trữ và quản lý lượng lớn dữ liệu có cấu trúc từ nhiều nguồn trong một tổ chức.
Mục tiêu chính của kho dữ liệu là cung cấp một kho thông tin tập trung có thể dễ dàng truy cập, phân tích và sử dụng cho mục đích báo cáo và ra quyết định.
Kho dữ liệu được thiết kế để hỗ trợ các truy vấn và phân tích dữ liệu phức tạp, giúp doanh nghiệp khai thác thông tin giá trị từ dữ liệu của mình.
Áp dụng kho dữ liệu có thể mang lại cho tổ chức nhiều lợi ích đáng kể:
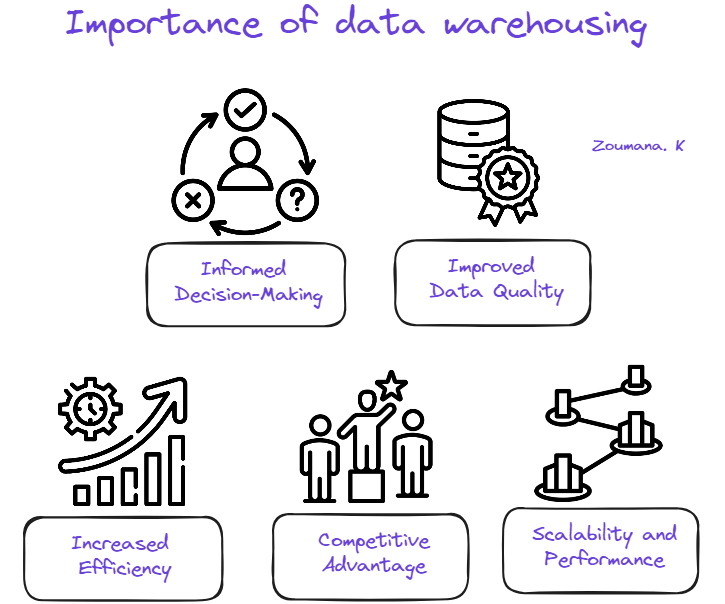
Tầm quan trọng của kho dữ liệu
AWS Redshift là dịch vụ kho dữ liệu trên đám mây được quản lý hoàn toàn, cho phép lưu trữ và phân tích tập dữ liệu ở quy mô petabyte. Với AWS Redshift Serverless, người dùng có thể truy cập và phân tích dữ liệu mà không cần tự tay cấu hình kho dữ liệu cấp phát trước.
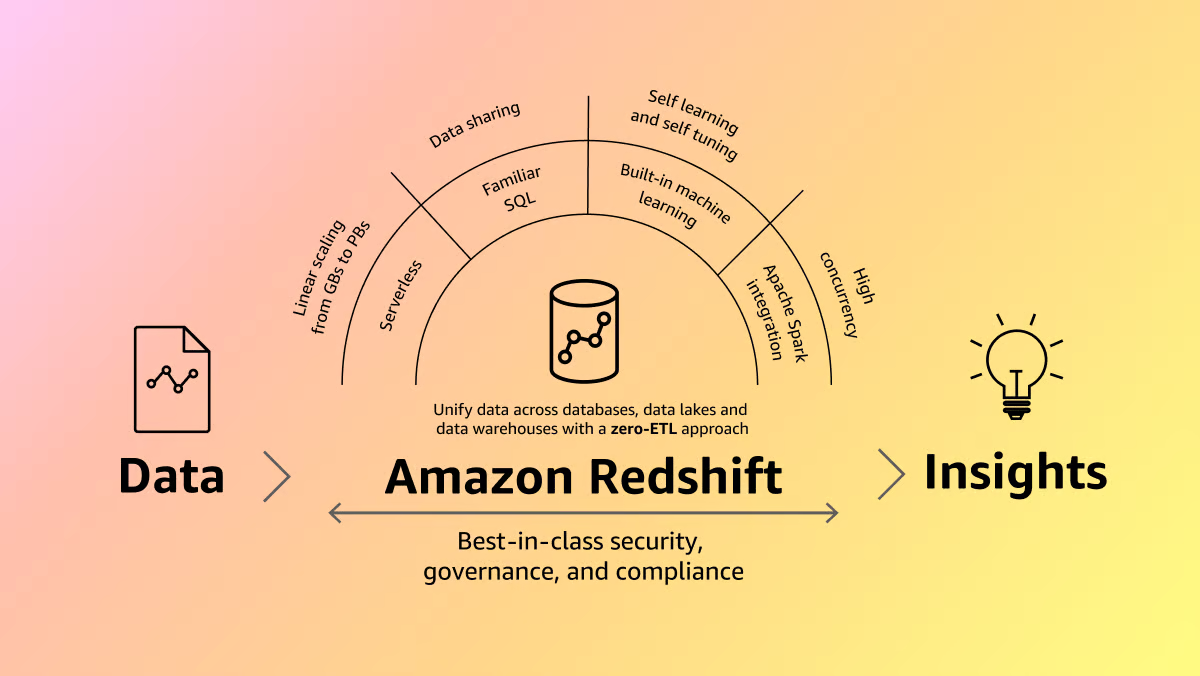
Amazon Redshift (Nguồn)
Dịch vụ tự động cấp phát tài nguyên và mở rộng thông minh dung lượng kho dữ liệu để đảm bảo hiệu năng nhanh, ngay cả với khối lượng công việc đòi hỏi cao và khó dự đoán. Người dùng chỉ trả tiền cho tài nguyên sử dụng, không phát sinh chi phí khi kho dữ liệu ở trạng thái nhàn rỗi.
AWS Redshift cho phép người dùng nạp dữ liệu và bắt đầu truy vấn ngay bằng Amazon Redshift query editor v2 hoặc công cụ BI (business intelligence) ưa thích. Dịch vụ mang lại tỷ lệ giá/thành hiệu năng tốt và các tính năng SQL quen thuộc trong một môi trường dễ dùng, không cần quản trị.
Bất kể kích thước tập dữ liệu, AWS Redshift đều cung cấp hiệu năng truy vấn nhanh với cùng các công cụ dựa trên SQL và ứng dụng BI đang được sử dụng phổ biến hiện nay.
AWS Redshift cung cấp nhiều tính năng và lợi ích giúp tổ chức lưu trữ, quản lý và phân tích hiệu quả khối lượng dữ liệu lớn. Một số tính năng và lợi ích chính được minh họa dưới đây:
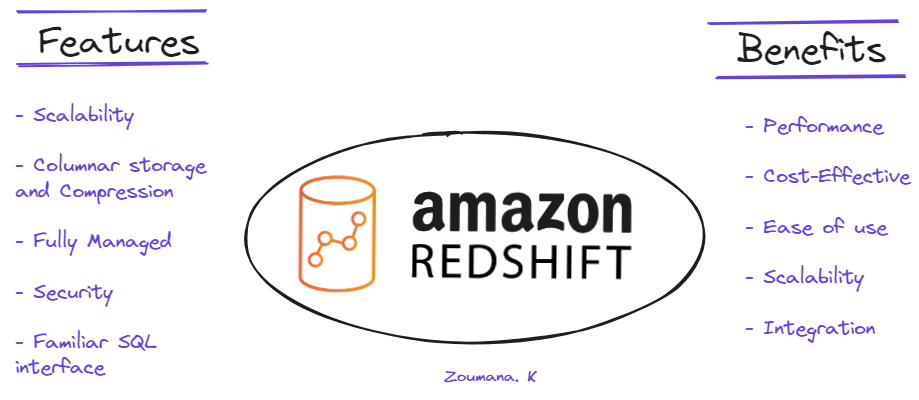
Các tính năng và lợi ích của AWS Redshift
Các phần trước chủ yếu tập trung vào hiểu biết tổng quan về Redshift. Giờ chúng ta sẽ đi vào khía cạnh kỹ thuật.
Phần này trước hết trình bày các điều kiện tiên quyết chính để thiết lập AWS Redshift thành công, sau đó hướng dẫn quy trình từng bước tạo cụm Redshift. Phần cuối tập trung giải thích chi tiết các thiết lập then chốt của cụm, như loại nút, số lượng nút và cấu hình bảo mật.
Trước khi đi sâu vào chi tiết trường hợp sử dụng, hãy điểm qua các điều kiện cần thiết để triển khai thành công:
Phần này cung cấp đầy đủ các bước để tạo một cụm Redshift qua AWS Management Console trong 11 bước đơn giản, như minh họa dưới đây:
1. Tìm Redshift từ console, và chọn “Amazon Redshift”:
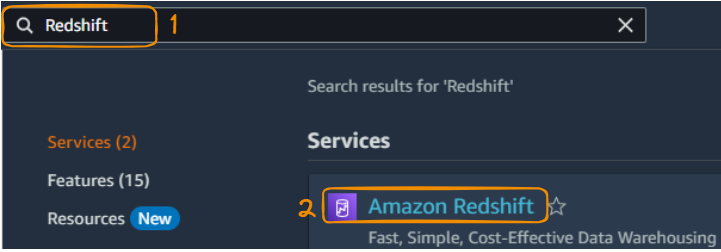
Tìm và chọn Redshift từ Management Console
2. Chọn nút “Create Cluster” để bắt đầu tạo cụm.
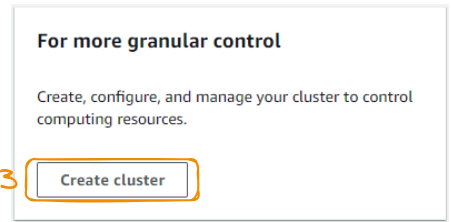
Nút tạo cụm
3. Từ thao tác trên, chúng ta có thể cấu hình cụm bằng cách cung cấp thông tin như định danh cụm, kích thước cụm, loại nút, lựa chọn vùng khả dụng, số lượng nút.
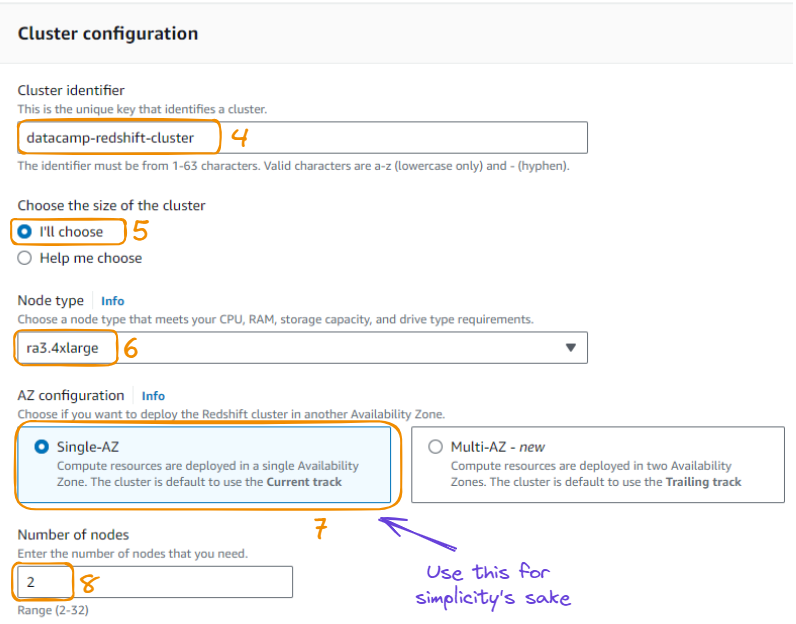
Cấu hình cụm trong 8 bước
4. Thay vì dùng dữ liệu mẫu như được gợi ý trên cùng trang, chúng ta sẽ dùng dữ liệu từ một S3 bucket để nạp vào Redshift.
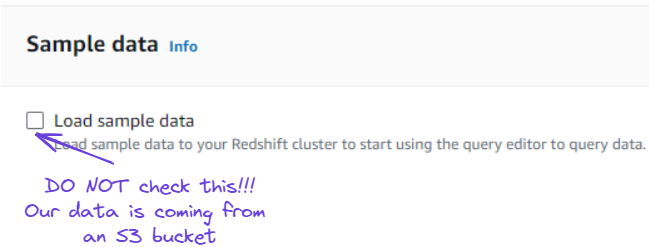
Bỏ qua tùy chọn nạp dữ liệu mẫu
5. Chúng ta có thể xác định quyền của cụm bằng cách cung cấp vai trò IAM. Phần này có thể bỏ qua và xử lý sau.
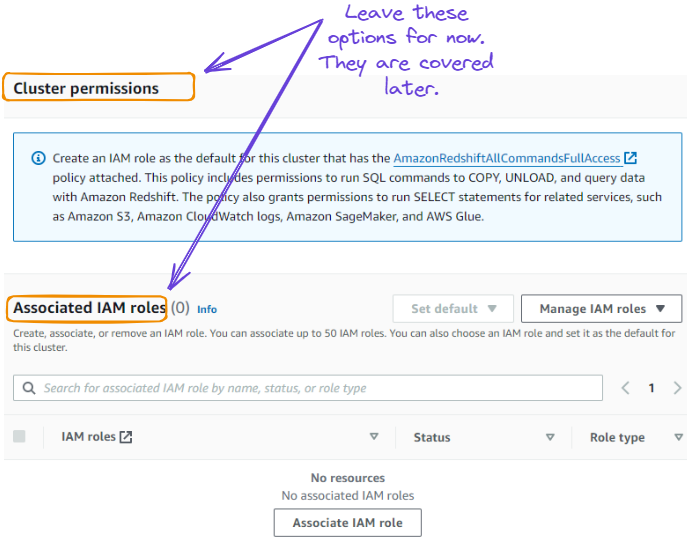
Bỏ qua phân quyền cụm và vai trò IAM
6. Giữ nguyên cấu hình mặc định cho mạng, bảo mật, sao lưu, bảo trì, và chọn nút “Create cluster” để tạo cụm.
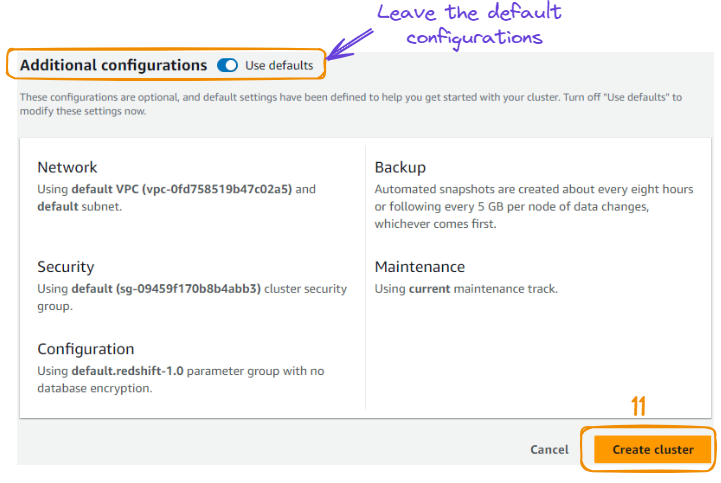
Tạo cụm
7. Sau thao tác trên, chúng ta được chuyển đến trang mới hiển thị cụm vừa tạo. Có thể mất vài phút để tạo thành công, và có thể theo dõi ở mục “Status”, từ “Creating” đến “Available”.
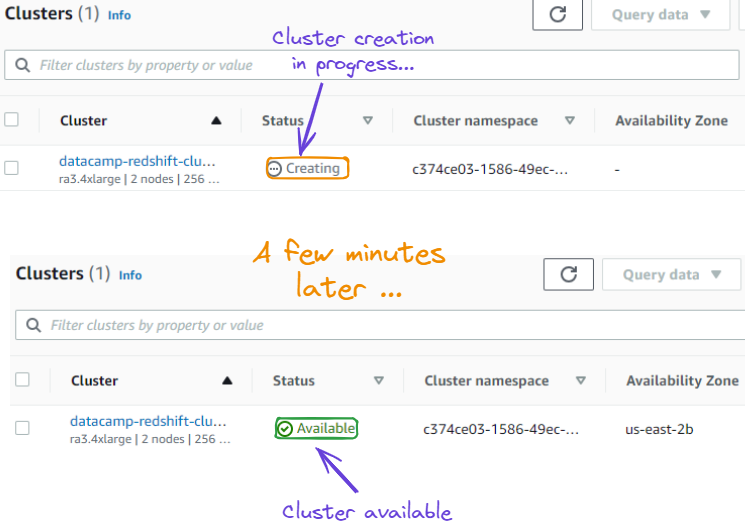
Trạng thái cụm từ “Creating” đến “Available”
Chúng ta đã tạo thành công các cụm Redshift. Phần này hướng dẫn toàn bộ bước, từ chọn bộ dữ liệu GDP Quốc gia, Khu vực và Thế giới có trên DataLab của chúng tôi đến tải lên một S3 bucket.
Dữ liệu của chúng tôi có nguồn gốc từ bộ dữ liệu của World Bank. Nội dung là GDP của các quốc gia, khu vực và thế giới tính theo đô la Mỹ hiện hành ($). Khu vực đề cập đến tập hợp quốc gia, như Châu Âu và Trung Á.
Mười quan sát đầu tiên của dữ liệu trông như sau:
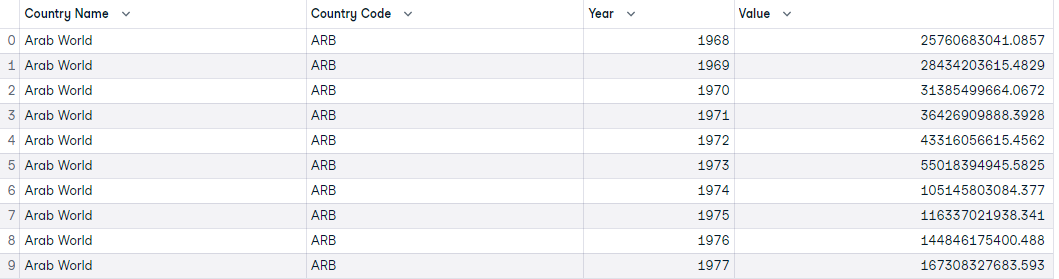
Mười quan sát đầu tiên của dữ liệu GDP
Để tương tác thành công giữa S3 và Redshift, trước tiên chúng ta cần tạo một vai trò IAM rồi mới tạo S3 bucket để lưu dữ liệu.
Lợi ích của việc tạo vai trò IAM là tạo kết nối giữa cụm Redshift và S3 bucket nơi dữ liệu được lưu trữ.
Tạo vai trò IAM được thực hiện như sau:
Từ Management Console, tìm “IAM” và chọn logo “IAM” từ kết quả tìm kiếm.
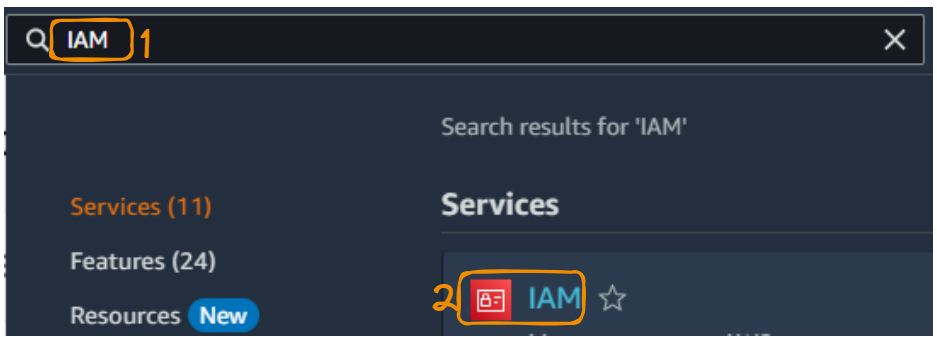
Dịch vụ IAM từ Management Console
Chọn “Roles” để hiển thị tất cả vai trò có thể có, và chọn “Create role” để tạo vai trò mới.
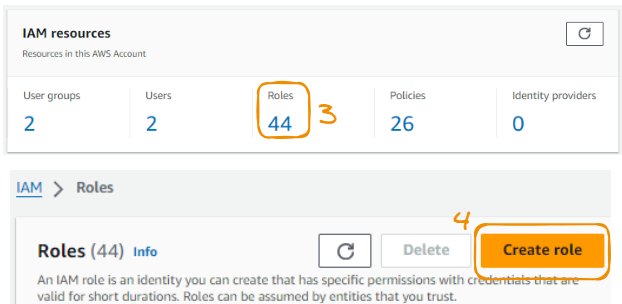
Bắt đầu tạo vai trò mới
Chọn “AWS service” tại “Trusted entity type”, sau đó “Redshift” ở “Use case”, và “Next” để tiếp tục.
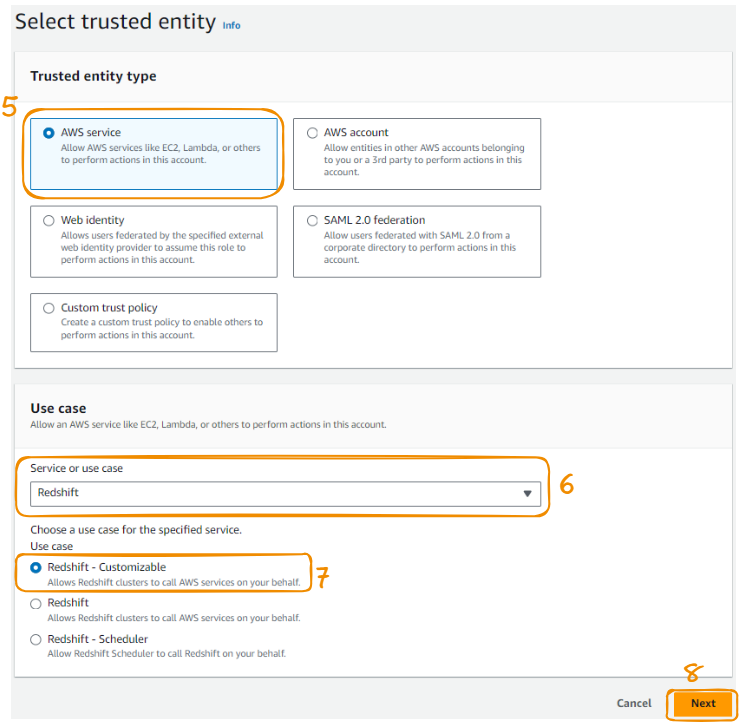
Các bước 5 đến 8 của việc tạo vai trò AMI
Tìm “S3FullAccess” ở ô tìm kiếm, sau đó tích chọn tùy chọn này và chọn “Next”.
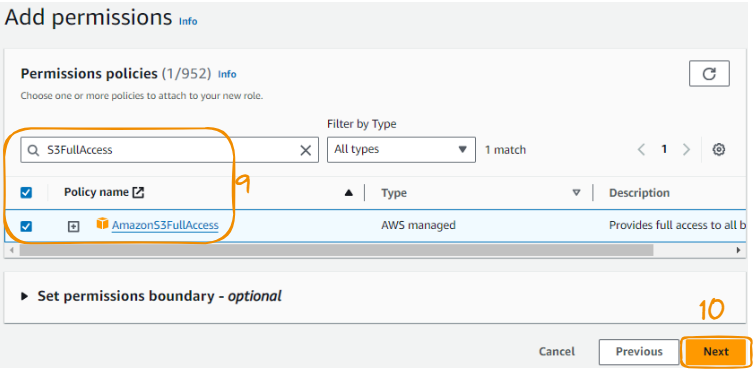
Các bước 9 đến 10 của việc tạo vai trò AMI
Cuối cùng, đặt tên vai trò, xem lại và chọn nút “Create role” để hoàn tất việc tạo vai trò.
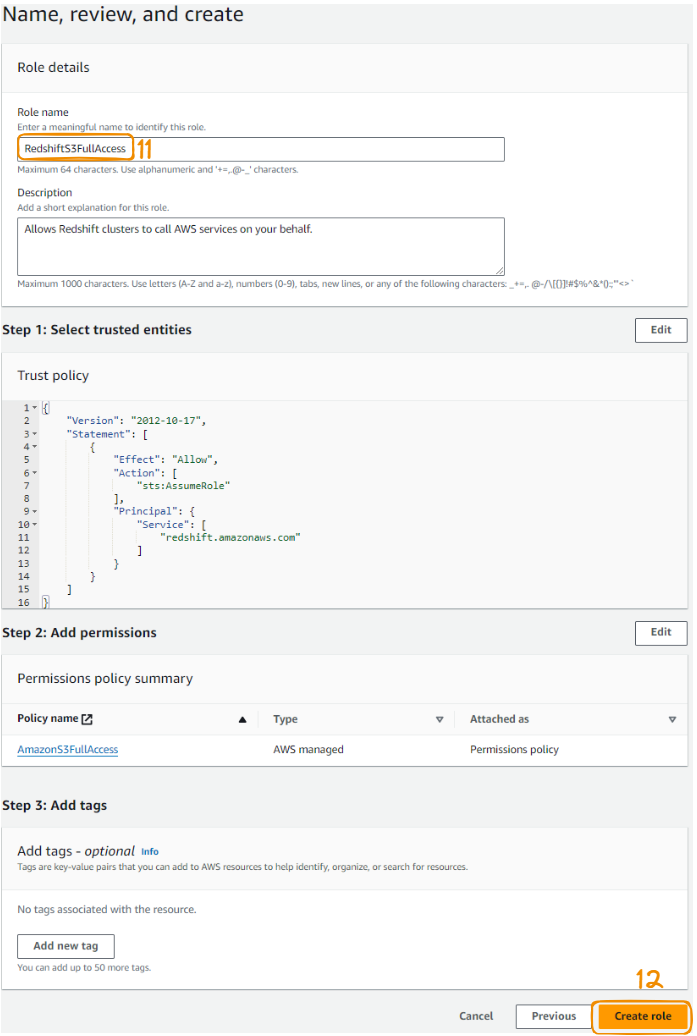
Các bước 11 đến 12 của việc tạo vai trò AMI
Khi mọi thứ thành công, thông báo màu xanh xác nhận tạo vai trò sẽ hiển thị ở góc trên.
Thông báo xác nhận tạo vai trò
Giờ chúng ta đã có vai trò IAM, có thể dùng để liên kết với cụm Redshift đã tạo ban đầu, thực hiện như sau:
Từ phần cụm, chọn cụm datacamp đã tạo, và dưới mục “Actions”, chọn “Manage IAM roles”.
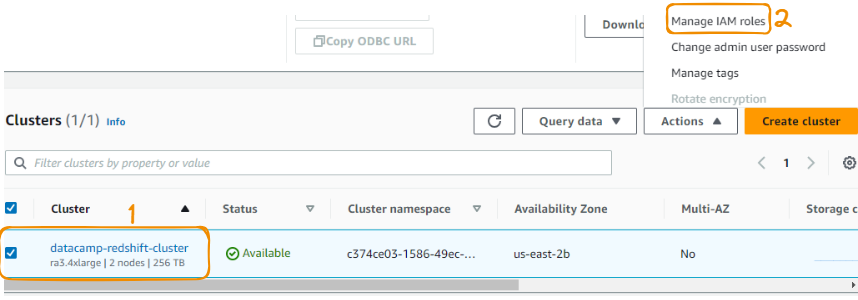
Liên kết vai trò IAM với Redshift bước 1 đến 2
Trong phần này, chọn vai trò IAM đã tạo trước đó và lưu thay đổi.
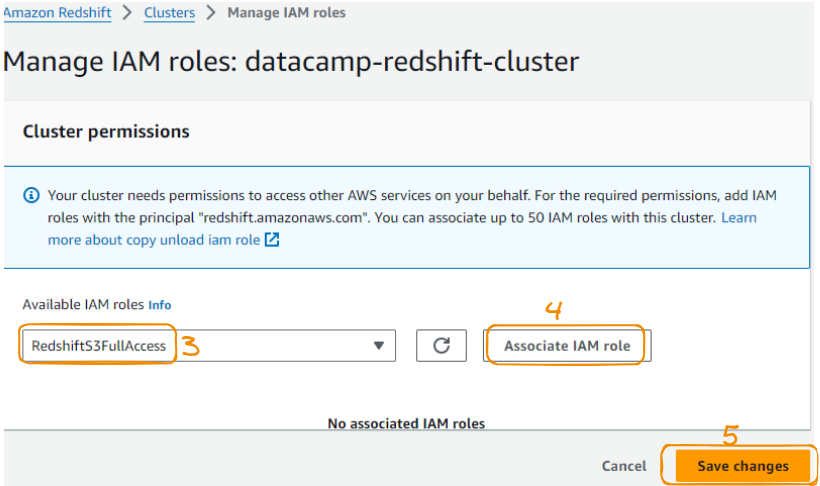
Liên kết vai trò IAM với Redshift bước 3 đến 4
Có nhiều công cụ để truy vấn dữ liệu từ Redshift. Một số là dịch vụ sẵn có trong AWS, số khác là công cụ bên ngoài. Trong phạm vi hướng dẫn này, chúng ta dùng query editor từ Redshift Dashboard.
Để sử dụng, trước hết cần tạo kết nối tới Query editor như sau, bắt đầu từ tùy chọn “Query in query editor” trong thẻ “Query data”:
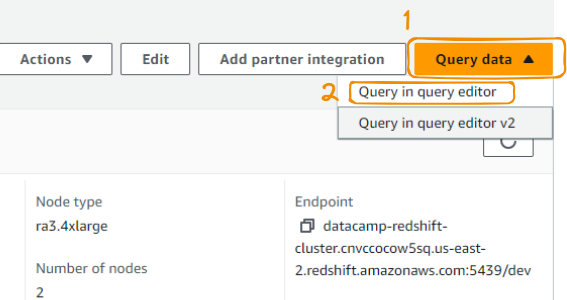
Query editor từ thẻ query data
Thao tác trên dẫn tới trang sau, nơi chúng ta có thể kết nối tới cơ sở dữ liệu sau khi đặt tên và cung cấp tên người dùng như sau:
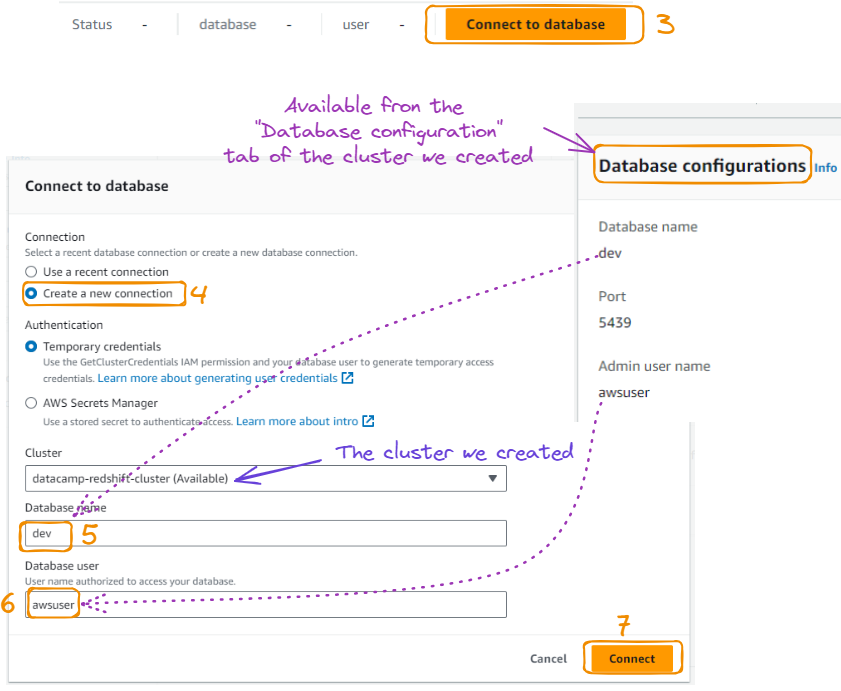
Kết nối cơ sở dữ liệu từ query editor
Sau khi nhấn nút “Connect”, chúng ta sẽ thấy thẻ màu xanh “Connected” ở trên cùng và thông tin cơ sở dữ liệu ở bên trái.
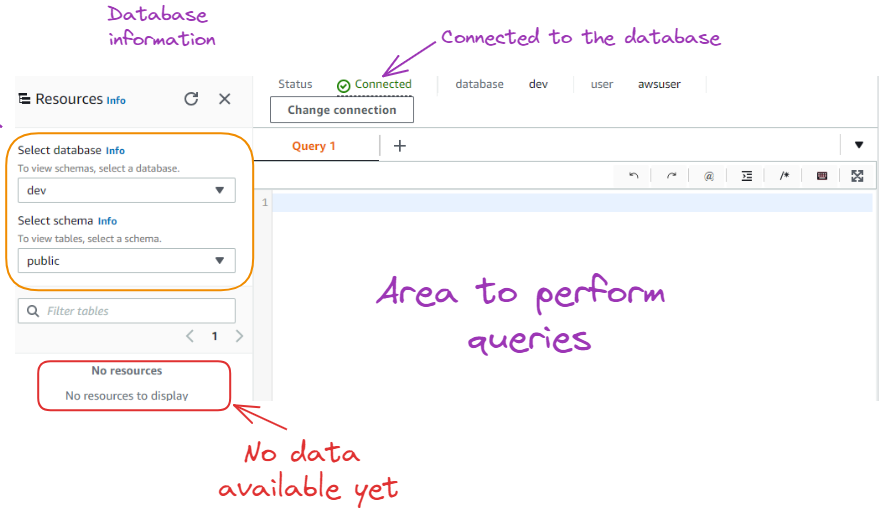
Kết quả sau khi kết nối tới cơ sở dữ liệu
Như thấy ở trên, hiện chưa có tài nguyên/dữ liệu nào trong cơ sở dữ liệu. Trước khi nhập dữ liệu, trước hết cần tạo một bảng có đặc tính tương tự dữ liệu sẽ nhập.
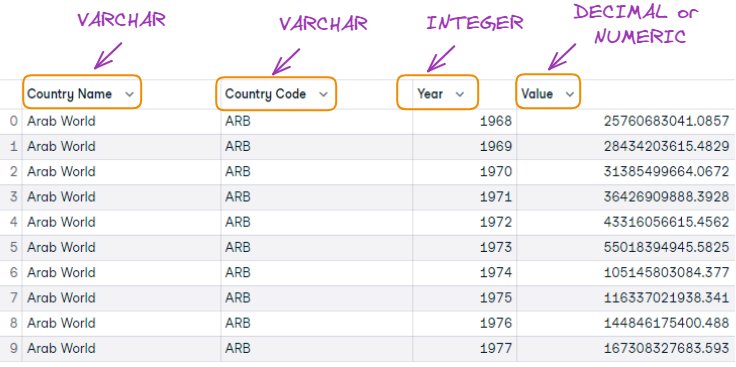
Khớp định dạng 10 quan sát đầu và các cột của bảng
Bảng được tạo bằng truy vấn SQL sau:
CREATE TABLE gdp_data (
id INTEGER PRIMARY KEY,
country_name VARCHAR(255),
country_code VARCHAR(10),
year INTEGER,
value DECIMAL(20,2)
);
Dưới đây là giải thích truy vấn SQL với một gạch đầu dòng cho mỗi cột:
id INTEGER PRIMARY KEY: Tạo cột "id" kiểu INTEGER và đặt làm khóa chính của bảng, đảm bảo giá trị duy nhất cho mỗi hàng.country_name VARCHAR(255): Tạo cột "country_name" kiểu VARCHAR, cho phép lưu chuỗi tối đa 255 ký tự.country_code VARCHAR(10): Tạo cột "country_code" kiểu VARCHAR, cho phép lưu chuỗi tối đa 10 ký tự.year INTEGER: Tạo cột "year" kiểu INTEGER, phù hợp để lưu số nguyên (trong trường hợp này là năm).value DECIMAL(20,2): Tạo cột "value" kiểu DECIMAL, cho phép lưu số thập phân với độ chính xác 20 chữ số và 2 chữ số thập phân.Bây giờ, chúng ta chạy truy vấn để tạo bảng:
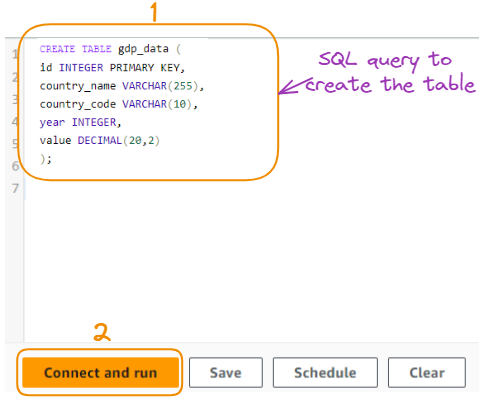
Truy vấn tạo bảng
Truy vấn này tạo một bảng tên "gdp_data" với các cột được chỉ định để lưu dữ liệu GDP như hiển thị bên dưới:
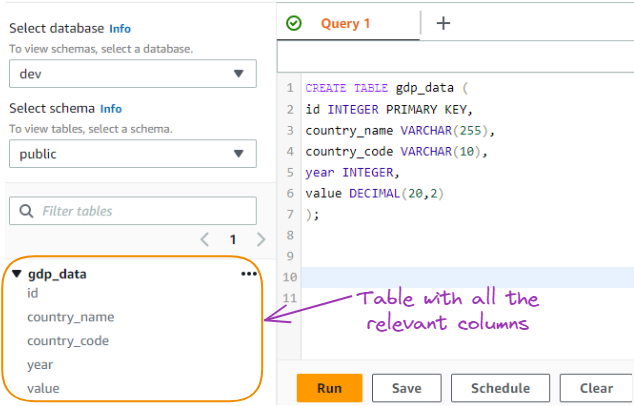
Bảng dữ liệu GDP được tạo từ truy vấn SQL
Dữ liệu sẽ được nhập vào bảng từ một S3 bucket. Phần này bao quát mọi bước tạo bucket và tải dữ liệu lên.
Tìm dịch vụ S3 từ Management Console, chọn logo tương ứng, và đặt tên trong khi giữ nguyên các thiết lập mặc định khác:
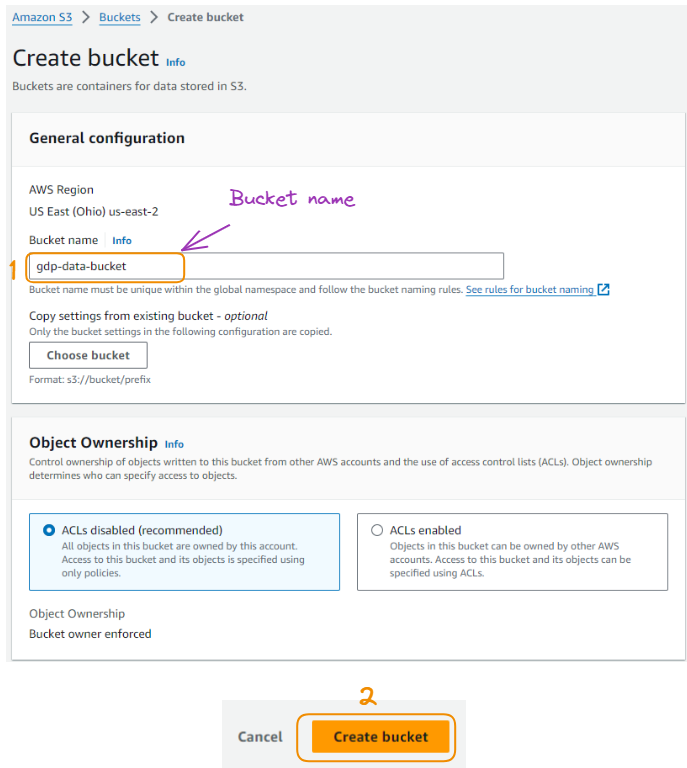
Tạo S3 bucket
Khi bucket được tạo, nó sẽ xuất hiện trong danh sách tất cả bucket đã tạo trước đó.
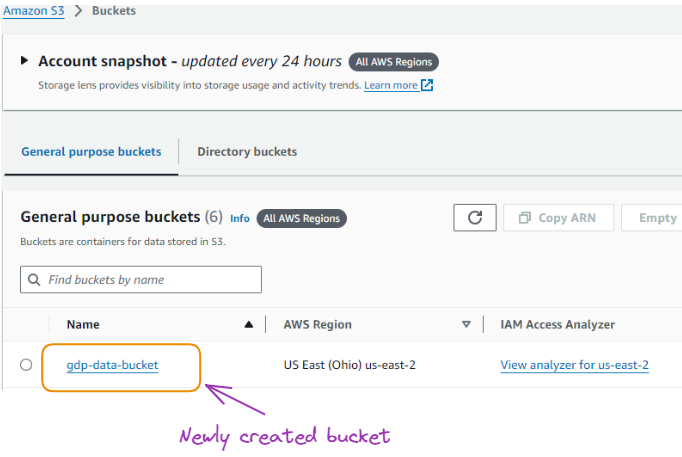
Bucket vừa được tạo
Từ đó, chúng ta có thể chọn tên bucket và tải dữ liệu GDP đã tải về cục bộ ở định dạng CSV lên.
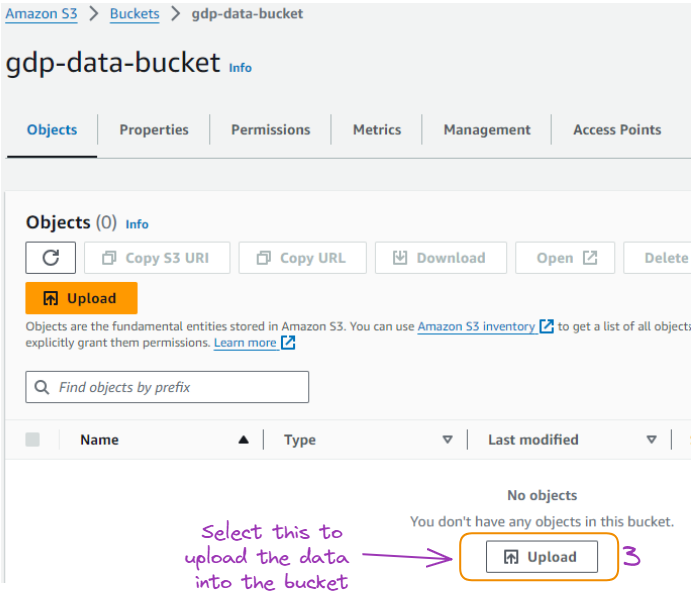
Trang tải dữ liệu vào bucket
Sau khi nhập dữ liệu thành công, dữ liệu sẽ hiển thị như sau:
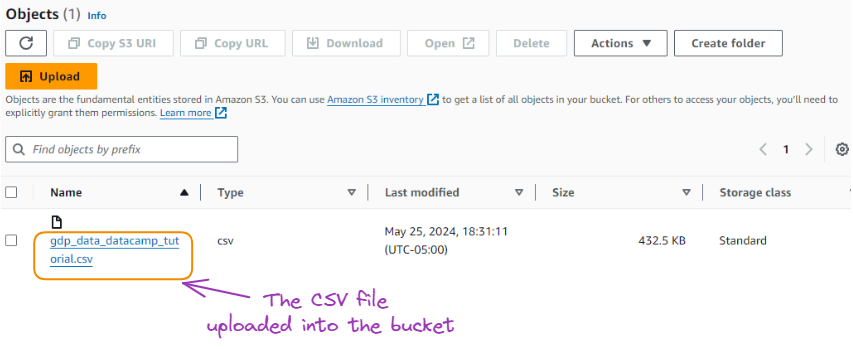
Tệp CSV đã được tải lên bucket
Chúc mừng bạn đã đi tới bước này!
Phần này minh họa cách sao chép dữ liệu từ S3 vào Redshift như sau.
COPY gdp_data (id, country_name, country_code, year, value)
FROM 's3://gdp-data-bucket/gdp/gdp_data.csv'
IAM_ROLE 'arn:aws:iam::654654631565:role/RedshiftS3FullAccess'
CSV
IGNOREHEADER 1;
Hãy cùng hiểu điều gì đang diễn ra tại đây:
Cùng đoạn mã đó trong trình soạn thảo được hiển thị bên dưới, và thao tác copy đã hoàn tất thành công sau vài giây:
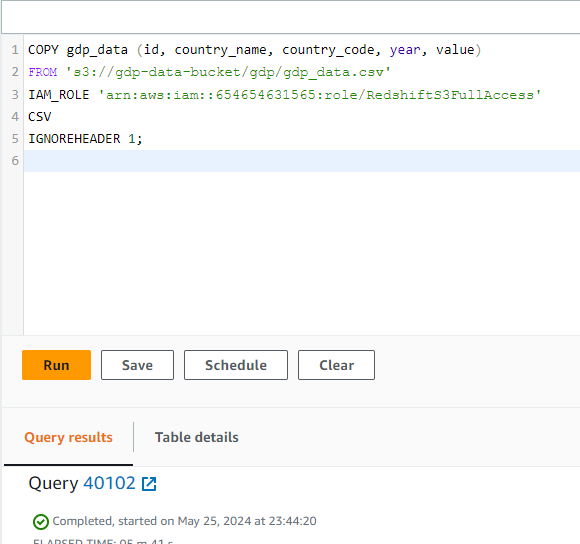
Tác vụ COPY đã hoàn tất
Thay vì tải toàn bộ dữ liệu từ tệp CSV gốc, chỉ một mẫu ngẫu nhiên gồm một trăm quan sát được tải lên cho đơn giản. Chúng ta có thể xem trước dữ liệu bằng cách chọn tùy chọn “Preview data” như sau:
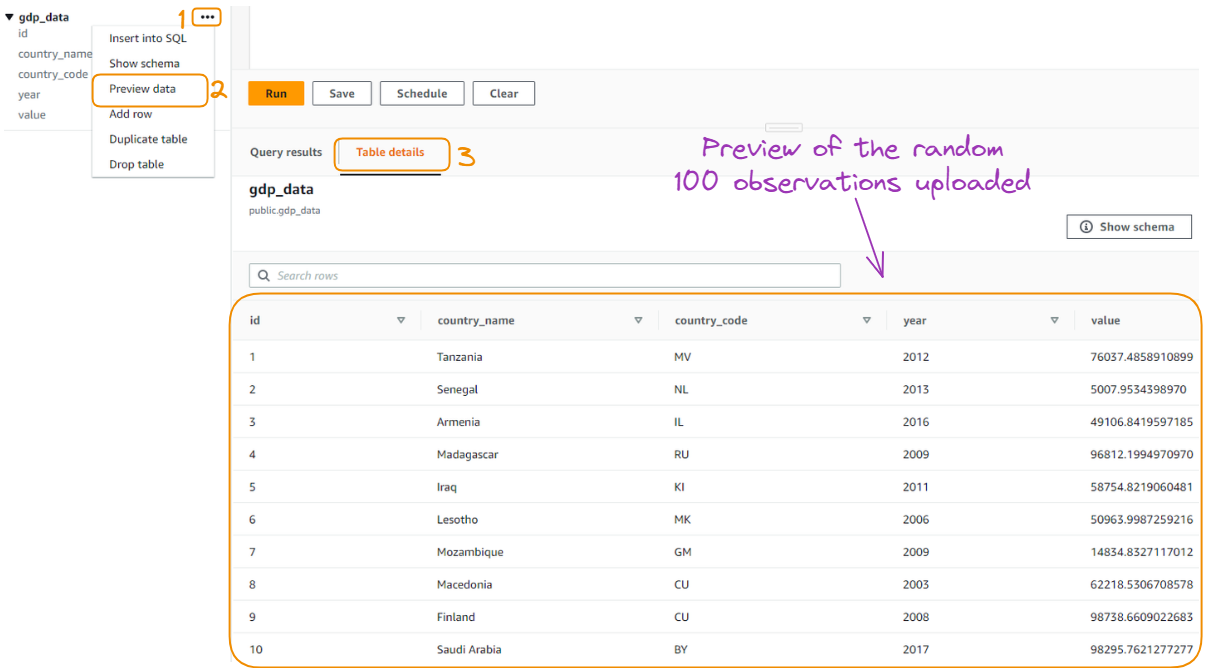
Xem trước 100 quan sát được tải ngẫu nhiên
Xem trước dữ liệu chỉ hiển thị mười quan sát đầu tiên. Tuy nhiên, chúng ta có thể muốn tương tác nhiều hơn với dữ liệu để có thêm insight, khi đó kỹ năng SQL sẽ rất hữu ích.
Trong phần này, chúng ta khám phá dữ liệu thông qua một số truy vấn SQL.
Chúng ta sử dụng năm truy vấn SQL để tương tác với dữ liệu lưu trong cơ sở dữ liệu, bắt đầu với truy vấn phổ biến nhất: chọn dữ liệu.
Chọn tất cả dữ liệu
SELECT *
FROM gdp_data;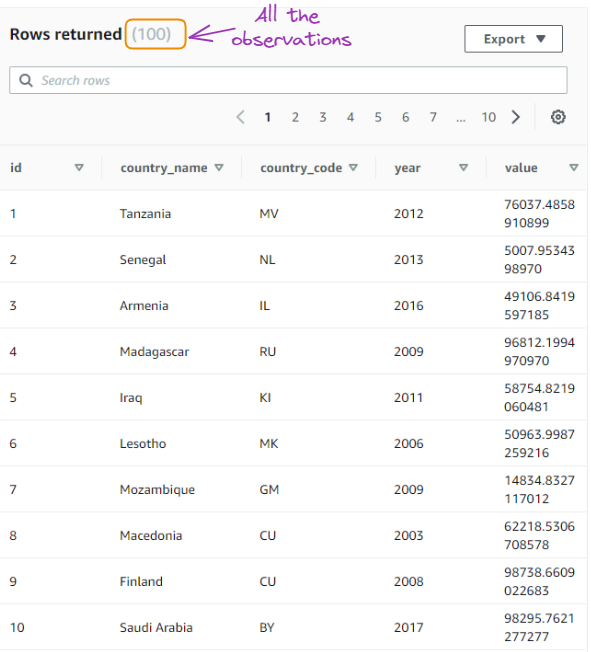
Kết quả truy vấn thứ nhất
Chọn dữ liệu cho một quốc gia cụ thể:
SELECT * FROM gdp_data
WHERE country_name = 'Senegal';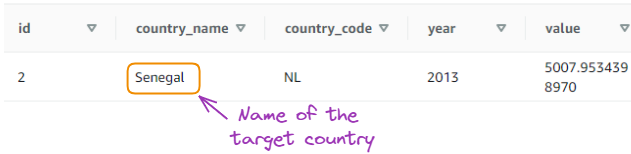
Kết quả truy vấn thứ hai
Tính GDP trung bình cho một năm cụ thể:
SELECT year, AVG(value) as average_gdp
FROM gdp_data
WHERE year = 2020
GROUP BY year;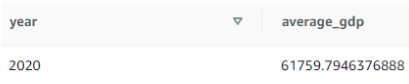
Kết quả truy vấn thứ ba
Tìm 5 quốc gia có GDP cao nhất trong một năm cụ thể:
SELECT country_name, value
FROM gdp_data
WHERE year = 2020
ORDER BY value DESC
LIMIT 5;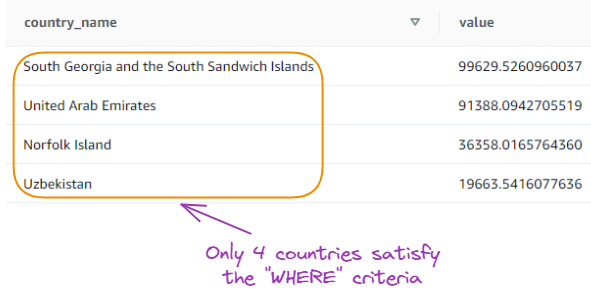
Kết quả truy vấn thứ tư
Đếm số bản ghi theo năm:
SELECT year, COUNT(*) as record_count
FROM gdp_data
GROUP BY year
ORDER BY year;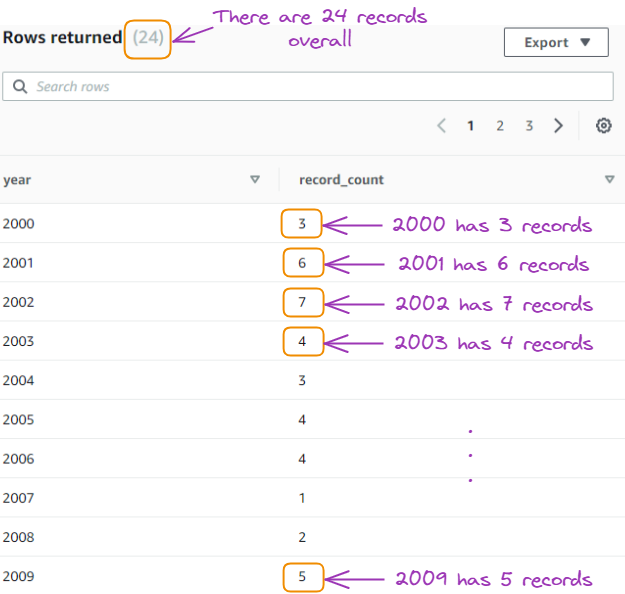
Kết quả truy vấn thứ năm
Các truy vấn trên cung cấp hiểu biết cơ bản về dữ liệu, và phần này tập trung vào ba kỹ thuật truy vấn nâng cao.
Tính tổng lũy kế: Truy vấn này tính tổng lũy kế giá trị GDP cho mỗi quốc gia, sắp xếp theo năm.
SELECT
    country_name,
    year,
    value,
    SUM(value) OVER (PARTITION BY country_name ORDER BY year) as running_total
FROM gdp_data;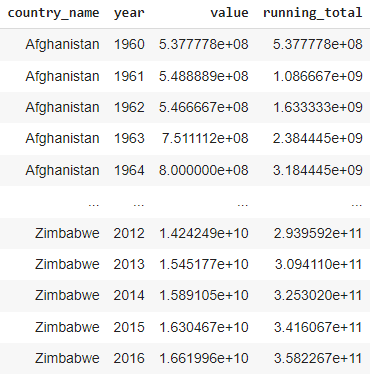
Kết quả tổng lũy kế
CTE để lọc và tổng hợp: truy vấn này dùng CTE để lọc dữ liệu chỉ bao gồm các bản ghi từ năm 2020 trở đi và sau đó tính GDP trung bình cho mỗi quốc gia.
WITH recent_data AS (
    SELECT
        country_name,
        year,
        value
    FROM gdp_data
    WHERE year >= 2020
)
SELECT
    country_name,
    AVG(value) as average_gdp
FROM gdp_data
GROUP BY country_name;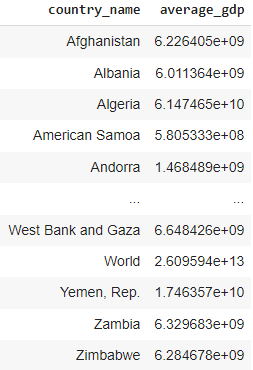
Kết quả từ CTE
Tính tăng trưởng GDP theo năm: với truy vấn này, chúng ta tính phần trăm tăng trưởng GDP theo năm cho từng quốc gia.
SELECT
    a.country_name,
    a.year,
    a.value as current_year_value,
    b.value as previous_year_value,
    (a.value - b.value) / b.value * 100 as growth_percentage
FROM gdp_data a
JOIN gdp_data b
    ON a.country_name = b.country_name
    AND a.year = b.year + 1;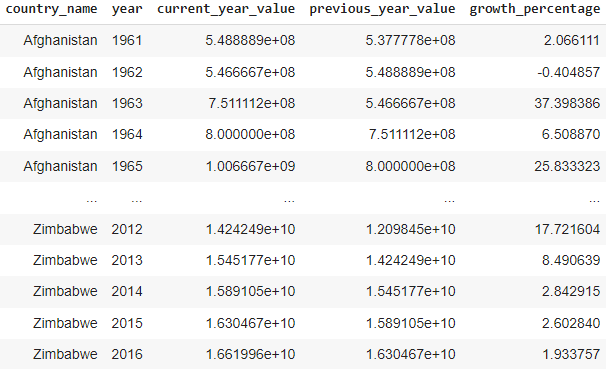
Kết quả truy vấn self join
Để đảm bảo hiệu năng tối ưu và hiệu quả chi phí, điều quan trọng là hiểu các yếu tố ảnh hưởng đến hiệu năng của Redshift và áp dụng thực tiễn tốt nhất để tinh chỉnh cụm của chúng ta.
Trong phần này, chúng ta sẽ khám phá các khía cạnh chính của việc tinh chỉnh hiệu năng Redshift và cung cấp insight dựa trên thông tin cụm đã có.
Hiệu năng trong Amazon Redshift bị ảnh hưởng bởi nhiều yếu tố, từ cấu hình phần cứng đến kỹ thuật tối ưu truy vấn, vì vậy hiểu các yếu tố này là điều cốt yếu để xác định nút thắt và đưa ra quyết định tốt hơn nhằm cải thiện hiệu năng cụm.
Chúng ta đã cấu hình cụm Redshift gồm hai nút ra3.4xlarge, và dữ liệu sử dụng chỉ 391 KB.
Ngoài ra, hình dưới cho thấy mức sử dụng CPU của cụm gần 0% trong suốt khoảng thời gian, cho thấy cụm không được sử dụng nhiều và có thể đã cấp phát dư thừa so với khối lượng công việc hiện tại.
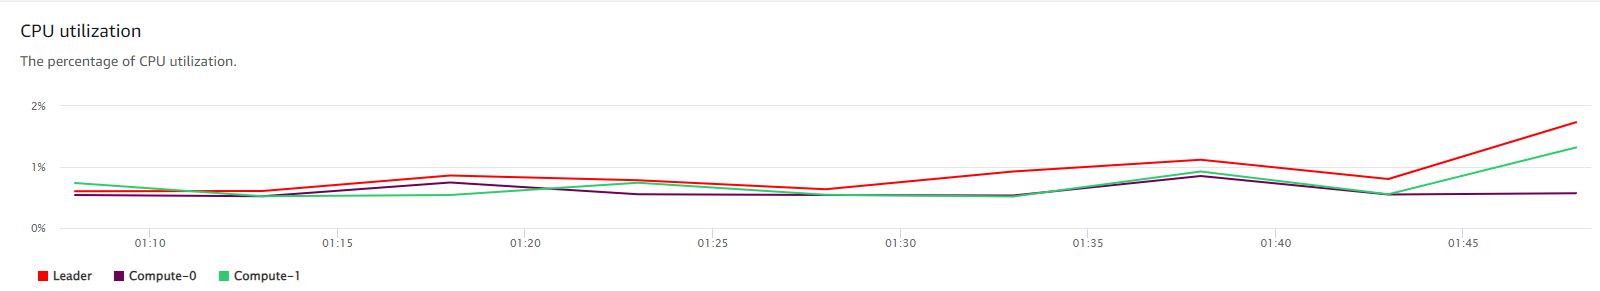
Mức sử dụng CPU của cụm
Một số yếu tố then chốt ảnh hưởng đến hiệu năng của Redshift gồm:
Để tối ưu hiệu năng cụm, điều quan trọng là tuân theo thực tiễn tốt nhất trong thiết kế bảng và quản lý dữ liệu. Ngay cả với tập dữ liệu nhỏ, áp dụng các thực tiễn này sẽ tạo nền tảng vững chắc cho tăng trưởng và hiệu quả hiệu năng trong tương lai.
Việc giám sát và bảo trì thường xuyên cụm là điều cần thiết để đảm bảo hiệu năng tối ưu và hiệu quả chi phí. Hình dưới cung cấp phân tích chi phí Redshift hàng tháng của chúng ta, cho thấy cơ hội tối ưu chi phí.
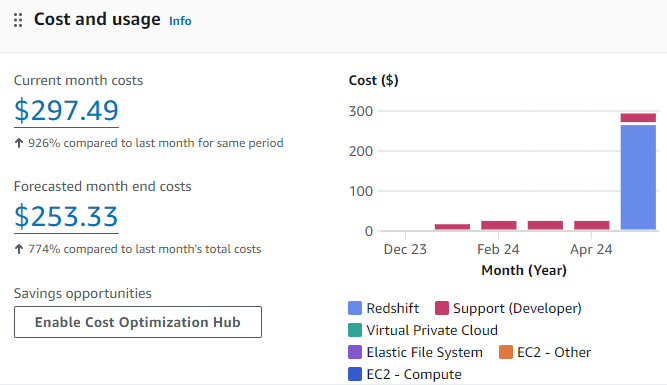
Đồ thị chi phí và mức sử dụng cho trường hợp Redshift hiện tại
Dựa trên hình trên, cụm Redshift của chúng ta dường như được cấp phát dư thừa cho tập dữ liệu nhỏ hiện tại, dẫn tới mức sử dụng thấp và kém hiệu quả chi phí.
Sử dụng các công cụ AWS như Amazon CloudWatch và AWS Management Console, chúng ta có thể theo dõi các chỉ số hiệu năng chính, bao gồm mức sử dụng CPU và hiệu năng truy vấn. Những insight này giúp xác định vấn đề tiềm ẩn và đưa ra quyết định dựa trên dữ liệu để tối ưu cụm.
Với mức sử dụng thấp của cụm hiện tại, chúng ta có thể cân nhắc các chiến lược tối ưu chi phí sau:
Khi khối lượng dữ liệu tăng và khối lượng công việc thay đổi, hãy liên tục giám sát hiệu năng cụm và đánh giá lại kích cỡ phiên bản cùng chiến lược tối ưu tương ứng.
Khi làm việc với dữ liệu nhạy cảm trong Amazon Redshift, đảm bảo tiêu chuẩn cao nhất về bảo mật và tuân thủ là rất quan trọng. Khi các tổ chức đối mặt với yêu cầu quy định ngày càng tăng và nhu cầu bảo vệ thông tin nhạy cảm, việc triển khai các biện pháp bảo mật mạnh mẽ và tuân thủ hướng dẫn trở thành khía cạnh cốt yếu trong quản lý cụm Redshift.
Tuân thủ các quy định theo ngành và luật bảo vệ dữ liệu là ưu tiên hàng đầu đối với các tổ chức xử lý dữ liệu nhạy cảm. Amazon Redshift cung cấp các tính năng và khả năng giúp chúng ta đáp ứng hiệu quả các yêu cầu tuân thủ này.
Bên cạnh yếu tố tuân thủ, áp dụng thực tiễn tốt nhất về bảo mật dữ liệu trong Amazon Redshift là điều quan trọng để bảo vệ thông tin nhạy cảm khỏi truy cập trái phép và rủi ro rò rỉ.
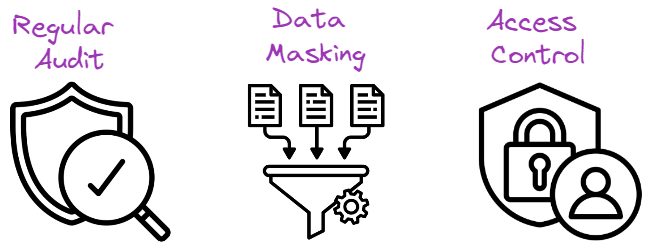
Thực tiễn tốt nhất cho bảo mật dữ liệu
Tiến hành kiểm toán bảo mật thường xuyên là điều cần thiết để xác định lỗ hổng, đánh giá hiệu quả của các biện pháp hiện có và đảm bảo tuân thủ liên tục. Cân nhắc các thực hành kiểm toán sau:
Che giấu dữ liệu là kỹ thuật làm mờ các thành phần dữ liệu nhạy cảm trong khi vẫn giữ cấu trúc và định dạng dữ liệu. Bằng cách che giấu thông tin nhạy cảm, chúng ta có thể bảo vệ khỏi truy cập trái phép và duy trì quyền riêng tư dữ liệu. Dưới đây là một số cách tiếp cận để che giấu dữ liệu trong Amazon Redshift:
Triển khai các cơ chế kiểm soát truy cập mạnh mẽ là điều quan trọng để đảm bảo chỉ những cá nhân được ủy quyền mới có thể truy cập dữ liệu nhạy cảm trong cụm Amazon Redshift của chúng ta. Có thể áp dụng như sau:
Trong bài viết này, chúng ta đã khám phá những nền tảng và khía cạnh nâng cao khi sử dụng Amazon Redshift cho kho dữ liệu. Chúng ta bắt đầu bằng việc hiểu tầm quan trọng của kho dữ liệu và cách Amazon Redshift cung cấp giải pháp mạnh mẽ, có khả năng mở rộng và tiết kiệm chi phí để phân tích các tập dữ liệu lớn bằng SQL.
Sau đó, chúng ta đã đi qua quy trình thiết lập cụm Amazon Redshift, bao gồm điều kiện tiên quyết, tạo cụm và các thiết lập cấu hình. Chúng ta cũng đi sâu vào chi tiết nạp dữ liệu vào Redshift bằng AWS S3 và lệnh COPY, kèm ví dụ cú pháp và giải thích.
Tiếp nữa, chúng ta đã đề cập các yếu tố thiết yếu khi truy vấn dữ liệu trong Redshift, từ truy vấn SQL cơ bản đến kỹ thuật nâng cao như hàm cửa sổ và các phép join phức tạp. Chúng ta cũng thảo luận tinh chỉnh hiệu năng trong Redshift, nhấn mạnh thực tiễn tốt nhất để tối ưu truy vấn, như kiểu phân phối, khóa sắp xếp và mã hóa nén.
Cuối cùng, chúng ta nhấn mạnh tầm quan trọng của bảo mật và tuân thủ trong Amazon Redshift, bao gồm các tính năng bảo mật như mã hóa và kiểm soát truy cập, cũng như các cân nhắc tuân thủ.
Với những ai muốn mở rộng kiến thức và kỹ năng làm việc với Amazon Redshift và AWS, bạn có thể khám phá các tài nguyên DataCamp sau:
Bằng cách thành thạo Amazon Redshift và tận dụng các khả năng của nó, người dùng có thể mở khóa những insight giá trị từ dữ liệu và đưa ra quyết định dựa trên dữ liệu.
Tiếp tục Hành Trình Kỹ Sư Dữ Liệu của Bạn Ngay Hôm Nay!
Khóa học
Lộ trình
Lộ trình