
Cours
Présentation de l’ingénierie des données
2 h
372.7K
Les données sont le socle des organisations modernes, mais le volume massif d’informations collectées et stockées est difficile à gérer. La clé du succès consiste à organiser et analyser efficacement ces données pour en extraire des insights exploitables qui éclairent la prise de décision.
C’est là qu’intervient l’entrepôt de données. Il s’agit d’une solution puissante qui permet de consolider et d’optimiser les données pour une analyse efficace. Et en matière d’entrepôt de données, AWS Redshift s’impose comme un excellent choix.
Dans cet article, nous passons en revue AWS Redshift, ses fonctionnalités clés, ses avantages et les bonnes pratiques pour la configuration, le chargement, l’interrogation, l’optimisation des performances, la sécurité et les intégrations.
Que vous soyez un professionnel des données ou un décideur souhaitant tirer le meilleur parti de vos données, vous trouverez ici les connaissances et les outils indispensables pour réussir avec AWS Redshift.
L’entrepôt de données est un processus de collecte, de stockage et de gestion de grandes quantités de données structurées issues de différentes sources au sein d’une organisation.
Son objectif principal est de fournir un référentiel centralisé d’informations, facilement accessible et analysable, afin d’alimenter le reporting et la prise de décision.
Conçus pour supporter des requêtes complexes et l’analyse de données, les entrepôts permettent aux entreprises de dégager des insights à forte valeur.
Adopter un entrepôt de données offre de nombreux bénéfices :
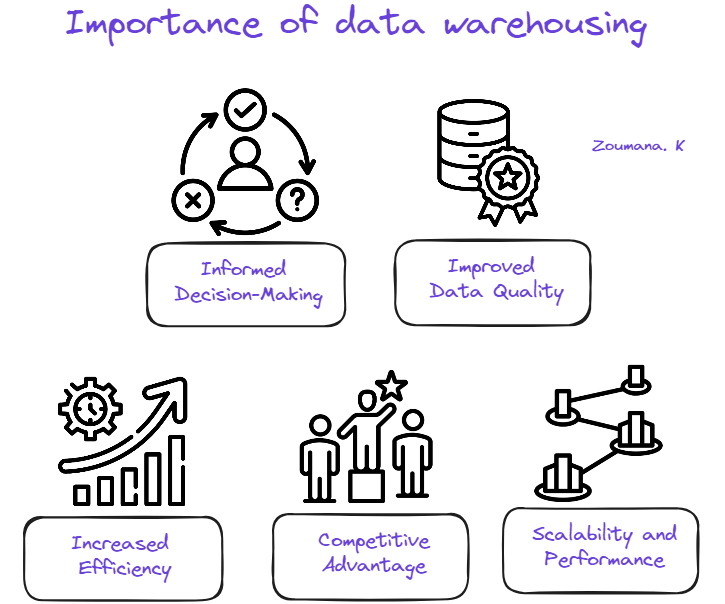
Importance de l’entrepôt de données
AWS Redshift est un service d’entrepôt de données entièrement géré dans le cloud, qui permet de stocker et d’analyser des jeux de données à l’échelle du pétaoctet. Avec AWS Redshift Serverless, vous pouvez accéder aux données et les analyser sans configurer manuellement un entrepôt provisionné.
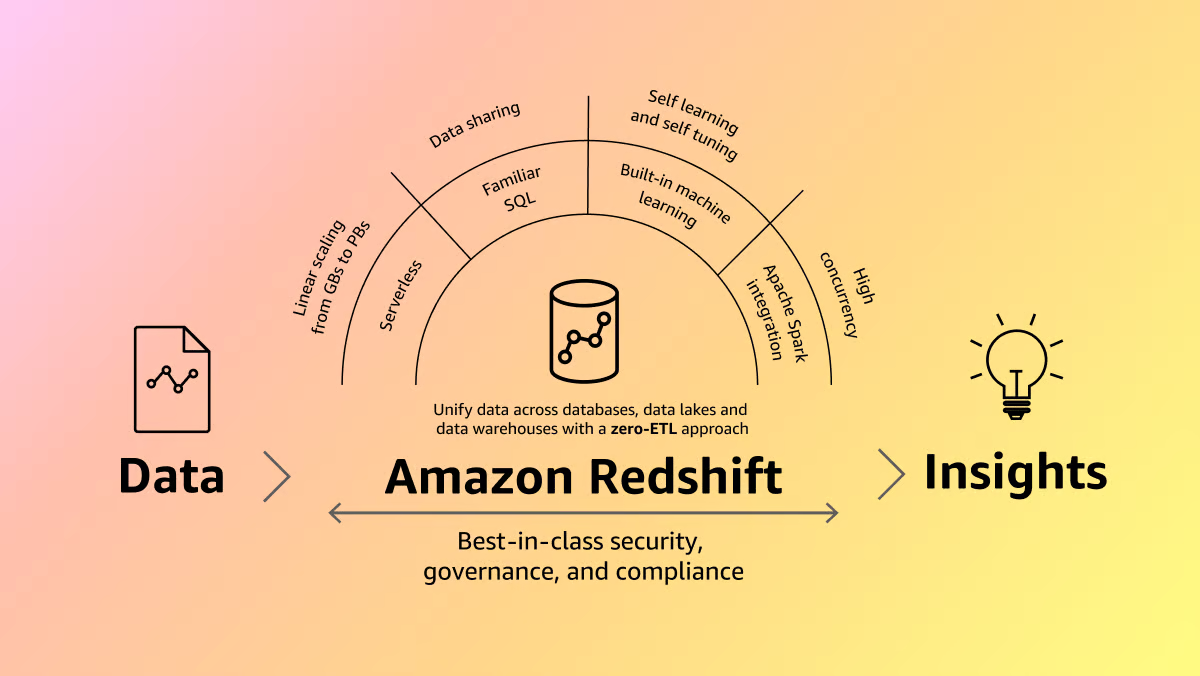
Amazon Redshift (Source)
Le service provisionne automatiquement les ressources et ajuste intelligemment la capacité pour garantir des performances rapides, même pour des charges de travail exigeantes et imprévisibles. Vous ne payez que ce que vous utilisez : aucune facturation lorsque l’entrepôt est à l’arrêt.
AWS Redshift permet de charger des données et de lancer des requêtes immédiatement via Amazon Redshift query editor v2 ou votre outil de business intelligence (BI) préféré. Le service offre un excellent rapport performance/prix, des fonctionnalités SQL familières et un environnement simple, sans administration.
Quelle que soit la taille du jeu de données, AWS Redshift délivre des performances de requêtes élevées en s’appuyant sur les mêmes outils SQL et applications BI couramment utilisés.
AWS Redshift propose de nombreuses fonctionnalités pour stocker, gérer et analyser efficacement de grands volumes de données. Voici les principaux atouts :
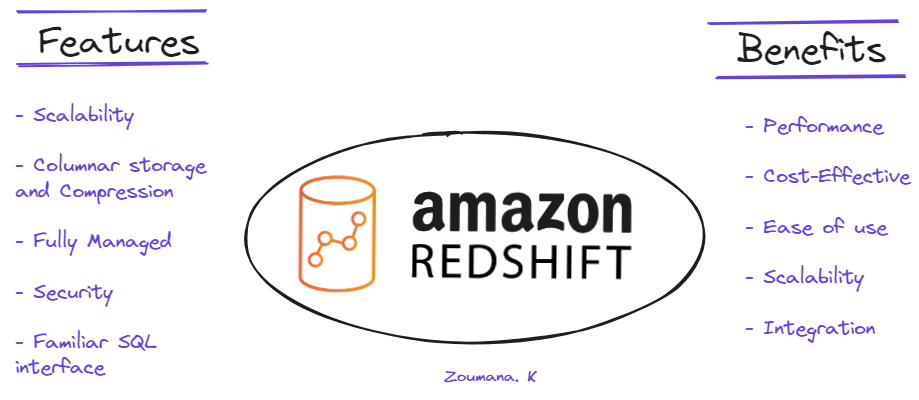
Fonctionnalités et bénéfices d’AWS Redshift
Les sections précédentes donnaient une vision d’ensemble de Redshift. Passons maintenant aux aspects techniques.
Nous détaillons d’abord les prérequis pour réussir la configuration, puis un pas-à-pas pour créer un cluster Redshift. Enfin, nous expliquons les paramètres clés du cluster : types de nœuds, nombre de nœuds et configuration de sécurité.
Avant d’entrer dans le détail du cas d’usage, passons en revue les prérequis d’une mise en œuvre réussie :
Voici les étapes pour créer un cluster Redshift via la console de gestion AWS en 11 étapes simples, comme illustré ci-dessous :
1. Recherchez Redshift depuis la console et sélectionnez « Amazon Redshift » :
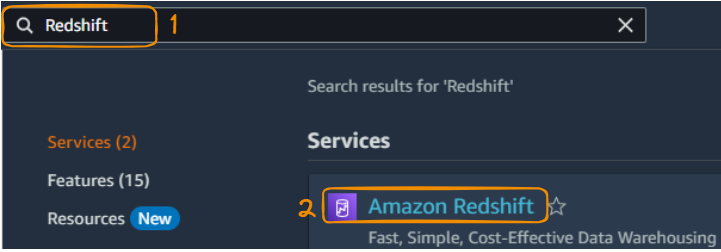
Rechercher et sélectionner Redshift dans la console
2. Cliquez sur le bouton « Create cluster » pour démarrer la création.
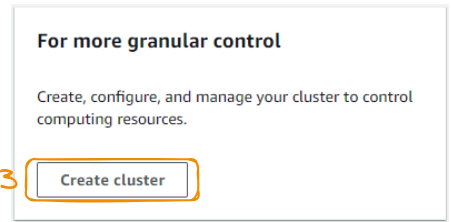
Bouton de création du cluster
3. Renseignez les informations de configuration : identifiant, taille, type de nœud, zone de disponibilité, nombre de nœuds.
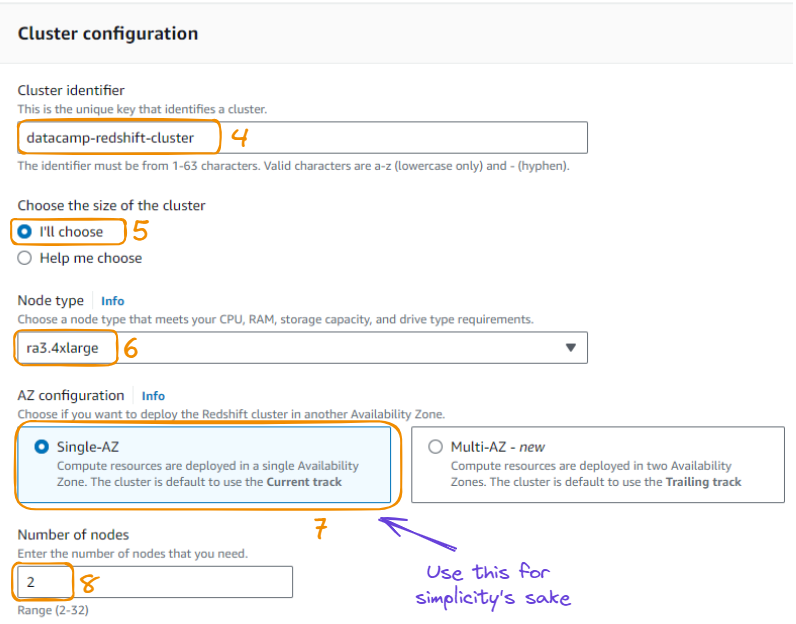
Configuration du cluster en 8 étapes
4. Plutôt que d’utiliser les données d’exemple proposées, nous chargerons des données depuis un bucket S3.
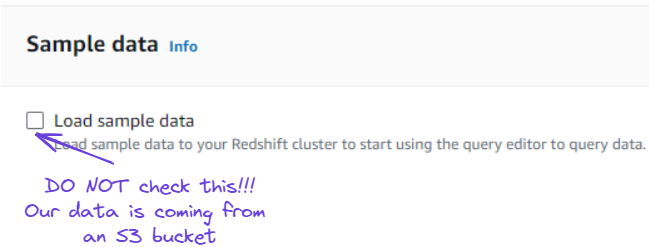
Ignorer l’option de chargement d’exemples
5. Vous pouvez définir les permissions du cluster via des rôles IAM. Cette étape peut être reportée.
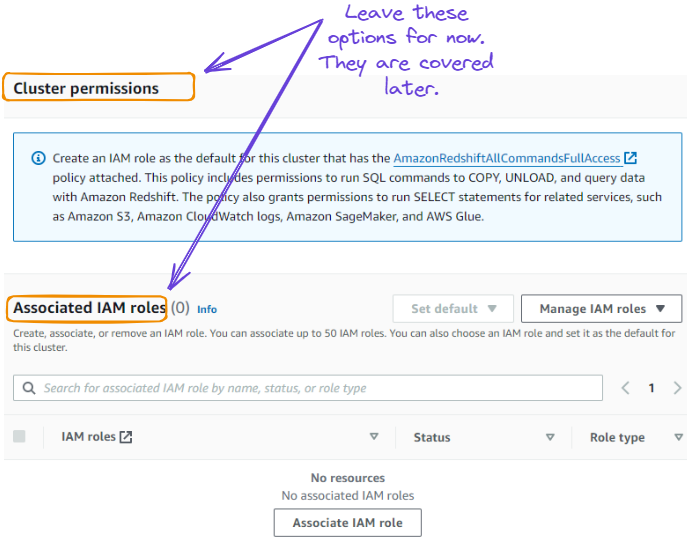
Ignorer les permissions de cluster et les rôles IAM
6. Conservez les paramètres par défaut pour le réseau, la sécurité, la sauvegarde, la maintenance, puis cliquez sur « Create cluster » pour créer le cluster.
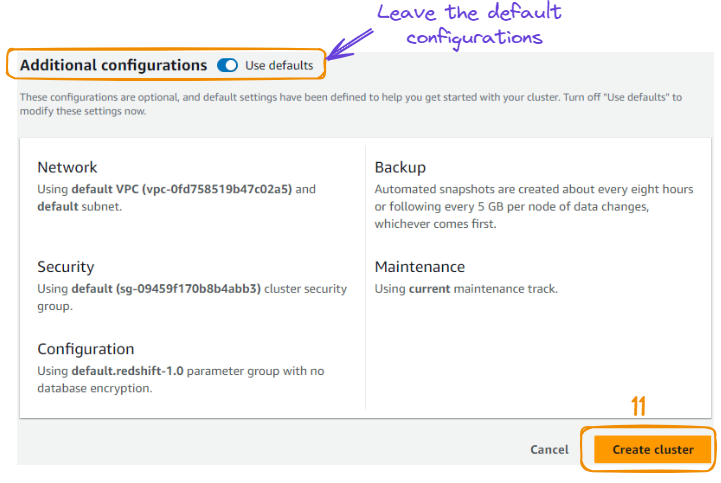
Création du cluster
7. Vous êtes redirigé vers la page du nouveau cluster. Le statut passe de « Creating » à « Available » après quelques minutes.
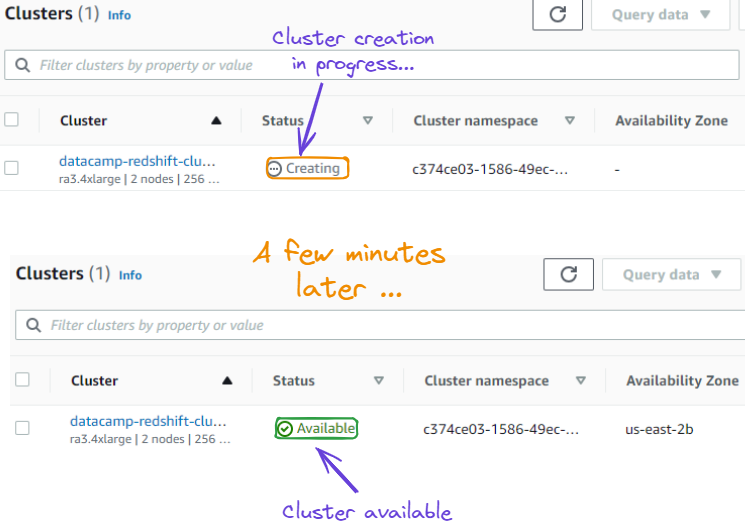
État du cluster de « Creating » à « Available »
Nous avons maintenant créé nos clusters Redshift. Cette section vous guide depuis le choix du jeu de données PIB (pays, régions et monde) disponible dans notre DataLab jusqu’à son dépôt dans un bucket S3.
Nos données proviennent initialement de la Banque mondiale. Elles concernent le PIB des pays, des régions et du monde, en dollars américains courants (US $). Par « régions », on entend des regroupements de pays comme l’Europe et l’Asie centrale.
Les dix premières observations ressemblent à ceci :
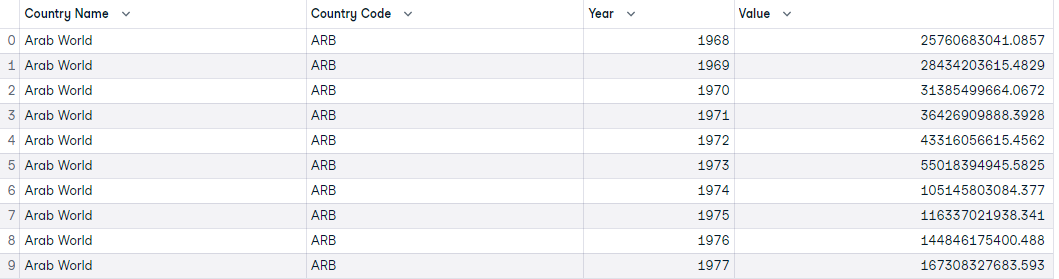
Premières dix observations du jeu de données PIB
Pour permettre l’échange entre S3 et Redshift, nous devons d’abord créer un rôle IAM, puis un bucket S3 pour stocker les données.
Le rôle IAM établit la connexion entre notre cluster Redshift et le bucket S3 qui héberge les données.
La création s’effectue comme suit :
Depuis la console, recherchez « IAM » et sélectionnez le service « IAM » dans les résultats.
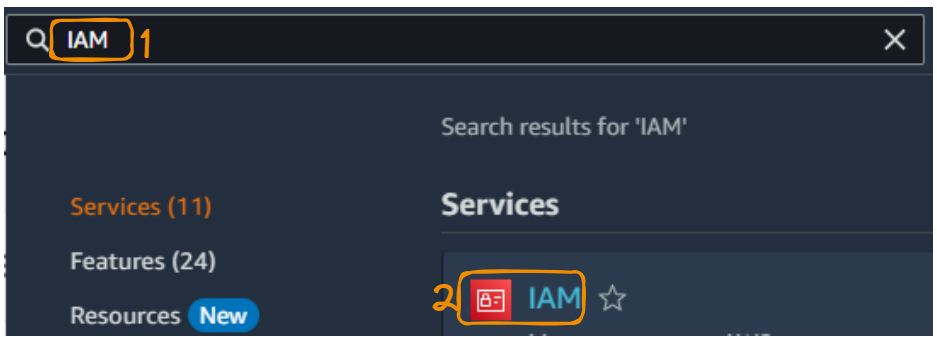
Service IAM depuis la console
Choisissez « Roles » pour afficher les rôles, puis « Create role » pour en créer un nouveau.
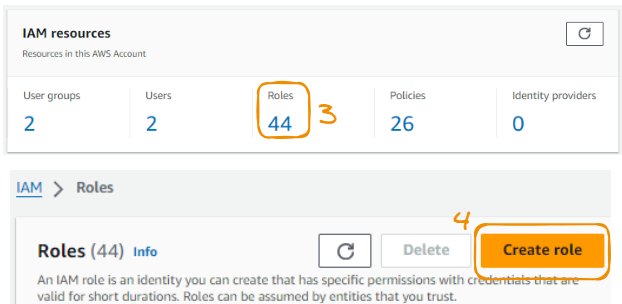
Démarrer la création d’un nouveau rôle
Sélectionnez « AWS service » comme « Trusted entity type », puis « Redshift » en « Use case », et cliquez sur « Next ».
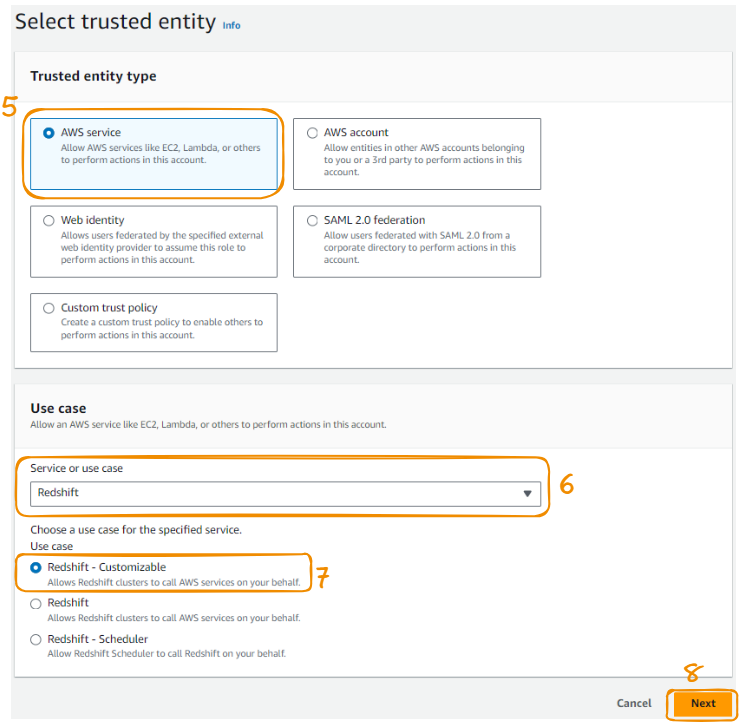
Étapes 5 à 8 de la création du rôle IAM
Recherchez « S3FullAccess », cochez l’option puis « Next ».
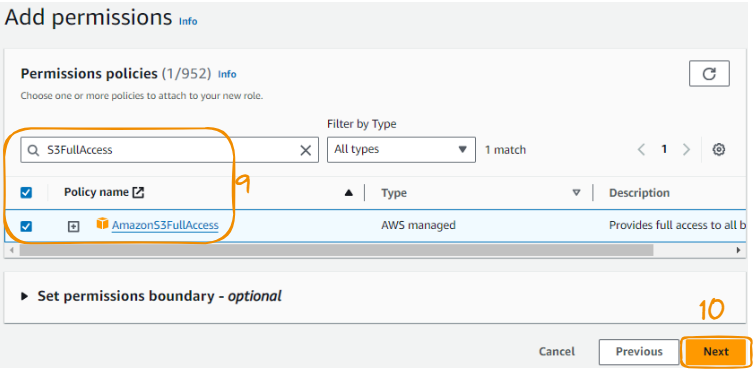
Étapes 9 à 10 de la création du rôle IAM
Enfin, nommez le rôle, vérifiez, puis cliquez sur « Create role » pour finaliser.
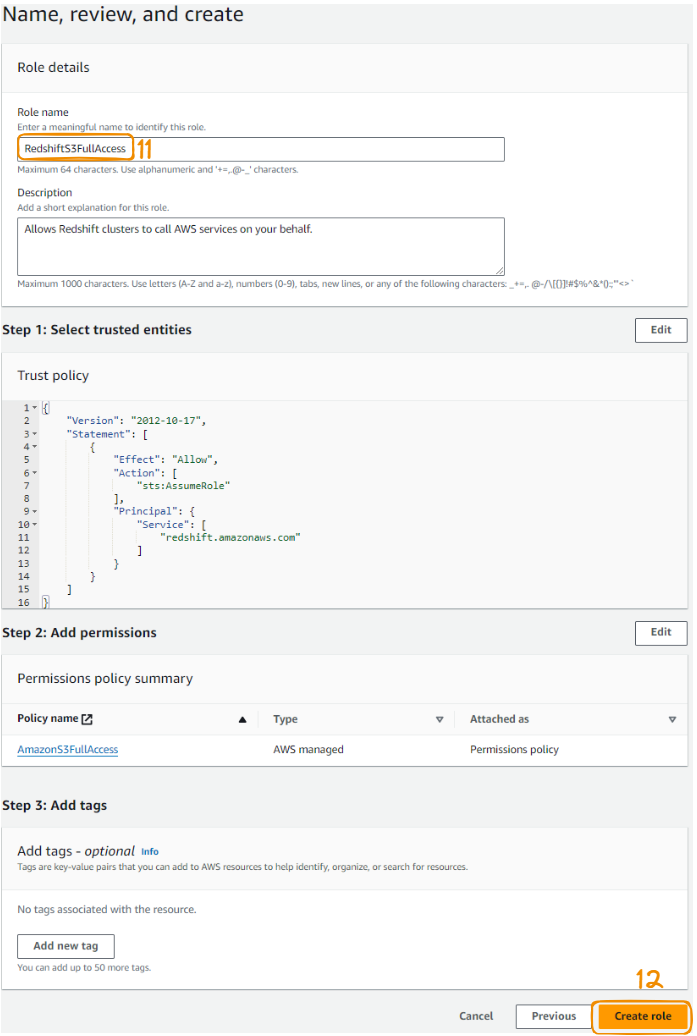
Étapes 11 à 12 de la création du rôle IAM
Une notification verte en haut confirme la création du rôle.
Message de confirmation de création du rôle
Nous pouvons maintenant lier le rôle IAM au cluster Redshift créé, comme suit :
Depuis la section Clusters, sélectionnez le cluster datacamp créé, puis dans « Actions », choisissez « Manage IAM roles ».
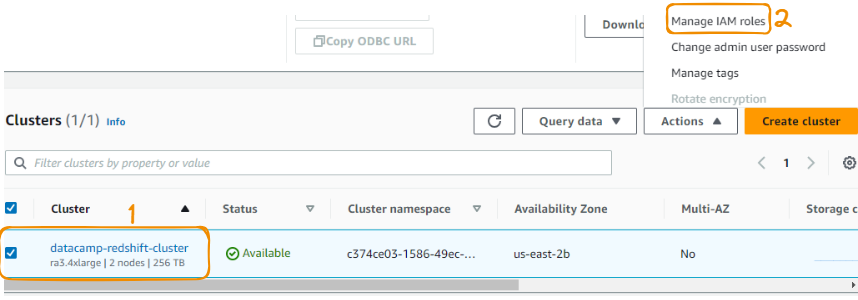
Lier le rôle IAM à Redshift : étapes 1 à 2
Sélectionnez le rôle IAM créé précédemment et enregistrez.
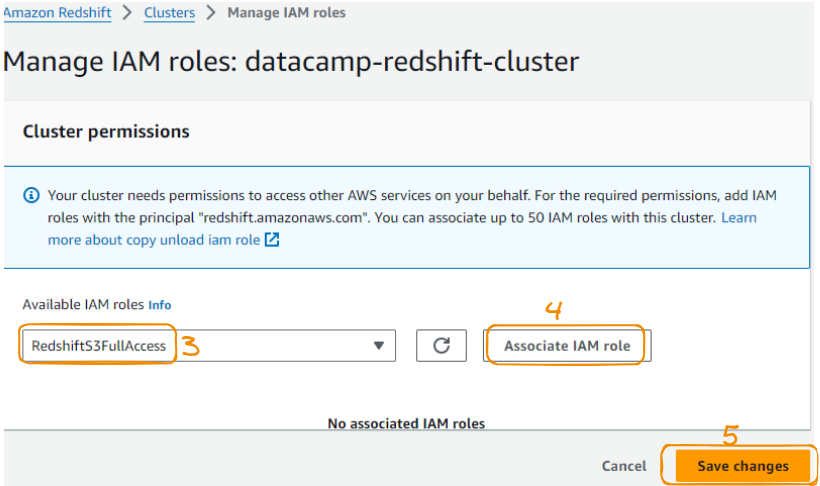
Lier le rôle IAM à Redshift : étapes 3 à 4
Plusieurs outils permettent d’interroger Redshift, internes à AWS ou externes. Dans ce tutoriel, nous utilisons l’éditeur de requêtes du tableau de bord Redshift.
Pour l’utiliser, créez d’abord une connexion à l’éditeur de requêtes depuis « Query in query editor » dans l’onglet « Query data » :
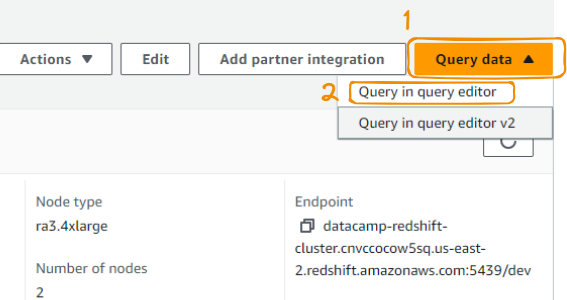
Éditeur de requêtes depuis « Query data »
Vous arrivez sur la page ci-dessous, où vous pouvez vous connecter à la base après avoir renseigné un nom et un identifiant utilisateur :
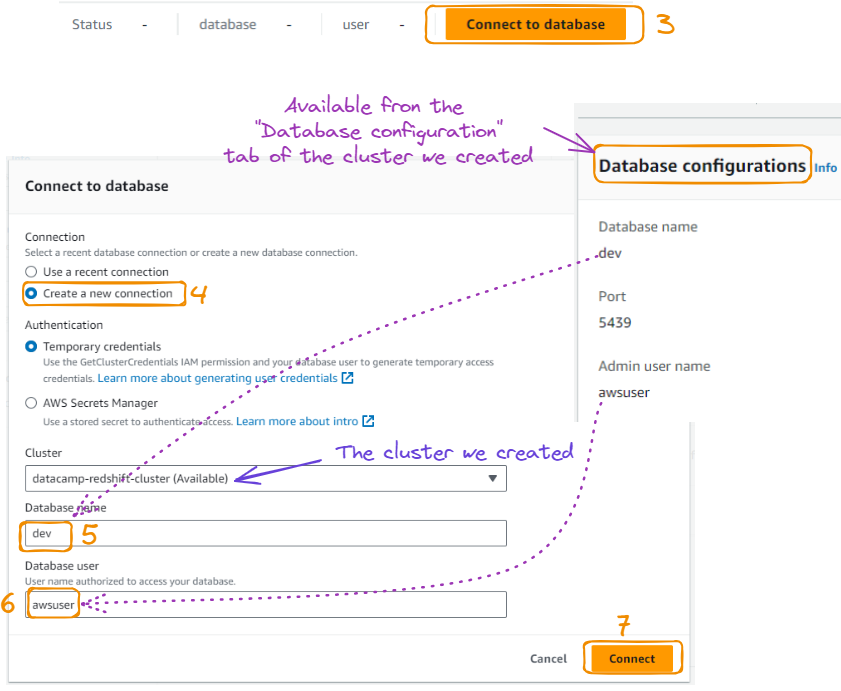
Connexion à la base de données depuis l’éditeur
Après avoir cliqué sur « Connect », l’onglet vert « Connected » apparaît en haut et les informations de la base à gauche.
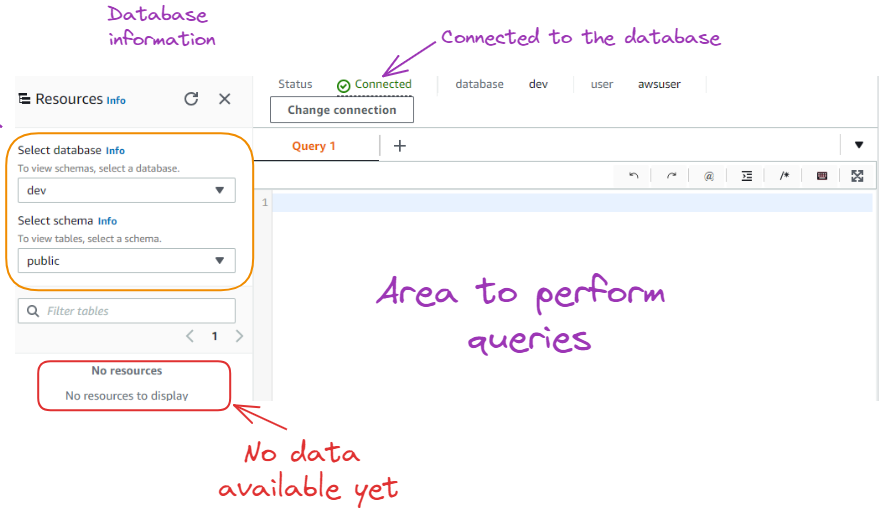
Résultat après connexion à la base
Comme indiqué, aucune ressource/donnée n’est encore présente. Avant d’importer, créons une table correspondant aux caractéristiques des données à charger.
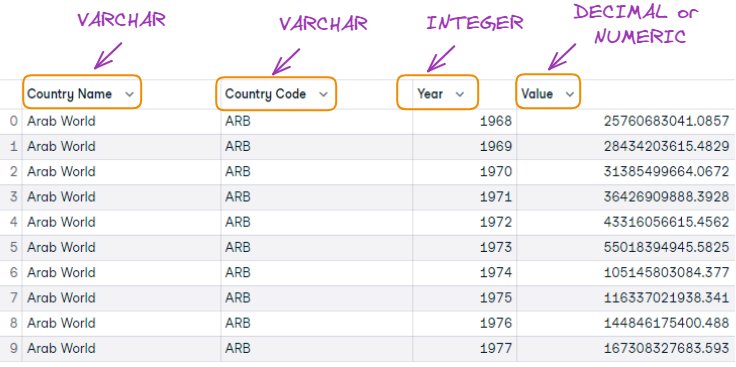
Correspondance entre les 10 premières lignes et le schéma de table
La table est créée avec la requête SQL suivante :
CREATE TABLE gdp_data (
id INTEGER PRIMARY KEY,
country_name VARCHAR(255),
country_code VARCHAR(10),
year INTEGER,
value DECIMAL(20,2)
);
Explication de la requête, colonne par colonne :
id INTEGER PRIMARY KEY : crée une colonne « id » de type INTEGER et la définit comme clé primaire, garantissant l’unicité de chaque ligne.country_name VARCHAR(255) : crée une colonne « country_name » de type VARCHAR, jusqu’à 255 caractères.country_code VARCHAR(10) : crée une colonne « country_code » de type VARCHAR, jusqu’à 10 caractères.year INTEGER : crée une colonne « year » de type INTEGER, adaptée aux nombres entiers (ici, des années).value DECIMAL(20,2) : crée une colonne « value » de type DECIMAL, précision 20 et 2 décimales.Lançons la requête pour créer la table :
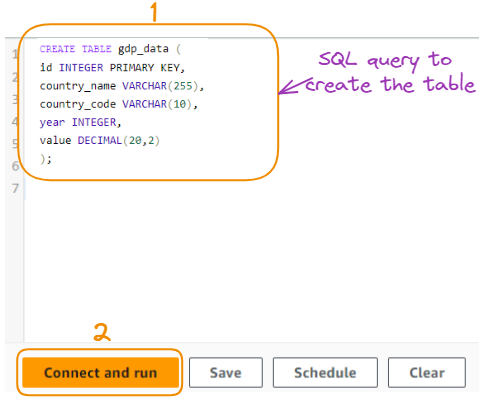
Requête de création de la table
Cette requête crée une table « gdp_data » avec les colonnes nécessaires pour stocker les données de PIB, comme ci-dessous :
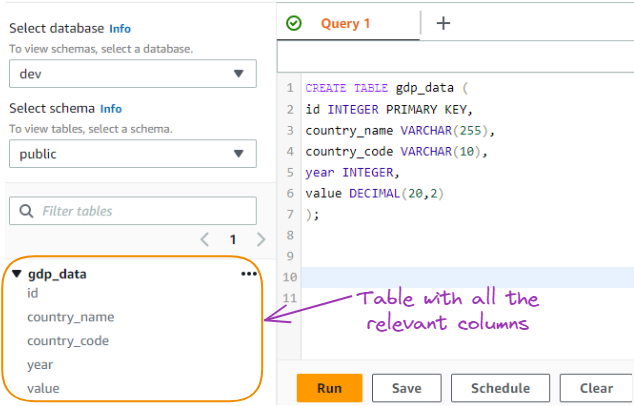
Table PIB créée via la requête SQL
Les données seront importées dans la table depuis un bucket S3. Voyons la création du bucket et le téléversement des données.
Recherchez le service S3 dans la console, sélectionnez son logo et donnez un nom au bucket en laissant le reste par défaut :
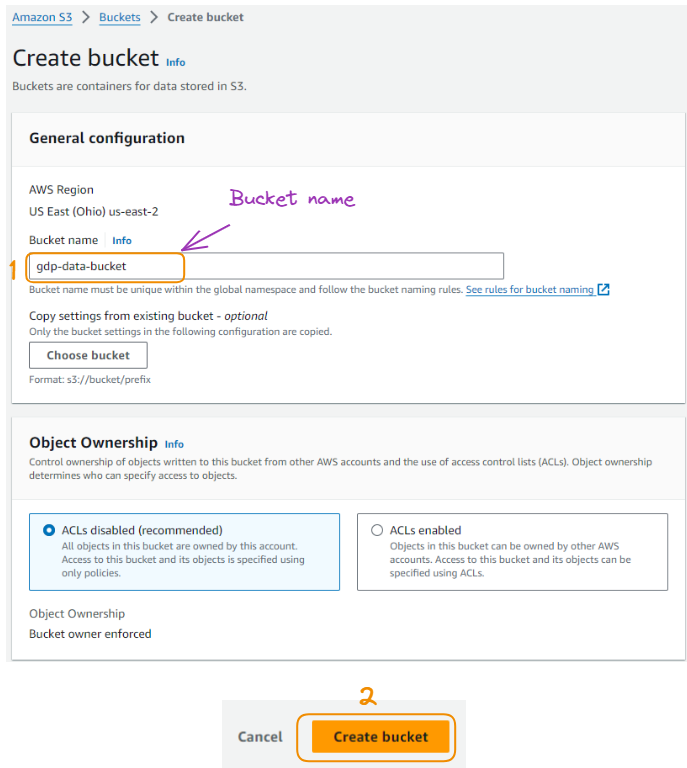
Création du bucket S3
Une fois créé, le bucket apparaît dans la liste de vos buckets.
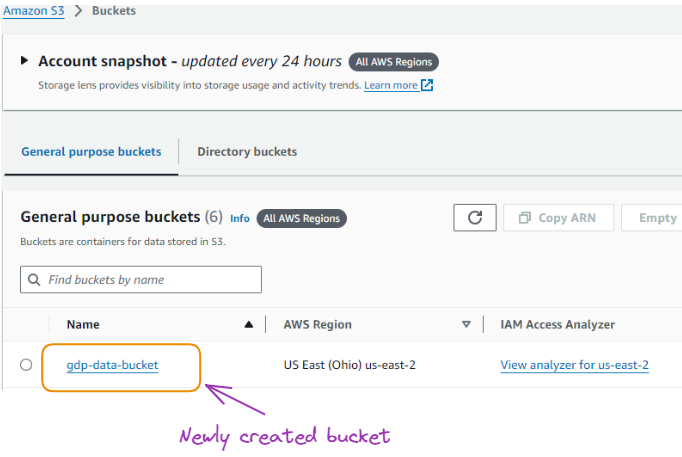
Le bucket nouvellement créé
Sélectionnez le bucket puis importez le fichier CSV de PIB précédemment téléchargé en local.
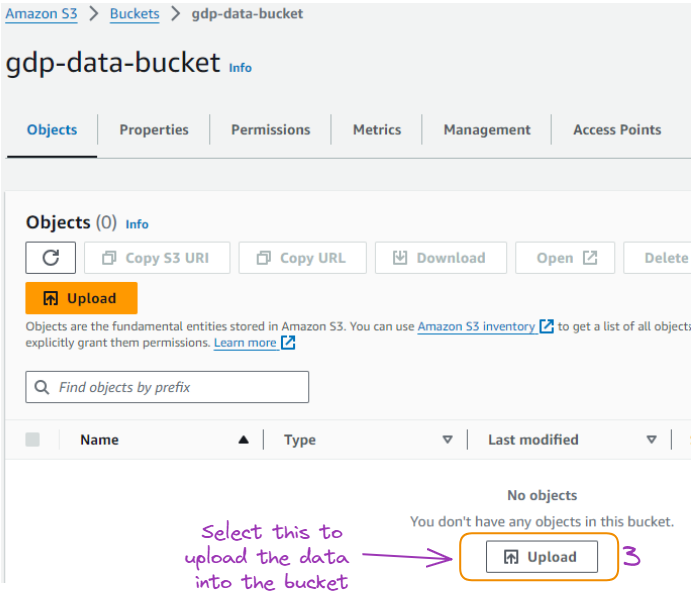
Page de téléversement dans le bucket
Après import réussi, le fichier apparaît comme suit :
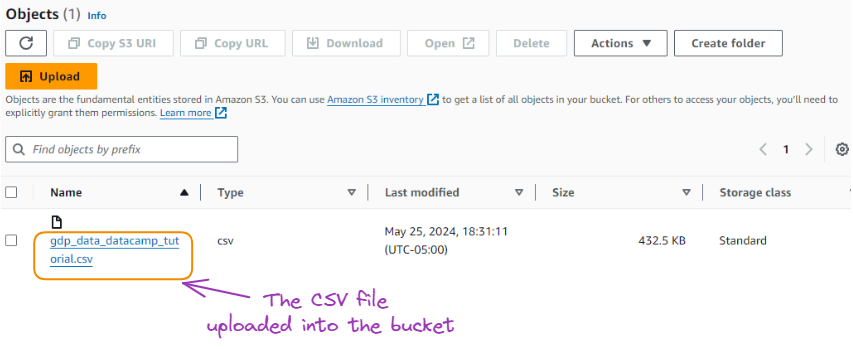
CSV téléversé dans le bucket
Bravo pour le chemin parcouru !
Voici comment copier les données de S3 vers Redshift :
COPY gdp_data (id, country_name, country_code, year, value)
FROM 's3://gdp-data-bucket/gdp/gdp_data.csv'
IAM_ROLE 'arn:aws:iam::654654631565:role/RedshiftS3FullAccess'
CSV
IGNOREHEADER 1;
Décryptage :
Le même code exécuté depuis l’éditeur montre une copie réussie en quelques secondes :
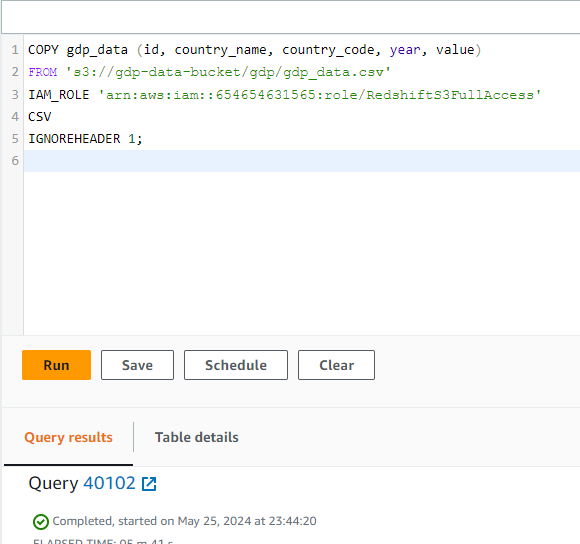
Tâche COPY terminée
Pour simplifier, nous n’avons chargé qu’un échantillon aléatoire de 100 lignes au lieu de l’intégralité du CSV. Un aperçu est disponible via « Preview data » comme suit :
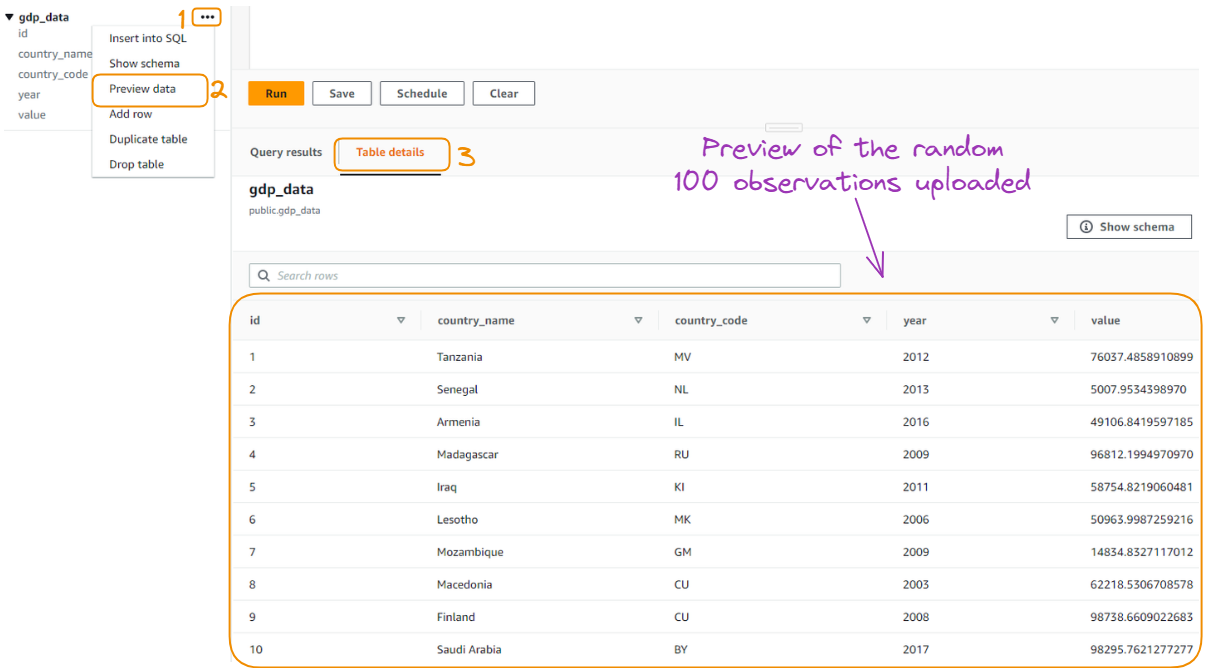
Aperçu des 100 observations chargées
L’aperçu n’affiche que les dix premières lignes. Pour aller plus loin et obtenir des insights, des compétences SQL sont utiles.
Dans cette section, nous explorons les données à travers quelques requêtes SQL.
Nous utilisons cinq requêtes pour interagir avec les données de la base, en commençant par la plus courante : la sélection.
Sélectionner toutes les données
SELECT *
FROM gdp_data;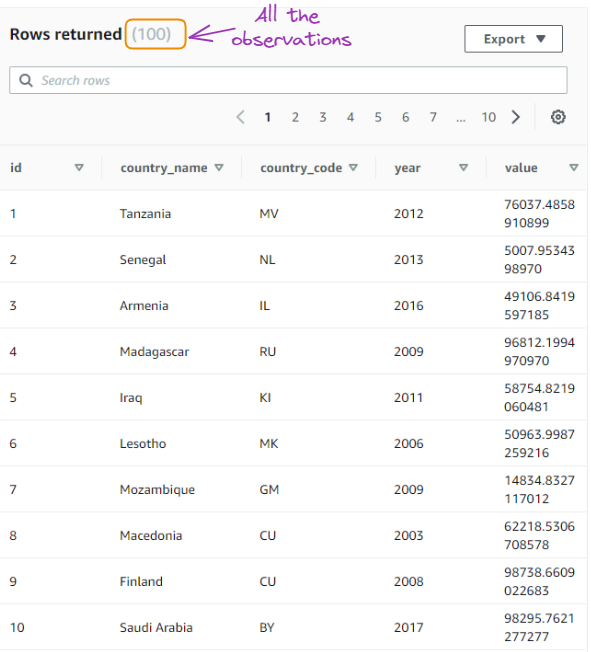
Résultat de la première requête
Sélectionner les données d’un pays spécifique :
SELECT * FROM gdp_data
WHERE country_name = 'Senegal';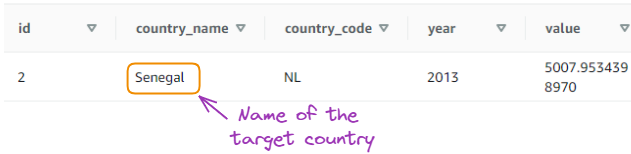
Résultat de la deuxième requête
Calculer le PIB moyen pour une année donnée :
SELECT year, AVG(value) as average_gdp
FROM gdp_data
WHERE year = 2020
GROUP BY year;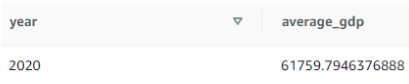
Résultat de la troisième requête
Trouver les 5 pays au PIB le plus élevé pour une année donnée :
SELECT country_name, value
FROM gdp_data
WHERE year = 2020
ORDER BY value DESC
LIMIT 5;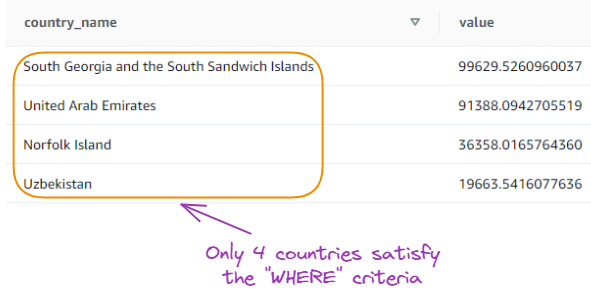
Résultat de la quatrième requête
Compter le nombre d’enregistrements par année :
SELECT year, COUNT(*) as record_count
FROM gdp_data
GROUP BY year
ORDER BY year;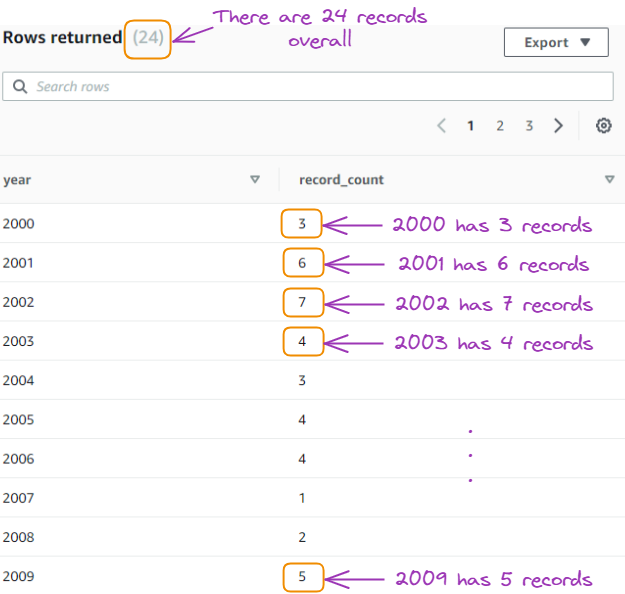
Résultat de la cinquième requête
Les requêtes ci-dessus offrent une compréhension de base. Voyons maintenant trois techniques avancées.
Calcul du cumul courant : cette requête calcule le cumul des valeurs de PIB pour chaque pays, ordonnées par année.
SELECT
    country_name,
    year,
    value,
    SUM(value) OVER (PARTITION BY country_name ORDER BY year) as running_total
FROM gdp_data;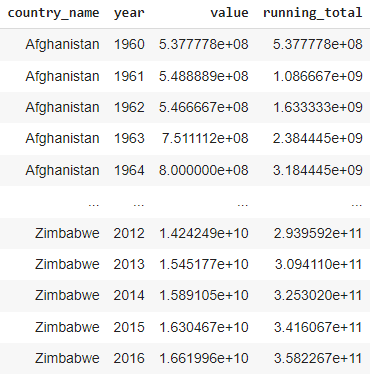
Résultat du cumul
CTE pour filtrage et agrégation : cette requête utilise un CTE pour ne conserver que les enregistrements à partir de 2020, puis calcule le PIB moyen par pays.
WITH recent_data AS (
    SELECT
        country_name,
        year,
        value
    FROM gdp_data
    WHERE year >= 2020
)
SELECT
    country_name,
    AVG(value) as average_gdp
FROM gdp_data
GROUP BY country_name;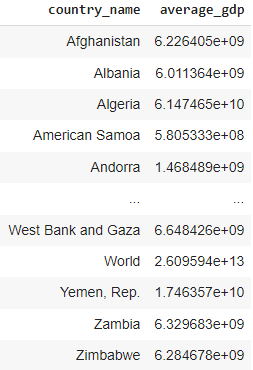
Résultat du CTE
Calculer la croissance annuelle du PIB : cette requête calcule, pour chaque pays, la croissance d’une année sur l’autre.
SELECT
    a.country_name,
    a.year,
    a.value as current_year_value,
    b.value as previous_year_value,
    (a.value - b.value) / b.value * 100 as growth_percentage
FROM gdp_data a
JOIN gdp_data b
    ON a.country_name = b.country_name
    AND a.year = b.year + 1;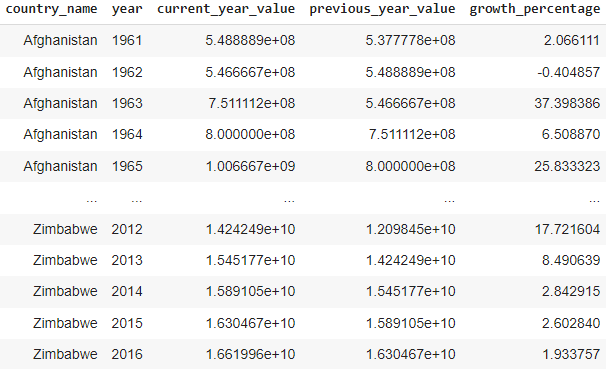
Résultat de l’auto-jointure
Pour garantir des performances optimales et des coûts maîtrisés, il est essentiel de comprendre les facteurs qui influencent Redshift et d’appliquer les bonnes pratiques d’optimisation.
Nous abordons ici les points clés de l’optimisation Redshift et partageons des observations à partir des informations de notre cluster.
Les performances d’Amazon Redshift dépendent de nombreux facteurs, de la configuration matérielle aux techniques d’optimisation des requêtes. Les comprendre aide à identifier les goulets d’étranglement et à prendre de meilleures décisions pour améliorer le cluster.
Nous avons configuré un cluster Redshift composé de deux nœuds ra3.4xlarge, avec des données de seulement 391 Ko.
L’image suivante montre une utilisation CPU proche de 0 % sur toute la période : le cluster est très peu sollicité et probablement surdimensionné pour notre charge actuelle.
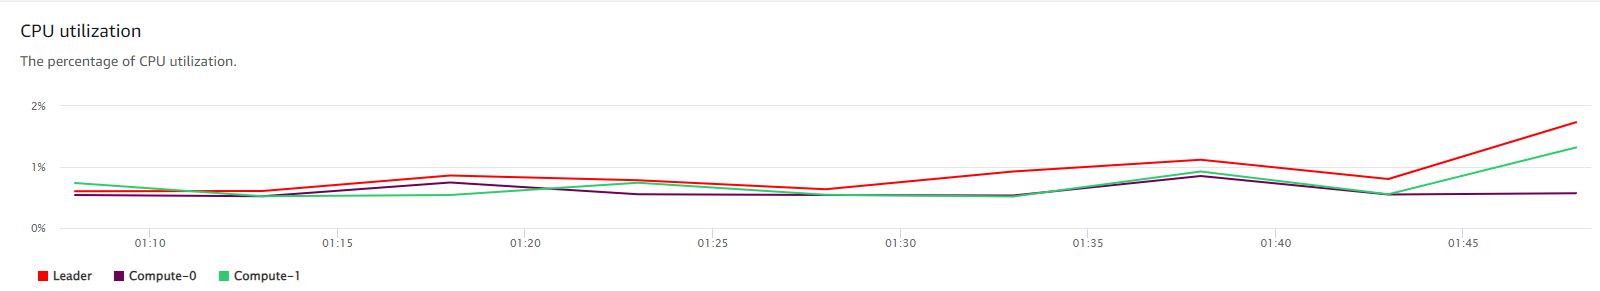
Utilisation CPU du cluster
Parmi les facteurs clés impactant les performances :
Pour optimiser les performances, soignez la conception des tables et la gestion des données. Même avec un petit jeu de données, ces pratiques posent les bases d’une montée en charge efficace.
La supervision et la maintenance régulières sont essentielles pour des performances optimales et des coûts maîtrisés. Le graphique suivant détaille nos coûts mensuels Redshift et met en évidence des pistes d’optimisation.
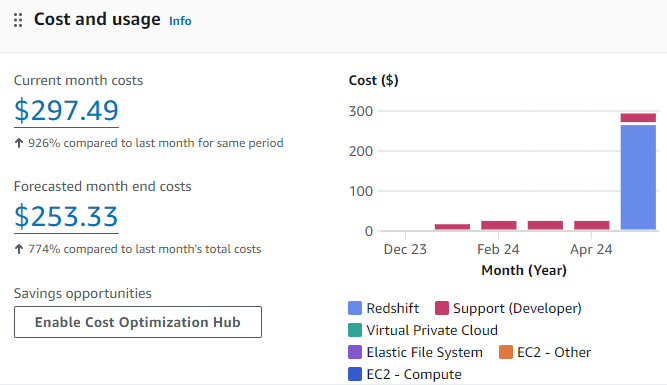
Coûts et utilisation pour ce cas Redshift
Selon ce graphique, notre cluster est surdimensionné pour un petit jeu de données, entraînant une faible utilisation et des coûts inutiles.
Avec Amazon CloudWatch et la console AWS, suivez les métriques clés (utilisation CPU, performances des requêtes). Ces insights aident à détecter des problèmes et à décider des optimisations.
Au vu de la faible utilisation, envisagez :
À mesure que les volumes et la charge évoluent, surveillez en continu et réévaluez le dimensionnement et les stratégies d’optimisation.
Avec des données sensibles dans Amazon Redshift, viser les plus hauts standards de sécurité et de conformité est essentiel. Face aux exigences réglementaires croissantes et à la nécessité de protéger les informations sensibles, des mesures robustes et le respect des règles de conformité sont des piliers de la gestion d’un cluster Redshift.
La conformité aux réglementations sectorielles et aux lois de protection des données est prioritaire pour toute organisation manipulant des données sensibles. Amazon Redshift fournit des fonctionnalités pour répondre efficacement à ces exigences.
Au-delà des aspects réglementaires, appliquer les bonnes pratiques de sécurité dans Redshift est crucial pour prémunir vos données sensibles contre les accès non autorisés et les fuites potentielles.
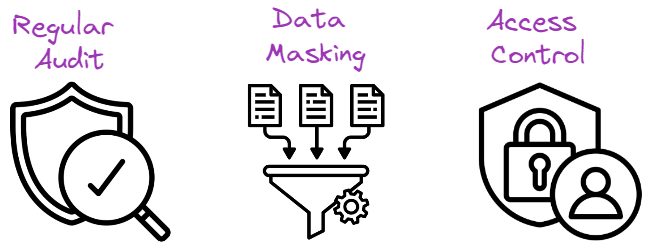
Bonnes pratiques pour la sécurité des données
Mener des audits de sécurité réguliers permet d’identifier des vulnérabilités, d’évaluer l’efficacité des contrôles en place et d’assurer la conformité continue. Pensez à :
Le masquage consiste à dissimuler des éléments sensibles tout en préservant la structure et le format des données. Il protège contre les accès non autorisés et maintient la confidentialité. Approches possibles dans Redshift :
Mettre en place un contrôle d’accès solide est essentiel pour que seules les personnes autorisées accèdent aux données sensibles de votre cluster Redshift. Pour cela :
Dans cet article, nous avons couvert les fondamentaux et des aspects avancés de l’utilisation d’Amazon Redshift pour l’entrepôt de données. Nous avons d’abord souligné l’importance de l’entrepôt et la façon dont Redshift offre une solution puissante, scalable et économique pour analyser de grands volumes en SQL.
Nous avons ensuite détaillé la création d’un cluster Redshift : prérequis, lancement et paramètres de configuration. Nous avons aussi expliqué le chargement via AWS S3 et la commande COPY, avec exemples de syntaxe et commentaires.
Nous avons abordé l’interrogation des données, des requêtes de base aux techniques avancées (fenêtrage, jointures complexes). Côté performance, nous avons mis en avant les bonnes pratiques (distribution, clés de tri, compression).
Enfin, nous avons insisté sur la sécurité et la conformité dans Amazon Redshift, du chiffrement au contrôle d’accès, ainsi que sur les considérations réglementaires.
Pour approfondir vos connaissances et compétences sur Amazon Redshift et AWS, explorez ces ressources DataCamp :
En maîtrisant Amazon Redshift et en tirant parti de ses capacités, vous pourrez extraire des insights précieux et prendre des décisions fondées sur les données.
Poursuivez votre parcours en data engineering dès aujourd’hui !
Cours
Cursus
Cursus